De Vraag Waarmee Elke Proxmox-Evaluatie Begint
“Is Proxmox echt enterprise-grade?”
Die vraag komt in bijna elk migratiegesprek langs, en de zorg eronder gaat vrijwel nooit over de webinterface. Niemand vreest serieus dat een browserdashboard hun data zal beschadigen. Wat mensen echt vragen is of het onderdeel dat tussen een virtuele machine en de hardware staat — de component die de ene tenant uit het geheugen van de andere moet houden, voor altijd, zonder één enkele fout — een serieus stuk engineering is of een communityproject dat populair werd.
Dat is precies het juiste om zenuwachtig over te zijn. Het is alleen op de verkeerde laag gericht, want Proxmox VE bevat geen hypervisor.
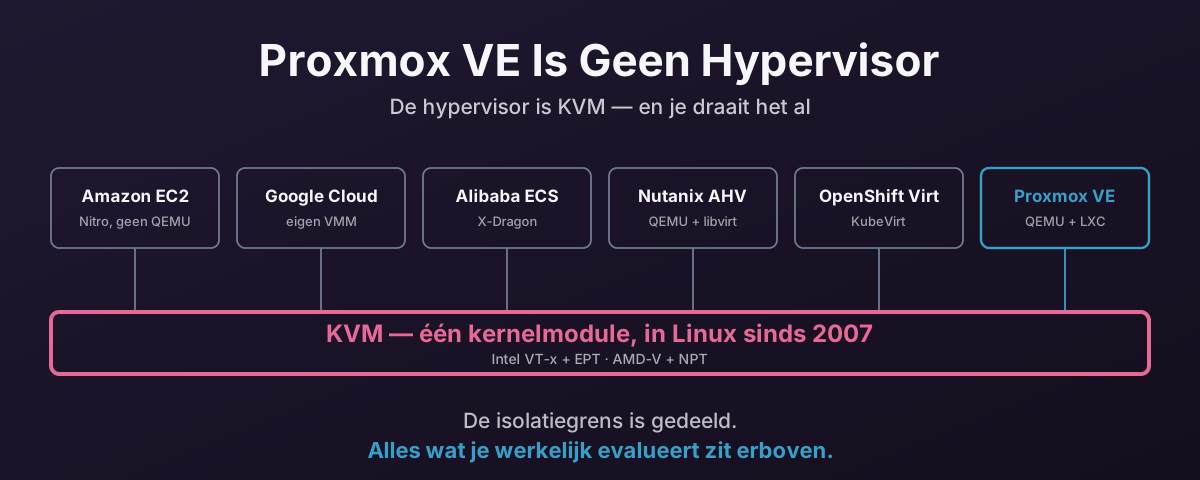
De hypervisor is KVM. Het is onderdeel van Linux, het zit er sinds 2007 in, en als jouw organisatie EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean of Nutanix gebruikt, draai je het vandaag al in productie — je hebt er alleen nooit over hoeven nadenken, omdat iemand anders de lagen erboven bezat.
Deze post gaat over wat dat gedeelde fundament werkelijk betekent. Allebei de helften ervan: het deel van het argument dat echt standhoudt, en het deel dat in verkoopsheets wordt overdreven.
Proxmox VE Is Een Managementlaag
Virtualisatie op Linux bestaat uit vier aparte lagen, gebouwd en onderhouden door vier verschillende groepen mensen.
1. Hardwarevirtualisatie-uitbreidingen. Intel VT-x met EPT, of AMD-V met NPT. Silicium. Dit is wat een gast in staat stelt zijn eigen kernel op native snelheid te draaien met zijn eigen page tables, zonder dat iets instructies emuleert.
2. KVM — de hypervisor.
Kernelmodules: kvm.ko voor de architectuuronafhankelijke kern, plus kvm-intel.ko of kvm-amd.ko voor de vendoruitbreidingen. Dit is de component die de isolatiegrens bezit. Het zet de virtual machine control structures van de gast op, handelt VM exits af, beheert de second-level page tables en levert interrupts af.
3. De VMM — de virtual machine monitor, in user space. Op Proxmox VE is dit QEMU. Het bouwt het virtuele moederbord: chipset, PCIe-topologie, schijven, NIC’s, seriële poorten, firmware. KVM draait de CPU; QEMU bepaalt welke hardware de gast denkt te hebben.
4. De managementlaag.
Dit is Proxmox VE: pve-manager en pveproxy voor de API en interface, qemu-server om een VM-configbestand om te zetten in een QEMU-commandoregel, pve-container voor LXC, pmxcfs bovenop Corosync voor de gerepliceerde clusterconfiguratie, pve-ha-manager voor fencing en herstart, plus de firewall- en SDN-stack.
Die vier lagen bestaan ook op het platform waar je vandaan migreert, en doen dezelfde vier taken — vCenter is laag 4, VMkernel is laag 2 — en ik kom op die vergelijking terug zodra alle stukken op tafel liggen.
Wat Proxmox Werkelijk Onderhoudt
Proxmox VE bezit laag 4 volledig. Het zou onjuist zijn te zeggen dat het lagen 2 en 3 alleen maar inpakt, en dat is de meest voorkomende verkeerde lezing van wat het bedrijf doet.
pve-qemu draagt op dit moment 78 patches tegen upstream QEMU in zijn series-bestand:
debian/patches/series. Het grootste deel van de wachtrij is Proxmox’ eigen engineering, en het geheel zit in laag 3 — geen van deze patches raakt kvm.ko.Ze bouwen ook hun eigen kernel, en onderhouden packaging of patches voor het grootste deel van de omringende stack — pve-edk2-firmware voor OVMF, plus lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm en ceph.
De echte grens is dus: heel laag 4, substantiële engineering binnen laag 3, en een kernel die ze zelf compileren. Wat ze niet hebben gedaan is een hypervisor schrijven. De KVM-code van laag 2 is upstream Linux.
En niets hiervan is kritiek op Proxmox. Het is juist de reden dat een bedrijf van Proxmox’ omvang de klus überhaupt toevertrouwd kan worden. Een klein bedrijf in Wenen is niet gaan zitten om vanaf nul een hypervisor te schrijven; ze bouwden voort op eentje die Intel, AMD, Red Hat, Google, Amazon en IBM al engineers betaalden om te onderhouden, en staken hun eigen inspanning in de laag erboven en het integratiewerk dat die laag nodig heeft. Dat is waar een team van die omvang het verschil kan maken, en de patchwachtrij laat zien dat ze het maken.
Wat KVM Werkelijk Is
KVM staat voor Kernel-based Virtual Machine, en de naam is exact: het is een kernelfunctie, geen programma.
Laad de modules en Linux krijgt een character device, /dev/kvm, plus een kleine set ioctl-aanroepen erop — KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Die interface is de hele hypervisor-API. Alles wat een file descriptor kan openen en ioctl kan aanroepen, kan virtuele machines maken.
Het werd geschreven door Avi Kivity bij Qumranet en samengevoegd in Linux 2.6.20, uitgebracht in februari 2007 — negentien jaar geleden. Red Hat nam Qumranet over in 2008, en KVM is sindsdien in elke kernelrelease meegeleverd, op het gebruikelijke ritme van negen à tien weken van de kernel. Het is ver buiten x86 geport: arm64, POWER, s390 op IBM Z, en RISC-V.
Het belangrijke architecturale punt is waarom het klein is.
KVM heeft geen scheduler, want Linux heeft er een. Een vCPU is een gewone hostthread, en de completely fair scheduler zet die net als elke andere thread op een core. Het heeft geen memory manager, want Linux heeft er een. Gast-RAM is een gewone user-space mapping, dus het kan worden gepaged, worden ondersteund door hugepages, of op een NUMA-node worden geplaatst met dezelfde machinerie als elk ander proces. Het heeft geen driverstack, geen block layer, geen netwerkstack en geen filesystem, want Linux had ze allemaal al en het zijn de exemplaren waar je hardwarevendor tegenaan test.
Dat is het werkelijke volwassenheidsargument, en het is veel sterker dan een versienummer. Elke NUMA-balancingverbetering, elke io_uring-wijziging, elke netwerkdriver, elke nieuwe CPU-errata-workaround die in Linux landt, landt onder je virtuele machines, want er is geen aparte hypervisorkernel waar iemand het naartoe hoeft te porten.
Het Type 1-Argument Trekt De Grens Op De Verkeerde Plek
Het bezwaar dat hierop volgt, betrouwbaar, is dat KVM “maar een type 2-hypervisor” is. Het draait op een host-OS, anders dan ESXi, dat op bare metal draait.
Die taxonomie is drie decennia ouder dan hardwarevirtualisatie, en het ding waar ze een grens omheen trok, zit niet meer waar iedereen denkt dat het zit.
Wat Er Werkelijk Gebeurt Als Een vCPU Draait
QEMU roept ioctl(vcpu_fd, KVM_RUN) aan. De controle gaat over naar kvm.ko, dat de CPU-toestand van de gast laadt en VMLAUNCH uitvoert. Vanaf die instructie tot de volgende VM exit draait de gast direct op de fysieke core, in guest mode, met zijn eigen page tables actief via EPT, op volledige hardwaresnelheid. Er zit niets onder dat iets interpreteert. Het “host-OS” zit niet in het pad. Het draait niet eens op die core.
Als de gast iets doet dat afhandeling vereist, exit de CPU naar de host — en landt in kvm.ko, in de kernel, op precies het privilegeniveau dat de VMkernel van ESXi bezet. De meeste exits worden daar meteen opgelost en heringesprongen zonder dat user space er ooit bij betrokken is.
ESXi Heeft Dezelfde Splitsing
Kijk nu naar het platform dat het onderscheid zogenaamd bewijst.
VMware’s eigen architectuurdocumentatie beschrijft VMkernel als “a POSIX-like operating system” dat “process creation and control, signals, file system, and process threads” biedt. Dat is een besturingssysteem, volgens de beschrijving van de auteur zelf. En een draaiende VM op ESXi is geen ding binnen de kernel — het is een groep userworld-processen: een VMM per virtuele CPU, die de instructies van de gast virtualiseert en zijn geheugen beheert, en een VMX-proces per VM, dat de I/O afhandelt naar de apparaten die niet prestatiekritisch zijn en praat met de snapshotmanager en de remote console.
Lees dat met QEMU in gedachten. Uitvoeringscontext per vCPU in de kernel, user-space-proces per VM dat apparaatemulatie en beheer doet. VMware heeft het gesplitst om precies dezelfde reden als iedereen.
Hyper-V is niet anders. Microsofts documentatie is expliciet dat het Virtual Machine Worker Process, vmwp.exe, “a user mode component of the virtualization stack” is, per VM gestart, en dat alle geëmuleerde apparaten erin worden geïmplementeerd — draaiend in de root partition, wat Windows is. Zelfs Xen, de architectuur waar de taxonomie het beste bij past, heeft een general-purpose Linux in dom0 nodig om te functioneren, en haalt zijn device model voor volledig gevirtualiseerde gasten uit QEMU.
Waar Ligt De Grens Dan?
Het criterium was nooit “gebruikt het user space”. Goldbergs taxonomie, uit de vroege jaren zeventig, vraagt of de hypervisor een applicatie is die draait op een reeds bestaand besturingssysteem dat de hardware al bezit en de scheduling doet. Dat is een type 2, hosted hypervisor: VMware Workstation, VirtualBox, Parallels Desktop, kale QEMU zonder versnelling. Je installeert een general-purpose OS, dan installeer je er een programma op, en dat programma vraagt het OS om geheugen en CPU-tijd zoals elk ander programma.
Dat is niet wat KVM is. kvm.ko is geen programma bovenop Linux. Het is onderdeel van Linux, uitgevoerd op hetzelfde privilegeniveau als de code die de hardware bezit, en als een gast exit landt het daar direct. Er zit geen host-OS onder de hypervisor. De kernel is de hypervisor. Proxmox VE levert die kernel als het systeem, precies zoals ESXi de VMkernel als het systeem levert.
En de versie “het heeft user space nodig, dus het is type 2” kan niet gered worden, want consequent toegepast vangt het alles. Geen VM draait op ESXi zonder zijn VMX-proces, geen op Hyper-V zonder vmwp.exe, geen op Xen als HVM-gast zonder QEMU. Een test die elke bestaande hypervisor in één emmer stopt, onderscheidt niets.
| Kernel die CPU- en geheugenvirtualisatie bezit | User-space device model per VM | Vereist een reeds bestaand host-OS? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX per VM | Nee |
| Microsoft Hyper-V | hypervisor plus de Windows root partition | vmwp.exe | Nee |
| Xen | Xen-hypervisor plus dom0 Linux | QEMU, in dom0 of een stub domain | Nee |
| KVM | kvm.ko | QEMU | Nee |
| VirtualBox, VMware Workstation | de kernel van de host, via een geïnstalleerde driver | de applicatie zelf | Ja |
Vier producten, één vorm — en dan een vijfde rij die echt anders is. Die laatste rij is waar “type 2” voor bedacht is, en het is de enige waar iets anders al de baas was over de hardware.
De taxonomie trekt dus nog steeds een grens. Alleen niet ergens in de buurt van waar het argument aanneemt: KVM en ESXi staan aan dezelfde kant ervan. KVM type 2 noemen leent een woord uit de VirtualBox-categorie en plakt het op iets dat architecturaal in de ESXi-categorie thuishoort.
Daarmee doet het label geen nuttig werk in een evaluatie, want beide producten waartussen je kiest zitten in dezelfde emmer. Wat verschilt is niet het typenummer. Het is dat de ene vendor ook de kernel schreef en je die niet laat lezen — een licentie- en transparantieverschil vermomd als architectuurdiagram. Nutanix laat het punt commercieel zien: het levert dezelfde KVM-code als Proxmox en omschrijft AHV als een bare-metal type 1-hypervisor. Dezelfde code, tegenovergesteld label, andere marketingafdeling.
Er zit een echte zorg verborgen in de beschuldiging, en die verdient een betere naam: een general-purpose kernel doet duizend taken die een purpose-built kernel niet doet, wat meer code en meer aanvalsoppervlak naast de isolatiegrens betekent. Dat is legitiem en meetbaar, en ik kom er tegen het eind op terug.
Waar Het Werk Werkelijk Gebeurt
De ene plek waar het “het draait op een host-OS”-instinct een echt punt heeft, is exit-afhandeling, dus het is de moeite waard om duidelijk te zijn over welke exits waarheen gaan.
| De gast doet dit | Afgehandeld door | Kosten |
|---|---|---|
| Raakt een pagina aan die nog niet in EPT/NPT is gemapt | kvm.ko, in de kernel | Eén exit, microseconden |
| Schrijft naar zijn lokale APIC | De CPU zelf, via APICv/AVIC | Vaak helemaal geen exit |
| Stuurt een inter-processor interrupt | Posted interrupts in hardware | Vaak geen exit |
Verzendt op een virtio-net-queue met vhost-net | Kernelthread, geen user-space-hop | Eén doorbell |
| Leest een register op een geëmuleerde e1000 of IDE-controller | Helemaal naar QEMU | Exit plus een user-space-rondgang |
Alleen de laatste rij lijkt ook maar iets op de type 2-karikatuur — en het is ook de rij die je wegontwerpt, door virtio-apparaten te gebruiken en geen geëmuleerde legacy-hardware te presenteren die je niet nodig hebt. Dat is dezelfde redenering achter Q35 kiezen boven i440fx: minder getrapte registertoegangen, minder legacy-apparaten om langs te lopen.
Het Host-OS Is Een Feature, Geen Ballast
De andere helft van dat grootboek haalt het argument nooit, dus hier is die: een Proxmox-node is een machine waar je echt op kunt werken. Het is Debian, dus het hele Debian-archief is één apt install verderop.
- Monitoring die je al draait — een Prometheus node exporter,
smartmontools, je bestaande agent — in plaats van wat de appliance kiest bloot te leggen. - Diagnostiek als iets traag is:
fio,iperf3,nvme-cli,perf,bpftrace. - Backup-agents van elke vendor die een Linux-binary levert.
- Configuration management, zodat de hypervisor in dezelfde Ansible-inventory zit als al het andere in plaats van een uitzondering te zijn.
fwupdvoor firmware, op hardware waarvan de vendor LVFS ondersteunt.
Niets daarvan heeft een pluginformaat, een gesigneerde bundel of vendorzegen nodig. Vergelijk dat met het ESXi-model, waar de shell bewust beperkt is, third-party code als VIB aankomt, en er helemaal geen package manager is om naar te grijpen.
Het Reikt Tot In De Storagestack
Monitoring-agents zijn de saaie versie hiervan. Proxmox’ eigen storagedocumentatie somt de native plugins op — dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS — en voegt er dan een zin aan toe die je letterlijk mag nemen:
you may use all storage technologies available for Debian Linux
Dat is een uitspraak over waar de grens ligt, en het mechanisme erachter is generiek: krijg een block device op elke node, zet er LVM op, voeg het toe als LVM-storage met shared ingeschakeld. Precies zo werken de ondersteunde Fibre Channel- en iSCSI-paden, dus alles wat een gedeeld block device kan produceren, kan dezelfde route gebruiken.
NVMe over TCP of RDMA is het geval dat het waard is te kennen, want het is snel, actueel, en afwezig op die pluginlijst. nvme-tcp en nvme-rdma zijn in-tree Linux-hostdrivers — NVMe/TCP zit sinds 5.0 in mainline — dus er is niets te compileren. nvme-cli is een Debian-pakket (nvme discover, dan nvme connect), en nvmetcli configureert de in-kernel nvmet-target aan de andere kant. Een verbonden namespace verschijnt als /dev/nvmeXnY, en van daaraf is het een gewoon block device.
ATA over Ethernet maakt hetzelfde punt vanaf het tegenovergestelde uiteinde van het spectrum — oeroud, obscuur, even niet-ondersteund als plugin. De aoe-driver zit in mainline; aoetools geeft je aoe-discover en aoe-stat; vblade maakt van elk bestand of block device op een andere machine een target. Zelfde route, zelfde uitkomst.
Geen van beide is een plugin-API, een SDK of een certificeringsprogramma. Het is wat er gebeurt als de storagelaag van de hypervisor de Linux block layer is.
De eerlijke kanttekeningen, want dit leest als een goocheltruc tot het 3 uur ’s nachts is. Geen van beide transports is een geteste Proxmox-storagetype, dus de integratie en de foutmodi ervan — reconnect-gedrag, multipath, timeouts onder belasting — zijn de jouwe om te bezitten en te testen voordat er iets belangrijks op leeft. En AoE is een kaal Layer 2-protocol, niet-routeerbaar en zonder authenticatie, dus het hoort op een geïsoleerd storage-VLAN en nergens anders. NVMe/TCP heeft tenminste een discoverymodel en kan gerouteerd worden, wat een groot deel is van waarom het degene is om nu naar te grijpen.
Wie KVM Nog Meer Draait
Hier komt de claim “je draait het al” vandaan. Elk platform hieronder draait dezelfde kernelmodule.
| Platform | Waar je het tegenkomt | Het KVM-deel | De user-space-VMM |
|---|---|---|---|
| Amazon EC2 (Nitro) | Publieke cloud | KVM-kernmodule | Eigen — QEMU verwijderd, device model in de Nitro-kaarten |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker — een minimale microVM-monitor in Rust |
| Google Compute Engine | Publieke cloud | KVM sinds de lancering | Google’s eigen VMM, bewust niet QEMU |
| Alibaba Cloud ECS | Publieke cloud | Vereenvoudigde KVM (X-Dragon) | Eigen, met net en storage offloaded naar een MoC-kaart |
| Oracle Cloud (OCI) | Publieke cloud | Oracle Linux KVM — dezelfde stack die Oracle on-premises levert | QEMU-afstamming |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Publieke cloud | Standaard-KVM | QEMU |
| Nutanix AHV | On-premises HCI | Standaard-KVM | QEMU met libvirt en Open vSwitch |
| OpenStack (Nova) | Private cloud | Standaard-KVM | QEMU via libvirt — de standaard- en best geteste driver |
| Apache CloudStack, OpenNebula, oVirt | On-premises | Standaard-KVM | QEMU via libvirt |
| OpenShift Virtualisation, SUSE Harvester | Kubernetes | Standaard-KVM | QEMU binnen een pod, via KubeVirt |
| Proxmox VE | On-premises | Standaard-KVM | QEMU, met LXC ernaast voor containers |
Iedereen Houdt De Kernelhelft En Herschrijft De User-Space-Helft
De hyperscalers hebben KVM niet geforkt. Ze hebben de taak van QEMU geforkt.
AWS haalde EC2 van Xen af naar de Nitro-hypervisor, die gebouwd is op de KVM-kernmodule met QEMU er volledig uit gegooid. Het device model leeft in plaats daarvan in speciale Nitro-kaarten, wat is hoe ze prestaties krijgen die niet van bare metal te onderscheiden zijn. Elk EC2-instancetype van de huidige generatie draait dit. Los daarvan draaien Lambda en Fargate Firecracker, een purpose-built VMM in Rust die met dezelfde /dev/kvm praat.
Google heeft elke Compute Engine-VM op KVM gedraaid sinds Compute Engine werd gelanceerd, en schreef zijn eigen user-space-VMM in plaats van QEMU te gebruiken, expliciet om QEMU’s enorme matrix van gasten, apparaten en modi te vermijden. Ze gingen ook de andere kant op en hardden de kernelmodule upstream, verwijderden geëmuleerde apparaten die niemand nodig had en versmalden de set geëmuleerde instructies. Dat werk zit in de KVM die je draait.
Alibaba deed hetzelfde soort ding met X-Dragon: een uitgeklede KVM-hypervisor met de netwerk- en storagevirtualisatie offloaded naar een FPGA-gebaseerde MoC-kaart.
Nutanix AHV is KVM plus libvirt plus QEMU plus Open vSwitch plus Nutanix’ orchestratie — van elk commercieel product op die lijst de naaste verwant die Proxmox VE heeft. Een andere laag 4, en een heel andere factuur.
Proxmox VE Houdt QEMU Met Opzet
Het is verleidelijk de tabel als een ranglijst te lezen, met AWS en Google bovenaan omdat ze QEMU vervingen. Dat is de verkeerde lezing, want hun beperking is niet de jouwe.
AWS en Google draaien één hardwareprofiel, op een schaal waar één device-emulatiebug een vlootbrede gebeurtenis is, en ze beheersen elke gast-imagegrens waar ze om geven. In die wereld is QEMU’s breedte bijna volledig een last, dus het schrappen ervan is overduidelijk juist.
Jij zit niet in die wereld.
Je hebt een appliance-image uit 2013 dat een e1000 wil. Je hebt een Windows-VM waarvan het machinetype de rest van zijn leven vastgepind moet blijven. Je hebt een GPU om door te geven, een geëmuleerde SAS-controller om een installer tevreden te stellen, een UEFI-variabelenopslag om te behouden. QEMU is precies wat een general-purpose platform in staat stelt op dat alles ja te zeggen.
Wat AWS aanvalsoppervlak noemt, noem jij een compatibiliteitsmatrix. Beide beschrijvingen kloppen; het verschil is of je je workloads mag kiezen.
Het verklaart ook de vorm van die patchwachtrij. AWS en Google losten backup en snapshots buiten de VMM op, in hun eigen storagediensten. Proxmox had geen storagedienst om het in op te lossen, dus stopten ze het in QEMU — en daarom bestaan savevm-async en de PBS-block-driver als patches in plaats van als producten.
En dat is de moeite waard te weten om een praktische reden: de onderdelen van Proxmox VE die je het meest zou missen, zijn de onderdelen die niet upstream zijn. Je VM-configs zijn platte tekst en je schijfimages zijn standaardformaten, dus een machine zal verhuizen. Maar een snapshot inclusief RAM-toestand, en een incrementele keten van Proxmox Backup Server, hangen af van Proxmox’ QEMU-fork. Dat is een veel lichtere afhankelijkheid dan een proprietary hypervisor — de fork is openbaar, AGPL, en je kunt elke patch erin lezen — maar het is niet nul, en “geen lock-in op softwareniveau” hoort die voetnoot te dragen.
Dus — Is Het Enterprise-Grade?
De luie vorm van dit argument werkt niet, en het is de moeite waard dat ronduit te zeggen. “AWS gebruikt KVM, dus Proxmox VE is enterprise-grade” is een non sequitur: het neemt een claim over één laag en past die stilletjes toe op een heel product.
Hier is de versie die wél standhoudt.
Wat gedeeld wordt, is de laag die het moeilijkst goed te krijgen is en het gevaarlijkst om verkeerd te krijgen. CPU- en geheugenvirtualisatie, en de isolatiegrens tussen tenants, is het deel waar een bug een inbraak is in plaats van een storing. Die code wordt beoordeeld door engineers die betaald worden door Amazon, Google, Red Hat, Intel, AMD, IBM en Alibaba, en de bugs ervan worden gevonden door de partijen die de grootste vloten ter wereld draaien — meestal voordat de kernel jou bereikt. Als er wél een guest-escape-kwetsbaarheid landt, komt de fix via de gewone kernelupdate die je toch al zou toepassen. Je wacht niet op de releasecyclus van één vendor voor een hypervisor die alleen die vendor kan zien.
Wat niet gedeeld wordt, is alles boven de grens. Wat betekent dat de vraag samenvalt tot twee veel beter te beantwoorden vragen:
- Is de managementlaag goed genoeg voor de manier waarop je werkt?
- Kun je er support voor kopen met voorwaarden waarmee je kunt leven?
Beide kunnen worden getest in een proof of concept en vastgelegd in een contract. Geen van beide vereist geloof in een hypervisor.
Dat is een veel betere positie dan die welke de oorspronkelijke vraag aanneemt — dat je gevraagd wordt een nieuwe hypervisor van een kleine vendor te vertrouwen. Dat is niet zo. De Proxmox-specifieke code is een managementlaag grotendeels in Perl en steeds meer in Rust, plus die patchwachtrij tegen QEMU, en let op waar de patches landen: het device model en het backuppad, niet de isolatiegrens.
Het is ook de moeite waard te weten wat het uitvallen van de Proxmox-specifieke laag je kost. De QEMU-processen zijn gewone onafhankelijke processen op de host, dus pveproxy dat omvalt stopt geen enkele virtuele machine. Dat is een heel andere blast radius dan het verliezen van de component die de isolatiegrens bezit.
Wat “Dezelfde Hypervisor” Je Niet Oplevert
Hier houden vertrouwensdocumenten van vendors doorgaans op, wat je iets vertelt over voor wie ze geschreven zijn. Het is de nuttiger helft.
Het levert je AWS’ betrouwbaarheid niet op. Nitro’s beschikbaarheid heeft heel weinig met KVM te maken. Ze komt van de control plane, de netwerkfabric, de storagedienst, het capaciteitsbeheer en de operationele praktijk eromheen. De betrouwbaarheid van jouw cluster komt van je Corosync-quorumontwerp, je fencingconfiguratie, je storagekeuze en je netwerkredundantie. KVM heeft over geen van die dingen een mening. Een hypervisor delen met een hyperscaler erft hun operations niet.
Het levert je Nitro’s aanvalsoppervlak niet op, en dit is waar de legitieme helft van de type 2-beschuldiging landt.
Je draait QEMU op een general-purpose kernel, en historisch is QEMU’s device model waar de gedenkwaardige VM-escapes zaten — VENOM, in een geëmuleerde floppycontroller die niemand gebruikte, is het canonieke voorbeeld. Google kon destijds opmerken dat Compute Engine onaangetast was, juist omdat het geen QEMU draait. Jij draait het wél, dus de compenserende controles zijn de jouwe: geef de voorkeur aan virtio boven geëmuleerde hardware, presenteer geen apparaten die je niet nodig hebt, laat de AppArmor-profielen met rust, en patch QEMU met dezelfde discipline als de kernel. Proxmox’ extra/-patches zijn hen die precies dat namens jou doen, wat een redelijk ding is om te controleren of ze het nog steeds doen.
Het maakt VM-gedrag niet overdraagbaar tussen platforms.
CPU-modelselectie, machinetypeversionering, live-migratiecompatibiliteit en klokgedrag worden allemaal in lagen 3 en 4 bepaald, en ze verschillen overal. Een cluster met gemengde CPU-generaties zal je nog steeds straffen voor het instellen van het CPU-type op host, en gastklokken driften nog steeds wat het logo op het platform ook is. Dezelfde hypervisor is niet hetzelfde gedrag.
Het beantwoordt de supportvraag niet — de vraag waar inkoop daadwerkelijk om geeft, en terecht. Proxmox VE is AGPLv3 en gratis te draaien in productie. Het abonnement koopt de enterprise-geteste repository en vendorsupport, vanaf €120 per socket per jaar. Proxmox’ eigen support wordt geleverd tijdens Oostenrijkse kantooruren, dus dekking rond de klok komt van partners in plaats van uit Wenen. croit, waar ik werk, is een van die partners, en dekt 24/7, 365 dagen per jaar. Dat is een commerciële onderhandeling, geen technisch risico — en dat het een commerciële onderhandeling is, is het hele punt van alles hierboven.
Wat Je In Plaats Daarvan Zou Moeten Evalueren
Als de hypervisor vaststaat, zou een proof of concept zijn tijd moeten besteden aan de laag die echt specifiek voor Proxmox VE is:
- Fencing en HA. Trek de stroom eruit op een node met draaiende HA-gasten en klok de herstart. Doe het dan bij twee nodes en bevestig dat de overige zich gedragen zoals je verwacht wanneer het quorum verloren gaat.
- Live migratie over CPU-generaties heen. Met het CPU-model waarop je echt van plan bent te standaardiseren, niet
host. - Backup en, belangrijker, restore. Hersteltijden onder belasting, geen backuptijden. Niemand is ooit bedankt voor een snelle backup.
- Het permissiemodel. Of je een applicatieteam console- en power-controle over hun eigen VM’s kunt geven en niets anders, granulair genoeg om een auditor tevreden te stellen.
- De API. Alles wat de webinterface doet is een API-aanroep; als je automatisering die niet kan aansturen, past het platform niet bij hoe je werkt.
- Het upgradepad. Een major-versie-upgrade op het PoC-cluster, voordat je er 400 VM’s op hebt.
Geen van die zijn vragen over KVM. Dat is juist het punt.
De hypervisor is het vaststaande deel. Besteed de proof of concept aan de delen die dat niet zijn.
Referenties
KVM zelf
- KVM API-documentatie — de
/dev/kvm-ioctl-interface, het hele hypervisorcontract - Linux 2.6.20 release notes — de release waarin KVM werd samengevoegd, februari 2007
- Some KVM developments — LWN, januari 2007, over KVM in de dagen nadat het in mainline landde
Hoe de andere hypervisors zijn gebouwd
- Interpreting virtual machine monitor and executable failures — Broadcoms eigen beschrijving van een draaiende ESXi-VM als “several processes or userworlds”, met één VMM per vCPU en één VMX per VM
- The Architecture of VMware ESXi (PDF) — de whitepaper die VMkernel “a POSIX-like operating system” noemt met processen, signalen, een file system en threads. Gelinkt via een mirror omdat de originele VMware-URL de Broadcom-reorganisatie niet overleefde, wat een eigen klein commentaar op vendorcontinuïteit is
- Hyper-V architecture — Microsoft over het Virtual Machine Worker Process als user-mode component, één per VM, waar alle geëmuleerde apparaten leven
- The Nutanix Bible — AHV architecture — AHV beschreven als KVM met libvirt, QEMU en Open vSwitch
Wie KVM draait, en hoe ze het veranderden
- 7 ways we harden our KVM hypervisor at Google Cloud — Google over het draaien van KVM zonder QEMU, en de upstream-hardening die ze deden
- The AWS Nitro System — welke EC2-instancetypes de Nitro-hypervisor draaien
- AWS EC2 Virtualization 2017: Introducing Nitro — Brendan Greggs verslag van de overgang van Xen naar KVM, nog steeds het helderste relaas ervan
- Firecracker — AWS’ minimale KVM-gebaseerde VMM achter Lambda en Fargate
- Alibaba Cloud’s sixth-generation ECS instances — de X-Dragon-hypervisor en MoC-offload
- KubeVirt — het QEMU/KVM-in-een-pod-model achter OpenShift Virtualisation en Harvester
- OpenStack Nova hypervisor support matrix — KVM als de referentiedriver
Wat Proxmox onderhoudt
- De Proxmox GitHub-organisatie — 89 repositories, waaronder
pve-qemu,pve-kernel,pve-edk2-firmwareen packaging voorlxc,zfsonlinux,openvswitch,libiscsi,corosync-pveenceph pve-qemupatch series — de 78 hierboven getelde patches, en de snelste manier om precies te zien wat Proxmox aan QEMU toevoegt- Proxmox VE storagedocumentatie — de native pluginlijst, welke storagetypes gedeeld zijn, en de regel over het gebruiken van alle storagetechnologieën beschikbaar voor Debian Linux
nvme-cliennvmetcli— NVMe-oF host- en target-tooling;aoetoolsenvbladevoor het ATA over Ethernet-equivalent. Allemaal in Debian trixie, waarop Proxmox VE 9 is gebouwd- Proxmox VE-prijzen en abonnementsniveaus — wat het abonnement dekt
Disclosure: ik werk voor croit, een Proxmox Gold Partner. De technische claims hierboven zijn onderbouwd en controleerbaar; de commerciële paragraaf is het deel waar ik een belang heb, dus behandel het dienovereenkomstig.