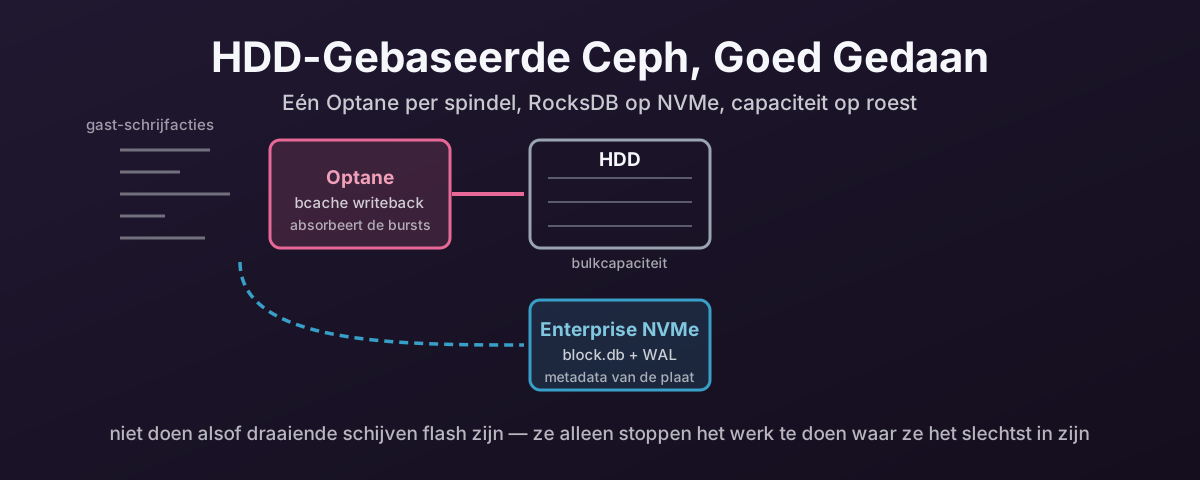
Waarom HDD’s Weer Op Het Menu Staan
Jarenlang was het advies eenvoudig genoeg om op een plakbriefje te passen: zet het allemaal op SSD’s.
Dat advies was juist, en het was ook goedkoop. Geen van beide is nu helemaal waar. NAND-aanbod is krapper geworden, AI-vraag heeft flash-prijzen omhooggeduwd, en NVMe met hoge capaciteit is moeilijk te rechtvaardigen geworden voor een kostenbewuste Proxmox-deployment — het soort dat operationeel, betrouwbaar en zo goedkoop als eerlijkheid toestaat moet zijn.
Enterprise-HDD’s zijn weer interessant om dezelfde reden als altijd: capaciteit per pond, en niets anders komt in de buurt.
De haak is dat iedereen die VM’s op draaiende schijven heeft gedraaid weet hoe slecht het kan gaan. Die ervaring is echt, en het is doorgaans de schuld van de architectuur in plaats van de schijven.
De schijven de schuld geven is makkelijker, dat wel. Het is ook fout, en het is duur, want het praat mensen flash aan die ze niet nodig hadden.
Alles hieronder gaat uit van Proxmox met hyper-converged Ceph-OSD’s, want dat is waar de indelingsbeslissingen werkelijk bijten.
Het Probleem Is Latency, Niet Doorvoer
Een moderne enterprise-HDD verplaatst grote sequentiële data prima. Dat was nooit de bottleneck.
Een 7,2k-RPM enterprise-schijf levert ergens rond de 80 tot 100 IOPS aan random werk, want elke random operatie wacht op een head-seek en een plaat-omwenteling. Dat getal is in twintig jaar nauwelijks bewogen. Het is mechanica, geen elektronica. Een instap-enterprise-SSD is er drie of vier ordes van grootte van verwijderd.
Geef dezelfde schijf sequentieel werk en het is een nuttig apparaat. Het operatietempo verdubbelt ruwweg, tot ongeveer 200 IOPS, maar elk van die operaties draagt nu een groot blok omdat de kop al op de juiste plek is en kan blijven streamen. Dus je krijgt echte doorvoer, 150 tot 250 MB/s ervan, tegen een prijs per terabyte die niets anders aanraakt.
Dat is de belangrijke asymmetrie, en het is niet “HDD’s zijn traag”. Een draaiende schijf is goed in sequentieel werk en hopeloos in random werk, en de twee getallen liggen alleen dicht bij elkaar omdat het begrensde ding het operatie-aantal is, niet de bytes.
Wat de hele ontwerpopdracht bepaalt. Je probeert de schijf niet sneller te maken. Dat kun je niet. Je probeert te regelen dat hij zijn tijd doorbrengt in de modus waar hij al competent is, en het kleine random verkeer bij hem weg te houden. Alles wat volgt is dan ook dat ene idee twee keer toegepast.
Het probleem is dat virtuele machines niet de workload genereren waar HDD’s goed in zijn. Ze genereren metadata-updates, journal-schrijfacties, kleine synchrone flushes, logging, filesystem-huishouding, en bursts van random activiteit van een dozijn gasten tegelijk die verweven bij de schijf aankomen.
Ceph voegt hier zijn eigen laag aan toe. Elke schrijfactie draagt RocksDB-metadata-updates naast de data. Als dat allemaal op kale spindels landt, brengen de schijven hun tijd door met seeken in plaats van serveren, en krijg je het symptoom dat elke beheerder herkent: hoge I/O-wait, trage gasten, inconsistente responsiviteit, en een cluster dat veel trager aanvoelt dan zijn capaciteitsblad suggereert.
Ceph’s eigen hardware-richtlijn is bot over waar dit toe leidt. Het waarschuwt om “consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB”, en zegt dat schijven boven 8 TB “may be best suited for storage of large files / objects that are not at all performance-sensitive.”
De moeite waard die rekensom te maken, want de schijven die dit überhaupt economisch maken zijn grote. 20 TB en meer. Een schijf van 20 TB doet nog steeds zijn 80 tot 100 random IOPS, want capaciteit koopt je helemaal geen operaties. Dus hij biedt ongeveer 4 tot 5 random IOPS per terabyte, waar een schijf van 8 TB er ruwweg elf haalt, en een schijf van 2 TB veertig.
Naar Ceph’s eigen maatstaf, dan, zit een spindel van 20 TB ruim in het gebied waarvan het je zegt er geen performance-gevoelige workloads op te zetten.
Dat is geen argument tegen ze kopen. Het is de reden dat de rest van deze post bestaat. Het ontwerp hieronder is precies wat een spindel van 20 TB levensvatbaar maakt voor VM-storage, door te regelen dat het kleine random werk hem nooit bereikt.
Verplaats De Metadata Van De Spindel
De hoogste-waarde-wijziging aan een HDD-gebaseerd cluster is stoppen de spindel Ceph’s boekhouding te laten opslaan.
BlueStore houdt drie dingen per OSD: de data zelf op block, de RocksDB-metadata-database op block.db, en het write-ahead log op block.wal. Standaard leven alle drie op hetzelfde apparaat. Zet block.db in plaats daarvan op NVMe en een grote hoeveelheid kleine random I/O verlaat de schijf volledig.
Ceph’s hardware-documentatie stelt het ronduit: “HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD.”
Gebruik hier goede enterprise-NVMe, geen consumentenflash. De reden is geen krantenkop-benchmarkgetallen. Het is stabiele latency onder aanhoudende belasting, en power-loss protection. Ceph’s documentatie is direct: “Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)”, en “bargain client-class or off-brand SSDs are a false economy.”
Samsung PM9A3- en Micron 7450 Pro-klasse-schijven zijn het soort ding dat hier thuishoort. Onder schrijfdruk geeft Ceph veel meer om consistentie dan om piekgetallen, en dat is precies wat een enterprise-schijf van een snelle consumentenschijf scheidt.
block.db Dimensioneren, en Wat Spillover Kost
Krijg de grootte fout en het voordeel verdampt stilletjes, want wanneer block.db vol raakt, faalt RocksDB niet — het spilt terug op het trage apparaat, precies waar het zonder de NVMe zou hebben gezeten.
Dat is het slechtste van beide werelden: je hebt de flash gekocht en je seekt nog steeds op de spindel.
De huidige Ceph-richtlijn:
| Workload | block.db als fractie van block |
|---|---|
| RBD / block — VM-schijven | 1% tot 2% |
| RGW / object | ten minste 4% |
| Algemene aanbeveling bij offloaden van WAL+DB | ten minste 2,5% |
Proxmox-VM-storage is de RBD-rij, dus 1–2% is het eerlijke planningsgetal, en 2,5% is een comfortabele plek om te zitten.
Draai dat tegen een schijf van 20 TB en de getallen krijgen je aandacht:
block.db voor één 20 TB-OSD | |
|---|---|
| Bij 1% | 200 GB |
| Bij 2% | 400 GB |
| Bij 2,5% | 500 GB |
Neem dat met de RocksDB-niveaustappen hieronder en 300 GB per OSD is de verstandige landingsplek. De nuttige stap het dichtst bij het midden van het bereik.
Wat verandert wat het gedeelde metadata-apparaat werkelijk is. Acht 20 TB-OSD’s willen 2,4 TB NVMe tussen zich; vijftien ervan, Ceph’s vermelde maximum achter één NVMe, willen 4,5 TB. Op schijven zo groot is het DB-capaciteit die beslist hoeveel OSD’s achter één apparaat zitten, niet de ratio. Je raakt door je gigabytes lang voordat je door Ceph’s zegen raakt.
Er is nog een kanttekening de moeite waard te kennen, want het maakt intuïtief dimensioneren fout. RocksDB’s niveaustructuur betekent dat een DB-partitie alleen groottes volledig kan gebruiken die overeenkomen met de sommen van zijn niveaus — historisch nuttige stappen rond 3 GB, 30 GB en 300 GB producerend, met groottes ertussen die niets over de stap eronder bieden. 18 GB omhoog afronden naar 30 GB is in de praktijk vaak gratis; het omlaag afronden naar 20 GB koopt je in het slechtste geval niets over 3 GB.
Controleer op spillover nadat het cluster een tijdje heeft gedraaid, niet op dag één. Het is een probleem met trage aanvang.
Je Hebt Geen Apart WAL-Apparaat Nodig
Deze bespaart een partitie en veel gepruts.
Als je een DB-apparaat specificeert en geen expliciet WAL-apparaat, zet Ceph de WAL automatisch op het snelle apparaat bij de DB. De documentatie stelt dat “whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device.”
Dus “zet de DB en WAL op NVMe” is het juiste doel, maar het is één argument, niet twee. Een aparte block.wal is alleen zinvol als je een derde, snellere tier hebt om het op te zetten.
Zet De HDD-Schrijfcache Uit
Klein, ongeglamoureerd, en makkelijk te missen.
Ceph’s documentatie merkt op dat OSD-prestaties “may be dramatically increased … by disabling this write cache” op HDD’s. De vluchtige cache in de schijf herordent en vertraagt schrijfacties op manieren die Ceph’s flush-semantiek tegenwerken, en hem uitzetten maakt dingen doorgaans sneller in plaats van trager.
Het wordt verplicht in plaats van aanbevolen zodra bcache betrokken is, wat de volgende sectie is.
Terwijl je er toch bent: je hebt geen RAID-capabele HBA nodig. Ceph zegt het rechtstreeks: “You do not need an RoC (RAID-capable) HBA.” Geef de OSD’s de schijven.
Eén Optane Per Spindel
De metadata van de schijf verplaatsen repareert de steady state. Het repareert geen bursts, want een burst van kleine synchrone schrijfacties moet nog steeds bevestigd worden, en de spindel bevestigt nog steeds op spindelsnelheid.
Dat is waar bcache voor is, en wat het hier laat werken is Optane.
Wat ertoe doet is geen capaciteit. Het is gedrag onder schrijfbelasting. Tegen NAND biedt Optane zeer lage latency, zeer hoge endurance, en geen van de garbage-collection-kliffen die de schrijfcacheprestaties van een SSD onvoorspelbaar maken zodra hij een tijdje in dienst is geweest. Klein, burst-achtig, schrijfzwaar verkeer absorberen is het ding waar het het beste ter wereld in is.
De indeling die ertoe doet: één Optane per HDD, elk paar zijn eigen bcache-apparaat. Niet één Optane gedeeld over een plank vol schijven.
De koppeling is een bewuste keuze, en het koopt twee dingen.
Geen contention. Elke spindel krijgt een hele Optane’s latency en queue depth voor zichzelf, in plaats van in de rij achter zeven andere OSD’s’ bursts.
Een failure domain die Ceph al weet te overleven. Een gedeelde schrijfcache houdt vuile data voor elke OSD erachter, dus hem verliezen verliest ze allemaal tegelijk; één-op-één gekoppeld kost een Optane verliezen precies één OSD. Dat onderscheid is het allerbelangrijkste gevolg van dit ontwerp, en het krijgt zijn eigen behandeling in wat je opgeeft.
Dit Moet Optane Zijn. Niet NAND.
Het woord “Optane” is hier geen merkvoorkeur of een nice-to-have. Een NAND-NVMe substitueren — hoe duur ook — bouwt iets dat verslijt, en de reden is endurance.
Kijk naar waar het cache-apparaat zit. Omdat dit ontwerp bcache’s sequentiële bypass uitzet — de sequential_cutoff=0 in de regel hieronder — passeert elke enkele schrijfactie naar die OSD erdoorheen: niet alleen de bursts, alles. Dat maakt de cache het apparaat met de hoogste duty cycle in de node, gevraagd om het schrijfvolume van een hele draaiende schijf te absorberen voor de levensduur van de machine.
Endurance wordt opgegeven in drive writes per day, en het gat is niet incrementeel:
| Apparaat | Opgegeven endurance |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| Write-intensive enterprise-NAND, top van het assortiment | rond 10 DWPD |
| Mixed-use enterprise-NAND | 3 DWPD of minder |
| Mainstream enterprise-NAND — PM9A3, 7450 Pro-klasse | rond 1 DWPD |
Optane is tussen tien en honderd keer de endurance van de NAND die je er anders zou zetten. Zet een 1 DWPD-schijf in de ene positie die elke schrijfactie in het cluster ontvangt en je hebt geen cache gebouwd, je hebt een verbruiksartikel gebouwd.
Het is erger dan de tabel suggereert, want NAND lijdt intern write amplification en Optane niet. De opgegeven DWPD van een NAND-schijf is wat hij aan de interface neemt; wat zijn cellen werkelijk absorberen is groter. Optane’s getal heeft zo’n asterisk niet nodig.
Rebuilds zijn waar dat getest wordt. Backfill duwt terabytes aan schrijfacties door de overlevende nodes in een gecomprimeerd venster, elke byte ervan over hun cache-apparaten — een endurance-gebeurtenis, niet slechts een latency-gebeurtenis, precies aankomend wanneer je het minst een tweede apparaat wilt zien falen.
Dus de twee flash-tiers willen verschillende schijven, om verschillende redenen:
| Tier | Schrijfvolume | Wat het apparaat nodig heeft |
|---|---|---|
| DB/WAL | klein — alleen RocksDB | Een snelle enterprise-NVMe. Lage latency, hoge random IOPS, PLP. Enterprise-NAND is de juiste technologie; een PM9A3 of 7450 Pro is de juiste aankoop |
| Schrijfcache | alles | PLP en endurance in de tientallen DWPD. NAND is de verkeerde technologie tegen elke prijs |
Eén soort schijf voor beide klussen kopen is de fout die deze sectie bestaat om te voorkomen — maar lees de eerste rij niet als toestemming om te bezuinigen, want laag schrijfvolume is geen lage eis.
Het DB/WAL-apparaat moet nog steeds werkelijk snelle NVMe zijn, om drie redenen die niets te maken hebben met hoeveel bytes het kruisen.
Het bedient elke OSD erachter tegelijk, dus de queue die het ziet is vier of vijftien sets metadataverkeer, niet één schijf waarde.
Zijn latency landt rechtstreeks op je clients. RocksDB-lookups zitten op het kritieke pad voor het vinden van objecten, voor peering en voor scrub, en het zijn kleine random reads. De workload waar het gat tussen een snelle NVMe en een middelmatige het grootst is. Elke microseconde wordt vermenigvuldigd met elke OSD die ervan afhangt.
En compaction is burst-achtig. RocksDB herschrijft periodiek zijn niveaus, en verandert gestage churn in een geconcentreerde spike van reads en writes. Een apparaat dat het gemiddelde aankan en op de spike stalt, stalt elke OSD erachter op hetzelfde moment.
Ceph’s eigen ratio’s zijn het teken. Het staat drie keer zoveel OSD’s achter een NVMe toe als achter een SATA-SSD, en dat is de interface en de apparaatklasse die spreekt, niet de capaciteit. Gebruik NVMe.
Dus: het cache-apparaat moet Optane zijn, het DB/WAL-apparaat mag NAND zijn, en geen van beide posities is waar je geld bespaart.
Welke Optane: Een 32 GB M10 Zou Vaak Volstaan
Niets daarvan betekent dat de grootste Optane de juiste is. Het apparaat dat je nodig hebt wordt beslist door je schrijfworkload — al blijkt de tweedehandsmarkt het misschien hoe dan ook voor je te beslissen. De rekenkunde doet er nog steeds toe, want het vertelt je wat je over- of onderkoopt.
Begin bij waar de cache voor is. Het houdt een burst, geen schijf. Bij writeback_percent=40 geeft een apparaat van 32 GB ruwweg 13 GB aan vuile buffer, wat een enorm aantal kleine synchrone schrijfacties is.
Dus laat je niet afschrikken door de ratio. Een module van 32 GB vóór een schijf van 20 TB is 0,16% ervan, wat absurd klinkt tot je je herinnert dat het een burst-absorbeerder is in plaats van een working-set-cache die hete data probeert te houden. Een apparaat van 375 GB vóór dezelfde schijf is 1,9%, wat simpelweg meer ruimte is dan je zult gebruiken.
Wat het goedkope eind van het bereik in het spel brengt. Hier is de kleine consumentenmodule tegen het datacenter-onderdeel, want het gat is niet waar mensen het verwachten:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Random read, 4K | 240.000 IOPS | 550.000 IOPS |
| Random write, 4K | 65.000 IOPS | vergelijkbaar met read |
| Sequentiële read | 1.200 MB/s | 2.400 MB/s |
| Sequentiële write | 290 MB/s | 2.000 MB/s |
| Typische latency | — | onder 10 µs |
| Endurance | 365 TBW | 12,3 PBW — 30 DWPD |
| Interface | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 of AIC |
Kijk eerst naar de schrijf-IOPS-rij. De kleine M10 doet 65.000 random writes per seconde; de spindel erachter doet 80. Zelfs de goedkoopste Optane is ruwweg 650 keer de schijf die hij cachet, dus op de prestatie-as is het argument voorbij voordat het begint. De extra IOPS van het DC-onderdeel hebben nergens heen te gaan wanneer er één 7,2k-schijf stroomafwaarts is.
De rij die de aankoop beslist is endurance, waar het gat 34× is. Omgezet in een dagelijks budget over een leven van vijf jaar:
| Apparaat | Volhoudbare schrijfacties per dag, over vijf jaar |
|---|---|
| M10 32 GB — 365 TBW | ongeveer 200 GB/dag |
| P4800X 375 GB — 12,3 PBW | ongeveer 6,7 TB/dag |
Onder 200 GB aan schrijfacties per dag en een 32 GB-M10 haalt het einde van de build. Bij twee keer zoveel krijg je tweeënhalf jaar. Echt schrijfzwaar en het DC-onderdeel verdient zijn prijs — niet voor de IOPS, die je niet kunt gebruiken, maar voor de dertig-en-nog-wat keer meer schrijven dat het tolereert.
Dus meet in plaats van te raden. nvme smart-log op een bestaand cache-apparaat geeft je data_units_written; sample het een week uit elkaar, deel, en vergelijk tegen de opgegeven TBW van wat je ook overweegt. bcache houdt zijn eigen totalen onder /sys/block/bcacheN/bcache/stats_total/ als je het daar liever leest.
Twee kanttekeningen bij de M10. Zijn random-cijfers worden opgegeven over een span van 8 GB in plaats van het volledige apparaat, dus op een cache die je van plan bent substantieel vol te draaien, behandel ze als het optimistische eind. En het is een consumentenonderdeel dat geen enterprise-PLP-claim draagt — Optane’s media wordt ter plaatse geschreven zonder DRAM-buffer in het schrijfpad, wat is waarom deze modules zich veel beter gedragen bij plotselinge stroomuitval dan consumenten-NAND zou, maar “gedraagt zich goed in de praktijk” is geen specificatie. Als je de garantie op schrift wilt, koop een DC-serie-onderdeel.
De Ondergrens Is Bandbreedte, Niet Capaciteit — Sla De 16 GB-Modules Over
Er is een tweede beperking, onafhankelijk van al het bovenstaande, en die diskwalificeert het goedkoopste onderdeel in het bereik.
De cache moet sequentieel sneller zijn dan de schijf, of het is een rem. De 16 GB-M10 is dat niet, en het is de module waardoor je het meest verleid zult worden, want hij is bijna gratis:
| Sequentiële write | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2.000 MB/s |
| Een 7,2k enterprise-HDD | 150–250 MB/s |
Lees de eerste en laatste rij samen. Een module van 16 GB schrijft sequentieel op ongeveer dezelfde snelheid als de draaiende schijf die hij zou moeten versnellen, en trager dan een goede. Hij blijft enorm veel sneller voor random werk — 35.000 random write-IOPS tegen de 80 van de schijf — maar op een sequentiële stream is hij op zijn best gelijkspel en op zijn slechtst een plafond onder wat de kale schijf onbijgestaan haalde.
En dit ontwerp garandeert dat je dat plafond raakt, want de sequentiële bypass uitzetten stuurt alles door de cache, waardoor de eigen sequentiële schrijfbandbreedte van de cache het harde plafond voor de hele OSD wordt. Recovery is waar het het hardst bijt: een 20 TB-OSD backfillen is ongeveer zo sequentieel als deze workload wordt, en het op 150 MB/s begrenzen maakt een toch al trage rebuild trager.
Dus de M10-lijn heeft een ondergrens bij 32 GB, en het is een bandbreedte-ondergrens in plaats van een capaciteits-ondergrens. De capaciteitsrekenkunde zei dat 32 GB ruim was; de bandbreedterekenkunde sluit 16 GB uit ongeacht hoe weinig je hoefde op te slaan. Beide tests moeten slagen, en het goedkope onderdeel faalt de ene die mensen niet controleren.
Wat je ook overweegt, zet zijn sequentiële schrijfcijfer naast 250 MB/s voordat je het koopt.
Een Product Kopen Dat Niemand Meer Maakt
Optane is stopgezet. Intel wond de business af in 2022, schreef 559 miljoen dollar aan voorraad af en beëindigde de ontwikkeling. Er is geen nieuwe productie en geen herbevoorrading; het totale aanbod gaat vanaf hier alleen omlaag.
Wat een voor de hand liggende vraag oproept, want er is een verrassende hoeveelheid ervan te koop. Begrijpen waar het vandaan komt vertelt je wat je koopt.
Het is OEM-service-reserveonderdelen-voorraad die geliquideerd wordt. De grote drie servermakers hadden Optane als reserveonderdelen op voorraad om de platforms te ondersteunen waar ze het in verkochten. Die platforms zijn end-of-life gegaan en van support afgevallen, dus de reserveonderdelen die ze ondersteunden werden van de ene dag op de andere dode voorraad — magazijnen vol onderdelen voor machines die niemand contractueel meer verplicht is te repareren. Die voorraad is wat op AliExpress en de refurbishers stroomt.
Twee gevolgen, en beide zijn goed nieuws.
Veel ervan is ongebruikt in plaats van getrokken. Reserveonderdelen lagen op een plank te wachten op een falen dat nooit kwam, dus het slijtagecijfer bij aankomst is vaak feitelijk nul — niet “een paar jaar lichte dienst” maar nooit geschreven. Verifieer in plaats van te vertrouwen: nvme smart-log geeft je percentage_used en data_units_written, en op echte reserveonderdelen-voorraad zouden die verbluffend laag moeten zijn. Alles dat echte slijtage toont is een pull die als iets anders wordt verkocht, al betekent zelfs dan de endurance-ruimte dat een gebruikte Optane meer leven over kan hebben dan een gloednieuwe NAND-schijf van dezelfde capaciteit.
Het verklaart welke capaciteiten je zult vinden. OEM-reserveonderdelen werden op voorraad gehouden voor servers, wat datacenter-onderdelen betekent. Hier is het volledige bereik, en merk op waar het vlaggenschip begint:
| Onderdeel | Capaciteiten | Vorm |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, consumer |
| Optane SSD 800P | 58, 118 GB | M.2 2280, consumer |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, datacenter-boot en cache-onderdeel |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm of U.2 |
| Optane SSD DC P4800X | 375 GB op zijn kleinst, 750 GB, 1,5 TB | U.2 of add-in card |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 of add-in card |
In theorie zijn de kleine M.2-onderdelen het elegante antwoord — de M10, de 800P, de P1600X en de 100 GB-P4801X doen allemaal de klus, en goedkoop. In de praktijk heeft de markt ze niet, want niemand hield desktop-accelerator-modules als server-reserveonderdelen op voorraad. Wat vermeld staat is 375 GB en meer, P4800X-klasse-hardware.
Dus reken erop meer capaciteit te kopen dan de rol nodig heeft, want dat is wat te koop is. Het is geen slechte uitkomst. Een cache-apparaat overkopen brengt je op 30 DWPD en sub-10 µs latency wanneer je workload een fractie van beide eiste, en voor een 20 TB-spindel die je jaren wilt houden, is dat de juiste manier om te dwalen. Het betekent wel dat de instapprijs hoger is dan de rekenkunde suggereert, en dat het dimensioneren hierboven een controle wordt tegen onderkopen in plaats van een boodschappenlijst.
Drie dingen om op te plannen, aangezien dit een liquidatie is in plaats van een supply chain:
Koop je reserveonderdelen met de build. Een eindige pool wordt geruimd. Wanneer een apparaat over drie jaar faalt zul je geen vervanging bestellen, je zult er een jagen — dus reken de reserveonderdelen nu in, terwijl de voorraad er is.
Verwacht OEM-firmware en controleer de namespace. Onderdelen uit het reserveonderdelenprogramma van een vendor dragen vaak die vendor’s firmware en kunnen aankomen geformatteerd naar een LBA-grootte of met metadata-instellingen die passen bij waarvoor ze ook op voorraad werden gehouden. Bevestig met nvme id-ns voordat je erop bouwt, en wees klaar om te nvme format naar een gewoon 4096-byte-formaat.
Er is geen garantie, geen support, en geen firmware-updates meer. Intels eigen support-melding dekt wat de afwikkeling betekent voor apparaten die al in dienst zijn, wat de positie is waar alles wat je koopt al in zit. Verifiëren dat het onderdeel dat aankwam het onderdeel in de vermelding is, is aan jou.
bcache Vervangt De DB/WAL-Offload Niet
De moeite waard expliciet te stellen, want het is de voor de hand liggende plek om geld te proberen te besparen en het werkt niet: je hebt nog steeds block.db op NVMe nodig. Beide lagen, niet de een of de ander.
De Optane is een schrijfcache. Dat is alles wat het is. Het verkort het bevestigingspad voor schrijfacties die naar de schijf gaan, en het doet niets anders.
RocksDB schrijft niet alleen. Ceph leest zijn metadata voortdurend — om objecten te vinden, om peering te bedienen, om scrubs te beantwoorden — en een schrijfcache biedt een read precies niets zodra de data eruit gaflusht is. De cache verwijdert het metadataverkeer ook niet; het stelt uit en batcht het, dus elke RocksDB-update komt uiteindelijk nog steeds bij de spindel aan, concurrerend om dezelfde seeks. En compaction verandert bescheiden churn in veel meer apparaatverkeer dan de schrijfacties die het veroorzaakten.
Dus de twee wijzigingen repareren verschillende problemen en geen substitueert voor de ander:
| Wat het repareert | Wat het niet | |
|---|---|---|
block.db op NVMe | metadata leeft op flash — reads en writes allebei, permanent van de spindel | niets voor een burst van gast-schrijfacties |
| Optane via bcache | burst-bevestigingslatency voor dataschrijfacties | niets voor metadata-reads; stelt alleen metadata-writes uit |
Sla de DB-offload over en houd de Optane, en RocksDB is terug op de plaat met zijn reads bediend op 80 IOPS. Sla de Optane over en houd de DB-offload, en de steady state is fatsoenlijk maar bursts stallen nog steeds op spindelsnelheid.
De udev-Regel, Regel Voor Regel
bcache’s tunables leven in sysfs, en sysfs reset ze elke keer dat het apparaat geregistreerd wordt — wat elke boot is. Dus ze horen in een udev-regel in plaats van een script dat iemand moet onthouden te draaien:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" matcht elk bcache-apparaat op de node, dus één regel dekt alle paren. ACTION=="add|change" betekent dat het opnieuw wordt toegepast wanneer een apparaat verschijnt of opnieuw wordt gekoppeld, niet alleen bij boot.
Wat elke instelling doet, en waarom:
cache_mode=writeback — het hele punt. In de standaard writethrough wordt een schrijfactie pas bevestigd wanneer die de HDD bereikt, dus de cache doet niets voor schrijflatency. In writeback bevestigt de Optane en haalt de spindel later in.
sequential_cutoff=0 — standaard detecteert bcache sequentiële I/O en routeert die zodra hij 4 MB passeert regelrecht langs de cache, op de theorie dat de backing-schijf sequentieel prima aankan. Nul schakelt die bypass uit zodat alles gecachet wordt. Op een hyper-converged node is dat de juiste keuze: wat sequentieel lijkt voor één bcache-apparaat houdt op sequentieel te zijn bij de plaat zodra meerdere OSD’s verweven raken, en je wilt elke schrijfactie ongeacht op Optane-snelheid bevestigd zien. Het draagt echter één verplichting — zonder bypass wordt de eigen sequentiële schrijfbandbreedte van het cache-apparaat het plafond voor de hele OSD, wat is waarom de 16 GB-modules gediskwalificeerd zijn.
congested_read_threshold_us=0 — bcache houdt zijn eigen cache-apparaat-latency in de gaten en begint de cache te bypassen wanneer het oordeelt dat die verstopt is, met een standaard van 2000 µs voor reads. Optane raakt niet verstopt zoals NAND doet, dus dit is bcache dat een apparaat betwijfelt dat het verkeerd heeft gemeten. Nul schakelt het volgen uit.
writeback_rate=81920 en writeback_rate_minimum=20480 — het achtergrond-flushtempo, in sectoren per seconde, dus ruwweg 40 MB/s-doel met een 10 MB/s-ondergrens. Een PD-controller beweegt het werkelijke tempo ertussen. Het doel is gezet nabij wat een spindel sequentieel kan absorberen, en de ondergrens stopt de controller ervan flush richting nul te throttelen en vuile data onbepaald te laten opstapelen. Beide zijn startpunten in plaats van constanten — hoe ze te veranderen staat hieronder.
writeback_percent=40 — hoeveel van de cache bcache vuil zal laten zitten voordat het hard terugduwt, tegen een standaard van 10. Veertig geeft je een veel diepere burst-buffer. Het betekent ook dat tot 40% van die Optane de enige kopie van data in het systeem houdt, wat de afweging is, en het is de reden dat de één-per-spindel-indeling ertoe doet. Dit is de waarde die het meest de moeite waard is te herzien zodra je een echte workload hebt bekeken.
De Vul- en Flushwaarden Later Veranderen
De 40% en de twee tempo’s hierboven zijn de waarden die hier draaien, geen universele constanten. Ze zijn het eerste dat je zult willen verplaatsen zodra je een echte workload hebt bekeken, dus het is de moeite waard te weten dat er twee plekken zijn om ze te veranderen, die twee verschillende dingen doen.
sysfs verandert het nu. De udev-regel verandert het volgende boot. Je wilt beide, en in die volgorde.
Verander het live, op één apparaat:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Of over elk paar op de node:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
Het flushtempo werkt op dezelfde manier. Beide waarden zijn in sectoren per seconde, dus deze halveren het doel en de ondergrens:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Dat treedt onmiddellijk in werking en overleeft precies tot het apparaat opnieuw geregistreerd wordt. De kerneldocumentatie is expliciet dat deze instellingen “do not persist across reboot” — wat de hele reden is dat de udev-regel bestaat.
Zodra je tevreden bent met een waarde, bewerk de regel en herlaad hem zonder te rebooten:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
Dit is waar ACTION=="add|change" zijn brood verdient. De trigger vuurt een change-event op apparaten die al aanwezig zijn, dus de regel wordt opnieuw toegepast op een draaiende node in plaats van te wachten op de volgende boot. Had de regel alleen op add gematcht, dan zou dat commando niets doen.
Lees dan de waarden terug, want een typefout in een udev-regel faalt stil:
grep . /sys/block/bcache*/bcache/writeback_percent
Weten Welke Kant Op Te Bewegen
Stel dit niet af vanuit eerste principes — bcache legt bloot wat je nodig hebt onder dezelfde sysfs-directory.
dirty_data is degene om in de gaten te houden: hoeveel data er momenteel in de cache zit en nergens anders. De docs beschrijven het als “continuously updated unlike the cache set’s version, but may be slightly off”, wat prima is voor dit doel. Sample het door een normale werkdag en een backup-venster.
cache_hits, cache_misses en cache_hit_ratio vertellen je of de cache gebruikt wordt, met de kanttekening dat “a partial hit is counted as a miss”. bypassed telt IO die de cache volledig voorbijging — met sequential_cutoff=0 zou dat bijna vlak moeten zijn, dus een groeiend getal betekent dat iets er nog steeds omheen routeert.
Al die komen als lopende totalen plus versies die vervallen over de afgelopen dag, uur en vijf minuten, wat de kort-venster-versies veel nuttiger maakt voor het opsporen van een probleem dan het levenslange cijfer.
Van daaruit:
| Symptoom | Knop | Richting |
|---|---|---|
| Bursts stallen — schrijfacties raken spindellatency midden in een burst | writeback_percent | omhoog, voor een diepere buffer |
| Meer data blootgesteld op de cache dan waar je comfortabel mee bent | writeback_percent | omlaag |
dirty_data vastgepind op het plafond tijdens gewoon werk | writeback_rate | omhoog — de buffer is niet het probleem, drainage is |
| Achtergrond-flush concurreert met gast-reads op de spindel | writeback_rate | omlaag |
dirty_data kruipt over dagen in plaats van uren omhoog | writeback_rate_minimum | omhoog, zodat de controller niet tot een kruipgang kan throttelen |
Als dirty_data vastgepind op het plafond zit wat je ook doet, is geen van beide knoppen het antwoord — het cluster schrijft sneller dan de spindels kunnen absorberen, en de eerlijke fixes zijn meer spindels of minder schrijfacties.
Eén bestand om met rust te laten: writeback_running. Het uitzetten stopt writeback volledig, en de documentatie zegt dat het “only meant for benchmarking” is. Op een productie-OSD betekent het dat vuile data zich opstapelt tot de cache vol is en nooit draineert.
Wat Je Opgeeft
De meeste beschrijvingen van dit ontwerp stoppen bij het goede nieuws. Dit zijn de delen die je werkelijk pijn zullen doen, en elk ervan is de moeite waard te kennen voordat je bouwt in plaats van erna.
Een van beide flash-apparaten verliezen vernietigt de OSD. Niet stopt hem — vernietigt hem. Beide apparaten houden toestand die nergens anders bestaat: block.db houdt de RocksDB die van block zin maakt, en een writeback-cache houdt elke schrijfactie die nog niet geflusht is. De kerneldocumentatie hedget niet over de tweede: “In writeback mode you’ll lose data if something happens to your SSD.” Hoe dan ook komt de OSD niet terug, hij wordt opnieuw aangemaakt en gebackfilld.
Dus dit zijn dezelfde klasse risico, en het is de moeite waard daar duidelijk over te zijn in plaats van de cache als de enge te behandelen. De Optane is geen gevaarlijker apparaat dan de NVMe. Twee dingen scheiden ze, en geen is ernst per OSD.
Het eerste is blast radius, en het is de hele rechtvaardiging voor de koppeling. Eén Optane per spindel betekent dat een cache-falen één OSD kost — een enkele-schijf-verlies, wat precies de gebeurtenis is die een gerepliceerde pool bestaat om te absorberen, en die Ceph afhandelt zonder dat iemand gepiept wordt. Het DB/WAL-apparaat is gedeeld, dus het verliezen kost elke OSD erachter tegelijk, wat een gecorreleerd falen is waar replicatie je niet tegen beschermt. Hetzelfde falen, één apparaat tegen vijf.
Het tweede is hoe het falen zich presenteert, en dit is een operationele val. Wanneer een cache sterft in writeback stopt het backing-apparaat en retourneert I/O-fouten, wat prima is — Ceph markeert de OSD down en gaat door. Het slechte geval is een reboot waar het backing-apparaat opkomt zonder zijn cache gekoppeld. Het ziet er dan uit als een mountbaar filesystem dat simpelweg elke vuile schrijfactie mist, wat corrupt is in plaats van slechts verouderd. Een ontbrekende block.db faalt luid en de OSD weigert te starten; een ontbrekende cache kan stil falen en je het wrak laten mounten. Behandel een bcache-backing-apparaat als onmountbaar zonder zijn cache, en laat nooit iets het behulpzaam voor je mounten.
bcache garandeert power-safe writeback niet vanzelf. Dit is waar de HDD-schrijfcache ophoudt een optimalisatie te zijn en een vereiste wordt — zet hem uit, en draai een kernel recent genoeg om de FUA-afhandeling te hebben, zodat synchrone schrijfacties door de stack heen gehonoreerd worden in plaats van ergens in het midden vroeg bevestigd. Een cache-apparaat zonder power-loss protection verergert het probleem, want het kan data verliezen die het al als veilig heeft gerapporteerd.
Wat de DB/WAL-ratio het getal maakt dat ertoe doet. Ceph staat 4–5 HDD-OSD’s per SATA-SSD toe en niet meer dan 15 per NVMe, en waarschuwt over “balancing the risk of reducing costs by placing too many responsibilities into too few failure domains.” Anders dan de cache-tier is er geen koppeling beschikbaar om deze in te perken — delen is het punt van het apparaat.
Op schijven van 20 TB is dat het hele gesprek, want de rebuild is enorm. Eén gefaalde OSD is 20 TB om te backfillen; bij de 150–250 MB/s die een spindel volhoudt, gethrottled zodat recovery de gasten niet verhongert, kijk je naar ruim een dag gedegradeerde werking voor één schijf. Verlies een gedeeld DB-apparaat dat er vijf draagt en er is 100 TB te verplaatsen.
Dus de ratio is niet echt een kostenbeslissing. Het is een beslissing over hoe lang je bereid bent gedegradeerd te draaien, en hoeveel rebuild-verkeer het cluster kan dragen terwijl het nog VM’s bedient.
Het ontwerp hangt af van een apparaat dat niemand meer maakt. Dit is degene zonder technisch antwoord. Optane is het juiste onderdeel voor de cache-positie en niets huidigs vervangt het — NAND kan het schrijfvolume niet aan, en het CXL-gebaseerde geheugen waarnaar Intel pivoteerde is geen drop-in voor een block-cache. Dus de mitigatie is commercieel in plaats van slim, het is hierboven behandeld, en de eerlijke samenvatting is dat deze architectuur een einddatum ergens in de toekomst heeft.
Niets hiervan maakt een HDD-cluster een all-flash-cluster. Aanhoudend random schrijfverkeer dat het flushtempo overtreft zal de cache vullen, en zodra hij vol is schrijf je op spindelsnelheid met extra lagen in het pad. Dit ontwerp absorbeert bursts en verwijdert metadata-overhead. Het fabriceert geen IOPS.
Waar Het Op Neerkomt
Drie tiers, elk die het ene ding doet waar hij het beste in is — en alle drie zijn vereist:
- Optane absorbeert random schrijf-bursts, één apparaat per spindel. Het moet Optane zijn, want elke schrijfactie kruist het en NAND-endurance is verkeerd voor die positie
- Een snelle enterprise-NVMe houdt RocksDB en de WAL, gedeeld over een handvol OSD’s tegen een ratio die je bewust koos in plaats van accepteerde
- HDD’s leveren bulkcapaciteit, bevrijd van zowel metadata als bursts
Het punt is niet doen alsof draaiende schijven flash zijn. Het is stoppen ze het werk te sturen waar ze het slechtst in zijn, zodat de capaciteit die je werkelijk betaalde bruikbaar is.
Dat is de hele truc, en er is niks slims aan. Zet elke klus op het apparaat dat er goed in is, en stop met twee keer betalen voor die welke dat niet zijn.
Voor een hyper-converged Proxmox-cluster dat multi-terabyte-capaciteit nodig heeft zonder all-flash-prijzen, is dat een verdedigbaar ontwerp. Goed gebouwd voelt het veel sneller dan kale HDD’s, het faalt op manieren die Ceph gebouwd is om af te handelen, en het geld gaat waar het de uitkomst verandert.
Twee gerelateerde dingen de moeite waard hiernaast te lezen: het sectorgrootte-werk in 4Kn, 512e en 512n doet veel toe voor wat de spindels doen met de schrijfacties die ze bereiken, en als je dit op direct-attached nodes bouwt, de switchloze mesh behandelt de netwerkkant van een klein Ceph-cluster.
Referenties
- Ceph — Hardware Recommendations — de IOPS-per-TB-waarschuwing op grote HDD’s, “HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD”, de 4–5 HDD per SATA-SSD- en ≤15 per NVMe-ratio’s, power-loss protection op enterprise-SSD’s, het uitzetten van de HDD-schrijfcache, en geen RoC-HBA nodig hebben
- Ceph — BlueStore Configuration Reference —
block.dbop 1–2% vanblockvoor RBD en ten minste 4% voor RGW, de 2,5% algemene aanbeveling, spillover terug op het primaire apparaat, de RocksDB-niveaugroottes achter de 3/30/300 GB-stappen, en de WAL die impliciet met de DB gecoloceerd wordt - Linux-kernel — bcache admin guide — de cache-modi,
sequential_cutoffen zijn 4 MB-standaard, de 2000 µs read-congestie-standaard,writeback_ratein sectoren per seconde, dewriteback_percent-PD-controller, dedirty_data/cache_hit_ratio/bypassed-tellers en hun vervallende dag-, uur- en vijf-minuten-versies, de waarschuwing datwriteback_running“only meant for benchmarking” is, de uitspraak dat deze instellingen “do not persist across reboot”, en “in writeback mode you’ll lose data if something happens to your SSD” - Intel — Optane Memory M10 32 GB specificaties — 365 TBW, 240.000 random read en 65.000 random write IOPS bij 4K over een span van 8 GB, 1200/290 MB/s sequentieel, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specificaties — de 150 MB/s sequentiële write en 35.000 random write IOPS die dit onderdeel onder een draaiende schijf plaatsen op sequentiële doorvoer
- PC Perspective — Optane SSD DC P4800X performance — de 550K random 4K read IOPS van het 375 GB-onderdeel, 2400/2000 MB/s sequentieel, sub-10 µs typische latency, en 12,3 PBW bij 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — de kleine-capaciteit datacenter-M.2-onderdelen, voor de capaciteitsladder
- StorageReview — Intel Optane SSD P5800X — de 100 DWPD-rating, de 30 DWPD van de P4800X, en de vergelijking tegen NAND-enterprise-schijven die rond 10 DWPD uitkomen voor write-intensive onderdelen en 3 of minder voor mixed-use
- Bcache — ArchWiki — de praktische faalmodi, inclusief een backing-apparaat dat na een reboot zonder zijn cache opkomt, en de power-safety-vereisten rond de HDD-schrijfcache en FUA
- Intel — Optane business update — de afwikkeling, en wat het betekent voor garantie en support op apparaten die al in dienst zijn, wat de positie is waar alles wat je op de recycler-markt koopt al in zit