Drie Manieren Waarop Een Schijf Zich Kan Presenteren
Een schijf heeft twee blokgroottes, en het verschil ertussen is het hele verhaal.
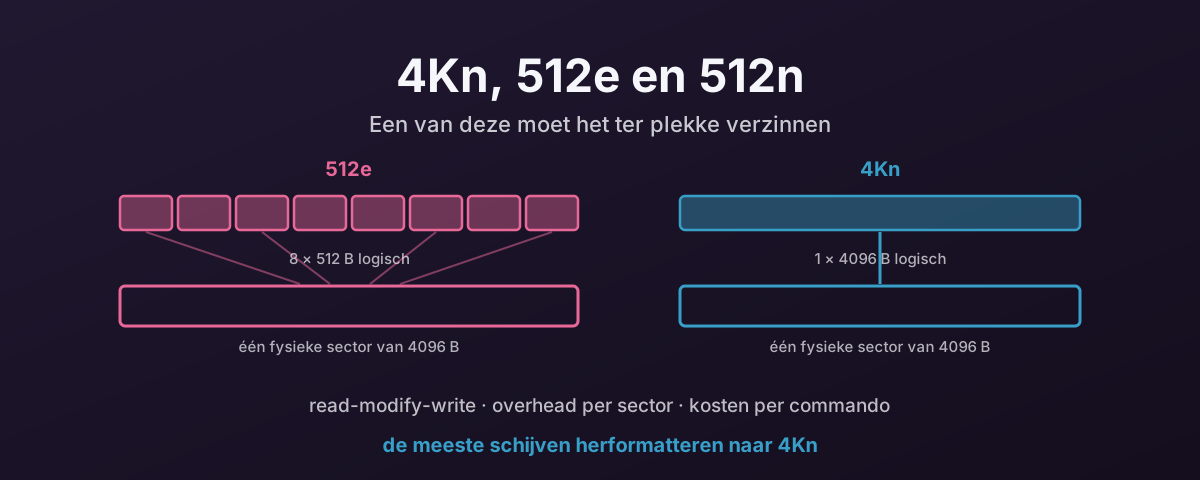
De fysieke sector is waar het medium werkelijk in werkt — de kleinste eenheid die de schijf kan lezen of schrijven zonder extra werk te doen. Het logische blok is wat de schijf de host vertelt dat hij in werkt — de eenheid die de host adresseert.
Er zijn drie combinaties in het wild.
512n — native 512. Beide groottes zijn 512 bytes. Dit is de oude wereld: harde schijven van voor 2010, en niks wat je vandaag nieuw zou kopen op enige omvang die de moeite waard is.
512e — 512-byte-emulatie. De fysieke sector is 4096 bytes, maar de schijf rapporteert logische blokken van 512 byte en vertaalt in firmware. Dit bestaat om één reden: compatibiliteit met besturingssystemen, bootloaders en applicaties die voor altijd 512 aannamen. Verstandig genoeg als engineering, en de wortel van bijna alle ellende die volgt.
4Kn — native 4K. Beide groottes zijn 4096 bytes. De schijf vertelt de waarheid, de host adresseert hem in de eenheid die het medium gebruikt, en er zit geen vertaallaag tussenin.
Wat 512e Doet Bij Elke Niet-Uitgelijnde Schrijfactie
Een leesactie is in alle drie de gevallen goedkoop. De schijf leest de 4K-sector en geeft welke 512-byte-plak je ook vroeg terug.
Schrijfacties zijn waar de fictie duur wordt.
Als de host één logisch blok van 512 byte schrijft, kan de schijf geen 512 bytes schrijven. Het medium heeft zo’n eenheid niet. Dus doet hij dit in plaats daarvan:
- Lees de hele fysieke sector van 4096 byte.
- Voeg de 512 bytes nieuwe data erin samen.
- Schrijf de hele sector van 4096 byte terug.
Dat is een read-modify-write, en het verandert één kleine schrijfactie in een lees plus een schrijf. Op een draaiende schijf betekent dat wachten tot de plaat weer langskomt. Een volledige omwenteling bij 7.200rpm is zoiets als 8ms waarop je niet had gerekend. Op flash is de kostenpost van andere aard, en die verdwijnt niet wanneer de schrijfactie klaar is. Die heeft zijn eigen sectie hieronder.
Misalignment is de versie hiervan die het hardst bijt. Als een partitie op een oneven 512-byte-offset begint — de klassieker is de oude 63-sector-conventie — dan overschrijdt elke 4K-filesystem-schrijfactie twee fysieke sectoren. Dat is niet één read-modify-write, het zijn er twee, bij elke enkele schrijfactie, voor altijd, totdat iemand de schijf herpartitioneert.
Write Amplification Op Flash
Op een harde schijf kost de read-modify-write je een omwenteling en dan is het voorbij. Op flash kost het je schijflevensduur, en dat is een rekening die je één keer betaalt en blijft betalen.
Write amplification is de verhouding van wat er werkelijk naar de NAND is geschreven tegen wat de host vroeg te schrijven. Een verhouding van 1,0 zou betekenen dat de schijf precies schreef wat hem werd gegeven. Het is nooit 1,0, want flash kan niet ter plaatse overschrijven: de schijf programmeert een verse pagina, markeert de oude als verouderd, en garbage collection verplaatst later de overlevende pagina’s zodat een heel blok gewist kan worden. Die verplaatsingen zijn ook schrijfacties.
512e voegt daar een vermijdbare laag bovenop, en de reden is een detail dat de moeite waard is helder te stellen: de vertaallaag van de schijf mapt in eenheden van ongeveer 4 KB ongeacht welke logische blokgrootte hij adverteert. Een schijf die blokken van 512 byte rapporteert, houdt intern nog steeds eenheden van 4 KB bij.
Dus een schrijfactie van 512 byte van de host wordt, binnen de schijf: lees de mapping-eenheid van 4 KB, voeg de 512 bytes erin samen, programmeer een nieuwe eenheid van 4 KB. 4096 bytes bereiken de NAND zodat 512 bytes konden veranderen. Acht keer de schrijfactie, voor die schrijfactie.
Misalignment is minder dramatisch per schrijfactie en erger in totaal. Een schrijfactie van 4 KB die twee mapping-eenheden overschrijdt, vervuilt ze allebei, dus wordt 8 KB geprogrammeerd voor 4 KB data. Dat is 2× amplification bij elke enkele schrijfactie, permanent, totdat de partitietabel is gerepareerd.
De vervolgeffecten zijn wat dit ertoe doet in plaats van slechts rommelig te zijn:
- Meer NAND-schrijfacties betekent dat garbage collection vaker draait, en zijn verplaatsingen zijn zelf amplification.
- Een SLC-schrijfcache raakt eerder vol, dus de schijf zakt eerder terug naar zijn tragere steady state en de aanhoudende schrijfdoorvoer daalt.
- Program/erase-cycli worden verbruikt in verhouding tot wat de NAND bereikte, niet tot wat de host verstuurde. Verdubbel de amplification en je hebt de levensduur van de schijf gehalveerd voor dezelfde workload.
- Endurance-ratings — TBW, DWPD — worden opgegeven tegen host-schrijfacties. Amplification vreet die marge stilletjes op, en de schijf slijt vóór de garantierekensom die je maakte toen je hem kocht.
Directe en Synchrone Schrijfacties Zijn Het Slechtste Geval
Meestal verbergt de page cache dit allemaal. De kernel verzamelt kleine schrijfacties, voegt ze samen, en geeft 4 KB of grotere IO aan de schijf, zodat de read-modify-write nooit gebeurt.
Twee flags verwijderen die bescherming, en applicaties die om duurzaamheid geven zetten beide.
O_DIRECT omzeilt de page cache.
Er zit nu niets tussen de applicatie en de schijf om een schrijfactie van 512 byte samen te voegen tot iets van sectorformaat.
O_SYNC of O_DSYNC vereist dat de schrijfactie op stabiel medium staat voordat de aanroep terugkeert.
Dat stopt de schijf ervan de schrijfactie in een vluchtige buffer op te nemen en die later met zijn buren te combineren.
Zet ze samen en elke schrijfactie van 512 byte is een complete read-modify-write-cyclus die nu moet voltooien, op zichzelf, met niets om ertegen te amortiseren. Dat is waar amplification op een 512e-schijf zijn theoretische 8× benadert, en het is precies het patroon dat een database-commit-log, een ZFS-ZIL of een Ceph-BlueStore-WAL produceert.
Power-loss protection is wat dit redt op enterprise-hardware. Een schijf met PLP kan een synchrone schrijfactie bevestigen zodra die in een condensator-ondersteunde DRAM-buffer staat, wat duurzaam is, en toch intern samenvoegen voordat er NAND wordt geprogrammeerd. Een consumentenschijf zonder PLP moet de flash bereiken voordat hij mag antwoorden, dus betaalt hij de volle prijs per schrijfactie. Nog een reden dat PLP niet optioneel is voor dit soort workload.
In Proxmox bepaalt de cache-modus welke van deze je krijgt:
cache=noneisO_DIRECT— de PVE-standaard, en de juiste keuze voor all-flash-HA. De host-page-cache is uit het pad, dus gast-schrijfpatronen bereiken de schijf zoals de gast ze uitgaf.cache=directsyncisO_DIRECTplusO_DSYNC— elke schrijfactie synchroon. Het is een niche-instelling voor toegewijde database-log-schijven en onbruikbaar voor algemene workloads.
Op een 512e-backing-device is cache=directsync met een gast die in records van 512 byte commit ongeveer de minst efficiënte beschikbare regeling: geen host-samenvoeging, geen schijf-samenvoeging, en een read-modify-write per commit.
En hier is het deel dat 4Kn structureel maakt in plaats van slechts te prefereren.
O_DIRECT vereist dat de offset, lengte en buffer uitgelijnd zijn op de logische blokgrootte van de schijf.
Op een 512e-schijf is dat 512 bytes, dus een directe schrijfactie van 512 byte is legaal en de schijf betaalt er stilletjes voor.
Op 4Kn is het logische blok 4096, dus de kleinste directe schrijfactie die de kernel accepteert is 4 KB.
Het pathologische patroon houdt op iets te zijn dat je moet vermijden en wordt iets dat de stack niet kan uitdrukken.
Overhead Op Het Medium
De tweede kostenpost is structureel, en het is de reden dat Advanced Format überhaupt bestaat.
Een sector is niet alleen zijn data. Op een harde schijf draagt elke sector een sync mark zodat de kop weet waar de sector begint, een gap zodat opeenvolgende sectoren niet in elkaar lopen, een address marker, en een ECC-veld om leesfouten te corrigeren.
Met sectoren van 512 byte betaal je dat allemaal acht keer voor elke 4K data. Met één 4K-sector betaal je het één keer.
Dat heeft twee gevolgen, en het tweede doet er meer toe dan het eerste:
- Een deel van de plaat dat overhead was, wordt bruikbare capaciteit. Dit was de vermelde motivatie van de industrie tijdens de Advanced Format-overgang, in de lage enkelcijferige percentages.
- Het ECC-veld kan veel groter zijn voor dezelfde totale overhead. Eén sterke code die 4096 bytes beschermt corrigeert veel meer dan acht zwakke codes die elk 512 bytes beschermen. Toen de areale dichtheid steeg, hield dat op een fijnigheid te zijn en werd het de enige manier om foutpercentages acceptabel te houden.
Flash heeft geen sync marks of rotatie-gaps, maar dezelfde logica geldt een niveau hoger: NAND wordt geprogrammeerd in pagina’s, pagina’s zijn veel groter dan 512 bytes, en de mapping-tabellen van de schijf hebben een entry per adresseerbare eenheid. Kleinere logische blokken betekent meer metadata om dezelfde capaciteit bij te houden.
Overhead In De Host: Commando’s en Interrupts
De derde kostenpost is degene die mensen missen, want die zit helemaal niet op de schijf.
De logische blokgrootte zet de ondergrens op hoe klein een IO kan zijn. Op een 512-byte logische schijf is een filesystem of een applicatie vrij een schrijfactie van 512 byte uit te geven, en elk daarvan is een complete IO: een commando gebouwd en ingediend, een doorbell-write, een completion-queue-entry, en een interrupt om te zeggen dat het klaar is.
Elk daarvan heeft een vaste kostenpost die er niet om geeft hoeveel data erbij betrokken was. Verplaats 4KB als acht commando’s van 512 byte en je betaalt die kostenpost acht keer. Verplaats het als één 4K-commando en je betaalt het één keer.
Twee eerlijke kanttekeningen, want dit is waar het argument doorgaans wordt overdreven.
Voor grote IO verandert de logische blokgrootte niets aan het commandoaantal. Eén commando kan veel blokken beschrijven, dus een sequentiële schrijfactie van 1MB is één commando of de blokken nu 512 bytes of 4K zijn. De besparing is alleen echt waar er kleine IO wordt uitgegeven.
Waar kleine IO wel wordt uitgegeven is het effect echter niet subtiel: elk van die acht aanvragen is er een die de kernel moet bouwen, plannen en voltooien, elk met zijn eigen MSI-X-interrupt en user-naar-kernel-overgang, en bij hoge queue depths is dat hoe je een interrupt-storm krijgt. Binnen een VM is het opnieuw erger, want elk van die interrupts is ook een gast-context-switch.
En moderne NVMe-controllers voegen interrupts samen, dus het interrupt-aantal is niet simpelweg het commandoaantal. Het submission- en completion-werk per commando blijft echter, en bij een paar honderdduizend IOPS is de CPU-kostenpost per commando een meetbare fractie van een core. Dit is dezelfde rekenkunde als posted interrupts in de passthrough-serie — kleine vaste kosten vermenigvuldigd met een zeer groot getal.
4Kn, Sector-Metadata en Hardware-RAID
Overgaan naar een 4096 + 0-formaat heeft een gevolg dat mensen verrast, en het landt vierkant op hardware-RAID.
Sommige RAID-controllers en storage-arrays gebruiken helemaal geen gewone sectoren van 512 of 4096 byte. Ze formatteren schijven naar een uitgebreide grootte — 520 of 528 bytes, of de 4K-equivalenten zoals 4104, 4160 en 4224 — omdat die extra bytes per sector zijn waar de controller zijn eigen metadata bewaart. Dat is T10-PI/DIF protection information, of vendor-integriteitsdata, opgeslagen inline met precies de data die het beschrijft.
Een 4096 + 0-formaat heeft nergens om het te plaatsen. De sector is data, van begin tot eind, en dat is het hele punt van het kiezen ervan.
Dus een controller die inline metadata wil, heeft drie opties, en geen ervan is gratis:
- Weiger de schijf.
- Herformatteer hem terug naar een uitgebreid formaat, en maak het 4Kn-werk dat je net deed ongedaan.
- Bewaar zijn metadata ergens anders op de schijf.
De derde is waar flash je straft. Metadata die apart van de data die het beschrijft wordt geschreven, is een tweede schrijfactie, op een andere offset, die in een andere mapping-eenheid landt. Nog een NAND-pagina geprogrammeerd voor elke die je werkelijk bedoelde te schrijven. Dat is de amplification uit de sectie hierboven, opzettelijk opnieuw geïntroduceerd, om integriteitsmetadata te dragen die de schijf gratis inline had kunnen houden als je hem in een uitgebreid formaat had gelaten.
Je kunt niet beide hebben. Ofwel draagt de sector de metadata van de controller, of hij draagt alleen jouw data.
En Daarom Heeft Flash De Zaak Voor Hardware-RAID Nogal Ondermijnd
De rest hiervan is oordeel in plaats van mechanisme, dus neem het als zodanig.
Een hardware-RAID-controller is firmware-RAID die op een toegewijde processor draait. De “hardware” is een CPU, wat DRAM en een batterij. Geen fundamenteel andere manier om pariteit te berekenen. Wat het je historisch opleverde was een batterij-ondersteunde schrijfcache en pariteit-offload, en op flash zijn beide argumenten flink verzwakt. Enterprise-NVMe heeft al een eigen power-loss-protected cache, en de controller wordt een bandbreedteplafond vóór apparaten die elk meerdere gigabytes per seconde kunnen verzadigen.
Het kost je ook dingen die je nu actief wilt:
- Apparaattoestand verdwijnt. SMART-detail, slijtage-indicatoren en de vendor-logs waarmee je write amplification kunt berekenen zitten allemaal achter een ondoorzichtige abstractie.
- Geen end-to-end checksums. Een controller verifieert pariteit, wat een ontbrekende schijf detecteert, niet een verkeerd antwoord van een aanwezige. ZFS en Ceph checksummen de data zelf en kunnen je vertellen welke kopie fout is — stille corruptie die een controller regelrecht doorlaat. De controller lost dan ook het verkeerde probleem op.
- Vendor-metadata op de schijven bindt de array aan een controllerfamilie, wat een eigen soort onbetrouwbaarheid is wanneer de controller is wat faalt.
- Pariteit-RAID doet zijn eigen read-modify-write bij partial-stripe-writes, gestapeld bovenop alles in de secties hierboven.
Voor Ceph is dit niet eens een voorkeur. Proxmox’ eigen hyper-converged-richtlijn is dat schijven gepresenteerd moeten worden in HBA- of pass-through-modus, niet achter een RAID-controller, en ZFS wil precies hetzelfde om dezelfde redenen.
Dus de regeling die uit dit alles volgt is: een HBA in plaats van een RAID-controller, schijven geformatteerd 4Kn met nul metadata, en redundantie plus checksums gedaan door ZFS of Ceph, die je werkelijk kunnen vertellen wanneer een schijf loog. Als iets in je landschap werkelijk een uitgebreid sectorformaat nodig heeft, is dat een bewuste of/of die je moet beslechten terwijl de schijven nog leeg zijn. Niet iets om te ontdekken nadat de OSD’s zijn gebouwd.
Waar 512e Werkelijk Bijt
Het zou oneerlijk zijn te beweren dat 512e een modern systeem ruïneert, want meestal doet het dat niet.
Een huidige Linux-stack leest de fysieke sectorgrootte, lijnt partities eraan uit — parted en sfdisk doen dit nu allebei standaard — en gebruikt 4K-filesystem-blokken.
In die configuratie geeft de host 4K-uitgelijnde 4K-IO uit, heeft de schijf nooit een read-modify-write nodig, en kost 512e je bijna niks.
De problemen zijn specifiek:
- Niet-uitgelijnde partities, doorgaans geërfd van een oude installatie of een gekloond image. Twee read-modify-writes bij elke schrijfactie.
- ZFS met
ashift=9op een 512e-schijf, omdat ZFS de gerapporteerde 512 geloofde. Elke record-schrijfactie wordt een read-modify-write, en je kuntashiftachteraf niet veranderen — de pool moet herbouwd worden. - Applicaties die records van 512 byte schrijven met O_DIRECT, waarbij ze de samenvoeging van de page cache omzeilen. Sommige databases en veel maatwerksoftware doen dit.
- Alles wat erop vertrouwt dat de logische grootte de echte is. Dat is de werkelijke schade in de emulatie: het deelt een getal uit dat fout is, en dingen stroomafwaarts nemen er beslissingen mee.
4Kn verwijdert de hele categorie. De schijf kan niet liegen over een sectorgrootte die hij niet heeft.
Het is echter de moeite waard eerlijk te zijn over de omvang van de prijs. Seagate’s eigen richtlijn is dat 4Kn duidelijk de moeite van het najagen waard is wanneer de stack volledig geoptimaliseerd is voor 4K en je elke IOPS telt — een afgestemde all-flash-tier, zeg. Daaronder, op een correct uitgelijnd modern Linux, is het prestatieverschil voor uitgelijnde IO vaak klein. Het andere argument is vlootconsistentie: een uniform 4Kn-landschap heeft er geen gemengd-formaat-verrassingen in, en niemand hoeft te onthouden welke schijven liegen.
De Meeste Schijven Kunnen Omgezet Worden — Als De Vendor Het Toestaat
Dit is het deel dat gemist wordt: 512e is vaak een format-instelling, geen eigenschap van de hardware. Heel veel enterprise-SAS- en SATA-schijven, en de meeste enterprise-NVMe, worden geleverd met een rapportage van 512 bytes en herformatteren graag naar 4Kn.
Alle volgende vernietigen elke byte op het apparaat. Er is geen in-place conversie.
NVMe — nvme-cli
Kijk eerst naar wat de namespace ondersteunt:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Je wilt een formaat met Data Size 4096 en Metadata Size 0, gemarkeerd als best en niet momenteel in gebruik. Pas het dan toe:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
De metadata-grootte doet er evenveel toe als de data-grootte. Sommige fabrieksformaten reserveren extra bytes per sector — 520, of 4160 — om end-to-end T10-PI/DIF protectiemetadata te dragen. Als niets in je stack dat verbruikt, is het opvulling op elke sector, dus kies het zero-metadata-formaat en wees ervan af. Per ongeluk een metadata-dragend formaat kiezen levert je ook een schijf op die zich anders gedraagt dan degene die je bedoelde te maken, en het combineren van een sectorgroottewijziging met een PI-wijziging kan een trage volledige format afdwingen in plaats van een snelle.
Voor een hele hosts waarde aan schijven: loop het. Dit heeft shopt -s extglob nodig voor de extended globs, en het selecteert alleen formaten die 4096/0 zijn en niet in gebruik:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Twee dingen daarin doen meer werk dan ze lijken.
De glob matcht namespaces — nvme0n1, nvme12n3 — en matcht opzettelijk geen partities zoals nvme0n1p1, want het patroon eindigt na de cijfers die op de n volgen. Dat is het verschil tussen het herformatteren van een namespace en het doen van iets onherstelbaars aan een draaiend systeem.
En de selectie zet alleen ooit een schijf om die werkelijk aanbiedt wat je vroeg. Al het andere valt door naar -1 en wordt overgeslagen, wat drie aparte gevallen dekt:
- De schijf biedt alleen 512. Er bestaat geen 4096-byte-formaat, dus er is niets om naar om te zetten en de loop laat hem met rust. Hij probeert het niet, en hij faalt niet halverwege.
- De schijf is al 4Kn. Het 4096/0-formaat is degene in gebruik, en
(?!.*in use)sluit het uit — dus een tweede run over dezelfde host is een no-op. Geen onnodige herformattering van elke schijf. - De enige 4096-formaten dragen metadata. Een 4096 + 8-formaat voldoet niet aan
Metadata Size: 0, dus de loop zal je niet stilletjes een T10-PI-schijf overhandigen waar je niet om vroeg.
Met andere woorden, het faalt gesloten. Wanneer het onzeker is, slaat het over.
Eén portability-opmerking: die lookaheads hebben GNU grep’s -P (PCRE) modus nodig. Op een systeem waar grep iets anders is, matcht het patroon niets en wordt elke schijf overgeslagen. Vervelend, maar het dwaalt tenminste in de veilige richting.
Lees de loop toch voordat je hem draait.
Waar hij wel matcht, herformatteert hij zonder verdere vraag. nvme format --force vraagt niet twee keer.
Het hoort in provisioning, op een machine waarvan de schijven niets bevatten, nooit op een host met een live OSD, pool of VM-schijf.
Op FreeBSD is het equivalent nvmecontrol, waar -f de format-index is:
nvmecontrol format -f 1 nvme0ns1
SAS en SATA — openSeaChest
Seagate’s openSeaChest is cross-platform, open source, en werkt ook op schijven van andere vendors.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Die bevestigingszin is niet mij die dramatisch doe. Het is de letterlijke string die het gereedschap vereist, en het deel “may render the drive inoperable” is echt. Een low-level format die door een stroomuitval wordt onderbroken, kan een schijf achterlaten die nog een format nodig heeft voordat hij überhaupt werkt.
Eronder verschilt de operatie per transport: SAS en SCSI gebruiken Format Unit, SATA gebruikt Set Sector Configuration Ext — het fast-format-pad — en NVMe gebruikt NVM Format. Voor een SAS-schijf kun je Format Unit rechtstreeks aansturen, en merk op dat deze optie de kortere bevestigingsstring neemt:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Twee verschillende opties, twee verschillende bevestigingsstrings — verwissel ze en het gereedschap weigert.
Waar de schijf een fast format ondersteunt, verandert de sectorgrootte in seconden in plaats van uren; de schijf doet daarna zijn integriteits- en achtergrondwerk, en je echte data erop schrijven verkort die achtergrondtijd. Een volledige format schrijft nullen van begin tot eind en kan vele uren tot dagen duren op een grote draaiende schijf.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI — sg_format
Voor alles wat SCSI spreekt, doet sg3_utils dezelfde klus:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format geeft je een aftelling van 15 seconden voordat het zich vastlegt, die --quick overslaat.
De documentatie waarschuwt ook voor een specifieke fout die de moeite waard is te kennen: als de blokgroottewijziging slaagt maar de format daarna faalt, kan de schijf in een “format corrupt”-toestand belanden en nog een format nodig hebben om te herstellen.
Voordat Je Iets Omzet
- Controleer het boot-pad. Een 4Kn-schijf als boot-apparaat heeft UEFI nodig en een OS dat het ondersteunt. Modern Linux is prima. Ouder Windows niet, en sommige hardware-RAID-controllers weigeren 4Kn nog helemaal.
- Doe het voordat de schijf iets bevat. Retrofitten betekent evacueren, omzetten, herstellen.
- Doe er één, controleer dan. Zet één schijf om, bevestig de gerapporteerde groottes, doe dan de rest.
- Verwacht uren op een draaiende schijf zonder fast format. Begin geen low-level format op een machine die je snel terug nodig hebt.
Controleren Wat Je Hebt
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical is een 512e-schijf.
Overeenkomende getallen betekenen native — 512n als beide 512 zijn, 4Kn als beide 4096 zijn.
En controleer dat de partities werkelijk uitlijnen:
parted /dev/sda align-check optimal 1
ZFS, Ceph en Virtuele Schijven
ZFS — zet ashift=12 expliciet bij het aanmaken van een pool, en vertrouw niet op de gerapporteerde grootte van de schijf, want op 512e vertelt hij je 9 en heeft hij ongelijk. Het kan later niet veranderd worden.
Ceph — BlueStore’s minimale allocatiegrootte zou 4 KB op flash moeten zijn. Modern Ceph staat standaard op 4096, maar oudere builds stonden standaard hoger — rond 16 KB op SSD en 64 KB op HDD — en dat past slecht bij RBD-VM-schijven, want die geven veel kleine random 4 KB-schrijfacties uit en een 4 KB-schrijfactie die in een allocatie-eenheid van 16 of 64 KB landt, amplificeert zowel de schrijfactie als verspilt de rest aan opvulling. Het wordt vastgelegd wanneer de OSD wordt aangemaakt, dus het moet gezet worden voor het aanmaken of herbouwen:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Er is een bijpassende bluestore_min_alloc_size_hdd. Bestaande OSD’s houden waarmee ze ook gebouwd zijn, dus het veranderen betekent ze herbouwen.
Virtuele schijven — een gast ziet wat de hypervisor ook presenteert, niet de onderliggende schijf, dus een 4Kn-schijf onder een VM overhandigt de gast nog steeds blokken van 512 byte tenzij je anders zegt. De stack 4K van begin tot eind houden betekent QEMU vertellen 4K te presenteren, wat in Proxmox een raw-argumentregel in /etc/pve/qemu-server/<vmid>.conf is:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Die regel is wat QEMU werkelijk in 4Kn dwingt voor die schijven — -global past het toe op elk scsi-hd-apparaat op de VM, dus de gast krijgt 4096 te horen voor zowel logische als fysieke blokgrootte en partitioneert en lijnt dienovereenkomstig uit.
Quote de hele string niet. Proxmox parseert args: met Text::ParseWords::shellwords, dus dit:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
klapt samen tot een enkel argument — de aanhalingstekens worden gehonoreerd en verwijderd, en QEMU krijgt één lange onparseerbare optie overhandigd in plaats van vier. Zonder quotes splitst dezelfde regel in -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, wat is wat je wilt. Het is een makkelijke fout om te maken, want quoten is het juiste instinct op een commandoregel, en de fout — een VM die niet start en klaagt over de optie — wijst niet terug naar de quotes.
Doe dit voordat je het gast-OS installeert. De blokgrootte van een schijf veranderen onder een al geïnstalleerd systeem kan het onbootbaar maken, want de partitie-indeling en bootloader werden voor sectoren van 512 byte geschreven. Merk ook op dat args: een expert-noodluik is buiten het beheer van de GUI, en de interactie met live migratie en snapshots is de moeite waard om opnieuw te controleren tegen de huidige Proxmox-documentatie.
Als De Gast 512 Zegt en De Host 4K
Dit is het geval dat de moeite waard is goed te begrijpen, want het is wat je standaard krijgt na al het werk hierboven te hebben gedaan.
QEMU presenteert logische blokken van 512 byte aan de gast tenzij anders verteld, wat het backing-device ook is. Dus je kunt elke schijf in de host omzetten naar 4Kn, en de VM’s erbovenop krijgen nog steeds 512 te horen — en ze zullen het geloven.
De gast partitioneert dan op 512-byte-grenzen omdat het mag, en geeft 512-byte-IO uit omdat het mag. Maar het host-apparaat heeft nu werkelijk een logisch blok van 4096 byte, en het accepteert geen schrijfactie van 512 byte. Iets moet de twee verzoenen, en dat iets is de host: QEMU leest de omringende 4 KB, voegt de 512 bytes van de gast erin samen, en schrijft het geheel terug.
Je hebt de emulatie niet verwijderd. Je hebt hem van de firmware van de schijf af verplaatst naar je hypervisor, waar hij host-CPU en een bounce buffer kost in plaats van schijfcycli.
Met cache=none is dit ook geen zachte straf. O_DIRECT tegen een 4Kn-apparaat vereist 4 KB-uitgelijnde offsets en lengtes, dus een sub-4K-gast-schrijfactie kan niet simpelweg doorgegeven worden — de uitlijning moet in QEMU gecorrigeerd worden voordat de IO überhaupt wordt uitgegeven.
En het misalignment-geval komt een laag hoger terug. Een gast die op 512-byte-granulariteit is gepartitioneerd, zet zijn 4 KB-filesystem-schrijfacties op offsets die twee host-4 KB-blokken overschrijden, dus elke wordt twee read-modify-writes op de host. Dezelfde fout als een niet-uitgelijnde partitie op een kale 512e-schijf, behalve dat het nu binnen een VM gebeurt waar niemand ernaar zoekt.
Dus de regel is: als de host 4Kn is, presenteer dan ook 4K aan de gast, en doe het voordat het OS erop gaat.
De uitzondering is gastondersteuning, wat de hele reden is dat 512e bestaat:
- Linux-gasten handelen 4Kn zonder gedoe af.
- Windows ondersteunt 4Kn voor datavolumes vanaf Windows 8 en Server 2012, en booten vanaf 4Kn wil UEFI.
- Alles ouder — Windows 7 en terug — kan helemaal geen 4Kn. Voor die is een 512-presenterende virtuele schijf de prijs van het draaien ervan, en de host doet het verzoenen. Als dat ertoe doet, houd die gasten dan op storage waar het je het minst kost in plaats van op je snelste tier.
Controleer wat de gast werkelijk kreeg, van binnen de gast:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 daar op een 4Kn-host betekent dat de verzoening hierboven bij elke niet-uitgelijnde schrijfactie plaatsvindt.
Referenties
- OpenZFS — Workload Tuning —
ashift, waarom2^ashiftde kleinst mogelijke IO op een vdev is, en de observatie dat “many devices misreport their sector sizes” nvme-formatman page —--lbaf,--namespace-id,--sesen--forcesg_formatman page —--sizemet--format, de fast-format-optie, en de format-corrupt-waarschuwing- openSeaChest — Seagate’s open-source schijfgereedschappen, waaronder
--setSectorSizeen--showSupportedFormats - openSeaChest wiki — Format, Fast Format, And Sector Sizes — welk transport welk commando gebruikt, en wanneer fast format van toepassing is
nvmecontrol(8)— het FreeBSD-equivalent- Linux block layer documentatie — hoe de kernel logische en fysieke blokgroottes modelleert