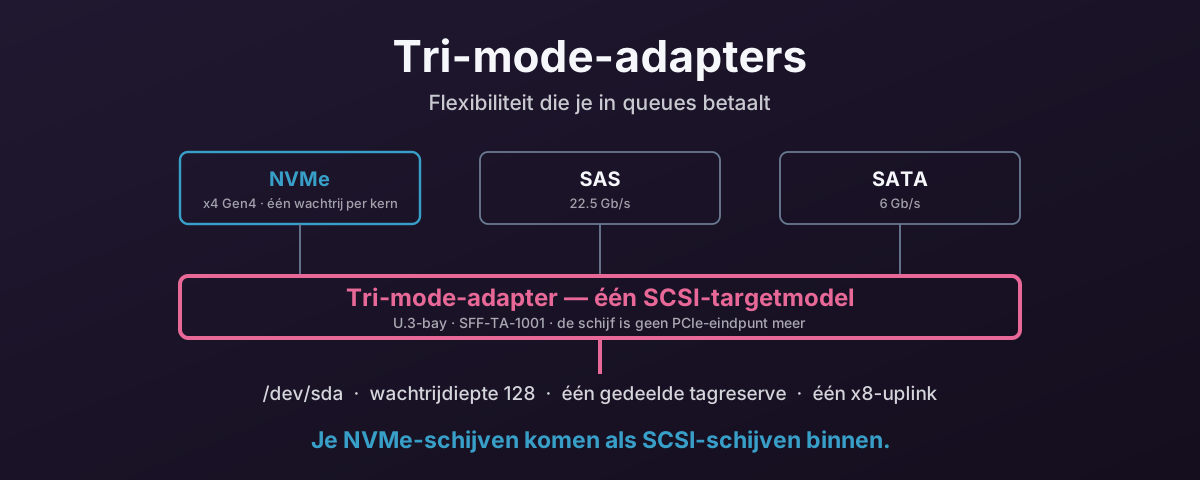
De bay die alles aanneemt
Het verkooppraatje voor een tri-mode-adapter is echt goed, en het is de moeite dat netjes te vertellen voordat we het uit elkaar halen.
Koop een kast met een U.3-backplane en een tri-mode-controller, en elke schijfbay wordt universeel. Slot 0 kan een 24G SAS-schijf bevatten, slot 1 een goedkoop SATA-opstartapparaat, slot 2 een Gen4 NVMe-SSD, en de adapter onderhandelt met wat er ook opduikt. Broadcom noemt het silicium Tri-Mode SerDes; de baystandaard is SFF-TA-1001, bekend als U.3, die een gemeenschappelijke connector definieert voor SAS x1/x2, SATA en NVMe op x1, x2 of x4. De beheerkant is SFF-TA-1005, Universal Backplane Management, en zo zoekt de behuizing uit waar hij eigenlijk mee praat en bedient hij de juiste activiteitslampjes.
Voor wie servers specificeert lost dat een echt en irritant probleem op. Je hoeft het opslagprotocol niet meer op het moment van de inkooporder te bepalen, of twee kast-SKU’s aan te houden, of te ontdekken dat de NVMe-geschikte bays de vier links zijn en jouw schijven in de andere twintig zijn gegaan. Eén artikelnummer dekt de vloot, en een SAS-omgeving kan schijf voor schijf naar NVMe in plaats van kast voor kast.
Niets daarvan is marketing. Het is de reden dat deze adapters verkopen, en het zou dwaas zijn te doen alsof dat niet zo is.
Maar de flexibiliteit is niet gratis, en de rekening wordt niet in ponden betaald. Hij wordt in queues betaald.
Wat er echt met de schijf gebeurt
Een NVMe-SSD is een PCIe-eindpunt. In een server met directe aansluiting lopen zijn vier lanes naar het root complex van de CPU — via een retimer of een PCIe-switch, maar elektrisch en logisch is het een apparaat op de PCIe-bus. De kernel inventariseert hem, bindt de nvme-driver, en vanaf dat punt praat de driver direct met de registers van de schijf.
Zet dezelfde schijf achter een tri-mode-adapter en dat is niet meer waar.
De lanes van de schijf eindigen nu bij de controller. De documentatie van Broadcom noemt het betreffende blok de PCIe device bridge, en dat woord bridge doet veel werk: dit is geen doorzichtige switch die de transacties van je CPU doorstuurt naar een schijf die hij nog kan zien. De adapter is het PCIe-eindpunt dat je host inventariseert. De schijf is een target dat aan de overkant hangt, en de firmware van de controller zet elke I/O opnieuw op.
De adapter geeft je NVMe-commando’s dus niet door. Hij beëindigt ze, en praat namens jou met de schijf.
Wat de vraag opwerpt welk protocol hij tegen jou spreekt.
Het besturingssysteem ziet nooit een NVMe-schijf
Hij spreekt SCSI.
Prik een NVMe-SSD in een tri-mode-HBA van Broadcom en hij komt niet als /dev/nvme0n1 naar boven. Hij komt als /dev/sdb, gebonden aan mpt3sas — dezelfde driver die al ruim tien jaar LSI SAS-controllers bedient. nvme list geeft niets terug. lsblk -o NAME,TRAN meldt het transport als sas. Voor zover elke laag van de opslagstack boven de driver het kan zien, heb je een SAS-schijf gekocht.
Dit is geen fout of een firmwarebeperking die op een oplossing wacht. Het is het ontwerp. Alles als SCSI-target presenteren is precies hoe één adapter drie protocollen bedient: de controller maakt SAS, SATA en NVMe gelijk tot één apparaatmodel, en de host krijgt één driver, één inventarisatiepad, één set gereedschap. De flexibiliteit in de marketing en de SCSI-presentatie in dmesg zijn dezelfde architectuurkeuze, van twee kanten bekeken.
De generaties 9500 en 9600 voegen wel een doorgeefmechanisme toe zodat gereedschap van de leverancier bij de NVMe-beheercommando’s van een schijf kan, en de nieuwere onderdelen van Broadcom zijn veel beter in het naar boven brengen van de gezondheid van een schijf dan de 9400 was. Maar dat is een zijkanaal voor beheer. Het datapad — elke read en write die je workload uitgeeft — loopt nog steeds door de SCSI-stack.
En de SCSI-stack heeft een wachtrijmodel dat flash twintig jaar voorafgaat.
Het wachtrijmodel dat je net hebt opgegeven
Dit is het deel dat je echt prestaties kost, en het is de moeite er precies over te zijn, want “NVMe is sneller dan SAS” is niet de reden.
De centrale ontwerpkeuze van NVMe was niet een snellere draad. Het was ophouden te doen alsof een opslagapparaat één geserialiseerd ding is.
De specificatie staat tot 65.535 paren I/O-wachtrijen toe, en dat getal wordt in elke NVMe-uitleg aangehaald. Het is het verkeerde getal om naar te grijpen. Geen schijf komt in de buurt van die uitvoering, dus wie ooit echt naar een draaiend systeem heeft gekeken kan de vergelijking wegwuiven — en daar zou hij gelijk in hebben. Het echte getal is kleiner, ongelamoureus, en maakt het punt beter.
Dus hier is een echte schijf. Geen enterprise-onderdeel: een SK Hynix OEM-SSD van 256 GB, het soort dat in een middenklaslaptop wordt gesoldeerd, in een machine met 16 kernen.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Zeventien wachtrijen: één beheerwachtrij, en zestien I/O-wachtrijen voor zestien kernen. Elk 1023 commando’s diep. De koppeling is één op één — elke hardwarewachtrij is aan precies één CPU gebonden:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Eén CPU per wachtrij, de hele weg omlaag — hardwarewachtrij 0 bedient kern 1 en niets anders.
Dat is wat “NVMe heeft veel wachtrijen” in de praktijk betekent. Niet 65.535 — één per kern, hoeveel kernen je ook hebt. Linux maakt een paar wachtrijen per CPU aan tot wat de controller toestaat, en controllers staan veel meer toe dan een gewone server kernen heeft, dus in de praktijk is het kernaantal het getal. Zet deze schijf in een bak met 64 kernen en je krijgt 64.
Die splitsing per kern is waar de prestaties vandaan komen:
- Een kern biedt aan in zijn eigen wachtrij. Geen lock, want geen andere kern raakt hem aan.
- Elke wachtrij krijgt zijn eigen MSI-X-vector, aan die kern gebonden.
- De afrondingsinterrupt landt terug op de kern die de I/O uitgaf, waar de betreffende cacheregels al staan.
- Alle zestien kernen kunnen tegelijk onderweg zijn zonder ooit op een gedeelde structuur te botsen.
Parallellisme schaalt met je kernaantal, en het werk van geen enkele kern staat ooit in de rij achter dat van een andere. Een goedkope consumentenschijf doet dit. Het is de laagste lat.
Kijk nu naar wat de schijf achter de adapter krijgt. De getallen hieronder zijn geen schattingen — het zijn constanten in de mainline-driver mpt3sas.
De wachtrijdiepte per apparaat komt uit ioc->max_nvme_qd, dat de driver overneemt van wat de controllerfirmware meldt en anders terugvalt op een standaard uit de compileertijd in drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Een apparaat dat tienduizenden uitstaande commando’s aankan, krijgt een wachtrijdiepte van 128 — en merk op dat die ondieper is dan de SAS-standaard van 254 twee regels erboven. De eigen mogelijkheden van de schijf komen nooit in de beslissing voor. Het getal komt van de controller.
Het aantal hardwarewachtrijen is erger, en de driver is er openhartig over. Uit mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Lees dat zorgvuldig, want er gebeuren drie afzonderlijke dingen.
De standaard is één hardwarewachtrij. nr_hw_queues = 1. Meerdere wachtrijen gebeuren alleen op gen35-controllers met de functie host_tagset aan, en zelfs dan is het wat de commitgeschiedenis van de driver zelf gesimuleerde meervoudige hardwarewachtrijen noemt — de I/O-controllerhardware is één aanbiedwachtrij met meerdere antwoordwachtrijen, en blk-mq wordt daarover heen gelegd.
Het aantal wachtrijen komt van de controller, niet van het kernaantal. Het is reply_queue_count minus de high-IOPS-wachtrijen — de MSI-X-vectortoewijzing van de adapter. Het heeft niets te maken met hoeveel CPU’s je hebt, en het groeit niet als je schijven toevoegt. Dit is de exacte omkering van de schijf hierboven, waar het aantal wachtrijen het kernaantal was.
En de tagreserve is gedeeld. host_tagset betekent precies wat het zegt: één tagreserve voor de hele hostadapter, en die logregel zegt “shared” hardop. Elke schijf op de kaart trekt uit dezelfde set commandoplekken. Een kast met vierentwintig bays heeft vierentwintig schijven die om de tags van één controller vechten.
Zet die twee naast elkaar. Die laptop-SSD had zestien eigen wachtrijen van 1023, één per kern, die alleen zichzelf antwoordden. Dezelfde schijf achter de adapter krijgt een deel van de antwoordwachtrijen van de kaart, 128 uitstaande commando’s, en drieëntwintig buren die uit dezelfde reserve trekken.
Het verlies is dus niet dat SCSI langzaam is. Modern SCSI op blk-mq is prima. Het verlies is structureel:
- Wachtrijen zijn van de adapter, niet van de schijf. Schijven toevoegen verdeelt een vaste hoeveelheid in plaats van eraan toe te voegen.
- De tagreserve is over de hele host gedeeld. Eén schijf onder zware last kan de andere uithongeren op een manier die simpelweg niet kan gebeuren als elke schijf zijn eigen wachtrijen heeft.
- De diepte per apparaat is begrensd op 128, wat de schijf ook kan volhouden.
- De plaatselijkheid van interrupts wordt zwakker. Afrondingen komen aan op de antwoordwachtrij die de controller gebruikte, niet noodzakelijk op de kern die aanbood.
Bij een wachtrijdiepte van 1 of 2 — één proces met af en toe een read — registreert niets hiervan. Je meet in beide gevallen dezelfde latency, binnen de ruis. De straf duikt precies op waar je NVMe voor kocht: veel kernen die veel gelijktijdige I/O’s uitgeven. Hoe dieper de workload, hoe meer van de schijf je hebt betaald en niet kunt bereiken.
De uplink is één x8-slot
Het wachtrijmodel is het subtiele probleem. Het bandbreedteplafond is het voor de hand liggende, en je kunt het van Broadcoms eigen productbladen aflezen zonder een benchmark nodig te hebben.
De HBA uit de 9500-serie is een x8 PCIe Gen 4.0-kaart. De gepubliceerde cijfers van Broadcom ervoor zijn 13.700 MB/s bij 256K sequentieel lezen en 3M IOPS bij 4K random lezen. Hetzelfde blad zegt dat hij tot 32 NVMe-apparaten ondersteunt.
Zet die twee getallen naast elkaar en de vraag antwoordt zichzelf: hoeveel schijven kost het om de adapter op te maken?
Niet veel, en elk jaar minder. Een Gen4 x4-SSD doet ruwweg 7 GB/s. Een Gen5 x4-SSD doet ruwweg 14. Beide zijn in 2026 gewone onderdelen — Gen4 is waar de tweedehandsmarkt voor U.2 vol van zit, en Gen5 is wat je nieuw koopt.
| Plafond | Gen4-schijven om het te halen | Gen5-schijven om het te halen |
|---|---|---|
| HBA 9500 — 13.700 MB/s sequentieel | 2 | 1 |
| HBA 9500 — 3M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600 — 6,4M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600 — 1,1M RAID 5-IOPS (4K RW) | ~1 | ~1 |
Lees de bovenste regel nog eens. Eén Gen5-SSD haalt het hele sequentiële plafond van een HBA 9500. Eén schijf, in een kaart die voor tweeëndertig is bedoeld. Alles daarna is capaciteit. Niet prestaties.
En de onderste regel is degene die een inkooporder zou moeten stoppen: op de MegaRAID van de huidige generatie levert een volle plank NVMe in RAID 5 ruwweg wat één gewone schijf op zichzelf doet.
De schijven linken niet eens op x4
Er zit een tweede knijper onder de gedeelde uplink, makkelijk te missen omdat hij in een specificatietabel staat en niet in een kop.
Dells PERC 12 User’s Guide, over de H965i tri-mode-controllers, zegt:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Elke NVMe-schijf krijgt twee lanes, niet vier. Dus vóór enige strijd om de uplink, vóór de tagreserve, vóór de SCSI-vertaling, zit een Gen4-schijf al terug op ongeveer 3,5 GB/s — de helft van wat hij kan. Zet een Gen5-schijf in die bay en hij onderhandelt terug naar Gen4 x2 en levert ruwweg een kwart van zijn opgegeven bandbreedte.
Het is de moeite precies te zijn over wat dit wel en niet verandert. Het betekent niet dat de adapter verder komt. Het kost ongeveer vier op x2 begrensde schijven om de uplink van de 9500 te vullen in plaats van twee, maar alleen omdat elke schijf half zoveel bijdraagt. Het knelpunt is van de uplink naar de schijflink verhuisd. Het totaal dat je eruit kunt halen is niet beter geworden.
Met directe aansluiting zouden diezelfde tweeëndertig schijven elk hun eigen x4-pad naar het root complex hebben, op welke generatie de schijf en de CPU ook kunnen onderhandelen.
De RAID 5-regel in die tabel verdient een eigen blik, want het is Broadcoms eigen getal en het is zonder opsmuk gepubliceerd. Uit het blad van de 9600-serie:
900K to 1.1M RAID 5 IOPS (4K RW)
Pariteits-RAID in controllerfirmware is het duurste dat je een tri-mode-kaart kunt vragen, en dit is de huidige generatie die het doet. Het waard te lezen voordat iemand RAID 5 over vierentwintig NVMe-schijven specificeert en de prestaties van vierentwintig schijven verwacht.
En een x16-kaart dan?
Het voor de hand liggende bezwaar tegen al het bovenstaande is dat de 9500 een x8 Gen4-kaart is, en dat het plafond een gevolg is van een smalle hostlink. Geef de adapter zestien lanes Gen5 en het probleem verdwijnt.
Het is een eerlijk bezwaar, en het verdient het sterkste voorbeeld in plaats van een stroman. Neem dus Dells PERC13 H975i — de huidige generatie, en ongeveer zo goed als tri-mode wordt. De gebruikershandleiding specificeert “Gen 4 and Gen 5 PCIe x16 host interfaces”, en StorageReview mat 52,5 GB/s en 12,5M IOPS per controller, tegen tot zestien NVMe-schijven.
Dat zijn serieuze getallen, en ze veranderen het beeld aanzienlijk. Tegen de 13.700 MB/s en 3M IOPS van de 9500 is dat ruwweg vier keer de bandbreedte en vier keer de IOPS, verspreid over half zoveel schijven. Dell heeft niet alleen de pijp verbreed — ze hebben ook de uitwaaiering gehalveerd, en de overboekingsverhouding is daardoor verbeterd. Op IOPS in het bijzonder: 12,5M over zestien schijven is ongeveer 780K per schijf, en dat komt in de buurt van wat een gewone schijf op zichzelf levert. Op dat punt is de controller echt niet meer wat je tegenhoudt.
Eer waar eer toekomt dus: een moderne x16 Gen5 tri-mode-kaart is een veel beter stuk techniek dan een x8 Gen4, en als bandbreedte je enige bezwaar was, antwoordt x16 dat grotendeels.
Drie dingen die het niet oplost.
De schijven linken nog steeds op x2. Deze verraste mij. De handleiding van de PERC13, over een Gen5 x16-controller, zegt nog steeds:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Een bredere hostlink verbreedt de schijflinks stroomafwaarts niet. Elke NVMe-schijf op de nieuwste, snelste tri-mode-RAID-controller die Dell verkoopt is nog steeds met twee lanes aangesloten in plaats van vier, en geeft nog steeds de helft van zijn bandbreedte op voordat er iets anders gebeurt.
Het wachtrijmodel blijft volledig onaangeroerd. Niets in de wachtrijsectie van dit bericht hangt af van de breedte van de hostlink. nr_hw_queues komt uit de MSI-X-antwoordwachtrijtoewijzing van de controller; de diepte van 128 per apparaat is een constante in driver en firmware; de tagreserve is over de hele host gedeeld omdat host_tagset dat zegt. Verbreed de hostlink naar x16, x32, wat je wilt — de schijven zijn nog steeds SCSI-targets die de wachtrijen van de kaart delen, er is nog steeds geen /dev/nvme0n1, en je kunt nog steeds geen schijf aan een VM doorgeven.
En x16 maakt geen bandbreedte — het waaiert lanes uit die je al had. Dit is het argument dat het echt beslecht. Zestien Gen5-lanes in een PERC13 kopen je 52,5 GB/s, gedeeld over zestien bays. Diezelfde zestien lanes rechtstreeks naar vier Gen5-schijven op x4 kopen je ruwweg 56 GB/s over vier bays — dezelfde bandbreedte uit dezelfde lanes, behalve dat elke schijf zijn volledige x4 krijgt, zijn eigen paar wachtrijen per kern, en een echte nvme-apparaatnode.
De eerlijke manier om een x16 tri-mode-kaart te beschrijven is dus niet “een snellere adapter”. Het is een lane-multiplexer: hij zet een vast lanebudget om in meer schijfbays, en rekent je het wachtrijmodel voor de omzetting. Of die deal goed is hangt van één ding af. Bays of parallellisme.
Wat er gebeurt als je alle bays vult
En dat brengt ons bij het geval dat echt uitmaakt, want niemand koopt een kast met 24 bays om er vier schijven in te zetten.
Voorbij het verzadigingspunt is de totaallijn vlak. Schijven toevoegen voegt capaciteit toe, en niets anders — dus de prestaties per schijf vallen als 1/N. Die rekenkunde is onverbiddelijk bij realistische aantallen:
| Schijven op een HBA 9500 | Totaal | Per schijf | Deel van een Gen4-schijf |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98% |
| 12 | 13,7 GB/s | 1,14 GB/s | 16% |
| 24 | 13,7 GB/s | 0,57 GB/s | 8% |
Kijk naar de onderste regel. Vierentwintig NVMe-schijven achter een HBA 9500 leveren elk ongeveer 570 MB/s. Een SATA-SSD doet rond de 550. Je hebt vierentwintig NVMe-schijven gekocht, betaald voor een tri-mode-controller om ze aan te sluiten, en bent op bandbreedte per schijf van SATA-klasse uitgekomen.
De IOPS-rekenkunde heeft dezelfde vorm: 3M verspreid over vierentwintig schijven is 125K elk, tegen de 1M die een gewone Gen4-schijf alleen haalt — ongeveer een achtste van wat je bezit.
De x16-kaart verbetert dit flink maar ontsnapt er niet aan. Een PERC13 op zijn volle zestien schijven is 52,5 GB/s ÷ 16 = 3,3 GB/s per schijf, of ruwweg 23% van een Gen5-schijf — en dat is voordat de x2-link het opnieuw halveert.
Twee effecten bij hoge schijfaantallen zijn erger dan de deling suggereert:
- Taguithongering gaat over apparaten heen. De gedeelde tagreserve van de host betekent dat één schijf onder zware last plekken kan opeten die andere schijven nodig hebben. Vierentwintig apparaten die elk nominaal 128 uitstaande commando’s mogen, willen er samen 3.072, getrokken uit de
can_queuevan één controller. Head-of-line-blocking tussen aparte schijven is een faalvorm die simpelweg niet bestaat als elke schijf zijn eigen wachtrijen bezit. - Herbouwen raakt alles. Een pariteitsherbouw over een gevulde plank verzadigt die ene gedeelde uplink, dus de voorgrond-I/O naar elke andere schijf op de kaart wordt op hetzelfde moment slechter. Met schijven op onafhankelijke lanes en software-RAID vecht de herbouw om CPU, niet om één pijp.
Wanneer niets hiervan uitmaakt
Er is een belangrijk tegenwicht, en het is de reden dat genoeg tri-mode-servers met 24 bays volstrekt tevreden draaien.
Het plafond van de adapter bijt alleen als iets stroomafwaarts meer kan verbruiken dan hij levert. Een server met 2 × 25GbE heeft 6,2 GB/s netwerk — hij kan zelfs een HBA 9500 niet vullen. Zijn die vierentwintig schijven een capaciteitslaag die bestanden over die link aanbiedt, dan is de adapter nergens in de buurt van het knelpunt en is de rekenkunde per schijf hierboven irrelevant.
Het moment dat het begint uit te maken is wanneer de verbruiker sneller wordt dan de kaart: 100GbE (12,5 GB/s) zet je op eigen kracht al gelijk met het hele sequentiële plafond van een 9500, en lokale workloads — databases, compileren, analyse, virtualisatiehosts met drukke gasten — hebben helemaal geen netwerk in het pad.
De vraag bij een gevulde plank is dus niet “is de adapter langzaam” maar “wat gaat dit verbruiken, en kan het meer verbruiken dan de kaart kan leveren?” Is het antwoord een 25GbE-link, stop dan met je zorgen maken. Is het antwoord 100GbE, NVMe-oF of een lokale database, dan is de kaart je knelpunt en maakt het aantal schijven het erger.
Wat er verder verdwijnt
Naast doorvoer betekent een NVMe-schijf als SCSI-schijf presenteren dat de NVMe-specifieke onderdelen van je gereedschapskist ophouden te werken:
| Direct aangesloten | Achter een tri-mode-adapter | |
|---|---|---|
| Apparaatnode | /dev/nvme0n1 | /dev/sdb |
| Driver | nvme | mpt3sas / mpi3mr |
nvme-cli | Werkt | Niets om mee te praten |
| Gezondheidsdata | NVMe SMART-logpagina’s | Vertaalde SCSI-logpagina’s |
| Namespacebeheer | Ja | Nee |
| Firmware-updates | nvme fw-download | Gereedschap van de leverancier via de controller |
| Format / sanitize | NVMe Format NVM | SCSI-equivalenten, als ze zijn uitgevoerd |
| Hardwarewachtrijen | Eén paar per kern (16 op de machine hierboven) | De antwoordwachtrijen van de kaart, gedeeld door elke schijf |
| Wachtrijdiepte | 1023 per wachtrij | 128 per apparaat |
Eén gevolg verrast mensen vaak genoeg om apart te benoemen: je kunt geen individuele schijf aan een virtuele machine doorgeven. PCIe-passthrough heeft nodig dat de schijf een PCIe-eindpunt met zijn eigen IOMMU-groep is, en achter een tri-mode-adapter is hij dat niet — het enige aanwezige PCIe-apparaat is de controller. Je kunt de hele adapter doorgeven, met elke schijf die eraan hangt, of niets. Was je plan bepaalde NVMe-schijven aan bepaalde gasten te geven, dan heeft de keuze van de backplane dat al voor je beslist.
Wie wil dit dan in 2026?
Hier moet het verkooppraatje aan het begin van dit bericht een moeilijkere vraag onder ogen zien, want de wereld waarvoor het is ontworpen is grotendeels verdwenen.
Tri-mode is bedacht toen NVMe de dure laag was die je aan een SAS-omgeving toevoegde. In 2026 is dat omgekeerd: NVMe is de standaard, U.2-enterpriseschijven zijn overvloedig en goedkoop op de tweedehandsmarkt, en “gemengd SAS, SATA en NVMe in één kast” beschrijft steeds minder echte uitrollen. Wie koopt het dus?
Vooral niemand — met opzet. Het eerlijke antwoord is dat de meeste tri-mode-controllers niet zijn gekozen. Ze kwamen mee, omdat de serverleverancier er een levert, en de leverancier levert er een omdat één U.3-backplane-SKU hem laat verkopen in configuraties met SAS, SATA en NVMe uit dezelfde kast. Dat is winst in de toeleveringsketen voor de OEM. Het doet niets voor jouw prestaties, en het is dan ook nooit als zodanig verkocht.
Drie van de klassieke rechtvaardigingen houden geen stand meer:
“Ik heb gemengde schijftypen nodig.” Zelden in dezelfde kast, en zelfs als dat zo is, is tri-mode niet de enige manier. Een gewone SAS-HBA voor de draaiende schijven plus NVMe aan het root complex geeft je beide, zonder dat er een van benadeeld wordt. Een gemengde omgeving houdt geen gemengde controller in.
“Ik heb niet genoeg PCIe-lanes.” Dat was in 2019 het echte argument, op platforms met 40 lanes en 24 bays. Een Genoa- of Turin-Epyc met één socket heeft 128 lanes. Vierentwintig schijven op x4 is 96. De schaarste die het aggregeren van schijven achter één controller rechtvaardigde is bijna weg, en waar dat niet zo is, doet een PCIe-switch het werk zonder het protocol te beëindigen.
“De bays moeten universeel zijn.” Deze is het waard zorgvuldig apart te zetten, want het is het argument dat het vaakst wordt gebruikt om het verkeerde onderdeel te rechtvaardigen. U.3 is een backplanestandaard, geen eis aan de controller. Een U.3-backplane kan rechtstreeks aan de PCIe-lanes van de CPU worden gedraad in plaats van via een tri-mode-controller, en leveranciers documenteren beide topologieën. Je kunt de universele bays houden en de belasting weghalen. Heb je een tri-mode-server geërfd, dan is het waardevolste dat je kunt nakijken of de backplane direct kan worden omgedraad.
Wat er echt overblijft:
- Hardware-RAID op dichtheid, waar beleid of platform het vereist — een auditvereiste, een ondersteuningsmatrix, een uitrol op Windows of ESXi zonder softwarelaag om het werk te doen. Dit is de echte resterende markt, het is het ene geval waarin je de RAID-motor koopt en niet de aansluiting, en op het huidige silicium is het een capabel product: zestien NVMe-schijven in hardware-RAID 5 met een cache die door een supercap is beschermd, uit zestien lanes, is iets wat directe aansluiting helemaal niet kan bieden.
- Bulkcapaciteit op SAS-HDD’s, waar £/TB nog beslissend bij draaiende schijven hoort. Maar dat is het werk van een gewone SAS-HBA, en een goedkopere.
- Zeer grote aantallen bays en externe behuizingen, waar SAS-expanders verder en breder reiken dan PCIe zal doen.
- Workloads die nooit diep gaan. Zitten je wachtrijdiepten in de enkele cijfers, dan registreert niets hiervan. Genoeg echte systemen wonen hier volstrekt tevreden.
Er is ook een gewoon bedrijfsmatig argument — één soort behuizing, één driver, één reserve op de plank — en voor een virtualisatiehost voor algemeen gebruik is dat echt iets waard. Prijs het alleen eerlijk af tegen het feit dat, volgens de tabel hierboven, één Gen5-schijf het hele sequentiële plafond van de kaart kan halen.
Wanneer het het verkeerde gereedschap is
De ruil wordt slecht in verhouding tot hoeveel gelijktijdigheid je workload heeft.
Ceph is het duidelijkste geval. Een opslagnode draait één OSD per schijf, elk met eigen threadpools, die allemaal tegelijk I/O uitgeven — en dan drijft een heel cluster aan clients ze gelijktijdig aan. Dat is het slechtste geval voor de gedeelde tagreserve: vierentwintig daemons die om de commandoplekken van één controller vechten, elke schijf begrensd op 128 uitstaande, alles door één x8-uplink getrechterd. Zet die schijven direct op het root complex en elke OSD krijgt zijn eigen wachtrijen, eigen tags en eigen lanes. Een Ceph-node met alleen NVMe hoort geen tri-mode-adapter in het datapad te hebben.
Dezelfde logica geldt voor NVMe-oF-targets, waar je schijven opnieuw exporteert en elke laag serialisatie op elkaar stapelt; voor databases met diepe asynchrone I/O; en voor alles dat op io_uring of SPDK is gebouwd, en die bestaan juist om de wachtrijen per kern te benutten die de adapter net heeft weggenomen.
De algemene regel: hoe meer parallellisme je software is geschreven te benutten, hoe meer een tri-mode-adapter je daarvoor rekent.
Hoe je nakijkt wat je hebt
Heb je een server geërfd en wil je weten aan welke kant hiervan je zit:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Die laatste print de regel Max SCSIIO MPT commands: N shared with nr_hw_queues = M die eerder is aangehaald. Is nvme list leeg op een machine waarvan je is verteld dat hij volledig NVMe-flash is, dan is de adapter de reden.
De korte versie
Een tri-mode-adapter zet je NVMe-schijven om in SCSI-schijven. Die omzetting is geen bijwerking. Het is hoe één kaart drie protocollen bedient, en het is wat je koopt.
Wat je opgeeft is specifiek en meetbaar: paren wachtrijen per kern vervangen door de gedeelde antwoordwachtrijen van een controller, een diepte van 128 per apparaat, een tagreserve verdeeld over elke schijf op de kaart, een x2-link waar de schijf x4 wilde, en één gedeelde uplink waar elke schijf eerder zijn eigen pad naar het root complex had. De adapter houdt op een verbinding te zijn en wordt het knelpunt, en op de huidige hardware wordt hij dat snel: twee Gen4-schijven halen een HBA 9500, vier Gen5-schijven halen zelfs een PERC13.
Een bredere hostlink helpt wel — een x16 Gen5-kaart heeft ruwweg vier keer de bandbreedte en IOPS van een x8 Gen4 — maar hij verandert de vorm niet. Hij koopt bays, geen parallellisme: diezelfde zestien lanes rechtstreeks naar vier schijven leveren dezelfde bandbreedte zonder enige wachtrijbelasting. En hij redt een volle plank niet. Vierentwintig schijven achter een 9500 krijgen elk ongeveer 570 MB/s, en dat is wat een SATA-SSD doet.
In 2019, toen NVMe de laag was die je aan een SAS-omgeving toevoegde en platforms lanes tekortkwamen, was dat een redelijke ruil. In 2026 is het dat meestal niet. NVMe is de standaard, tweedehands U.2-schijven zijn goedkoop, een Epyc met één socket heeft lanes over, en het ene voordeel dat nog staat — universele schijfbays — is van de U.3-backplane, niet van de controller. Je kunt heel vaak de bays houden en de belasting weghalen door de backplane rechtstreeks aan de CPU te draden.
Koop dus een tri-mode-adapter als je zijn RAID-motor koopt en die nodig hebt. Koop hem niet voor de flexibiliteit, en heb je er een geërfd in een kast vol NVMe, ga dan uitzoeken hoe die backplane is gedraad.
Het heeft geen zin twee keer te betalen voor schijven die je dan niet goed kunt gebruiken.