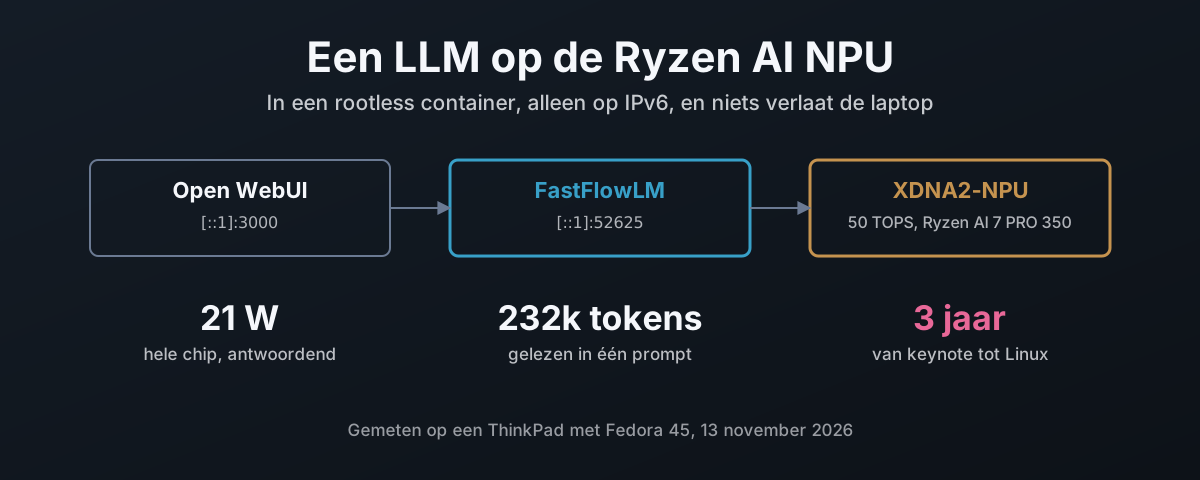
50 TOPS die niks doen
Elke Ryzen AI-laptop die de afgelopen twee jaar is verkocht, heeft een Neural Processing Unit (NPU), een blok silicium dat nergens anders voor gebouwd is dan het rekenwerk achter AI-modellen. In de mijne, een ThinkPad met een Ryzen AI 7 PRO 350, geeft AMD hem op voor maximaal 50 TOPS, biljoenen bewerkingen per seconde1. Je hebt ervoor betaald. Op een standaard Linux-installatie doet hij niets.
Dat is dit jaar veranderd. Eenmaal ingericht draait de NPU een taalmodel van 4 miljard parameters achter een chatvenster, plus spraak-naar-tekst, allemaal op de laptop, zonder account, zonder abonnement en zonder dat er iets de machine verlaat. Voor alles wat je liever niet in de website van een ander intypt, is dat precies de bedoeling. De hele chip trekt ongeveer 21 W terwijl hij antwoordt, en stationair minder dan 9 W.
| Wat er draait | Waar | Adres |
|---|---|---|
| Qwen 3.5 4B, context van 256k tokens | NPU, in een container | http://[::1]:52625/v1 |
Spraak-naar-tekst: Whisper van OpenAI, whisper-v3:turbo | NPU, dezelfde container | idem, /audio/transcriptions |
| Open WebUI, de chatpagina | CPU, in een container | http://[::1]:3000 |
| amdxdna-kerneldriver, firmware | host | /dev/accel/accel0 |
Twee regels bepaalden de bouw. Alleen de kerneldriver en zijn firmware gaan op de host; elk modelframework draait in een rootless podman-container. En elke dienst luistert alleen op IPv6-loopback, met helemaal niets op IPv4. Beide bleken minder werk dan het op de rommelige manier doen, en beide vingen problemen die ik anders zou hebben opgeleverd.
Wat het op Linux vraagt
De NPU in deze chip is AMD’s ontwerp van de tweede generatie, XDNA2. Dat doet ertoe, want de software die taalmodellen erop draait, ondersteunt XDNA2-onderdelen (Ryzen AI 300- en 400-serie, Strix Halo) en niet de eerste generatie in de Ryzen 7040 en 80402. Controleer de jouwe voordat je begint:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Er zitten vier lagen tussen dat apparaat en een antwoord in de chat, en de scheiding tussen host en container is het hele ontwerp:
| Laag | Wat het is | Woont op |
|---|---|---|
amdxdna | kerneldriver, maakt /dev/accel/accel0 aan3 | host, via DKMS |
| NPU-firmware | npu_7.sbin, 1.1.2.64 op deze chip | host, uit linux-firmware |
XRT + amdxdna-plug-in | AMD’s runtimebibliotheek en zijn NPU-backend | container |
| FastFlowLM | de LLM-runtime, NPU-kernels inbegrepen | container |
Kernel 7.x levert amdxdna in-tree mee, maar AMD ontwikkelt hem eerst in een eigen repository, en de
userspace-plug-in moet passen bij de kernelmodule waarmee hij praat4. Het verschil tussen de twee
is niet klein. Op deze laptop:
| In-tree, Fedora’s 7.2.15 en 7.3.3 | Out-of-tree, amd/xdna-driver op 24dfd686 | |
|---|---|---|
| Driverinterface | 0.105 | 0.19 |
| Moduleversie | geen | 2.27.0_20261113 |
| NPU-PCI-ID’s die hij bindt | 6 | 8 |
| Firmwarebestanden die hij vraagt | 7 | 59 |
| Firmware die deze chip laadt | 17f0_10/npu_7.sbin, 1.1.2.64 | hetzelfde bestand |
Negen interfaceversies uit elkaar, en Linux 7.3, de nieuwste release, heeft nog steeds 0.10. Het enige
waarover ze het eens zijn, is de firmware, en die komt uit Fedora’s linux-firmware, niet uit een van beide
drivers. Dus bouw ik beide helften uit één commit van amd/xdna-driver, zet ik de module op de host,
en bak ik de bijpassende userspace in de image.
De driver: bouw alles, houd alleen het kernelstuk
amd/xdna-driver heeft XRT als git-submodule, en het bouwen levert RPM’s op voor XRT en een
plug-inpakket. Het plug-inpakket bevat ook de driverbroncode, die het registreert bij
DKMS (Dynamic Kernel Module Support, het ding dat een module voor elke nieuwe kernel opnieuw bouwt).
Niets daarvan is moeilijk:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
Op Fedora 45 eindigt het afhankelijkhedenscript met een fout. Negeer die:
| Het vraagt om | Wat er gebeurt | Maakt het uit? |
|---|---|---|
protobuf-devel | botst met een geïnstalleerde protobuf3-compiler | nee, XRT slaat zonder dat alleen een tracingtool over |
redhat-lsb | bestaat niet, Fedora heeft het laten vallen | nee |
| al het andere | al geïnstalleerd |
De laatste getagde release daar is van februari, dus main is het releasekanaal. Ik ging van een
build van mei naar die van november: 550 commits, XRT 2.23 naar 2.27.
De upgrade verwijdert de driver die hij net heeft geïnstalleerd
Mijn eerste upgradepoging haalde de module helemaal weg. RPM draait het installatiescript van het nieuwe pakket,
dat de nieuwe driver bouwt en bij DKMS registreert, en daarna het verwijderscript van het oude pakket.
Dat verwijderscript leest de driverversie uit een bestand dat het nieuwe pakket al heeft
overschreven, dus het deregistreert de versie die net is geïnstalleerd. De uitvoer van dnf
zegt het in twee regels, de ene na de andere:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Niets faalde, niets werd rood, en de volgende boot zou stilletjes hebben geladen wat de kernel
zelf meeleverde. Mag ik vragen waarom een verwijderscript bij een upgrade draait zonder te controleren of het
een upgrade is? RPM geeft elk scriptlet dat antwoord als eerste argument. Het is één if.
Het is ook de reden dat de host de RPM’s nu helemaal niet meer krijgt. De driverbroncode is een tarball in het plug-inpakket, dus ik haal hem eruit en geef hem rechtstreeks aan DKMS:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Geen reboot. Het is Linux, en niets heeft het apparaat op dat moment open, dus de module wisselt
live. DKMS bouwt hem
daarna opnieuw voor elke kernel die dnf installeert; toen 7.3.3 binnenkwam, was hij al gebouwd voordat ik
erin had herstart.
Controleer dat het de DKMS-build is die geladen is en niet de in-tree, en dat de firmware nieuw genoeg is. FastFlowLM wil 1.1.0.0 of later2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS zet de eigen module van de kernel opzij in plaats van hem te verwijderen, naar
/var/lib/dkms/xrt-amdxdna/original_module/, dus wie de DKMS-build weghaalt, krijgt hem terug.
Nog één ding om met rust te laten: amd_iommu=off op de kernelcommandline schakelt de NPU uit2.
FastFlowLM in een container
FastFlowLM is de runtime die de NPU bruikbaar maakt voor taalmodellen. Het is een commandline in Ollama-stijl en een OpenAI-compatibele server, geschreven voor XDNA2, en het is dit jaar onder AMD’s ROCm-organisatie gekomen6. De runtime heeft een MIT-licentie. De NPU-kernels die het meelevert, zijn gesloten binaries, vrij te gebruiken en ongewijzigd te verspreiden7. Ik had ze liever open gezien, en dat zeg ik ook, maar ze staan in de repository en er hoeft niets van ergens anders opgehaald te worden.
De image bestaat uit drie stages op Fedora 45: XRT uit de driverbuild, FastFlowLM daartegen gecompileerd, en dan een runtime met alleen wat hij nodig heeft. Het deel dat ertoe doet:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Elk van die flags staat er omdat er zonder iets stukging:
| Probleem | Oplossing |
|---|---|
| De scripts van de plug-in bouwen een kernelmodule, en die hoort op de host | --noscripts, en de driverbroncode en firmware uitgesloten |
| RPM 6 in Fedora 45 dwingt standaard handtekeningcontrole af8, en een zelfgebouwde RPM is niet ondertekend | --nosignature: ik heb hem gebouwd, ik weet waar hij vandaan komt |
De bibliotheken van XRT staan in lib64, en dat staat niet in het linkerpad | /etc/ld.so.conf.d/xrt.conf in de image |
FastFlowLM vindt XRT via pkg-config, en setup.sh van XRT zet het pad niet | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig in de buildstage |
De uiteindelijke image is 609 MB, en de tag draagt de drivercommit,
fastflowlm:v1.0.12-xdna24dfd686. Een healthcheck vergelijkt die met de commit die de geladen
module meldt, en faalt als ze verschillen. Een image die voor de verkeerde driver is gebouwd, is de enige fout
hier die echt verwarrend is om te diagnosticeren, dus die wordt gevangen voordat het zover komt.
De container krijgt één apparaat, de NPU, en de memory-lock-limiet die FastFlowLM nodig heeft om zijn buffers vast te pinnen:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
AMD’s eigen zelftest, xrt-smi validate, zette de NPU op 51 TOPS bij een matrixvermenigvuldiging. Dat is de
50 op de doos, geleverd.
Starten bij het booten, alleen op IPv6
Quadlet maakt van een kort .container-bestand een systemd-dienst9. Als user unit draait het
rootless, als mij, en met lingering aan start het bij het booten zonder dat er iemand is ingelogd10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 zet het contextvenster, en de contexttest hieronder is
waarom het zo groot is. -a whisper-v3:turbo laadt een tweede model naast het chatmodel, een dat
spraak omzet in tekst; dat krijgt een eigen sectie.
Drie regels daarin zijn met vallen en opstaan geleerd:
| Regel | Zonder |
|---|---|
StopSignal=SIGINT | FastFlowLM negeert SIGTERM, het stopsignaal van podman, en wordt tien seconden later gekilld |
--host ::1 | het luistert op 127.0.0.1, IPv4 |
::1, niet [::1] | de vorm met haken wordt niet geparsed; haken horen in een URL |
Bewijs het adres in plaats van erop te vertrouwen:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost werkt nog steeds voor alles wat het eerst naar ::1 resolvet, en dat doen Fedora’s
/etc/hosts en Chrome allebei.
Wat het doet, gemeten
Negen modellen door FastFlowLM’s eigen benchmark, waarbij decode de snelheid is waarmee het antwoord binnenstroomt:
| Model | Decode, 1k context | Decode, 8k context | Prompt lezen, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2.009 tok/s |
qwen3.5:2b | 32 | 29 | 1.533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
Leestempo is vijf tot acht tokens per seconde, dus elk van deze blijft je voor. Decode
halveert ruwweg telkens als het model verdubbelt, en dat verwacht je als de grens de geheugenbandbreedte
is en niet de rekenkracht. Ik draai qwen3.5:4b. Phi-4 mini is sneller, maar Qwen 3.5 houdt zijn snelheid vast naarmate een gesprek groeit,
kan met afbeeldingen en tool calls overweg, en houdt een promptcache bij die bij elke beurt het opnieuw lezen van de hele geschiedenis
bespaart. Dat beslist het.
256.000 tokens aan context
Qwen 3.5 is gebouwd voor een venster van 262.144 tokens11, en FastFlowLM staat standaard op 32.768. Voorbij die
grens doet het iets wat je moet weten: het logt Max length reached, stopping prefilling
en sluit de verbinding zonder antwoord en zonder fout, dus het chatvenster blijft staan met een leeg
antwoord en jij mag raden of het model, de server of de browser is omgevallen.
Dus heb ik het opgehoogd met -c 262144 en het fatsoenlijk getest. Een code verstopt in de eerste regel van een
prompt van 232.250 tokens, zo’n 175.000 woorden, aan het eind gevraagd:
| 8k context | 232k context | |
|---|---|---|
| Antwoord | goed | goed, AMBER-FALCON-7731 |
| Prompt lezen | 657 tok/s | 210 tok/s |
| Wachten op het eerste woord | 12 seconden | 18,4 minuten |
| Decode | 15 tok/s | 2,4 tok/s |
| Gereserveerd geheugen | ~5 GB | ~12,7 GB |
Het werkt. Het is traag. En het geheugen wordt gereserveerd of je het venster nu gebruikt of niet. Met 90 GB in de machine betaal ik dat graag om een lange plak tekst beantwoord te krijgen in plaats van stilletjes weggegooid.
Kan de GPU helpen?
Dezelfde chip heeft een Radeon 860M, dus de voor de hand liggende vraag is of die een deel van de last kan overnemen. Eén model over de NPU en de GPU verdelen, de prompt op de een lezen en het antwoord op de ander schrijven, doet vandaag geen enkele Linux-runtime. Een tweede runtime op de GPU draaien wel, dus dat heb ik gemeten.
“Efficiënt” betekent hier snelheid en energie samen. De amdgpu-driver meldt het package-vermogen van
de hele chip zonder root, en de amdxdna-driver meldt de NPU apart, dus elke run
hieronder werd vier keer per seconde bemonsterd. Overal hetzelfde model op 4 bit.
Van de GPU-runtimes die ik bekeek, werkte er één:
| Runtime | Resultaat op de 860M |
|---|---|
| llama.cpp, Vulkan-backend12 | werkt; image van 881 MB |
| llama.cpp, ROCm-backend | ziet de GPU en segfault dan bij het eerste stuk werk, met of zonder override van de GPU-versie; image van 23 GB |
| MLC-LLM, Vulkan13 | de compiler segfault bij het bouwen van de Qwen 3.5-architectuur |
| vLLM, SGLang | niet geprobeerd: gebouwd voor datacenter-GPU’s en veel gebruikers, niet voor een iGPU met 8 units |
En de NPU tegen degene die werkte:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Stationair, model geladen | 8,6 W | 16,0 W, tegen 9,7 W als hij gestopt is |
| Prompt lezen, ~6k tokens | 557 tok/s bij 23,8 W | 411 tok/s bij 46,1 W |
| Energie per prompttoken | 0,043 J | 0,112 J |
| Decode | 18,2 tok/s bij 21,0 W | 23,5 tok/s bij 40,7 W |
| Energie per gegenereerd token | 1,16 J | 1,73 J |
De GPU schrijft antwoorden zo’n 29% sneller. Hij verstookt er het dubbele vermogen voor. De NPU leest prompts sneller en met minder dan de helft van de energie. Het grotere getal is het stationaire: de GPU-server geladen en niets doend kost 6,3 W bovenop dezelfde machine met hem gestopt, de hele dag. Beide tegelijk draaien bracht de NPU van 18,2 naar 14,2 tokens per seconde en de GPU van 23,5 naar 13,9, omdat ze hetzelfde geheugen delen. Daarom bestaat de GPU-container wel, maar hij wordt gestart als ik een tweede model wil, en hij staat niet aan bij het booten.
De NPU zelf trok in elke run minder dan 2 W. Het grootste deel van de 21 W is de CPU en het geheugen die hem voeden. Dat is het plafond om in de gaten te houden bij toekomstige releases van FastFlowLM.
Spraak naar tekst, ook op de NPU
Whisper is het spraakherkenningsmodel van OpenAI: audio erin, tekst eruit, in 99 talen, en uitgebracht onder de MIT-licentie, dus het draait overal zonder dat je iemand iets hoeft te vragen14. Large-v3 is de huidige volledige versie. Turbo is hetzelfde model met zijn decoder, de helft die de tekst uitschrijft, teruggebracht van 32 lagen naar 4. De model card zegt de ruil ronduit: “way faster, at the expense of a minor quality degradation”. Met 809 miljoen parameters is het een vijfde van de grootte van het chatmodel.
FastFlowLM levert het al omgezet voor de NPU als whisper-v3:turbo, een download van 623 MB, en
laadt het naast het chatmodel met -a whisper-v3:turbo. Whisper alleen serveert het niet;
er moet ook een chatmodel geladen zijn. Audio gaat naar het standaard OpenAI-transcriptie-endpoint
en de tekst komt terug.
| 19,6 seconden spraak | |
|---|---|
| Eerste verzoek, Whisper laden | 6,2 s |
| Daarna | 2,0 s, ongeveer tien keer realtime |
| Vermogen hele chip | ~24,7 W |
| Nauwkeurigheid | elk woord goed |
Wel gespeld in Amerikaans nep-Engels, let wel: “color” en “program”. De API van Whisper neemt een prompt, en een
prompt in echte Britse Engelse spelling, het Engels van Engeland waar de taal vandaan
komt, is genoeg om dat recht te zetten:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
We zouden deze modellen helemaal niet moeten hoeven corrigeren. Whisper is getraind op 99 talen en schrijft Engels nog steeds op de Amerikaanse manier tenzij het anders wordt verteld, omdat de mensen die het bouwden hun spelling als de standaard zien en die van alle anderen als een optie waar je om moet vragen. Dat is het irritante Amerikaanse standaarddenken waar de rest van de wereld een hekel aan heeft, en het zit erin gebakken als vooroordeel. De systeemprompt voor het chatmodel bevat dezelfde instructie, in de sectie hieronder, om dezelfde reden.
Een chatvenster, en 7.000 tokens die je nooit typte
Open WebUI is de front-end in de browser15, in een eigen container, op dezelfde manier gebonden aan [::1]:3000
en gericht op de NPU. De microfoonknop gaat naar Whisper op de NPU in plaats van naar de eigen
standaard, die een model zou hebben gedownload en op de CPU zou hebben gedraaid.
Het eerste bericht dat ik stuurde, was twintig woorden. Het kwam bij de NPU aan als een prompt van 7.223 tokens, omdat Open WebUI 0.13 de definities van al zijn ingebouwde tools (geheugen, notities, agenda, automatiseringen, zoeken op het web) aan elk bericht hangt, en een beheerder krijgt ze allemaal.
| Dezelfde vraag van twintig woorden | Prompt naar de NPU | Wachten op het eerste woord |
|---|---|---|
| Ingebouwde tools aan, de standaard | 7.223 tokens | ~12 s |
| Ingebouwde tools uit voor het model | 127 tokens | minder dan 1 s |
Voor een lokaal model hoort die standaard uit te staan. Twaalf seconden, bij elk antwoord.
Het vertelde me ook vol vertrouwen dat het “trained by Google” was en draaide “on Google’s advanced infrastructure”. Het is een Qwen-model, gemaakt door Alibaba, draaiend op een laptop. Dat is complete onzin, en het zou niet mogen gebeuren.
Het ligt niet aan de opzet. Een model ziet alleen de tekst die het gestuurd krijgt, en de naam in het keuzemenu is een label voor de server, die nooit aan het model wordt doorgegeven. Dat antwoord kwam dus van het model alleen, en het had het enige feit over zichzelf fout dat nooit in twijfel zou mogen staan. Dat is een ontwerpfout, en die ligt bij wie het model heeft uitgebracht.
Alibaba wist hoe het dit kon voorkomen. Het chattemplate van Qwen 2.5 opende elk gesprek met “You are Qwen, created by Alibaba Cloud”, tenzij je het iets anders gaf16. Qwen 3 liet die regel vallen17, en Qwen 3.5 wordt ook zonder geleverd18. Niets verving hem, en afgaande op dat antwoord is het model het nooit goed genoeg aangeleerd om het zelf te redden. Vraag een 4B-model “what are you?” zonder prompt en het valt terug op het meest voorkomende antwoord in zijn trainingsdata, en dat is dat van een ander.
Is dat iets kleins? Nee. Een model dat je vol vertrouwen vertelt wie het gebouwd heeft en in wiens datacenter het draait, en beide fout heeft, doet hetzelfde met alles wat het niet kan controleren. Hier weet jij het juiste antwoord. Meestal niet.
Dus het moet verteld worden, in een systeemprompt:
| Gevraagd “what are you, and what are you running on?” | Antwoord |
|---|---|
| Geen systeemprompt | “a large language model trained by Google… Google’s advanced infrastructure” |
| Met een | “Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM” |
Dezelfde prompt zegt het Brits Engels te schrijven, weer vanwege het Amerikaanse standaarddenken dat Whisper ook heeft. Als het verteld wordt, doet het dat. Welke dag het is, kan het je nog steeds niet zeggen. Een model zonder agenda en zonder internet raadt datums en recente gebeurtenissen, en het zal dat niet altijd zeggen, wat de prompt ook vraagt.
Drie jaar om AI op Linux te draaien
AMD zette Ryzen AI in januari 2023 op het podium als “the first dedicated artificial intelligence hardware in an x86 processor”19. Tel vanaf die keynote vooruit:
| Wanneer | Wat er op Linux gebeurde | Na de keynote |
|---|---|---|
| 4 januari 2023 | Ryzen AI aangekondigd, in de Ryzen 7040 | |
| 25 januari 2024 | amd/xdna-driver gepubliceerd op GitHub4 | 1 jaar |
| 24 maart 2025 | amdxdna in mainline Linux, 6.1420 | 2 jaar en 2 maanden |
| 27 maart 2025 | deze chip, de Ryzen AI 7 PRO 350, komt uit1 | 2 jaar en 2 maanden |
| 11 maart 2026 | FastFlowLM 0.9.35, de eerste native Linux-release21 | 3 jaar en 2 maanden |
| 11 augustus 2026 | FastFlowLM 1.0.0, nu onder AMD’s ROCm6 | 3 jaar en 7 maanden |
| vandaag | nog steeds geen LLM-runtime voor de 7040 en 80402 | 3 jaar en 10 maanden |
Drie jaar en twee maanden om überhaupt een taalmodel op de NPU onder Linux te draaien, en AMD’s eigen software deed het niet. FastFlowLM deed het, een project dat buiten het bedrijf begon en dit jaar onder ROCm werd binnengehaald. De Linux-releasenotes openen met “The wait is finally over”, en zeggen dan dat het “the exact same recipe you already know and love on Windows” gebruikt21. Fisher-Price OS (Windows) kreeg het eerst, en dat zeiden ze ook. AMD’s eigen Ryzen AI Software zegt in de huidige releasenotes nog steeds: “Model generation is not supported on Linux in this release”22.
Wie de eerste generatie kocht, heeft het slechter. Een Ryzen 7040-laptop uit 2023 heeft een NPU die geen enkele taalmodelruntime op Linux aanraakt, en nergens staat dat er een komt. Hetzelfde logo.
Mag ik vragen waarom? Niet wie, waarom. Wat in het proces van AMD maakte het mogelijk dat een chip met AI in de naam werd verkocht terwijl de software om die AI op Linux te gebruiken jaren later opdook, en van buiten? Het specblad zegt “Up to 50 TOPS”1. Het logo zegt Ryzen AI. Beide zijn uitspraken gedaan tegen degene die de laptop koopt, en in het eerste jaar van deze chip op Linux waren ze allebei niks waard.
Gericht op Copilot, niet op het datacenter
Het is niet dat AMD Linux moeilijk vindt. In het datacenter is Linux eersteklas en dat weet AMD: El Capitan in Lawrence Livermore bestaat uit AMD EPYC-processors en AMD Instinct-versnellers, het was tot juni van dit jaar de snelste computer ter wereld23, en het draait TOSS, Livermores eigen build van Red Hat Linux24. Zie je AMD een Instinct-versneller verkopen en de koper vertellen dat de Linux-software uiteindelijk wel zou volgen, van iemand anders? Dat zou een nee zijn. AMD heeft zelfs de kerneldriver van deze NPU geschreven en in mainline gekregen. De laatste laag, die de hardware het werk laat doen waarvoor hij verkocht is, was het stuk dat moest wachten.
Het had nooit een laptopproject mogen zijn. Dezelfde XDNA-architectuur ging datzelfde jaar in een datacenterkaart, de Alveo V70, verkocht als “the first Alveo production card leveraging AMD XDNA architecture with AI Engines”25. Bouw één softwarestack voor de AI Engine, Linux eerst zoals de rest van het datacenter, en de laptop krijgt hem er gratis bij. De server ook. Een kleine, zuinige versneller is precies wat je aan virtuele machines wilt uitdelen, elk een stukje, voor de kleine modellen die geen hele GPU nodig hebben. De kernel heeft dat pas dit jaar geleerd: een NPU opsplitsen in virtual functions op de nieuwe AIE4-onderdelen26. Op de NPU in deze laptop kan hij het helemaal niet.
In plaats daarvan ging de moeite naar Fisher-Price OS (Windows), en naar Copilot. AMD lanceerde de generatie van deze chip als processors die “Unlock Transformational AI Experiences for Windows Copilot+ PCs”27. Bijna niemand trapte erin. Copilot+-machines waren 2,3% van de Fisher-Price OS (Windows)-pc’s die in het eerste kwartaal van 2025 werden verkocht, en Microsofts nieuwere Copilot-functies draaien hoe dan ook in de cloud: “only one of its new AI capabilities actually requires an NPU”28. Microsoft meldt ook dat wat het aan pc-makers verdient 7% is gedaald door “lower PC market demand”, met “roughly 30% of the installed base still on Windows 10”29. De NPU was dus gericht op een besturingssysteem waar mensen niet naar upgraden, om een assistent te draaien waar ze niet om vroegen, die de NPU meestal niet eens gebruikt.
Het is ook niet waar AI gebouwd wordt. De mensen die dit voor hun brood doen, draaien Linux, omdat daar hun tools draaien. TensorFlow zegt ronduit dat 2.10 “was the last TensorFlow release that supported GPU on native-Windows”30. De vLLM-modelserver “does not support Windows natively”31. JAX noemt zijn build voor Fisher-Price OS (Windows) experimenteel, en zijn AMD-ondersteuning “AMD GPU (Linux)”32. Waar Fisher-Price OS (Windows) deze tools wel draait, is dat via WSL 2, wat volgens Microsofts eigen beschrijving “an actual Linux kernel inside a managed VM” is33. AMD richtte zijn AI-chip op de ene desktop die het AI-vak niet gebruikt. Dat half ondersteunen is niet genoeg, AMD.
En dan verkoopt AMD zich aan beleggers als AI-bedrijf. Op 11 november 2025 zei de voorzitter en CEO dat AMD “is uniquely positioned to lead the next generation of high-performance and AI computing”, in een persbericht dat opschept over de groei van de “AI PC portfolio 2.5x since 2024” en afsluit met “full-stack AI solutions”34. Full stack. Op de AI-pc in dit stuk kwam de top van die stack van een project dat AMD niet begon, en op de eerste generatie kwam hij nooit. Een AI-bedrijf waarvan de eigen AI-chip drie jaar moest wachten om AI te draaien op het besturingssysteem waarop zijn datacenterbusiness gebouwd is? Lachwekkend.
Eersteklas ondersteuning is eenvoudig te beschrijven. Het werkt op de dag dat je de machine koopt, op het besturingssysteem dat je draait, van het bedrijf dat je de chip verkocht. Deze NPU haalt dat nog niet. Ik kocht de laptop voor de rest en de NPU kwam mee, en dat is de enige reden dat dit een verslag is en geen klacht. Wie er een kocht voor de AI op het logo, en Linux draait, kocht een belofte die laat werd nagekomen, en door iemand anders.
Bezit het silicium waarvoor je betaald hebt
De NPU kwam met de laptop mee. Zoals hij verkocht wordt, is hij het stuk dat de machine klaar maakt voor AI, en de AI die wordt aangeboden, is die van een ander, in het datacenter van een ander, die leest wat je typt zodat er op een andere manier voor betaald kan worden. Niets aan de hardware heeft die regeling nodig. Een 4B-model op 21 W beantwoordt een vraag, leest een plak tekst van 175.000 woorden als je het de tijd geeft, en schrijft op wat je zegt, en niets daarvan verlaat het bureau.
Afgewerkte software is het niet, en elke ruwe kant hierboven kostte een uur om te vinden en een regel of twee om te repareren. Dat is wat open source kost als je het echt draait. Het is nog steeds een betere deal dan dezelfde mogelijkheid terughuren, en het uur koopt je de kennis van hoe het werkt.
De containers houden het eerlijk. Niets op de host behalve een kernelmodule en zijn firmware, één apparaat doorgegeven aan één container, een adres dat niemand anders kan bereiken, en een controle die faalt op het moment dat de stukken niet meer passen. Het kostte een dag. Het blijft werken, omdat ik weet waarom elke regel erin staat en de controle me zegt op de ochtend dat een van die regels niet meer klopt.
AMD — Ryzen AI 7 PRO 350 — 8 kernen, 16 threads, Radeon 860M, “NPU TOPS: Up to 50 TOPS”, lanceringsdatum “3/27/2025”. ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — alleen XDNA2 (Ryzen AI 300/400, Strix Halo), niet XDNA1; NPU-firmware 1.1.0.0 of later; zet geen
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — de in-tree acceleratordriver voor AMD-NPU’s. ↩︎
amd/xdna-driver — driver, XRT-submodule en plug-in; bouw het XRT-basispakket uit de meegeleverde submodule zodat het met de plug-in werkt; repository aangemaakt op 25 januari 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; hetzelfde in v7.2. ↩︎ROCm/FastFlowLM — NPU-LLM-runtime voor XDNA2, OpenAI-compatibele server, onderdeel van ROCm sinds v1.0.0; de hier gebruikte release is v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — voorwaarden voor de meegeleverde NPU-kernelbinaries. ↩︎
RPM 6.0.0 release notes — “RPM defaults to enforcing signature checking”. ↩︎
podman-systemd.unit(5) — Quadlet-units van het type
.container, inclusiefAddDevice=,Ulimit=,StopSignal=enExec=. ↩︎loginctl(1) —
enable-lingerstart een user manager bij het booten en houdt hem draaiende na het uitloggen. ↩︎Qwen/Qwen3.5-4B — “Context Length: 262,144 natively”; hybride lagen met Gated DeltaNet en gated attention. ↩︎
ggml-org/llama.cpp — de containerimage
server-vulkandie voor de GPU-runs is gebruikt, build 12352. ↩︎mlc-ai/mlc-llm — getest met de nightly-pakketten van 0.26. ↩︎
openai/whisper-large-v3-turbo — “a state-of-the-art model for automatic speech recognition (ASR) and speech translation”; gesnoeid uit large-v3, “the number of decoding layers have reduced from 32 to 4”; 809M parameters; MIT-licentie. ↩︎
open-webui/open-webui — hier gebruikte release v0.13.3. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — het standaard systeembericht van het chattemplate: “You are Qwen, created by Alibaba Cloud. You are a helpful assistant.” ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — chattemplate zonder standaard systeembericht. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — chattemplate zonder standaard systeembericht. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 januari 2023: “AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.” ↩︎
Kernel Newbies — Linux 6.14 — uitgebracht op maandag 24 maart 2025; “an amdxdna driver for AMD NPUs”. ↩︎
FastFlowLM v0.9.35 release notes — 11 maart 2026: “The wait is finally over… FastFlowLM is officially available natively on Linux!” ↩︎ ↩︎
AMD — Ryzen AI Software release notes — bekende problemen: “Model generation is not supported on Linux in this release.” ↩︎
TOP500 — June 2026 — “LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list”; El Capitan “is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators”. ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — “a fully functional cluster operating system, based on Red Hat Linux”. ↩︎
AMD — Alveo V70 — “the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency”. ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — “Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement”. De tabel van de driver geeft alleen die onderdelen vermeldingen voor virtual functions; de NPU van deze laptop is
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 juni 2024: “AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs”. ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 december 2025: Copilot+-systemen “made up just 2.3 percent of Windows machines sold in the first quarter of 2025”; “only one of its new AI capabilities actually requires an NPU”. ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 juli 2026, met een citaat uit Microsofts resultatencall: “Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand”; “roughly 30% of the installed base still on Windows 10”. ↩︎
TensorFlow — Install TensorFlow with pip — “TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.” ↩︎
vLLM — GPU installation — “vLLM does not support Windows natively”. ↩︎
JAX — Installation — CPU-wheels voor “Windows, x86_64 (experimental)”; GPU-secties voor NVIDIA, Google Cloud TPU, Mac en “AMD GPU (Linux)”. ↩︎
Microsoft — Comparing WSL versions — “the use of an actual Linux kernel inside a managed VM”. ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 november 2025: “AMD is uniquely positioned to lead the next generation of high-performance and AI computing”; “AMD has expanded its AI PC portfolio 2.5x since 2024”; “AMD delivers full-stack AI solutions”. ↩︎