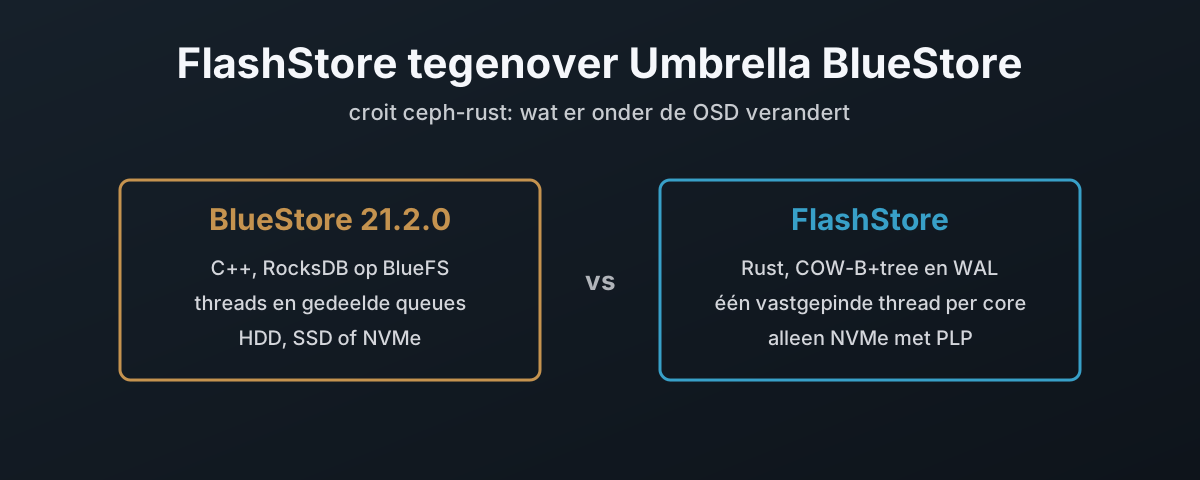
Eerst de disclosure: ik werk voor croit, dat dit geschreven heeft. Alles hieronder is gelezen uit de gepubliceerde broncode en documentatie van beide projecten, gelinkt onderaan de pagina, en waar de docs van croit het oneens zijn met de code van croit, zeg ik dat.
De OSD Van Ceph, Vanaf Nul Herschreven
croit heeft ceph-rust gepubliceerd, een Ceph-OSD die vanuit het niets in Rust is geschreven, met een eigen object store genaamd FlashStore in plaats van BlueStore1.
Hij ging op 9 november 2026 in public preview, en algemene beschikbaarheid staat gepland voor het eerste kwartaal van 20271.
Het is geen fork.
De eigen regel van het project is dat de C++ van Ceph als referentie wordt gelezen, in croits eigen woorden als specificatie wordt uitgeschreven, en dan vanuit die specificatie wordt geïmplementeerd2.
De claim die telt voor iedereen die Ceph draait, is de drop-in-claim.
Je monitors, je managers, de ceph-CLI en je clients blijven zoals ze zijn.
Een FlashStore-OSD sluit aan bij dezelfde pools en dezelfde placement groups als de klassieke OSD’s die er al zitten, en je vervangt één schijf tegelijk1.
Dus de vraag voor een beheerder is praktisch. Als je een BlueStore-OSD verruilt voor een FlashStore-OSD, wat is er dan onderaan anders? Niet in het abstracte, en niet tegenover een BlueStore uit een conferentietalk van jaren geleden. Tegenover de BlueStore die je vandaag echt draait als je op Umbrella zit, Ceph 21.2.0, de release waartegen FlashStore gebouwd en getest is1.
Dus dat is hier de vergelijking, en alleen dat. De BlueStore van Umbrella zoals zijn eigen broncode en documentatie hem beschrijven, tegenover FlashStore zoals zijn broncode en beslisdocumenten hem beschrijven.
Het raakt iedereen met NVMe-Ceph-clusters, en iedereen die ooit heeft uitgerekend wat een OSD aan cores kost. HDD-clusters raakt het helemaal niet, en de reden daarvoor komt hieronder aan bod.
Wat Er In De Repository Zit
De repository is een read-only snapshot van de private ontwikkelboom van croit. Geen issuetracker, geen pull requests; updates komen binnen als nieuwe snapshot-commits1. Dat hoort bij de preview-fase, en die is er voor feedback uit de community terwijl croit intern zijn productietestcases doorloopt voordat het als veilig voor gebruik wordt aangemerkt. Na de eerste productierelease wordt de ontwikkeling open, zoals bij de meeste door bedrijven gedragen open-sourceprojecten. Deze is gedateerd op 10 november 2026 en bevat zo’n 700.000 regels Rust en meer dan 450 architecture decision records, de ADR’s: korte documenten die vastleggen waarom elke ontwerpkeuze gemaakt is.
De ADR’s zijn voor een vergelijking als deze het nuttige deel. Ze zijn bot, ze bevatten metingen, en ze leggen vast wat geprobeerd en weggegooid is, en niet alleen wat bleef.
| Component | Wat het vervangt | Preview | GA (gepland) |
|---|---|---|---|
| FlashStore OSD | ceph-osd + BlueStore | nov 2026 | Q1 2027 |
| librustyrados | librados | nov 2026 | Q1 2027 |
| librustyrbd | librbd | nov 2026 | Q1 2027 |
| RDMA-transport (RoCEv2) | niets in Umbrella | nov 2026 | Q1 2027 |
| CephFS2, Rust RGW | MDS, RGW | Q1 2027 | Q2 2027 |
| ceph-mon, ceph-mgr | niet vervangen | n.v.t. | n.v.t. |
De licenties zijn het weten waard voordat je er iets op bouwt. De daemon en de tools zijn LGPL-3.0-only, de clientbibliotheken MPL-2.0, en de documentatie CC-BY-SA-4.03. De clientbibliotheken werden MPL zodat een Rust-programma ze statisch kan linken zonder de relink-verplichtingen die LGPL meebrengt. Een beredeneerde keuze, en als zodanig ook vastgelegd3.
Preview betekent wat het zegt. De eigen README van croit zegt dat het voor testen en evaluatie is en “not yet recommended for production data”1. Ik zou er ook nog geen klantdata op zetten, en niets in de rest van deze post verandert dat.
Twee Stores, Naast Elkaar
Een OSD heeft twee helften. De bovenste helft spreekt het Ceph-protocol, bezit placement groups, peert, herstelt en scrubt. De onderste helft, de object store, maakt van “schrijf deze bytes naar dit object” blokken op een schijf, en belooft dat ze een stroomstoring overleven.
BlueStore is de onderste helft van Umbrella. De documentatie zegt dat hij “reads and writes to the devices directly in a ‘raw’ fashion”4, en dat hij “raw block devices or partitions” gebruikt5. Objectdata gaat rechtstreeks naar het blockdevice. Al het andere, de objectmetadata, OMAP en zijn eigen boekhouding, gaat naar een ingebedde RocksDB-key/value-database, en RocksDB staat op BlueFS, een klein bestandssysteem dat BlueStore daarvoor meedraagt56.
FlashStore laat dat allemaal vallen. Eén copy-on-write-B+tree per store-shard bevat alles: collecties, objectmetadata, extended attributes, extent maps, OMAP, de PG-log, referentietellingen en zelfs de eigen bitmap van de allocator7. Ernaast zitten een redo-write-ahead-logring en de dataregio. Er is geen RocksDB, geen BlueFS, en geen tweede database om te tunen.
De andere grote splitsing is de schijf zelf. BlueStore gaat via de blocklaag van de kernel naar wat je hem ook geeft. FlashStore praat met NVMe via SPDK, een userspace-driver die het device via vfio van de kernel afpakt, of via de kernel met io_uring89. SPDK is de standaardbackend. De io_uring-tier is degene die werkt waar vfio dat niet doet, en als zodanig is het de tier waar ik in de Proxmox-build op uitkwam.
Waar De Metadata Staat
Begin hier. Het meeste van de rest volgt eruit.
| Umbrella BlueStore | FlashStore | |
|---|---|---|
| Objectmetadata | RocksDB-keys | COW-B+tree per shard |
| OMAP | RocksDB-keys | standaard dezelfde B+tree; LSM of RocksDB optioneel bij prepare |
| PG-log | RocksDB-keys | dezelfde B+tree |
| Allocatorstatus | hybrid allocator, freelist in RocksDB | bitmap per shard, in de boom |
| Metadatadevice | optioneel block.db en block.wal | geen, dezelfde NVMe |
| Datachecksums | standaard crc32c per 4 KiB | crc32c per 4 KiB, in de extent map |
| Aantal stores per OSD | één | één per core |
De standaarden aan de BlueStore-kant komen rechtstreeks uit het optiebestand van Umbrella: RocksDB als key/value-backend, de hybrid allocator, crc32c-checksums61011. Over de metadatachecksums van BlueStore zegt de documentatie dat dat “is handled by RocksDB and uses the crc32c algorithm”, en data kost hem “a checksum value (usually 4 bytes) for every 4 KB block of data”4. Over checksums zijn de twee stores het eens. FlashStore houdt een crc32c per blok van 4 KiB bij in de extent map en controleert die bij het lezen7.
Op structuur gaan ze uiteen. De RocksDB van BlueStore is een log-structured merge tree, dus hij schrijft en compacteert daarna op de achtergrond, waarbij hij data herschrijft die hij al geschreven had. De boom van FlashStore wordt bijgewerkt via copy-on-write en bij checkpoints naar schijf weggeschreven: elke vijf seconden zolang er iets niet persistent is, of zodra de WAL-ring halfvol raakt7.
Een verder gevolg is dat FlashStore geen snel device voor metadata heeft, omdat hij er geen nodig heeft.
Op Umbrella kun je block.db op een snellere schijf zetten, en BlueStore zet dan “as much metadata as it can on the DB device”4.
FlashStore gaat ervan uit dat elke schijf al snelle NVMe is, en houdt zijn metadata naast de data.
Voor de hardware waar hij op mikt is dat een redelijke aanname. Het is ook precies waarom er geen HDD-verhaal is.
OMAP is de enige plek waar FlashStore zich indekt. De boom is de standaard, maar een store kan ook voorbereid worden met een eigen LSM-engine van croit, of met RocksDB, achter dezelfde interface12. De OMAP-engine wordt gekozen als de store wordt aangemaakt. Je wisselt hem niet op een draaiende OSD.
Eén Write Van 4 KiB, Op Twee Manieren
Hier zit het verschil dat je zou voelen, als je al iets voelt.
Neem een write van 4 KiB naar een object op Umbrella, met standaardinstellingen op flash.
bluestore_min_alloc_size_ssd is 4 KiB en bluestore_prefer_deferred_size_ssd is 0, dus een hele write van 4 KiB gaat naar een nieuw gealloceerde 4 KiB1314.
BlueStore dient die datawrite in, en de transactie blijft in STATE_AIO_WAIT staan tot de schijf zegt dat hij klaar is15.
Pas dan gaat de metadata in de wachtrij voor RocksDB, en de sync-thread van RocksDB flusht het blockdevice voordat hij commit16.
Dan krijgt de client zijn bevestiging.
Twee ritten naar het device, na elkaar.
FlashStore stuurt ze allebei tegelijk. De data gaat naar een vers extent van 4 KiB en de WAL-unit gaat parallel naar de logring. Het WAL-record bevat de crc32c van elk nieuw datablok, zodat replay na een crash kan zien of de data het gehaald heeft7. De bevestiging gaat, in logvolgorde, de deur uit zodra de data, de WAL-unit en elke eerdere transactie duurzaam zijn7. De ADR onderbouwt het ontwerp zelf met “parallel commit gives one device latency per ack”7.
Twee dingen houden dit eerlijk. Op een drukke OSD bundelen beide stores hun commits, dus onder belasting is het verschil kleiner dan één devicelatentie per write. En één rit naar het device is op NVMe een paar tientallen microseconden. Of je dat merkt hangt ervan af of je clients bij lage queue depth op latentie wachten, wat databases op RBD vaak doen, of doorvoer pompen, waar het wegvalt.
croit probeerde verder te gaan, naar één device-write per transactie, in ZFS-stijl. Ze bouwden het, maten het en gooiden het eruit: de winst was alleen zichtbaar bij queue depth 1 en de complexiteit was het niet waard17. Dat waardeer ik meer dan welke benchmarkgrafiek ook. Het is een beslisdocument dat in het openbaar zegt “we hebben dit gebouwd en het was het niet waard”.
De Write Onder 4 KiB
Bij de kleinere write lopen de twee echt uiteen.
Stel dat een client 512 bytes overschrijft midden in een blok dat al data bevat.
Umbrella draait standaard nog zijn oorspronkelijke write-pad; bluestore_write_v2, de herziening, wordt uitgeschakeld geleverd18.
Op dat pad wordt een write kleiner dan min_alloc_size naar een blok dat al gealloceerd is een deferred write19.
De data reist mee in de RocksDB-transactie als key onder de prefix L, en gaat pas naar zijn echte plek nadat de client te horen heeft gekregen dat hij veilig is2021.
Dus de data bereikt de schijf twee keer. De documentatie van Umbrella verstopt het niet: “writes smaller than min_alloc_size must first pass through the BlueStore WAL”4.
FlashStore overschrijft nooit live data op zijn plek, punt7. Objecten tot 2 KiB gaan nog verder en leven volledig in de boom, dus één WAL-write is de hele commit7.
Dat betekent ook dat FlashStore geen deferred-write-wachtrij heeft om leeg te maken, geen deferred replay bij het mounten, en geen L-keys om op te ruimen.
Hij betaalt in plaats daarvan ergens anders: vrijgegeven blokken worden vastgehouden tot de volgende checkpoint, dus vrijgekomen ruimte loopt tot één checkpointinterval achter7.
Threads Tegenover Cores
De bovenste helft van de OSD verschilt net zo veel.
De ceph-osd van Umbrella is een klassieke multithreaded server, en elk getal in de linkerhelft van het diagram hieronder is een van zijn standaardwaarden op flash22.
Een op passeert onderweg verscheidene van die pools. Ze delen state achter locks.
FlashStore houdt de hele reis op één vastgepinde, pollende core, van de netwerkkaart tot de schijf en terug23. Elke placement group hoort bij precies één core, en dat geldt ook voor alles wat de PG aanraakt: “no locks, no atomics, no shared mutable state”24. Verkeer tussen cores gaat over single-producer-rings, en het eigendom van het bericht gaat mee.
De store volgt dezelfde splitsing.
flashstore_store_shards staat standaard op één shard per core, elk met een eigen WAL-ring, boom en allocator, en een PG leeft in precies één shard257.
BlueStore is één store per OSD met één RocksDB.
Er hangt een prijs aan, en de ADR noemt hem: “idle cores burn CPU (accepted; optional adaptive sleep later)”23.
Later werk voegde adaptieve idle en op het device getimede waits toe, zodat een core bij lage queue depth niet de hele devicelatentie lang spint8, maar het principe staat, en flashstore_cores staat standaard op 8 als je geen bereik vastpint25.
Je geeft FlashStore hele cores.
Op een dedicated storagenode is dat prima. Op een hyperconverged machine waar diezelfde cores ook VM’s draaien, is dat de eerste som die je maakt.
De Schijf Moet Zijn Belofte Houden
BlueStore is geschreven om om te gaan met een schijf die liegt over wanneer data veilig is. FlashStore weigert met zo’n schijf ook maar iets te maken te hebben.
| Umbrella BlueStore | FlashStore | |
|---|---|---|
| Wat een write duurzaam maakt | flush van het blockdevice vóór de RocksDB-commit | de write die voltooit op een PLP-schijf |
| Flush op het hot path | ja | nee |
| Schijf met een vluchtige write cache | gebruikt, en geflusht | mkfs weigert hem; hostcheck FAIL |
| Override | niet nodig | alleen lab: FUA-bit op elke duurzame write |
De BlueStore-kant is de al geciteerde kv-sync-thread16. De FlashStore-kant is de duurzaamheids-ADR en de hostcheck: PLP betekent dat de schijf geen vluchtige write cache meldt, dus een completion betekent dat de data op stabiel medium staat2426.
Dit is de juiste keuze voor het doel, maar wees helder over wat het uitsluit. Vrijwel alle consumenten-NVMe heeft een vluchtige cache en geen PLP, en dat geldt ook voor een flink deel van de “datacenter”-spullen die op prijs verkocht worden. Geen PLP, geen FlashStore. Wat je er verder ook van vindt.
Waar FlashStore Niet Op Draait
Zet de eisen naast elkaar en de doelmarkt is duidelijk.
| Umbrella BlueStore | FlashStore | |
|---|---|---|
| Media | HDD, SSD, NVMe | alleen NVMe |
| Power-loss protection | niet vereist | vereist, mkfs weigert zonder |
| Sectorformaat | 512 B of 4 KiB | 4 KiB verwacht, anders een waarschuwing |
| Indeling | partities, LVM via ceph-volume | hele namespaces, geen partities |
| Apart DB/WAL-device | ondersteund | bestaat niet |
| Encryptie at rest | --dmcrypt via ceph-volume | buiten scope |
| msgr1-clients | standaard gebonden | geweigerd, alleen msgr2 |
| Cache tiering | deprecated, nog aanwezig | geweigerd, pool wordt passief |
| Kerneleisen | elke ondersteunde | io_uring: Linux 5.19+, of de 5.14 van RHEL 9 met backports; hugepages voor SPDK |
De BlueStore-kolom komt van Umbrella zelf: ceph-volume versleutelt logical volumes “using dmcrypt by specifying the --dmcrypt flag”27, en ms_bind_msgr1 staat nog steeds standaard op true28.
De FlashStore-kolom komt uit zijn hardwarereferentie en zijn scopebeslissing2629.
Twee daarvan verdienen meer dan een tabelregel.
Encryptie at rest valt af, met een reden: SPDK omzeilt dm-crypt, en encryptie in de store staat niet op de planning. Het antwoord van de ADR is zelfversleutelende NVMe-schijven, of encryptie boven de store, bij de client of in RGW29. Als je een compliance-eis hebt die dm-crypt op de OSD voorschrijft, is dat vandaag een showstopper.
msgr1 valt af als geaccepteerd risico. Kernelclients ouder dan 5.11 en librados van vóór Nautilus kunnen helemaal niet met een FlashStore-OSD praten29. De meeste omgevingen zijn daar al lang voorbij. Sommige niet, en het is de oude vergeten machine in de hoek die erachter komt.
Hij Vertelt De Monitor Dat Hij BlueStore Is
Hier gaan mensen in trappen.
Standaard start een FlashStore-OSD op en vertelt hij de monitors osd_objectstore=bluestore30.
Hij verstopt zich niet. Hij zet er zijn eigen keys flashstore_version en flashstore_build naast30.
De reden is compatibiliteit: een Umbrella-monitor staat features zoals EC-overwrites op een pool alleen toe als elke OSD erin BlueStore meldt, en managermodules zoals Prometheus en telemetry vertakken op dezelfde waarde30.
De ADR zegt expliciet dat bluestore hier “is a compat value for mon/mgr feature gates, not a product name”30.
Er is een schakelaar, flashstore_report_objectstore=flashstore, die alles hernoemt: de metadata, de bluestore_bdev_*-keys, de perf logger, de tell-commando’s en de BLUESTORE_*-healthcodes. Hij vereist gepatchte monitors, en de standaard blijft bluestore2530.
De eigen Ceph-builds van croit hebben die patches, dus daar meldt FlashStore zich als flashstore en geldt niets van wat volgt.
De naam bluestore is er voor de standaardmonitors en -managers die vandaag in productie draaien.
Ik begrijp waarom.
Een monitor-gate die op een string sleutelt is het ontwerp van Ceph, niet van croit, en weigeren bluestore te zeggen zou op een ongepatcht cluster features uitschakelen.
Dat is de valkuil op een standaardcluster.
Elk dashboard, elk inventarisscript en elke ceph osd count-metadata osd_objectstore die je draait, telt FlashStore-OSD’s als BlueStore.
Tijdens een migratie, juist als je het meest moet weten welke OSD’s welke zijn, vertelt het voor de hand liggende veld je niks.
Dus controleer flashstore_version in ceph osd metadata, niet osd_objectstore.
Zet dat in je runbook voordat de eerste FlashStore-OSD erin gaat.
Dezelfde Knoppen, Ander Gedrag
FlashStore leest veel van de bestaande opties van Ceph, en dat is grotendeels goed nieuws. Niet elke optie betekent wat hij op Umbrella betekende, en de opties waarbij dat niet zo is, zijn waar een getuned cluster verrast wordt.
| Optie | Umbrella BlueStore | FlashStore |
|---|---|---|
compression_mode, per pool | none, passive, aggressive, force | dezelfde vier, dezelfde betekenis |
compression_algorithm | standaard snappy | snappy, zlib, zstd, lz4; zstd-niveau vast op 1 |
bluestore_compression_max_blob_size_ssd | 64 KiB | chunks van 64 KiB |
osd_memory_target | 4 GiB, caches live autogetuned | één keer gelezen bij start, dimensioneert storecaches, geen autotune |
osd_op_queue | mclock_scheduler | geaccepteerd en genegeerd |
osd_mclock_* | actief | geaccepteerd en genegeerd |
csum_type | standaard crc32c, xxhash-varianten beschikbaar | crc32c vast; elke andere waarde logt een waarschuwing31 |
Compressie komt overeen.
De standaardmodus van BlueStore is none en zijn standaardalgoritme snappy3233; FlashStore implementeert dezelfde vier modi, dezelfde pool-opties en dezelfde chunking van 64 KiB, en de ADR merkt op dat een voor 50% comprimeerbare chunk van 64 KiB op beide evenveel ruimte inneemt34.
Het zat er niet altijd in. Het ADR-bestand heet nog steeds no-store-compression, naar de oorspronkelijke beslissing, die werd teruggedraaid toen croit volledige functionele pariteit met klassiek Ceph als opdracht stelde34.
Geheugen is geen pariteit.
Umbrella autotunet de caches van BlueStore tegen osd_memory_target terwijl hij draait3536.
FlashStore leest het doel één keer bij de start, verdeelt het over zijn shards, en een wijziging met ceph config set gaat pas bij de volgende herstart in37.
Hij houdt het proces ook niet aan het doel: hugepages, netwerkbuffers en PG-state vallen erbuiten37.
Dus osd_memory_target dimensioneert de caches van FlashStore. Het begrenst het geheugen van de OSD niet zoals je misschien gewend bent.
En mClock wordt botweg genegeerd37.
Niet teruggeschroefd. Genegeerd.
Er is geen op-scheduler om te configureren, omdat elke core zijn eigen PG’s bezit.
Recovery en backfill worden in plaats daarvan afgeremd door osd_max_backfills, osd_recovery_max_active en de sleep-opties37.
Als je op Umbrella mClock-profielen hebt getuned voor een rebuild, doen die instellingen niets op een FlashStore-OSD, en niets waarschuwt je.
Er Is Geen Conversie, In Geen Van Beide Richtingen
Je kunt een BlueStore-OSD niet omzetten naar een FlashStore-OSD. De migratiegids van croit is er duidelijk over: “There is no in-place conversion of a BlueStore device”38. Hij biedt in plaats daarvan twee volgordes, en beide zijn backfill38:
| Toevoegen, dan verwijderen | Vrijmaken, dan toevoegen | |
|---|---|---|
| Vereist | een vrij NVMe-slot | niets extra |
| Stap 1 | FlashStore voorbereiden op de nieuwe schijf | ceph osd out, wachten op clean |
| Stap 2 | wachten op active+clean | de klassieke OSD stoppen en purgen |
| Stap 3 | de klassieke OSD verwijderen | FlashStore voorbereiden op de vrijgekomen schijf |
| Risico tijdens het draaien | niets boven normale backfill | één kopie minder tot de backfill klaar is |
Later wordt het ook niet makkelijker. Het on-disk formaat van FlashStore heeft feature bits, en een mount weigert een onbekende bit: “Every format change means mkfs; unknown bits refuse mount (no downgrade)”7. Dus een formaatwijziging in een latere FlashStore-release is dezelfde ronde van leegmaken en opnieuw vullen als de eerste migratie.
Eén ding heeft de documentatie fout.
De checklist van de migratiegids zegt dat je moet zorgen dat “the pools do not use erasure coding on croit-flashstore-osd OSDs”38.
De erasure-codinggids in dezelfde snapshot zegt dat FlashStore standaard legacy EC-pools bedient, en de eigen standaard van de code voor geoptimaliseerde EC is all3940.
Een van de twee is verouderd, en volgens de code is dat de migratiegids.
Ik zou de EC-gids nog steeds volledig lezen voordat je EC-pools over beide soorten OSD mengt, want de fout die hij beschrijft is een PG die degradeert en een backfill die vastloopt39.
Een Store Gebouwd Voor De Schijven Die We Echt Kopen
BlueStore is gebouwd om op alles te draaien. Draaiende schijven, goedkope SSD’s, NVMe, partities, LVM, versleutelde volumes, een snel DB-device voor een traag datadevice. Die breedte is waarom hij de standaard werd, en het is waarom hij een deferred write-pad meesleept, een flush vóór elke commit, een key/value-database op een eigen bestandssysteem, en een pool threads om dat allemaal in beweging te houden. Elk daarvan bestaat omdat ergens een schijf het nodig had.
FlashStore begint aan de andere kant. Hij gaat ervan uit dat de schijf NVMe is, dat hij power-loss protection heeft, en dat hij snel genoeg is dat de software nu de bottleneck is. Dan gooit hij alles weg wat alleen voor de andere schijven bestond.
Is dat de juiste gok? Voor nieuwe all-flashclusters, gebouwd op degelijke enterprise-NVMe: ja. Daar gaan Ceph-clusters naartoe, en een OSD die zijn cores besteedt aan locks, overdrachten en een database die achter hem compacteert, betaalt elke seconde van elke dag voor flexibiliteit die zo’n cluster nooit gaat gebruiken.
Maar de gok heeft een prijs, en ik heb liever dat je die ziet voordat je erin stapt. Je levert HDD, dm-crypt, msgr1, live geheugentuning en mClock in. Op een standaardcluster krijg je een OSD die je monitors vertelt dat hij BlueStore is, omdat de huidige monitors en managers hem geen andere weg laten; de eigen builds van croit hebben dat niet nodig. Je krijgt een formaat waar je niet naartoe kunt converteren, en ook niet tussen versies ervan. En je krijgt het in preview, van één leverancier, die toevallig mij in dienst heeft.
Dus behandel de broncode als het bewijs, niet deze post en niet het benchmarkrapport van croit. De beslisdocumenten zijn openbaar en ze zeggen wat er gemeten is en wat er weggegooid is. Lees ze, bouw een testcluster op de kit die je echt zou uitrollen, en meet je eigen workload. Als het op jouw schijven doet wat de ADR’s zeggen, dan weet je het. Als het dat niet doet, weet je dat ook, en dan heb je het op een testcluster ontdekt.
croit ceph-rust, README at snapshot 48f9014 — componenten, status en roadmap, “not yet recommended for production data”, wire-compatibel met v21.2.0 en v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, green-field, no Crimson fork — “No fork, no linking of Ceph code”; de broncode van Ceph als referentie gelezen, specificaties in eigen woorden. ↩︎
ADR 0164, licences — daemon en tools LGPL-3.0-only, clientbibliotheken MPL-2.0, docs CC-BY-SA-4.0, en de reden voor MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — directe toegang tot het device, DB-device, “writes smaller than min_alloc_size must first pass through the BlueStore WAL”, checksums. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore “consumes raw block devices or partitions”; RocksDB ingebed voor interne metadata. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— standaardrocksdb. ↩︎ ↩︎ADR 0021, storage engine — COW-B+tree per shard, WAL-ring, parallelle commit, checkpoints, inline data, vastgehouden vrijgaven, “Every format change means mkfs”. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, storage I/O — SPDK via vfio, later aangepast tot twee tiers met io_uring, op het device getimede idle. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkis de standaardbackend,kernelenkernel-cmdlaten de NVMe op de kerneldriver. ↩︎Ceph v21.2.0,
bluestore_allocator— standaardhybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— standaardcrc32c. ↩︎ceph-rust, croit-flashstore-tool usage — “fresh prepare/mkfs –omap-engine btree|lsm|rocksdb”. ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— standaard 4 KiB. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— standaard 0. ↩︎Ceph v21.2.0,
BlueStore.cc, transaction state machine — openstaande aio’s zetten de transactie inSTATE_AIO_WAITvoordat hij in de wachtrij gaat voor de key/value-commit. ↩︎Ceph v21.2.0,
BlueStore.cc, kv sync thread — “flush/barrier on block device” vóór de RocksDB-submit. ↩︎ ↩︎ADR 0027, single-IO atomic commit, rejected — “gain only at QD1”, gebouwd en weer verwijderd. ↩︎
Ceph v21.2.0,
bluestore_write_v2— “Use faster write path”, standaard false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— kop en staart gelezen, dan “chunk-aligned deferred overwrite”. ↩︎Ceph v21.2.0,
BlueStore.cc, “journal deferred items” — de deferred transactie wordt als key in dezelfde RocksDB-transactie gezet. ↩︎Ceph v21.2.0,
BlueStore.cc, key prefixes —PREFIX_DEFERRED = "L". ↩︎Standaardwaarden voor threads in Ceph v21.2.0 —
osd_op_num_shards_ssd8;osd_op_num_threads_per_shard_ssd2;osd_op_queuemclock_scheduler;ms_async_op_threads3; het aanmaken van threads inBlueStore.cc,bstore_kv_syncenbstore_kv_final. ↩︎ADR 0006, thread-per-core runtime — één vastgepinde, busy-pollende thread per core, PG’s in bezit van één core, “idle cores burn CPU (accepted …)”. ↩︎ ↩︎
ADR 0008, concurrency and durability — “no locks, no atomics, no shared mutable state”; PLP vereist,
mkfsweigert schijven zonder PLP, FUA-override voor het lab. ↩︎ ↩︎ceph-rust docs, configuration reference —
flashstore_coresstandaard 8,flashstore_store_shardsautomatisch,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, hardware and host requirements — vluchtige write cache geeft FAIL, 4 KiB-LBA, geen partities, eisen aan kernel en io_uring. ↩︎ ↩︎
Ceph Umbrella, ceph-volume encryption — “Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag”. ↩︎Ceph v21.2.0,
ms_bind_msgr1— standaard true. ↩︎ADR 0168, encryption at rest, msgr1, cache tiering out of scope — “SPDK bypasses dm-crypt”; clients die alleen v1 spreken “cannot reach croit-flashstore-osd”. ↩︎ ↩︎ ↩︎
ADR 0019, report
osd_objectstore=bluestore— de feature gates van de monitor, de extraflashstore_*-keys en de rapportageoptieflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— “csum_type {v} unsupported; using fixed crc32c per 4096-byte block”. ↩︎Ceph v21.2.0,
bluestore_compression_mode— standaardnone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— standaardsnappy. ↩︎ADR 0059, per-pool store compression — dezelfde modi en opties als BlueStore, zstd vast op niveau 1, ruimte bij 50% comprimeerbaar “identical to BlueStore”. ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— standaard 4 GiB. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— standaard true. ↩︎ADR 0062, memory target and mClock — doel één keer gelezen, geen autotune, RSS niet afgedwongen; mClock-opties “ACCEPTED and IGNORED”. ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migrate from classic — “There is no in-place conversion of a BlueStore device”; de twee volgordes; de EC-regel in de checklist. ↩︎ ↩︎ ↩︎
ceph-rust docs, erasure-coded pools —
ec_enable_poolsstandaardall,ec_enable_optimizedstandaardall, en hoe een geweigerde pool eruitziet. ↩︎ ↩︎ceph-rust, OSD config defaults —
("ec_enable_optimized", "all"). ↩︎