De Host Bestaat Deze Keer. Hij Zit Alleen Op De Verkeerde Hypervisor
Vorige keer was het probleem dat de machine die in de inventory genoemd werd nog niet bestond — geen IP, geen SSH, geen Python, niets om mee te verbinden. Elke task moest ervan weg gedelegeerd worden.
Een VMware-migratie keert dat om en verandert niets. De machine bestaat, hij draait, mensen gebruiken hem. Je verbindt er nog steeds nooit mee. Het is een naam en een zak variabelen die iets beschrijven om ergens anders te herbouwen. Elke task draait nog steeds op de control-node, en nu zijn er twee API’s aan de andere kant in plaats van één.
Een opmerking over wat dit is. Deze post is het ontwerp en de playbook, geen oorlogsverhaal. Ik heb het nog niet van begin tot eind tegen een productielandschap gedraaid. Alles wat ik hieronder over modulegedrag zeg is uit de geleverde code gelezen en gecontroleerd, en ik heb ronduit gezegd waar een claim uit de bron komt in plaats van uit een run. Wanneer ik er een echte migratie mee heb gedaan, krijgen de getallen en de verrassingen hun eigen post.
Versies waartegen dit gecontroleerd is:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
De fragmenten hieronder zijn geknipt uit een enkele playbook — migrate.yml, een vSphere dynamische
inventory in inventory/vmware.vms.yml, en één group_vars/all.yml. Ik heb de
datacenter-, node- en storagenamen gegenericeerd voor leesbaarheid.
De Vorm Van De Klus
Vijf stappen, en alleen de laatste kost iets.
De volgorde is het hele ontwerp. Discovery verandert niets. Het netwerk bouwen verandert alleen Proxmox. De schillen bouwen verandert alleen Proxmox, en een schil zonder schijf is goedkoop om te verwijderen. De schijven verplaatsen is traag maar live. Alleen de laatste play schakelt iets uit.
Loop halverwege weg en elke gast draait nog steeds op VMware, onaangeraakt.
Twee Collecties, en Een Ervan Wordt Uitgefaseerd
Je hebt beide nodig, en niet om de reden die je zou raden.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware is de oude, brede collectie en die wordt uit elkaar gehaald. Zijn MANIFEST.json declareert {"vmware.vmware": ">=2.5.0"} als harde afhankelijkheid, dus de eerste installeren trekt de tweede erbij of je erom vroeg of niet. Modules verhuizen één voor één, en die welke je in een migratie pakt zitten in verschillende stadia van die verhuizing:
vmware_dvs_portgroup_info— nog steeds alleen incommunity.vmware, en het is wat je VLAN’s leest.vmware_vmotion— nog steeds alleen incommunity.vmware.vmware_guest_powerstate— deprecated, verwijderd incommunity.vmware7.0.0. Gebruikvmware.vmware.vm_powerstate.vmware_vm_inventory— deprecated, verwijderd in 7.0.0. Gebruikvmware.vmware.vms.
Ansible vertelt je over de module-deprecations op de eerste run, wat aardig van het is:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Het waarschuwt je niet over de inventory-plugin, want inventory-plugins worden geparseerd voordat die machinerie draait. Je moet de plugin gaan lezen.
Er is een derde val in de splitsing. vmware.vmware.vm_portgroup_info ziet eruit als precies wat een netwerkmigratie wil — per VM, per NIC, geeft je de portgroup en het VLAN. Maar het is gebouwd op ModuleRestBase en importeert com.vmware.vapi, wat betekent dat het de vSphere Automation SDK op de control-node nodig heeft, niet alleen pyVmomi. Zijn gedocumenteerde return is ook verouderd: het RETURN-blok belooft name en vlan_id, terwijl de code werkelijk portgroup_name en een vlan_info-dict bouwt voor het distributed-geval. Ik ging een andere weg, hieronder, en had geen van beide nodig.
De Inventory Is De Discovery
Er is geen “ga de VM’s zoeken”-play in deze playbook, want tegen de tijd dat de eerste task draait heeft de inventory het al gedaan — in één property-collector-query in plaats van een lus per VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
De bestandsnaam doet ertoe. De verify_file van de plugin claimt alleen bestanden die eindigen op vms.yml, vms.yaml, vmware_vms.yml of vmware_vms.yaml. Noem het vcenter.yml en het is stilletjes niet jouw inventory.
search_paths filtert vóór de query, niet erna. Op een groot landschap is dat het verschil tussen seconden en minuten — anders dan filter_expressions, waar de docs expliciet over zijn: het draait na collectie en “does not affect the speed of the inventory plugin”.
filter_expressions laat een host vallen wanneer de expressie waar is. config.template verwijdert daarom templates, wat de eerste keer achterstevoren leest.
En de belangrijke regel is config.hardware.device, die in geen enkele standaard-property-lijst ergens staat. Het is de hele hardware-inventory van de VM, en het draagt drie dingen die deze migratie niet zonder kan: het MAC van elke NIC, de dvportgroup-key waaraan elke NIC gekoppeld is, en het datastore-pad van elke schijf. Zonder het ben je terug bij een vmware_guest_info-lus, één rondgang per VM.
De apparaten komen terug als JSON met hun vSphere-type bewaard in _vimtype. Dat is de moeite waard te weten want het is hoe je een NIC van een schijf onderscheidt. Ik controleerde de encoder in plaats van te raden:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Dus een compose-blok kan de lastige paden omhoogtrekken naar platte hostvars:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Die asymmetrie is echt en het verrast mensen. Er is geen VirtualEthernetCard-type om op te matchen. Dat is de abstracte basisklasse, en wat vCenter je werkelijk overhandigt is VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 of VirtualSriovEthernetCard. Er is geen substring die aan alle gemeen is. Een MAC hebben, echter, is een ding dat alleen een NIC doet.
Elke Info-Module Verbergt Het Veld Dat Je Nodig Hebt
Dit is de rode draad van de hele klus, en zodra je het drie keer hebt gezien begin je elke standaard te controleren voordat je de task schrijft.
vmware_dvs_portgroup_info heeft zes show_*-opties. Vijf staan standaard op true. De zesde is show_vlan_info, en die staat standaard op false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Laat het met rust en je krijgt MAC-learning-beleid, teaming-beleid, uplink-volgorde en port-beleid voor elke portgroup in het landschap. Alles behalve de VLAN-tag, wat het enige veld is waar een netwerkmigratie werkelijk om vraagt. Dus de task is binnenstebuiten van wat je instinctief zou schrijven: zet het ene ding aan, zet de andere vijf uit.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Het is geen eenmalig ding. vmware.vmware.vms heeft gather_compute_objects, dat cluster en esxi_host vult — standaard false. community.vmware.vmware_vm_info heeft show_allocated, wat het blok is dat CPU en geheugen houdt — standaard false. In alle drie de gevallen is het duur-te-verzamelen veld degene die de migratie nodig heeft, en de standaard beschermt een read-only rapportage-use-case die niet degene is waar je in zit.
vlan_id Is Drie Verschillende Types
Dan krijg je de VLAN-tags en vind je dat ze niet één vorm hebben. Rechtstreeks uit get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Een access-portgroup geeft je de string "100". Een PVLAN geeft je een string. Een trunk geeft je een lijst van strings, elk ofwel "20" of "20-30". En elke distributed switch heeft er minstens één trunk op of je er nu een maakte of niet, want de uplink-portgroup is een trunk die "0-4094" draagt.
Dus | int is niet voor je beschikbaar totdat je de andere twee vormen hebt weggegooid:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Drie rejects, in die volgorde. Trunks gaan weg, PVLAN’s gaan weg, en dan gaan untagged portgroups weg, wat ook de uplink-groepen en alles op VLAN 0 wegwerkt.
Ik vertaal trunks of PVLAN’s niet automatisch en ik zou iedereen tegenspreken die het wel deed. Een VMware-trunk die op Proxmox landt heeft ofwel een Q-in-Q-zone of een VLAN-aware VNet nodig, en welke juist is hangt af van wat de gast verwacht te zien. Dat is een beslissing, geen mapping. De playbook print ze en gaat door:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
De VLAN’s Spiegelen Naar SDN
Eén VLAN-zone gebonden aan een bridge, dan één VNet per VLAN met de tag erop.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
VNet-namen zijn kort en beperkt, en VMware-portgroup-namen niet. Production-Web-Tier-VLAN100 is een volstrekt gewone portgroup-naam en een onmogelijke VNet-naam. Dus de naam wordt gegenereerd — v100, uit de tag — en het menselijk leesbare origineel gaat in alias, waar het zichtbaar blijft in de UI en in pvesh-uitvoer. De naam afleiden van het VLAN in plaats van van de portgroup betekent ook dat de mapping zes maanden later omkeerbaar is door inspectie.
Twee portgroups op hetzelfde VLAN klappen samen tot één VNet. Dat is correct — ze waren ook in VMware hetzelfde broadcastdomein — maar je zou het moeten zien gebeuren, wat is wat unique(attribute='vlan_info.vlan_id') doet. Twee portgroups genaamd prod-web en prod-web-b, beide op VLAN 100, produceren één v100.
throttle: 1 is geen voorzichtigheid, het is de module. Elke SDN-write in community.proxmox neemt een globale clusterlock, past de pending config toe en geeft die vrij — get_global_sdn_lock(), dan apply_sdn_changes_and_release_lock(). Draai ze parallel en ze staan toch in de rij op de lock; de throttle stopt je alleen ervan te doen alsof anders. Ook de moeite waard te weten dat rollback bij falen versieafhankelijk is — de module controleert is_lock_and_rollback_supported en, op ouder PVE, vertelt je dat het niet kon terugrollen in plaats van het te doen.
Eén cosmetisch ding dat je aan jezelf zal laten twijfelen. Op 1.6.0 zendt proxmox_vnet zijn hele params-dict als een Ansible-waarschuwing bij elke enkele create:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
Dat is een debug-regel die iemand liet staan. Het is ruis, geen fout.
Bouw De Schillen, Zonder Schijven
Nu de VM’s, en dit is waar het ontwerp zichzelf verdient. Elke VM wordt in Proxmox gebouwd met het juiste CPU-aantal, het juiste geheugen, de juiste firmware en de juiste NIC’s op de juiste VLAN’s. Helemaal geen schijven.
Een schijfloze schil is snel te maken, gratis te verwijderen, en boot naar een PXE-prompt als iemand hem per ongeluk start. Je kunt er vierhonderd bouwen in een middag, naar het resultaat kijken, besluiten dat het fout is, de hele boel verwijderen en het opnieuw doen. Niets is gekopieerd, niets is uitgeschakeld, en niemand heeft het gemerkt.
De afgeleide waarden zijn declaraties, geen tasks. Ansible evalueert ze lui tegen welke host ook in scope is, dus elke VM krijgt zijn eigen zonder één enkele set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
De VMID komt uit de vCenter-MoID. vm-42 wordt 20042. Dat doet er meer toe dan het lijkt: de cutover-play moet de VM vinden die de build-play maakte, en een herdraai moet op dezelfde landen in plaats van stilletjes een tweede te bouwen. De API de volgende vrije ID laten toewijzen — wat gebeurt als je vmid weglaat, en waar ik vorige keer over schreef — maakt dat onmogelijk.
Geheugen heeft geen conversie nodig. VMware rapporteert config.hardware.memoryMB en Proxmox wil MB. Sockets wel: VMware geeft je totale vCPU’s en cores-per-socket, Proxmox wil sockets en cores.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false met opzet. Niets zou vanzelf moeten starten midden in een migratie, het minst van al een machine waarvan de schijven nog door een andere hypervisor beschreven worden.
Firmware is niet optioneel om goed te krijgen. Een UEFI-gast geïmporteerd op een SeaBIOS-VM zal perfect importeren en dan weigeren te booten, en je zult er een uur aan besteden. config.firmware is efi of bios en mapt rechtstreeks op ovmf en seabios. Een UEFI-gast heeft ook een EFI-vars-schijf nodig, die met de VM aangemaakt moet worden — zie hieronder voor waarom.
proxmox_kvm Zal Een NIC Niet Repareren, en Zal Het Je Niet Vertellen
Vorige keer schreef ik dat proxmox_kvm weigert te convergeren in plaats van te updaten. Hier is de scherpere versie daarvan, die me beet terwijl ik dit schreef en de moeite waard is precies over te zijn.
update staat standaard op false, dus herdraaien tegen een VM die al bestaat doet niets. Prima, en gedocumenteerd. Maar zet update: true en de module weigert nog steeds sommige parameters aan te raken:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Het verwijdert ze uit de aanvraag en gaat door. Dus je corrigeert een NIC in je inventory-mapping, herdraait met update: true, ziet Ansible changed melden, en de NIC is precies zo fout als hij was. De changed is waar — iets anders in de payload werd geüpdatet — maar niet het ding dat je aan het repareren was.
update_unsafe: true heft de beperking op, en de naam is eerlijk. Dezelfde waarborg dekt schijven, dus op een VM die schijven heeft is een unsafe update een goede manier om een tweede kopie van een te verwerven. Dat is geen schakelaar om tijdens een migratie naar te grijpen.
De uitweg is net helemaal niet gebruiken. NIC’s gaan erop met proxmox_nic, een module wiens hele klus één interface is en die correct convergeert:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
Dat is dezelfde splitsing waar ik vorige keer uitkwam: proxmox_kvm om de machine te definiëren, proxmox_disk en proxmox_nic voor de dingen die daarna veranderen. De parameter is mac, niet mac_addr.
efidisk0 kan niet op dezelfde manier verplaatst worden — proxmox_disk heeft geen efitype of pre_enrolled_keys — dus het moet bij het aanmaken erop en de eerste keer goed zijn.
Draag het MAC over. VMware deelt MAC’s uit vanaf 00:50:56:... en Proxmox neemt ze zonder klagen. Ze houden betekent dat DHCP-reserveringen nog matchen, MAC-locked licenties nog valideren, en elke firewallregel geschreven tegen een MAC nog vuurt. Ze veranderen betekent een dag kleine mysteries. proxmox_nic accepteert ook model: vmxnet3 als je nodig hebt dat de gast dezelfde NIC ziet die hij eerder zag, maar op KVM is virtio de betere kaart, en een Windows-gast zal hoe dan ook nieuwe drivers willen.
Weiger In Plaats Van Te Raden
Een NIC op een standaard-portgroup heeft helemaal geen backing.port. Zijn backing is een NetworkBackingInfo met een deviceName. Het zal niet in de map staan, en het juiste om te doen is stoppen:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Twee condities in plaats van één, want de eerste moet vóór de tweede draaien: map(attribute=...) over een NIC zonder port zou ontploffen op de undefined lookup. Weiger eerst de vormeloze, controleer dan de rest tegen de map.
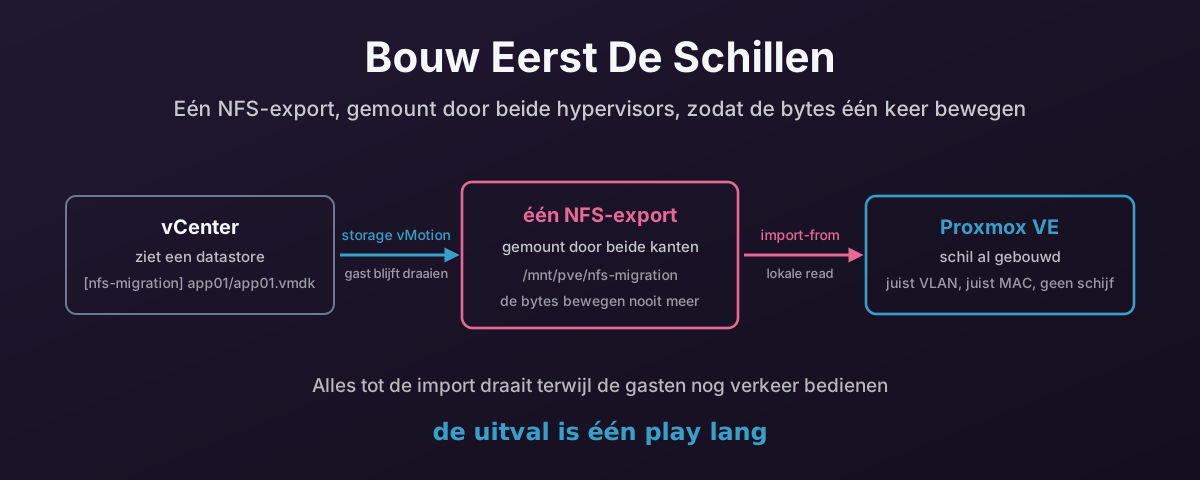
Eén Export, Twee Keer Gemount
Hier is het deel dat het hele ding goedkoop maakt.
Zet een NFS-export waar beide hypervisors het kunnen mounten. vCenter ziet een datastore genaamd nfs-migration; de Proxmox-nodes mounten dezelfde export en zien /mnt/pve/nfs-migration. Storage-vMotion nu de VMDK’s erop.
Storage vMotion is live. De gast blijft de hele tijd verkeer bedienen. Niets wordt overgezet, geen venster is nodig, en het kan halverwege afgebroken worden zonder gevolg voorbij verspilde I/O. Het is met een ruime marge de traagste fase en het kost niets.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout staat standaard op 3600 — één uur. Een VMDK van 2 TB haalt het niet, en de faalmodus is naar op een stille manier: de Ansible-task faalt terwijl de vMotion doordraait in vCenter. Je hebt nu een playbook die zegt dat het faalde en een landschap dat nog druk is. Zet het op iets dat je werkelijke storage weerspiegelt.
throttle: 2, want de bottleneck is niet de control-node. Storage vMotion wordt begrensd door de array en het netwerk. Zes tegelijk geeft je geen zes keer de doorvoer; het geeft je zes trage migraties en een boos storage-team.
De module is idempotent op de manier die je wilt — het zet storage_vmotion_needed = False als de VM al op de doel-datastore staat — dus herdraaien om achterblijvers op te pikken is veilig.
Tegen de tijd dat dit klaar is, zitten de bytes op storage die Proxmox al mount. Er hoeft ze dan ook niets anders te kopiëren. Ooit.
De Cutover
Dit is de enige play die downtime kost, en de volgorde erin is niet onderhandelbaar.
Eerst, een probleem dat makkelijk te missen is: de inventory is nu verouderd. Hij werd verzameld vóór de vMotion, dus vm_disks houdt nog de oude datastore-paden. Importeer daaruit en je wijst Proxmox naar een pad dat het niet kan zien.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Wat ook is waarom caching uitgeschakeld is in de inventory-config. Een warme cache zou refresh_inventory precies de verouderde data teruggeven die het geroepen werd te vervangen. Dat is een echte afweging — vCenter is niet snel — maar een fout pad hier is een gefaalde cutover in een venster, en de rondgang is daarbij vergeleken goedkoop.
Dan uitschakelen. Een VMDK importeren die een ESXi-host nog open heeft geeft je op zijn best een crash-consistente kopie:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest is een gracieuze afsluiting via VMware Tools; force: true stopt hard alles dat niet binnen de timeout wil. Op de nieuwe module is de parameter timeout, niet state_change_timeout zoals op de deprecated.
Dan de import, wat het draaipunt is:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
De regex_replace doet de vertaling tussen de twee werelden. vCenter noemt een schijf [nfs-migration] app01/app01.vmdk; Proxmox bereikt hetzelfde bestand op /mnt/pve/nfs-migration/app01/app01.vmdk. Zelfde export, zelfde bytes, geen tweede kopie. Je houdt de descriptor-.vmdk en negeert de -flat.vmdk ernaast — qemu-img leest de descriptor en volgt die naar de extent.
Drie dingen over import_from die allemaal in de module zitten en allemaal de moeite waard zijn te weten voordat het venster opent.
Het vuurt alleen bij create. In de update-tak:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Als scsi0 al bestaat op die VM, wordt de parameter verwijderd en krijg je een gewone update. Dus een herdraai na een slechte import her-importeert niet. Het doet stilletjes helemaal niets en meldt succes. Als een import misgaat, verwijder de schijf voordat je het opnieuw probeert.
timeout staat standaard op 600 seconden. Tien minuten, om de schijf van een virtuele machine te importeren en te converteren. De eigen documentatie van de module zegt hem te verhogen; neem het advies.
En een absoluut pad heeft root nodig. De documentatie is er bot over:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Wat ongemakkelijk landt tegen het advies dat ik vorige keer gaf, en nog steeds achtersta: gebruik een scoped API-token, geen root. Dat advies houdt voor elke andere fase hier: discovery, SDN, schillen bouwen, boot-volgorde zetten werken allemaal prima met een token. Deze ene task niet, en geen hoeveelheid privilege op de rol zal het veranderen, want de beperking zit op de gebruiker die root is in plaats van op een permissie.
Er zijn drie eerlijke uitwegen, en geen slimme vierde:
- PVE 9.x: gebruik
<storage>:import/<file>en blijf op het token. - PVE 8.x: doe deze ene task als
root@pam, en alleen deze ene. - PVE 8.x, geen root over de API: draai in plaats daarvan
qm importdiskover SSH.
De playbook neemt de eerste twee via een flag, want anders doen zou het probleem alleen verschuiven naar wie het ook draait.
Ten slotte de boot-volgorde, wat een gewone update is en daarom onaangeraakt door de update_unsafe-beperking:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Niks start de gast. Dat is bewust. Start hem met de hand, kijk hem opkomen, en denk pas dan aan het verwijderen van iets in VMware.
Het Draaien
Het hele ding is één playbook, getagd per fase, want dit zijn geen stappen die je samen wilt draaien:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit is overal je vriend. Doe eerst één VM. Doe één cluster. De playbook heeft geen mening over hoeveel je afbijt, en de inventory geeft je groepen gratis — power_poweredOn, cluster_<name>, plus vmware_windows en vmware_linux uit het groups-blok.
Controleer waar je naar wijst voordat je ernaar wijst:
ansible-inventory --graph
ansible-inventory --host some-vm
Waar Ik Nog Steeds Op Zou Letten
Dingen die ik verwacht te vinden wanneer dit een echt landschap ontmoet, nu opgeschreven zodat ik achteraf niet kan beweren dat ik ze zag aankomen:
- Windows-gasten booten niet schoon van een VirtIO SCSI-controller zonder dat de driver eerst aanwezig is.
virtio-scsi-singleis de juiste controller en de verkeerde om aan een Windows-VM te overhandigen die hem nooit heeft gezien. Dat is een heel probleem op zichzelf en het wordt door niets hierboven opgelost. - VMware Tools zou eraf moeten voor de verplaatsing, niet erna.
- Snapshots. Een VM met een snapshot-keten heeft meer dan één
.vmdkper schijf en de basis importeren geeft je de toestand vóór de snapshot. Consolideer eerst. - De
config.hardware.device-volgorde is wat beslist welke schijfscsi0wordt. Het heeft overal waar ik heb gekeken de eigen volgorde van de gast gematcht, maar ik zou het op een multi-disk-databaseserver controleren voordat ik het in een venster vertrouw. - Independent- en RDM-schijven zullen niet storage-vMotionen zoals gewone.
Niets daarvan verandert de vorm. Bouw eerst de schillen, verplaats de schijven terwijl alles nog draait, en houd de uitval bij de ene play die het nodig heeft.