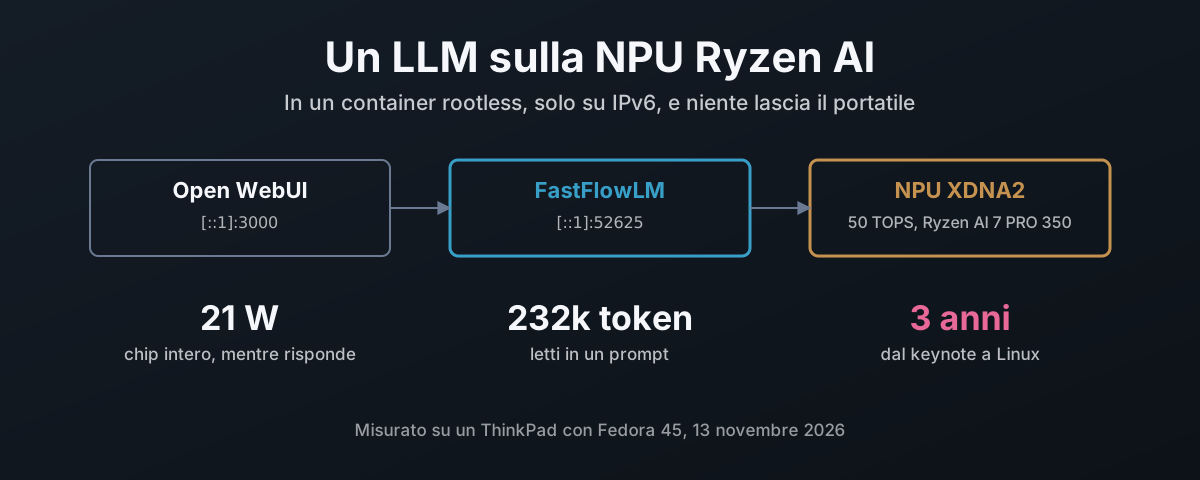
Un LLM sulla NPU Ryzen AI, in un container
La NPU di un portatile Ryzen AI vale 50 TOPS e sulla maggior parte delle installazioni Linux resta ferma. Qui si compila il driver amdxdna di AMD tenendo sull’host solo il modulo del kernel, si costruisce FastFlowLM con il runtime XRT di AMD in un container podman rootless allineato a quel driver, si lega tutto al loopback IPv6 e lo si avvia al boot con Quadlet. Poi cosa fa: nove modelli misurati, un test di contesto da 232.000 token, Whisper che trascrive la voce a dieci volte il tempo reale, Open WebUI e i 7.000 token nascosti che aggiungeva a ogni messaggio, e velocità ed energia della NPU misurate contro llama.cpp sulla iGPU Radeon 860M. Infine la cronologia: tre anni dall’annuncio di Ryzen AI a un modello linguistico sulla sua NPU sotto Linux, arrivato da un progetto che AMD non ha avviato, mentre lo sforzo andava a Copilot+ sul Fisher-Price OS (Windows) invece che al data centre e agli strumenti Linux che i professionisti dell’AI usano davvero.