Quando chiedi una pagina non gira niente
Questa settimana il progetto PHP ha rilasciato le correzioni per PHP2Shell, e il suo avviso diceva che l’attacco può scattare “before any application code runs”1. Ho scritto cosa significa per PHP in PHP: ventinove anni a lasciare la porta aperta. Questo articolo parla dell’altra metà della risposta. E se non girasse proprio niente?
È così che funziona questo blog. Quando hai chiesto questa pagina, nessun mio programma si è avviato, ha letto un database, ha controllato un login o ha costruito dell’HTML. Ti è stato rimandato un file che esisteva già. Tutto qui.
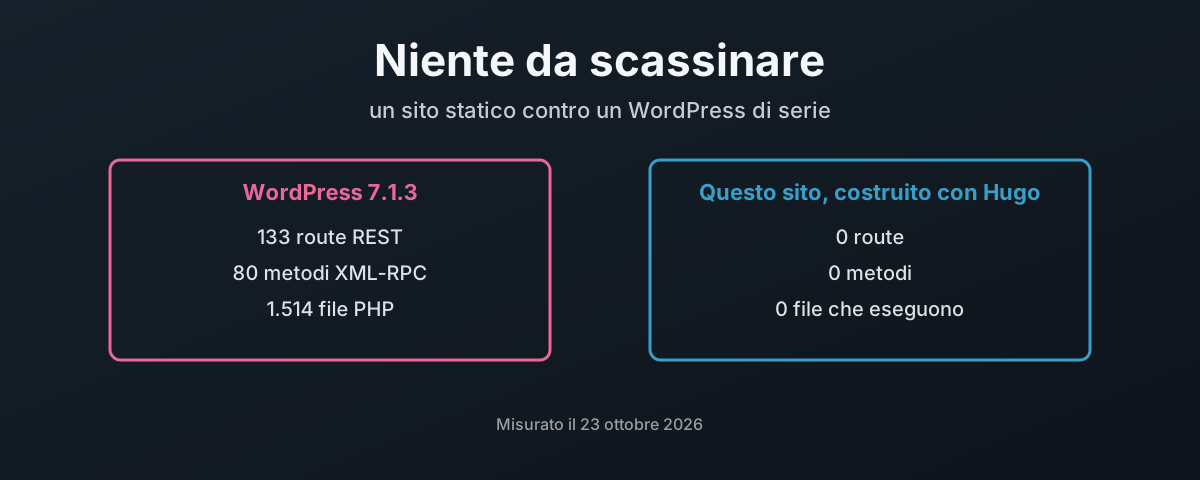
Ecco come si presenta quella differenza, misurata lo stesso giorno, su un WordPress di serie installato da zero in laboratorio e su questo sito così com’è online adesso:
| WordPress 7.1.3 di serie | Questo sito | |
|---|---|---|
| Route della REST API | 133 | 0 |
| Route REST che accettano scritture | 62 | 0 |
| Metodi XML-RPC | 80 | 0 |
| File eseguiti sul server | 1.514 PHP | 0 |
| File scrivibili dall’utente che serve il sito | 3.785 su 3.785 | nessuno: non gira niente che possa scrivere |
| Database | 12 tabelle, account applicativo con tutti i privilegi | nessuno |
| Pagina di login | wp-login.php, attiva | nessuna; il percorso restituisce 404 |
| Un POST, PUT o DELETE sulla home page | PHP gira e genera comunque la pagina | rifiutato all’edge con 405; non gira niente |
Nessuno di quegli zeri è un’impostazione che ho spento. Sono zeri perché la cosa che contano qui non esiste. Non puoi attaccare una pagina di login che non è mai stata costruita.
Cosa mette su internet un WordPress di serie
Non volevo sostenerlo a memoria, quindi l’ho misurato. Le immagini container ufficiali wordpress e mariadb, avviate in podman sulla mia macchina e legate a localhost, installate senza aggiungere niente: nessun plugin oltre a quelli inclusi, il tema predefinito, un amministratore. WordPress 7.1.3 su PHP 8.3.36. Poi ho contato a cosa risponde.
La REST API è la superficie singola più grande. Cinque namespace, 133 route, 257 coppie di route e metodo, e 62 route che accettano una scrittura di qualche tipo. È arrivata nel core con WordPress 4.7, “with REST API endpoints for posts, comments, terms, users, meta, and settings”2. E ti dicono di non spegnerla: “You should not disable the REST API; doing so will break WordPress Admin functionality that depends on the API being active.”3 Quindi resta accesa.
| Cosa è esposto di default | Cosa dice la documentazione di WordPress stessa |
|---|---|
| XML-RPC, 80 metodi | attivo di default dalla 3.5: “Enable XML-RPC by default, remove Writing Settings option”4 |
| la REST API, 133 route | “content that is public on your site is generally publicly accessible via the REST API”5 |
| l’elenco degli utenti | GET /wp/v2/users restituisce nome visualizzato, slug, link e avatar di ogni autore nella vista predefinita6 |
wp-login.php e xmlrpc.php | “xmlrpc.php is a frequent brute‑force target”; “Apply rate limits to /wp-login.php and /xmlrpc.php globally.”7 |
wp-cron.php | “WP-Cron works by checking, on every page load, a list of scheduled tasks to see what needs to be run.”8 |
| l’editor di temi e plugin | “This is often the first tool an attacker will use if able to login, since it allows code execution.”9 |
L’elenco degli utenti merita una seconda occhiata. Nel mio laboratorio, una richiesta anonima a quell’endpoint ha restituito l’unico account amministratore, con nome visualizzato e slug. Qualcuno che non ha mai fatto login scopre quali sono gli account del sito prima di aver provato qualsiasi cosa, su un’installazione da zero, per progetto. Nessuno ha dovuto configurarlo male.
Poi i file. L’immagine ufficiale fa girare Apache come www-data, e www-data possiede tutta la web root. Tutti i 3.785 file, compresi i 1.514 file PHP, sono scrivibili dallo stesso utente che esegue il codice. Ogni file. Il codice compreso. wp-config.php, con dentro la password del database, sta nella web root con modo 644. L’account di database che usa WordPress ha ALL PRIVILEGES sul suo database.
È il modello a processo unico dell’articolo su PHP, attivo e non modificato, dall’immagine ufficiale. Non è un sito gestito male. È il punto di partenza da cui comincia ogni sito WordPress, prima che entri il primo plugin.
E i plugin sono da dove arriva la maggior parte del problema. Patchstack ha contato 11.334 nuove vulnerabilità nell’ecosistema WordPress nel 2025. “91% of new vulnerabilities were found in plugins, and 9% were found in themes. There were only 6 vulnerabilities reported in the WordPress core.”10 Quasi la metà non aveva una correzione nel momento in cui è stata resa pubblica, e il tempo mediano fino allo sfruttamento di massa, per quelle che interessavano agli attaccanti, è stato di cinque ore10.
Cosa mette su internet questo sito
Questo blog è 6.343 file. Eccolo tutto, per tipo:
| Tipo di file | Numero | Cos’è |
|---|---|---|
.html | 3.486 | le pagine, in cinque lingue |
.xml | 1.576 | feed RSS e sitemap |
.svg | 1.181 | diagrammi, copertine, icone |
.png | 46 | screenshot |
.json | 10 | l’indice di ricerca e i timbri di build |
.js | 4 | piccoli script che girano nel tuo browser, non sul server |
.css, font e il resto | 40 | stili, e file allegati agli articoli |
| Eseguiti sul server | 0 |
Ci sono alcuni file .py e .sh lì dentro. Sono script allegati agli articoli perché i lettori li scarichino, e il server li manda come testo. Niente sul server li esegue. Sul server non c’è niente con cui eseguirli.
È pubblicato su Cloudflare come asset statici, senza nessuno script Worker. La configurazione di deploy non ha un entry point, e la documentazione di Cloudflare dice cosa significa: “The main key is optional for assets-only Workers.”11 Quando un percorso richiesto corrisponde a un file, “that file will be served” senza invocare codice Worker, e “If no Worker script is present, a 404 Not Found response is returned.”12 E non costa niente: “Requests to static assets are free and unlimited.”13
Cloudflare è una scelta, non un requisito. Il risultato è una cartella di file, e qualsiasi server HTTPS capace di mandare un file può servirlo: nginx, Caddy, un Apache che serve solo file statici, o un bucket di object storage dietro una CDN. I link sono relativi, quindi la stessa build si serve invariata dalla radice di un dominio o da una sottodirectory; è stato verificato servendo il sito costruito sotto /preview/ e confermando che tutti i 592 riferimenti locali su sei pagine si risolvevano. Cambiare host significa copiare una cartella. L’unico pezzo specifico di Cloudflare è il file _headers; altrove, gli stessi header vanno nella configurazione del server. Quello che si porta dietro è la proprietà che conta. Qualunque cosa lo serva deve solo mandare file, quindi non deve mai eseguire il tuo codice.
Quindi il sito online risponde così:
$ for m in POST PUT DELETE; do curl -s -o /dev/null -w "$m %{http_code}\n" -X $m https://blogs.damiendye.uk/en/; done
POST 405
PUT 405
DELETE 405

$ for p in wp-login.php xmlrpc.php wp-admin/ wp-json/; do curl -s -o /dev/null -w "%{http_code} $p\n" https://blogs.damiendye.uk/$p; done
404 wp-login.php
404 xmlrpc.php
404 wp-admin/
404 wp-json/
Non risponde niente. È il progetto.
Gli header di sicurezza escono con ogni file da un file di testo semplice _headers nel repository, che Cloudflare legge al deploy14. La Content Security Policy blocca ogni script, stile, immagine, font e connessione su quest’unica origine. Sarò franco sulla lacuna: script-src e style-src portano ancora 'unsafe-inline', perché il tema scrive nella pagina alcuni piccoli script. È il lavoro in sospeso su quel file, ed è scritto nel repository esattamente come tale.
E pubblicare non ha bisogno di una porta. Su WordPress, pubblicare è una scrittura via HTTP: l’editor, la REST API e XML-RPC esistono perché è così che gli articoli arrivano sul server, e ognuno di loro è una via d’ingresso. Qui scrivo un articolo come file di testo e lo pusho in un repository Git, e la build carica i file finiti attraverso l’API di deploy di Cloudflare. Niente di ciò che serve il sito accetta una scrittura dal web, perché a niente serve. Anche il repository è privato. Chiedilo a GitHub senza le mie credenziali e la risposta è un 404, quindi i sorgenti, le bozze e la cronologia non sono su internet nemmeno loro.
La superficie d’attacco è un conteggio, non una sensazione
OWASP definisce la superficie d’attacco come “the sum of all paths for data/commands into and out of the application, and the code that protects these paths”15, e dice che il modo per ridurla è “turning off features and interfaces that aren’t being used”15. Il National Cyber Security Centre britannico la mette in modo più brusco: “If would-be attackers can’t reach an interface, they can’t attack it.”16 Il suo schema Cyber Essentials ne fa un requisito: “remove or disable unnecessary software (including applications, system utilities and network services)”17.
Quindi conta le vie, per quello che sono e non per quante sono:
| Via d’ingresso o d’uscita | WordPress | Sito statico |
|---|---|---|
| login e tentativi di indovinare le password | wp-login.php, XML-RPC | nessuna |
| interfaccia di amministrazione | /wp-admin/, con un editor di codice | nessuna |
| API programmabile | REST e XML-RPC, con scritture | nessuna |
| codice lato server per ogni richiesta | core, tema, ogni plugin | nessuno |
| database | sì, raggiungibile da tutto quanto sopra | nessuno |
| storage scrivibile sul server | uploads, e nell’immagine di serie, tutto | nessuno |
| job pianificati fatti scattare dai visitatori | wp-cron.php al caricamento della pagina | nessuno |
| codice di terzi che devi tenere aggiornato | ogni plugin e tema, sul server | gli strumenti di build, fuori dal server |
| cosa ottiene un attaccante con una sessione rubata | il sito | niente in cui entrare |
Nove righe. Nessuna di loro esegue codice sul server. Tutte per lo stesso motivo. Il lavoro è stato fatto prima che qualcuno chiedesse una pagina.
La penultima riga è il rovescio onesto della medaglia, e il resto di questo articolo parla di quello. Un sito statico esegue comunque del codice. Solo che lo esegue da un’altra parte, una volta, prima di pubblicare.
Come Hugo tiene onesta la build
Hugo è “a static site generator written in Go”18, quindi il programma che fa la build è a sua volta memory safe e compilato, e dopo l’articolo su PHP questo conta. La sua pagina sulla sicurezza traccia la linea esattamente dove la traccia questo articolo: il risultato “runs directly in the browser”, ma “during development and site building, the hugo executable itself is the runtime environment.”19 E sul servizio, chiaro e tondo: “We have no online production server”19. Bene.
Dentro la build, è blindato di default. “Hugo’s built-in security policy, which restricts access to os/exec, remote communication, and similar operations, is configured via allowlists. By default, access is restricted.”20
| L’impostazione predefinita di Hugo | Cosa impedisce |
|---|---|
| “No arbitrary commands”19 | un template non può lanciare comandi sulla macchina |
exec.allow limitato a Sass, Go, Git, Node e PostCSS20 | solo strumenti nominati, con flag fissi |
funcs.getenv limitato a ^HUGO_ e ^CI$20 | i template non possono leggere i tuoi segreti dall’ambiente |
| i fetch remoti rifiutano host che sono indirizzi IP o localhost20 | un template non può entrare nella tua rete |
i moduli verificati contro go.sum19 | una dipendenza manomessa fa fallire la build |
Questo sito ne allarga una apposta. Aggiunge le variabili di commit della CI a funcs.getenv, così il timbro di build in /en/version.json può registrare quale commit ha costruito il sito online. È una scelta fatta e scritta, che è il senso di una allowlist. Per questo non è un buco. È una decisione.
Dove si sposta il rischio: la build
Togli il server e il rischio non sparisce. Si sposta su quello che costruisce i file. Il framework SLSA nomina con precisione le due minacce: una “build integrity threat”, in cui un avversario introduce “behavior to an artifact without changing its source code”, e una “dependency threat”, “compromising some other artifact that the former depends on at build time”21.
Questo sito sta nella riga di mezzo, e non ho intenzione di fingere il contrario. Fa la build nel container di Cloudflare a ogni push sul repository. Quel container non è il server che ti risponde, e sparisce quando la build finisce. Ma per la durata della build, gli si affida tutto quello che finisce sul sito.
E la build aveva due lacune, che ho trovato tutte e due scrivendo questo articolo. Una è chiusa. L’altra è una scelta.
| Lacuna | Perché conta | Stato |
|---|---|---|
| il binario di Hugo era preso sulla fiducia: il download dello script stesso non aveva controllo del checksum, e in CI saltava comunque il download e usava la copia installata dall’immagine di build di Cloudflare | un binario sostituito costruirebbe quello che gli pare | chiusa, 23 ottobre 2026: la build scarica sempre Hugo da sé, lo verifica contro lo SHA-256 pubblicato della release22, e rifiuta di costruire se non corrisponde |
il tema segue il suo ramo master upstream a ogni build | un cambiamento upstream può alterare il sito online senza un commit qui | aperta, per scelta; la soluzione è fissarlo a un commit, o spostarlo in un modulo Hugo coperto da go.sum19 |
La prima è il genere di cosa che trovi solo leggendo il tuo script di build riga per riga. Lo script controllava la versione. Ma una stringa di versione è qualcosa che un binario dice di sé. Non prova niente sui byte. Adesso i byte vengono controllati:
Fetching Hugo Extended 0.167.0...
Hugo verified: sha256 0163f5c3deddac1f494a1629ddc40c65d18de9d5794facd98f7f96ac2c7d8957
E una copia dello stesso tarball con un byte in più viene rifiutata:
Refusing to build: hugo_extended_0.167.0_linux-amd64.tar.gz does not match the release checksum
  expected 0163f5c3deddac1f494a1629ddc40c65d18de9d5794facd98f7f96ac2c7d8957
  got      92682d765d9d34bc53d6f818d56e598d34b5b8267a1cc3b9971da0f53c792251
Il tema è un compromesso deliberato, aggiornamento contro riproducibilità, ed è scritto come tale. Ma è esattamente la minaccia sulle dipendenze descritta da SLSA, e la cosa onesta è dirlo. Nessuna delle due lacune ha mai esposto il sito online a un visitatore. Entrambe erano fiducia riposta nella build, e preferisco elencarle piuttosto che lasciarle trovare a un lettore.
Anche il checksum ha un limite. Prova che il file che hai scaricato è il file sulla pagina della release. Non prova chi ce l’ha messo: tra i file della release non ci sono firme22. È integrità, non autenticità, ed è il massimo che il progetto offre oggi.
Costruirlo offline, una volta
La versione più rigorosa toglie la build dalle macchine di chiunque altro. Fai la build su una macchina che possiedi e controlli, verifica quello che hai costruito e carica solo i file finiti. Niente su internet esegue mai la tua build, e l’host non vede altro che il risultato.
| Passo | Perché |
|---|---|
| installa la release esatta di Hugo e verificala contro lo SHA-256 pubblicato | sai quale binario ha costruito il tuo sito |
fissa il tema e i moduli a dei commit, e fai commit di go.sum | la build cambia solo quando la cambi tu |
costruisci in una directory di output pulita, senza --buildDrafts | quello che pubblichi è quello che volevi pubblicare |
| cerca qualsiasi cosa eseguibile nell’output prima che parta | un sito statico non deve contenere niente che il server eseguirebbe |
| carica solo la directory di output, con una credenziale che può solo fare deploy | l’host non tiene mai i tuoi sorgenti, i tuoi strumenti o la tua cronologia |
| servilo da un host che non esegue codice per i file statici | al momento del servizio non resta niente da aggiornare |
Sono pochi comandi, non un progetto. E cambia dove deve trovarsi un attaccante per farti del male. Per cambiare un sito WordPress gli basta una richiesta al server. Per cambiare questo tipo di sito gli serve la tua macchina di build. È un bersaglio molto più piccolo, ed è uno che puoi staccare dalla presa.
Diecimila pagine, misurate
La superficie d’attacco è un costo dell’eseguire codice a ogni richiesta. L’elettricità è un altro, e anche il disco. Quindi li ho messi entrambi sotto lo stesso carico: 10.000 richieste della home page, dieci alla volta, dallo stesso portatile, in HTTP semplice su localhost così che nessuna delle due parti pagasse il TLS. Da un lato il WordPress di serie del laboratorio. Dall’altro, i veri file costruiti di questo sito serviti da nginx in un container, perché sull’edge di Cloudflare non posso mettere un contatore. Ho letto il tempo di CPU usato da ogni container dal suo cgroup prima e dopo ogni esecuzione, tre esecuzioni ciascuno.
| 10.000 richieste di pagina | WordPress 7.1.3 di serie | Questo sito su nginx |
|---|---|---|
| Tempo di CPU, tre esecuzioni | 409 s, 530 s, 575 s | 0,15 s, 0,18 s, 0,19 s |
| Tempo di CPU per pagina | da 41 a 57 ms | da 15 a 19 µs |
| Pagine al secondo | da 168 a 236 | da 23.679 a 28.044 |
| Memoria sotto carico | da 302 a 310 MiB, più 145 MiB per il database | 15 MiB |
| Richieste fallite | 0 | 0 |
Sono da due a tremila e cinquecento volte il tempo di processore per le stesse diecimila pagine. Ognuno di quei secondi di CPU è stato preso dalla presa e trasformato in calore. Il lato statico ha servito tutte le 10.000 pagine più o meno nel tempo di processore che WordPress ha speso su tre o quattro delle sue.
Il disco racconta la stessa storia:
| Su disco e in memoria | WordPress di serie | Questo sito |
|---|---|---|
| Immagini container per farlo girare | 803 MB WordPress, 334 MB MariaDB | 166 MB nginx, o niente del tutto su Cloudflare |
| Il sito vero e proprio | 115 MB di web root, per un sito vuoto | 114 MB, cinque lingue, ogni articolo e diagramma |
| Database | 163 MB di file che contengono 0,72 MB di dati | nessuno |
| Memoria a riposo | 170 MiB, più 139 MiB per il database | 13 MiB |
I dati di WordPress sono un’installazione da zero con un articolo di esempio. Quelli statici sono questo blog intero.
Per essere onesti con WordPress, un plugin di cache a pagina intera chiuderebbe buona parte del divario di CPU. Ma guarda cos’è quella soluzione. È una copia statica di ogni pagina, messa davanti al PHP così che il PHP non giri. La cura è proprio la cosa che questo articolo sostiene, imbullonata di fianco alla cosa contro cui argomenta, con la pagina di login, l’API e il database tutti ancora lì dietro.
A cosa rinunci
L’elenco onesto, perché un sito statico non è lo strumento giusto per tutto:
| Rinunci a | Cosa fa invece questo sito |
|---|---|
| commenti | niente; i lettori possono mandare un’email |
| ricerca lato server | un indice JSON costruito con il sito, cercato nel tuo browser |
| moduli che inviano al server | niente |
| login e aree riservate | niente; qui è tutto pubblico |
| modifica nel browser | gli articoli sono file di testo in un repository git |
| pubblicazione istantanea senza build | una build richiede un minuto o due |
Se ti servono un negozio, un’area riservata o degli account utente, ti serve qualcosa che giri su un server, e questo articolo non ti dice il contrario. Quello che ti dice è che un blog, un sito vetrina o un insieme di documentazione non ha bisogno di niente di tutto questo. La maggior parte dei siti WordPress è una di queste tre cose. Sii onesto su quale sia il tuo.
Costruiscilo una volta e servilo morto
Quello che non mi va giù è quanto rischio ci si porta dietro senza nessun motivo. Una pagina aziendale che cambia due volte l’anno, con un database, una pagina di login, un’API con 62 route scrivibili e un esecutore di job pianificati che parte ogni volta che qualcuno visita. Tutto lì per produrre lo stesso HTML che ha prodotto ieri. Ogni giorno.
Non è una decisione tecnica. È un’abitudine, ed è un’abitudine che qualcuno fattura. Hosting, plugin, componenti aggiuntivi di sicurezza, la pulizia quando va male. Il prezzo è un piano WordPress gestito. Il costo è ognuna di quelle vie tenuta aperta, e aggiornata, e sorvegliata, per contenuti che potevano essere una cartella di file.
Lo standard a cui tengo questo sito è semplice. Non gira niente che non serva. Ogni lacuna è scritta dove la troverà la prossima persona, comprese le due nella build, e una di quelle è già chiusa. Non è questione di essere furbi. Uno standard è quello che mantieni quando nessuno controlla, e nessuno controlla un blog fino al giorno in cui comincia a servire il codice di qualcun altro.
Quindi costruiscilo una volta, verifica quello che hai costruito, e servilo morto. Quello che resta da attaccare è sulla tua macchina, che è dove deve stare.
PHP — News archive 2026, 21st October — “We consider the risk highest for mod_php, with a demonstrated exploit where an unauthenticated request can trigger the attack before any application code runs”. ↩︎
WordPress 4.7 release notes — “WordPress 4.7 comes with REST API endpoints for posts, comments, terms, users, meta, and settings.” ↩︎
WordPress REST API Handbook — Frequently Asked Questions — “You should not disable the REST API; doing so will break WordPress Admin functionality that depends on the API being active.” ↩︎
WordPress 3.5 release notes — “Enable XML-RPC by default, remove Writing Settings option”. ↩︎
WordPress REST API Handbook — “content that is public on your site is generally publicly accessible via the REST API”. ↩︎
WordPress REST API reference — Users —
GET /wp/v2/users, contesto predefinito “view”; name, slug, link, avatar_urls nel contesto view. ↩︎WordPress — Brute force attacks — “xmlrpc.php is a frequent brute‑force target”; “Apply rate limits to /wp-login.php and /xmlrpc.php globally.” ↩︎
WordPress Plugin Handbook — Cron — “WP-Cron works by checking, on every page load, a list of scheduled tasks to see what needs to be run.” ↩︎
WordPress — Hardening WordPress — l’editor della Dashboard “is often the first tool an attacker will use if able to login, since it allows code execution.” ↩︎
Patchstack — State of WordPress Security in 2026 — dati 2025: 11.334 nuove vulnerabilità; 91% plugin, 9% temi, 6 nel core; 46% non corrette in tempo per la divulgazione; mediana di 5 ore fino allo sfruttamento di massa. ↩︎ ↩︎
Cloudflare — Wrangler configuration — “The main key is optional for assets-only Workers.” ↩︎
Cloudflare — Workers static assets — un file corrispondente “will be served” senza invocare codice Worker; “If no Worker script is present, a 404 Not Found response is returned.” ↩︎
Cloudflare — Static assets billing and limitations — “Requests to static assets are free and unlimited.” ↩︎
Cloudflare — Static assets headers — header impostati da “a plain text file called _headers”. ↩︎
OWASP — Attack Surface Analysis Cheat Sheet — “the sum of all paths for data/commands into and out of the application, and the code that protects these paths”; si riduce con “turning off features and interfaces that aren’t being used”. ↩︎ ↩︎
NCSC — Making compromise difficult, 2.2 Reduce attack surface — “If would-be attackers can’t reach an interface, they can’t attack it.” ↩︎
NCSC — Cyber Essentials: Requirements for IT infrastructure v3.2 — “remove or disable unnecessary software (including applications, system utilities and network services)”. ↩︎
Hugo — Introduction — “Hugo is a static site generator written in Go, optimized for speed and designed for flexibility.” ↩︎
Hugo — Security model — “during development and site building, the hugo executable itself is the runtime environment”; “We have no online production server”; “No arbitrary commands”; un checksum go.sum che non corrisponde fa fallire la build. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Hugo — Configure security — “By default, access is restricted”; allowlist predefinite per exec, getenv e http. ↩︎ ↩︎ ↩︎ ↩︎
SLSA v1.2 — Threats — minaccia all’integrità della build: “behavior to an artifact without changing its source code”; minaccia sulle dipendenze: “compromising some other artifact that the former depends on at build time”. ↩︎
Hugo v0.167.0 release — 36 asset tra cui
hugo_0.167.0_checksums.txt(SHA-256); nessun file di firma, SBOM o attestazione. ↩︎ ↩︎