Il presupposto di ogni orologio
L’orologio di un computer funziona contando qualcosa di regolare e fidandosi che continui a contare. Un cristallo oscilla, un contatore si incrementa, e il software calcola quanto tempo è passato.
La virtualizzazione rompe la parte della fiducia.
La documentazione del kernel sulla gestione del tempo in KVM mette il problema in una frase: «the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption.» Tutto quello che segue discende da qui.
La tua vCPU non è sempre in esecuzione
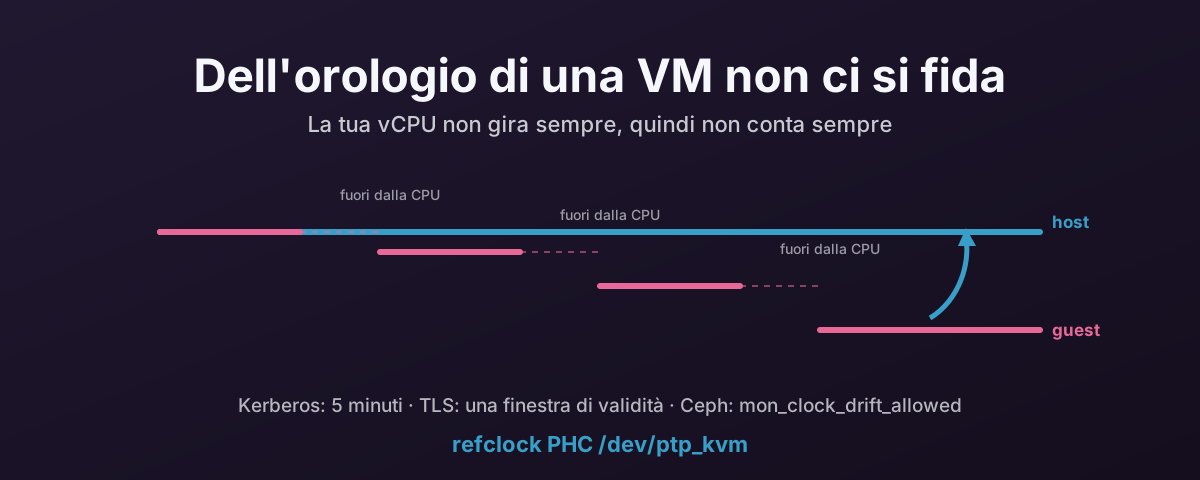
Una vCPU è un thread sull’host. Gira quando lo dice lo scheduler dell’host.
Quando non gira, il guest non è semplicemente inattivo: è assente. Non può contare, non può servire un interrupt del timer, e non ha modo di sapere quanto è rimasto via. L’host lo registra come steal time, che è il nome onesto per «tempo che ti è capitato invece che tempo per te».
Gli interrupt del timer sono dove fa più male. Un guest che chiede un tick periodico chiede all’host di consegnare interrupt a una frequenza fissa, e l’host non sempre può accontentarlo. Di nuovo dalla documentazione del kernel: «the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind.»
Più alta è la frequenza dei tick peggio va, e un host in overcommit peggiora ancora le cose. È anche il motivo per cui un host carico degrada la gestione del tempo dei guest tranquilli. Sono tutti in coda per gli stessi core fisici.
Nemmeno i contatori sono tuoi
Se i tick periodici sono inaffidabili, la risposta ovvia è leggere un contatore. Che ha i suoi problemi.
Il TSC è quello veloce, e la documentazione del kernel è brutale al riguardo: «The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times.» La sua frequenza può variare con gli stati di risparmio energetico del processore, e sui chip più vecchi si ferma del tutto quando il core è inattivo. Una vCPU che migra tra core fisici può quindi leggere un contatore che non concorda con quello letto un microsecondo prima.
Le alternative sono peggio in un altro modo. HPET, PIT e il timer ACPI PM sono tutti dispositivi emulati, quindi ogni lettura è una trap nell’hypervisor. Corretti, e abbastanza costosi che un guest che legge l’orologio in un ciclo stretto se ne accorge.
Ecco perché esistono gli orologi paravirtuali. Su KVM, kvm-clock permette all’host di pubblicare la propria gestione del tempo in una struttura condivisa che il guest legge direttamente: niente trap, niente conteggio, nessun presupposto che il guest fosse sveglio.
Ed è anche il motivo per cui dovresti lasciare in pace la clocksource del guest invece di forzare tsc o hpet perché un post su un forum diceva che era più veloce.
Migrazione, snapshot e sospensione
Migrazione live, ripristino di uno snapshot e sospensione/ripresa fanno tutti la stessa cosa all’orologio di un guest: lo fermano, e poi lo fanno ripartire da un’altra parte.
Quello che il guest vede non è una deriva, è un salto. L’orologio aveva un valore, e adesso ne ha un altro, senza niente in mezzo. Migrare su un host il cui TSC gira a una frequenza diversa aggrava la cosa.
I salti contano perché il software che corregge gli orologi è fatto per correggere la deriva, non il teletrasporto.
Non è un problema di KVM
Viene la tentazione di leggere tutto quanto sopra come un difetto di KVM. Non lo è.
Ogni hypervisor include un orologio paravirtuale, perché ogni hypervisor ha lo stesso problema strutturale: KVM ha kvm-clock, Hyper-V ha la sua reference TSC page, VMware ha un contatore pseudo-performance più la sincronizzazione via Tools, Xen ha il suo pvclock. Sono quattro implementazioni indipendenti dello stesso ripiego.
La conclusione della stessa documentazione del kernel è che qui non esiste una soluzione perfetta. Solo compromessi tra precisione, prestazioni e complessità.
Se lo vuoi sentire da un vendor invece che dagli sviluppatori del kernel, il limite di supporto di Microsoft per il tempo ad alta precisione è sorprendentemente schietto. Per dichiarare una precisione di 50 ms su un sistema Windows virtualizzato, uno dei requisiti indicati è che «the one-day average CPU utilization of the host must not exceed 90%.» Per 1 ms, l’host deve restare sotto l'80%.
Rileggilo: la precisione dell’orologio del guest è documentata come subordinata a quanto è carico l’host. Non è una stranezza di Windows, è la stessa fisica descritta dalla documentazione del kernel, messa per iscritto come limite di supporto.
Perché NTP dentro il guest è lo strumento sbagliato
NTP è bravo in ciò per cui è stato progettato: una macchina con un oscillatore vero che va un po’ veloce o un po’ piano, corretta misurando il giro di andata e ritorno verso un server remoto e regolando dolcemente l’orologio locale.
Ognuno di questi presupposti è traballante in una VM.
L’oscillatore locale non è un po’ sbagliato, è a tratti assente. La misura del giro di andata e ritorno la fa un processo che può essere tolto dalla CPU tra la lettura dell’orologio e l’invio del pacchetto, e questo corrompe la misura stessa. E le correzioni necessarie dopo una migrazione sono salti, che un algoritmo di regolazione graduale gestisce male o rifiuta del tutto.
chrony se la cava molto meglio di ntpd qui. Regola più in fretta, tollera i salti, ed è onesto sulla propria incertezza. Ma sta comunque risolvendo il problema sbagliato: tirare il tempo attraverso una rete da un server di stratum 2 a 20 ms di distanza, quando il tempo giusto sta nell’hypervisor, dall’altra parte di un singolo confine di memoria.
Quello che ottieni in pratica è un guest che ha quasi sempre ragione, ogni tanto è fuori di decine o centinaia di millisecondi, e non è mai del tutto in grado di dirti quando.
Cosa rompe davvero lo scarto
A nessuno importa degli orologi in sé. Importa quando qualcosa smette di funzionare.
Kerberos e Active Directory
Kerberos dipende dal tempo per progetto, perché la validità di un ticket è espressa come una finestra temporale.
La documentazione di krb5.conf del MIT definisce clockskew come «the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid», e il default è 300 secondi, cioè cinque minuti.
Supera quel limite e l’autenticazione non degrada, fallisce.
E siccome l’autenticazione di Active Directory è Kerberos, vuol dire login al dominio, net use, connessioni a SQL Server, Exchange, condivisioni di file: tutto quanto.
Cinque minuti sembrano generosi finché un guest non fa un salto all’indietro dopo il ripristino di uno snapshot.
TLS
Un certificato porta con sé una finestra di validità: notBefore e notAfter.
Un guest con l’orologio indietro rifiuterà un certificato emesso stamattina perché, per quanto ne sa lui, il certificato non è ancora valido.
Un guest con l’orologio avanti ne rifiuterà uno che in realtà non è scaduto.
La stessa aritmetica governa la freschezza di OCSP e CRL, i claim JWT nbf/exp e i codici TOTP per l’autenticazione a più fattori, che vivono in finestre di 30 secondi.
Un orologio fuori di 45 secondi è un’interruzione dell’autenticazione con un messaggio d’errore molto confuso.
Ceph
I monitor di Ceph ci tengono più di quasi qualunque altra cosa nello stack, perché il loro consenso dipende da questo.
Il controllo di salute MON_CLOCK_SKEW scatta quando «the clocks on hosts running Ceph Monitor daemons are not well-synchronized». In particolare, quando lo scarto supera mon_clock_drift_allowed.
Il consiglio della documentazione è sincronizzare con ntpd o chrony su più sorgenti, e fa notare che la sincronizzazione tra monitor conta in modo particolare.
Puoi alzare mon_clock_drift_allowed, ma la documentazione è chiara: deve restare «significantly below the mon_lease interval». Per questo è un budget piccolo, e spenderlo per tappare un problema di gestione del tempo dell’hypervisor non è un buon affare.
Tutto il resto
I log tra host smettono di correlarsi, e la timeline di un incidente diventa un tirare a indovinare. La replica dei database e il consenso distribuito (etcd, Galera, qualunque cosa faccia leader lease) ne soffrono. Le finestre di backup e di monitoraggio si disallineano dalla cosa che dovevano osservare.
I guest Windows sbandano in modo diverso
Windows merita una nota a parte, perché il suo servizio del tempo è stato costruito con obiettivi diversi e si vede.
Microsoft dichiara senza giri di parole che le versioni precedenti a Windows 10 1607 / Server 2016 «can’t guarantee highly accurate time». Quello che il servizio Windows Time forniva in quelle versioni era «the necessary time accuracy to satisfy Kerberos version 5 authentication requirements» e «loosely accurate time» per le macchine in una foresta AD comune. Più stretto di così era «outside of the design specification… and weren’t supported.»
In altre parole, il Windows più vecchio punta a restare dentro la finestra di cinque minuti di Kerberos, non ad avere l’ora giusta. Il che va bene finché qualcosa nella tua infrastruttura non ha bisogno di meglio. Una macchina Windows virtualizzata fuori di 90 secondi si autentica tranquillamente mentre scrive log che non si possono correlare con niente.
Da Windows 10 e Server 2016 in poi si può arrivare a 1 s, 50 ms o anche 1 ms, ma solo alle condizioni citate prima, compresi i limiti di utilizzo della CPU dell’host. Microsoft fa anche notare che «anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy». Una vCPU contesa è carico di CPU elevato sul sistema di destinazione sotto un altro nome.
Non esiste ptp_kvm per Windows. Quello che hai invece:
- Le enlightenment di clock di Hyper-V. Proxmox le espone già ai guest Windows.
PVE::QemuServer::CPUConfigimpostahv_timeinsieme ahv_vapic,hv_spinlocks,hv_relaxedehv_synic.hv_timeè l’orologio paravirtuale, ed è l’equivalente lato Windows dikvm-clock. È attivo di default per le VM di tipo Windows; non c’è niente da abilitare. - Il QEMU guest agent. Con l’agent installato, l’host può spingere la sua ora nel guest dopo una ripresa o il ripristino di uno snapshot, e questo gestisce il caso del salto, quello che NTP gestisce peggio.
- Scegli un’unica autorità. Il classico guasto di Windows in una VM sono due sorgenti di tempo che litigano: sincronizzazione host-guest e sincronizzazione dalla gerarchia del dominio, entrambe a correggere lo stesso orologio in direzioni opposte. Per un guest unito al dominio, lascia vincere la gerarchia del dominio e impedisci all’host di spingergli l’ora. Per un guest standalone, la sincronizzazione dall’host va bene. Mai entrambe.
Se vuoi sapere esattamente cosa racconta il tuo hypervisor a una certa VM riguardo al tempo, chiediglielo invece di tirare a indovinare:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
La soluzione su QEMU/KVM: ptp_kvm
Per i guest Linux su KVM c’è una risposta come si deve, e non è «più server NTP».
ptp_kvm permette al guest di chiedere all’host che ora è, direttamente, tramite una hypercall: KVM_HC_CLOCK_PAIRING su x86, e una chiamata firmware equivalente su arm64.
Il kernel la presenta come un dispositivo di orologio hardware PTP, quindi dallo spazio utente sembra una qualsiasi altra sorgente di tempo di precisione, e chrony la può usare come orologio di riferimento.
Le proprietà che contano:
- Nessuna rete. Niente jitter, niente asimmetria, niente stratum, niente pacchetti. Il percorso è un confine di memoria.
- Sotto il microsecondo. La precisione è limitata dalla hypercall, non da un giro di andata e ritorno attraverso un datacenter.
- Aggira la parte rotta. Il guest non sta contando niente né stimando un giro di andata e ritorno. Sta leggendo un valore che l’host ha calcolato con un orologio che è rimasto in funzione per tutto il tempo.
Implementazione
Applicalo a ogni VM Linux che ha il driver. L’hypervisor host deve avere a sua volta un NTP o PTP funzionante. ptp_kvm consegna al guest l’ora dell’host, quindi ne eredita l’errore.
1. Carica il modulo del kernel all’avvio.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Dagli un nome stabile e lascia che chrony lo legga.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
Il symlink conta perché la numerazione dei dispositivi PTP non è stabile. /dev/ptp0 può essere l’orologio di una NIC a un avvio e l’orologio KVM a quello dopo. Fare il match su clock_name prende quello giusto ogni volta.
3. Punta chrony lì, e togli i pool.
Modifica /etc/chrony/chrony.conf su Debian e Ubuntu, o /etc/chrony.conf sulla famiglia RHEL. Cancella le righe pool e usa:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Togliere i pool non è pulizia facoltativa. Lasciarli chiede a chrony di conciliare un riferimento locale sotto il microsecondo con server su internet a decine di millisecondi di distanza, e le sorgenti su internet possono solo peggiorare la risposta.
4. Riavvia e controlla.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Verifica
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
In chronyc sources, il refclock PHC compare come #* PHC0 una volta selezionato. Il # indica un riferimento hardware locale invece di un peer di rete, e l’* lo indica come quello in uso.
Se lo vedi elencato ma non selezionato, chrony non l’ha accettato: controlla i permessi sul dispositivo e che il gruppo chrony nella regola udev corrisponda all’utente con cui chrony gira davvero sulla tua distribuzione.
Avvertenze
- L’host deve avere ragione. Questo fa sì che il guest concordi con l’host, il che serve solo se l’host concorda con la realtà. Dai agli hypervisor un NTP o PTP vero.
- Ogni guest ne ha bisogno. Una flotta in cui metà delle VM usa
ptp_kvme metà usa pool su internet è una flotta con due autorità del tempo. - La migrazione live va bene, ed è proprio il punto. Dopo la migrazione, il guest legge l’orologio del nuovo host. Purché gli host concordino tra loro, il guest non vede mai un salto.
- Solo KVM. È una hypercall di KVM. Hypervisor annidati o di altro tipo non presenteranno il dispositivo, e la regola udev semplicemente non scatterà. È un fallimento pulito invece di una risposta sbagliata in silenzio.
Cosa non fare
- Non forzare la clocksource. Lascia in pace
kvm-clock. Forzaretscohpetsulla riga di comando del kernel del guest scambia un orologio paravirtuale progettato per questa situazione con un contatore che non è mai stato tuo. - Non lanciare
ntpdateohwclockda cron. È un salto a orario fisso, esattamente ciò che database e Kerberos odiano. - Non tenere i pool «come riserva». Con un refclock funzionante non sono una riserva, sono un secondo parere da una fonte peggiore.
- Non alzare
mon_clock_drift_alloweddicendo che è risolto. Hai speso parte di un budget che esiste per la realtà della rete, per tollerare un problema che ha una soluzione nota.
Quest’ultimo vale la pena dirlo chiaro: allargare la soglia non è sistemare l’orologio. È spostare l’allarme perché smetta di suonare.
Riferimenti
- Linux kernel — KVM timekeeping — perché il tempo del guest resta indietro, il problema del TSC come orologio locale, e la conclusione che esistono solo compromessi
- Linux kernel — PTP_KVM — l’interfaccia hypercall dietro il dispositivo di orologio PTP
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, il lato x86 - chrony — chrony.conf — la direttiva
refclocke le opzioni del driver PHC - MIT Kerberos — krb5.conf —
clockskewe il suo default di 300 secondi - Microsoft — support boundary for high accuracy time — gli obiettivi di precisione, e le condizioni di utilizzo della CPU dell’host per i sistemi virtualizzati
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowede il suo rapporto conmon_lease