Meno byte arrivano al drive
VDO è lo strato di deduplicazione e compressione del kernel Linux. Sta sotto un volume group e lavora a blocchi da 4 KiB. Ogni blocco che ha già visto, lo memorizza una volta sola.
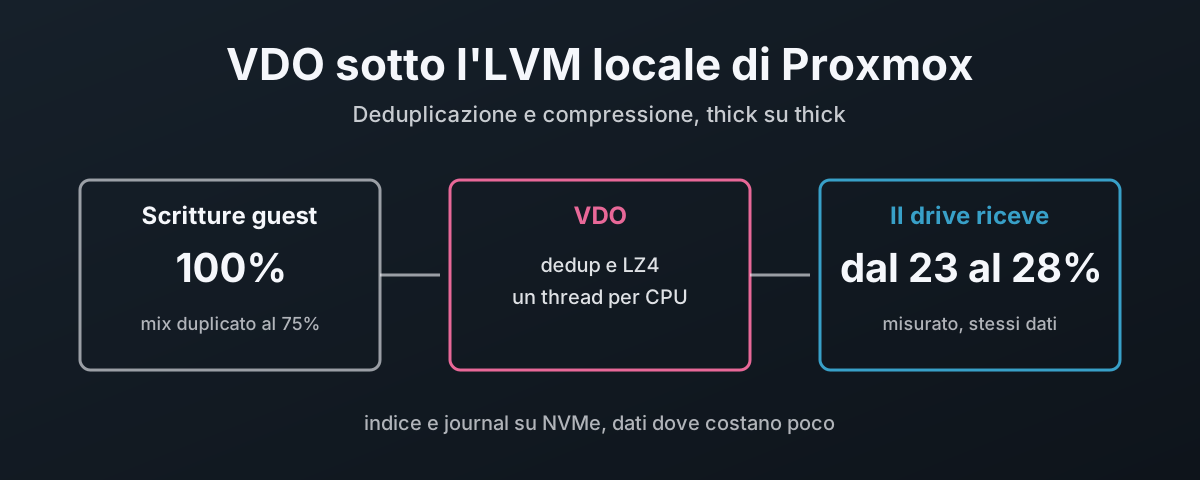
Cosa significa per l’hardware è semplice. Al drive arrivano meno byte. Ho scritto attraverso VDO un mix al 75% duplicato e al 50% comprimibile, 30 secondi alla volta, e i contatori del drive stesso dicevano che aveva ricevuto dal 23 al 28% di ciò che il guest aveva scritto. Sei cloni completi del disco di un template hanno aggiunto in tutto 8 blocchi di dati. Trentadue kilobyte.
Meno byte significa meno usura, e meno lavoro per qualsiasi cache sul drive o sul controller davanti a esso. Per arrivarci costa CPU e latenza, e su un drive veloce quel costo è misurato più sotto contro la stessa Optane senza VDO. Sui dischi rotanti lenti lo stesso costo sparisce dentro i tempi di seek, ed è lì che la cosa si fa interessante.
Due regole danno forma a tutto ciò che segue. Lo stack è thick su thick: niente sopra VDO, e VDO stesso, può promettere più spazio di quello che ha il drive. E i metadati propri di VDO, l’indice e i journal, possono vivere su NVMe mentre i dati vivono su qualcosa di più lento.
Ogni numero qui viene da un solo host Proxmox VE 9.2, un Ryzen 7 5700G con 16 CPU, kernel 7.0.14-25-pve, LVM 2.03.31 e gli strumenti vdo 8.3.1.1 di Debian, su due drive Intel Optane cancellati al termine.
Cos’è VDO e dove si trova
Il kernel descrive dm-vdo come un target device-mapper che «provides block-level deduplication, compression, and thin provisioning»1. Ogni blocco da 4 KiB in arrivo viene sottoposto a hash. Se un blocco identico è già memorizzato, VDO registra un riferimento invece di una copia. I blocchi che non sono duplicati passano per LZ4 e vengono impacchettati in più d’uno per blocco fisico, e i blocchi fatti solo di zeri non vengono memorizzati affatto2.
È LVM a guidare il tutto.
lvcreate --type vdo crea un VDO pool, che contiene i blocchi reali, e sopra di esso un VDO LV con la dimensione virtuale che chiedi2.
Sul VDO LV va un volume group thick, e Proxmox lo usa come normale storage lvm.
| Strato | Nome nel laboratorio | Cosa fa |
|---|---|---|
| Dischi delle VM | vm-9901-disk-0 e così via | LV thick, creati da Proxmox |
| Volume group | vdovg, 35 GiB | LVM normale, ciò che legge lo storage lvm di Proxmox |
| VDO LV | vdolab/vdolv, 35 GiB virtuali | dedup, LZ4, blocchi di zeri scartati |
| VDO pool | vdolab/vdopool, 40 GiB | i blocchi reali, i metadati e l’indice di VDO |
| Fisico | nvme8n1 | VG vdolab |
Thick su thick, o niente
VDO è un thin provisioner a pieno titolo: al VDO LV si può dare qualsiasi dimensione virtuale. Fallo più grande di quanto il pool possa contenere e il volume group sopra è thick su una promessa, cioè thin su thin spostato di uno strato più in basso. L’ho fatto proprio così nella prima build, un VDO LV da 120 GiB su un pool da 40 GiB, e Proxmox mostrava un terzo dello storage libero mentre VDO era pieno.
Quindi dimensiona il VDO LV su ciò che il pool può davvero indirizzare, non di più.
lvcreate stampa quella cifra, «can address 36.00 GB» su questo pool da 40 GiB, e la block map di VDO per lo spazio logico esce dallo stesso spazio, quindi gli ho dato 35 GiB.
Poi l’ho dimostrato nel modo più duro. Un solo disco di VM che prende ogni extent che Proxmox gli concede, 34 GiB, riempito da cima a fondo con dati casuali su cui VDO non può fare niente:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
Il disco si è esaurito alla sua fine, come deve fare un disco thick. VDO aveva ancora 1,9 GiB liberi, più dell'1 GiB che a Proxmox restava da allocare. La cifra di Proxmox è il limite reale, e VDO non può esaurirsi per primo.
Ciò a cui rinunci è l’overcommit: lo spazio che la deduplicazione risparmia si presenta come drive che non viene mai scritto, non come dischi in più per Proxmox. È lo scambio giusto per questo post, che parla dell’hardware. E non metterci sopra nemmeno un pool lvmthin. Due strati thin sono due libri contabili3.
Quanto costa prima di memorizzare un byte
VDO tiene un indice di deduplicazione, l’indice UDS, sul pool stesso.
Un pool da 40 GiB vuoto riportava 4,0 GiB usati e 36,0 GiB disponibili.
vdolistmetadata, dallo stesso pacchetto vdo, elenca ogni blocco di metadati sul dispositivo, e ne spiega quasi tutto:
| Regione | Blocchi da 4 KiB | Dimensione |
|---|---|---|
| Indice UDS | 679.127 | 2,59 GiB |
| Recovery journal | 32.768 | 128 MiB |
| Reference count e journal, 18 slab | 6.372 | 25 MiB |
| Spazio troppo piccolo per un diciannovesimo slab | 336.555 | 1,28 GiB |
| Totale | circa 4,0 GiB |
La riga degli avanzi vale la pena conoscerla: gli slab sono da 2 GiB, quindi dimensiona il pool in slab interi più l’overhead, altrimenti il resto rimane semplicemente inutilizzato.
La RAM è l’altro conto. Si paga che il pool sia occupato o fermo:
| Costo | Regola da lvmvdo(7) | Questo pool da 40 GiB |
|---|---|---|
| Fisso | 38 MiB | 38 MiB |
| Cache della block map | 1,15 MiB per MiB di cache, minimo 150 MiB | 150 MiB (128 MiB di default) |
| Spazio fisico | 268 MiB per TiB | 11 MiB |
| Indice UDS (dense) | minimo 250 MiB, il default | 256 MiB |
| Totale | circa 455 MiB |
L’indice dense di default copre una finestra di deduplicazione di circa 256 GiB, visto che un indice dense con 1 GiB di RAM «maintains a 1 TiB deduplication window»2. La cache della block map da 128 MiB è dimensionata per un «efficient access to 100 GB of logical space at a time», e la documentazione del kernel la indica come il valore più importante da regolare quando il working set cresce1.
Costruire lo stack
Lasciare che LVM veda un PV su un LV
Il volume group sta su un LV, e di default LVM ignora gli LV come volumi fisici.
devices/scan_lvs lo attiva, e il riferimento di LVM porta con sé l’avvertenza che va insieme: «Caution is required to avoid using PVs that belong to guest images stored on LVs»4.
Altrimenti un guest che usa LVM dentro il proprio disco si vedrebbe comparire i suoi volume group sull’host.
Quindi cambia anche il filtro. Stessa modifica. Il filtro di serie su questo host rifiutava solo gli zvol ZFS e i dispositivi RBD. Ho aggiunto un rifiuto per ogni disco di VM di Proxmox:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
Lo stesso riferimento dice che scan_lvs «does not enable autoactivation of layered VGs»4.
A Proxmox non serve. Il suo plugin LVM attiva ogni disco con lvchange -aey quando la VM si avvia5.
L’ho provato nello stato in cui lo lascia un boot, tutto disattivato e poi le stesse esecuzioni udev di pvscan: il VG sotto VDO è salito, e qm start ha attivato da sé il disco della VM.
Il tranello sta sotto. Con il VG sotto VDO incompleto, lo stesso qm start falliva con «Volume group “vdovg” not found».
Il VDO pool, thick, con le impostazioni sulla riga di creazione
Il formattatore è nel pacchetto vdo di Debian6:
# apt install vdo
Poi il pool.
-L è lo spazio reale, -V la dimensione virtuale, tenuta dentro ciò che il pool può indirizzare.
La disposizione dei thread e la dimensione del discard vanno sulla stessa riga, perché nessuna delle due si può cambiare dopo senza fermare tutte le VM sul pool:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
La disposizione dei thread è quella misurata più sotto per un host con 16 CPU; max_discard=4096 ha una sezione tutta sua.
Il volume group e lo storage di Proxmox
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 conta, ed è trattato più sotto.
Quanto ha risparmiato la deduplicazione
Ho scritto cose che un host Proxmox memorizza davvero e dopo ognuna ho letto i contatori di blocchi di VDO.
logical blocks used è ciò che hanno scritto gli strati sopra; data blocks used è ciò che VDO ha memorizzato. Entrambi sono blocchi da 4 KiB.
| Cosa è stato scritto | Blocchi logici aggiunti | Blocchi di dati aggiunti | Risparmiato |
|---|---|---|---|
| Rootfs di Rocky Linux 10, ext4 su un disco da 4 GiB | 114.505 | 60.537 | 47% |
Sei cloni completi (qm clone --full, circa 4 s ciascuno) | 6.291.456 | 8 | 99,9999% |
| ISO di Proxmox Datacenter Manager 1.1, 1,36 GiB | 356.172 | 351.965 | 1,2% |
La sua ricostruzione -auto, quasi gli stessi byte | 356.399 | 40 | 99,99% |
| 4 GiB di zeri | 1.048.575 | 0 | 100% |
| 1 GiB di dati casuali | 262.143 | 262.144 | 0% |
Ogni clone ha scritto tutti i 4 GiB, zeri compresi, perché un clone completo su un LV thick copia ogni blocco. VDO ha memorizzato gli zeri come niente e il resto come riferimenti.
VDO è bravissimo con i dati che ha già visto. E con il niente. È inutile su dati già compressi o cifrati, ed è per questo che la prima ISO, quasi tutta squashfs, ha risparmiato l'1,2%.
Con il template e i suoi sei cloni al loro posto, Proxmox mostrava lo storage all'80,01% usato, 28 GiB di dischi thick su 35. Il drive conteneva 4,3 GiB, e la maggior parte era l’indice. Su uno storage thick il punto è proprio questo: Proxmox conta ciò che è stato allocato, e il drive porta ciò che è davvero diverso.
Cosa riceve davvero il drive
Il risparmio su disco è un’istantanea. All’hardware importa il flusso.
Così ho misurato i byte che arrivavano al drive durante la scrittura: fio per 30 secondi, il contatore di scrittura del drive da /sys/block prima e dopo, la stessa Optane con e senza VDO, due volte ciascuno.
Il contatore è onesto. Su tutta la serie di prove ha sommato 794 GB, e anche i «Data Units Written» SMART del drive si sono mossi di 794 GB.
| Carico di lavoro, 30 s | Senza VDO | Con VDO, 16 thread | Byte che arrivano al drive |
|---|---|---|---|
| Scrittura casuale 4k, QD32, 4 job, 75% dup, 50% compress | 582.013 IOPS, p99 244 µs | 460.887 IOPS, p99 1,05 ms | 28% |
| Scrittura 128k, QD8, 75% dup, 50% compress | 2.345 MiB/s, p99 490 µs | 2.179 MiB/s, p99 1,02 ms | 23% |
| Scrittura casuale 4k, QD32, 4 job, dati casuali | 571.721 IOPS | da 272.366 a 381.005 IOPS | dal 59 al 100% |
| Scrittura 128k, QD8, dati casuali | 2.346 MiB/s | da 1.051 a 1.854 MiB/s | 100% |
Su un mix realistico, VDO ha mantenuto dal 79 al 93% del throughput del drive nudo e gli ha mandato un quarto dei byte. Su dati completamente casuali non risparmia niente e costa parecchio, e le due esecuzioni erano così in disaccordo che do solo l’intervallo.
La latenza di coda è l’elaborazione di VDO stesso, non il drive. Un p99 di circa un millisecondo, contro un quarto di millisecondo a nudo.
L’Optane non ha nessuna cache da alleggerire
Questi drive lo dicono da soli: vwc 0 da nvme id-ctrl, write through in /sys/block.
Un’Optane scrive sul posto senza staging in DRAM o SLC, quindi su questo hardware il guadagno sono i byte e l’usura, non una cache del drive che si riempie più lentamente.
Un SSD NAND con una cache SLC, o un controller RAID con una cache write-back, è dove meno byte comprano anche reattività. È la sezione sul RAID6 più sotto.
Allineare i thread di VDO alle CPU
Di serie LVM dà a VDO dieci thread: uno logical, uno physical, uno hash zone, due CPU, quattro di bio submission, uno di acknowledgement. Su un host con 16 CPU questo lascia ferma la maggior parte della macchina mentre il lavoro sulla block map di VDO fa la coda dietro un unico thread logical.
La documentazione del kernel spiega le manopole1. I thread logical possiedono ciascuno «a disjoint section of the block map», quelli physical «a disjoint section of the data blocks», ed entrambi «can increase throughput», mentre i thread in eccesso «can waste resources and increase contention». I thread logical arrivano fino a 60, quelli physical fino a 16, e il pool ha bisogno di almeno uno slab per thread physical. Con 18 slab questo ha spazio.
| Disposizione | logical | physical | hash | cpu | bio | ack | Totale |
|---|---|---|---|---|---|---|---|
| Default di LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Allineata a 16 CPU | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Il doppio | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Ogni disposizione ha eseguito gli stessi job di fio due volte, alternati, con dati casuali, più tutti e sette i dischi clone letti insieme come quando sette VM si avviano insieme:
| Test, media di due esecuzioni | Default | Allineata a 16 CPU | Il doppio |
|---|---|---|---|
| Scrittura casuale 4k, QD32, 4 job | 292.466 IOPS | 365.314 IOPS | 302.461 IOPS |
| p99 scrittura casuale 4k, 4 job | da 2,1 a 3,7 ms | da 1,5 a 1,6 ms | da 2,1 a 2,2 ms |
| Scrittura sequenziale 1M | 1.153 MiB/s | 1.729 MiB/s | 1.507 MiB/s |
| Lettura casuale 4k, QD32, 4 job | 507.450 IOPS | 503.827 IOPS | 485.263 IOPS |
| Sette dischi clone letti insieme | 7,5 s | 3,1 s | 3,4 s |
Allineata al numero di CPU vince quasi tutto: un quarto in più di scritture parallele, la metà in più sulle scritture sequenziali, sette dischi letti 2,4 volte più in fretta, e una coda più stretta. Raddoppiare ancora è peggio su tutta la linea. È la contesa da cui mette in guardia la documentazione. I default erano anche i meno stabili, con la lettura dei sette dischi che oscillava da 6,1 a 8,8 s tra un’esecuzione e l’altra.
Per questo la regola è un thread VDO per CPU, distribuiti tra i tipi come sopra, con i thread physical limitati dal numero di slab.
Quanto costa VDO su hardware veloce
La stessa Optane senza VDO, contro VDO con i thread allineati, dati casuali, media di due esecuzioni:
| Test | Optane, senza VDO | VDO, 16 thread |
|---|---|---|
| Scrittura casuale 4k, QD1 | 42.294 IOPS, 19,4 µs | 55.806 IOPS, 12,1 µs |
| Scrittura casuale 4k, QD32 | 142.416 IOPS | 144.292 IOPS |
| Scrittura casuale 4k, QD32, 4 job | 572.293 IOPS | 365.314 IOPS |
| Lettura casuale 4k, QD1 | 55.276 IOPS, 14,4 µs | 27.988 IOPS, 31,4 µs |
| Lettura casuale 4k, QD32, 4 job | 586.463 IOPS | 503.827 IOPS |
| Scrittura sequenziale 1M, QD8 | 2.348 MiB/s | 1.729 MiB/s |
| Sette dischi template letti insieme | 11,1 s | 3,1 s |
Leggila senza giri di parole. Una singola lettura casuale attraverso VDO richiede più del doppio del tempo. Le scritture casuali parallele perdono più di un terzo, quelle sequenziali un quarto. Su un drive così veloce, i 17 µs di lavoro extra di VDO per ogni lettura sono la maggior parte della lettura.
La scrittura QD1 più veloce attraverso VDO non è un pasto gratis. Tutt’altro. VDO conferma una scrittura prima che sia sul drive, e la documentazione del kernel è chiara: «unflushed writes may or may not persist after a crash»1. Quel numero misura una conferma. Un guest che fa flush, come fa ogni filesystem, ottiene la durabilità che chiede.
La riga dei sette dischi è quella che VDO vince nettamente, e vale la pena essere chiari sul perché. Sette copie normali devono leggere 28 GiB di byte reali, zeri compresi. VDO legge un solo insieme di blocchi condivisi e salta gli zeri.
Quindi sulla flash veloce VDO scambia latenza con byte. Ognuno di quei microsecondi però è un costo fisso, e non cresce quando il drive sotto diventa più lento.
Mettere i metadati di VDO su NVMe
VDO non ha un dispositivo separato per i metadati. Tutto vive sull’unico LV del pool. Ma il sorgente di dm-vdo mostra che la disposizione è fissa, e un LV si può costruire con pezzi su drive diversi.
Il codice di formattazione mette le radici della block map dall’inizio della regione dati, poi lo slab summary e il recovery journal dalla fine, e riempie il mezzo con gli slab7.
L’indice UDS sta prima di tutto, subito dopo il blocco di geometria.
vdolistmetadata lo ha confermato sul pool del laboratorio:
| Blocchi | Cosa | Dove si trova |
|---|---|---|
| da 0 a 679.188 | geometria, indice UDS, super block, radici della block map | i primi 2,59 GiB |
| dentro ogni slab da 2 GiB | dati, foglie della block map, 130 blocchi di reference e uno slab journal da 224 blocchi | sparsi per il pool |
| da 10.452.928 a 10.485.695 | recovery journal | gli ultimi 128 MiB, quasi |
| da 10.485.696 a 10.485.759 | slab summary | gli ultimissimi 256 KiB |
Quindi costruisci l’LV del pool in tre pezzi: la testa su NVMe, il mezzo sul drive lento, la coda su NVMe.
Poi convertilo in un VDO pool, cosa che lvmvdo(7) documenta per un LV esistente2.
Qui nvme6n1 fa la parte della NVMe e nvme8n1 quella del drive lento:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Poi controlla che VDO abbia messo i metadati dove stanno gli extent:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Un extent è 1.024 blocchi. La testa su NVMe sono gli extent da 0 a 767, blocchi da 0 a 786.431, che copre l’indice e le radici, con circa 420 MiB di dati del primo slab che si aggiungono al viaggio. La coda su NVMe sono gli extent da 10.176 a 10.239, blocchi da 10.420.224 in poi, che copre il recovery journal e lo slab summary.
Quanta parte del lavoro di VDO si sposta con loro, per esecuzione da 30 secondi, contata per dispositivo:
| Carico di lavoro | I/O di scrittura NVMe | I/O di scrittura sul drive dati | Quota NVMe |
|---|---|---|---|
| Scrittura casuale 4k, 75% dup, 50% compress | da 388.430 a 538.223 | da 3,42 a 3,63 milioni | dal 10 al 13% |
| Scrittura 128k, 75% dup, 50% compress | da 458.214 a 634.167 | da 3,30 a 3,53 milioni | dal 12 al 15% |
| Scrittura casuale 4k, dati casuali | da 181.457 a 384.507 | da 3,25 a 8,49 milioni | dal 4 al 5% |
| Lettura casuale 4k | 0 scritture, 2% delle letture | 0 |
Circa un decimo delle operazioni di scrittura: il recovery journal, gli aggiornamenti dell’indice, e quella fetta dello slab 0 sulla testa NVMe. Sono scritture di metadati piccole e sparse, il tipo che un disco rotante gestisce peggio. Su NVMe non sono niente.
Due limiti.
I metadati per slab, reference count, slab journal e foglie della block map, vivono dentro gli slab, e restano con i dati.
E non ho provato a far crescere un pool diviso. Il journal viene posizionato dalla fine, quindi dopo qualsiasi lvextend lancia di nuovo vdolistmetadata e guarda dove è finito prima di fidarti.
VDO su bcache: una NVMe, due lavori
bcache è l’altro modo di mettere la flash davanti ai dischi lenti. È quello che uso già sotto Ceph sui drive rotanti, con ogni impostazione spiegata nel post su bcache. Quindi la domanda è cosa fa VDO a una cache bcache quando ci sta sopra.
Una sola NVMe fa entrambi i lavori della flash, divisa in due partizioni:
| Dispositivo | Dimensione | Lavoro |
|---|---|---|
nvme8n1p1 | 32 GiB | cache bcache, writeback |
nvme8n1p2 | 8 GiB | testa e coda di VDO: indice, radici, recovery journal, slab summary |
nvme6n1 | 349 GiB | dispositivo di backing di bcache, dove vivono i dati |
/dev/bcache0 | 349 GiB | il mezzo del VDO pool, gli slab |
Entrambi i drive sono di nuovo Optane, quindi nvme6n1 fa le veci del disco rotante.
Tienilo a mente per ogni cifra qui sotto. Il dispositivo di backing qui è veloce, quindi questo misura cosa arriva alla cache, non quanto ci mette un mandrino a svuotarla.
Le partizioni e il cache set, con le impostazioni di quel post:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Quelle righe echo durano fino al prossimo riavvio. La regola udev nel post su bcache è il modo per renderle permanenti.
Poi il pool, diviso come sopra, con nvme8n1p2 per le due estremità e bcache0 per il mezzo:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata ha stampato gli stessi intervalli di blocchi della build divisa, quindi l’indice e i due journal stanno su nvme8n1p2.
vdovg e lo storage di Proxmox vanno sopra esattamente come prima.
Cosa arriva alla cache
Il confronto è un LV da 8 GiB direttamente su bcache0 contro un LV da 8 GiB in vdovg, gli stessi job di fio per 30 secondi, due volte, con la cache svuotata e pulita tra un’esecuzione e l’altra.
I contatori dei dispositivi in /sys/class/block dicono dove sono andati i byte.
| 75% dup, 50% compress, 30 s | Solo bcache | VDO su bcache |
|---|---|---|
| Scrittura casuale 4k, QD32, 4 job | 212.222 e 205.585 IOPS | 390.206 e 304.757 IOPS |
| p99 | 1,89 e 2,04 ms | 1,45 e 2,54 ms |
| Scritto dal guest | 24,29 e 23,53 GiB | 44,67 e 34,88 GiB |
| Scritto nella cache bcache | 25,00 e 24,26 GiB | 11,48 e 10,44 GiB |
| Scritto sulla partizione dei metadati di VDO | 1,18 e 0,59 GiB | |
| Scritture in cache per byte del guest | 103% | 26 e 30% |
| Rimasto dirty in cache alla fine | 6,0 e 6,5 GiB | 5,5 e 5,2 GiB |
| Scrittura 128k, QD8 | 2.001 e 1.985 MiB/s | 1.878 e 1.416 MiB/s |
| Scritture in cache per byte del guest, 128k | 101% | 24 e 27% |
bcache da solo si è fermato a circa 210.000 scritture piccole al secondo, e ha scritto ogni byte nella cache più un 3% suo. Metti VDO davanti e la cache ha preso un quarto dei byte. Nella prima esecuzione la stessa cache ha poi portato 390.206 scritture al secondo, quasi il doppio, e ha finito comunque con meno dati dirty in attesa del drive lento. Il limite era la cache. VDO lo ha spostato.
La seconda esecuzione è quella onesta per un pool che è già stato usato. Di default fio inizializza i suoi generatori allo stesso modo a ogni esecuzione8, quindi la seconda esecuzione ha scritto dati che l’indice aveva già visto, puntando a blocchi che nel frattempo erano stati scartati. VDO tratta l’indice come suggerimenti e legge ogni blocco candidato per verificare che sia davvero un duplicato prima di condividerlo9. Durante un test di sola scrittura, quella seconda esecuzione ha riletto 7,11 GiB dalla cache e 1,20 GiB dal drive dati. La prima 0,12 GiB. Un consiglio scaduto non è gratis, e su un pool dove le VM vanno e vengono ce ne sarà sempre un po'.
I dati casuali sono l’altra faccia:
| Dati casuali, 30 s | Solo bcache | VDO su bcache |
|---|---|---|
| Scrittura casuale 4k, QD32, 4 job | 205.984 e 203.066 IOPS | 203.186 e 85.882 IOPS |
| p99 | 2,04 e 2,15 ms | 5,7 e 17,7 ms |
| Scrittura 128k, QD8 | 2.038 e 2.017 MiB/s | 878 e 357 MiB/s |
| Lettura casuale 4k, QD1 | 36.609 e 36.639 IOPS, 21,6 µs | 26.345 e 26.202 IOPS, 33,6 e 33,7 µs |
| Lettura casuale 4k, QD32, 4 job | 471.585 e 471.730 IOPS | 335.461 e 336.941 IOPS |
Niente da risparmiare, quindi VDO è puro overhead, e nell’esecuzione con l’indice scaduto ha più che dimezzato le scritture piccole. Ogni lettura in entrambe le colonne è venuta dalla cache. I 12 µs di VDO in più sono lo stesso costo fisso che aggiunge sull’Optane nuda.
Quindi dove i dati si ripetono, i due si sommano bene. La cache riceve un quarto dei byte, regge un picco più a lungo, e ha meno da riscrivere sui dischi rotanti. Dove non si ripetono, bcache sta meglio da solo.
Su RAID6 hardware con HDD: ragionato, non misurato
Non ho un host RAID6 con HDD su cui provare, quindi questa sezione è un ragionamento costruito sulle misure di sopra. Misura il tuo array prima di farci affidamento.
| Su RAID6 con HDD | Cosa cambia VDO |
|---|---|
| Scritture che arrivano all’array | circa un quarto, su un mix come quello misurato |
| Cache write-back del controller | si riempie a un quarto della velocità, quindi regge un picco circa quattro volte più a lungo |
| Costo in CPU di VDO | 17 µs per lettura, persi dentro un seek da 5 a 10 ms |
| Scritture del recovery journal | circa un decimo degli I/O di scrittura, piccole e con flush: mettile su NVMe |
| Ricerche nell’indice | tieni d’occhio dedupe advice timeouts in vdostats; su storage lento VDO può rinunciare a cercare e scrivere comunque il duplicato |
| Leggere un clone dall’inizio alla fine | più lento: i suoi blocchi puntano a quelli del template, sparsi per l’array |
Le prime due righe sono la risposta sull’hardware. Finché la cache del controller, con batteria o su flash, ha spazio, il guest vede la latenza della cache. Quando si riempie, il guest vede i mandrini. Mandale un quarto dei byte e la stessa cache dà circa quattro volte il margine, e ha un quarto da svuotare. La sezione su bcache qui sopra è proprio questo, misurato con una cache software al posto di quella del controller.
La terza è il motivo per cui VDO sta meglio sui dischi lenti che su quelli veloci. Sull’Optane VDO ha raddoppiato la latenza di lettura. Su drive da 7.200 rpm lo stesso costo fisso sparisce dentro un solo seek.
Le ultime tre sono i costi. Una tempesta di boot di cloni identici diventa più veloce, ma un clone letto da cima a fondo diventa più lento, perché la deduplicazione lo sparpaglia. E anche le piccole scritture di VDO stesso finiscono sull’array, che è la ragione per la disposizione divisa di sopra: indice e journal su NVMe, slab sul RAID6.
Cancellare un disco: fai fare il discard a Proxmox
Rimuovere un LV libera i suoi extent in LVM. Non dice a VDO che i blocchi sono inutilizzati, quindi VDO li tiene. La documentazione del kernel dice perché conta: «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»1. Su uno storage thick non può esaurirsi, ma i blocchi non scartati sono comunque spazio sul drive tenuto per dati che non sono di nessuno.
L’opzione on-volume-remove discard=1 sullo storage è la soluzione. Proxmox la descrive come l’invio di «discard (TRIM) requests before removal»5:
| Cancellazione | Blocchi VDO liberati |
|---|---|
storage lvm normale, un disco con 1 GiB | 0 |
con on-volume-remove discard=1, lo stesso | 262.140, l’intero 1 GiB |
Su un disco grande però è lento.
Cancellare il disco da 34 GiB della prova di riempimento ha richiesto a Proxmox 262,6 s, mentre blkdiscard sullo stesso tipo di dati ha fatto 15 GiB in 2,25 s.
Quindi per qualsiasi cosa grande, prima blkdiscard sul disco e poi cancellalo.
Conta anche la dimensione del discard. Il max_discard di default di VDO è un blocco da 4 KiB per richiesta1:
| Discard di 15 GiB di dati casuali | Tempo trascorso | CPU (sys) |
|---|---|---|
max_discard=1, il default | 8,06 s | 8,06 s |
max_discard=4096, 16 MiB | 2,25 s | 0,00 s |
Dentro i guest, attiva l’opzione Discard del drive perché il loro TRIM arrivi allo storage10, e lancia fstrim a intervalli regolari.
Dove si guadagna il suo posto
| Adatto | Non adatto |
|---|---|
| molte VM dagli stessi pochi template | database e lavori legati alla latenza a profondità elevata |
| RAID6 con HDD dietro una cache write-back del controller | un host tutto NVMe che ha bisogno di ogni microsecondo |
| dati su dischi rotanti con una NVMe per i metadati di VDO | dati già compressi: media, backup, ISO |
| bcache davanti a dati su dischi rotanti, dove i dati si ripetono | bcache davanti a dati che non si ripetono |
| drive dove il limite è la resistenza alle scritture | dischi dei guest cifrati, che non si deduplicano mai |
| un host con mezzo gigabyte di RAM libera per pool | un pool piccolo, dove l’indice si mangia un decimo |
| Impostazione | Default | Impostala a | Modificarla dopo |
|---|---|---|---|
Dimensione virtuale VDO -V | quella che chiedi | non più di quanto il pool può indirizzare | solo crescere, mai ridurre |
| Thread di VDO | 10, uno logical | uno per CPU, distribuiti come sopra | solo con le VM del pool ferme |
max_discard | 1, cioè 4 KiB | 4096, cioè 16 MiB | solo con le VM del pool ferme |
on-volume-remove sullo storage | non impostato | discard=1 | sì, pvesm set |
| Discard su ogni disco virtuale | spento | acceso | sì, per disco |
scan_lvs e il filtro | 0, nessun rifiuto dei dischi delle VM | 1, dischi delle VM rifiutati | sì, in lvm.conf |
Niente di tutto ciò è difficile. Niente di tutto ciò è il default.
La scrittura più economica è quella che non mandi mai
Ciò che mi colpisce di VDO è quanto venga venduto male. Si presenta come un modo per mettere su un disco più di quanto il disco contenga, ed è la cosa meno utile che fa. L’ho fatto per sbaglio nella prima build, e Proxmox mostrava un terzo dello storage libero mentre VDO era pieno. L’overcommit è un prestito, e il drive lo richiede indietro a piena velocità di scrittura.
Il valore vero sta nella riga che la maggior parte della gente non misura mai. Un quarto dei byte che arrivano al drive è un quarto dell’usura e una cache del controller che dura quattro volte tanto. Non è capacità. È l’hardware che fa meno lavoro per lo stesso risultato, che è l’unico tipo di risparmio che non torna a morderti.
Costa CPU, e sulla flash veloce costa latenza, ed entrambi sono fissi. È questo lo scambio, detto chiaro: tempo di processore speso perché la parte lenta e costosa della macchina lavori meno. Su dischi rotanti dietro un controller RAID o un bcache, con indice e journal su una NVMe, i conti tornano bene. Su un host tutto Optane per lo più no.
E non si gestisce da solo. Ogni default che conta è sbagliato per questo lavoro: dieci thread su sedici CPU, una dimensione del discard che brucia un core, una dimensione virtuale che puoi impostare a qualsiasi cosa, e niente nella configurazione dello storage che dica a Proxmox di restituire lo spazio. Niente di tutto ciò è nascosto. È tutto nella documentazione.
Quindi costruiscilo thick, una volta, come si deve, con le impostazioni sulla riga di creazione e i metadati dove devono stare. Fallo e il drive fa un quarto del lavoro. Saltalo e hai comprato un altro strato che promette più di quello che ha.
Linux kernel documentation — dm-vdo — il target «provides block-level deduplication, compression, and thin provisioning»; «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»; «unflushed writes may or may not persist after a crash»; la cache della block map da 128 MB supporta un «efficient access to 100 GB of logical space at a time»; i parametri dei thread, i loro limiti e le indicazioni di tuning; maxDiscard «in 4096-byte blocks». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — VDO pool e VDO LV, la conversione di un LV esistente con
lvconvert --type vdo-pool, l’uso di memoria, l’indice dense e la sua finestra di 1 TiB per GiB di RAM, e «You cannot reduce the size of a VDOPoolLV». ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()disattiva il passdown del discard quando il dispositivo dati non può accettare un intero chunk thin, che è ciò che fa il default di VDO sotto un thin pool. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: «Caution is required to avoid using PVs that belong to guest images stored on LVs» e «This option does not enable autoactivation of layered VGs». ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — la proprietà
on-volume-remove, «Use ‘discard=1’ to issue discard (TRIM) requests before removal»; i volumi vengono attivati uno per uno conlvchange -aeyinvece che convgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — «Management tools for Virtual Data Optimizer», versione 8.3.1.1-1, che fornisce
vdoformat,vdostatsevdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()crea la partizione della block map all’inizio, le partizioni dello slab summary e del recovery journal alla fine, e lo slab depot con ciò che resta. ↩︎fio documentation — randrepeat — «Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.» ↩︎
Linux kernel documentation — Design of dm-vdo — «vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.» ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — «For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.» ↩︎