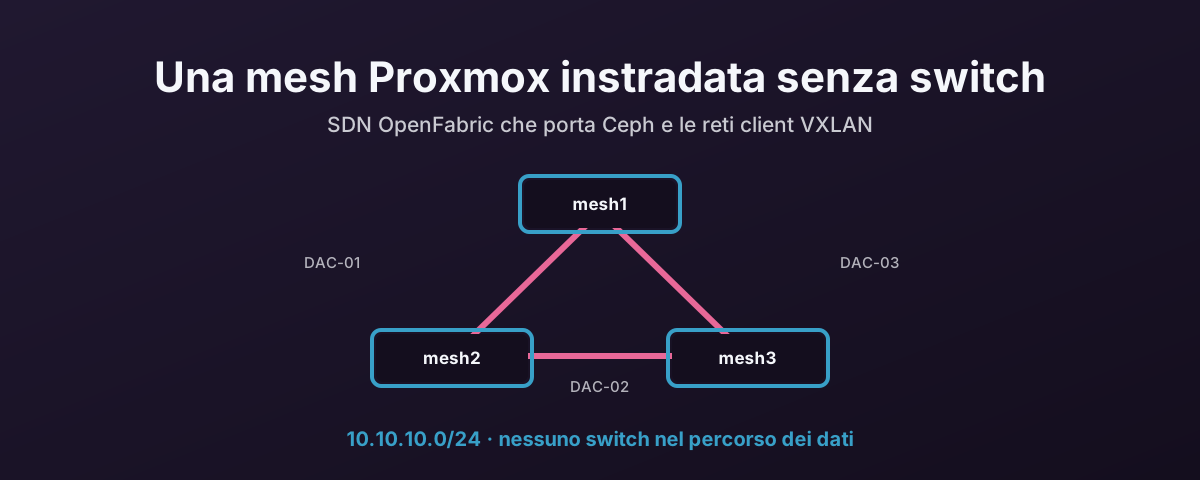
Lo switch che non compri
Un cluster Proxmox a tre nodi con Ceph vuole una rete veloce tra i nodi. La risposta abituale è uno switch da 100 Gbit, e l’obiezione abituale è quanto costa.
Per tre nodi c’è un’altra risposta: collegali direttamente tra loro a triangolo e instrada attraverso. Nessuno switch nel percorso dello storage.
Il componente più economico di qualsiasi design è quello che non compri, ed è l’unico che non si guasta mai.
Questo ti dà quattro cose.
Il costo dello switch sparisce. Ti servono schede di rete e tre cavi, non uno switch da 100 o 200 Gbit con il numero di porte che ne consegue.
Il percorso dei dati non ha un singolo punto di guasto. Uno switch che si guasta o si riavvia si porta via tutto il traffico est-ovest del cluster. Nodi collegati direttamente tra loro se ne infischiano di cosa succede a uno switch da qualche altra parte nell’edificio.
Il traffico pesante ha i suoi cavi. La migrazione live e la replica di Ceph restano sulla mesh invece di fare a gara con il traffico d’ufficio e di gestione.
Ingrandirla è un lavoro di cablaggio, non di budget di porte. Non c’è una scatola centrale che faccia da tetto alla banda o al numero di porte, quindi il fabric cresce finché ogni server ha uno slot PCIe libero. OpenFabric instrada da solo sui nuovi link.
E un limite onesto, perché conta più dei quattro vantaggi. Una full mesh vuole un cavo tra ogni coppia di nodi. Tre nodi sono tre cavi. Quattro sono sei. Cinque sono dieci. Il cablaggio cresce più in fretta del numero di nodi, e questo design non sopravvive oltre un piccolo cluster senza passare a qualcosa con gli switch, come una leaf-spine.
Tre nodi è esattamente il punto in cui una full mesh ha senso. Oltre, con due porte di mesh per nodo, quello che puoi ancora costruire è un anello, e questo richiede una cosa che altrimenti questa build evita, spiegata più sotto.
Cosa si costruisce
Tre host Proxmox VE, ciascuno con due interfacce dedicate da 100 Gbit, cablati a triangolo così che ogni nodo abbia due vicini diretti.
L’SDN di Proxmox gestisce l’instradamento. Il protocollo è OpenFabric: calcola il percorso migliore attraverso la mesh, e quando un cavo viene staccato o un link cade reinstrada sul percorso rimasto. Nessuno deve fare login.
Il fabric vive in 10.10.10.0/24, riservato alla mesh e a nient’altro: non la gestione, non i guest, non l’indirizzamento dello storage, niente di esterno.
| Nodo | Indirizzo di mesh | Interfacce di mesh |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
Ogni nodo riceve un /32, non una fetta della subnet.
È questo il senso di una mesh instradata invece che in bridge. L’indirizzo identifica il nodo, OpenFabric lo annuncia, e i due link fisici sono solo percorsi per raggiungerlo.
Proxmox crea un’interfaccia loopback dummy per ospitarlo.
Il cablaggio
Cavi DAC in fibra attiva, a triangolo, con i jumbo frame attivati su entrambe le interfacce di mesh di ogni nodo.
| Cavo | Da | A |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
Fibra attiva invece di DAC in rame, per due motivi che riguardano il rack più che la rete:
- Gestione dei cavi. I DAC in fibra attiva sono più sottili e molto più flessibili del rame, quindi si instradano in modo pulito e non si ammucchiano dietro i server.
- Flusso d’aria. Meno volume di cavi dietro lo chassis significa meno disturbo al flusso d’aria da davanti a dietro, e conta quando diversi link ad alta velocità arrivano nelle stesse poche unità di rack.
Due reti, non una
La mesh non è l’unica rete, e non deve diventarlo.
Ogni nodo ha nic0 su uno switch da 2,5 Gbit, presentata a Proxmox come il bridge vmbr0.
Quella porta l’interfaccia web, l’accesso di amministrazione e il traffico dei client. È anche il percorso che usi mentre costruisci il fabric, ed è per questo che deve esserne indipendente.
nic0 è lasciata fuori dal fabric di proposito. Solo nic1 e nic2 vengono selezionate quando si creano i nodi del fabric.
La mesh porta tre cose:
- Ceph. Replica tra nodi, recovery e backfill per lo storage iperconvergente.
- Reti virtuali dei client. VNet basate su VXLAN estendono le reti dei guest su tutti e tre i nodi, usando la mesh instradata come underlay.
- Corosync, come secondo percorso. Il traffico di appartenenza al cluster passa sulla rete di gestione e sulla mesh, così il quorum non dipende dalla sopravvivenza di una sola delle due.
La regola da scrivere sul ticket di modifica: l’accesso di gestione e dei client resta disponibile attraverso lo switch da 2,5 Gbit in ogni momento, qualunque sia lo stato delle interfacce da 100 Gbit.
Tutto dall’interfaccia web
Questa build si fa interamente nell’interfaccia web di Proxmox. È una scelta voluta, non un limite degli strumenti.
Non usati, di proposito:
- Modificare
/etc/network/interfacesa mano. - Modificare i file di configurazione di FRR a mano.
vtyshcome metodo di costruzione.
Proxmox genera la configurazione di rete e di instradamento sottostante a partire dagli oggetti SDN che definisci. Se qualcosa davvero non si può impostare nell’interfaccia, vale la pena dichiararlo come prerequisito invece di sistemarlo in silenzio dalla riga di comando. La prossima persona che apre l’interfaccia web non saprà che l’hai fatto.
L’output della riga di comando compare qui sotto solo come prova, mai come passo della costruzione.
La costruzione
1. Apri l’interfaccia web di Proxmox e vai su Datacentre → SDN → Fabrics.
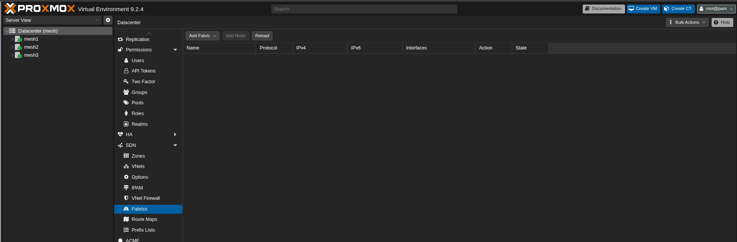
2. Aggiungi il fabric. Dagli un nome, il prefisso della mesh, e imposta i timer.
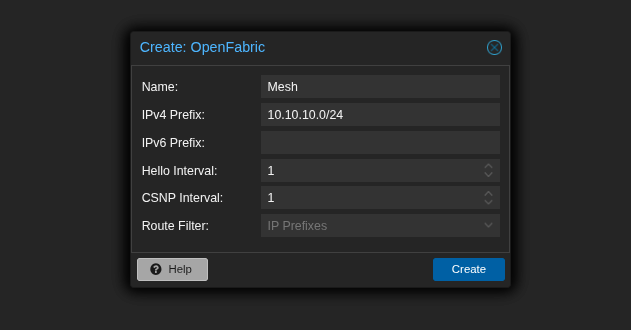
Intervalli Hello e CSNP a 1 aggiornano lo stato il più in fretta possibile quando qualcosa cambia, ed è quello che vuoi su un fabric così piccolo.
Il prezzo è più chiacchiericcio nel control plane. Irrilevante su tre nodi con due link ciascuno, da ripensare se il fabric dovesse mai crescere.
3. Aggiungi ogni nodo con Add node. Dagli un indirizzo dal range della mesh e spunta le interfacce che ne fanno parte.
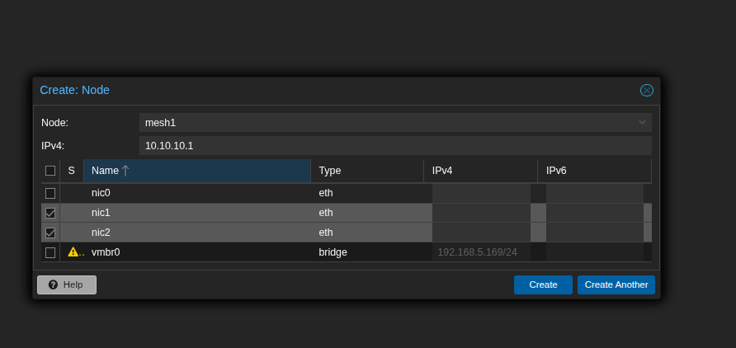
Nota cosa non è spuntato: nic0 resta fuori, e vmbr0 mantiene l’indirizzo di gestione.
Usa Create another per i primi due nodi e Create sull’ultimo.
4. Controlla il risultato prima di applicarlo.
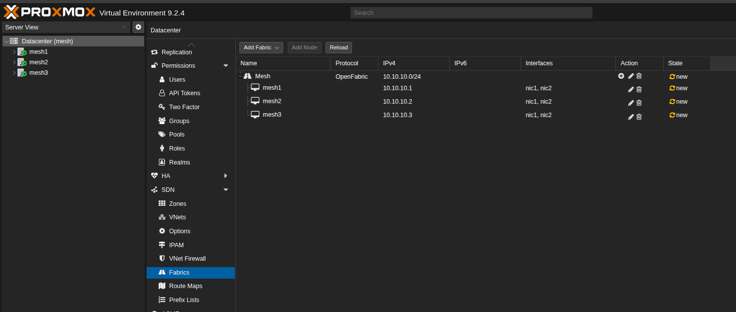
Tre nodi, tre indirizzi, nic1, nic2 su ciascuno, tutti segnati new: non è stato ancora scritto niente.
5. Applica la configurazione SDN.
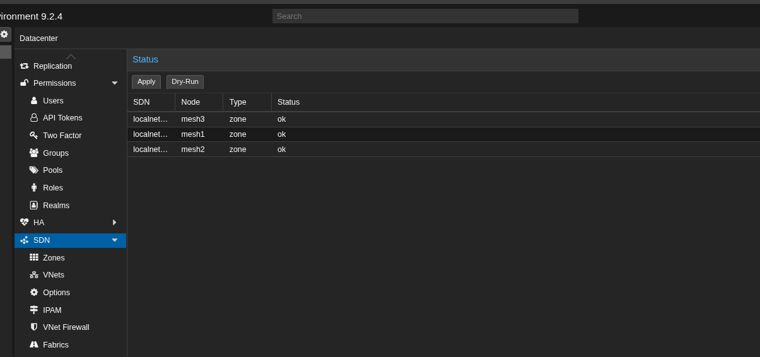
Accanto ad Apply c’è un Dry-Run, se preferisci vedere prima cosa intende fare.
Sapere che ha funzionato
La vista di stato dovrebbe mostrare sia le voci della zona sia quelle del fabric ok su tutti e tre i nodi, e nessuna modifica in sospeso da applicare.
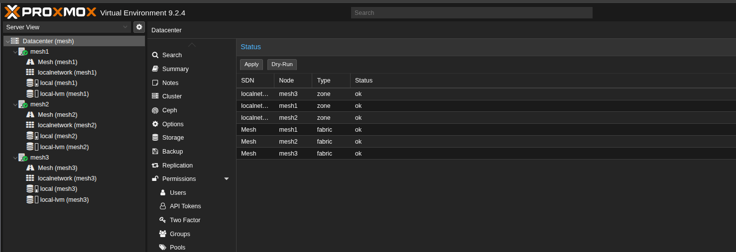
Poi controlla il fabric dal punto di vista di un nodo.
Prima le rotte: ogni nodo dovrebbe avere un /32 verso ciascuno degli altri, e la colonna Via ti dice quale vicino sta usando.
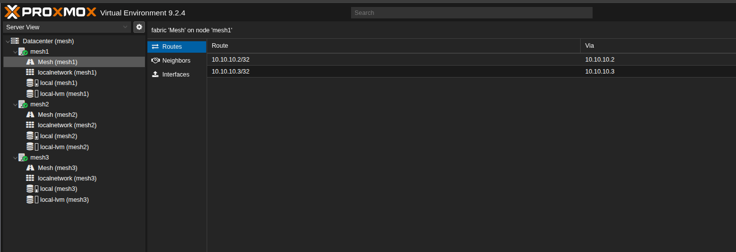
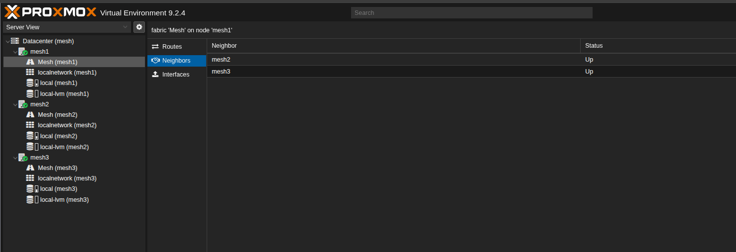
Poi i vicini. Due, entrambi Up, su un triangolo di tre nodi.
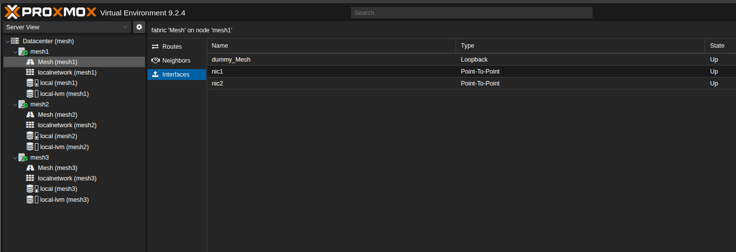
Poi le interfacce, ed è qui che si vede la forma della cosa: dummy_Mesh come loopback che ospita l’indirizzo del router, e nic1 e nic2 come Point-To-Point invece che segmenti broadcast.
Infine, dimostralo da un capo all’altro.
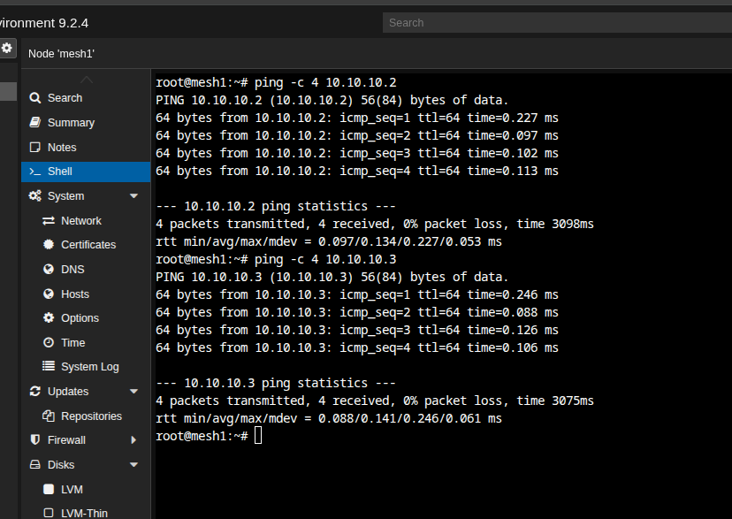
Nessuna perdita, e medie di 0,134 ms e 0,141 ms. Entrambi i vicini sono a un hop diretto, ed è quello che ti dà un triangolo.
Il controllo da fare che nessuno screenshot può mostrare: stacca un cavo e conferma che tutto sia ancora raggiungibile. È tutto il motivo per scegliere una mesh instradata invece di una coppia di link punto-punto. Per questo è l’unico test che conta.
Oltre tre nodi: l’anello
Un triangolo è una full mesh. Ogni nodo ha un cavo diretto verso ogni altro nodo, ogni hop è un hop solo, e nessun nodo porta mai traffico che non sia suo.
Questa proprietà è ciò che due porte di mesh per nodo ti comprano a tre nodi, ed è esattamente ciò che perdi a quattro. Non in parte. Tutta. Una full mesh di quattro nodi vuole tre porte ciascuno. Con due, il massimo che puoi cablare è un anello.
Un anello cambia il modello di traffico. I nodi adiacenti hanno ancora un cavo diretto, ma i nodi ai lati opposti dell’anello no: il loro traffico deve attraversare un nodo intermedio. E quel nodo deve essere disposto a inoltrare pacchetti tra le sue due interfacce di mesh, cosa che Linux di default non fa. Il kernel documenta ip_forward come «Forward Packets between interfaces» con un «Default: 0 (disabled)».
Attivalo per le interfacce di mesh, e solo per quelle:
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
Rileggili invece di dare per scontato:
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
L’impostazione per interfaccia è l’ambito giusto qui, e funziona da sola. Il net.ipv4.ip_forward globale non è un prerequisito. La decisione di inoltro del kernel legge il valore dell’interfaccia che riceve:
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET restituisce l’impostazione di quel dispositivo, non un AND con quella globale. Così nic1 e nic2 inoltrano il traffico in transito per il fabric mentre nic0 e vmbr0 restano esattamente ciò che devono essere: interfacce dell’host che non instradano. Attivare l’interruttore globale trasformerebbe in router ogni interfaccia della macchina, compresa quella rivolta alla rete del tuo ufficio. Una cosa di cui questo design non ha bisogno per niente.
Una cosa da sapere sull’interruttore globale IPv4 anche se non lo imposti: net.ipv4.ip_forward è un’impostazione in blocco, ed è per questo che la documentazione del kernel avverte che cambiarlo «resets all configuration parameters to their default state». Se qualcos’altro sull’host lo scrive, sovrascrive questi valori per interfaccia. Meglio saperlo prima di passare un pomeriggio a chiederti perché il transito ha smesso di funzionare.
IPv6 è l’eccezione, ed è l’unico posto dove l’interruttore globale ci sta. La documentazione del kernel lo dice chiaramente sotto conf/all/forwarding:
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
Quindi per IPv6 non esiste l’equivalente dell’approccio ordinato per interfaccia visto sopra. Se il fabric porta IPv6 attivi l’inoltro a livello globale e poi lo restringi con force_forwarding, documentato come «Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding». Nota che lo stesso comportamento di sovrascrittura vale al contrario: impostare conf.all.forwarding a 0 azzera force_forwarding su ogni interfaccia.
La build qui sopra lascia vuoto il prefisso IPv6 del fabric, quindi niente di tutto questo si applica qui: conta solo se ne aggiungi uno.
Nota cosa l’inoltro non cambia: OpenFabric annunciava già il /32 di ogni nodo e calcolava già il percorso attraverso l’anello. L’inoltro è il permesso mancante, non il cervello mancante. La tabella di routing era giusta fin dall’inizio. Il kernel semplicemente si rifiutava di fare da router.
Cosa costa l’anello, rispetto al triangolo:
- Traffico in transito. Su un anello di quattro nodi, le due coppie in diagonale attraversano un nodo intermedio, quindi il loro traffico consuma la banda dei link di quel nodo oltre alla sua. Ceph se ne accorge per primo, perché la replica è tutti-verso-tutti invece che vicino-verso-vicino.
- Un hop in più di latenza su quei percorsi, in aggiunta ai soliti valori sotto il millisecondo del design senza switch.
- Meno margine per i guasti. Un link rotto trasforma un anello in una catena: ancora completamente connessa, ma con percorsi più lunghi e più transito. Una seconda rottura partiziona il cluster. Un triangolo tollera una rottura senza alcun transito.
E peggiora in un modo che è più facile disegnare che descrivere. Aggiungi un quinto nodo e metà delle coppie di nodi del cluster dipende da qualcun altro che inoltra:
Questo è il vero tetto di questo design, e non è il protocollo di routing. OpenFabric se la cava benissimo. È che le porte per nodo sono fisse, quindi oltre tre nodi ogni nuova macchina trasforma una parte maggiore del tuo traffico nel transito di qualcun altro.
E la nota onesta, perché conta per una build che finora è stata solo interfaccia web: un sysctl non è un’azione dell’interfaccia web. Per la regola fissata prima, questo lo rende un prerequisito da dichiarare invece di qualcosa da sistemare in silenzio dalla riga di comando. Scrivilo nel runbook, perché la prossima persona che apre il pannello SDN vedrà un fabric sano e nessun indizio che un anello dipende da un file in /etc/sysctl.d.
Tornare indietro
Rimuoverla è la build al contrario, nella stessa interfaccia: cancella gli oggetti SDN creati per la mesh, applica la configurazione, e conferma che l’accesso di gestione non sia stato toccato.
Quest’ultimo passo è il motivo per cui esistono nic0 e lo switch da 2,5 Gbit. Se annullare la mesh potesse costarti l’interfaccia web, il design era sbagliato prima ancora di cominciare.
Prima di cominciare
- L’accesso di gestione è davvero indipendente dalla mesh. Controllalo, non darlo per scontato.
- Tutti e tre i nodi sono sani prima di qualsiasi modifica SDN.
- Nomi dei nodi, nomi delle interfacce e cablaggio sono scritti da qualche parte, perché
nic1su un host che ènic2su un altro è un brutto pomeriggio. - I jumbo frame sono impostati su entrambe le interfacce di mesh, e l’MTU tiene conto dell’overhead di VXLAN sull’underlay.
- Il range della mesh è riservato e non è usato da nessun’altra parte.
Riferimenti
- Proxmox VE — Software-Defined Network — la documentazione degli SDN Fabrics. I fabric «provide automated routing between nodes in a cluster», OpenFabric è «based on IS-IS and optimized for the spine-leaf topology common in data centers», ogni nodo ha bisogno di un Router-ID univoco, e «a dummy ’loopback’ interface with the router-id is automatically created»
- Proxmox VE — Cluster Manager — rete di Corosync e link ridondanti, alla base del design di appartenenza a due percorsi
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — le aspettative di rete per un cluster iperconvergente
- Linux kernel — IP sysctl documentation —
ip_forwarde il suo default a 0, il controlloforwardingper interfaccia, e l’avvertimento che cambiare l’interruttore globale azzera la configurazione per interfaccia