Il problema
È saltato fuori durante un lavoro per un cliente, mentre progettavamo un deployment di Proxmox VE con passthrough NVMe per un carico sensibile alla latenza.
Il cliente aveva fatto i suoi benchmark prima della call.
Sull’host, fio contro il disco NVMe dava 700K IOPS in lettura casuale con una latenza di completamento sotto i 10µs.
Dentro la VM, con lo stesso disco e lo stesso test, ne otteneva più o meno la metà.
Le cose ovvie le aveva già controllate. Il disco non era cambiato. Il firmware non era cambiato. Lo slot PCIe non si era spostato. Cominciava a chiedersi se il passthrough fosse proprio l’approccio sbagliato.
Non lo era. Quello che vedeva è la tassa IOMMU. Coglie la gente impreparata perché nessuno te ne parla prima che tu ti sia impegnato nel design con passthrough. La buona notizia è che la maggior parte dell’overhead si recupera, una volta capito da dove arriva.
Nel dettaglio
I problemi da risolvere
Dare a una VM l’accesso diretto a un dispositivo PCIe fisico sembra semplice. In pratica è uno dei problemi più difficili della virtualizzazione di sistema. Alcune cose che sul bare metal funzionano da sole diventano pericolose quando un dispositivo è condiviso tra un host e un guest.
Isolamento del DMA
Questo è il problema di fondo.
I dispositivi PCIe non passano dalla CPU per leggere e scrivere la memoria. Usano il Direct Memory Access. Scrivono direttamente agli indirizzi fisici della RAM. Sul bare metal va bene. Il dispositivo e il sistema operativo si fidano l’uno dell’altro.
Con la virtualizzazione, la VM guest ha una sua visione della memoria fisica. Gli indirizzi che il driver del guest passa al controller NVMe sono indirizzi fisici del guest. Non corrispondono alle stesse posizioni nella RAM dell’host. Se il dispositivo li usa direttamente, legge e scrive la memoria sbagliata. E corrompe l’host, le altre VM, o entrambi.
Peggio ancora, un driver guest malevolo o difettoso potrebbe programmare apposta il dispositivo per fare DMA in qualsiasi parte della memoria dell’host. Di fatto è un accesso root all’intera macchina senza mai sfruttare un bug dell’hypervisor.
La soluzione è l’IOMMU: un’unità hardware di traduzione (Intel VT-d, AMD-Vi) che sta tra ogni dispositivo PCIe e la memoria principale. Mantiene le sue tabelle delle pagine, separate da quelle della CPU. Ogni richiesta DMA del dispositivo passa dall’IOMMU, che traduce gli indirizzi fisici del guest in indirizzi fisici dell’host e blocca qualsiasi accesso fuori dalle regioni di memoria assegnate al guest.
Senza IOMMU, un passthrough sicuro è impossibile. Con l’IOMMU, il dispositivo è contenuto.
Raggruppamento dei dispositivi
L’IOMMU non isola i singoli dispositivi. Isola dei gruppi.
La specifica PCIe definisce gli Access Control Services (ACS), che stabiliscono se i dispositivi sullo stesso bus possono parlarsi direttamente, con DMA peer-to-peer, senza passare dal root complex dove sta l’IOMMU. Se due dispositivi condividono uno switch PCIe che non applica l’ACS, uno dei due può fare DMA nello spazio di memoria dell’altro, scavalcando del tutto l’IOMMU.
Il kernel raggruppa in un unico gruppo IOMMU i dispositivi che potenzialmente possono raggiungersi senza il controllo dell’IOMMU. Se il tuo controller NVMe condivide un gruppo con un altro dispositivo, passare solo l’NVMe rompe il modello di isolamento. L’altro dispositivo del gruppo potrebbe ancora essere usato come canale laterale per aggirare l’IOMMU.
L’hardware di classe server, con un vero supporto ACS su ogni bridge e switch, di solito dà a ogni dispositivo il suo gruppo. Le schede consumer e workstation spesso ammucchiano più dispositivi insieme, perché il root complex PCIe non implementa l’ACS su ogni porta.
Proxmox include una patch del kernel, pcie_acs_override, che dice al kernel di trattare ogni dispositivo come isolato a prescindere dal supporto ACS dell’hardware.
In pratica funziona, ma sta mentendo al kernel sulla topologia dell’hardware.
Su un sistema in produzione, gruppi puliti sostenuti da un vero ACS hardware sono sempre preferibili.
Consegna degli interrupt
Sul bare metal, quando un controller NVMe completa un’operazione di IO, lancia un interrupt MSI-X direttamente alla CPU. La CPU lo gestisce in qualche centinaio di nanosecondi.
Con la virtualizzazione, quell’interrupt deve arrivare al guest, non all’host. L’approccio ingenuo è intercettare ogni interrupt nell’hypervisor, provocare una VM exit, iniettare l’interrupt nel guest e riprendere. Funziona, ma ogni VM exit costa 5–20µs. A IOPS alti, centinaia di migliaia di interrupt al secondo, l’overhead è notevole.
La soluzione hardware sono i posted interrupt. APICv di Intel e AVIC di AMD permettono all’IOMMU di scrivere l’interrupt direttamente nella pagina APIC virtuale del guest, senza causare alcuna VM exit. Il guest vede l’interrupt come se arrivasse da hardware bare metal. L’overhead scende a qualche centinaio di nanosecondi.
Non tutte le piattaforme supportano i posted interrupt. CPU più vecchie, alcuni chipset workstation e alcune versioni di BIOS non espongono la funzione. Quando manca, ogni interrupt passa dal percorso lento, e non c’è un rimedio software.
Reset del dispositivo
Quando una VM si spegne o va in crash, il dispositivo passato deve tornare a uno stato pulito e noto. Altrimenti non può essere riassegnato a un’altra VM né ripreso dall’host.
Sul bare metal, il sistema operativo spegne in modo ordinato il driver del dispositivo. Con il passthrough, il guest potrebbe andare in crash, l’utente potrebbe forzare lo stop della VM, o l’hypervisor potrebbe uccidere il processo. Il dispositivo potrebbe essere a metà di un trasferimento, con operazioni DMA in volo.
Per questo PCIe definisce il Function Level Reset (FLR), un modo per resettare una singola funzione del dispositivo senza toccare il resto del bus. I controller NVMe in genere supportano l’FLR e lo gestiscono bene. Le GPU sono notoriamente pessime in questo, ma è un altro articolo.
Se l’FLR non è supportato, il ripiego è un secondary bus reset, che resetta tutto quello che sta dietro quel bridge PCIe. Se sul bridge ci sono altri dispositivi, vengono resettati anche loro. Nel caso peggiore, l’unico modo per riprendersi il dispositivo è un riavvio completo dell’host.
Overhead della traduzione degli indirizzi
L’IOMMU risolve il problema della sicurezza. Per questo non è opzionale. Ma ne introduce uno di prestazioni.
Ogni operazione DMA ora passa per un livello in più di traduzione degli indirizzi. L’IOMMU ha il suo TLB, l’IOTLB, e quando c’è un hit l’overhead è piccolo. Quando c’è un miss, l’IOMMU deve percorrere le sue tabelle delle pagine, e questo aggiunge latenza vera a ogni operazione di IO coinvolta.
Questa è la tassa IOMMU. Il resto dell’articolo serve a capire da dove viene e come ridurla al minimo.
Mappatura dei BAR e spazio degli indirizzi
Ogni dispositivo PCIe espone uno o più Base Address Register (BAR) che mappano i registri interni e la memoria del dispositivo nello spazio di indirizzi MMIO dell’host. La CPU dell’host accede al dispositivo attraverso queste mappature. Perché il passthrough funzioni, l’hypervisor deve presentarle correttamente al guest.
Tradizionalmente, le dimensioni dei BAR erano fissate all’avvio dal BIOS e stavano dentro la vecchia finestra MMIO a 32 bit sotto i 4GB. Funzionava finché i BAR erano piccoli. Le GPU moderne hanno cambiato il quadro. Un framebuffer da 24GB ha bisogno di un BAR da 24GB, che non entra in uno spazio di indirizzi a 32 bit.
Il Resizable BAR (ReBAR), venduto anche come AMD Smart Access Memory (SAM), è una funzione PCIe che permette di rinegoziare la dimensione del BAR dopo l’avvio. Per le GPU è una funzione importante. Invece di accedere al framebuffer da una finestra di 256MB, scorrendolo a pezzi, l’host mappa tutta la VRAM in una volta.
Per l’NVMe l’impatto diretto è minore. I BAR dei controller NVMe sono di solito da 16KB a 64KB per l’insieme dei registri del controller (BAR0). La specifica NVMe definisce un Controller Memory Buffer (CMB) che può esporre un BAR più grande per code di submission residenti sull’host, ma la maggior parte dei dischi non lo implementa. Il ReBAR non cambia il throughput NVMe come fa per le GPU.
Il motivo per cui conta in un contesto di passthrough NVMe è l’ambiente PCIe condiviso. Se passi un disco NVMe insieme a una GPU sullo stesso host, il BAR ridimensionato della GPU ha bisogno di spazio di indirizzi oltre il limite dei 4GB. Il BIOS, l’IOMMU e la topologia PCIe virtuale devono tutti farci posto. Sbagliare l’allocazione dello spazio di indirizzi significa dispositivi che non si inizializzano, e il passthrough NVMe che fallisce insieme a tutto il resto.
Esposizione alla perdita di alimentazione
Su un disco virtuale, l’hypervisor e lo strato di storage gestiscono l’ordine delle scritture e la coerenza dopo un crash. Con il passthrough, il guest parla direttamente con la flash. Se l’host perde l’alimentazione a metà scrittura, è quello che il firmware del controller NVMe fa, o non fa, con la sua cache di scrittura a decidere se perdi dati.
I dischi NVMe enterprise hanno condensatori di power loss protection (PLP) che svuotano la cache di scrittura in sicurezza durante un’interruzione di corrente. I dischi consumer senza PLP potrebbero non farlo. Con il passthrough non c’è una rete di sicurezza dell’hypervisor tra il guest e l’hardware.
Per un carico in produzione, un disco enterprise con PLP non è opzionale.
Compromessi operativi
Il passthrough toglie anche funzioni che i dischi virtuali danno.
Un dispositivo passato è fisicamente imbullonato a un host specifico. La VM non può essere migrata a caldo mentre il dispositivo è collegato. In un cluster Proxmox con HA, un nodo che cade significa che la VM va giù e riparte a freddo su un altro nodo. Non c’è un failover trasparente.
Il disco è anche invisibile a vzdump e a Proxmox Backup Server.
Non finirà negli snapshot della VM né nei backup pianificati.
Prima che il carico vada in produzione serve una strategia di backup separata: a livello di guest, di filesystem o di applicazione.
Come funziona davvero il passthrough VFIO
Quando passi un dispositivo PCIe a una VM, l’hypervisor dà al guest il controllo diretto dei registri MMIO del dispositivo. Il driver del guest parla con il controller NVMe come se girasse su bare metal. Quella parte è quasi nativa. L’accesso ai registri MMIO passa dalle Extended Page Tables (EPT su Intel, NPT su AMD) e di solito si completa senza VM exit.
Il costo compare nel percorso DMA. Ogni operazione DMA passa dall’IOMMU per la traduzione degli indirizzi e, come descritto sopra, quella traduzione ha un prezzo. Soprattutto sui miss dell’IOTLB.
Perché i benchmark sembrano peggio della realtà
Qui è dove quasi tutti sbagliano i test.
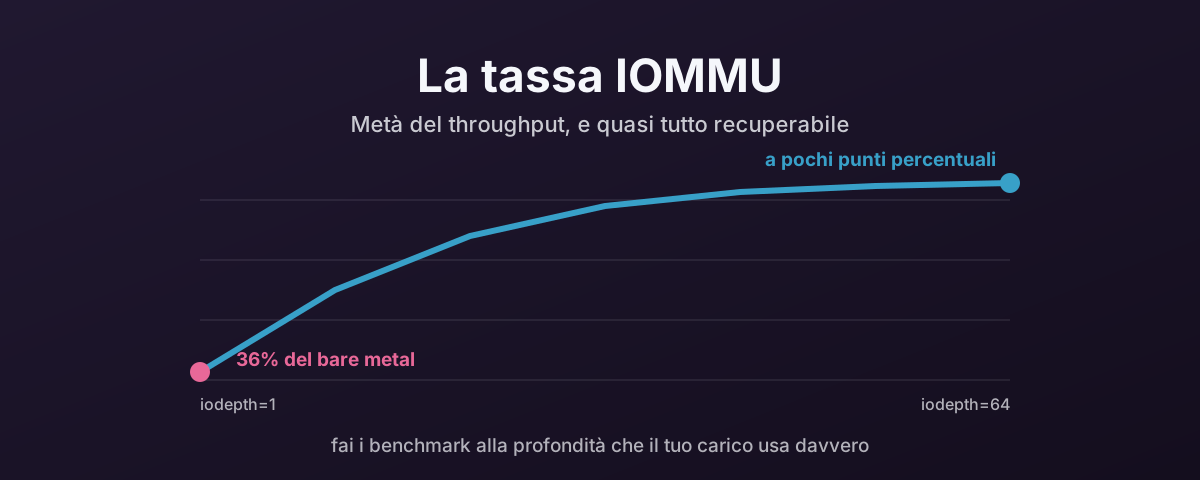
Un thread del forum Proxmox da cui è nato questo articolo aveva utenti che lanciavano fio con iodepth=1.
A quella queue depth, fio invia un IO, aspetta che si completi, poi invia il successivo.
Il test misura soltanto la latenza per IO.
Ogni microsecondo di overhead IOMMU si vede per intero.
I numeri di quel thread raccontano la storia con chiarezza.
Sul bare metal la latenza di completamento era in media intorno ai 10µs.
Dentro la VM era in media intorno ai 28µs.
Quei ~18µs in più per IO sono l’overhead di traduzione dell’IOMMU.
A iodepth=1 dimezzano direttamente il throughput, perché il throughput è pari a 1 / latency quando c’è un solo IO in volo.
Porta la queue depth a 32 o 64, che è il modo in cui i dischi NVMe sono progettati per lavorare, e il quadro cambia. Con più IO in volo, l’overhead IOMMU si ammortizza su tutti. Il controller elabora i completamenti mentre avvengono nuove traduzioni. Il throughput torna a pochi punti percentuali dal bare metal.
La conclusione pratica è questa. Se il tuo carico gira a queue depth sopra 4, la penalità IOMMU sul throughput è probabilmente trascurabile. Questo copre la maggior parte dei carichi di database, virtualizzazione e storage. Se il tuo carico è sensibile alla latenza a queue depth basse, certe applicazioni real-time o operazioni sincrone sui metadati, la sentirai.
Fai girare i benchmark a queue depth realistiche prima di concludere che il passthrough è troppo lento:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Confronta i percentili di clat (latenza di completamento) e le cifre di IOPS.
A iodepth=32 con quattro job, la differenza dovrebbe essere di qualche punto percentuale, non del 50%.
Allineamento NUMA
Questo ha un articolo tutto suo. Vedi Allineamento NUMA su Proxmox VE: perché conta e come farlo bene.
In breve: sui sistemi multi-socket ogni dispositivo PCIe è cablato a un socket specifico. Se il disco NVMe è sul nodo NUMA 1 e le vCPU della VM sono fissate al nodo 0, ogni completamento DMA attraversa il collegamento tra i socket. Questo aggiunge 50–100ns per operazione. A IOPS alti, la differenza di throughput tra NUMA allineato e disallineato è del 20–30%.
Controlla con cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, poi fissa le vCPU della VM a core dello stesso nodo con il parametro affinity nella configurazione della VM.
Sui sistemi a socket singolo non è un problema.
PCIe Active State Power Management (ASPM)
Questo ha un articolo tutto suo. Vedi PCIe ASPM e perché disattivarlo per il passthrough.
In breve: l’ASPM permette ai link PCIe di entrare in stati a basso consumo quando sono inattivi.
Con il passthrough, l’host controlla ancora il link fisico ma il dispositivo è del guest.
Quando il guest invia IO e il link è addormentato, il tempo di risveglio aggiunge latenza.
Il sintomo è un ventaglio largo nei percentili di clat. Il p99 può essere 5–10x più alto della media, mentre la media sembra a posto.
Disattivalo sull’host con pcie_aspm=off nella riga di comando del kernel.
Aggiungi anche disable_idle_d3=1 alle opzioni del modulo vfio-pci se il tuo controller NVMe ha problemi a recuperare gli stati di alimentazione. Il Samsung 990 EVO Plus è un colpevole noto.
MaxPayloadSize (MPS)
Questo ha un articolo tutto suo. Vedi PCIe MaxPayloadSize: prestazioni gratis per il passthrough.
In breve: i dispositivi PCIe trasferiscono i dati in Transaction Layer Packet.
Il root complex virtuale di QEMU usa di default un payload massimo di 128 byte.
La maggior parte dei dispositivi supporta 256 o 512 byte.
Aggiungere pci=pcie_bus_perf alla riga di comando del kernel dell’host imposta l’MPS al massimo consentito dal bus padre di ciascun dispositivo.
È un piccolo miglioramento di throughput, qualche punto percentuale nel migliore dei casi, ma è gratis e senza controindicazioni.
Resizable BAR e apertura MMIO
Il problema della mappatura dei BAR descritto prima ha passi pratici sia sul lato BIOS sia sul lato VM.
Prima di tutto, attiva Above 4G Decoding nel BIOS. Permette di mappare i BAR in uno spazio di indirizzi oltre il limite dei 4GB, cosa necessaria per qualsiasi dispositivo con BAR grandi. Attivalo anche per un passthrough solo NVMe. Non ha controindicazioni ed evita problemi se più avanti aggiungi una GPU o un altro dispositivo con BAR grandi.
Se nel BIOS c’è il ReBAR, attiva anche quello. Non cambierà le prestazioni NVMe direttamente, ma permette alle GPU sullo stesso host di usare la mappatura completa del framebuffer.
Sul lato VM, il root complex virtuale Q35 di QEMU ha bisogno di una finestra MMIO a 64 bit abbastanza grande perché il guest veda i BAR ridimensionati. Di default OVMF alloca una finestra relativamente piccola. Per un passthrough solo NVMe va bene. I BAR NVMe ci stanno comodi. Ma se la VM ha sia un NVMe sia una GPU passati, aumenta l’apertura MMIO:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Questo dice a OVMF di allocare 64GB di spazio MMIO a 64 bit, abbastanza per la maggior parte dei framebuffer GPU insieme al piccolo BAR del controller NVMe.
Il supporto ReBAR di QEMU sta migliorando ma non è ancora liscio. Alcune GPU AMD (Vega e successive) provocano errori del driver (Code 43 in Windows) con il ReBAR attivo sotto QEMU. Se ti capita, come primo passo disattiva il ReBAR nel BIOS. Il passthrough NVMe non ne risente in nessun caso.
Per cosa fa il Resizable BAR dal lato GPU, e perché Intel lo considera obbligatorio su Arc mentre NVIDIA lo attiva gioco per gioco, vedi PCIe Resizable BAR e le GPU moderne.
Gestione degli interrupt
Il problema della consegna degli interrupt descritto prima ha un passo pratico di tuning. I posted interrupt (APICv su Intel, AVIC su AMD) potrebbero non essere attivi di default.
Controlla se lo sono:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Sui sistemi AMD EPYC, attiva AVIC nel modulo KVM se non è attivo di default:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Sui sistemi Intel, APICv con i posted interrupt di solito si attiva da solo quando VT-d è attivo.
Se la tua piattaforma non supporta i posted interrupt, non c’è un rimedio software. È una capacità dell’hardware. Ma vale la pena verificare che sia davvero accesa prima di dare per inevitabile il percorso lento.
Affinità degli interrupt e allineamento delle code
I controller NVMe usano più coppie di code di submission e di completamento. Di solito una per core della CPU. Quando le vCPU della VM non sono allineate ai core fisici che gestiscono gli interrupt NVMe, i completamenti devono attraversare i core tramite interrupt tra processori. E questo aggiunge latenza.
Dentro il guest, controlla quante code di IO ha creato il driver NVMe e come sono mappate:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idealmente, l’interrupt di ogni coda di IO NVMe dovrebbe avere affinità con la vCPU che invia su quella coda. La maggior parte dei driver NVMe moderni lo gestisce da sé. Ma vale la pena verificarlo, soprattutto se hai fissato le vCPU a mano o hai ridotto il numero di vCPU sotto il numero di code del controller.
Usa sempre Q35, non i440fx
Questo merita un articolo tutto suo. Vedi Usa sempre Q35, non i440fx.
In breve: i440fx presenta un bus PCI legacy piatto. Q35 presenta un vero root complex PCIe. I dispositivi passati su i440fx appaiono come PCI legacy, e questo rompe la consegna degli interrupt MSI-X multi-coda. I controller NVMe hanno bisogno di MSI-X per la loro architettura a una coda per core. Senza, tutti i completamenti di IO passano da un solo interrupt e ottieni un collo di bottiglia a IOPS alti che nessun tuning del kernel potrà sistemare.
In Proxmox 8.x e successivi, Q35 è il default per le nuove VM. Se fai passthrough su una VM vecchia che è ancora i440fx, cambiala. RHEL 10 ha deprecato formalmente i440fx, e il resto dell’ecosistema KVM sta seguendo.
Mettere tutto insieme
Ecco un riepilogo dei passi di tuning in ordine di impatto.
Allineamento NUMA: assicurati che il disco NVMe e le vCPU della VM siano sullo stesso nodo NUMA. Da solo può valere una differenza di throughput del 20–30% sui sistemi multi-socket.
ASPM spento: aggiungi pcie_aspm=off alla riga di comando del kernel dell’host.
Elimina il jitter di latenza dovuto alle transizioni di stato di alimentazione del link PCIe.
Queue depth realistiche: testa a iodepth=32 o più, non a iodepth=1.
L’overhead IOMMU che domina a queue depth basse si ammortizza a profondità realistiche.
Posted interrupt: verifica che APICv (Intel) o AVIC (AMD) sia attivo. Riduce l’overhead per interrupt da microsecondi a nanosecondi.
Ottimizzazione dell’MPS: aggiungi pci=pcie_bus_perf alla riga di comando del kernel dell’host.
Imposta il MaxPayloadSize al massimo che la topologia supporta.
Gestione energetica di vfio-pci: aggiungi disable_idle_d3=1 se il tuo controller NVMe ha problemi di stato di alimentazione in passthrough.
Una riga di comando del kernel combinata per un nodo Proxmox che fa passthrough NVMe su un sistema AMD EPYC sarebbe più o meno così:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Per Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Quando il passthrough non ne vale la pena
Prima di imboccare questa strada, vale la pena chiedersi se ti serve davvero il passthrough NVMe.
VirtIO-SCSI e VirtIO-BLK con un disco virtuale su NVMe sono già molto efficienti. L’overhead rispetto al passthrough è di solito del 5–10% sulla latenza. La differenza di throughput è trascurabile per la maggior parte dei carichi.
Il passthrough ha senso quando ti serve che il sistema operativo guest gestisca direttamente il dispositivo. Questo include il monitoraggio SMART, gli aggiornamenti del firmware, il controllo di TRIM/discard e funzioni NVMe specifiche come le reservation. Ha senso anche per i carichi sensibili alla latenza dove contano persino pochi microsecondi. Certi motori di database e l’ingestione di dati in tempo reale rientrano in questa categoria.
Per tutto il resto, i compromessi operativi visti prima, cioè la perdita della migrazione a caldo, degli snapshot e dell’integrazione con i backup, di solito pesano più del piccolo guadagno di prestazioni.
Non c’è niente di furbo nello scegliere la strada più difficile quando quella più facile fa il lavoro.
Verificare le modifiche
Dopo aver applicato i passi di tuning, verifica che tutto funzioni come previsto:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Confronta i risultati della VM con la baseline bare metal di prima.
A iodepth=32 dovresti vedere un throughput entro il 5% dal bare metal.
Le medie della latenza di completamento dovrebbero stare entro 10–15µs dalle cifre dell’host.
Se la differenza è ancora grande, controlla prima l’allineamento NUMA.
È il fattore trascurato più spesso.
E non costa altro che una modifica di configurazione, il che lo rende il tipo di problema migliore che ti possa restare.
Riferimenti
- Linux kernel PCI documentation — MPS and MRRS tuning options — la fonte autorevole per
pcie_bus_perf,pcie_bus_safee i parametri collegati - Proxmox VE Administration Guide — PCI(e) Passthrough — la documentazione ufficiale di Proxmox sulla configurazione del passthrough di dispositivi VFIO
- Proxmox Forum — NVMe Passthrough Performance — la discussione della community da cui è nato questo articolo