Che cos’è l’MPS
I dispositivi PCIe trasferiscono i dati in pacchetti chiamati Transaction Layer Packet (TLP). Ogni TLP ha un header e un payload. La dimensione massima di quel payload è la MaxPayloadSize (MPS).
L’MPS viene negoziata tra un dispositivo e il suo bridge a monte durante il link training. Il valore negoziato è il più piccolo tra quello che il dispositivo supporta e quello che il bridge consente. Ogni bridge e switch nel percorso tra il dispositivo e il root complex ha la sua capacità MPS. L’MPS finale di qualsiasi dispositivo la decide il punto più stretto della catena.
I valori MPS comuni sono 128, 256 e 512 byte. Alcuni dispositivi supportano 1024 o perfino 4096 byte, ma in pratica 256 o 512 è il valore tipico per controller NVMe e schede di rete. Le GPU spesso supportano 256 byte.
Perché conta
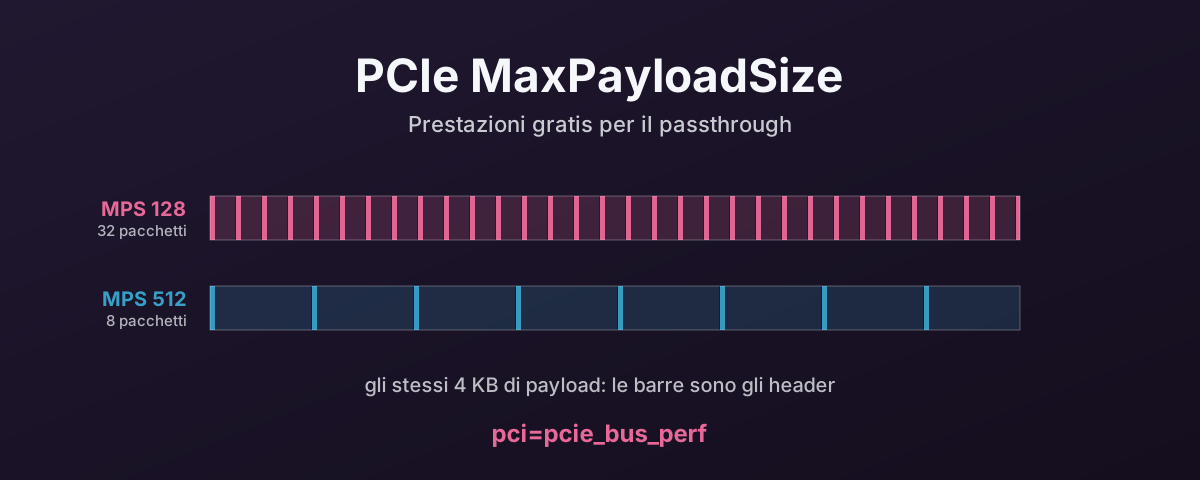
Un’MPS più grande significa meno pacchetti per la stessa quantità di dati. Un IO da 4KB trasferito con MPS 128 richiede 32 TLP. Lo stesso trasferimento con MPS 512 ne richiede 8.
Ogni TLP porta con sé un overhead di protocollo: l’header, il CRC, il framing. Meno TLP significa meno overhead di protocollo per byte trasferito. Ad alto throughput, la differenza si misura. Non è drammatica. Ma è reale. Ed è lo stesso overhead, pagato su ogni pacchetto.
L’MPS influisce anche su quanto bene viene usato il link PCIe. Payload più piccoli significano che il link passa più tempo sugli header rispetto ai dati. Payload più grandi spostano il rapporto verso i dati utili.
L’impatto sulla latenza è minore di quello sul throughput. Una singola lettura da 4KB con MPS 128 contro 512 non mostrerà una differenza di latenza che valga la pena misurare, perché i TLP vanno in pipeline. Ma spingi molti IOPS con tanti trasferimenti in volo e il minore overhead di un’MPS più grande si somma.
Il problema con il passthrough
Su bare metal, il BIOS imposta l’MPS durante il POST in base alla topologia PCIe. Il BIOS di un server moderno di solito imposta l’MPS al massimo che la topologia supporta, in genere 256 o 512 byte.
Sotto QEMU, il root complex del chipset virtuale Q35 ha la sua capacità MPS.
Di default presenta un’MPS bassa.
La policy MPS predefinita del kernel Linux (pcie_bus_default) imposta l’MPS di ogni dispositivo uguale a quella del suo bridge padre, il che in una topologia virtuale vuol dire il valore predefinito del root complex di QEMU. Spesso 128 byte.
Per questo un dispositivo che può fare payload da 512 byte gira a 128, perché il root complex virtuale ha fissato il tetto.
Come sistemarlo: lato host
Di’ al kernel di impostare l’MPS al massimo che il bus padre di ogni dispositivo supporta:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Così l’MPS di ogni dispositivo diventa il valore più grande che il suo bus padre consente. Imposta di conseguenza anche l’MRRS (Max Read Request Size). Il sorgente del kernel dice che garantisce che l’MPS di un dispositivo non sia più grande di quella del padre. Così la catena resta coerente e si ottengono le dimensioni di trasferimento migliori.
Dopo il riavvio, verifica la nuova MPS:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Dovresti vedere MaxPayload 256 bytes o MaxPayload 512 bytes al posto del valore predefinito 128.
Le altre opzioni del kernel
Il kernel offre cinque policy MPS, ognuna impostata tramite il parametro di boot pci=:
pcie_bus_tune_off: non toccare affatto l’MPS.
Usa quello che ha impostato il BIOS.
Su bare metal con un buon BIOS spesso va bene.
Sotto QEMU, il BIOS è OVMF o SeaBIOS, che potrebbero non ottimizzare l’MPS.
pcie_bus_default: il valore predefinito del kernel.
Imposta l’MPS di ogni dispositivo uguale a quella del suo bridge a monte.
Prudente e sicura, ma non massimizza le prestazioni.
pcie_bus_safe: imposta l’MPS al valore più grande supportato da tutti i dispositivi del sistema.
Utile nei sistemi chiusi dove conosci tutti i dispositivi e niente verrà collegato a caldo.
Un po’ più aggressiva di quella predefinita.
pcie_bus_perf: imposta l’MPS di ogni dispositivo al valore più grande che il bus padre consente.
Ogni dispositivo ottiene la migliore MPS che la sua topologia locale supporta.
È la scelta giusta per il passthrough, perché ottimizza ogni percorso in modo indipendente.
pcie_bus_peer2peer: imposta l’MPS a 128 byte su tutto.
Ogni dispositivo parla alla dimensione comune più bassa.
Si usa quando i dispositivi devono fare DMA direttamente l’uno verso l’altro (da GPU a GPU, da GPU a NIC via RDMA).
Non serve per il passthrough normale.
pcie_bus_perf è quella giusta per il passthrough.
Come sistemarlo: lato guest
Puoi impostare pci=pcie_bus_perf anche nella configurazione di boot del kernel guest.
Se abbia un effetto pratico dipende da come QEMU presenta la topologia PCIe virtuale.
Il root complex virtuale limita quello che il guest può negoziare.
Nei test, la correzione lato host è quella che tiene. L’host possiede il dispositivo fisico, e la sua impostazione MPS decide la dimensione reale dei TLP sul filo. L’impostazione del guest tocca solo la topologia virtuale dentro la VM, e se questo cambi il comportamento reale dipende da come QEMU presenta il percorso PCIe per quel dispositivo.
Impostala sull’host. Impostarla anche nel guest non fa male, ma non contare solo su quella.
Che cos’è l’MRRS
La Max Read Request Size (MRRS) è collegata ma distinta. L’MPS limita quanti dati un dispositivo può inviare in un TLP. L’MRRS limita quanti dati un dispositivo può chiedere in una richiesta di lettura.
Un dispositivo con MRRS 4096 può emettere una sola richiesta di lettura da 4KB. La risposta torna in più TLP, ognuno grande al massimo quanto l’MPS. Un’MRRS più alta significa che il dispositivo può chiedere più dati per transazione, riducendo il numero di TLP di richiesta di lettura sul bus.
pci=pcie_bus_perf imposta sia l’MPS sia l’MRRS ai valori ottimali.
Non serve regolarle separatamente.
Impatto rispetto ad altre ottimizzazioni
La differenza di MPS tra 128 e 512 byte ha un impatto sulle prestazioni minore dell’allineamento NUMA o dell’ASPM. Di solito è un miglioramento del throughput di poche unità percentuali. Non lo vedrai nei benchmark di latenza a bassa queue depth.
Ma è un’ottimizzazione gratuita. Un parametro del kernel, nessuno svantaggio, nessun rischio di compatibilità. Non c’è motivo per non impostarlo su qualsiasi sistema che fa passthrough.
Non costa niente, e l’hardware l’hai già pagato. Tanto vale avere quello che hai comprato.
Riferimenti
- Linux kernel PCI Kconfig — MPS and MRRS tuning options — fonte autorevole per tutte e cinque le policy MPS
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — la presentazione di Sinan Kaya sulla gestione di MPS/MRRS nel kernel