Cos’è NUMA
NUMA sta per Non-Uniform Memory Access. Su un sistema a socket singolo, ogni core della CPU accede a tutta la RAM del sistema attraverso lo stesso controller di memoria. Il tempo di accesso è lo stesso, qualunque sia il core che fa la richiesta e dovunque stiano i dati nella memoria fisica.
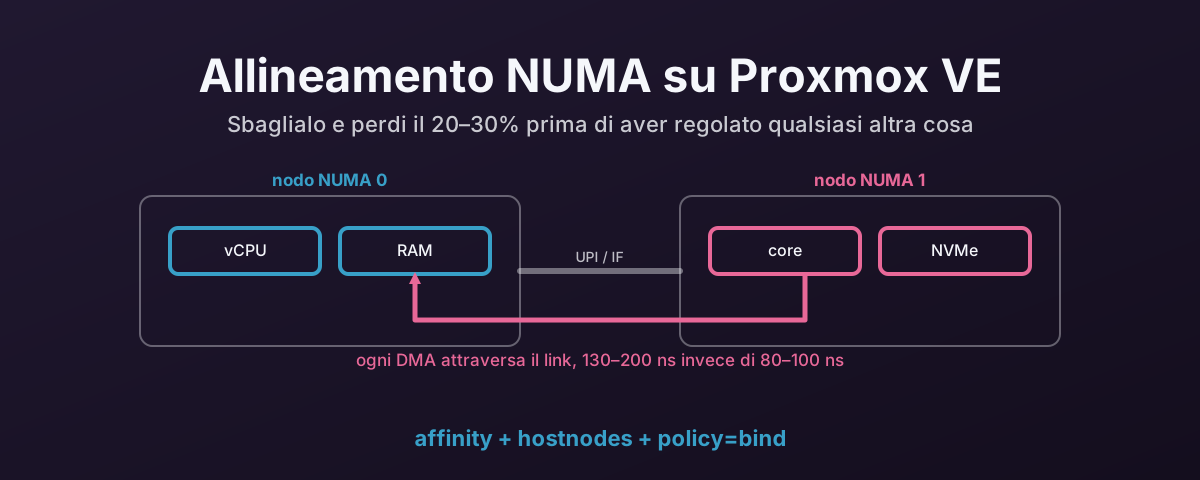
Su un sistema multi-socket, ogni socket ha il suo controller di memoria e il suo banco di RAM. Un core sul socket 0 accede velocemente alla RAM collegata al socket 0: quella è memoria locale. Può accedere anche alla RAM collegata al socket 1, ma quella richiesta deve attraversare il collegamento tra i socket (Intel UPI, AMD Infinity Fabric). Quella è memoria remota, ed è più lenta.
Il kernel chiama ogni socket con la sua memoria locale un nodo NUMA. Un sistema AMD EPYC a doppio socket ha almeno due nodi NUMA. Alcuni processori EPYC espongono quattro nodi NUMA per socket (uno per CCD), il che fa otto nodi su una scheda a doppio socket.
La differenza di prestazioni tra accesso locale e remoto non è sottile. L’accesso locale costa circa 80–100ns. Quello remoto circa 130–200ns. È una penalità del 50–100% per ogni operazione di memoria. Da solo è un numero piccolissimo. Pagato su ogni accesso alla memoria per tutta la vita della VM, smette di essere piccolo.
Perché conta per la virtualizzazione
Quando Proxmox crea una VM, assegna vCPU e RAM. Di default, quelle vCPU possono essere schedulate su qualsiasi core fisico di qualsiasi socket. La RAM della VM può essere allocata dal pool di memoria di qualsiasi nodo NUMA.
Se lo scheduler mette una vCPU sul socket 0 e la RAM della VM è sul socket 1, ogni accesso alla memoria di quella vCPU attraversa il collegamento tra i socket. Se le vCPU rimbalzano tra i socket, e lo fanno se non sono pinnate, lo schema di accesso alla memoria diventa un disastro. Alcuni accessi sono locali, altri remoti, e le prestazioni della VM oscillano di conseguenza.
Per i carichi generici, un web server, un file server, una VM desktop, spesso ci si convive. L’overhead c’è, ma è spalmato su tante operazioni e non domina.
Per i carichi intensivi di IO, database, storage server, qualsiasi cosa faccia molto IO su disco o in rete, la penalità si accumula. Ogni completamento DMA, ogni consegna di interrupt, ogni copia di buffer coinvolge un accesso alla memoria. Se quegli accessi attraversano i socket, l’overhead cresce in fretta.
Perché conta per il passthrough
I dispositivi PCIe sono collegati fisicamente a un socket preciso. Ogni socket ha il suo root complex PCIe. Il disco NVMe nello slot 3 potrebbe stare sulle linee PCIe del socket 0. La GPU nello slot 5 potrebbe stare su quelle del socket 1.
Quando un dispositivo fa DMA, i dati finiscono nella memoria collegata al nodo NUMA a cui l’IOMMU li mappa. Se la RAM della VM è allocata dal nodo locale del dispositivo, la scrittura DMA va dritta in memoria locale. Se la RAM sta sull’altro nodo, ogni operazione DMA attraversa il collegamento tra i socket.
Per un disco NVMe che fa centinaia di migliaia di IOPS, quella penalità di 50–100ns per operazione si somma.
Con iodepth=32 e letture casuali da 4KB, la differenza di throughput tra NUMA allineato e disallineato può arrivare al 20–30%.
E questo prima di aver guardato l’overhead dell’IOMMU, ASPM, MPS o qualsiasi altra cosa.
Lo stesso vale per schede di rete, GPU e qualsiasi altro dispositivo in passthrough. Il traffico DMA del dispositivo deve finire in memoria locale, e le vCPU che elaborano quel traffico devono stare sullo stesso nodo.
Come controllare la tua topologia
Trova su quale nodo NUMA sta un dispositivo
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Restituisce il numero del nodo NUMA.
Se restituisce -1, il kernel non è riuscito a determinare il nodo. A volte succede con dispositivi dietro certi switch PCIe.
In quel caso, ricostruisci la topologia PCIe a mano con lspci -tv e abbina la root port al socket.
Guarda la disposizione NUMA completa
numactl --hardware
Ti mostra ogni nodo NUMA, quanti core CPU ci sono sopra, quanta memoria è collegata e la distanza (il costo relativo) tra i nodi.
Output di esempio da un sistema EPYC a doppio socket:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
La tabella delle distanze ti dà il costo relativo. 10 è locale. 32 è remoto. Numeri più alti significano più salti. Sulle configurazioni EPYC a quattro nodi per socket, alcune coppie di nodi hanno distanza 32 e altre 16, a seconda del CCD su cui stanno.
Abbina i dispositivi ai nodi
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Così hai il quadro completo di quali dispositivi stanno su quali nodi. Cerca i controller NVMe, le schede di rete e le GPU che passi in passthrough.
Come allineare una VM in Proxmox
Pinna le vCPU sul nodo giusto
Nel file di configurazione della VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
Il parametro affinity pinna le vCPU della VM a core fisici precisi.
Impostalo all’intervallo di core dello stesso nodo NUMA del dispositivo in passthrough.
Se il tuo NVMe è sul nodo 1 e il nodo 1 ha i core 16–31, imposta affinity: 16-31.
Se la VM ha bisogno solo di 8 vCPU, pinnala su un sottoinsieme: affinity: 16-23.
Alloca la memoria dal nodo giusto
Attivare numa: 1 nella configurazione della VM dice a Proxmox di presentare alla VM una topologia NUMA.
QEMU cercherà di allocare la memoria della VM dal nodo NUMA su cui sono pinnate le vCPU.
Per un controllo esplicito, puoi impostare la topologia NUMA nella configurazione della VM:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Questo dice a QEMU di legare il primo nodo NUMA della VM (il nodo 0 dal punto di vista del guest) al nodo NUMA 0 dell’host, usando i core 0–7 e 16GB di memoria.
policy=bind garantisce che la memoria venga allocata solo da quel nodo invece di ripiegare su altri nodi se il pool locale è sotto pressione.
Verifica il pinning
Dopo aver avviato la VM, controlla che le vCPU girino davvero dove ti aspetti:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Errori comuni
Non pinnare affatto
Se non imposti affinity, le vCPU della VM possono essere schedulate su qualsiasi core.
Lo scheduler del kernel le sposterà tra i nodi in base al bilanciamento del carico.
Ogni volta che una vCPU migra da un nodo all’altro, tutti i dati su cui lavorava nella cache del vecchio nodo diventano remoti.
Per le VM generiche è accettabile. Per le VM in passthrough con IO pesante, no.
Pinnare sul nodo sbagliato
Controlla il nodo NUMA del dispositivo prima di pinnare.
Non darlo per scontato.
Su alcune schede madri la numerazione fisica degli slot non corrisponde in modo ovvio all’assegnazione dei nodi NUMA.
Verifica sempre con cat /sys/bus/pci/devices/.../numa_node.
Sovraccaricare un nodo
Se pinni troppe VM sullo stesso nodo NUMA, i core di quel nodo finiscono sovraccarichi e il pool di memoria locale si esaurisce. Quando la memoria trabocca sul nodo remoto, ottieni il peggio dei due mondi: vCPU pinnate con memoria remota.
Distribuisci le VM tra i nodi. Se hai due nodi NUMA e quattro VM, dividile in parti uguali.
Dimenticare l’allocazione della memoria
Pinnare le vCPU senza controllare anche l’allocazione della memoria ti dà metà del beneficio.
Le vCPU sono sul nodo giusto, ma la memoria potrebbe non esserlo.
Usa policy=bind o almeno attiva numa: 1, così l’allocazione di QEMU segue il pinning delle CPU.
Sistemi a socket singolo
Su un sistema a socket singolo, tutto sta sul nodo NUMA 0. C’è un solo controller di memoria e un solo insieme di linee PCIe. L’allineamento NUMA non è un problema.
Puoi comunque impostare numa: 1 nella configurazione della VM, non fa danni, ma non aiuta nemmeno.
Un socket, un controller di memoria, niente da allineare.
Tieni lo sforzo per una macchina che di socket ne ha due.
Per questo i guadagni di prestazioni descritti qui valgono solo per i sistemi multi-socket, dove il collegamento tra i socket esiste.
Riferimenti
- Proxmox VE Administration Guide — CPU and NUMA Configuration — documentazione ufficiale sul pinning delle vCPU e sulle opzioni NUMA
- Linux kernel NUMA documentation — riferimento sulle memory policy del kernel
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — la documentazione AMD su NUMA per socket e sulla topologia CCD/CCX