La domanda con cui inizia ogni valutazione di Proxmox
«Proxmox è davvero enterprise?»
Salta fuori in quasi ogni discussione su una migrazione, e la preoccupazione che ci sta sotto non è quasi mai l’interfaccia web. Nessuno teme seriamente che una dashboard nel browser gli corrompa i dati. Quello che le persone chiedono è se la cosa che sta tra una macchina virtuale e l’hardware, il componente che deve tenere un tenant fuori dalla memoria di un altro tenant, per sempre, senza un solo errore, sia un pezzo di ingegneria serio o un progetto della community diventato popolare.
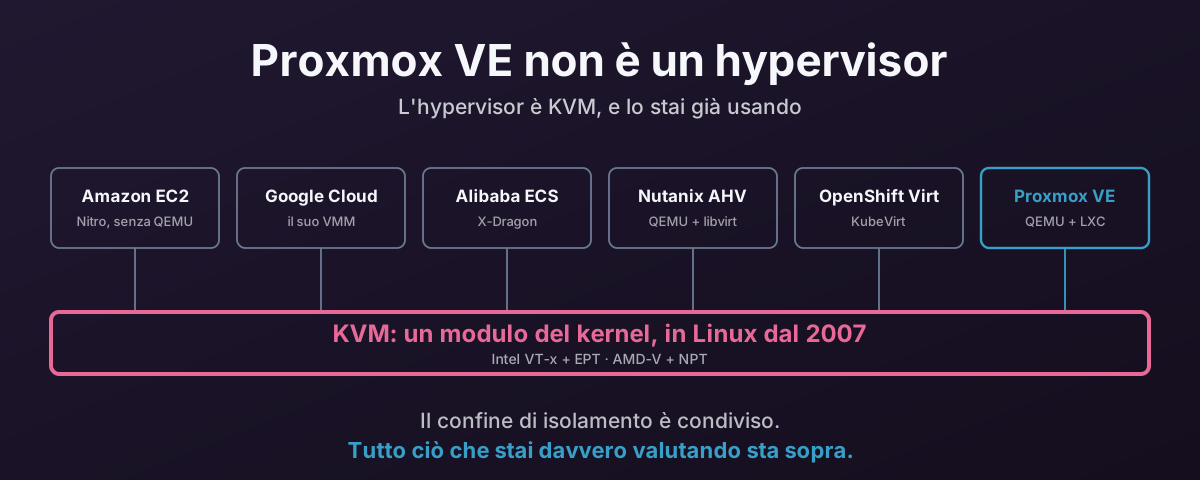
È esattamente la cosa giusta di cui preoccuparsi. Solo che è puntata sul livello sbagliato, perché Proxmox VE non contiene un hypervisor.
L’hypervisor è KVM. Fa parte di Linux, c’è dal 2007, e se la tua organizzazione usa EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean o Nutanix, lo stai già usando in produzione oggi: semplicemente non ci hai mai dovuto pensare, perché i livelli sopra erano di qualcun altro.
Questo articolo parla di cosa significa davvero quella base comune. Di entrambe le metà: la parte dell’argomento che regge davvero, e la parte che nelle slide dei vendor viene gonfiata.
Proxmox VE è un livello di gestione
La virtualizzazione su Linux è fatta di quattro livelli distinti, costruiti e mantenuti da quattro gruppi diversi di persone.
1. Le estensioni hardware per la virtualizzazione. Intel VT-x con EPT, o AMD-V con NPT. Silicio. È ciò che permette a un guest di far girare il proprio kernel a velocità nativa con le proprie page table, senza che niente emuli le istruzioni.
2. KVM: l’hypervisor.
Moduli del kernel: kvm.ko per il nucleo indipendente dall’architettura, più kvm-intel.ko o kvm-amd.ko per le estensioni del vendor. È il componente che possiede il confine di isolamento. Prepara le strutture di controllo della macchina virtuale del guest, gestisce le VM exit, amministra le page table di secondo livello e consegna gli interrupt.
3. Il VMM: il monitor delle macchine virtuali, in user space. Su Proxmox VE è QEMU. Costruisce la scheda madre virtuale: chipset, topologia PCIe, dischi, schede di rete, porte seriali, firmware. KVM fa girare la CPU; QEMU decide quale hardware il guest crede di avere.
4. Il livello di gestione.
Questo è Proxmox VE: pve-manager e pveproxy per l’API e l’interfaccia, qemu-server per trasformare un file di configurazione di VM in una riga di comando di QEMU, pve-container per LXC, pmxcfs sopra Corosync per la configurazione replicata del cluster, pve-ha-manager per fencing e riavvio, più lo stack di firewall e SDN.
Quei quattro livelli esistono anche sulla piattaforma da cui stai migrando, e fanno gli stessi quattro lavori: vCenter è il livello 4, VMkernel il livello 2. Tornerò su questo confronto quando tutti i pezzi saranno sul tavolo.
Cosa mantiene davvero Proxmox
Proxmox VE possiede interamente il livello 4. Sarebbe però sbagliato dire che si limita a pacchettizzare i livelli 2 e 3, ed è l’equivoco più comune su cosa faccia l’azienda.
pve-qemu porta 78 patch rispetto a QEMU upstream nel suo file series, nel momento in cui scrivo:
debian/patches/series. Gran parte della coda è ingegneria propria di Proxmox, e sta tutta nel livello 3: nessuna di queste patch tocca kvm.ko.Compilano anche il proprio kernel, e mantengono pacchetti o patch per gran parte dello stack intorno: pve-edk2-firmware per OVMF, più lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm e ceph.
Quindi il confine reale è: tutto il livello 4, ingegneria sostanziale dentro il livello 3, e un kernel che compilano loro. Quello che non hanno fatto è scrivere un hypervisor. Il codice KVM del livello 2 è Linux upstream.
E niente di tutto questo è una critica a Proxmox. Per questo, anzi, è il motivo per cui ci si può fidare di un’azienda delle dimensioni di Proxmox per questo lavoro. Una piccola azienda di Vienna non si è messa a scrivere un hypervisor da zero; ha costruito su uno che Intel, AMD, Red Hat, Google, Amazon e IBM pagavano già degli ingegneri per mantenere, e ha speso il proprio impegno sul livello sopra e sul lavoro di integrazione che quel livello richiede. È lì che un team di quelle dimensioni può fare la differenza, e la coda delle patch mostra che la fa.
Cos’è davvero KVM
KVM sta per Kernel-based Virtual Machine, e il nome è esatto: è una funzione del kernel, non un programma.
Carichi i moduli e Linux ottiene un dispositivo a caratteri, /dev/kvm, più un piccolo insieme di chiamate ioctl su di esso: KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Quell’interfaccia è l’intera API dell’hypervisor. Qualsiasi cosa sia in grado di aprire un file descriptor e chiamare ioctl può creare macchine virtuali.
L’ha scritto Avi Kivity in Qumranet ed è stato integrato in Linux 2.6.20, rilasciato a febbraio 2007: diciannove anni fa. Red Hat ha acquisito Qumranet nel 2008, e KVM è presente in ogni release del kernel da allora, con la solita cadenza del kernel di nove-dieci settimane. È stato portato ben oltre x86: arm64, POWER, s390 su IBM Z e RISC-V.
Il punto architetturale importante è perché è piccolo.
KVM non ha uno scheduler, perché Linux ne ha uno. Una vCPU è un normale thread dell’host, e il completely fair scheduler la mette su un core come qualsiasi altro thread. Non ha un gestore della memoria, perché Linux ne ha uno. La RAM del guest è una normale mappatura in user space, quindi può essere paginata, appoggiata su hugepage o collocata su un nodo NUMA con gli stessi meccanismi di qualsiasi altro processo. Non ha uno stack di driver, un block layer, uno stack di rete o un filesystem, perché Linux li aveva già tutti, e sono quelli su cui il produttore del tuo hardware fa i test.
Questo è il vero argomento della maturità, ed è molto più forte di un numero di versione. Ogni miglioramento del bilanciamento NUMA, ogni modifica a io_uring, ogni driver di rete, ogni nuovo workaround per un’errata della CPU che arriva in Linux arriva sotto le tue macchine virtuali, perché non esiste un kernel dell’hypervisor separato su cui qualcuno debba portarlo.
L’argomento del type 1 traccia la linea nel posto sbagliato
L’obiezione che segue, puntuale, è che KVM è «solo un hypervisor di type 2». Gira su un sistema operativo host, a differenza di ESXi, che gira su bare metal.
Quella tassonomia è più vecchia della virtualizzazione hardware di tre decenni, e la cosa intorno a cui tracciava una linea non sta più dove tutti pensano.
Cosa succede davvero quando una vCPU gira
QEMU chiama ioctl(vcpu_fd, KVM_RUN). Il controllo passa in kvm.ko, che carica lo stato della CPU del guest ed esegue VMLAUNCH. Da quell’istruzione fino alla VM exit successiva, il guest esegue direttamente sul core fisico, in modalità guest, con le proprie page table attive tramite EPT, alla piena velocità dell’hardware. Sotto non c’è niente che interpreti qualcosa. Il «sistema operativo host» non è nel percorso. Su quel core non sta nemmeno girando.
Quando il guest fa qualcosa che va gestito, la CPU esce verso l’host e atterra in kvm.ko, nel kernel, esattamente al livello di privilegio occupato dal VMkernel di ESXi. La maggior parte delle exit viene risolta lì e si rientra senza che lo user space venga mai coinvolto.
ESXi ha la stessa divisione
Ora guarda la piattaforma che dovrebbe dimostrare la distinzione.
La documentazione di architettura di VMware stessa descrive VMkernel come «a POSIX-like operating system» che fornisce «process creation and control, signals, file system, and process threads». Questo, per descrizione del suo autore, è un sistema operativo. E una VM in esecuzione su ESXi non è una cosa dentro il kernel: è un gruppo di processi userworld: un VMM per ogni CPU virtuale, che virtualizza le istruzioni del guest e ne gestisce la memoria, e un processo VMX per ogni VM, che gestisce l’I/O verso i dispositivi non critici per le prestazioni e parla con il gestore degli snapshot e con la console remota.
Rileggilo pensando a QEMU. Contesto di esecuzione per vCPU nel kernel, processo per VM in user space che fa emulazione dei dispositivi e gestione. VMware l’ha divisa per lo stesso motivo di tutti gli altri.
Hyper-V non è diverso. La documentazione di Microsoft dice esplicitamente che il Virtual Machine Worker Process, vmwp.exe, è «a user mode component of the virtualization stack», avviato uno per VM, e che tutti i dispositivi emulati sono implementati lì, in esecuzione nella root partition, che è Windows. Perfino Xen, l’architettura a cui la tassonomia calza meglio, ha bisogno di un Linux general purpose in dom0 per funzionare, e prende il modello dei dispositivi per i guest completamente virtualizzati da QEMU.
Allora dov’è la linea?
Il criterio non è mai stato «usa lo user space?». La tassonomia di Goldberg, dei primi anni ‘70, chiede se l’hypervisor sia un’applicazione che gira su un sistema operativo preesistente che possiede già l’hardware e fa lo scheduling. Quello è un hypervisor di type 2, ospitato: VMware Workstation, VirtualBox, Parallels Desktop, QEMU puro senza accelerazione. Installi un sistema operativo general purpose, poi ci installi sopra un programma, e quel programma chiede al sistema operativo memoria e tempo di CPU come qualsiasi altro programma.
Non è questo che è KVM. kvm.ko non è un programma sopra Linux. È parte di Linux, esegue allo stesso livello di privilegio del codice che possiede l’hardware, e quando un guest esce atterra lì direttamente. Sotto l’hypervisor non c’è nessun sistema operativo host. Il kernel è l’hypervisor. Proxmox VE distribuisce quel kernel come il sistema, esattamente come ESXi distribuisce VMkernel come il sistema.
E la versione «ha bisogno dello user space, quindi è type 2» non si salva, perché applicata con coerenza prende tutto. Nessuna VM gira su ESXi senza il suo processo VMX, nessuna su Hyper-V senza vmwp.exe, nessuna su Xen come guest HVM senza QEMU. Un test che mette ogni hypervisor in commercio nello stesso secchio non sta distinguendo niente.
| Kernel che possiede la virtualizzazione di CPU e memoria | Modello dei dispositivi per VM in user space | Serve un sistema operativo host preesistente? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX per VM | No |
| Microsoft Hyper-V | hypervisor più la root partition Windows | vmwp.exe | No |
| Xen | hypervisor Xen più Linux in dom0 | QEMU, in dom0 o in uno stub domain | No |
| KVM | kvm.ko | QEMU | No |
| VirtualBox, VMware Workstation | il kernel dell’host, tramite un driver installato | l’applicazione stessa | Sì |
Quattro prodotti, una sola forma, e poi una quinta riga davvero diversa. Quell’ultima riga è ciò che «type 2» è stato coniato per descrivere, ed è l’unica dove qualcos’altro comandava già l’hardware.
Quindi la tassonomia traccia ancora una linea. Solo che non la traccia neanche lontanamente dove l’argomento presume: KVM ed ESXi stanno dallo stesso lato. Chiamare KVM type 2 prende in prestito una parola dalla categoria di VirtualBox e la applica a qualcosa che architetturalmente sta nella categoria di ESXi.
Il che lascia l’etichetta senza nessuna utilità in una valutazione, perché entrambi i prodotti tra cui stai scegliendo stanno nella stessa casella. Quello che cambia non è il numero del tipo. È che un vendor ha scritto anche il kernel e non te lo fa leggere: una distinzione di licenza e di trasparenza travestita da diagramma di architettura. Nutanix lo dimostra sul piano commerciale: distribuisce lo stesso codice KVM di Proxmox e descrive AHV come un hypervisor bare metal di type 1. Stesso codice, etichetta opposta, ufficio marketing diverso.
Dentro l’accusa c’è una preoccupazione reale, e merita un nome migliore: un kernel general purpose fa mille lavori che uno costruito apposta non fa, il che significa più codice e più superficie d’attacco accanto al confine di isolamento. È legittima e misurabile, e ci torno verso la fine.
Dove avviene davvero il lavoro
L’unico punto in cui l’istinto del «gira su un sistema operativo host» ha ragione è la gestione delle exit, quindi conviene essere chiari su quali exit vanno dove.
| Il guest fa questo | Gestito da | Costo |
|---|---|---|
| Tocca una pagina non ancora mappata in EPT/NPT | kvm.ko, nel kernel | Una exit, microsecondi |
| Scrive sul proprio APIC locale | La CPU stessa, tramite APICv/AVIC | Spesso nessuna exit |
| Invia un interrupt tra processori | Posted interrupt in hardware | Spesso nessuna exit |
Trasmette su una coda virtio-net con vhost-net | Thread del kernel, nessun passaggio in user space | Un doorbell |
| Legge un registro di un controller e1000 o IDE emulato | Fino a QEMU | Exit più un giro in user space |
Solo l’ultima riga assomiglia alla caricatura del type 2, ed è anche la riga che elimini con la progettazione, usando dispositivi virtio e non presentando hardware legacy emulato che non ti serve. È lo stesso ragionamento dietro alla scelta di Q35 invece di i440fx: meno accessi ai registri intercettati, meno dispositivi legacy da percorrere.
Il sistema operativo host è una funzione, non un peso
L’altra metà del conto non entra mai nell’argomento, quindi eccola: un nodo Proxmox è una macchina su cui puoi davvero lavorare. È Debian, quindi l’intero archivio Debian è a un apt install di distanza.
- Il monitoraggio che già usi, un node exporter di Prometheus,
smartmontools, il tuo agent attuale, invece di quello che l’appliance sceglie di esporre. - Diagnostica quando qualcosa è lento:
fio,iperf3,nvme-cli,perf,bpftrace. - Agent di backup di qualsiasi vendor che distribuisca un binario per Linux.
- Gestione della configurazione, così l’hypervisor sta nello stesso inventario Ansible di tutto il resto invece di essere un caso speciale.
fwupdper il firmware, su hardware il cui vendor supporta LVFS.
Niente di questo richiede un formato di plugin, un bundle firmato o la benedizione del vendor. Confrontalo con il modello di ESXi, dove la shell è volutamente limitata, il codice di terze parti arriva come VIB, e non c’è proprio nessun package manager a cui rivolgersi.
Arriva fino allo stack di storage
Gli agent di monitoraggio sono la versione noiosa di questo discorso. La documentazione di storage di Proxmox elenca i plugin nativi, dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS, e poi aggiunge una frase che vale la pena prendere alla lettera:
you may use all storage technologies available for Debian Linux
È un’affermazione su dove sta il confine, e il meccanismo dietro è generico: porta un block device su ogni nodo, mettici sopra LVM, aggiungilo come storage LVM con shared attivo. È esattamente così che funzionano i percorsi supportati per Fibre Channel e iSCSI, quindi qualsiasi cosa sia in grado di produrre un block device condiviso può usare la stessa strada.
NVMe over TCP o RDMA è il caso da conoscere, perché è veloce, attuale e assente da quell’elenco di plugin. nvme-tcp e nvme-rdma sono driver host di Linux nel tree, e NVMe/TCP è in mainline dalla 5.0, quindi non c’è niente da compilare. nvme-cli è un pacchetto Debian (nvme discover, poi nvme connect), e nvmetcli configura il target nvmet nel kernel dall’altra parte. Un namespace collegato appare come /dev/nvmeXnY, e da lì è un normale block device.
ATA over Ethernet dimostra lo stesso punto dall’estremo opposto: antico, oscuro, ugualmente non supportato come plugin. Il driver aoe è in mainline; aoetools ti dà aoe-discover e aoe-stat; vblade trasforma qualsiasi file o block device su un’altra macchina in un target. Stessa strada, stesso risultato.
Nessuno dei due è un’API di plugin, un SDK o un programma di certificazione. È ciò che succede quando lo storage dell’hypervisor è il block layer di Linux.
Gli avvertimenti onesti, perché sembra un trucco da festa fino alle 3 di notte. Nessuno dei due trasporti è un tipo di storage di Proxmox testato, quindi l’integrazione e i suoi modi di fallire, comportamento alla riconnessione, multipath, timeout sotto carico, sono tuoi da gestire e tuoi da testare prima che ci finisca sopra qualcosa di importante. E AoE è un protocollo nudo di Livello 2, non instradabile e senza autenticazione, quindi va su una VLAN di storage isolata e da nessun’altra parte. NVMe/TCP almeno ha un modello di discovery e può essere instradato, ed è in gran parte per questo che oggi è quello da scegliere.
Chi altro usa KVM
Ecco da dove viene l’affermazione «lo stai già usando». Ogni piattaforma qui sotto usa lo stesso modulo del kernel.
| Piattaforma | Dove la incontri | La parte KVM | Il VMM in user space |
|---|---|---|---|
| Amazon EC2 (Nitro) | Cloud pubblico | Modulo core di KVM | Personalizzato: QEMU rimosso, modello dei dispositivi nelle schede Nitro |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker: un monitor di microVM minimale in Rust |
| Google Compute Engine | Cloud pubblico | KVM dal lancio | VMM proprio di Google, volutamente non QEMU |
| Alibaba Cloud ECS | Cloud pubblico | KVM semplificato (X-Dragon) | Personalizzato, con rete e storage scaricati su una scheda MoC |
| Oracle Cloud (OCI) | Cloud pubblico | KVM di Oracle Linux: lo stesso stack che Oracle distribuisce on-premises | Discendente di QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Cloud pubblico | KVM standard | QEMU |
| Nutanix AHV | HCI on-premises | KVM standard | QEMU con libvirt e Open vSwitch |
| OpenStack (Nova) | Cloud privato | KVM standard | QEMU tramite libvirt: il driver predefinito e il più testato |
| Apache CloudStack, OpenNebula, oVirt | On-premises | KVM standard | QEMU tramite libvirt |
| OpenShift Virtualisation, SUSE Harvester | Kubernetes | KVM standard | QEMU dentro un pod, tramite KubeVirt |
| Proxmox VE | On-premises | KVM standard | QEMU, con LXC accanto per i container |
Tutti tengono la metà del kernel e riscrivono la metà in user space
Gli hyperscaler non hanno fatto un fork di KVM. Hanno fatto un fork del lavoro di QEMU.
AWS ha spostato EC2 da Xen all’hypervisor Nitro, costruito sul modulo core di KVM con QEMU buttato via del tutto. Il modello dei dispositivi vive invece in schede Nitro dedicate, ed è così che ottengono prestazioni indistinguibili dal bare metal. Ogni tipo di istanza EC2 di generazione attuale gira su questo. A parte, Lambda e Fargate usano Firecracker, un VMM costruito apposta in Rust che parla con lo stesso /dev/kvm.
Google fa girare ogni VM di Compute Engine su KVM dal lancio di Compute Engine, e ha scritto un proprio VMM in user space invece di usare QEMU, esplicitamente per evitare l’enorme matrice di guest, dispositivi e modalità di QEMU. Sono anche andati nell’altra direzione e hanno irrobustito il modulo del kernel upstream, togliendo dispositivi emulati che non servivano a nessuno e restringendo l’insieme delle istruzioni emulate. Quel lavoro è nel KVM che stai usando.
Alibaba ha fatto una cosa della stessa forma con X-Dragon: un hypervisor KVM ridotto all’osso, con la virtualizzazione di rete e storage scaricata su una scheda MoC basata su FPGA.
Nutanix AHV è KVM più libvirt più QEMU più Open vSwitch più l’orchestrazione di Nutanix: di tutti i prodotti commerciali in quell’elenco, il parente più stretto di Proxmox VE. Un livello 4 diverso, e una fattura molto diversa.
Proxmox VE tiene QEMU di proposito
Viene la tentazione di leggere la tabella come una classifica, con AWS e Google in cima per aver sostituito QEMU. È la lettura sbagliata, perché il loro vincolo non è il tuo.
AWS e Google hanno un solo profilo hardware, su una scala dove un singolo bug di emulazione di un dispositivo è un evento che colpisce tutta la flotta, e controllano ogni confine delle immagini guest che a loro interessa. In quel mondo l’ampiezza di QEMU è quasi solo un rischio, quindi eliminarla è ovviamente giusto.
Tu non sei in quel mondo.
Hai un’immagine di appliance del 2013 che vuole una e1000. Hai una VM Windows il cui machine type deve restare bloccato per il resto della sua vita. Hai una GPU da passare in passthrough, un controller SAS emulato per accontentare un installer, un archivio di variabili UEFI da conservare. QEMU è esattamente ciò che permette a una piattaforma general purpose di dire di sì a tutto questo.
Quello che AWS chiama superficie d’attacco tu lo chiami matrice di compatibilità. Entrambe le descrizioni sono esatte; la differenza è se puoi scegliere i tuoi carichi.
Spiega anche la forma di quella coda di patch. AWS e Google hanno risolto backup e snapshot fuori dal VMM, nei loro servizi di storage. Proxmox non aveva un servizio di storage in cui risolverlo, quindi l’ha messo in QEMU: ecco perché savevm-async e il driver a blocchi di PBS esistono come patch e non come prodotti.
E vale la pena saperlo per un motivo pratico: le parti di Proxmox VE che ti mancherebbero di più sono quelle che non sono upstream. Le configurazioni delle tue VM sono testo semplice e le immagini dei dischi sono in formati standard, quindi una macchina si sposta. Ma uno snapshot che include lo stato della RAM, e una catena incrementale di Proxmox Backup Server, dipendono dal fork di QEMU di Proxmox. È una dipendenza molto più leggera di un hypervisor proprietario, il fork è pubblico, AGPL, e puoi leggerne ogni patch, ma non è zero, e «nessun lock-in a livello software» dovrebbe portarsi dietro questa nota.
Allora: è enterprise?
La versione pigra di questo argomento non funziona, e conviene dirlo chiaramente. «AWS usa KVM, quindi Proxmox VE è enterprise» è un non sequitur: prende un’affermazione su un livello e la applica di nascosto a un prodotto intero.
Ecco la versione che regge.
Ciò che è condiviso è il livello più difficile da fare bene e più pericoloso da sbagliare. La virtualizzazione di CPU e memoria, e il confine di isolamento tra tenant, è la parte dove un bug è una violazione e non un disservizio. Quel codice è revisionato da ingegneri pagati da Amazon, Google, Red Hat, Intel, AMD, IBM e Alibaba, e i suoi bug li trovano le realtà che gestiscono le flotte più grandi che esistano, di solito prima che il kernel arrivi a te. Quando arriva davvero una vulnerabilità di fuga dal guest, la correzione arriva con il normale aggiornamento del kernel che avresti applicato comunque. Non stai aspettando il ciclo di rilascio di un singolo vendor per un hypervisor che solo quel vendor può vedere.
Ciò che non è condiviso è tutto quello che sta sopra il confine. Il che significa che la domanda si riduce a due domande a cui è molto più facile rispondere:
- Il livello di gestione è abbastanza buono per il modo in cui lavori?
- Puoi comprarne il supporto a condizioni con cui puoi convivere?
Entrambe si possono verificare in un proof of concept e scrivere in un contratto. Nessuna delle due richiede di avere fede in un hypervisor.
È una posizione molto migliore di quella che la domanda originale presume, cioè che ti si chieda di fidarti di un hypervisor nuovo di un piccolo vendor. Non è così. Il codice specifico di Proxmox è un livello di gestione per lo più in Perl e sempre più in Rust, più quella coda di patch su QEMU, e nota dove atterrano le patch: il modello dei dispositivi e il percorso di backup, non il confine di isolamento.
Vale anche la pena sapere quanto ti costa un guasto del livello specifico di Proxmox. I processi QEMU sono normali processi indipendenti sull’host, quindi se pveproxy cade non si ferma neanche una macchina virtuale. È un raggio d’impatto molto diverso dal perdere il componente che possiede il confine di isolamento.
Cosa «lo stesso hypervisor» non ti compra
È qui che i documenti di rassicurazione dei vendor tendono a fermarsi, il che dice qualcosa su per chi sono scritti. È la metà più utile.
Non ti compra l’affidabilità di AWS. La disponibilità di Nitro ha pochissimo a che fare con KVM. Viene dal control plane, dalla rete, dal servizio di storage, dalla gestione della capacità e dalla pratica operativa intorno. L’affidabilità del tuo cluster verrà dal progetto del quorum di Corosync, dalla configurazione del fencing, dalla scelta dello storage e dalla ridondanza di rete. KVM non ha opinioni su nessuna di queste cose. Condividere un hypervisor con un hyperscaler non ti fa ereditare le sue operations.
Non ti compra la superficie d’attacco di Nitro, ed è qui che atterra la metà legittima dell’accusa di type 2.
Stai facendo girare QEMU su un kernel general purpose, e storicamente è nel modello dei dispositivi di QEMU che sono vissute le fughe dalle VM più memorabili: VENOM, in un controller floppy emulato che nessuno usava, è l’esempio canonico. All’epoca Google poté far notare che Compute Engine non era colpito proprio perché non usa QEMU. Tu lo usi, quindi i controlli compensativi sono tuoi: preferisci virtio all’hardware emulato, non presentare dispositivi che non ti servono, lascia stare i profili AppArmor, e aggiorna QEMU con la stessa disciplina del kernel. Le patch extra/ di Proxmox sono loro che fanno esattamente questo per conto tuo, ed è ragionevole controllare che lo stiano ancora facendo.
Non rende portabile il comportamento delle VM tra piattaforme.
Scelta del modello di CPU, versioni dei machine type, compatibilità della migrazione live e comportamento dell’orologio si decidono tutti nei livelli 3 e 4, e cambiano ovunque. Un cluster con generazioni di CPU miste ti punirà comunque se imposti il tipo di CPU su host, e gli orologi dei guest derivano comunque qualunque sia il logo sulla piattaforma. Stesso hypervisor non vuol dire stesso comportamento.
Non risponde alla domanda sul supporto, che è quella a cui gli acquisti tengono davvero, e a ragione. Proxmox VE è AGPLv3 e gratuito da usare in produzione. La sottoscrizione compra il repository enterprise testato e il supporto del vendor, a partire da 120 € per socket all’anno. Il supporto di Proxmox stesso viene erogato in orario d’ufficio austriaco, quindi la copertura 24 ore su 24 viene dai partner e non da Vienna. croit, dove lavoro, è uno di quei partner, e copre 24/7, 365 giorni l’anno. È una trattativa commerciale, non un rischio tecnico, e il fatto che sia una trattativa commerciale è il senso di tutto quello che c’è sopra.
Cosa valutare davvero invece
Se l’hypervisor è una questione chiusa, un proof of concept dovrebbe spendere il suo tempo sul livello davvero specifico di Proxmox VE:
- Fencing e HA. Togli la corrente a un nodo con guest HA in esecuzione e cronometra il riavvio. Poi fallo a due nodi e verifica che quelli rimasti si comportino come ti aspetti quando si perde il quorum.
- Migrazione live tra generazioni di CPU. Con il modello di CPU su cui intendi davvero standardizzare, non
host. - Il backup e, soprattutto, il ripristino. Tempi di ripristino sotto carico, non tempi di backup. Nessuno è mai stato ringraziato per un backup veloce.
- Il modello dei permessi. Se puoi dare a un team applicativo console e controllo dell’alimentazione delle sue VM e nient’altro, con una granularità sufficiente a soddisfare un auditor.
- L’API. Tutto ciò che fa l’interfaccia web è una chiamata API; se la tua automazione non riesce a pilotarla, la piattaforma non si adatterà al tuo modo di lavorare.
- Il percorso di aggiornamento. Un aggiornamento di versione maggiore sul cluster del PoC, prima di averci sopra 400 VM.
Nessuna di queste è una domanda su KVM. È proprio questo il punto.
L’hypervisor è la parte chiusa. Spendi il proof of concept sulle parti che non lo sono.
Riferimenti
KVM in sé
- KVM API documentation — l’interfaccia ioctl di
/dev/kvm, che è l’intero contratto dell’hypervisor - Linux 2.6.20 release notes — la release in cui è stato integrato KVM, febbraio 2007
- Some KVM developments — LWN, gennaio 2007, su KVM nei giorni dopo il suo arrivo in mainline
Come sono costruiti gli altri hypervisor
- Interpreting virtual machine monitor and executable failures — la descrizione di Broadcom stessa di una VM ESXi in esecuzione come «several processes or userworlds», con un VMM per vCPU e un VMX per VM
- The Architecture of VMware ESXi (PDF) — il whitepaper che chiama VMkernel «a POSIX-like operating system» con processi, segnali, un file system e thread. Collegato tramite un mirror perché l’URL originale di VMware non è sopravvissuto alla riorganizzazione di Broadcom, il che è già di per sé un piccolo commento sulla continuità dei vendor
- Hyper-V architecture — Microsoft sul Virtual Machine Worker Process come componente in user mode, uno per VM, dove vivono tutti i dispositivi emulati
- The Nutanix Bible — AHV architecture — AHV descritto come KVM con libvirt, QEMU e Open vSwitch
Chi usa KVM, e come l’ha cambiato
- 7 ways we harden our KVM hypervisor at Google Cloud — Google su KVM senza QEMU, e sul lavoro di irrobustimento fatto upstream
- The AWS Nitro System — quali tipi di istanza EC2 girano sull’hypervisor Nitro
- AWS EC2 Virtualization 2017: Introducing Nitro — il resoconto di Brendan Gregg del passaggio da Xen a KVM, ancora il più chiaro
- Firecracker — il VMM minimale di AWS basato su KVM dietro Lambda e Fargate
- Alibaba Cloud’s sixth-generation ECS instances — l’hypervisor X-Dragon e lo scarico su MoC
- KubeVirt — il modello QEMU/KVM dentro un pod dietro OpenShift Virtualisation e Harvester
- OpenStack Nova hypervisor support matrix — KVM come driver di riferimento
Cosa mantiene Proxmox
- The Proxmox GitHub organisation — 89 repository, tra cui
pve-qemu,pve-kernel,pve-edk2-firmwaree i pacchetti perlxc,zfsonlinux,openvswitch,libiscsi,corosync-pveeceph pve-qemupatch series — le 78 patch contate sopra, e il modo più rapido per vedere esattamente cosa aggiunge Proxmox a QEMU- Proxmox VE storage documentation — l’elenco dei plugin nativi, quali tipi di storage sono condivisi, e la frase sull’uso di tutte le tecnologie di storage disponibili per Debian Linux
nvme-clienvmetcli— gli strumenti host e target per NVMe-oF;aoetoolsevbladeper l’equivalente ATA over Ethernet. Tutti in Debian trixie, su cui è costruito Proxmox VE 9- Proxmox VE pricing and subscription tiers — cosa copre la sottoscrizione
Trasparenza: lavoro per croit, un Gold Partner di Proxmox. Le affermazioni tecniche qui sopra hanno fonti e si possono verificare; il paragrafo commerciale è la parte in cui ho un interesse, quindi trattala di conseguenza.