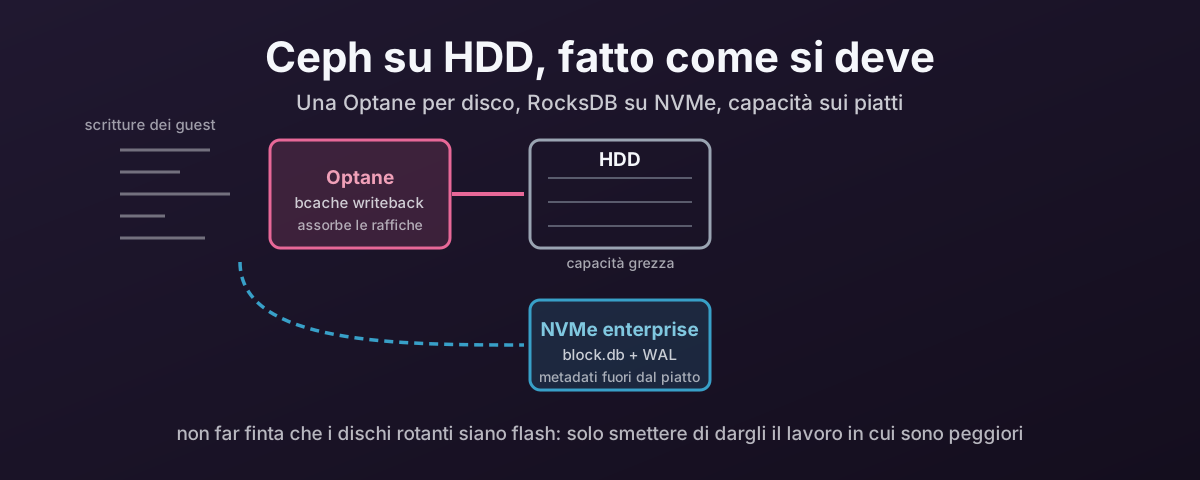
Perché gli HDD sono tornati nel menu
Per anni il consiglio era abbastanza semplice da stare su un post-it: metti tutto su SSD.
Quel consiglio era giusto, ed era anche economico. Nessuna delle due cose è più del tutto vera. L’offerta di NAND si è ristretta, la domanda dell’IA ha spinto in alto i prezzi del flash, e l’NVMe ad alta capacità è diventato difficile da giustificare in un deployment Proxmox attento ai costi, quello che deve essere operativo, affidabile e tanto economico quanto l’onestà permette.
Gli HDD enterprise tornano interessanti per lo stesso motivo di sempre: capacità per sterlina, e niente altro ci si avvicina.
Il problema è che chiunque abbia fatto girare VM su dischi rotanti sa quanto possa andare male. Quell’esperienza è reale, e di solito è colpa dell’architettura più che dei dischi.
Dare la colpa ai dischi è più facile, però. È anche sbagliato, ed è costoso, perché convince la gente a comprare flash di cui non aveva bisogno.
Tutto quello che segue presume Proxmox con OSD Ceph iperconvergenti, perché è lì che le decisioni sul layout fanno davvero male.
Il problema è la latenza, non il throughput
Un HDD enterprise moderno sposta benissimo grandi quantità di dati sequenziali. Non è mai stato quello il collo di bottiglia.
Un disco enterprise a 7.2k RPM fornisce intorno agli 80-100 IOPS di lavoro casuale, perché ogni operazione casuale aspetta uno spostamento della testina e una rotazione del piatto. Quel numero si è mosso a malapena in vent’anni. È meccanica, non elettronica. Un SSD enterprise di fascia base sta a tre o quattro ordini di grandezza di distanza.
Dai allo stesso disco lavoro sequenziale ed è un dispositivo utile. Il numero di operazioni grosso modo raddoppia, a circa 200 IOPS, ma ognuna di quelle operazioni ora porta un blocco grande perché la testina è già nel punto giusto e può continuare a leggere di seguito. Quindi ottieni throughput vero, da 150 a 250 MB/s, a un prezzo per terabyte che nient’altro tocca.
È questa l’asimmetria importante, e non è «gli HDD sono lenti». Un disco rotante è bravo nel lavoro sequenziale e senza speranza in quello casuale, e i due numeri sono vicini solo perché la cosa limitata è il numero di operazioni, non i byte.
Il che fissa l’intero obiettivo del progetto. Non stai cercando di rendere il disco più veloce. Non puoi. Stai cercando di fare in modo che passi il suo tempo nella modalità in cui è già competente, e di tenere lontano da lui il piccolo traffico casuale. Tutto quello che segue è questa sola idea applicata due volte.
Il guaio è che le macchine virtuali non generano il carico in cui gli HDD sono bravi. Generano aggiornamenti di metadati, scritture di journal, piccoli flush sincroni, log, manutenzione del filesystem, e raffiche di attività casuale da una dozzina di guest alla volta che arrivano al disco mescolate tra loro.
Ceph ci aggiunge il suo strato. Ogni scrittura porta con sé, oltre ai dati, aggiornamenti di metadati RocksDB. Se tutto questo finisce sui dischi rotanti nudi, i dischi passano il tempo a spostare la testina invece che a servire, e ottieni il sintomo che ogni amministratore riconosce: I/O wait alto, guest lenti, reattività incostante, e un cluster che sembra molto più lento di quanto suggerisca la sua scheda di capacità.
Le linee guida hardware di Ceph stesso sono esplicite su dove porta tutto questo. Avvertono di «consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB», e dicono che i dischi sopra gli 8 TB «may be best suited for storage of large files / objects that are not at all performance-sensitive.»
Vale la pena fare quel conto, perché i dischi che rendono tutto questo conveniente sono proprio quelli grandi. Da 20 TB in su. Un disco da 20 TB fa sempre i suoi 80-100 IOPS casuali, perché la capacità non ti compra nessuna operazione in più. Quindi offre circa 4-5 IOPS casuali per terabyte, dove un disco da 8 TB ne fa circa undici, e uno da 2 TB quaranta.
Secondo la misura di Ceph stesso, quindi, un disco da 20 TB è ben dentro il territorio su cui ti dice di non mettere carichi sensibili alle prestazioni.
Non è un argomento contro l’acquistarli. È il motivo per cui esiste il resto di questo articolo. Il progetto qui sotto è esattamente ciò che rende un disco da 20 TB adatto allo storage delle VM, facendo in modo che il piccolo lavoro casuale non lo raggiunga mai.
Togli i metadati dal disco rotante
La modifica di maggior valore per un cluster su HDD è smettere di far tenere al disco la contabilità di Ceph.
BlueStore tiene tre cose per OSD: i dati veri e propri su block, il database di metadati RocksDB su block.db, e il write-ahead log su block.wal. Di default vivono tutti e tre sullo stesso dispositivo. Metti block.db su NVMe e una gran quantità di piccolo I/O casuale lascia del tutto il disco.
La documentazione hardware di Ceph lo dice chiaramente: «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD.»
Usa qui un NVMe enterprise vero, non flash consumer. Il motivo non sono i numeri da benchmark in prima pagina. È una latenza stabile sotto carico prolungato, e la protezione dalla perdita di alimentazione. La documentazione di Ceph è diretta: «Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)», e «bargain client-class or off-brand SSDs are a false economy.»
Dischi della classe Samsung PM9A3 e Micron 7450 Pro sono il genere di cosa che va qui. Sotto pressione in scrittura a Ceph interessa la costanza molto più dei numeri di picco, ed è esattamente ciò che separa un disco enterprise da uno consumer veloce.
Dimensionare block.db, e quanto costa lo spillover
Sbagli la dimensione e il beneficio evapora in silenzio, perché quando block.db si riempie, RocksDB non fallisce: si riversa sul dispositivo lento, esattamente dove sarebbe stato senza l’NVMe.
È il peggio dei due mondi: hai comprato il flash e la testina del disco continua a spostarsi.
Le indicazioni attuali di Ceph:
| Carico | block.db come frazione di block |
|---|---|
| RBD / a blocchi, dischi delle VM | dall'1% al 2% |
| RGW / a oggetti | almeno il 4% |
| Raccomandazione generale quando si spostano WAL+DB | almeno il 2,5% |
Lo storage delle VM Proxmox è la riga RBD, quindi l'1-2% è la cifra onesta per pianificare, e il 2,5% è un posto comodo dove stare.
Applicalo a un disco da 20 TB e i numeri catturano la tua attenzione:
block.db per un OSD da 20 TB | |
|---|---|
| All'1% | 200 GB |
| Al 2% | 400 GB |
| Al 2,5% | 500 GB |
Mettilo insieme ai gradini dei livelli di RocksDB qui sotto e 300 GB per OSD è il punto d’arrivo sensato. Il gradino utile più vicino al centro dell’intervallo.
Il che cambia ciò che è davvero il dispositivo condiviso dei metadati. Otto OSD da 20 TB vogliono 2,4 TB di NVMe in tutto; quindici, il massimo dichiarato da Ceph dietro un NVMe, vogliono 4,5 TB. Su dischi così grandi è la capacità del DB a decidere quanti OSD stanno dietro un dispositivo, non il rapporto. Finirai i gigabyte molto prima di finire la benedizione di Ceph.
C’è un’altra piega da conoscere, perché rende sbagliato il dimensionamento a intuito. La struttura a livelli di RocksDB fa sì che una partizione DB possa usare pienamente solo dimensioni che corrispondono alle somme dei suoi livelli, il che storicamente produce gradini utili intorno a 3 GB, 30 GB e 300 GB, con le dimensioni intermedie che non offrono nulla in più del gradino inferiore. Arrotondare 18 GB a 30 GB spesso non costa niente in pratica; arrotondarli a 20 GB non ti compra niente in più di 3 GB nel caso peggiore.
Controlla lo spillover dopo che il cluster ha girato per un po’, non il primo giorno. È un problema a insorgenza lenta.
Non ti serve un dispositivo WAL separato
Questo ti risparmia una partizione e un sacco di armeggi.
Se specifichi un dispositivo DB e nessun dispositivo WAL esplicito, Ceph mette automaticamente il WAL sul dispositivo veloce insieme al DB. La documentazione dice che «whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device.»
Quindi «metti DB e WAL su NVMe» è l’obiettivo giusto, ma è un argomento, non due. Un block.wal separato ha senso solo se hai un terzo livello, più veloce, su cui metterlo.
Spegni la cache di scrittura dell’HDD
Piccola, poco affascinante e facile da dimenticare.
La documentazione di Ceph nota che le prestazioni degli OSD «may be dramatically increased … by disabling this write cache» sugli HDD. La cache volatile nel disco riordina e ritarda le scritture in modi che si scontrano con la semantica di flush di Ceph, e spegnerla di solito rende le cose più veloci, non più lente.
Diventa obbligatorio, non più solo consigliabile, quando entra in gioco bcache, che è la prossima sezione.
Già che ci sei: non ti serve un HBA con capacità RAID. Ceph lo dice direttamente: «You do not need an RoC (RAID-capable) HBA.» Dai i dischi agli OSD.
Una Optane per disco
Togliere i metadati dal disco sistema lo stato stazionario. Non sistema le raffiche, perché una raffica di piccole scritture sincrone deve comunque essere confermata, e il disco rotante conferma comunque alla velocità del disco rotante.
È a questo che serve bcache, e quello che lo fa funzionare qui è Optane.
Quello che conta non è la capacità. È il comportamento sotto carico di scrittura. Rispetto alla NAND, Optane offre una latenza bassissima, un’endurance altissima, e nessuno dei crolli da garbage collection che rendono imprevedibili le prestazioni di un SSD usato come cache di scrittura dopo un po’ che è in servizio. Assorbire traffico piccolo, a raffiche e pesante in scrittura è la cosa in cui è il migliore al mondo.
Il layout che conta: una Optane per HDD, ogni coppia il suo dispositivo bcache. Non una Optane condivisa tra uno scaffale di dischi.
L’abbinamento è una scelta voluta, e compra due cose.
Nessuna contesa. Ogni disco ha tutta per sé la latenza e la profondità di coda di un’intera Optane, invece di mettersi in fila dietro le raffiche di altri sette OSD.
Un dominio di guasto a cui Ceph sa già sopravvivere. Una cache di scrittura condivisa tiene dati dirty per ogni OSD dietro di sé, quindi perderla li perde tutti insieme; con l’abbinamento uno a uno, perdere una Optane costa esattamente un OSD. Questa distinzione è la conseguenza più importante di tutto il progetto, e ha una trattazione a parte in cosa stai cedendo in cambio.
Deve essere Optane. Non NAND.
La parola «Optane» qui non è una preferenza di marca né un di più. Sostituirla con un NVMe NAND, per quanto costoso, costruisce qualcosa che si consuma, e il motivo è l’endurance.
Guarda dove sta il dispositivo di cache. Siccome questo progetto spegne il bypass sequenziale di bcache, il sequential_cutoff=0 della regola qui sotto, ogni singola scrittura verso quell’OSD ci passa attraverso: non solo le raffiche, tutto. Questo fa della cache il dispositivo con il ciclo di lavoro più alto del nodo, chiamato ad assorbire il volume di scrittura di un intero disco rotante per tutta la vita della macchina.
L’endurance si esprime in scritture dell’intero disco al giorno, e il divario non è incrementale:
| Dispositivo | Endurance dichiarata |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| NAND enterprise write-intensive, di fascia alta | circa 10 DWPD |
| NAND enterprise mixed-use | 3 DWPD o meno |
| NAND enterprise mainstream, classe PM9A3, 7450 Pro | circa 1 DWPD |
Optane ha tra dieci e cento volte l’endurance della NAND che altrimenti metteresti lì. Metti un disco da 1 DWPD nell’unica posizione che riceve ogni scrittura del cluster e non hai costruito una cache, hai costruito un materiale di consumo.
È peggio di quanto suggerisca la tabella, perché la NAND soffre di write amplification interna e Optane no. Il DWPD dichiarato di un disco NAND è quello che accetta all’interfaccia; quello che le sue celle assorbono davvero è di più. Il numero di Optane non ha bisogno di questo asterisco.
Le ricostruzioni sono dove questo viene messo alla prova. Il backfill spinge terabyte di scritture attraverso i nodi superstiti in una finestra compressa, ogni byte attraverso i loro dispositivi di cache: un evento di endurance, non solo di latenza, che arriva esattamente quando meno vorresti che si guastasse un secondo dispositivo.
Quindi i due livelli di flash vogliono dischi diversi, per motivi diversi:
| Livello | Volume di scrittura | Cosa serve al dispositivo |
|---|---|---|
| DB/WAL | piccolo, solo RocksDB | Un NVMe enterprise veloce. Bassa latenza, alti IOPS casuali, PLP. La NAND enterprise è la tecnologia giusta; un PM9A3 o un 7450 Pro è l’acquisto giusto |
| Cache di scrittura | tutto | PLP e un’endurance nell’ordine delle decine di DWPD. La NAND è la tecnologia sbagliata a qualunque prezzo |
Comprare un solo tipo di disco per entrambi i lavori è l’errore che questa sezione esiste per evitare, ma non leggere la prima riga come un permesso a risparmiare, perché un volume di scrittura basso non è una richiesta bassa.
Il dispositivo DB/WAL deve comunque essere un NVMe davvero veloce, per tre motivi che non hanno niente a che fare con quanti byte ci passano.
Serve ogni OSD dietro di sé allo stesso tempo, quindi la coda che vede è il traffico di metadati di quattro o quindici dischi, non di uno.
La sua latenza ricade direttamente sui tuoi client. Le ricerche in RocksDB stanno sul percorso critico per trovare gli oggetti, per il peering e per lo scrub, e sono piccole letture casuali. Il carico in cui il divario tra un NVMe veloce e uno mediocre è più ampio. Ogni microsecondo viene moltiplicato per ogni OSD che ne dipende.
E la compaction arriva a raffiche. RocksDB riscrive periodicamente i suoi livelli, trasformando un ricambio costante in un picco concentrato di letture e scritture. Un dispositivo che regge la media e si blocca sul picco blocca nello stesso momento ogni OSD dietro di sé.
I rapporti di Ceph stesso sono l’indizio. Permette il triplo degli OSD dietro un NVMe rispetto a un SSD SATA, e a parlare sono l’interfaccia e la classe del dispositivo, non la capacità. Usa NVMe.
Quindi: il dispositivo di cache deve essere Optane, il dispositivo DB/WAL può essere NAND, e nessuna delle due posizioni è dove si risparmia.
Quale Optane: spesso basterebbe una M10 da 32 GB
Niente di tutto questo significa che la Optane più grande sia quella giusta. Il dispositivo che ti serve lo decide il tuo carico di scrittura, anche se, come si vedrà, il mercato dell’usato potrebbe decidere per te comunque. Il conto conta lo stesso, perché ti dice cosa stai comprando in eccesso o in difetto.
Parti da cosa serve la cache. Tiene una raffica, non un disco. Con writeback_percent=40 un dispositivo da 32 GB dà circa 13 GB di buffer dirty, che sono un numero enorme di piccole scritture sincrone.
Quindi non lasciarti spaventare dal rapporto. Un modulo da 32 GB davanti a un disco da 20 TB ne è lo 0,16%, che sembra assurdo finché non ti ricordi che è un assorbitore di raffiche e non una cache del working set che cerca di tenere i dati caldi. Un dispositivo da 375 GB davanti allo stesso disco è l'1,9%, che è semplicemente più margine di quanto ne userai.
Il che mette in gioco la fascia economica. Ecco il piccolo modulo consumer contro il componente da datacenter, perché il divario non sta dove la gente se lo aspetta:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Lettura casuale, 4K | 240.000 IOPS | 550.000 IOPS |
| Scrittura casuale, 4K | 65.000 IOPS | paragonabile alla lettura |
| Lettura sequenziale | 1.200 MB/s | 2.400 MB/s |
| Scrittura sequenziale | 290 MB/s | 2.000 MB/s |
| Latenza tipica | n.d. | sotto i 10 µs |
| Endurance | 365 TBW | 12,3 PBW, 30 DWPD |
| Interfaccia | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 o AIC |
Guarda prima la riga degli IOPS in scrittura. La piccola M10 fa 65.000 scritture casuali al secondo; il disco rotante dietro di lei ne fa 80. Anche la Optane più economica è circa 650 volte il disco che sta mettendo in cache, quindi sull’asse delle prestazioni la discussione è chiusa prima di cominciare. Gli IOPS in più del componente DC non hanno dove andare quando a valle c’è un solo disco da 7.2k.
La riga che decide l’acquisto è l’endurance, dove il divario è di 34×. Trasformata in un budget giornaliero su una vita di cinque anni:
| Dispositivo | Scritture sostenibili al giorno, su cinque anni |
|---|---|
| M10 32 GB, 365 TBW | circa 200 GB/giorno |
| P4800X 375 GB, 12,3 PBW | circa 6,7 TB/giorno |
Sotto i 200 GB di scritture al giorno una M10 da 32 GB arriva in fondo alla vita del sistema. Al doppio ti dura due anni e mezzo. Con un carico davvero pesante in scrittura il componente DC si guadagna il suo prezzo, non per gli IOPS, che non puoi usare, ma per le trenta e rotte volte di scrittura in più che tollera.
Quindi misura invece di indovinare. nvme smart-log su un dispositivo di cache esistente ti dà data_units_written; campionalo a una settimana di distanza, dividi, e confronta con i TBW dichiarati di quello che stai valutando. bcache tiene i suoi totali in /sys/block/bcacheN/bcache/stats_total/ se preferisci leggerli lì.
Due avvertenze sulla M10. I suoi valori casuali sono dichiarati su un intervallo di 8 GB e non sull’intero dispositivo, quindi su una cache che intendi tenere piena per buona parte, considerali l’estremo ottimistico. Ed è un componente consumer senza alcuna dichiarazione di PLP enterprise. Il supporto di Optane viene scritto sul posto senza buffer DRAM nel percorso di scrittura, ed è per questo che questi moduli si comportano molto meglio di quanto farebbe una NAND consumer in caso di perdita improvvisa di alimentazione, ma «si comporta bene in pratica» non è una specifica. Se vuoi la garanzia per iscritto, compra un componente della serie DC.
Il limite è la banda, non la capacità: lascia perdere i moduli da 16 GB
C’è un secondo vincolo, indipendente da tutto quello che c’è sopra, e squalifica il componente più economico della gamma.
La cache deve essere più veloce del disco in sequenziale, altrimenti è uno strozzamento. La M10 da 16 GB non lo è, ed è il modulo che ti tenterà di più perché costa quasi niente:
| Scrittura sequenziale | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2.000 MB/s |
| Un HDD enterprise da 7.2k | 150-250 MB/s |
Leggi insieme la prima e l’ultima riga. Un modulo da 16 GB scrive in sequenziale più o meno alla stessa velocità del disco rotante che dovrebbe accelerare, e più lentamente di uno buono. Resta enormemente più veloce nel lavoro casuale, 35.000 IOPS di scrittura casuale contro gli 80 del disco, ma su un flusso sequenziale nel migliore dei casi è un pareggio e nel peggiore un tetto più basso di quello che il disco nudo raggiungeva da solo.
E questo progetto garantisce che quel tetto lo incontrerai, perché spegnere il bypass sequenziale manda tutto attraverso la cache, facendo della banda di scrittura sequenziale della cache stessa il tetto rigido dell’intero OSD. Il recupero è dove fa più male: il backfill di un OSD da 20 TB è quanto di più sequenziale offra questo carico, e limitarlo a 150 MB/s rende ancora più lenta una ricostruzione già lenta.
Quindi la linea M10 ha un minimo a 32 GB, ed è un minimo di banda, non di capacità. Il conto della capacità diceva che 32 GB erano abbondanti; il conto della banda esclude i 16 GB a prescindere da quanto poco ti servisse memorizzare. Devono passare entrambe le prove, e il componente economico fallisce quella che la gente non controlla.
Qualunque cosa tu stia valutando, metti il suo valore di scrittura sequenziale accanto a 250 MB/s prima di comprarla.
Comprare un prodotto che nessuno fa più
Optane è fuori produzione. Intel ha chiuso l’attività nel 2022, svalutando 559 milioni di dollari di magazzino e fermando lo sviluppo. Non c’è nuova produzione né rifornimento; da qui in poi la quantità totale può solo scendere.
Il che pone una domanda ovvia, perché ce n’è in vendita una quantità sorprendente. Capire da dove viene ti dice cosa stai comprando.
Sono scorte di ricambi di assistenza degli OEM in liquidazione. I tre grandi produttori di server tenevano Optane come ricambio per supportare le piattaforme in cui la vendevano. Quelle piattaforme sono arrivate a fine vita e uscite dal supporto, quindi i ricambi che le coprivano sono diventati merce morta dall’oggi al domani: magazzini di pezzi per macchine che nessuno è più obbligato per contratto a riparare. Quel magazzino è quello che sta arrivando su AliExpress e dai ricondizionatori.
Due conseguenze, ed entrambe sono buone notizie.
Molti sono inutilizzati più che smontati. I ricambi di assistenza sono rimasti su uno scaffale ad aspettare un guasto che non è mai arrivato, quindi l’usura all’arrivo spesso è di fatto zero: non «qualche anno di uso leggero» ma mai scritti. Verifica invece di fidarti: nvme smart-log ti dà percentage_used e data_units_written, e su veri ricambi di magazzino dovrebbero essere sorprendentemente bassi. Tutto ciò che mostra un’usura reale è un pezzo smontato venduto per qualcos’altro, anche se pure in quel caso il margine di endurance fa sì che una Optane usata possa avere più vita davanti di un disco NAND nuovo della stessa capacità.
Spiega quali capacità troverai. I ricambi OEM venivano tenuti per i server, il che significa componenti da datacenter. Ecco la gamma completa, e nota da dove parte il modello di punta:
| Componente | Capacità | Formato |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, consumer |
| Optane SSD 800P | 58, 118 GB | M.2 2280, consumer |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, componente da datacenter per boot e cache |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm o U.2 |
| Optane SSD DC P4800X | 375 GB come minimo, 750 GB, 1,5 TB | U.2 o scheda add-in |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 o scheda add-in |
In teoria i piccoli componenti M.2 sono la risposta elegante: la M10, la 800P, la P1600X e la P4801X da 100 GB fanno tutte il lavoro, e costano poco. In pratica il mercato non li ha, perché nessuno teneva in magazzino moduli acceleratori da desktop come ricambi per server. Quello che si trova in vendita parte da 375 GB in su, hardware di classe P4800X.
Quindi metti in conto di comprare più capacità di quanta ne richieda il ruolo, perché è quello che c’è in vendita. Non è un cattivo risultato. Comprare un dispositivo di cache più grande del necessario ti porta a 30 DWPD e a una latenza sotto i 10 µs quando il tuo carico ne chiedeva una frazione, e per un disco da 20 TB che intendi tenere per anni, è il modo giusto di sbagliare. Significa però che il prezzo d’ingresso è più alto di quanto suggerisca il conto, e che il dimensionamento qui sopra diventa un controllo contro il comprare troppo poco più che una lista della spesa.
Tre cose da pianificare, visto che questa è una liquidazione e non una catena di fornitura:
Compra i ricambi insieme al sistema. Si sta svuotando una riserva finita. Quando un dispositivo si guasterà tra tre anni non ordinerai un sostituto, ne andrai a caccia, quindi metti in conto i ricambi adesso, finché le scorte ci sono.
Aspettati firmware OEM e controlla il namespace. I componenti del programma ricambi di un vendor spesso hanno il firmware di quel vendor e possono arrivare formattati con una dimensione LBA o con impostazioni di metadati adatte a quello per cui erano stati messi in magazzino. Verifica con nvme id-ns prima di costruirci sopra, e preparati a fare nvme format in un formato semplice a 4096 byte.
Non c’è garanzia, né supporto, né altri aggiornamenti del firmware. L’avviso di supporto di Intel stessa spiega cosa significa la chiusura per i dispositivi già in servizio, che è la condizione in cui si trova già qualunque cosa tu compri. Verificare che il componente arrivato sia quello dell’annuncio tocca a te.
bcache non sostituisce lo spostamento di DB/WAL
Vale la pena dirlo esplicitamente, perché è il posto ovvio dove provare a risparmiare e non funziona: ti serve comunque block.db su NVMe. Entrambi gli strati, non uno o l’altro.
La Optane è una cache di scrittura. È tutto quello che è. Accorcia il percorso di conferma delle scritture dirette al disco, e non fa nient’altro.
RocksDB non si limita a scrivere. Ceph legge di continuo i suoi metadati, per trovare oggetti, per gestire il peering, per rispondere agli scrub, e una cache di scrittura non offre esattamente nulla a una lettura una volta che i dati ne sono stati svuotati. Né la cache toglie il traffico di metadati; lo rimanda e lo raggruppa, quindi ogni aggiornamento di RocksDB arriva comunque prima o poi al disco rotante, contendendosi gli stessi spostamenti di testina. E la compaction trasforma un ricambio modesto in molto più traffico sul dispositivo delle scritture che l’hanno causato.
Quindi le due modifiche risolvono problemi diversi e nessuna sostituisce l’altra:
| Cosa risolve | Cosa non risolve | |
|---|---|---|
block.db su NVMe | i metadati vivono sul flash, letture e scritture, permanentemente fuori dal disco rotante | nulla per una raffica di scritture dei guest |
| Optane tramite bcache | latenza di conferma delle raffiche per le scritture di dati | nulla per le letture dei metadati; rimanda soltanto le scritture dei metadati |
Salta lo spostamento del DB e tieni la Optane, e RocksDB torna sul piatto con le sue letture servite a 80 IOPS. Salta la Optane e tieni lo spostamento del DB, e lo stato stazionario è decente ma le raffiche si bloccano comunque alla velocità del disco rotante.
La regola udev, riga per riga
I parametri di bcache vivono in sysfs, e sysfs li azzera ogni volta che il dispositivo viene registrato, cioè a ogni avvio. Quindi il loro posto è una regola udev e non uno script che qualcuno deve ricordarsi di lanciare:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" corrisponde a ogni dispositivo bcache del nodo, quindi una sola regola copre tutte le coppie. ACTION=="add|change" significa che si riapplica ogni volta che un dispositivo compare o viene ricollegato, non solo all’avvio.
Cosa fa ogni impostazione, e perché:
cache_mode=writeback: il senso di tutto. Nel default writethrough, una scrittura non viene confermata finché non raggiunge l’HDD, quindi la cache non fa niente per la latenza di scrittura. In writeback, la Optane conferma e il disco rotante si mette in pari dopo.
sequential_cutoff=0: di default bcache rileva l’I/O sequenziale e lo manda dritto oltre la cache una volta superati i 4 MB, partendo dall’idea che il disco sottostante gestisca bene il sequenziale. Zero disattiva quel bypass, così tutto passa in cache. Su un nodo iperconvergente è la scelta giusta: ciò che sembra sequenziale a un dispositivo bcache smette di esserlo sul piatto quando diversi OSD si mescolano, e vuoi comunque ogni scrittura confermata alla velocità di Optane. Comporta però un obbligo: senza bypass, la banda di scrittura sequenziale del dispositivo di cache diventa il tetto dell’intero OSD, ed è il motivo per cui i moduli da 16 GB sono squalificati.
congested_read_threshold_us=0: bcache osserva la latenza del proprio dispositivo di cache e comincia a scavalcare la cache quando la giudica congestionata, con un default di 2000 µs per le letture. Optane non si congestiona come fa la NAND, quindi questo è bcache che mette in dubbio un dispositivo che ha misurato male. Zero spegne il monitoraggio.
writeback_rate=81920 e writeback_rate_minimum=20480: la velocità di svuotamento in background, in settori al secondo, quindi circa 40 MB/s di obiettivo con un minimo di 10 MB/s. Un controller PD sposta la velocità effettiva tra i due. L’obiettivo è fissato vicino a quanto un disco rotante può assorbire in sequenziale, e il minimo impedisce al controller di strozzare lo svuotamento verso lo zero lasciando accumulare dati dirty all’infinito. Sono entrambi punti di partenza, non costanti: come cambiarli è spiegato più sotto.
writeback_percent=40: quanta parte della cache bcache lascia restare dirty prima di frenare con decisione, contro un default di 10. Quaranta ti dà un buffer per le raffiche molto più profondo. Significa anche che fino al 40% di quella Optane contiene l’unica copia di dati nel sistema, che è il compromesso, ed è il motivo per cui il layout uno per disco conta. È il valore che più vale la pena rivedere dopo aver osservato un carico reale.
Cambiare i valori di riempimento e svuotamento in seguito
Il 40% e le due velocità qui sopra sono i valori che girano qui, non costanti universali. Sono la prima cosa che vorrai spostare dopo aver osservato un carico reale, quindi vale la pena sapere che ci sono due posti dove cambiarli, che fanno due cose diverse.
sysfs lo cambia adesso. La regola udev lo cambia al prossimo avvio. Ti servono entrambi, e in quest’ordine.
Cambialo a caldo, su un dispositivo:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Oppure su tutte le coppie del nodo:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
La velocità di svuotamento funziona allo stesso modo. Entrambi i valori sono in settori al secondo, quindi questi dimezzano obiettivo e minimo:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Ha effetto subito e sopravvive esattamente fino a quando il dispositivo viene registrato di nuovo. La documentazione del kernel è esplicita sul fatto che queste impostazioni «do not persist across reboot», ed è proprio il motivo per cui esiste la regola udev.
Quando un valore ti soddisfa, modifica la regola e ricaricala senza riavviare:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
È qui che ACTION=="add|change" si guadagna il pane. Il trigger invia un evento change ai dispositivi già presenti, quindi la regola si riapplica a un nodo in funzione invece di aspettare il prossimo avvio. Se la regola corrispondesse solo ad add, quel comando non farebbe niente.
Poi rileggi i valori, perché un errore di battitura in una regola udev fallisce in silenzio:
grep . /sys/block/bcache*/bcache/writeback_percent
Sapere in che direzione spostarli
Non regolare tutto questo partendo dai principi primi: bcache espone quello che ti serve nella stessa directory di sysfs.
dirty_data è quello da tenere d’occhio: quanti dati stanno in questo momento nella cache e da nessun’altra parte. La documentazione lo descrive come «continuously updated unlike the cache set’s version, but may be slightly off», che per questo scopo va bene. Campionalo durante una normale giornata di lavoro e durante una finestra di backup.
cache_hits, cache_misses e cache_hit_ratio ti dicono se la cache viene usata, con l’avvertenza che «a partial hit is counted as a miss». bypassed conta l’IO che è passato del tutto oltre la cache: con sequential_cutoff=0 dovrebbe restare quasi piatto, quindi un numero che cresce significa che qualcosa la sta ancora aggirando.
Tutti questi arrivano come totali progressivi più versioni che decadono sull’ultimo giorno, sull’ultima ora e sugli ultimi cinque minuti, il che rende quelli a finestra breve molto più utili del dato di tutta la vita per individuare un problema.
Da lì:
| Sintomo | Parametro | Direzione |
|---|---|---|
| Le raffiche si bloccano, le scritture incontrano la latenza del disco a metà raffica | writeback_percent | su, per un buffer più profondo |
| Più dati esposti sulla cache di quanti te ne senti di rischiare | writeback_percent | giù |
dirty_data fermo al tetto durante il lavoro ordinario | writeback_rate | su, il problema non è il buffer ma lo svuotamento |
| Lo svuotamento in background compete con le letture dei guest sul disco | writeback_rate | giù |
dirty_data che sale lentamente nell’arco di giorni più che di ore | writeback_rate_minimum | su, così il controller non può rallentare fino a strisciare |
Se dirty_data resta fermo al tetto qualunque cosa tu faccia, nessuno dei due parametri è la risposta: il cluster scrive più in fretta di quanto i dischi rotanti riescano ad assorbire, e le soluzioni oneste sono più dischi o meno scritture.
Un file da lasciare stare: writeback_running. Spegnerlo ferma del tutto il writeback, e la documentazione dice che è «only meant for benchmarking». Su un OSD in produzione significa che i dati dirty si accumulano finché la cache è piena e non si svuota mai.
Cosa stai cedendo in cambio
La maggior parte delle descrizioni di questo progetto si ferma alle buone notizie. Queste sono le parti che ti faranno male davvero, e ognuna vale la pena di conoscerla prima di costruire, non dopo.
Perdere uno qualsiasi dei due dispositivi flash distrugge l’OSD. Non lo ferma: lo distrugge. Entrambi i dispositivi tengono uno stato che non esiste da nessun’altra parte: block.db tiene il RocksDB che dà senso a block, e una cache in writeback tiene ogni scrittura non ancora svuotata. La documentazione del kernel non tentenna sul secondo: «In writeback mode you’ll lose data if something happens to your SSD.» In entrambi i casi l’OSD non torna, viene ricreato e ripopolato con il backfill.
Quindi sono la stessa classe di rischio, e vale la pena dirlo chiaramente invece di trattare la cache come quella che fa paura. La Optane non è un dispositivo più pericoloso dell’NVMe. Due cose li separano, e nessuna delle due è la gravità per OSD.
La prima è il raggio d’impatto, ed è l’intera giustificazione dell’abbinamento. Una Optane per disco significa che un guasto della cache costa un OSD: la perdita di un solo disco, che è esattamente l’evento che un pool replicato esiste per assorbire, e che Ceph gestisce senza che nessuno venga chiamato. Il dispositivo DB/WAL è condiviso, quindi perderlo costa ogni OSD dietro di sé in una volta sola, ed è un guasto correlato da cui la replica non ti protegge. Stesso guasto, un dispositivo contro cinque.
La seconda è come si presenta il guasto, e questa è una trappola operativa. Quando una cache muore in writeback il dispositivo sottostante si ferma e restituisce errori di I/O, il che va bene: Ceph segna l’OSD come down e va avanti. Il caso brutto è un riavvio in cui il dispositivo sottostante torna su senza la sua cache collegata. A quel punto sembra un filesystem montabile a cui mancano semplicemente tutte le scritture dirty, il che lo rende corrotto e non solo vecchio. Un block.db mancante fallisce rumorosamente e l’OSD si rifiuta di partire; una cache mancante può fallire in silenzio e lasciarti montare i rottami. Tratta un dispositivo sottostante bcache come non montabile senza la sua cache, e non lasciare mai che qualcosa lo monti per te per farti un favore.
bcache da solo non garantisce un writeback sicuro rispetto all’alimentazione. È qui che la cache di scrittura dell’HDD smette di essere un’ottimizzazione e diventa un requisito: spegnila, e usa un kernel abbastanza recente da avere la gestione FUA, così le scritture sincrone vengono rispettate lungo tutto lo stack invece di essere confermate in anticipo da qualche parte nel mezzo. Un dispositivo di cache senza protezione dalla perdita di alimentazione aggrava il problema, perché può perdere dati che ha già dichiarato al sicuro.
Il che fa del rapporto DB/WAL il numero che conta. Ceph permette 4-5 OSD HDD per SSD SATA e non più di 15 per NVMe, e avverte di «balancing the risk of reducing costs by placing too many responsibilities into too few failure domains.» A differenza del livello di cache, qui non c’è abbinamento disponibile per contenere il rischio: la condivisione è lo scopo del dispositivo.
Su dischi da 20 TB è tutto lì, perché la ricostruzione è enorme. Un OSD guasto sono 20 TB di backfill; ai 150-250 MB/s che un disco rotante sostiene, rallentato perché il recupero non affami i guest, parli di ben più di un giorno di funzionamento degradato per un solo disco. Perdi un dispositivo DB condiviso che ne porta cinque e ci sono 100 TB da spostare.
Quindi il rapporto non è davvero una decisione di costo. È una decisione su quanto a lungo sei disposto a funzionare in modo degradato, e su quanto traffico di ricostruzione il cluster riesce a portare continuando a servire le VM.
Il progetto dipende da un dispositivo che nessuno fa più. Questo è quello senza risposta tecnica. Optane è il componente giusto per la posizione di cache e niente di attuale lo sostituisce: la NAND non regge il volume di scrittura, e la memoria basata su CXL verso cui si è spostata Intel non è un sostituto diretto per una cache a blocchi. Quindi la mitigazione è commerciale più che ingegnosa, è trattata sopra, e il riassunto onesto è che questa architettura ha una data di scadenza da qualche parte nel futuro.
Niente di tutto questo fa di un cluster HDD un cluster all-flash. Un traffico di scrittura casuale prolungato che supera la velocità di svuotamento riempirà la cache, e una volta piena stai scrivendo alla velocità del disco rotante con strati in più nel percorso. Questo progetto assorbe le raffiche e toglie il carico dei metadati. Non fabbrica IOPS.
A cosa si riduce
Tre livelli, ognuno che fa l’unica cosa in cui è il migliore, e servono tutti e tre:
- Optane assorbe le raffiche di scritture casuali, un dispositivo per disco. Deve essere Optane, perché ogni scrittura ci passa attraverso e l’endurance della NAND è sbagliata per quella posizione
- Un NVMe enterprise veloce tiene RocksDB e il WAL, condiviso tra una manciata di OSD con un rapporto che hai scelto di proposito invece di subirlo
- Gli HDD forniscono la capacità grezza, liberati sia dai metadati sia dalle raffiche
Il punto non è far finta che i dischi rotanti siano flash. È smettere di mandargli il lavoro in cui sono peggiori, così la capacità che hai davvero pagato diventa usabile.
Tutto il trucco è questo, e non ha niente di furbo. Metti ogni lavoro sul dispositivo che ci è bravo, e smetti di pagare due volte per quelli che non lo sono.
Per un cluster Proxmox iperconvergente che ha bisogno di capacità nell’ordine dei terabyte senza i prezzi dell’all-flash, è un progetto difendibile. Costruito come si deve sembra molto più veloce degli HDD nudi, si guasta in modi che Ceph è fatto per gestire, e i soldi vanno dove cambiano il risultato.
Due cose correlate da leggere insieme a questa: il lavoro sulle dimensioni dei settori in 4Kn, 512e e 512n conta moltissimo per quello che i dischi rotanti fanno delle scritture che li raggiungono, e se costruisci tutto questo su nodi collegati direttamente, la mesh senza switch copre il lato rete di un piccolo cluster Ceph.
Riferimenti
- Ceph — Hardware Recommendations — l’avvertenza sugli IOPS per TB dei grandi HDD, «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD», i rapporti di 4-5 HDD per SSD SATA e ≤15 per NVMe, la protezione dalla perdita di alimentazione sugli SSD enterprise, lo spegnimento della cache di scrittura dell’HDD, e il fatto che non serve un HBA RoC
- Ceph — BlueStore Configuration Reference —
block.dball'1-2% diblockper RBD e almeno al 4% per RGW, la raccomandazione generale del 2,5%, lo spillover sul dispositivo primario, le dimensioni dei livelli di RocksDB dietro i gradini da 3/30/300 GB, e il WAL implicitamente collocato con il DB - Linux kernel — bcache admin guide — le modalità di cache,
sequential_cutoffe il suo default di 4 MB, il default di 2000 µs per la congestione in lettura,writeback_ratein settori al secondo, il controller PD diwriteback_percent, i contatoridirty_data/cache_hit_ratio/bypassede le loro versioni che decadono su giorno, ora e cinque minuti, l’avvertenza chewriteback_runningè «only meant for benchmarking», l’affermazione che queste impostazioni «do not persist across reboot», e «in writeback mode you’ll lose data if something happens to your SSD» - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240.000 IOPS in lettura casuale e 65.000 in scrittura casuale a 4K su un intervallo di 8 GB, 1200/290 MB/s in sequenziale, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — i 150 MB/s di scrittura sequenziale e i 35.000 IOPS di scrittura casuale che mettono questo componente sotto un disco rotante nel throughput sequenziale
- PC Perspective — Optane SSD DC P4800X performance — i 550K IOPS in lettura casuale 4K del componente da 375 GB, 2400/2000 MB/s in sequenziale, latenza tipica sotto i 10 µs, e 12,3 PBW a 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — i componenti M.2 da datacenter di piccola capacità, per la scala delle capacità
- StorageReview — Intel Optane SSD P5800X — la classificazione da 100 DWPD, i 30 DWPD della P4800X, e il confronto con i dischi NAND enterprise che arrivano al massimo intorno ai 10 DWPD per i modelli write-intensive e a 3 o meno per i mixed-use
- Bcache — ArchWiki — i modi di guasto pratici, compreso un dispositivo sottostante che torna su senza la sua cache dopo un riavvio, e i requisiti di sicurezza rispetto all’alimentazione legati alla cache di scrittura dell’HDD e a FUA
- Intel — Optane business update — la chiusura, e cosa significa per garanzia e supporto sui dispositivi già in servizio, che è la condizione in cui si trova già qualunque cosa tu compri sul mercato del recupero