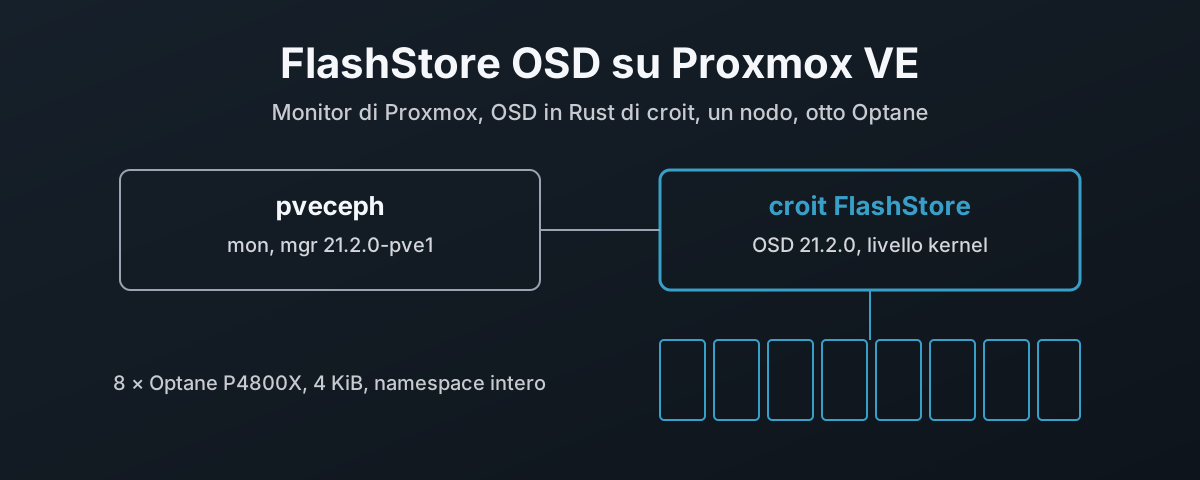
Un OSD in Rust, il giorno del rilascio
croit ha messo FlashStore OSD in anteprima pubblica il 9 novembre 20261.
È un OSD Ceph scritto da zero in Rust, con un proprio object store al posto di BlueStore, e parla il protocollo di rete di Ceph.
La promessa è che si inserisce in un cluster che hai già: i tuoi monitor, i tuoi manager, la tua CLI ceph e i tuoi client restano come sono, e sostituisci un disco alla volta1.
Questa promessa conta per chi usa Proxmox più che per quasi chiunque altro.
Su un nodo Proxmox VE iperconvergente, Ceph non è qualcosa che installi a parte.
Arriva dalla GUI di Proxmox, dai repository di Proxmox, compilato e patchato da Proxmox, e tutto è gestito da pveceph.
Se un OSD di qualcun altro riesce a stare lì dentro senza rompere niente, ottieni un nuovo motore di storage senza rinunciare agli strumenti.
Se non ci riesce, lo scopri a tue spese, su un nodo che fa girare anche le tue VM.
Allora l’ho provato.
Lavoro per croit, che produce FlashStore. È il motivo per cui l’ho provato entro due giorni dal rilascio, ed è anche il motivo per cui niente di quello che segue viene addolcito. È un’anteprima, il README dice che «not yet recommended for production data»1, e questo è il resoconto di cosa è servito su hardware vero, non una brochure.
Risposta breve: funziona. Mentre scrivo, otto OSD FlashStore servono un pool RBD a una VM su un nodo Proxmox VE 9.2 standard, in HEALTH_OK. La risposta lunga è che sono servite due correzioni che la documentazione non cita, una per come Proxmox conserva la configurazione di Ceph e una per il kernel di Proxmox, e il resto di questo articolo parla di quelle correzioni e di come sono state trovate. Se vuoi solo farlo funzionare, verso la fine c’è uno script che fa tutto, ed è stato eseguito su questo nodo.
La macchina
Il laboratorio è un nodo singolo, pve2, sulla mia LAN di casa, ed è un mini PC Minisforum B550 del 2021, una ciofeca.
Ceph su un nodo singolo non è come lo faresti girare in produzione, e la regola CRUSH più sotto è il prezzo da pagare, ma ogni passaggio qui è identico su un nodo che ha dei vicini.
| Proxmox VE | pve-manager 9.2.26, kernel 7.0.14-28-pve, Debian 13.7 |
| Macchina | mini PC Minisforum B550, 2021; la scheda si presenta come BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 core, 16 thread, 1 nodo NUMA |
| Memoria | 58 GiB |
| Dischi OSD | 8 × Intel Optane P4800X 375 GB (6 con marchio Dell, 2 Intel retail) |
| PCIe verso gli Optane | tutti e otto dietro uno switch Broadcom PEX880xx, su un solo link PCIe 3.0 x16 dall’APU |
| Disco di boot | WD SN750 512 GB, VG pve, tenuto fuori da tutto questo |
| Rete | una porta da 2,5 GbE, vmbr0 |
| FlashStore | snapshot-2026-11-10, commit upstream c5792750020e2 |
Gli Optane ci sono perché FlashStore ha due requisiti rigidi che molti dischi non rispettano.
Il disco deve avere la protezione contro la perdita di alimentazione, e il namespace deve usare blocchi da 4096 byte, come namespace intero senza partizioni né filesystem sopra1.
FlashStore conferma una scrittura quando è durevole sul disco, quindi un disco che mente sulla durabilità con una cache volatile viene rifiutato al mkfs3.
Ogni P4800X dichiara di non avere una cache di scrittura volatile nei dati Identify (vwc 0), cioè è il disco stesso a dire che la cache non può perdere una scrittura confermata.
Per questo il limite di questa analisi è il mini PC, non FlashStore e non i dischi. Otto core significano uno per OSD e niente di scorta, 58 GiB devono sfamare sia Ceph sia le VM, e otto Optane condividono un solo link PCIe 3.0 perché l’APU non ha altro da dare. Leggi ogni numero qui sotto come quello che questa macchina permette.
Umbrella o niente
FlashStore viene compilato per una release di Ceph alla volta.
Lo decide il branch: main parla Ceph 21.2.0 Umbrella, e un branch v20.2.4 parla 20.2.4 Tentacle4.
Il daemon controlla la release del cluster all’avvio e ne rifiuta una fuori dalla sua finestra4.
I pacchetti nella pagina delle release sono compilati da main, e il binario lo dice da solo: croit-flashstore-osd 21.2.0 umbrella.
Proxmox VE 9 offre tre repository Ceph, e solo uno combacia.
Tentacle è il default di Proxmox, quindi è la scelta sicura?
È quella che non funziona.
Il repository di Proxmox porta Tentacle fino alla 20.2.5-pve1, e il branch Tentacle di FlashStore punta esattamente alla 20.2.4.
Umbrella nel repository di Proxmox è la 21.2.0-pve1, la stessa release a cui punta main.
Proxmox non nasconde cos’è Umbrella.
PVE/Ceph/Releases.pm la elenca con unsupported => 15, e la procedura guidata della GUI lo dice chiaro nel momento in cui la scegli.
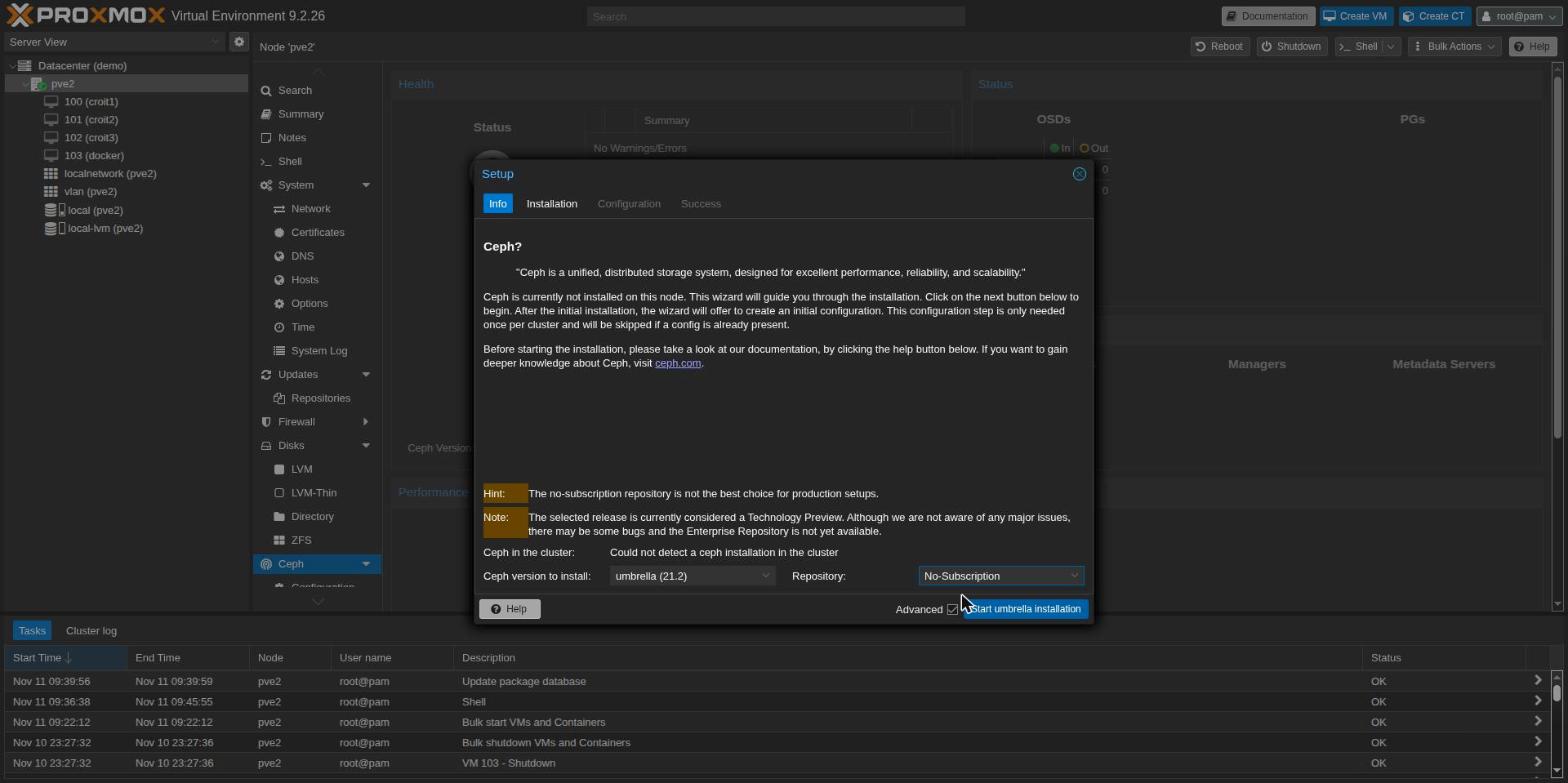
«Technology Preview», nessun repository enterprise, e l’installer chiede una seconda volta nel terminale, continue (y/N)?, prima di toccare apt.
È la giusta dose di avvertimento, e vale la pena leggerla come una dichiarazione sull’intero stack: un OSD in anteprima su una release di Ceph in anteprima.
L’installazione è Proxmox standard. Datacenter → Ceph → Install, versione Umbrella, repository No-Subscription, poi la rete pubblica e il primo monitor.
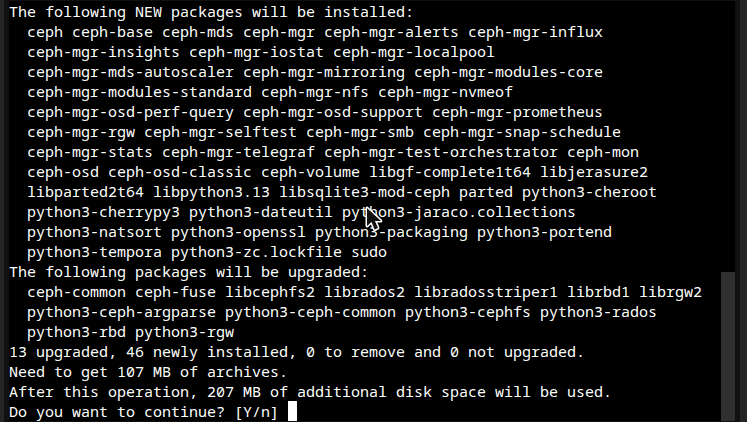
Tredici pacchetti aggiornati, 46 nuovi, 107 MB scaricati.
Una cosa in quell’elenco è nuova in Umbrella: ceph-osd-classic accanto a ceph-osd.
Nessuno dei due viene usato qui, perché non viene mai creato un OSD classico.
Circa un minuto dopo mon.pve2 e mgr.pve2 erano in funzione, ceph versions riportava 21.2.0 … umbrella, e lo stato era OK, senza ancora niente da archiviare.
Quattro dischi a 512 byte
Quattro degli otto Optane erano stati passati a una VM di laboratorio ed erano ancora formattati a 512 byte, con vecchie etichette ZFS sopra. Altri due avevano il formato giusto e le stesse etichette. La soluzione per entrambi i casi è semplice: toglierli dalla VM, formattarli a 4 KiB, cancellare le etichette.
Il P4800X offre 4096 byte senza metadati come formato LBA 3, che nvme id-ns riporta come lbaf 3 : ms:0 lbads:12.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
Il primo tentativo è fallito, e anche uno successivo.
Entrambe le volte nvme format è tornato con Interrupted system call e il disco era ancora a 512 byte.
Il log del kernel ha il motivo:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
L’opcode 0x2 è Get Log Page e 0x6 è Identify.
Nessuno dei due è la formattazione.
Un P4800X formatta l’intero supporto, e qui ci sono voluti da 345 a 351 secondi per disco.
Mentre lavora, il controller non risponde ad altri comandi admin, quindi qualunque cosa faccia una domanda al disco resta in attesa.
Dopo il timeout admin di 60 secondi del kernel, questo si arrende e resetta il controller, e il reset uccide la formattazione.
| Tentativo | Cosa ha raggiunto il disco | Risultato |
|---|---|---|
| nvme0, primo | un Get Log Page alle 09:53:04, a metà installazione di Ceph | interrotto, ancora 512 B |
| nvme0, in una unit | niente | 4 KiB in 345 s |
| nvme1 | il mio nvme list, per controllare l’avanzamento | interrotto, ancora 512 B |
| nvme2, nvme3 | niente | 4 KiB in 351 s e 350 s |
| nvme1, da solo | niente | 4 KiB in 346 s |
La soluzione è lanciare ogni formattazione in una unit transitoria con un timeout lungo, un disco alla volta, e lasciare in pace i dischi finché non ha finito:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
Così l’unico controllo dell’avanzamento è il journal, e niente raggiunge il controller.
A quel punto tutti e otto risultavano 4 KiB in nvme list.
Il pacchetto
La pagina delle release ha pacchetti .deb e .rpm, tra cui Debian 13 trixie, su cui è costruito Proxmox VE 92.
Un’unica build serve ogni distribuzione e richiede glibc 2.34 o più recente6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Controllalo a mano.
sha256sum -c non può verificare questo download, perché il file dei checksum lo chiama debian-trixie/flashstore_…_amd64.deb mentre l’asset si chiama flashstore_…_debian-trixie_amd64.deb.
Gli hash coincidono, ce1fb352…26c8 da entrambe le parti, quindi il file è a posto e solo l’elenco è disallineato con gli asset.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Si è installato senza problemi accanto a ceph-osd e ceph-osd-classic di Proxmox.
Il pacchetto installa un ceph-osd.target minimale solo sugli host che non ne hanno uno6, e Proxmox ce l’ha già, quindi le unit FlashStore si agganciano allo stesso target a cui si aggancerebbero quelle classiche.
Tre cose sul pacchetto da sapere prima di scriverci sopra uno script:
| Cosa dice la documentazione | Cos’è il pacchetto | |
|---|---|---|
| Nome del pacchetto | apt remove flashstore …6 | croit-flashstore-osd, il file dell’asset è flashstore_… |
| Backend dello store | l’insieme di funzioni di produzione di main è knet,spdk,rdma,mimalloc1 | niente SPDK: --check riporta «SPDK NVMe driver: compiled out» |
Valori di flashstore_dev | spdk:<pci>, oppure file: nelle build di sviluppo7 | il livello kernel, kernel:/dev/…, è l’unico percorso di store reale in questa build |
La riga centrale conta.
Il livello SPDK, il driver NVMe in user space che richiede il disco legato a vfio-pci, non è nel pacchetto Debian pubblicato.
Quello che c’è è il livello kernel: il disco resta sul driver nvme del kernel e FlashStore gli parla tramite io_uring.
Il sorgente mostra che è compilato, perché la funzione knet include kernel-nvme8, anche se la riga di riepilogo del controllo dell’host dice che è «compiled out of this build».
Quella riga è sbagliata.
Chi le crede si fermerebbe proprio lì.
Cosa dice il controllo dell’host
croit-flashstore-osd --check è in sola lettura e gira prima che venga scritto qualunque cosa.
Controlla la build, la CPU, la memoria, l’IOMMU, ogni controller NVMe, la scheda di rete, il kernel e la configurazione, e stampa la correzione esatta per ogni risultato9.
Su questo nodo ha eseguito 115 controlli, ed è fatto bene: ogni risultato arriva con il comando che lo risolve, e questo mi ha risparmiato un sacco di ricerche.
| Risultato | Esito | Cosa ho fatto |
|---|---|---|
| Hugepage: nessuna riservata | FAIL | riservati i 16 GiB richiesti, resi persistenti in /etc/sysctl.d |
| Disco di boot SN750: cache di scrittura volatile | FAIL | niente, non è un candidato OSD |
vfio-pci non caricato | WARN | niente, questa build non ha SPDK con cui usarlo |
| limite memlock 8 MiB | WARN | niente, misura la shell; la unit imposta LimitMEMLOCK=infinity |
niente isolcpus / nohz_full | WARN | annotato, tuning della latenza |
IOMMU in traduzione, non iommu=pt | WARN | annotato |
init_on_alloc=1 | WARN | annotato, costa dal 15 al 20% di CPU sulle letture grandi, dice |
| porta da 2,5 GbE, code della scheda di rete di default, IRQ su cinque CPU | WARN | annotato |
| 8 × P4800X: niente VWC, 4096+0 attivo, x4 a 8 GT/s, liberi | OK | |
| io_uring con SEND_ZC e buffer fissi, kernel 7.0 | OK |
Metti in conto il secondo FAIL.
Il controllo conta ogni controller nella macchina, e l’SSD di boot ha una cache di scrittura, quindi non passa il test sulla perdita di alimentazione, anche se lo stesso controllo lo segna correttamente come «in use, not a candidate».
Il tutorial dice che uscire con 0 significa nessun FAIL9.
Su qualunque host che fa il boot da un SSD consumer, cioè molti host Proxmox, --check non può uscire con 0, qualunque cosa tu sistemi.
Scrivi gli script sulle righe dei singoli controlli, non sul codice di uscita.
I WARN di tuning sono rimasti. Ognuno richiede una modifica alla riga di comando del kernel e un riavvio, e questa è un’installazione, non un benchmark. Sono l’elenco giusto da smaltire prima che qualcuno citi un numero preso da questa macchina.
Core e hugepage per otto OSD
FlashStore gira con un thread per core, e il controllo spiega cosa significa: «one core = one shard/PG owner», al massimo 8 core per OSD, e ogni core di un OSD su un proprio core fisico invece di condividerlo con un fratello SMT.
Otto core fisici e otto OSD fanno un core ciascuno, da flashstore_lcores = 0 a 7, con i fratelli SMT lasciati a Proxmox e alle VM.
Rieseguito con questo nella configurazione, il controllo segna OK ogni piano dei core.
Guarda di nuovo le hugepage.
Il controllo chiede 2048 MiB per OSD, che è il --mem di default del daemon, quindi otto OSD richiedono 16 GiB riservati.
In funzione, ogni OSD ne ha usati 512 dei suoi 2048.
Corrisponde alla nota di progetto di croit per il backend kernel, che assegna un quarto di --mem al suo allocatore per i dati10.
Quindi su questa macchina, con tutti e otto in funzione, 12 GiB di RAM restano riservati come hugepage che niente tocca, su un host che deve sfamare anche delle VM.
Un nodo di solo storage farebbe spallucce.
Su un nodo Proxmox quella memoria era una VM, e più sotto viene ridotta a quello che gli OSD usano.
Posso chiedere perché non riesce a leggere ceph.conf?
Con i dischi formattati, il pacchetto installato e il controllo dell’host superato, il primo OSD non partiva.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
Su Proxmox, /etc/ceph/ceph.conf è un link simbolico a /etc/pve/ceph.conf, e /etc/pve è pmxcfs, il filesystem del cluster che tiene allineata la configurazione di ogni nodo.
I file lì sono root:www-data 0640, e pmxcfs non ti permette di cambiarlo file per file11.
I daemon Ceph di Proxmox se la cavano perché partono come root, leggono la configurazione e poi passano all’utente ceph, che è quello che fa --setuser ceph --setgroup ceph su ogni unit ceph-osd@.
La unit di FlashStore non parte come root.
È User=ceph dalla prima istruzione, ExecStartPre compreso12, quindi non arriva mai a leggere il file.
Posso chiedere perché un pacchetto compilato per Debian, per un prodotto che si vende come drop-in, non è stato provato sulla piattaforma Ceph basata su Debian più diffusa che esista? Non sto chiedendo chi. pveceph tiene la sua configurazione su pmxcfs, e ogni OSD FlashStore su un nodo gestito da pveceph ci sbatterà contro al primo avvio.
Il daemon ha già la risposta dentro.
Il suo sorgente descrive un classico passaggio con --setuser/--setgroup: «started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file»13.
Quindi un drop-in che avvia la unit come Proxmox avvia i propri OSD dovrebbe bastare.
Non del tutto. Avviato come root puro, il rifiuto successivo è stato il disco.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
Il CapabilityBoundingSet della unit lascia fuori CAP_DAC_OVERRIDE12, quindi root è vincolato ai normali permessi dei file, e i nodi dei namespace appartengono a ceph:ceph.
Partire come root con il gruppo impostato a ceph copre entrambe le cose: root possiede il file di configurazione, il gruppo ceph apre il disco, e il daemon passa a ceph prima di fare qualunque altra cosa.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
Il daemon conferma il passaggio nel suo log: set uid:gid to 64045:64045 (ceph).
C’è una correzione più corta, SupplementaryGroups=www-data, e non l’ho usata.
Permetterebbe all’OSD di leggere ogni file leggibile dal gruppo sotto /etc/pve, non solo la configurazione di Ceph.
Un OSD non ha alcun motivo di leggere il resto della configurazione del cluster, e il drop-in qui sopra non gli dà niente di più di quello che Proxmox dà ai propri.
Poi i nodi dei dispositivi.
La documentazione di FlashStore dice che il nodo del namespace deve essere scrivibile da ceph, «(udev rule)»14, e il pacchetto non ne fornisce nessuna.
Questa riconosce i dischi per modello, quindi non può prendere il disco di boot qualunque cosa faccia la numerazione:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Dopo udevadm trigger, i sedici nodi degli Optane erano ceph:ceph 0660 e l’SN750 è rimasto root.
Il passthrough che questo kernel non fa
Il livello kernel ha due modalità, e sceglie il nodo che indichi.
kernel:/dev/ngXnY manda i comandi NVMe dritti al disco tramite io_uring, che croit chiama kernel-cmd.
kernel:/dev/nvmeXnY fa letture e scritture O_DIRECT sul dispositivo a blocchi, chiamato kernel o diretto10.
croit ha misurato kernel-cmd in vantaggio in ogni caso testato10, e il quick start del README lo usa1, quindi è quello che ho configurato.
Con i permessi sistemati, il daemon è passato a ceph, ha letto la configurazione e si è fermato alla prima lettura:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
La stessa prova era passata un minuto prima in activate, che aveva ancora le capability di root.
Quindi la domanda è se questo kernel permette a un processo non privilegiato di mandare comandi di I/O attraverso /dev/ngXnY.
Si può rispondere senza FlashStore, con la stessa lettura fatta da nvme-cli, come ceph:
| Come | Comando su /dev/ng0n1 | Risultato |
|---|---|---|
ceph | Identify Namespace | permesso |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | permesso |
Tutti e otto gli Optane hanno dato la stessa risposta, compresi due che non avevo mai formattato né resettato, con il firmware di Intel invece di quello di Dell. Quindi non sono i dischi e non sono le formattazioni della mattina.
Upstream dice che dovrebbe funzionare.
In Linux 7.0, nvme_cmd_allowed() permette a un processo non privilegiato di mandare un comando di I/O quando il log Commands Supported and Effects del disco lo segna come supportato senza effetti insoliti, e richiede un’apertura in scrittura solo per i comandi che scrivono o modificano dati15.
Il log degli effetti del P4800X segna Read come supportato, 00000001, e nient’altro.
La lettura è permessa.
Il kernel di Proxmox non è quello di upstream.
Il suo changelog per questa build include una correzione portata indietro proprio su questo percorso, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), che a prima vista riguarda un ioctl diverso da quello che ho testato.
Non ho individuato quale modifica nel kernel 7.0.14-28-pve faccia la differenza, e non tirerò a indovinare.
Quello che è certo è il comportamento: su questo kernel, l’I/O NVMe in passthrough non privilegiato viene rifiutato.
FlashStore ha un ripiego per il passthrough rifiutato, e non è scattato.
La nota di progetto di croit dice che quando Identify viene rifiutato, un dispositivo kernel-cmd ripiega sull’I/O diretto sul suo nodo a blocchi e lo dice all’avvio10.
Qui Identify è permesso e Read no, quindi il ripiego non scatta mai e l’OSD si ferma.
All’I/O diretto non importa. È una riga per OSD:
flashstore_store_backend = kernel
Con questa, osd.0 è partito.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Attivo in 2,4 secondi.
Preparare e avviare gli OSD
Ogni OSD riceve una sezione nella configurazione di Ceph, che su Proxmox significa modificare /etc/pve/ceph.conf, e farlo a mano va benissimo.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
Il dispositivo è indicato per indirizzo PCI, non come /dev/nvme0n1, e il prefisso spdk: qui non significa SPDK.
Con un backend kernel impostato, il daemon cerca l’indirizzo in sysfs a ogni avvio e trova i nodi attuali del controller10.
Qui conta.
Il disco di boot SN750 era nvme7 a ottobre ed è nvme8 adesso, e nemmeno i minor dei nodi generici seguono l’ordine dei dischi, con ng1n1 al minor 0 e ng0n1 al minor 2.
Una configurazione che dice /dev/nvme4n1 può puntare a un disco diverso dopo un riavvio.
Una configurazione che dice 0000:0b:00.0 no.
Poi un comando per disco, che scrive lo store e registra l’OSD presso il monitor:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Due secondi, come root.
prepare legge la chiave di bootstrap da /var/lib/ceph/bootstrap-osd/ceph.keyring16, che pveceph scrive solo la prima volta che crea un proprio OSD, quindi senza OSD classici va recuperata prima:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Sei dischi preparati al primo colpo. Due sono stati rifiutati:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk e blkid avevano entrambi segnalato quei due dischi come vuoti.
Sopra c’era l’area dei metadati testuali di un volume group LVM di un laboratorio precedente, rimosso da tempo, con l’etichetta in testa già azzerata.
La sonda di FlashStore legge i primi 8 KiB e le zone a 64 KiB e 256 KiB17, più in là di dove guardano i soliti strumenti, e aveva ragione.
Rifiutare un disco che contiene qualcosa, a meno che non gli si dica --wipe, è esattamente quello che dovrebbe fare uno strumento per OSD.
Cancellarli è una decisione di chi possiede i dischi, non dello strumento.
Una volta deciso, --wipe li ha preparati entrambi in circa due secondi, e si sono aggiunti dopo l’installazione più sotto, ed è per questo che lo screenshot del pannello e i dati dell’installazione ne mostrano sei.
Poi avviali:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Ogni OSD si è messo sotto host=pve2 con classe di dispositivo nvme.
Quello che dicono di sé al cluster vale la pena leggerlo una volta:
| Campo | Monitor e manager | OSD FlashStore |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Compilato da | Proxmox, pacchetti -pve1 | croit, dal commit upstream v21.2.0 indicato nel README1 |
osd_objectstore | bluestore, con ogni campo bluestore_bdev_* compilato | |
| Cos’è davvero | FlashStore, niente BlueFS, niente RocksDB |
La risposta BlueStore è voluta.
flashstore_report_objectstore ha come default bluestore perché i monitor classici attivano alcune funzioni solo quando ogni OSD lo riporta, quindi il default tiene in piedi un cluster misto7.
Non è vero, ed è bene saperlo prima di leggere i metadati del cluster e crederci.
Cosa ne fa Proxmox
Il pannello OSD di Proxmox li elenca tutti e sei, up e in, classe nvme, versione 21.2.0, 344 GiB ciascuno.
Li chiama anche FileStore.
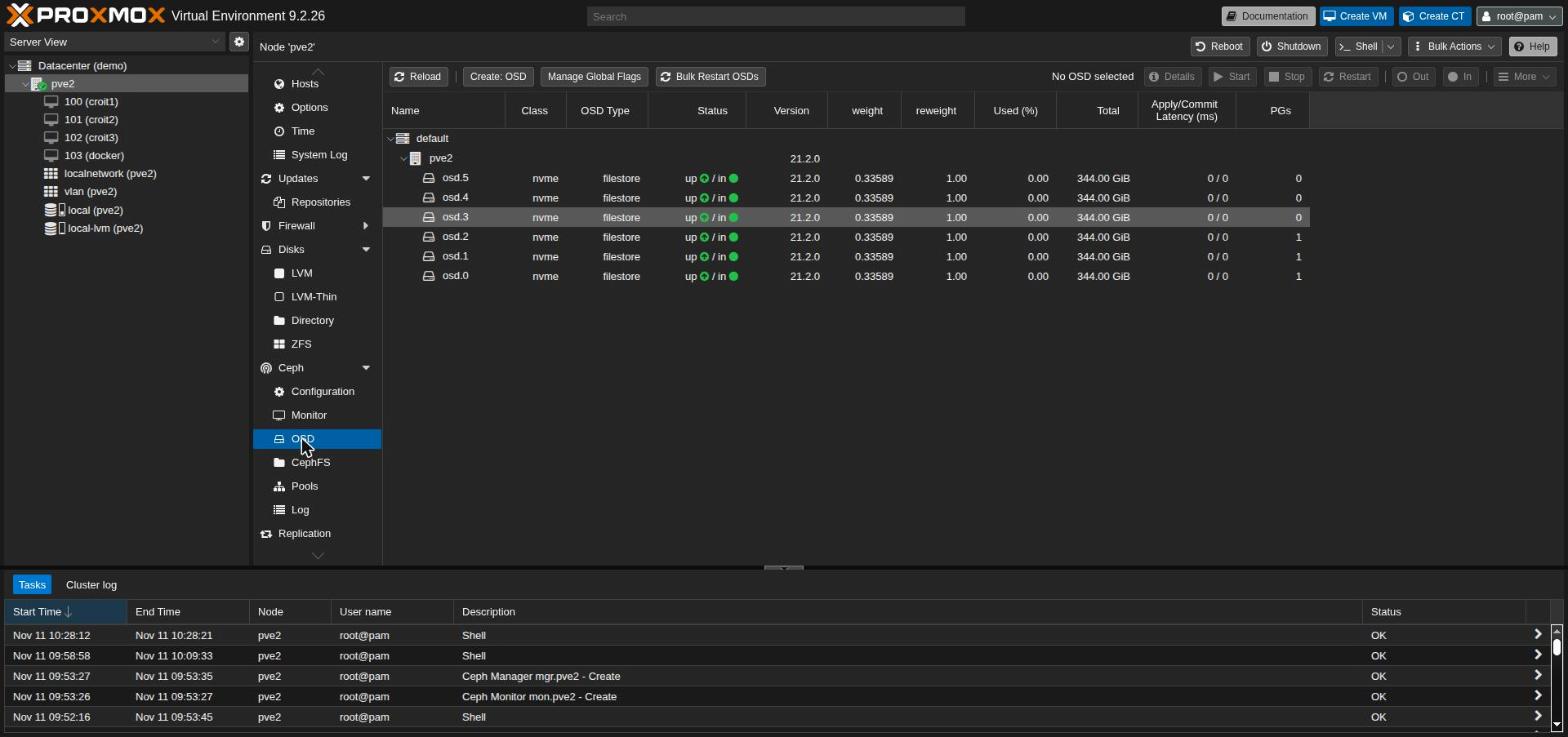
FileStore è l’object store che BlueStore ha sostituito.
Proxmox ricava l’etichetta in PVE/API2/Ceph/OSD.pm: se i metadati dell’OSD hanno una chiave bluefs è BlueStore, e qualunque altra cosa è FileStore18.
FlashStore non ha BlueFS, perché sotto non c’è RocksDB, quindi dichiara BlueStore in un campo e viene etichettato FileStore in base a un altro.
Nessuna delle due cose è giusta.
E il pannello è il primo posto dove guarda la maggior parte degli amministratori Proxmox.
Le colonne della latenza segnano 0 / 0 a riposo.
Durante l’installazione qui sotto, ceph osd perf ha riportato latenze di commit da 0 a 3 ms sui sei.
Start, Stop e Restart nel pannello comandano ceph-osd@N, la unit classica, che non è quella in funzione19.
Per questo il pannello è una vista su questi OSD, non un comando per gestirli.
Usa systemctl … croit-flashstore-osd@N e la CLI per qualunque cosa tocchi i daemon, e lascia stare Create: OSD e Destroy su questi.
Un pool, uno storage e una VM Fisher-Price OS (Windows)
Il primo PG del cluster, il pool .mgr del manager, è rimasto undersized+degraded appena gli OSD sono partiti.
Colpa del nodo singolo.
La replicated_rule di default mette ogni copia su un host diverso, e c’è un solo host.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Una regola con dominio di guasto osd e classe di dispositivo nvme20 mette ogni copia su un OSD diverso, e il PG è passato ad active+clean in pochi secondi.
Su un cluster vero con tre o più host, tieni la regola per host e salta questo passaggio.
Tutto il resto è la GUI di Proxmox come al solito.
Ceph → Pools → Create: nome flashstore, size 3, min size 2, regola replicated_osd, Add as Storage spuntato.
Più avanti è passato a size 2, min size 1, per la prova di carico più sotto.
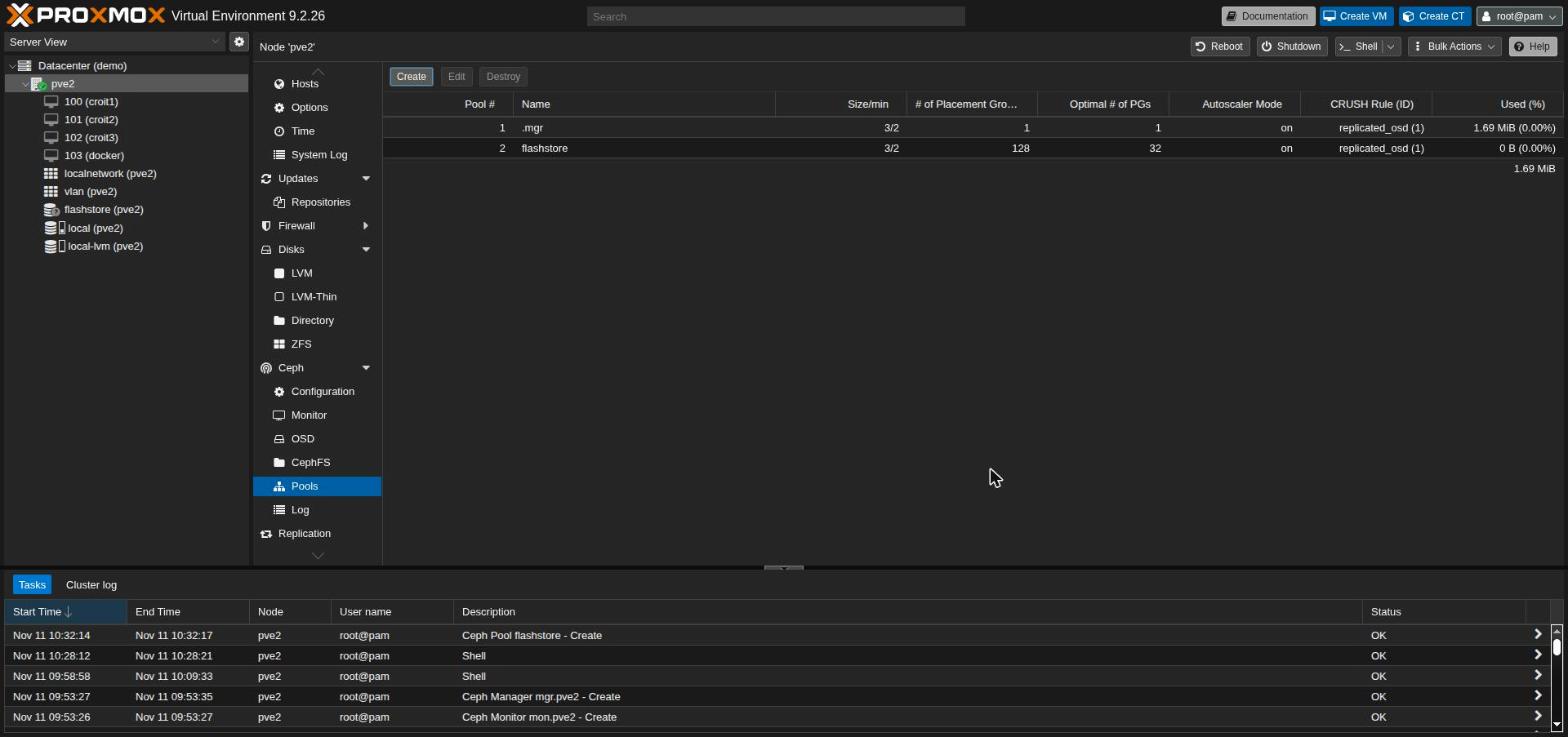
Proxmox ha creato il pool e la definizione dello storage RBD in un colpo solo, e flashstore è comparso nell’albero con 654 GiB utilizzabili, cioè i 2 TiB grezzi divisi per tre copie, meno l’overhead.
129 PG sono passati ad active+clean, e poco dopo l’autoscaler ha portato il nuovo pool da 128 a 32.
La VM di prova è una VM Fisher-Price OS (Windows).
Non è una preferenza, è quello che una buona parte dei clienti fa davvero girare sui propri pool Proxmox, quindi è il carico che conta: 16 GiB di memoria, 4 core, un disco da 60 GiB su flashstore con discard e iothread attivi.
Fa anche molto rumore sul disco e lo usa male, ed è proprio questo il punto: una prova di storage vuole il guest che si appoggia al disco più di tutti.
Campionando il pool ogni dieci secondi per i primi quindici minuti dell’installazione:
| Scritture sul pool | mediana 9,3 MB/s quando attivo, picco 302 MB/s |
| Operazioni di scrittura | picco di 2.486 al secondo |
| Letture dal pool | picco 60 MB/s |
| Spazio grezzo usato | 35 GiB su sei OSD |
| Stato | HEALTH_OK in tutti i 90 campioni |
| Riavvii degli OSD | 0 |
| Memoria residente degli OSD | da 565 a 871 MiB ciascuno, dopo |
Sono i numeri di un installer, con la VM e gli OSD sullo stesso host e i WARN di tuning intatti, e non dicono niente sulla velocità di FlashStore. Quello che dicono è che un client Proxmox classico ha portato a termine l’installazione di un sistema operativo su OSD in Rust, 35 GiB grezzi, senza un errore, che è proprio la promessa che questo articolo voleva mettere alla prova.
Cosa fa sotto carico
Un’installazione dimostra che funziona. Non ti dice com’è usare la VM.
Allora la VM ha avuto CrystalDiskMark 9.0.321, tre volte: il profilo Real World Performance [+Mix], Read&Write [+Mix], un file da 16 GiB su C: e un mix 70/30 di letture e scritture, una volta con tre passate e due volte con nove. Quel profilo esegue tutto una richiesta alla volta su un solo thread, che è quello che fa davvero un desktop o un piccolo database, non quello che fa una scheda tecnica.
A quel punto la configurazione era andata oltre l’installazione. La VM aveva sei core, e il pool era stato cambiato dalla GUI a size 2, min size 1 e 256 PG. Size 2 con min size 1 è un’impostazione da laboratorio su una sola macchina: con una sola copia rimasta, il pool continua ad accettare scritture che un singolo guasto può poi far perdere. Altrove, tieni 3 e 2.
Il disco era sul default di Proxmox, nessuna cache, che è il default da Proxmox 222.
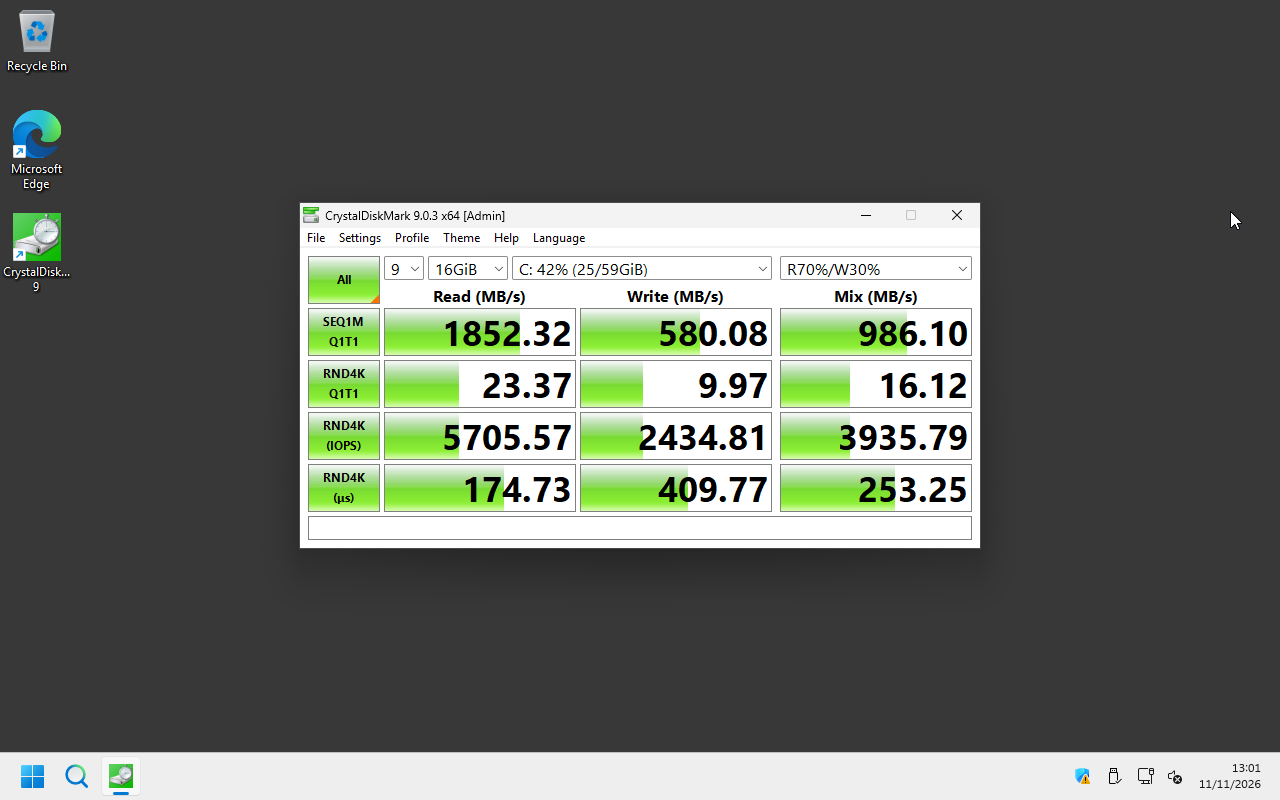
| Real World Performance [+Mix], 16 GiB | 3 passate | 9 passate | 9 passate di nuovo |
|---|---|---|---|
| SEQ1M Q1T1 lettura | 1.279,71 MB/s | 1.675,33 MB/s | 1.852,32 MB/s |
| SEQ1M Q1T1 scrittura | 563,67 MB/s | 576,65 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 mix | 1.043,75 MB/s | 1.043,28 MB/s | 986,10 MB/s |
| RND4K Q1T1 lettura | 5.342 IOPS, 186,57 µs | 5.659 IOPS, 176,17 µs | 5.706 IOPS, 174,73 µs |
| RND4K Q1T1 scrittura | 2.419 IOPS, 412,51 µs | 2.405 IOPS, 414,79 µs | 2.435 IOPS, 409,77 µs |
| RND4K Q1T1 mix | 3.938 IOPS, 253,13 µs | 3.826 IOPS, 260,49 µs | 3.936 IOPS, 253,25 µs |
Le scritture e la latenza sui blocchi piccoli restano entro circa l'1% da un’esecuzione all’altra. La lettura sequenziale sale del 45% nelle tre. È il primo segnale che la colonna delle letture non sta misurando quello che sembra.
L’host è stato campionato ogni cinque secondi durante tutte e tre, da /proc/diskstats per gli otto Optane, ceph status per il pool e /proc per ogni processo e thread, e le due viste non raccontano la stessa storia.
Scritture: il disco è la parte piccola
| Una scrittura casuale da 4 KiB alla volta, ultima esecuzione | |
|---|---|
| Tempo per scrittura, visto dalla VM | 409,77 µs |
| Tempo per scrittura, a ciascun Optane | 17 µs |
| Scritture che arrivano agli Optane per ogni scrittura della VM | 4,05: due copie, circa due scritture ciascuna |
| Scritture sequenziali grandi | 580 MB/s dalla VM, 1,14 GB/s agli Optane, con la seconda copia che le raddoppia |
Il disco è meno del 5% di una scrittura piccola. Gli altri 393 µs sono il viaggio: QEMU, librbd, il messenger verso l’OSD, l’OSD stesso, e l’attesa della seconda copia. Niente di questo è stato misurato separatamente qui, quindi non darò un numero a ciascun pezzo. Quello che dice è che su questa macchina gli Optane non sono il limite per l’I/O una richiesta alla volta, e un disco più veloce non sposterebbe di molto quei 410. Il limite si è spostato sul client, la librbd fornita da Proxmox, e ci sarà altro da dire quando la librustyrbd di croit verrà installata qui.
Letture: la cache, non gli Optane
Nell’ultima esecuzione la passata di letture casuali da 4 KiB ha fatto 5.700 letture al secondo sull’intero file da 16 GiB, e gli otto Optane non hanno letto assolutamente niente.
La passata sequenziale ha raggiunto 2,2 GB/s al pool mentre le letture dei dischi scendevano da 755 MB/s a zero.
CrystalDiskMark aggira la cache del guest e il disco in QEMU non ne ha, quindi la memoria che fa il lavoro sta negli OSD.
flashstore_obj_cache è attivo di default in questa build, la quota del file di ciascun OSD è di circa 2 GiB con size 2, e ogni OSD era cresciuto a circa 2,6 GiB.
FlashStore non riporta i suoi hit, quindi chiamalo quasi certo invece che dimostrato.
È anche il motivo per cui la lettura sequenziale è salita a ogni esecuzione: una parte maggiore del file era già lì.
Tratta la colonna delle letture come un dato della cache, non dello store.
CPU: dove sono finiti i core
| Ultima esecuzione, in core | Host occupato | OSD | vCPU del guest | librbd e client Ceph | QEMU |
|---|---|---|---|---|---|
| A riposo tra le passate | dal 20 al 24% | 3,3 | 0,1 | 0,03 | 0,03 |
| Scrittura casuale 4 KiB | 30% | 3,9 | 0,38 | 0,20 | 0,08 |
| Lettura casuale 4 KiB | 30% | 3,6 | 0,47 | 0,39 | 0,15 |
| Mix sequenziale | dal 41 al 53% | 3,8 | da 1,5 a 2,3 | 0,5 | 0,12 |
Le tre colonne della VM vengono dai suoi thread: QEMU dà un nome alle vCPU del guest, e i thread messenger e worker di librbd girano dentro lo stesso processo.
La colonna degli OSD si muove appena. Otto OSD in polling costano 3,3 core senza fare niente e 3,9 al massimo, quindi su una macchina da 16 thread un quinto della CPU se ne va prima che una VM chieda qualcosa. Nient’altro si è avvicinato al proprio limite. Il thread singolo più impegnato è stato una vCPU del guest al 47%, e il più impegnato di librbd è rimasto sotto il 15%. Con una richiesta alla volta il limite è l’attesa, non il lavoro, e un dato sulla CPU non può mostrare un’attesa.
Memoria: pianifica per il picco
| Su tutte e tre le esecuzioni | |
|---|---|
| Stato | HEALTH_OK in ogni campione, ogni PG active+clean, nessun riavvio degli OSD |
| Hugepage in uso | 4 GiB dall’inizio alla fine |
| Memoria dell’host ancora assegnabile, con una VM da 16 GiB in funzione | da 3,1 a 4,0 GiB |
La riga delle hugepage è di nuovo la sezione sul budget, stavolta sotto carico: 512 MiB per OSD, e gli altri 12 GiB mai toccati.
La memoria ordinaria è il numero da tenere d’occhio, perché la cache qui sopra è fatta di quella. Una volta che una lettura aveva caricato il file, ogni OSD si è assestato intorno a 2,5 GiB, e questo è quanto teneva Ceph su un host da 58,7 GiB:
| Memoria di Ceph al picco, target di default 4 GiB | |
|---|---|
| Processi OSD, gli otto insieme | 19,9 GiB, da 2,4 a 2,6 GiB ciascuno |
| Hugepage riservate per gli OSD | 16 GiB, di cui 4 GiB usati |
| Monitor e manager | 0,3 GiB |
| Totale | 36,2 GiB, il 62% dell’host |
| Rimasto da assegnare all’host, con una VM da 16 GiB in funzione | 3,6 GiB |
Torna indietro, ma non con una tempistica che io abbia potuto vedere.
È rimasta a 19,9 GiB per 25 minuti, pause di inattività comprese, poi è scesa a 13,9 GiB alla fine dell’ultima esecuzione, e l’host aveva di nuovo 10,2 GiB da assegnare.
osd_memory_target è rimasto al suo default di 4 GiB per OSD per tutto il tempo, quindi otto OSD avevano diritto a 32 GiB prima ancora di contare una sola hugepage.
Su un nodo che deve anche far girare VM, il picco è il budget da calcolare prima dei dischi, ed è lì che i 12 GiB di hugepage inutilizzate fanno più male.
Tre VM insieme, con un budget più stretto
Una VM lascia un sacco di spazio. Tre sono il punto in cui il budget deve essere giusto. Quindi prima sono cambiate due impostazioni.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
Il target non richiede altro: ogni OSD ha riportato il nuovo valore in pochi secondi, e sono stati comunque riavviati uno alla volta, con tutti i 257 PG tornati active+clean prima del successivo.
Le hugepage hanno un tranello.
Prima di ogni avvio di un OSD, croit-flashstore-prep vuole libero un intero --mem, 2048 MiB, e alza il pool se manca, ma non lo riabbassa mai.
Riavviare osd.7 dopo il taglio ha riportato subito su il pool:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Quindi il minimo che sopravvive a un riavvio dell’OSD o della macchina è quello che usano gli OSD più il margine di un avvio: 2.816 pagine, 5,5 GiB, contro i 16 GiB che chiede il controllo. Lo script più avanti ora riserva esattamente quello. Ritagliare a 2.048 una volta che tutti e otto sono su fa guadagnare altri 1,5 GiB fino al riavvio successivo.
Poi tre cloni della VM, da 10 GiB ciascuno, hanno eseguito CrystalDiskMark nello stesso momento: Real World Performance [+Mix], tre passate, ma su un file da 1 GiB ciascuno invece che da 16 GiB. Questo rende la colonna delle letture ancora più un dato della cache, quindi leggi le scritture.
| CrystalDiskMark, tre VM insieme | VM 104 | VM 105 | VM 106 | Tutte e tre | Una VM da sola |
|---|---|---|---|---|---|
| SEQ1M Q1T1 scrittura | 346,99 MB/s | 318,99 MB/s | 446,98 MB/s | 1.113 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 lettura | 796,05 MB/s | 905,03 MB/s | 1.160,93 MB/s | 2.862 MB/s | 1.852,32 MB/s |
| RND4K Q1T1 scrittura | 1.901 IOPS | 1.928 IOPS | 1.862 IOPS | 5.691 IOPS | 2.435 IOPS |
| RND4K Q1T1 latenza in scrittura | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 lettura | 3.773 IOPS | 3.916 IOPS | 3.909 IOPS | 11.598 IOPS | 5.706 IOPS |
| RND4K Q1T1 mix | 2.978 IOPS | 3.027 IOPS | 3.411 IOPS | 9.416 IOPS | 3.936 IOPS |
Tre VM hanno ottenuto 2,3 volte le scritture piccole di una, e ciascuna l’ha pagato con circa il 27% di latenza in più. Gli Optane non erano ancora la causa. Hanno toccato il picco di 20.900 scritture al secondo a 17 µs ciascuna, gli stessi 17 µs di una VM, e il più impegnato degli otto era occupato al 14%.
| Host, ogni cinque secondi durante l’esecuzione | Target di default 4 GiB, una VM | Target 1 GiB, tre VM |
|---|---|---|
| Processo OSD più grande | 2,7 GiB | 1,15 GiB al picco, 0,8 dopo |
| Gli otto processi OSD insieme | 19,9 GiB | 8,0 GiB al picco, 5,8 dopo |
| Hugepage riservate | 16 GiB, 4 usati | 4 GiB, tutti usati |
| Memoria data alle VM | 16 GiB | 30 GiB |
| Memoria dell’host ancora assegnabile, al minimo | 3,1 GiB | 14,8 GiB |
| Crescita dello swap | nessuna | nessuna |
Quindi FlashStore rispetta davvero osd_memory_target.
È andato oltre del 15% al picco di una passata di letture ed è tornato sotto, con la cache che fa il suo lavoro dentro il budget invece che fuori.
Tra il target e il taglio, 26 GiB sono tornati alle VM sulla stessa macchina.
| CPU in core, tre VM | Host occupato | OSD | Guest | librbd e client Ceph | QEMU |
|---|---|---|---|---|---|
| Tre avvii di Fisher-Price OS (Windows) | dall'81 all'89% | da 3,4 a 3,6 | da 6,3 a 7,9 | da 0,4 a 0,7 | 0,3 |
| Benchmark | dal 42 al 73% | da 3,7 a 4,5 | da 1,2 a 4,0 | da 0,4 a 1,6 | da 0,2 a 0,4 |
| A riposo dopo | dal 20 al 24% | 3,3 | 0,3 | 0 | 0 |
Avviare tre guest ha fatto lavorare la CPU più del benchmark. Lo storage sotto non ci si è mai avvicinato, ed è il mini PC che pone il limite, come era scontato che fosse.
Tutto quanto, in uno script
Tutto quello che c’è qui sopra sta in un solo script. Dagli gli indirizzi PCI dei dischi che vuoi come OSD e fa il resto, nell’ordine seguito da questo articolo, con dentro le due correzioni per Proxmox.
flashstore-pve-setup.sh: OSD FlashStore su un nodo Proxmox VElspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Controlla | Scrive | Esegue |
|---|---|---|
| Proxmox VE 9 e Ceph 21.2.0 Umbrella | il keyring bootstrap-osd | una lettura in passthrough come ceph, per scegliere kernel-cmd o kernel |
| ogni disco: NVMe, niente cache di scrittura, non montato, partizionato o in uso | il drop-in root-poi---setuser | prepare e systemctl enable --now per ogni disco |
| nessun dato nelle zone che legge la sonda di FlashStore | una regola udev per disco, riconosciuto dal numero di serie | il controllo dell’host, fermandosi solo su ciò che serve agli OSD |
| blocchi da 4 KiB | una sezione [osd.N] per disco, un core fisico ciascuno | il download del pacchetto, verificato contro lo SHA-256 della release |
Niente viene distrutto a meno che tu non lo chieda.
--format-4k riformatta un disco che non è a 4 KiB, uno alla volta nella propria unit così che niente lo interrompa, e --wipe gli permette di sovrascrivere un disco che contiene dati.
--single-node aggiunge la regola replicated_osd, e rieseguirlo salta i dischi che sono già OSD.
È stato testato qui, non solo scritto.
Ha rifiutato l’SN750 per la sua cache di scrittura, ha rifiutato il disco di osd.7 finché conteneva ancora uno store, e poi, con osd.7 eliminato e i suoi nodi restituiti a root, l’ha ricostruito da zero in 10,5 secondi, scegliendo da solo il backend kernel.
Quello che non fa è installare Ceph.
Quel passaggio ti chiede di accettare una Technology Preview, e quella è una decisione tua, non di uno script.
Cosa va sistemato
Niente di questo ferma un amministratore determinato, e tutto questo fermerebbe uno di fretta. Ogni voce è una dichiarazione che croit fa a chiunque scarichi il pacchetto, e ci ho sbattuto contro ciascuna al primo tentativo.
| Dove | Cosa succede | Cosa la risolverebbe |
|---|---|---|
| unit systemd | User=ceph non può leggere pmxcfs, quindi l’OSD non parte mai su un nodo pveceph | fornire l’avvio root-poi---setuser, o un drop-in per Proxmox |
| ripiego di kernel-cmd | ripiega solo se Identify viene rifiutato; sul kernel di PVE viene rifiutato Read e l’OSD si ferma | ripiegare sull’I/O diretto per qualunque I/O in passthrough rifiutato |
| udev | la documentazione richiede una regola che dia a ceph i nodi dei namespace; non ne viene fornita nessuna | fornirne una legata ai dispositivi configurati |
riepilogo di --check | dice che il kernel NVMe è «compiled out» quando è l’unico percorso di store compilato | correggere l’etichetta |
codice di uscita di --check | l’SSD di boot non passa il test PLP, quindi uscire con 0 è impossibile | valutare solo i dispositivi configurati o candidati |
| hugepage | dimensiona 2048 MiB per OSD, e prep li vuole liberi a ogni avvio; il backend kernel ne usa 512 | dimensionare il backend kernel per quello che usa, e far chiedere a prep la stessa cifra |
sha256sums.txt | i nomi dei file non corrispondono agli asset della release | chiamarli come sono pubblicati |
| nome del pacchetto | la documentazione dice apt remove flashstore; il pacchetto è croit-flashstore-osd | un solo nome, o quello giusto nella documentazione |
riferimento di flashstore_dev | elenca solo spdk: e file: | documentare kernel: e spdk: con un backend kernel |
Niente di questo è lavoro nuovo. Il daemon ha già il passaggio di privilegi, il backend diretto e la logica del ripiego. Solo che non sono stati collegati per la piattaforma su cui la maggior parte delle persone lo proverà per prima.
Un’anteprima è dove lo scopri
Un’anteprima è il posto giusto per ognuno di questi risultati, e il posto sbagliato dove lasciarli. È a questo che serve un’anteprima: qualcuno se la porta a casa, la mette sull’hardware che ha davvero, e scrive dove cade. Le parti che contano hanno tenuto. Lo store è salito in millisecondi, gli OSD si sono uniti a un cluster costruito con gli strumenti di qualcun altro, e l’installazione di un sistema operativo ci è andata sopra senza un errore.
Quello che l’ha fatto inciampare è tutto ciò che sta intorno al daemon. Un file di configurazione su un filesystem che la unit non poteva leggere, un kernel che dice no a una chiamata che upstream permette, un disco di boot che il controllo non smetteva di contare. Niente di tutto questo è difficile. Tutto questo è la differenza tra un software che funziona e un software che funziona sulla tua macchina, e l’unico modo per colmarla è testare sulle macchine che la gente ha davvero invece che su quelle che hai costruito apposta.
Detto questo, è un inizio promettente. Su un mini PC scadente, con il lato client ancora sulla librbd classica e tutti e otto i dischi su un solo link PCIe 3.0, qui gli Optane lavorano più che sotto BlueStore. Man mano che il progetto cresce ci tornerò sopra e scaverò più a fondo, quando altre parti dello stack verranno sostituite, e darò anche un’occhiata a CephFS2.
«Drop-in» è una promessa fatta a un amministratore che non ha tempo di leggere il sorgente. I monitor di Proxmox, la GUI di Proxmox, il kernel di Proxmox e un pacchetto di qualcun altro sono esattamente la situazione per cui esiste quella promessa. Adesso la mantiene quasi. Nove piccole correzioni e la manterrà, e preferisco essere io a trovarle un mercoledì mattina piuttosto che un cliente a trovarle un venerdì sera.
croit/ceph-rust README — anteprima pubblica dal 9 novembre 2026, «not yet recommended for production data», requisiti, quick start, insieme di funzioni di produzione, commit Ceph testato. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — i pacchetti usati qui, tra cui
flashstore_…_debian-trixie_amd64.debesha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — controllo della cache di scrittura volatile, hugepage, note sulla versione del kernel. ↩︎
croit/ceph-rust — branches and versions —
mainpunta a v21.2.0,v20.2.4punta a v20.2.4; «The daemon refuses a cluster release outside its supported window.» ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellaelencata conrelease => '21.2'eunsupported => 1. ↩︎croit/ceph-rust — build and install packages — distribuzioni, glibc 2.34, gestione di
ceph-osd.target, la rigaapt remove. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstoree perché il suo default èbluestore. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — riga 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — il controllo dell’host in sola lettura; «Exit 0 means no FAIL.» ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — le due modalità kernel, il confronto misurato, il budget dell’allocatore per i dati, la risoluzione degli indirizzi
spdk:e il ripiego solo su Identify (emendamento 6). Aggiunto al repository la sera stessa del rilascio. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — il filesystem del cluster sotto
/etc/pvee i suoi proprietari e permessi fissi. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activate, e unCapabilityBoundingSetsenzaCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — il classico passaggio di privilegi con
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — «the namespace node must be readable and writable by user
ceph(udev rule)». ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), la regola per il passthrough NVMe non privilegiato. ↩︎croit/ceph-rust — security — «
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring». ↩︎croit/ceph-rust — prepare, activate and list — la sonda per i dispositivi non vuoti e
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypeèbluestoresolo quando i metadati contengonobluefs, altrimentifilestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()associaosd.Nalla unit systemdceph-osd@N. ↩︎Ceph documentation — CRUSH maps — regole replicate, domini di guasto e classi di dispositivo. ↩︎
CrystalDiskMark — il benchmark per dischi di Crystal Dew World; «Various measure mode (Peak/Real World/Demo)». ↩︎
Proxmox VE wiki — Performance Tweaks — le modalità di cache del disco: «cache=none seems to be the best performance and is the default since Proxmox 2.X». ↩︎