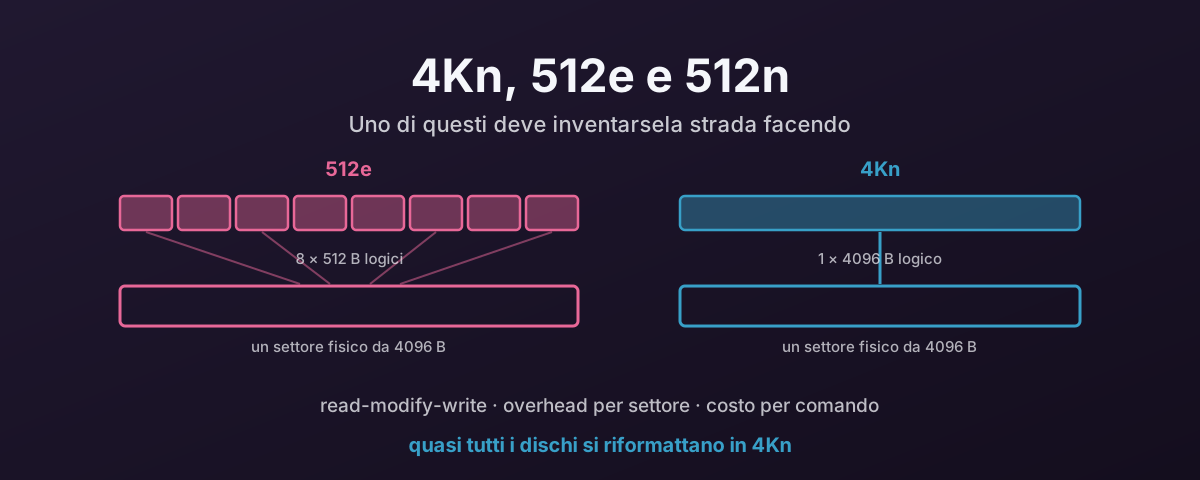
Tre modi in cui un disco può presentarsi
Un disco ha due dimensioni di blocco, e la differenza tra le due è tutta la storia.
Il settore fisico è l’unità in cui il supporto lavora davvero: la più piccola unità che il disco può leggere o scrivere senza fare lavoro in più. Il blocco logico è l’unità in cui il disco dice all’host di lavorare: l’unità che l’host indirizza.
In giro ci sono tre combinazioni.
512n: 512 nativo. Entrambe le dimensioni sono 512 byte. È il vecchio mondo: dischi rigidi di prima del 2010, e niente che compreresti nuovo oggi in una capacità che valga la pena avere.
512e: emulazione a 512 byte. Il settore fisico è di 4096 byte, ma il disco dichiara blocchi logici da 512 byte e traduce nel firmware. Esiste per un solo motivo: la compatibilità con sistemi operativi, bootloader e applicazioni che davano per scontato 512 per sempre. Come ingegneria è abbastanza sensato, ed è la radice di quasi tutti i problemi che seguono.
4Kn: 4K nativo. Entrambe le dimensioni sono 4096 byte. Il disco dice la verità, l’host lo indirizza nell’unità che il supporto usa, e in mezzo non c’è alcuno strato di traduzione.
Che cosa fa il 512e a ogni scrittura non allineata
Una lettura costa poco in tutti e tre i casi. Il disco legge il settore da 4K e restituisce la fetta da 512 byte che hai chiesto.
È nelle scritture che la finzione diventa cara.
Se l’host scrive un singolo blocco logico da 512 byte, il disco non può scrivere 512 byte. Il supporto non ha un’unità del genere. Così fa invece questo:
- Legge l’intero settore fisico da 4096 byte.
- Ci fonde dentro i 512 byte di dati nuovi.
- Riscrive l’intero settore da 4096 byte.
Questo è un read-modify-write, e trasforma una piccola scrittura in una lettura più una scrittura. Su un disco rotante significa aspettare che il piatto faccia un altro giro. Una rotazione completa a 7.200 rpm vale circa 8 ms che non avevi messo in conto. Sulla flash il costo è di natura diversa, e non sparisce quando la scrittura finisce. Quello ha una sezione tutta sua più sotto.
Il disallineamento è la versione che morde più forte. Se una partizione inizia a un offset dispari di 512 byte (il caso classico è la vecchia convenzione dei 63 settori), allora ogni scrittura da 4K del filesystem scavalca due settori fisici. Non è un read-modify-write, sono due, a ogni singola scrittura, per sempre, finché qualcuno non ripartiziona il disco.
La write amplification sulla flash
Su un disco rigido il read-modify-write ti costa un giro di piatto e poi è finita. Sulla flash ti costa vita del disco, e quello è un conto che paghi una volta e continui a pagare.
La write amplification è il rapporto tra quanto è stato effettivamente scritto sulla NAND e quanto l’host ha chiesto di scrivere. Un rapporto di 1,0 vorrebbe dire che il disco ha scritto esattamente ciò che gli è stato dato. Non è mai 1,0, perché la flash non può sovrascrivere sul posto: il disco programma una pagina nuova, marca la vecchia come obsoleta, e più tardi la garbage collection sposta le pagine ancora valide così che un intero blocco possa essere cancellato. Anche quegli spostamenti sono scritture.
Il 512e ci aggiunge sopra uno strato evitabile, e il motivo è un dettaglio che vale la pena dire chiaramente: lo strato di traduzione del disco mappa in unità di circa 4 KB, qualunque dimensione di blocco logico dichiari. Un disco che dichiara blocchi da 512 byte continua a tenere traccia internamente di unità da 4 KB.
Così una scrittura da 512 byte dall’host diventa, dentro il disco: leggi l’unità di mappatura da 4 KB, fondi i 512 byte, programma una nuova unità da 4 KB. 4096 byte arrivano sulla NAND perché ne cambino 512. Otto volte la scrittura, per quella scrittura.
Il disallineamento è meno drammatico per singola scrittura e peggiore in totale. Una scrittura da 4 KB che scavalca due unità di mappatura le sporca entrambe, quindi vengono programmati 8 KB per 4 KB di dati. Sono 2× di amplificazione su ogni singola scrittura, in modo permanente, finché la tabella delle partizioni non viene sistemata.
Sono gli effetti a catena che rendono la cosa importante, e non solo disordinata:
- Più scritture sulla NAND significano che la garbage collection gira più spesso, e i suoi spostamenti sono a loro volta amplificazione.
- La cache di scrittura SLC si riempie prima, quindi il disco scende prima al suo stato stazionario più lento e il throughput di scrittura sostenuto cala.
- I cicli di programmazione/cancellazione si consumano in proporzione a ciò che ha raggiunto la NAND, non a ciò che l’host ha mandato. Raddoppia l’amplificazione e hai dimezzato la vita del disco a parità di carico.
- I valori di endurance (TBW, DWPD) sono dichiarati rispetto alle scritture dell’host. L’amplificazione si mangia quel margine in silenzio, e il disco si consuma prima dei conti sulla garanzia che hai fatto al momento dell’acquisto.
Le scritture dirette e sincrone sono il caso peggiore
La maggior parte del tempo la page cache nasconde tutto questo. Il kernel accumula le piccole scritture, le unisce e manda al disco I/O da 4 KB o più grandi, così il read-modify-write non avviene mai.
Due flag tolgono questa protezione, e le applicazioni a cui importa la durabilità li impostano entrambi.
O_DIRECT scavalca la page cache.
Ora tra l’applicazione e il disco non c’è più niente che possa raccogliere una scrittura da 512 byte in qualcosa della dimensione di un settore.
O_SYNC o O_DSYNC richiede che la scrittura sia su un supporto stabile prima che la chiamata ritorni.
Questo impedisce al disco di assorbire la scrittura in un buffer volatile e di combinarla più tardi con quelle vicine.
Mettili insieme e ogni scrittura da 512 byte è un ciclo completo di read-modify-write che deve finire adesso, da solo, senza nulla con cui ammortizzarlo. È lì che l’amplificazione su un disco 512e si avvicina al suo 8× teorico, ed è esattamente lo schema che producono il commit log di un database, lo ZIL di ZFS o il WAL di Ceph BlueStore.
La protezione da perdita di alimentazione è ciò che salva la situazione sull’hardware enterprise. Un disco con PLP può confermare una scrittura sincrona appena è in un buffer DRAM protetto da condensatori, che è durevole, e continuare a combinare internamente prima di programmare la NAND. Un disco consumer senza PLP deve raggiungere la flash prima di poter rispondere, quindi paga il costo pieno a ogni scrittura. Un motivo in più per cui la PLP non è opzionale per questo tipo di carico.
In Proxmox è la modalità di cache a decidere quale dei due casi ottieni:
cache=noneèO_DIRECT: il default di PVE, e la scelta giusta per l’HA all-flash. La page cache dell’host è fuori dal percorso, quindi gli schemi di scrittura del guest arrivano al disco così come il guest li ha emessi.cache=directsyncèO_DIRECTpiùO_DSYNC: ogni scrittura è sincrona. È un’impostazione di nicchia per dischi dedicati ai log dei database, e inutilizzabile per i carichi generici.
Su un dispositivo 512e, cache=directsync con un guest che fa commit in record da 512 byte è più o meno la disposizione meno efficiente disponibile: niente aggregazione nell’host, niente aggregazione nel disco, e un read-modify-write per ogni commit.
Ed ecco la parte che rende il 4Kn strutturale, e non soltanto preferibile.
O_DIRECT richiede che offset, lunghezza e buffer siano allineati alla dimensione del blocco logico del disco.
Su un disco 512e quella è 512 byte, quindi una scrittura diretta da 512 byte è lecita e il disco la paga in silenzio.
Sul 4Kn il blocco logico è 4096, quindi la scrittura diretta più piccola che il kernel accetta è di 4 KB.
Lo schema patologico smette di essere qualcosa da evitare e diventa qualcosa che lo stack non riesce nemmeno a esprimere.
Overhead sul supporto
Il secondo costo è strutturale, ed è il motivo per cui l’Advanced Format esiste.
Un settore non è soltanto i suoi dati. Su un disco rigido ognuno porta un sync mark perché la testina sappia dove inizia il settore, un gap perché settori consecutivi non si sovrappongano, un address marker e un campo ECC per correggere gli errori di lettura.
Con settori da 512 byte paghi tutto questo otto volte per ogni 4K di dati. Con un solo settore da 4K lo paghi una volta.
Ci sono due conseguenze, e la seconda conta più della prima:
- Una parte del piatto che era overhead diventa capacità utilizzabile. Durante la transizione all’Advanced Format era questa la motivazione dichiarata dall’industria, nell’ordine di pochi punti percentuali.
- Il campo ECC può essere molto più grande a parità di overhead totale. Un solo codice robusto che protegge 4096 byte corregge molto più di otto codici deboli che ne proteggono 512 ciascuno. Con la crescita della densità superficiale, questo ha smesso di essere un vezzo ed è diventato l’unico modo di tenere i tassi di errore accettabili.
La flash non ha sync mark né gap di rotazione, ma la stessa logica si applica un livello più su: la NAND si programma in pagine, le pagine sono molto più grandi di 512 byte, e le tabelle di mappatura del disco hanno una voce per ogni unità indirizzabile. Blocchi logici più piccoli significano più metadati per tenere traccia della stessa capacità.
Overhead nell’host: comandi e interrupt
Il terzo costo è quello che sfugge, perché non sta affatto sul disco.
La dimensione del blocco logico fissa il minimo di quanto può essere piccolo un I/O. Su un disco con blocco logico da 512 byte, un filesystem o un’applicazione è libero di emettere una scrittura da 512 byte, e ognuna è un I/O completo: un comando costruito e inviato, una scrittura sul doorbell, una voce nella completion queue e un interrupt per dire che ha finito.
Ognuno di questi passaggi ha un costo fisso che non dipende da quanti dati c’erano. Sposta 4 KB come otto comandi da 512 byte e paghi quel costo otto volte. Spostali come un solo comando da 4K e lo paghi una volta.
Due precisazioni oneste, perché è qui che l’argomento di solito viene gonfiato.
Per gli I/O grandi, la dimensione del blocco logico non cambia nulla nel numero di comandi. Un solo comando può descrivere molti blocchi, quindi una scrittura sequenziale da 1 MB è un comando, che i blocchi siano da 512 byte o da 4K. Il risparmio è reale solo dove si emettono I/O piccoli.
Dove invece si emettono I/O piccoli, l’effetto non è affatto sottile: ognuna di quelle otto richieste è una che il kernel deve costruire, schedulare e completare, ciascuna con il proprio interrupt MSI-X e la propria transizione da user a kernel, e ad alte queue depth è così che ti ritrovi con una tempesta di interrupt. Dentro una VM è ancora peggio, perché ognuno di quegli interrupt è anche un cambio di contesto del guest.
E i controller NVMe moderni aggregano gli interrupt, quindi il numero di interrupt non coincide semplicemente con il numero di comandi. Il lavoro di invio e completamento per comando resta, però, e a qualche centinaio di migliaia di IOPS il costo di CPU per comando è una frazione misurabile di un core. È la stessa aritmetica dei posted interrupt nella serie sul passthrough: piccoli costi fissi moltiplicati per un numero molto grande.
4Kn, metadati di settore e RAID hardware
Passare a un formato 4096 + 0 ha una conseguenza che coglie molti di sorpresa, e cade in pieno sul RAID hardware.
Alcuni controller RAID e storage array non usano affatto settori semplici da 512 o 4096 byte. Formattano i dischi a una dimensione estesa (520 o 528 byte, o gli equivalenti 4K come 4104, 4160 e 4224) perché quei byte in più per settore sono dove il controller tiene i propri metadati. Sono le protection information T10-PI/DIF, o dati di integrità del vendor, memorizzati in linea con i dati stessi che descrivono.
Un formato 4096 + 0 non ha dove metterli. Il settore è tutto dati, da cima a fondo, ed è proprio questo il motivo per sceglierlo.
Quindi un controller che vuole metadati in linea ha tre opzioni, e nessuna è gratis:
- Rifiutare il disco.
- Riformattarlo in un formato esteso, disfacendo il lavoro sul 4Kn appena fatto.
- Tenere i propri metadati da qualche altra parte sul disco.
La terza è quella in cui la flash ti punisce. Metadati scritti separatamente dai dati che descrivono sono una seconda scrittura, a un offset diverso, che finisce in un’unità di mappatura diversa. Un’altra pagina NAND programmata per ognuna che intendevi davvero scrivere. È l’amplificazione della sezione precedente, reintrodotta deliberatamente, per trasportare metadati di integrità che il disco avrebbe potuto tenere in linea per niente se l’avessi lasciato in un formato esteso.
Non puoi avere entrambe le cose. O il settore porta i metadati del controller, o porta solo i tuoi dati.
Ed è per questo che la flash ha parecchio indebolito le ragioni del RAID hardware
Il resto è un giudizio più che un meccanismo, quindi prendilo come tale.
Un controller RAID hardware è RAID firmware che gira su un processore dedicato. L’«hardware» è una CPU, un po’ di DRAM e una batteria. Non un modo fondamentalmente diverso di calcolare la parità. Quello che storicamente ti comprava era una cache di scrittura protetta da batteria e lo scarico del calcolo di parità, e sulla flash entrambi gli argomenti si sono indeboliti parecchio. Gli NVMe enterprise hanno già una propria cache protetta da perdita di alimentazione, e il controller diventa un tetto di banda davanti a dispositivi che da soli possono saturare diversi gigabyte al secondo.
Ti costa anche cose che adesso vuoi attivamente:
- Lo stato del dispositivo sparisce. I dettagli SMART, gli indicatori di usura e i log del vendor che ti permettono di calcolare la write amplification stanno tutti dietro un’astrazione opaca.
- Nessun checksum end-to-end. Un controller verifica la parità, che rileva un disco mancante, non una risposta sbagliata da uno presente. ZFS e Ceph fanno il checksum dei dati stessi e sanno dirti quale copia è sbagliata: corruzione silenziosa che un controller lascia passare dritta. Per questo il controller sta risolvendo il problema sbagliato.
- I metadati del vendor sui dischi legano l’array a una famiglia di controller, il che è un tipo di inaffidabilità tutto suo quando è proprio il controller a guastarsi.
- Il RAID a parità fa il proprio read-modify-write sulle scritture a stripe parziale, che si somma a tutto quanto visto nelle sezioni precedenti.
Per Ceph non è nemmeno una preferenza. Le indicazioni di Proxmox stesso sull’iperconvergenza dicono che i dischi vanno presentati in modalità HBA o pass-through, non dietro un controller RAID, e ZFS vuole esattamente la stessa cosa per gli stessi motivi.
Quindi la disposizione che segue da tutto questo è: un HBA al posto di un controller RAID, dischi formattati 4Kn con zero metadati, e ridondanza più checksum affidati a ZFS o Ceph, che sanno davvero dirti quando un disco ha mentito. Se qualcosa nel tuo parco ha davvero bisogno di un formato di settore esteso, è un aut-aut deliberato da decidere finché i dischi sono ancora vuoti. Non qualcosa da scoprire dopo aver costruito gli OSD.
Dove il 512e morde davvero
Sarebbe disonesto sostenere che il 512e rovini un sistema moderno, perché di solito non lo fa.
Uno stack Linux attuale legge la dimensione del settore fisico, allinea le partizioni a quella (parted e sfdisk lo fanno entrambi di default, ormai) e usa blocchi di filesystem da 4K.
In quella configurazione l’host emette I/O da 4K allineati a 4K, il disco non ha mai bisogno di un read-modify-write, e il 512e ti costa quasi niente.
I problemi sono specifici:
- Partizioni disallineate, di solito ereditate da una vecchia installazione o da un’immagine clonata. Due read-modify-write a ogni scrittura.
- ZFS con
ashift=9su un disco 512e, perché ZFS ha creduto al 512 dichiarato. Ogni scrittura di record diventa un read-modify-write, eashiftnon si può cambiare a posteriori: il pool va ricostruito. - Applicazioni che scrivono record da 512 byte con O_DIRECT, scavalcando l’aggregazione della page cache. Alcuni database e molto software su misura fanno così.
- Tutto ciò che si fida che la dimensione logica sia quella reale. È questo il danno vero dell’emulazione: distribuisce un numero sbagliato, e ciò che sta a valle prende decisioni basandosi su quello.
Il 4Kn elimina l’intera categoria. Il disco non può mentire su una dimensione di settore che non ha.
Vale però la pena essere chiari sull’entità del premio. Le indicazioni di Seagate stessa dicono che il 4Kn vale chiaramente la pena quando lo stack è completamente ottimizzato per il 4K e stai contando ogni IOPS: un tier all-flash ben regolato, per esempio. Sotto quel livello, su un Linux moderno correttamente allineato, la differenza di prestazioni per gli I/O allineati è spesso piccola. L’altro argomento è la coerenza del parco: un parco uniformemente 4Kn non ha sorprese di formati misti, e nessuno deve ricordarsi quali dischi mentono.
La maggior parte dei dischi si può convertire, se il vendor lo permette
Questa è la parte che sfugge: il 512e è spesso un’impostazione di formato, non una proprietà dell’hardware. Moltissimi dischi enterprise SAS e SATA, e la maggior parte degli NVMe enterprise, escono di fabbrica dichiarando 512 byte e si riformattano volentieri a 4Kn.
Tutto quanto segue distrugge ogni singolo byte sul dispositivo. Non esiste una conversione sul posto.
NVMe: nvme-cli
Prima guarda che cosa supporta il namespace:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Vuoi un formato con Data Size 4096 e Metadata Size 0, marcato come best e non attualmente in uso. Poi applicalo:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
La dimensione dei metadati conta quanto quella dei dati. Alcuni formati di fabbrica riservano byte in più per settore (520, o 4160) per trasportare metadati di protezione end-to-end T10-PI/DIF. Se nel tuo stack niente li usa, sono imbottitura su ogni settore, quindi scegli il formato con zero metadati e liberatene. Scegliere per sbaglio un formato con metadati ti dà anche un disco che si comporta diversamente da quello che volevi creare, e combinare un cambio di dimensione del settore con un cambio di PI può costringere a un formato completo lento invece di uno veloce.
Per tutti i dischi di un host, mettilo in un ciclo. Serve shopt -s extglob per i glob estesi, e seleziona solo i formati che sono 4096/0 e non in uso:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Due cose lì dentro fanno più lavoro di quanto sembri.
Il glob corrisponde ai namespace (nvme0n1, nvme12n3) e volutamente non corrisponde a partizioni come nvme0n1p1, perché lo schema finisce dopo le cifre che seguono la n. È la differenza tra riformattare un namespace e fare qualcosa di irrecuperabile a un sistema in funzione.
E la selezione converte soltanto un disco che offre davvero ciò che hai chiesto. Tutto il resto ricade su -1 e viene saltato, il che copre tre casi distinti:
- Il disco offre solo 512. Non esiste un formato da 4096 byte, quindi non c’è niente in cui convertirlo e il ciclo lo lascia stare. Non ci prova, e non fallisce a metà.
- Il disco è già 4Kn. Il formato 4096/0 è quello in uso, e
(?!.*in use)lo esclude: quindi un secondo passaggio sullo stesso host non fa nulla. Nessuna riformattazione inutile di ogni disco. - Gli unici formati 4096 portano metadati. Un formato 4096 + 8 non soddisfa
Metadata Size: 0, quindi il ciclo non ti rifila di nascosto un disco T10-PI che non avevi chiesto.
In altre parole fallisce in modo chiuso. Quando non è sicuro, salta.
Una nota di portabilità: quei lookahead richiedono la modalità -P (PCRE) del grep GNU. Su un sistema dove grep è qualcos’altro, lo schema non corrisponde a niente e ogni disco viene saltato. Fastidioso, ma almeno sbaglia nella direzione sicura.
Leggi comunque il ciclo prima di lanciarlo.
Dove trova una corrispondenza, riformatta senza chiedere altro. nvme format --force non chiede due volte.
Il suo posto è nel provisioning, su una macchina i cui dischi non contengono niente, mai su un host con un OSD, un pool o un disco di VM attivo.
Su FreeBSD l’equivalente è nvmecontrol, dove -f è l’indice del formato:
nvmecontrol format -f 1 nvme0ns1
SAS e SATA: openSeaChest
openSeaChest di Seagate è multipiattaforma, open source, e funziona anche sui dischi di altri vendor.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Quella frase di conferma non è una mia esagerazione. È la stringa letterale che lo strumento richiede, e la parte «may render the drive inoperable» è vera. Un formato a basso livello interrotto da un blackout può lasciare un disco che ha bisogno di un altro formato prima di funzionare di nuovo.
Sotto il cofano l’operazione cambia a seconda del trasporto: SAS e SCSI usano Format Unit, SATA usa Set Sector Configuration Ext (il percorso di formato veloce) e NVMe usa NVM Format. Per un disco SAS puoi usare direttamente Format Unit, e nota che questa opzione richiede la stringa di conferma più corta:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Due opzioni diverse, due stringhe di conferma diverse: se le inverti, lo strumento rifiuta.
Dove il disco supporta un formato veloce, la dimensione del settore cambia in secondi invece che in ore; il disco poi fa il suo lavoro di integrità e in background, e scriverci sopra i tuoi dati veri riduce quel tempo in background. Un formato completo scrive zeri da un capo all’altro e su un grosso disco rotante può richiedere da molte ore a giorni.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI: sg_format
Per qualunque cosa parli SCSI, sg3_utils fa lo stesso lavoro:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format ti dà un conto alla rovescia di 15 secondi prima di procedere, che --quick salta.
La sua documentazione avverte anche di un guasto specifico che vale la pena conoscere: se il cambio di dimensione del blocco riesce ma poi il formato fallisce, il disco può finire in uno stato «format corrupt» e ha bisogno di un altro formato per riprendersi.
Prima di convertire qualsiasi cosa
- Controlla il percorso di avvio. Un disco 4Kn come dispositivo di avvio richiede UEFI e un sistema operativo che lo supporti. Il Linux moderno va bene. Le versioni più vecchie di Windows no, e alcuni controller RAID hardware rifiutano ancora del tutto il 4Kn.
- Fallo prima che il disco contenga qualcosa. Farlo a posteriori significa svuotare, convertire, ripristinare.
- Fanne uno, poi controlla. Converti un solo disco, verifica le dimensioni dichiarate, poi fai gli altri.
- Aspettati ore su un disco rotante senza formato veloce. Non avviare un formato a basso livello su una macchina che ti serve di nuovo a breve.
Controllare che cosa hai
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical è un disco 512e.
Numeri uguali significano nativo: 512n se sono entrambi 512, 4Kn se sono entrambi 4096.
E controlla che le partizioni siano davvero allineate:
parted /dev/sda align-check optimal 1
ZFS, Ceph e dischi virtuali
ZFS: imposta ashift=12 esplicitamente quando crei un pool, e non fidarti della dimensione dichiarata dal disco, perché su un 512e ti dirà 9 e sbaglierà. Non si può cambiare dopo.
Ceph: la dimensione minima di allocazione di BlueStore dovrebbe essere 4 KB sulla flash. Il Ceph moderno ha 4096 di default, ma le build più vecchie avevano default più alti (circa 16 KB su SSD e 64 KB su HDD), e questo si adatta male ai dischi di VM su RBD, perché emettono molte piccole scritture casuali da 4 KB, e una scrittura da 4 KB che finisce in un’unità di allocazione da 16 o 64 KB amplifica la scrittura e spreca il resto in imbottitura. Viene fissata alla creazione dell’OSD, quindi va impostata prima di creare o ricostruire:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Esiste un corrispondente bluestore_min_alloc_size_hdd. Gli OSD esistenti tengono ciò con cui sono stati costruiti, quindi cambiarlo significa ricostruirli.
Dischi virtuali: un guest vede ciò che l’hypervisor presenta, non il disco sottostante, quindi un disco 4Kn sotto una VM passa comunque al guest blocchi da 512 byte, a meno che tu non dica altrimenti. Tenere lo stack a 4K da cima a fondo significa dire a QEMU di presentare 4K, che in Proxmox è una riga di argomenti grezzi in /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
È quella riga a forzare davvero QEMU sul 4Kn per quei dischi: -global la applica a ogni dispositivo scsi-hd della VM, così al guest viene detto 4096 sia per il blocco logico sia per quello fisico, e partiziona e allinea di conseguenza.
Non mettere tra virgolette l’intera stringa. Proxmox interpreta args: con Text::ParseWords::shellwords, quindi questo:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
collassa in un unico argomento: le virgolette vengono rispettate e tolte, e QEMU riceve un’unica lunga opzione non interpretabile invece di quattro. Senza virgolette, la stessa riga si divide in -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, che è ciò che vuoi. È un errore facile da fare perché mettere le virgolette è l’istinto giusto su una riga di comando, e il guasto (una VM che non si avvia, lamentandosi dell’opzione) non riconduce alle virgolette.
Fallo prima di installare il sistema operativo del guest. Cambiare la dimensione del blocco di un disco sotto un sistema già installato può lasciarlo non avviabile, perché il layout delle partizioni e il bootloader sono stati scritti per settori da 512 byte. Nota anche che args: è una via di fuga per esperti, fuori dalla gestione della GUI, e l’interazione con la migrazione a caldo e gli snapshot va ricontrollata con la documentazione attuale di Proxmox.
Quando il guest dice 512 e l’host dice 4K
Questo è il caso che vale la pena capire bene, perché è ciò che ottieni di default dopo aver fatto tutto il lavoro qui sopra.
QEMU presenta al guest blocchi logici da 512 byte se non gli si dice altrimenti, qualunque sia il dispositivo sottostante. Quindi puoi convertire a 4Kn ogni disco dell’host, e alle VM sopra verrà comunque detto 512, e ci crederanno.
Il guest allora partiziona su confini di 512 byte perché può, ed emette I/O da 512 byte perché può. Ma il dispositivo dell’host adesso ha davvero un blocco logico da 4096 byte, e non accetterà una scrittura da 512 byte. Qualcosa deve riconciliare le due cose, e quel qualcosa è l’host: QEMU legge i 4 KB circostanti, ci fonde i 512 byte del guest e riscrive il tutto.
Non hai eliminato l’emulazione. L’hai spostata dal firmware del disco al tuo hypervisor, dove costa CPU dell’host e un bounce buffer invece di cicli del disco.
Con cache=none non è nemmeno una penalità leggera. O_DIRECT su un dispositivo 4Kn richiede offset e lunghezze allineati a 4 KB, quindi una scrittura del guest sotto i 4K non può semplicemente passare: l’allineamento deve essere sistemato in QEMU prima ancora che l’I/O venga emesso.
E il caso del disallineamento ritorna uno strato più su. Un guest partizionato con granularità di 512 byte mette le sue scritture di filesystem da 4 KB a offset che scavalcano due blocchi da 4 KB dell’host, quindi ognuna diventa due read-modify-write sull’host. Lo stesso guasto di una partizione disallineata su un disco 512e nudo, solo che adesso avviene dentro una VM dove nessuno lo sta cercando.
Quindi la regola è: se l’host è 4Kn, presenta 4K anche al guest, e fallo prima che ci vada sopra il sistema operativo.
L’eccezione è il supporto del guest, che è il motivo stesso per cui il 512e esiste:
- I guest Linux gestiscono il 4Kn senza storie.
- Windows supporta il 4Kn per i volumi di dati da Windows 8 e Server 2012 in poi, e l’avvio da 4Kn richiede UEFI.
- Qualunque cosa più vecchia (Windows 7 e precedenti) non può fare il 4Kn per niente. Per quelli, un disco virtuale che presenta 512 è il prezzo per farli girare, e l’host farà la riconciliazione. Se la cosa conta, tieni quei guest su uno storage dove ti costa meno, invece che sul tuo tier più veloce.
Controlla che cosa ha davvero ottenuto il guest, da dentro il guest:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 lì su un host 4Kn significa che la riconciliazione descritta sopra sta avvenendo a ogni scrittura non allineata.
Riferimenti
- OpenZFS — Workload Tuning —
ashift, perché2^ashiftè il più piccolo I/O possibile su un vdev, e l’osservazione che «many devices misreport their sector sizes» nvme-formatman page —--lbaf,--namespace-id,--sese--forcesg_formatman page —--sizecon--format, l’opzione di formato veloce e l’avvertimento sul format-corrupt- openSeaChest — le utility open source di Seagate per i dischi, comprese
--setSectorSizee--showSupportedFormats - openSeaChest wiki — Format, Fast Format, And Sector Sizes — quale trasporto usa quale comando, e quando si applica il formato veloce
nvmecontrol(8)— l’equivalente su FreeBSD- Linux block layer documentation — come il kernel modella le dimensioni dei blocchi logici e fisici