Tutto quello che c’è in questo articolo è stato eseguito su un NetBox 4.7.2 sulla mia scrivania, con un parco reale caricato dentro: un sito, un armadio, quattordici apparati, cablati, alimentati e indirizzati tra tre clienti. Ogni schermata è quell’istanza, e ogni messaggio di errore è uno che ho ricevuto davvero.
Va nell’ordine in cui lo incontreresti. Cos’è la cosa, perché ne vorresti una, il fork di cui sentirai parlare entro una settimana di ricerche, come metterne in piedi uno, l’ordine in cui devi riempirlo, e poi cosa ne ricavi. Il lavoro di personalizzazione ed estensione sta alla fine, perché niente di quello ha senso finché non hai visto la forma di ciò che stai estendendo.
Cos’è NetBox
NetBox è un database con un’opinione molto precisa su cosa compone una rete, e un’applicazione web sopra. È un’applicazione Django su PostgreSQL, è open source sotto Apache 2.0 da quando DigitalOcean l’ha pubblicata nel giugno 2016, e oggi il progetto è curato da NetBox Labs insieme a un gruppo di maintainer volontari.12
Sotto ci sono 149 modelli divisi in dieci applicazioni, raggiungibili tramite 146 endpoint REST e un endpoint GraphQL. Contati sull’istanza che ho costruito per questo, non letti da una pagina di funzionalità:
| Applicazione | Modelli | Applicazione | Modelli |
|---|---|---|---|
| dcim | 56 | virtualization | 7 |
| extras | 23 | tenancy | 6 |
| ipam | 18 | wireless | 3 |
| circuits | 11 | users | 7 |
| vpn | 10 | core | 8 |
Cinquantasei sono DCIM, il livello fisico: siti, location, rack, device type, apparati, e ogni tipo di porta, alloggiamento e terminazione di cavo che un apparato può avere. Diciotto sono IPAM. Il resto copre circuiti, tunnel e policy IKE, macchine virtuali e cluster, link wireless, tenancy, e i meccanismi che rendono tutto estendibile.
Il conteggio non è il punto. Lo sono i join, e il modo più rapido per vederlo è la schermata per cui NetBox è più conosciuto.
Parti dall’armadio, perché è la schermata che vende la cosa.
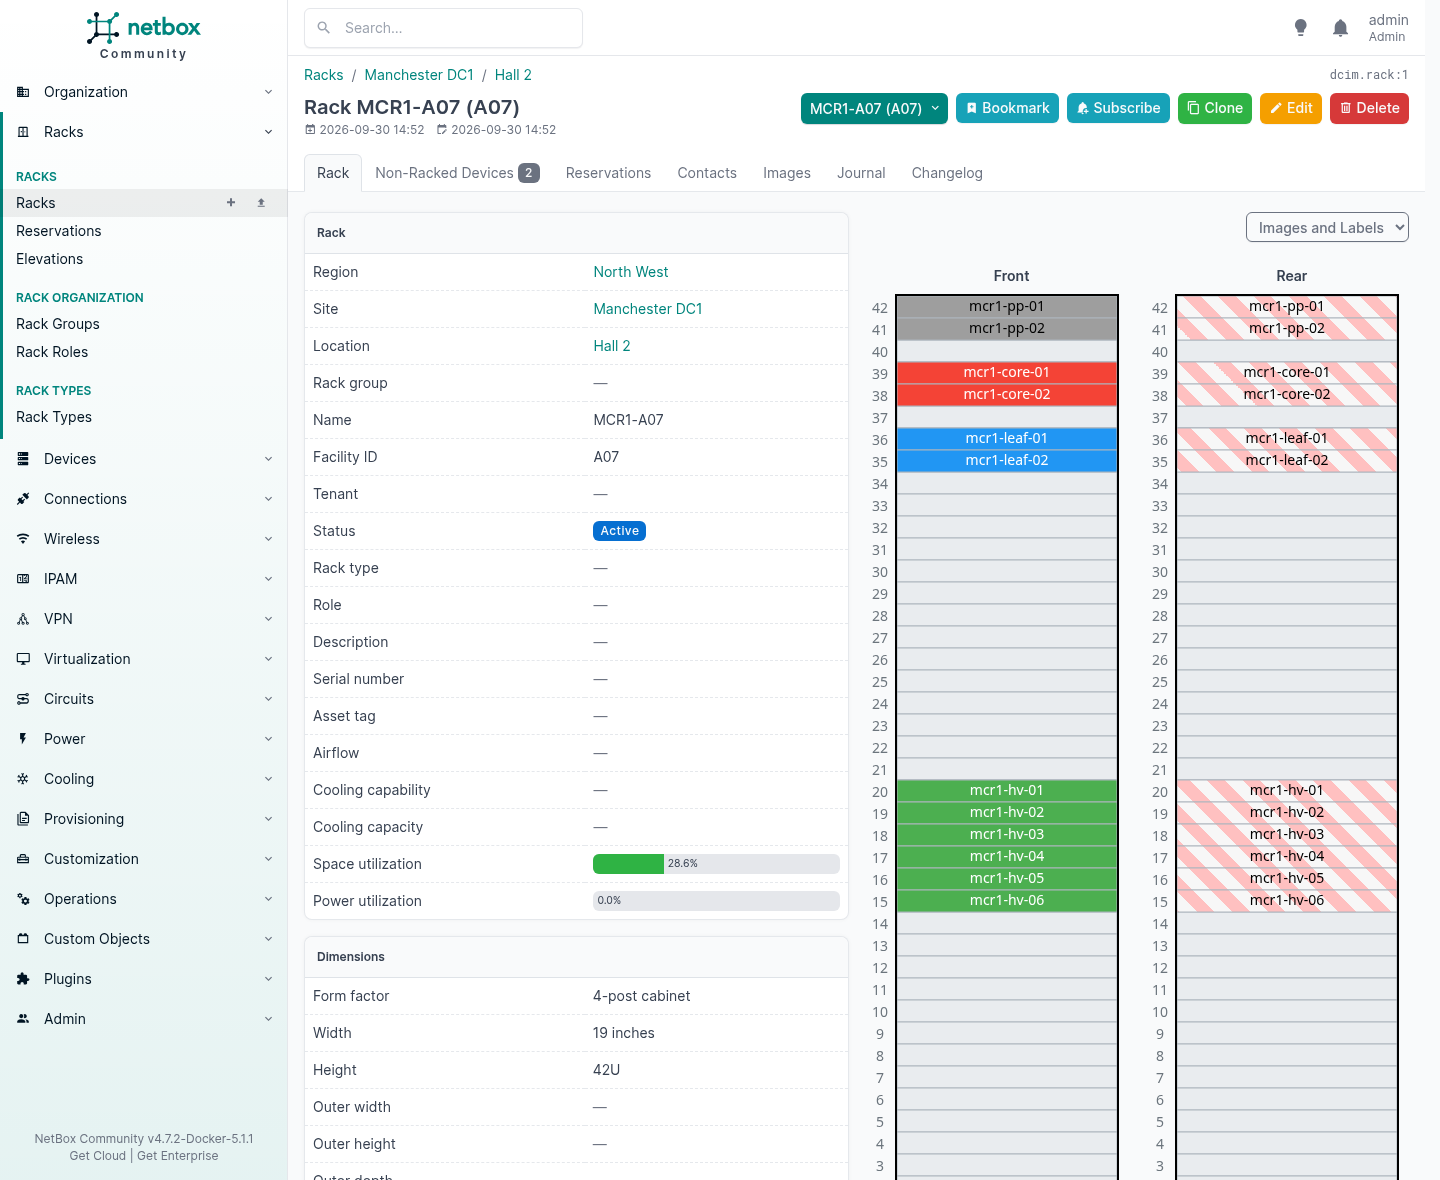
Quell’elevazione è disegnata dai dati, non caricata. Ogni apparato è lì perché qualcosa dice che occupa quelle unità rack, rivolto in quel verso, e i colori vengono dal ruolo che gli hai dato. L’occupazione dello spazio indica 28,6% perché l’ha calcolata NetBox. Nessuno mantiene quel numero.
Ne seguono due cose che valgono più dell’immagine.
Puoi chiedere quali unità sono libere, e avere una risposta su cui agire. Puoi anche prenotare unità prima che ci sia installato qualcosa, che è la differenza tra vendere lo spazio che hai e vendere lo spazio che pensi di avere.
Cosa si rifiuta deliberatamente di fare
Un prodotto che sa cosa non è risulta più raro di uno che fa tutto male, e la documentazione di NetBox è schietta in merito. Non fornisce monitoraggio di rete, servizio DNS, RADIUS, gestione della configurazione o gestione delle strutture.1
Più importante ancora, contiene lo stato desiderato della tua rete, non il suo stato operativo, e la documentazione dice che l’importazione automatica dello stato reale della rete è «strongly discouraged», perché ogni record dovrebbe prima essere verificato da una persona.1
È la decisione su cui poggia tutto il resto, ed è quella con cui la gente discute. L’argomento è: una fonte di verità dovrebbe pure essere la verità, quindi scopri la rete e caricala. La risposta è che una rete scoperta ti dice cosa c’è, e quello che c’è include ogni errore che chiunque abbia mai fatto. Una porta di switch lasciata nella VLAN sbagliata nel 2021 è un fatto. Non è un’intenzione.
NetBox contiene l’intenzione. Il tuo monitoraggio contiene la realtà. Il numero interessante è la differenza tra le due, e non puoi calcolare una differenza da un solo dato.
L’altro principio è dichiarato con la stessa chiarezza: potendo scegliere tra una soluzione relativamente semplice all’ottanta per cento e una completa molto più complessa, prendi quella semplice.1 Lo sentirai la prima volta che vorrai modellare qualcosa che non modella, e verso la fine c’è un’intera serie di sezioni su cosa fare quando ci sbatti contro.
| NetBox fa | NetBox non fa |
|---|---|
| Registra cosa dovrebbe esserci | Interroga cosa c’è |
| Contiene la VLAN prevista per una porta | Ti dice che la porta è giù |
| Dice a quale cliente appartiene un prefisso | Glielo fattura |
| Genera la configurazione di un apparato da un template | La spinge sull’apparato |
| Traccia il circuito, il fornitore e l’impegno contrattuale | Monitora il circuito |
| Dice in quale rack sta un apparato, e in quale U | Apre l’armadio |
Leggi quella colonna di destra come un elenco di strumenti che ti servono ancora. Leggila male e proverai a far diventare NetBox tutti quanti, ed è così che una fonte di verità diventa un altro sistema di cui nessuno si fida.
Perché te ne serve uno
Chiedi a un managed service provider dove sta il registro autorevole della rete di un cliente, e avrai una risposta. Chiedilo separatamente a due dei suoi tecnici e ne avrai due.
Uno indicherà un foglio di calcolo. Uno indicherà un diagramma salvato l’ultima volta da qualcuno che se n’è andato nel 2023. Qualcun altro dirà che la documentazione è la configurazione del firewall, il che almeno è onesto, perché una configurazione descrive davvero cosa sta facendo un apparato. Solo che non descrive perché, né chi l’ha chiesto, né quale dei quattro clienti dietro quell’apparato paga per quella regola.
Il guasto non è mai il giorno in cui ti accorgi che il registro è sbagliato. È il giorno in cui a qualcuno serve.
| Il momento | Cosa devi produrre | Quanto costa quando non ci riesci |
|---|---|---|
| Una trattativa di rinnovo | Un conto dettagliato di cosa compra il canone mensile | Il preventivo del concorrente è dettagliato, perché lui è andato a contare |
| Un tecnico dà le dimissioni | Tutto quello che sapeva, messo per iscritto | Sei mesi a scoprirlo, un ticket alla volta |
| Un cliente se ne va | Una descrizione del suo parco | Tre settimane per metterla insieme, e una referenza che darà onestamente |
| Un auditor fa una domanda sul perimetro | Quali sistemi contengono dati personali, e dove si trovano fisicamente | A un regolatore viene detto qualcosa che poi si rivela falso |
| Una migrazione va quotata | Un conteggio di cosa c’è davvero | Fai un’offerta su una stima e ti mangi la differenza |
Niente di tutto questo è esotico. È un martedì qualunque.
Quello che ne ricavi non è documentazione. La documentazione è una cosa che scrivi e poi smetti di mantenere. Quello che ricavi è un database che si rifiuta di contenere una contraddizione, e che risponde a domande che nessuno aveva pensato di fargli in anticipo. Più avanti in questo articolo c’è un armadio che risulta pieno al 28,6 per cento di apparati e al 90,7 per cento di potenza. Nessuno era partito per scoprirlo. È saltato fuori inserendo una volta un wattaggio su un device type.
Insieme arriva l’avvertenza onesta, e l’ultima sezione parla di quello. Un registro vale solo quanto ti costa tenerlo giusto. Ma l’alternativa è un’azienda che non sa descrivere sé stessa, e il primo a scoprirlo di solito è un cliente.
L’altro: Nautobot
Ci sbatterai contro entro circa una settimana di ricerche, quindi vale la pena sapere cosa è successo.
Nel 2021 Network to Code ha fatto un fork di NetBox e ha chiamato il risultato Nautobot. Non un fork morbido né una distribuzione: un hard fork che diverge da cinque anni. Le sue stesse note di rilascio v1.0 lo descrivono come «a divergent fork of NetBox 2.10», il repository è stato creato il 19 febbraio 2021 e la v1.0.0 è uscita il 26 aprile 2021.3
Le ragioni dichiarate stanno sul loro blog e vale la pena leggerle con le loro parole piuttosto che con le mie. Tre cose l’hanno spinto. Volevano vendere supporto enterprise: «We need to offer high-touch support models with Service Level Agreements (SLAs) we can guarantee. We need flexibility to offer Long-term Support (LTS) for customers who can’t upgrade at the pace of a fast moving open source project.» Volevano che la fonte di verità stesse al centro di una piattaforma di automazione invece di servire da documentazione. E «there became a growing divergence in our vision about what a Source of Truth for networking should look like and how to get there».4
Quella prima ragione ha bisogno della sua data, perché ha smesso di essere vera. Nel febbraio 2021 non c’era nessuna azienda dietro NetBox che potesse venderti qualcosa. NetBox Labs è stata fondata solo nel 2023, nata da NS1 dopo che IBM l’aveva acquisita, e cofondata dal lead maintainer di NetBox in persona.5
E non è una terza parte che ha costruito un’attività sul progetto di qualcun altro. NetBox Labs è il custode di NetBox: la documentazione del progetto dice «the open source project is stewarded by NetBox Labs and a team of volunteer maintainers».1 Vende NetBox Enterprise per le installazioni gestite in proprio, lo ospita per te come NetBox Cloud, e offre supporto 24/7.6
Quindi «non puoi comprare supporto per NetBox» era una cosa giusta da dire quando Network to Code ha fatto il fork, e non lo è più adesso. Entrambi i progetti hanno dietro un’azienda commerciale che firmerà qualcosa, e nel caso di NetBox quell’azienda è proprio quella che cura il progetto.
La frase che quasi tutti si perdono è la successiva, ed è il motivo per cui questa non è una storia squallida: «the NetBox project team suggested that we should consider forking.»
È più o meno il fork più civile che si possa avere. Due gruppi volevano cose diverse, l’hanno detto per molto tempo, e si sono separati invece di litigare su un’unica base di codice. Entrambe le metà sono ancora Apache 2.0. Nessuno ha preso niente che non avesse il diritto di prendere.
A cosa serviva davvero il fork
Le note di rilascio di Nautobot 1.0 elencano cosa aggiungeva rispetto a NetBox 2.10, e l’elenco spiega la discussione meglio di qualsiasi post sul blog:3
| Cosa aggiunse Nautobot nel 2021 | Dove sta NetBox oggi |
|---|---|
| Supporto GraphQL | NetBox ce l’ha |
| Integrazione Git come fonte di dati | NetBox ce l’ha, come synchronized data source |
| Single sign-on | NetBox ce l’ha |
| Secret | NetBox ce l’ha tramite un plugin |
| Script e report riuniti nei Job | NetBox sposta gli script in un plugin nella 4.7 |
| Custom field su tutti i modelli | NetBox ha un ampio supporto ai custom field |
| API di plugin per la validazione dei dati | NetBox ha le custom validation rule |
| Stati personalizzabili, come oggetti del database | Gli stati di NetBox sono ancora un choice set Python |
| Relazioni tra modelli definite dall’utente | NetBox non ha un equivalente |
| Chiavi primarie UUID | NetBox usa chiavi intere |
| Miglioramenti all’API dei plugin | Il framework dei plugin di NetBox è cresciuto molto da allora |
Quasi tutta la metà superiore è convergente. Diverse cose che Nautobot ha introdotto nel 2021 sono arrivate in NetBox dopo, che è quello che succede di solito quando due progetti risolvono gli stessi problemi in pubblico.
Le ultime tre non sono convergenti, e sono architetturali, non cosmetiche. Ho controllato oggi entrambe le basi di codice invece di fidarmi delle note del 2021.
Lo Status di Nautobot è un modello del database, descritto nel suo stesso codice come «Model for database-backend enum choice objects», quindi uno stato è una riga che qualcuno può aggiungere dall’interfaccia. Gli stati di NetBox vengono da un choice set Python, ed è per questo che la sezione su FIELD_CHOICES più avanti ne aggiunge uno modificando configuration.py e riavviando. Nautobot ha i modelli Relationship e RelationshipAssociation, quindi puoi definire una relazione tra due tipi di oggetto esistenti senza scrivere codice. La risposta di NetBox a quel problema è un plugin, che ha più avanti una serie di sezioni tutta sua. E le chiavi primarie di Nautobot sono UUID, mentre quelle di NetBox sono interi.
Hanno anche fatto la cosa per cui avevano fatto il fork. Ad oggi Nautobot pubblica la 3.2.x e la 2.4.x lo stesso giorno, che è una vera linea di manutenzione a lungo termine che corre accanto alla corrente, ed era una delle tre ragioni dichiarate.
Quale dei due
Prima i numeri onesti. NetBox ha 21.625 stelle e 3.133 fork; Nautobot ne ha 1.617 e 422.7 Entrambi hanno ricevuto push negli ultimi due giorni, entrambi sono Apache 2.0, ed entrambi ora hanno dietro un’azienda commerciale che vende supporto e hosting.
Quel divario non è un giudizio sulla qualità. Riflette cinque anni di vantaggio e il fatto che la maggior parte di chi cerca una fonte di verità trova prima NetBox. Ma decide la cosa che di solito conta più delle funzionalità, cioè quanti plugin, integrazioni, moduli Ansible, risposte sui forum e colleghi troverai per quello che scegli.
Quindi: se vuoi un inventario e una fonte di verità che altri sistemi leggono, e vuoi l’ecosistema più grande e le assunzioni più facili, la risposta è NetBox, ed è di questo che parla il resto dell’articolo. Se la ragione per cui vuoi una fonte di verità è proprio guidarci l’automazione, o vuoi stati e relazioni definiti dal tuo team invece che da un file di configurazione e un riavvio, vai a guardare Nautobot per bene prima di decidere.
Non lasciare che qualcuno ti venda l’uno o l’altro solo sul supporto. Ormai entrambi i lati ce l’hanno coperto, e le differenze che ci saranno ancora tra cinque anni sono quelle nella tabella sopra.
Quello che non devi fare è sceglierne uno perché qualcuno ti ha detto che l’altro è morto. Non lo è nessuno dei due, ed entrambi hanno rilasciato versioni anche questa settimana.
Metterne in piedi uno
Due strade, e per questo le ho provate entrambe. Container se lo vuoi funzionante in venti minuti, pacchetti su un host se deve reggere carichi seri.
Lo stack di container
La community mantiene netbox-docker, che è la risposta rapida:8
git clone -b release https://github.com/netbox-community/netbox-docker.git
cd netbox-docker
tee docker-compose.override.yml <<'EOF'
services:
  netbox:
    ports:
      - 8000:8080
EOF
docker compose pull
docker compose up
Questo ti dà l’applicazione, PostgreSQL, Redis e un worker in background, collegati tra loro. Ho costruito la stessa cosa a mano sotto podman per vedere i pezzi, e vale la pena conoscerli perché due di loro fregano la gente:
| Container | Cosa fa | Se lo lasci fuori |
|---|---|---|
netbox | L’applicazione Django dietro gunicorn | non funziona niente |
postgres | Il database, 15 o successivo | non funziona niente |
redis / valkey | Due database: uno per i task, uno per la cache | non funziona niente |
netbox-worker | rqworker, che svuota la coda dei task | i webhook non partono mai, i job in background non girano mai, e niente ti avvisa |
netbox-housekeeping | La pulizia periodica | i record del change log non scadono mai |
È la quarta riga quella che conta. Senza worker sembra tutto in salute. Le event rule si accodano e restano lì.
Due cose mi hanno morso al primo avvio e nessuna delle due sta in un messaggio di errore che cercheresti.
La prima migrazione ci mette molto. Non un minuto. Su questa macchina ce ne sono voluti diversi, perché NetBox 4.7 sostituisce django-mptt con ltree di PostgreSQL e ricostruisce ogni tabella gerarchica strada facendo. Il container resta lì ad applicare migrazioni. Lascialo stare.
Senza API_TOKEN_PEPPERS non puoi creare un token API v2, e l’unico segnale è un avviso nel log:
UserWarning: API_TOKEN_PEPPERS is not defined. v2 API tokens cannot be used.
Impostane almeno uno, di almeno cinquanta caratteri, prima di andare a cercare perché l’API ti respinge.
Su un host, dai pacchetti
La strada documentata è testata su Ubuntu 24.04. L’ho seguita dall’inizio alla fine su un’installazione pulita, e il risultato è stato questo:
| Componente | Cosa mi ha dato la 24.04 | Cosa serve a NetBox 4.7 |
|---|---|---|
| PostgreSQL | 16.15 | 15 o successivo |
| Redis | 7.0.15 | 6.0 o successivo |
| Python | 3.12.3 | 3.12, 3.13 o 3.14 |
| Django | 6.1.1 | arriva con NetBox |
| NetBox | v4.7.2 |
Quei minimi sono quelli di NetBox, e la 4.7 ha alzato sia la soglia di PostgreSQL sia quella di Redis.9
L’intero lavoro sono cinque passi.
# 1. the services
sudo apt install -y postgresql redis-server
sudo -u postgres psql -c "CREATE DATABASE netbox;"
sudo -u postgres psql -c "CREATE USER netbox WITH PASSWORD 'something-you-generated';"
sudo -u postgres psql -c "ALTER DATABASE netbox OWNER TO netbox;"
sudo -u postgres psql -d netbox -c "GRANT CREATE ON SCHEMA public TO netbox;"

# 2. the build dependencies
sudo apt install -y python3 python3-pip python3-venv python3-dev build-essential   libxml2-dev libxslt1-dev libffi-dev libpq-dev libssl-dev zlib1g-dev git

# 3. the application, at a release tag rather than at main
sudo mkdir -p /opt/netbox && cd /opt/netbox
sudo git clone https://github.com/netbox-community/netbox.git .
sudo git checkout v4.7.2
sudo adduser --system --group netbox
sudo chown -R netbox /opt/netbox/netbox/media/ /opt/netbox/netbox/scripts/ /opt/netbox/netbox/reports/

# 4. the configuration: five values, no more
cd /opt/netbox/netbox/netbox/
sudo cp configuration_example.py configuration.py
python3 /opt/netbox/netbox/generate_secret_key.py   # run it twice
sudo $EDITOR configuration.py

# 5. let the upgrade script do the rest
sudo /opt/netbox/upgrade.sh
Quei cinque valori sono ALLOWED_HOSTS, DATABASES, REDIS, SECRET_KEY e API_TOKEN_PEPPERS. Genera gli ultimi due separatamente e non riusare l’uno per l’altro. Per questo, esegui il generatore di chiavi due volte e incolla i risultati su righe diverse.
upgrade.sh crea il virtual environment, installa ogni dipendenza Python, esegue le migrazioni, compila la documentazione per l’uso offline e raccoglie i file statici. Quando finisce su una macchina nuova stampa un avviso che sembra allarmante e non lo è:
WARNING: No existing virtual environment was detected. A new one has
been created. Update your systemd service files to reflect the new
Python and gunicorn executables. (If this is a new installation,
this warning can be ignored.)
Poi un superuser, e gira:
source /opt/netbox/venv/bin/activate
cd /opt/netbox/netbox && python3 manage.py createsuperuser
Per qualsiasi cosa seria, metti gunicorn davanti invece di runserver. La configurazione e i file di unit sono già nel repository, ed è il dettaglio da sapere perché la gente se li scrive da sé:
sudo cp /opt/netbox/contrib/gunicorn.py /opt/netbox/gunicorn.py
sudo cp -v /opt/netbox/contrib/*.service /etc/systemd/system/
sudo systemctl daemon-reload
sudo systemctl enable --now netbox netbox-rq
netbox.service fa girare gunicorn su 127.0.0.1:8001, netbox-rq.service fa girare il worker, e nginx o Apache vanno davanti per terminare il TLS e servire /static. Due servizi, e il secondo è lo stesso worker di cui ha bisogno lo stack di container.
L’ordine in cui devi riempirlo
Un NetBox appena installato è un database vuoto con delle opinioni, e la prima ora con uno di solito si passa a scoprire quali sono. Vai ad aggiungere un apparato, e non te lo lascia fare.
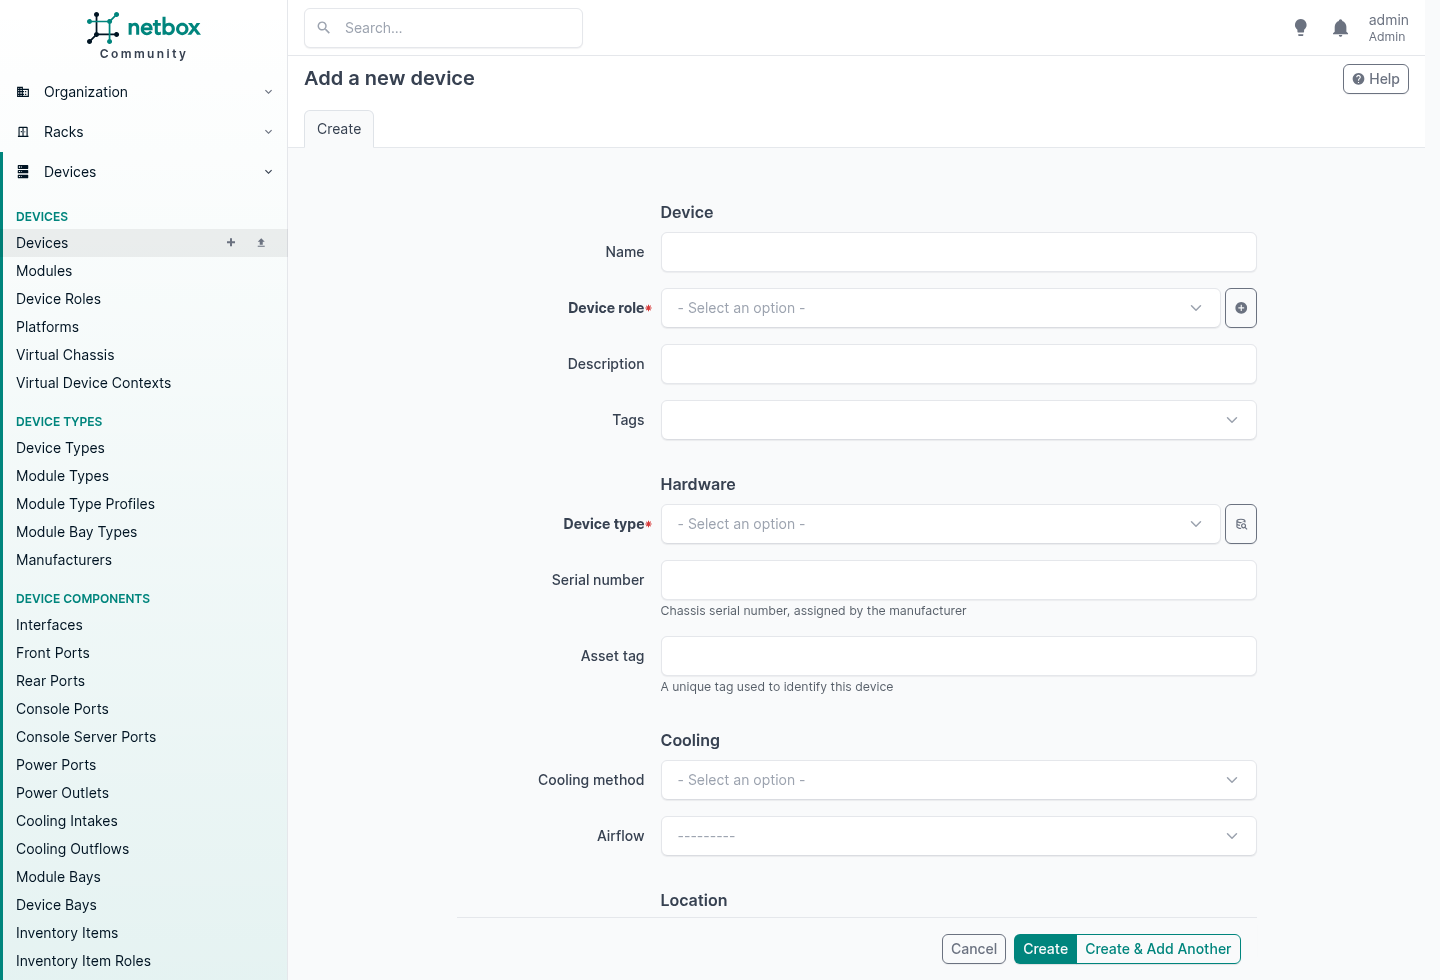
Quegli asterischi rossi sono tutta la lezione. NetBox non registra una cosa prima che esistano le cose a cui è appesa, e non lo fa per dispetto: un apparato senza tipo è una riga che non sa rispondere a nessuna delle domande per cui esiste un apparato.
Quindi, invece di tirare a indovinare, ho chiesto al modello quali chiavi esterne sono davvero obbligatorie, e poi ho provato a violare ogni regola tramite l’API per vedere cosa torna indietro.
POST /api/dcim/device-types/   no manufacturer
  {"manufacturer": ["This field is required."]}
POST /api/dcim/devices/        no device type
  {"device_type": ["This field is required."]}
POST /api/dcim/interfaces/     no device
  {"device": ["This field is required."]}
POST /api/ipam/aggregates/     no RIR
  {"rir": ["This field is required."]}
POST /api/circuits/circuits/   no provider, no type
  {"provider": ["This field is required."], "type": ["This field is required."]}
POST /api/virtualization/virtual-machines/   nothing at all
  {"__all__": ["A virtual machine must be assigned to a site, cluster, or device."]}
Li ha rifiutati tutti, e ha detto esattamente cosa mancava. Ecco la stessa informazione come elenco di prerequisiti:
| Per creare | Serve prima | Facoltativo, ma lo vuoi prima |
|---|---|---|
| Tenant | niente | un Tenant group |
| Region, Site group | niente | un genitore dello stesso tipo, si annidano |
| Site | niente | una Region, un Site group, un Tenant |
| Location | un Site | una Location genitore, un Tenant |
| Rack type | un Manufacturer | |
| Rack | un Site | una Location, Rack group, Rack role, Rack type, Tenant |
| Device type | un Manufacturer | |
| Device role | niente | un Device role genitore, si annidano |
| Device | un Device role, un Device type, un Site | un Rack e una posizione, una Platform, un Tenant |
| Interface, e ogni altro componente | un Device | |
| Cable | due cose su cui terminare | un Tenant |
| Aggregate | un RIR | un Tenant |
| VLAN | niente | un VLAN group, un Role, un Tenant |
| Prefix | niente | un Site, una VLAN, un Role, una VRF, un Tenant |
| IP address | niente | un’Interface a cui assegnarlo, un Tenant |
| Circuit | un Provider e un Circuit type | un Tenant |
| Circuit termination | un Circuit | un Site su cui atterrare |
| Cluster | un Cluster type | un Cluster group, un Site, un Tenant |
| Virtual machine | un Site, un Cluster o un Device | una Platform, un Tenant |
| VM interface | una Virtual machine |
È la seconda colonna quella che ti costa. Prefissi, indirizzi IP, VLAN e tenant non richiedono niente, quindi niente ti impedisce di crearli il primo giorno nell’ordine che preferisci. Se servano a qualcosa è un’altra questione, perché un indirizzo senza un’interfaccia dietro è una riga in un elenco, e un apparato senza tenant è un apparato che dovrai modificare di nuovo più avanti.
L’ordine in cui lavorare davvero
Ne esce una sequenza. Seguila dall’alto in basso e niente ti respingerà mai.
Prima, le cose a cui è appeso tutto il resto. Nessuna è entusiasmante e tutte costano poco da sbagliare.
- Tenant group, poi tenant. Falli prima di tutto il resto. Ventotto modelli accettano un tenant, tra cui Site, Location e Rack, quindi se i clienti non esistono ancora non puoi assegnarli strada facendo e finirai a fare modifiche di massa dopo.
- Region e site group. Entrambi facoltativi, entrambi si annidano in sé stessi, e sono indipendenti l’uno dall’altro. Le region sono per la geografia, i site group per la funzione, e puoi usarne uno, entrambi o nessuno.
- Site. La radice di quasi tutto. Un site non richiede niente, ed è per questo che è la prima cosa che puoi davvero creare.
- Location. Queste richiedono un site, e si annidano, quindi una sala che contiene file che contengono pod è un solo modello profondo tre livelli.
- Rack role e rack group. Entrambi facoltativi. I rack group sono piatti e stanno accanto alle location come secondo asse, comodo per file e pod.
- Manufacturer, poi rack type. Un rack type richiede un manufacturer. Salta i rack type se non stai modellando gli armadi in sé.
- Rack. Richiedono un site. Se gli dai anche una location, quella location deve appartenere a quel site, e NetBox lo controlla.
Poi il catalogo hardware, non l’hardware. Prima di poter aggiungere un singolo apparato ti servono manufacturer, device type, device role e, in pratica, platform.
- Manufacturer. Potresti averne già alcuni dal passo 6, perché servono anche ai rack type. E anche ai module type.
- Device type, ciascuno con il suo manufacturer.
- Device role, che si annidano, e platform.
Questo è il passo che la gente salta, ed è il passo che decide quanta digitazione richiederà il resto del lavoro. Un device type porta con sé le proprie interfacce, porte e alloggiamenti come template, quindi ogni apparato che crei da lì arriva con i componenti giusti già montati. Imposta bene il tipo una volta e metterne quaranta nei rack significa scrivere quaranta nomi.
Platform è l’intruso in quell’elenco, perché un apparato non ne richiede strettamente una. Fallo adesso lo stesso. È quello che porterà il config template e il driver NAPALM più avanti, e tornare indietro a impostarlo su un intero parco è la stessa serata che avresti passato sui tenant.
Poi gli apparati veri e propri.
- Device. Ruolo, tipo e site sono tutti obbligatori. Rack e posizione sono facoltativi, e se li indichi devono essere coerenti con il site.
- Componenti, se il device type non li ha già forniti.
- Cavi, tra i componenti.
Poi l’indirizzamento, perché un indirizzo vuole un’interfaccia su cui vivere e l’interfaccia esiste solo dopo il passo 12.
- RIR, poi aggregate.
- Role di prefissi e VLAN, VRF, VLAN group e poi VLAN.
- Prefissi, poi i singoli indirizzi IP.
Poi il livello commerciale.
- Provider, provider account e circuit type.
- Circuiti, poi terminali sui site.
E il parco virtuale, che rispecchia quello fisico.
- Cluster type e cluster group, poi cluster.
- Macchine virtuali, che richiedono un site, un cluster o un apparato, poi le loro interfacce.
I passi da 1 a 10 sono un pomeriggio e sembrano lavoro d’ufficio. Non c’è niente di affascinante in nessuno di essi. Sono anche il pomeriggio che decide se il passo 11 richiede una mattina o due settimane.
Le regole che mordono dopo
I campi obbligatori sono la metà facile, perché falliscono subito e ti dicono perché. Quelle che fregano la gente sono le regole di coerenza, che scattano solo quando hai abbastanza dati per contraddirti:
device at Leeds, put in a Manchester rack
  {"rack": ["Rack MCR1-A07 (A07) does not belong to site Leeds Edge."]}
device at Leeds, in a Manchester location
  {"location": ["Location Hall 2 does not belong to site Leeds Edge."]}
rack at Leeds, in a Manchester location
  {"__all__": ["Assigned location must belong to parent site (Leeds Edge)."]}
a second device in a unit that is already taken
  {"position": ["U39.0 is already occupied or does not have sufficient
                 space to accommodate this device type: MX204 (1.0U)"]}
Quell’ultima è quella che indicherei se qualcuno mi chiedesse perché darsi pena con tutto questo. NetBox sa che l’apparato è 1U, sa cosa c’è nell’armadio, e non ti lascia registrare due cose nello stesso spazio. Il tuo foglio di calcolo te lo lascerà fare per tutto il pomeriggio senza dire una parola, e lo scoprirai quando qualcuno sarà in sala con una scatola in mano.
Nessuna di queste è configurabile e nessuna dovrebbe esserlo. Sono la differenza tra un registro e un desiderio.
Usarlo: cosa ti dà ogni schermata
Con il parco caricato, ecco cosa ne ricavi davvero. Tutto quello che segue è la stessa istanza: un armadio, quattordici apparati, cablati e indirizzati tra tre clienti.
Un apparato sono i suoi componenti
Entra in uno di quegli hypervisor e la scheda interessante non è il riepilogo, sono le interfacce.
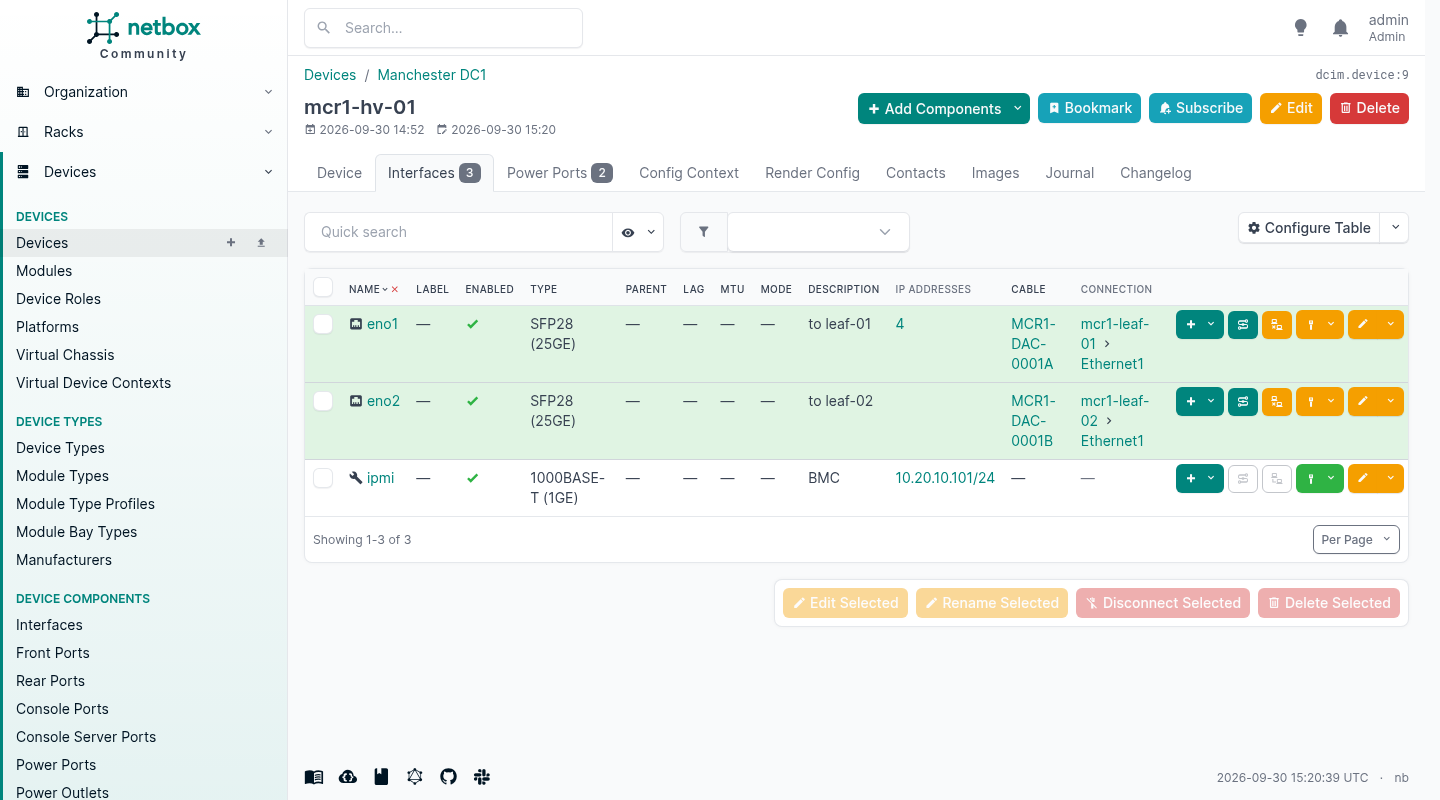
Leggi una riga da sinistra a destra. L’interfaccia, la sua velocità, cosa ci hai scritto, l’indirizzo che porta, l’etichetta sul cavo, e la porta all’altro capo. È una sola query, ed è la risposta alla domanda che tutti fanno davvero, cioè «a cosa è collegato questo».
Nota dove sta l’indirizzo. Sta su eno1, non sul server. Sembra pignoleria fino al giorno in cui hai un apparato con un’interfaccia di gestione, due interfacce dati e una loopback, e qualcuno chiede quale indirizzo risponde per lui. Un modello che appende gli indirizzi agli apparati non sa dirtelo. Questo sì, e sa anche gestire il caso del tutto normale di quattro indirizzi su un’interfaccia.
Segui il cavo
I cavi terminano sui componenti, non sugli apparati. Un’interfaccia da un lato, un’interfaccia dall’altro, oppure una front port, una rear port, una power outlet, una circuit termination. È il dettaglio su cui poggia l’intera funzione, ed è il motivo per cui l’elenco delle interfacce sopra poteva stampare l’altro capo in una sua colonna senza che glielo dicessi.
Modella un cavo da apparato ad apparato e hai fatto un disegno. Terminalo sulle porte e NetBox può percorrerlo.
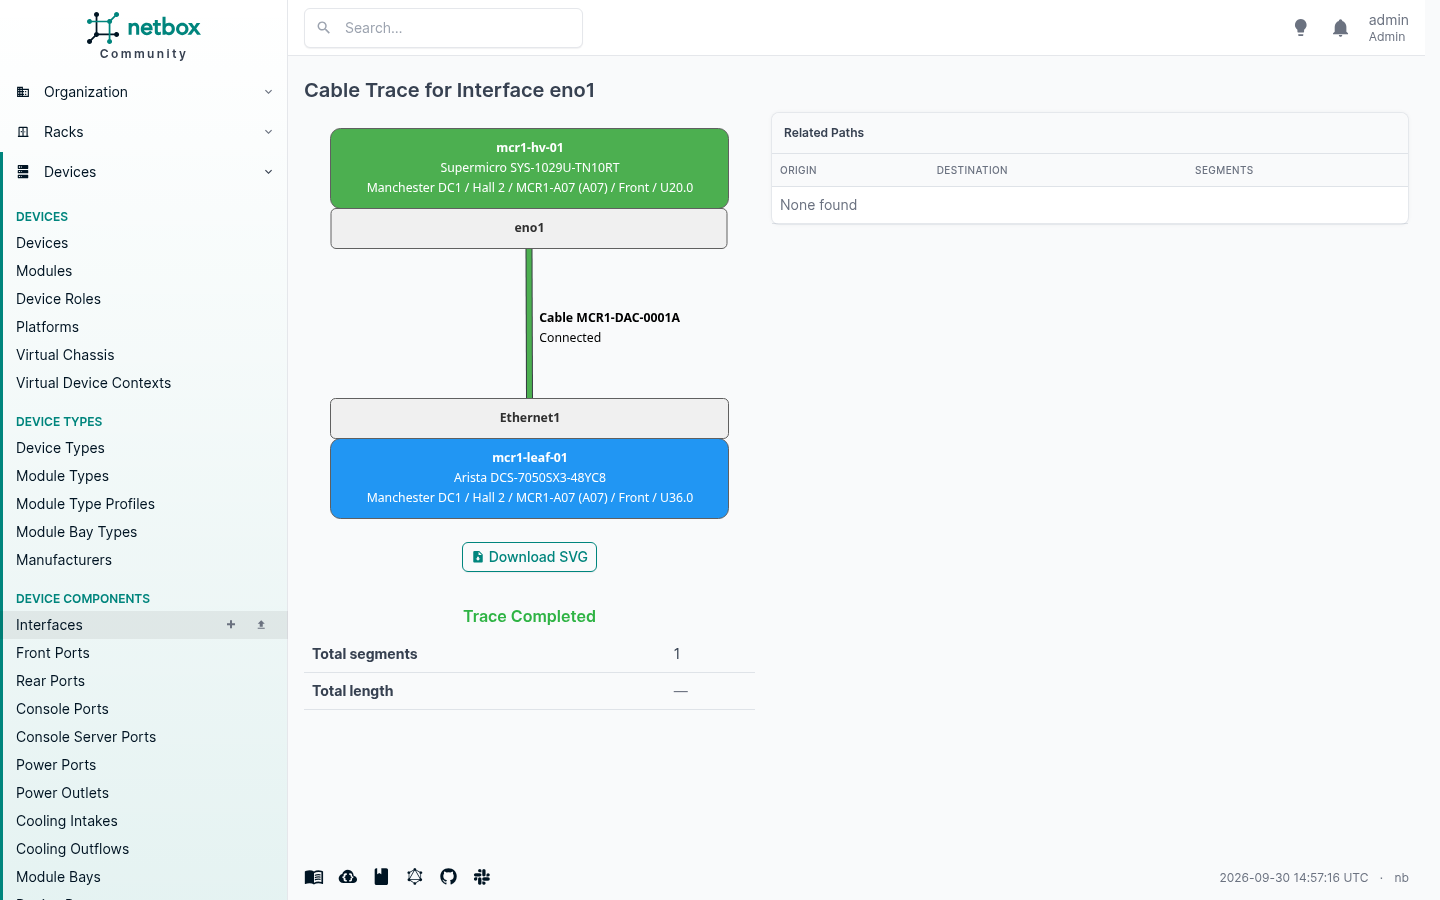
Un solo salto qui, perché è un cavo direct attach. Metti dei patch panel in mezzo e li percorre, pannello per pannello, e ti dice cosa c’è all’altro capo di una tratta che attraversa tre armadi. È il lavoro che altrimenti richiede una torcia e qualcuno che tiene l’altro capo di un generatore di tono.
La traccia stampa anche la posizione completa di ogni estremità. Site, sala, armadio, lato, unità rack. Se ti è mai capitato di stare al telefono cercando di dire a un tecnico remote hands quale apparato guardare, quella riga è tutto il valore.
Gli indirizzi, come albero e non come scheda
L’IPAM è la metà per cui la gente arriva.
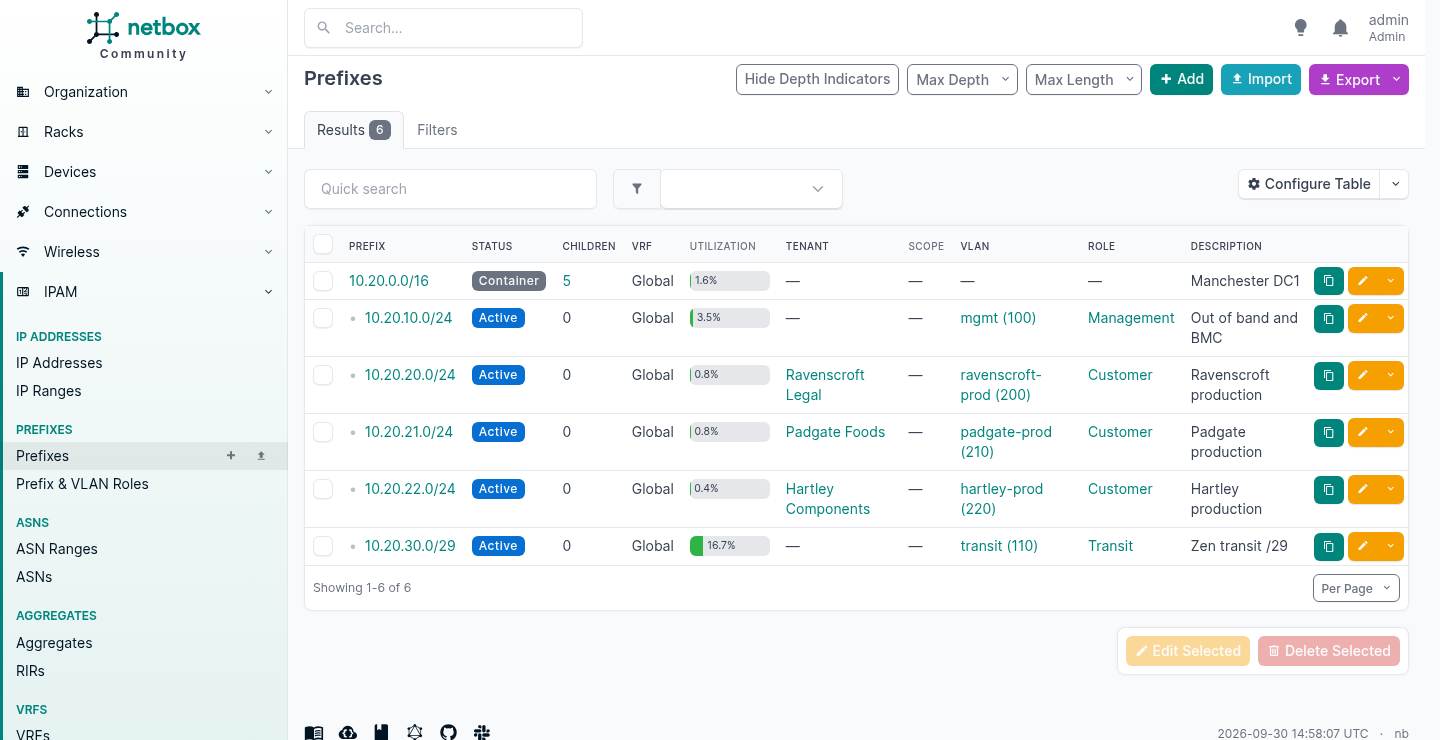
Il rientro è calcolato dagli indirizzi stessi. Non dici a NetBox che 10.20.20.0/24 sta dentro 10.20.0.0/16, lo capisce da solo, e continuerà a capirlo quando l’anno prossimo qualcuno aggiungerà un /26 lì in mezzo.
Ogni riga porta le cose per cui filtri davvero: la VLAN a cui corrisponde, il ruolo, e il cliente a cui appartiene. Anche l’utilizzo è calcolato.
Aprine uno e vedi gli indirizzi che contiene, e i buchi.
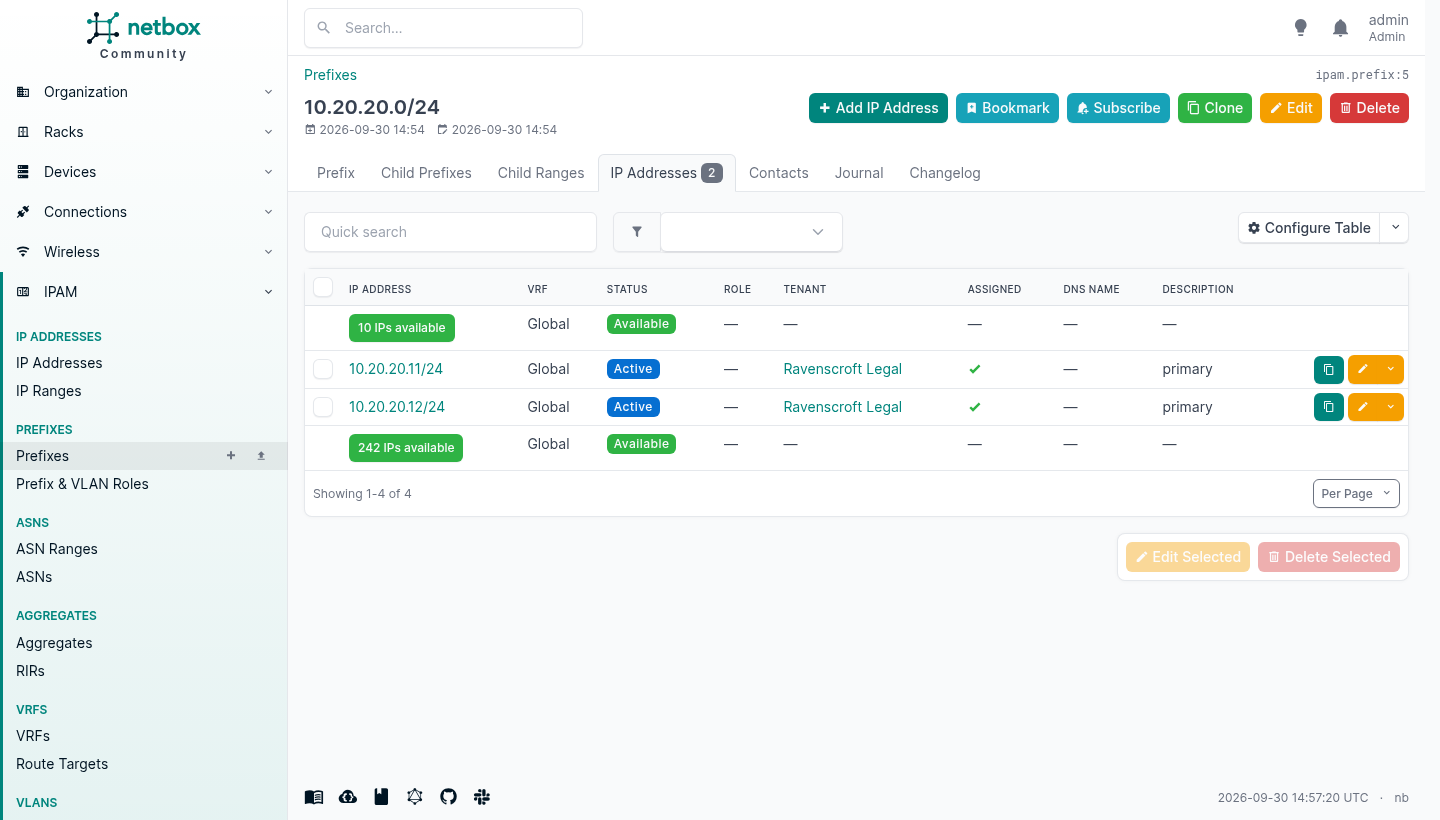
Quelle righe verdi sono lo spazio libero, mostrato in linea con lo spazio usato. C’è una chiamata API che ti consegna il prossimo indirizzo libero di un prefisso, ed è l’unico pezzo di automazione IPAM che si ripaga subito, perché è la cosa che altrimenti la gente fa strizzando gli occhi davanti a un foglio di calcolo e sperando.
Un’interfaccia accetta tutti gli indirizzi che vuoi, di entrambe le famiglie, e ne nomini uno per famiglia come primario dell’apparato.
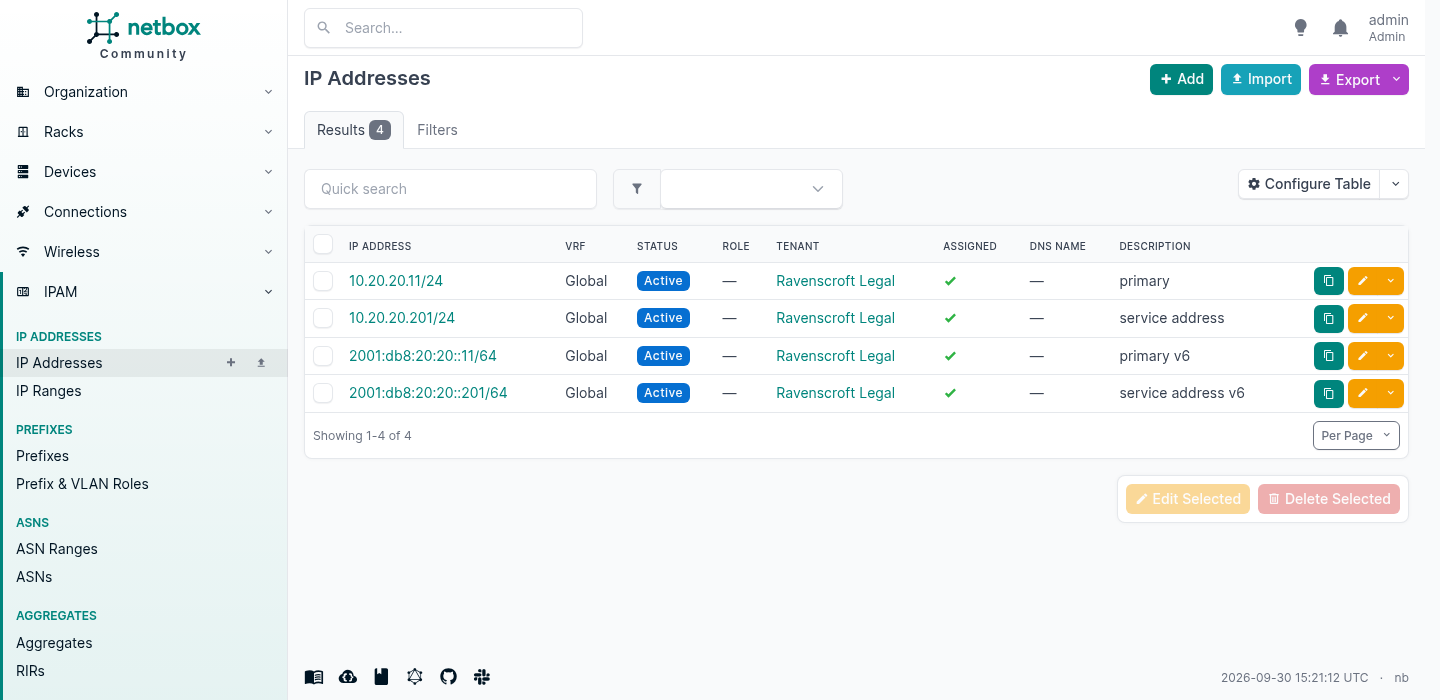
Due IPv4 e due IPv6 su una porta, che è un martedì qualunque e una cosa che un modello centrato sull’apparato non sa esprimere affatto.
Inserisci gli indirizzi con la maschera della rete su cui stanno, non come /32. NetBox accetterà 10.20.20.11/32 e lo archivierà sotto il prefisso giusto, perché il contenimento si calcola dall’indirizzo host. Quello che non farà è correggerti dopo: la maschera viene salvata esattamente come l’hai scritta e restituita a chiunque la legga, quindi un /32 su un indirizzo di LAN genera un /32 nella configurazione dell’apparato. Il posto dove morde è tre mesi dopo in un config template, non oggi nel modulo.
Un’installazione, tre clienti
La maggior parte degli oggetti in NetBox può essere assegnata a un tenant. Un’azienda lo usa per le business unit. Se vendi servizi gestiti, ne crei uno per cliente.
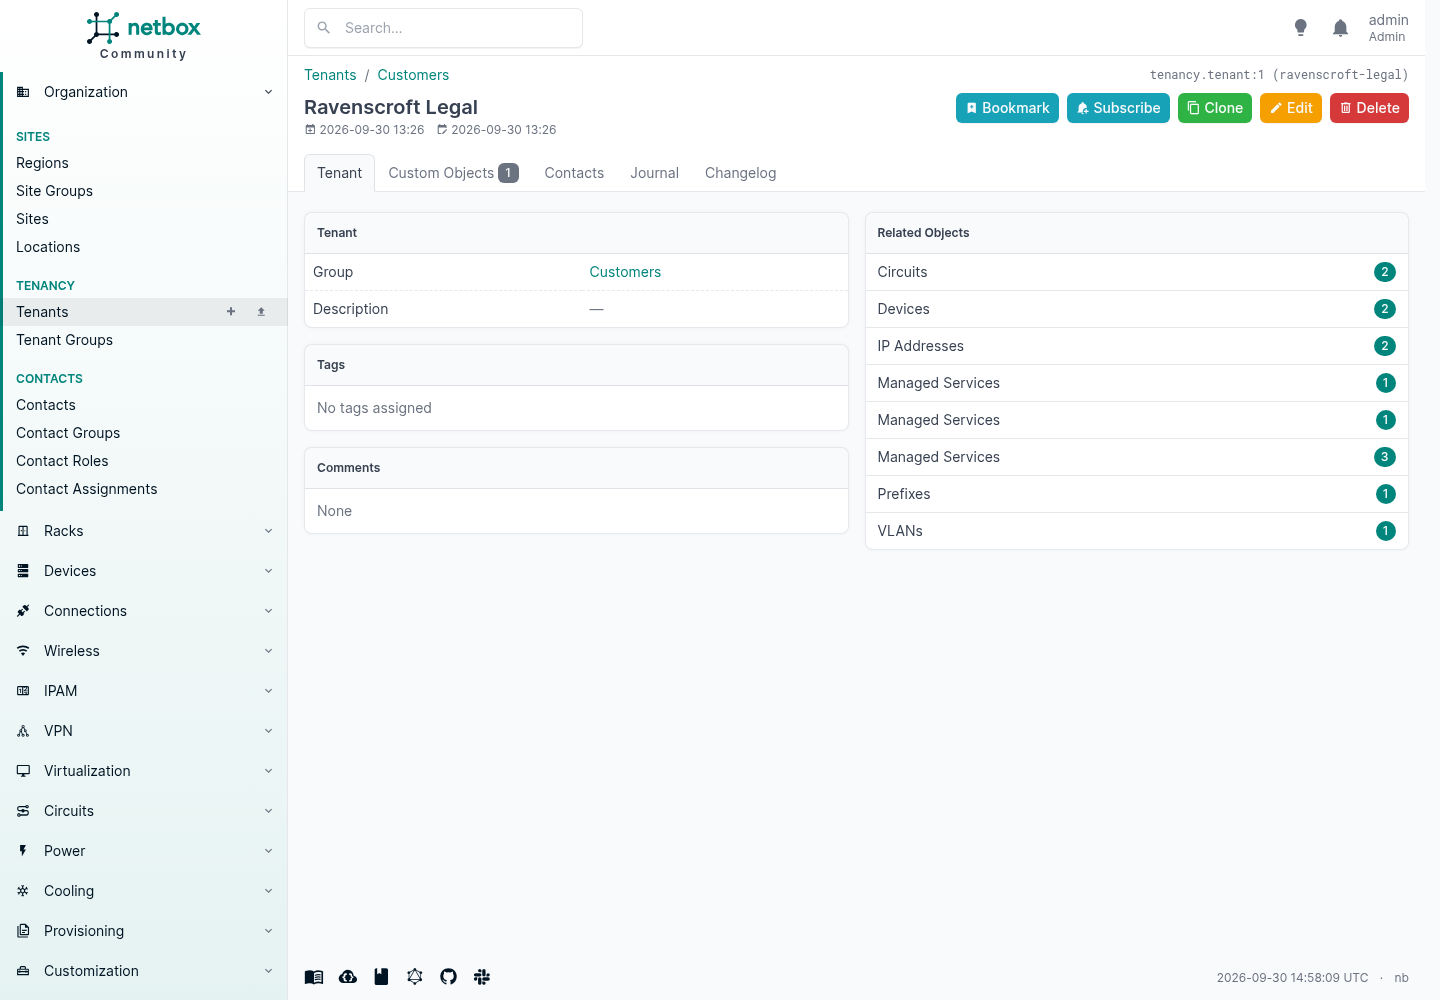
Quel pannello a destra è la risposta a «cosa ha questo cliente», e si è composto da solo. Nessun report, nessun foglio di calcolo, nessuna domanda al tecnico che l’ha costruito.
Vale la pena fare attenzione a cosa significa tenancy, perché sbagliarla il primo giorno è un anno di lavoro per disfarla dopo. Un tenant significa che l’oggetto è dedicato a quel cliente. Un router che serve solo lui prende il suo tenant. Un firewall che ne serve quattro non appartiene a nessuno di loro, quindi non ne prende nessuno, e la relazione va da un’altra parte. Ne parliamo più avanti, perché è il punto in cui quasi tutti scoprono di dover aggiungere qualcosa di proprio.
Metti i numeri sul device type
Questo è il passo che separa un inventario da qualcosa che risponde alle domande, e costa una decina di minuti per device type.
Un device type può portare il suo peso e, tramite i template delle sue power port, il suo assorbimento. Mettili sul tipo una volta e ogni apparato che creerai da lì li eredita. Lasciali fuori e NetBox ti dirà tranquillamente che un armadio è pieno al 28,6% e nient’altro.
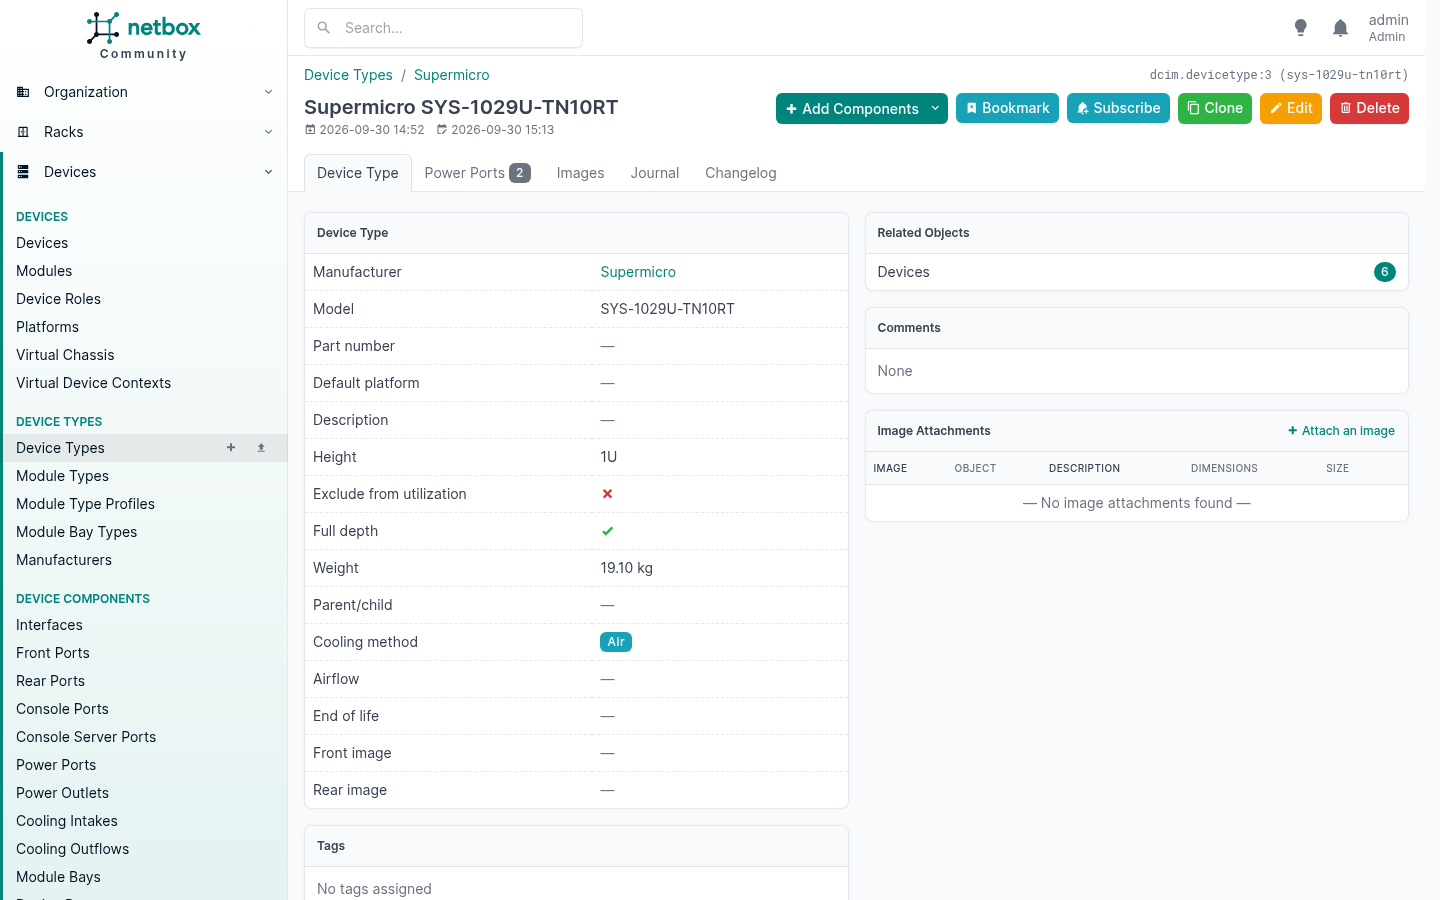
Qui ho messo il peso su tutti e cinque i tipi, ho dato a ciascuno due template di power port con un assorbimento massimo e uno allocato, ho dato al tipo della PDU un ingresso e dodici uscite, poi ho creato un power panel e due feed verso l’armadio e ho cablato tutto: il PSU1 di ogni apparato alla PDU A, ogni PSU2 alla PDU B, e l’ingresso di ogni PDU al suo feed.
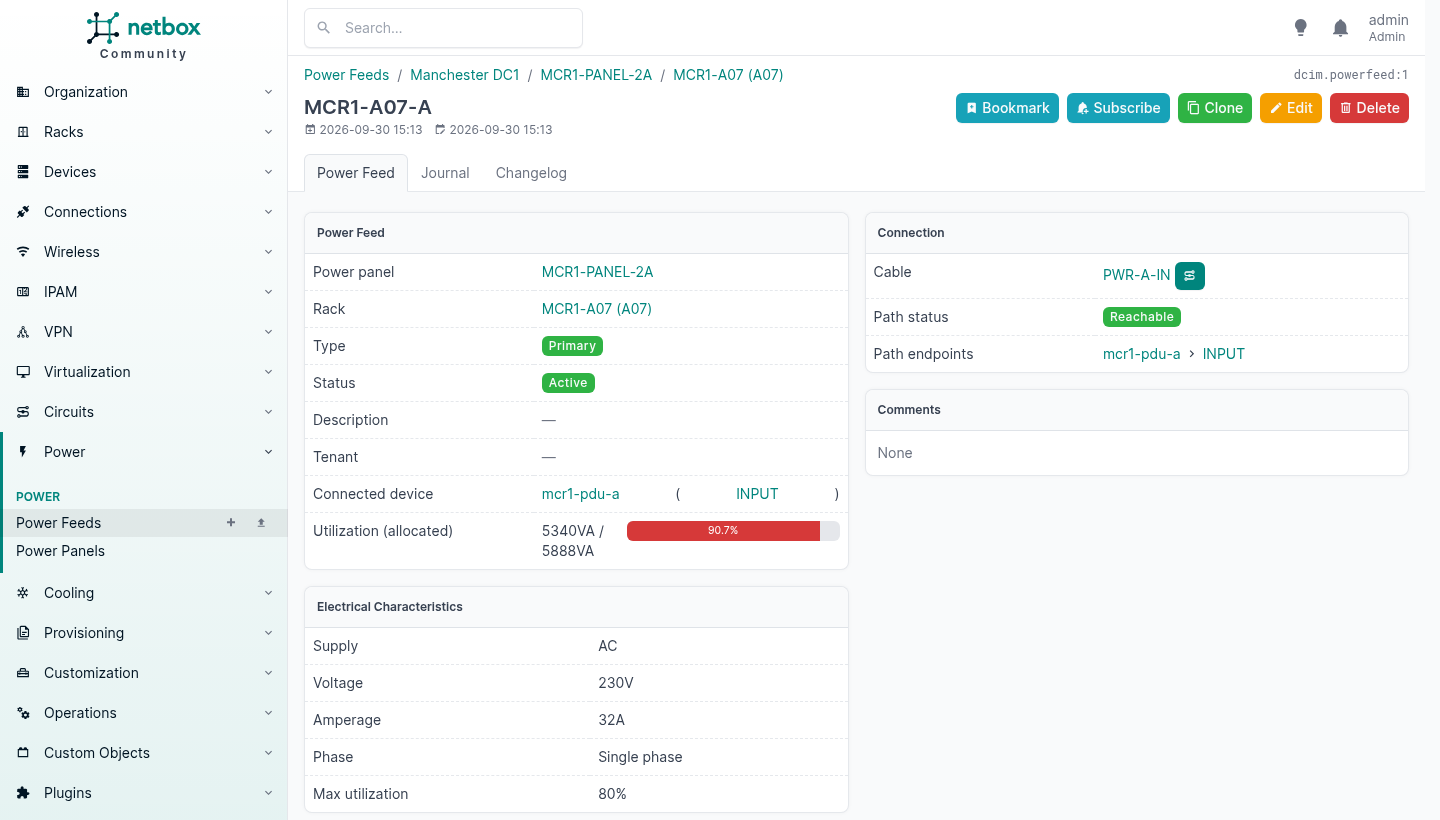
Poi la pagina del rack cambia completamente.
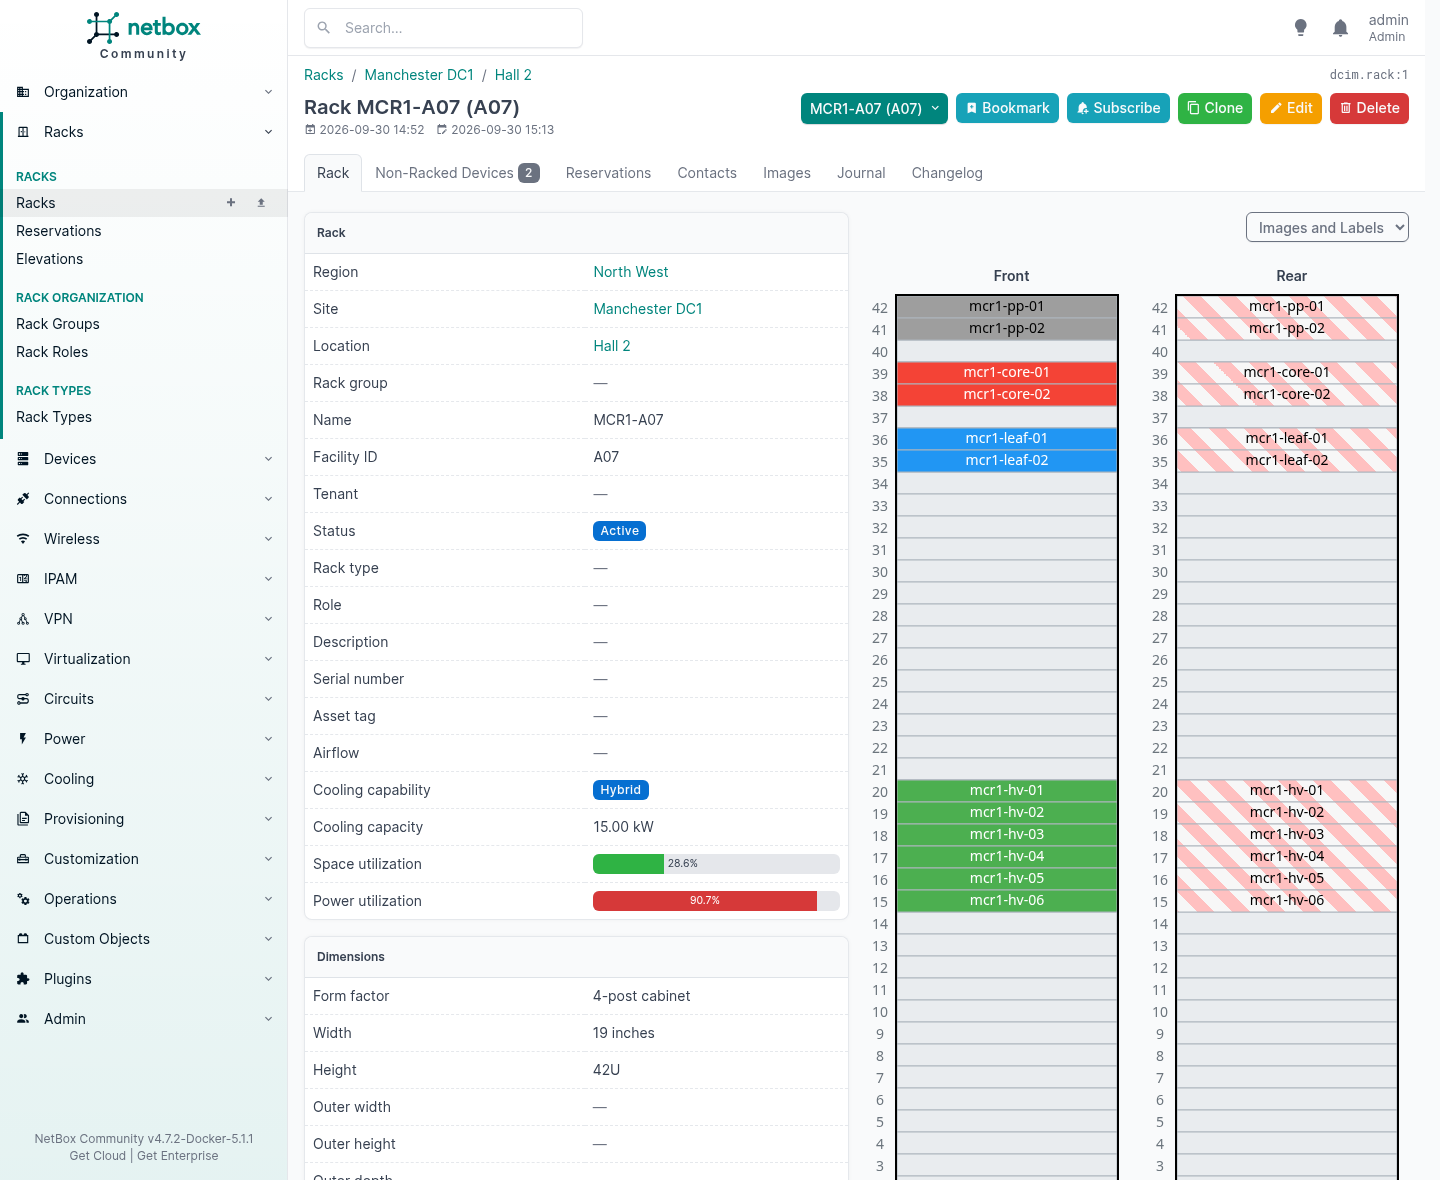
Occupazione dello spazio 28,6%. Utilizzo della potenza 90,7%.
Quell’armadio è pieno per un terzo di apparati e quasi senza potenza, ed è un fatto del tuo parco che nessun foglio di calcolo ti offrirà mai spontaneamente. È anche il fatto che decide se il prossimo ordine finisce in quel rack o da un’altra parte, ed è saltato fuori da dati inseriti una volta sola, sui tipi.
Due cose che lo lasciano a zero
All’inizio ho ottenuto 0,0%, due volte, e vale la pena conoscere entrambe le cause perché nessuna delle due produce un errore.
Le uscite devono fare riferimento all’ingresso. Una power outlet su una PDU ha un campo power_port che punta alla porta a monte sullo stesso apparato. Lascialo vuoto e la catena è spezzata: NetBox non ha modo di sapere che quelle dodici uscite sono alimentate da quell’ingresso, quindi non somma niente.
Lascia vuoti i campi di assorbimento dell’ingresso. Questo è quello controintuitivo. NetBox calcola l’assorbimento di una power port da ciò che vi è collegato solo se entrambi i suoi campi di assorbimento sono vuoti:
if self.allocated_draw is None and self.maximum_draw is None:
    ...aggregate the downstream power ports...
# otherwise
return {'allocated': self.allocated_draw or 0, ...}
Avevo gentilmente impostato maximum_draw: 7400 sull’ingresso della PDU, perché è il valore nominale della PDU. NetBox quindi mi ha creduto, ha preso allocated_draw come non impostato, e ha riportato zero. Svuotali entrambi e lo calcola da solo:
mcr1-pdu-a INPUT -> allocated 5340 VA, maximum 8480 VA, across 12 outlets
mcr1-pdu-b INPUT -> allocated 5340 VA, maximum 8480 VA, across 12 outlets
feed MCR1-A07-A: available 5888 VA   (230 V x 32 A x 80% max utilisation)
RACK power utilisation: 90.7 %
RACK weight: 166.6 kg of 900 kg
Quindi la regola è: metti numeri veri sulle foglie, e lascia vuote le porte intermedie così NetBox può sommarle. Un valore definito amministrativamente vince sempre su quello calcolato, il che è il comportamento corretto ed esattamente la cosa sbagliata da fare su una PDU.
Il raffreddamento, che è nuovo
La versione 4.7 ha aggiunto il raffreddamento al DCIM, ed è arrivato con la parte che sta diventando costosa. Un rack porta una capacità di raffreddamento ad aria, ibrida o a liquido e una potenza in kilowatt; un device type porta un metodo di raffreddamento. Sopra ci sono le cooling source per chiller e unità CRAC, i cooling feed che rappresentano un circuito verso un rack, e componenti di intake e outflow sugli apparati stessi per cold plate e collettori.
L’armadio sopra indica Hybrid, 15,00 kW, perché l’ho detto io al rack. Se quest’anno ricevi apparati raffreddati a liquido, questo è un modello per la cosa che oggi tieni in un foglio di calcolo.
Un’installazione, molti clienti
La tenancy è il motivo per cui un provider può far girare un solo NetBox invece di uno per cliente, e vale la pena capire cosa fa e, soprattutto, cosa non fa.
Ventotto modelli di NetBox hanno un campo tenant. Site, location, rack e prenotazioni di rack. Apparati, cavi e virtual device context. Prefissi, indirizzi IP, range, aggregate, VLAN, VLAN group, VRF, route target, ASN. Circuiti e gruppi di circuiti. Cluster e macchine virtuali. Tunnel, L2VPN, LAN e link wireless. Power feed e cooling feed.
Sono tutti i sostantivi fatturabili. Impostalo in modo coerente e «cosa ha questo cliente» smette di essere un’indagine.
Ma un tenant è un’etichetta, non una serratura. Dice che l’oggetto è dedicato a quel cliente. Non impedisce a chiunque possa fare login di leggere tutto, il che va bene dentro una sola azienda e non serve a niente nel momento in cui un cliente ha un account.
Ne seguono due cose, e la seconda è quella che la gente sbaglia.
Un tenant significa dedicato. Un router che serve un solo cliente prende il suo tenant. Un firewall che ne serve quattro non appartiene a nessuno di loro, quindi non prende niente, e registri invece la relazione sulla cosa che hai effettivamente venduto. Forzare un tenant su apparati condivisi rende silenziosamente sbagliato ogni report costruito sulla tenancy.
E l’accesso è un meccanismo del tutto separato.
L’isolamento sta nei permessi
I permessi sugli oggetti di NetBox accettano un vincolo JSON, e il vincolo è un filtro dell’ORM di Django. Restringe il queryset prima che venga costruito qualsiasi cosa, quindi ogni vista, esportazione, chiamata API e ricerca ne viene ristretta insieme.
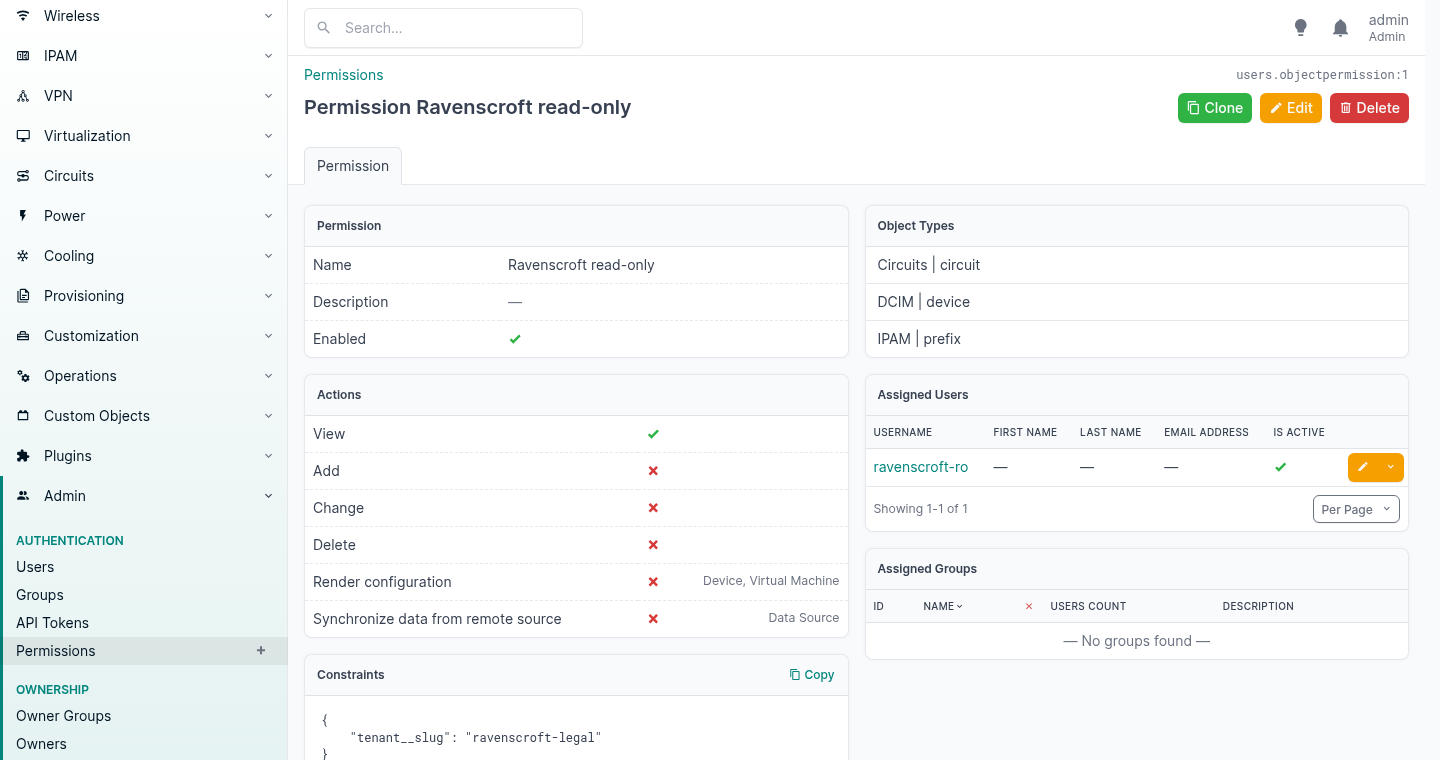
Tre campi fanno il lavoro. I tipi di oggetto a cui si applica, le azioni che concede, e quel vincolo in fondo. Tutto il resto è contabilità.
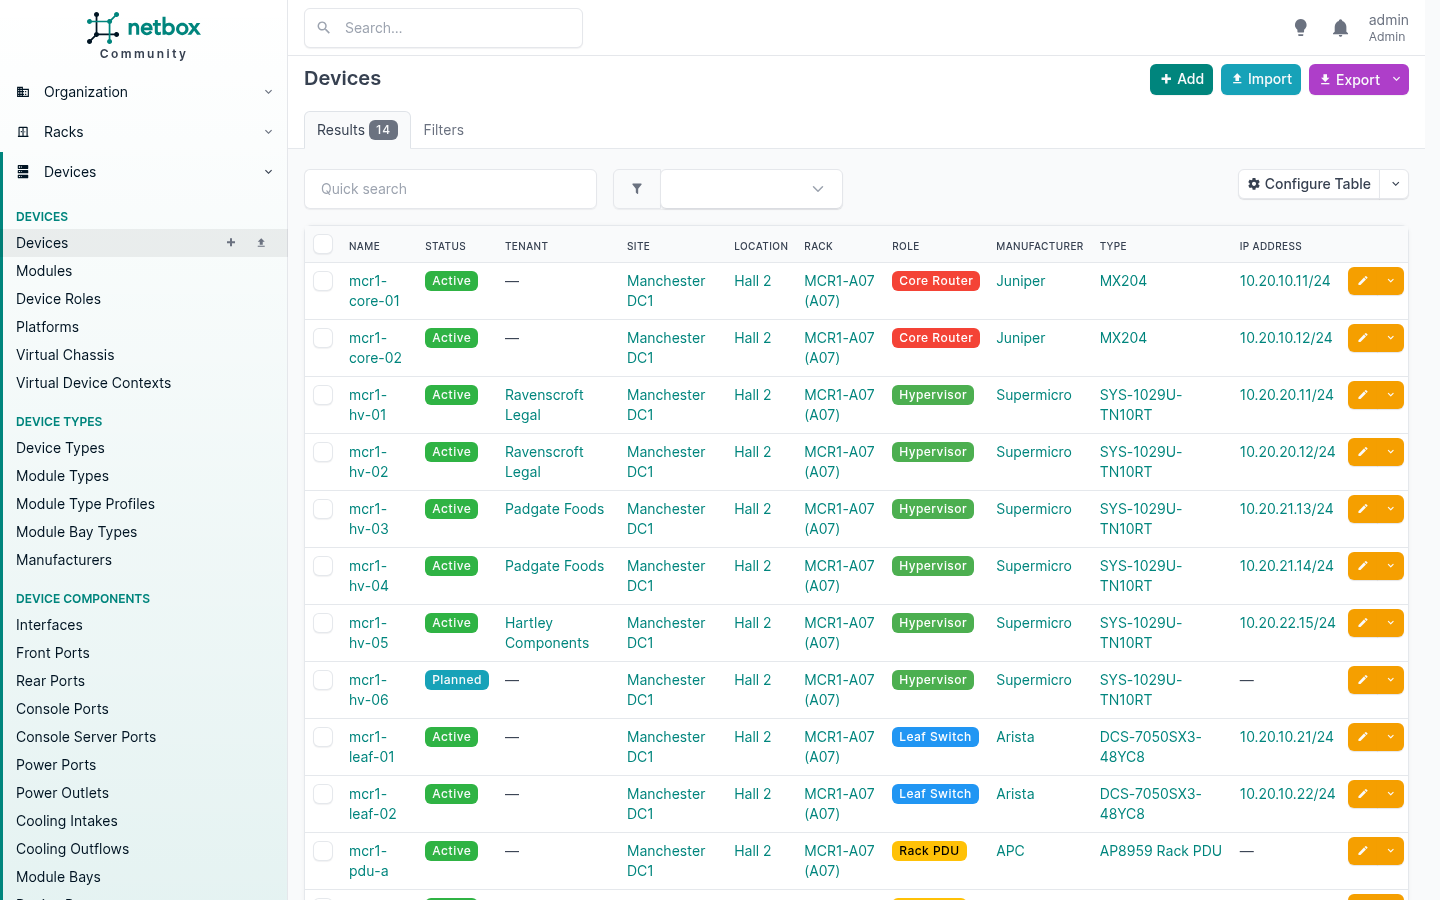
Ecco l’elenco degli apparati visto da un amministratore.
Ed ecco lo stesso URL, la stessa installazione, con l’accesso del cliente.
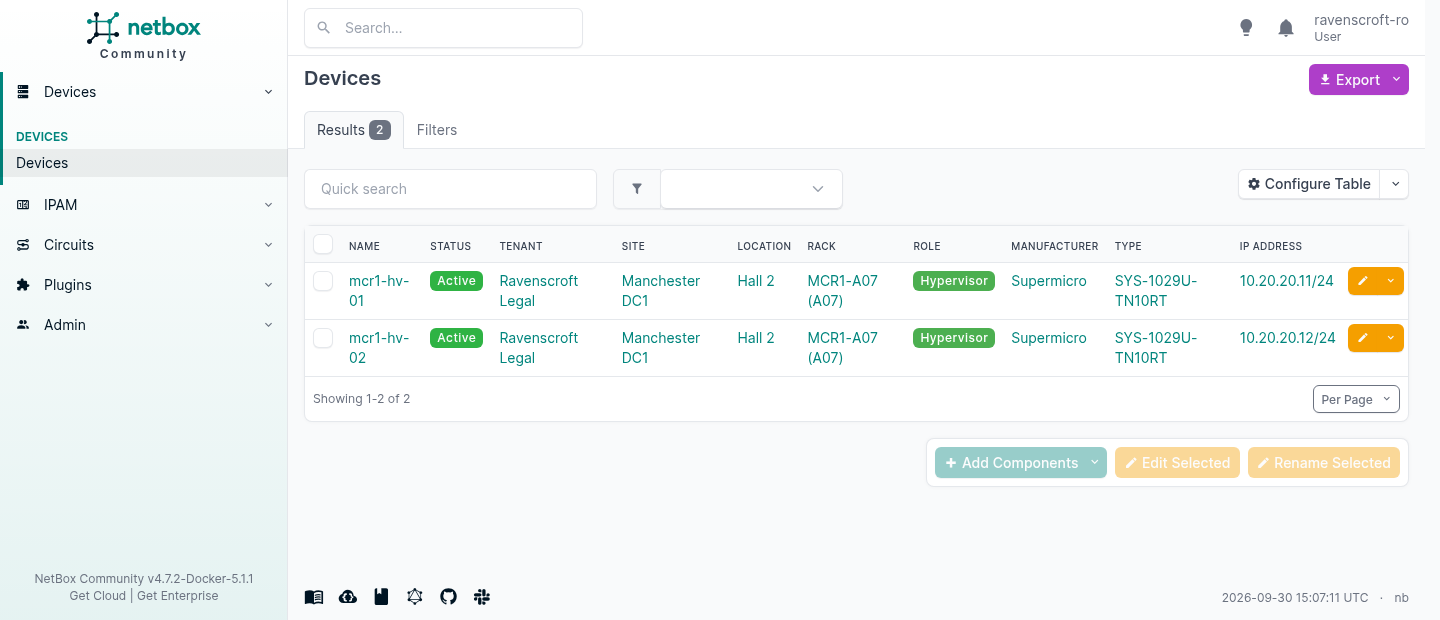
Due righe invece di quattordici, e guarda il menu a sinistra. Si è ridotto alle quattro cose che quell’account può toccare. Nessuno l’ha configurato. La navigazione è costruita dagli stessi permessi, quindi un cliente non vede mai un link verso qualcosa che lo respingerebbe.
I due modi in cui dice no
È il dettaglio che vale la pena conoscere, perché i due rifiuti significano cose diverse ed entrambi sono voluti.
| Il token del cliente chiede | Ottiene |
|---|---|
/api/dcim/devices/ | 200, una riga su due |
/api/dcim/devices/1/, il suo | 200 |
/api/dcim/devices/2/, quello di un altro | 404 |
/api/tenancy/tenants/ | 403 |
/api/dcim/sites/, mai concesso | 403 |
| nessun token | 403 |
404 significa che il tipo è tuo ma quella riga no. Il vincolo l’ha tolta dal queryset, quindi per quanto riguarda la richiesta non esiste. Un 403 lì confermerebbe che esiste, e permetterebbe a un cliente curioso di contare il tuo parco scorrendo gli ID.
403 significa che il tipo non è mai stato tuo. Tenant e site non sono mai stati concessi, quindi rifiutano e basta, e il cliente non può elencare chi altro c’è sulla piattaforma.
Poi lasciali scrivere
La sola lettura è il caso facile. La vera domanda è se ci si può fidare di un cliente con diritti di modifica, quindi ho concesso change con lo stesso vincolo e sono andato a cercare la via d’uscita.
| Tentativo | Risultato |
|---|---|
| Modificare il proprio apparato | 200, salvato |
| Modificare l’apparato di un altro cliente | 404 |
| Modificare il proprio apparato spostandolo sul tenant dell’altro cliente | 403 |
| Cancellare il proprio apparato | 403, la cancellazione non è mai stata concessa |
È la terza riga quella che conta. Riassegnare il proprio apparato al tenant di qualcun altro è la fuga ovvia, perché l’oggetto è dentro il tuo vincolo quando arriva la richiesta e fuori dopo. NetBox valuta il vincolo sullo stato in cui l’oggetto verrebbe lasciato, quindi rifiuta. Ho riletto l’apparato invece di fidarmi del codice di stato, e il tenant non si era spostato.
È il buco che la maggior parte della multi-tenancy fatta in casa lascia aperto, e di solito lo trova un cliente e non un test.
Variabili che devono ereditare
Ecco la distinzione che la gente sbaglia, e farla giusta risparmia un sacco di modifiche.
Un custom field è un valore su un oggetto. Lo imposti oggetto per oggetto, e resta lì. Va bene per un fatto sulla cosa in sé: un asset tag, un numero di contratto di assistenza, una data di messa in servizio.
Un config context è un valore legato a una caratteristica, che tutto ciò che ha quella caratteristica eredita. Va bene per una variabile che deve scendere a cascata: i tuoi server NTP, i tuoi target syslog, la tua community SNMP, il tuo dominio DNS, la tua VLAN di gestione, la tua finestra di backup.
Se ti ritrovi a impostare lo stesso custom field allo stesso valore su quaranta apparati, volevi un config context.
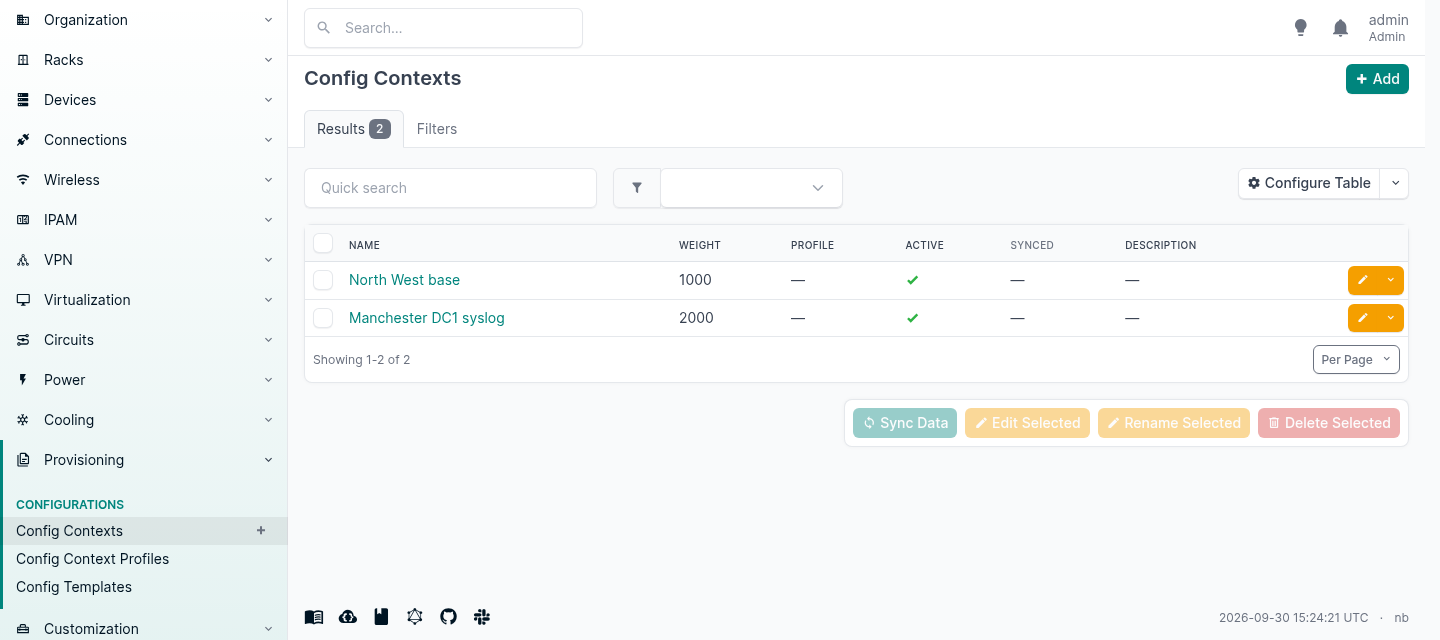
Un context è JSON arbitrario, e può essere legato a una region, site group, site, location, device type, ruolo, platform, cluster, cluster type, cluster group, tenant group, tenant o tag. Il tenant è in quell’elenco, il che per un provider significa che un fatto vero per un cliente ovunque lo segue su ogni apparato che aggiungerai per lui.
L’unione avviene per chiave, e il peso decide chi vince ciascuna.
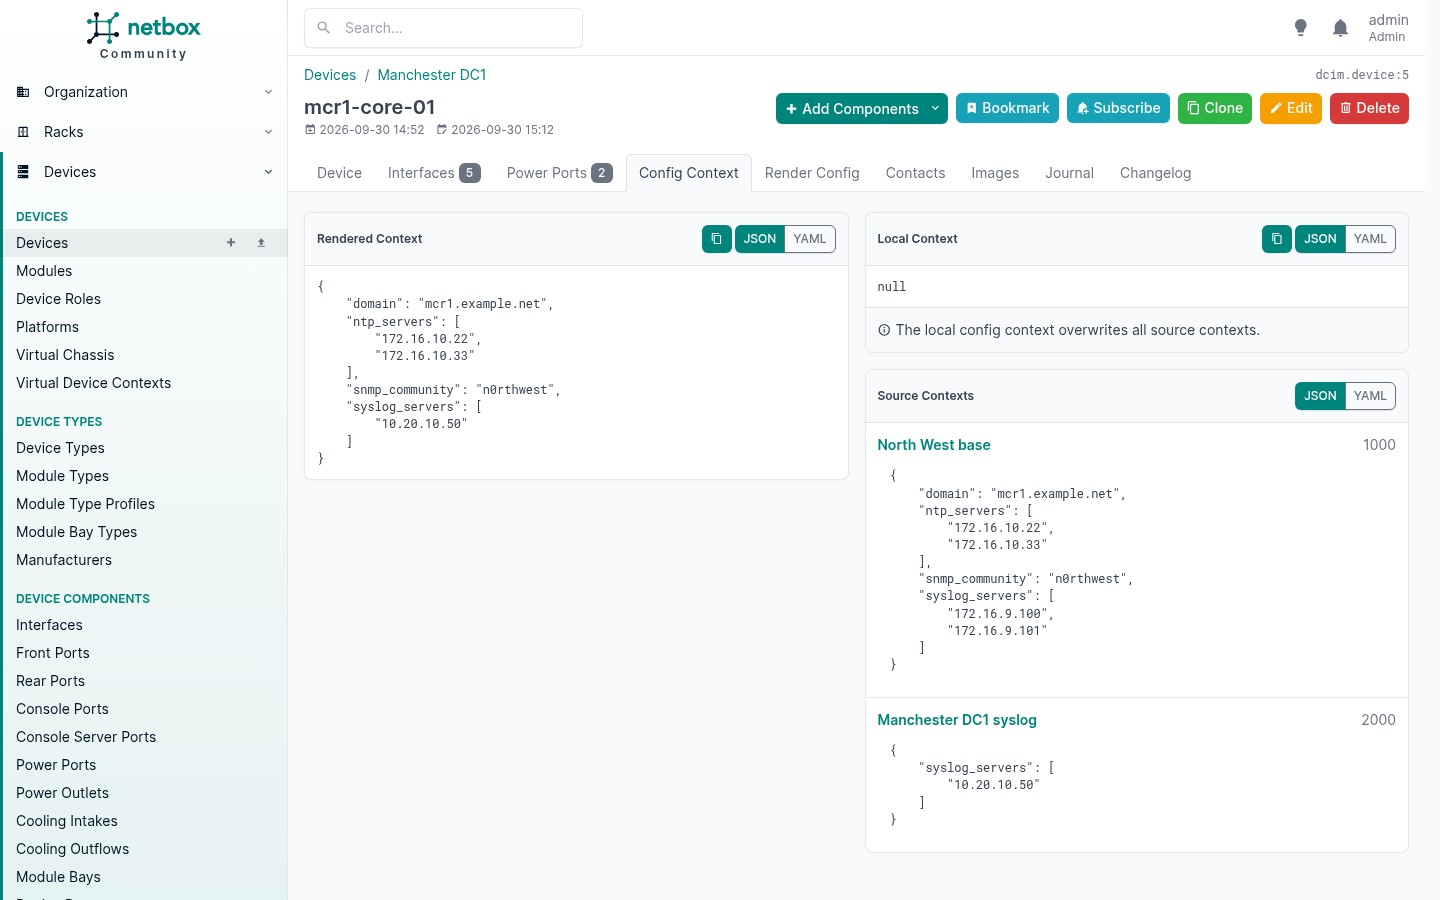
Leggi il pannello di destra accanto a quello di sinistra. La region fornisce quattro chiavi a peso 1000. Il site fornisce una chiave a peso 2000. Il context risultante mantiene intatti il dominio, i server NTP e la community della region, e prende il server syslog del site, perché è l’unica chiave contesa.
Scrivi l’eccezione, non una copia nuova di tutto con dentro l’eccezione. È tutto il valore, ed è il motivo per cui questo scala dove un file di variabili per apparato non scala.
Il local context batte tutto ciò che sta sopra
La pila dell’ereditarietà ha una cima, ed è l’oggetto stesso. I local context data su un apparato vincono su ogni source context che gli si applica, qualunque sia il loro peso.
L’ho impostato su mcr1-core-01:
{"syslog_servers": ["10.20.10.99"], "note": "this box logs somewhere else"}
e il suo context risultante è diventato:
{
  "note": "this box logs somewhere else",
  "domain": "mcr1.example.net",
  "ntp_servers": ["172.16.10.22", "172.16.10.33"],
  "snmp_community": "n0rthwest",
  "syslog_servers": ["10.20.10.99"]
}
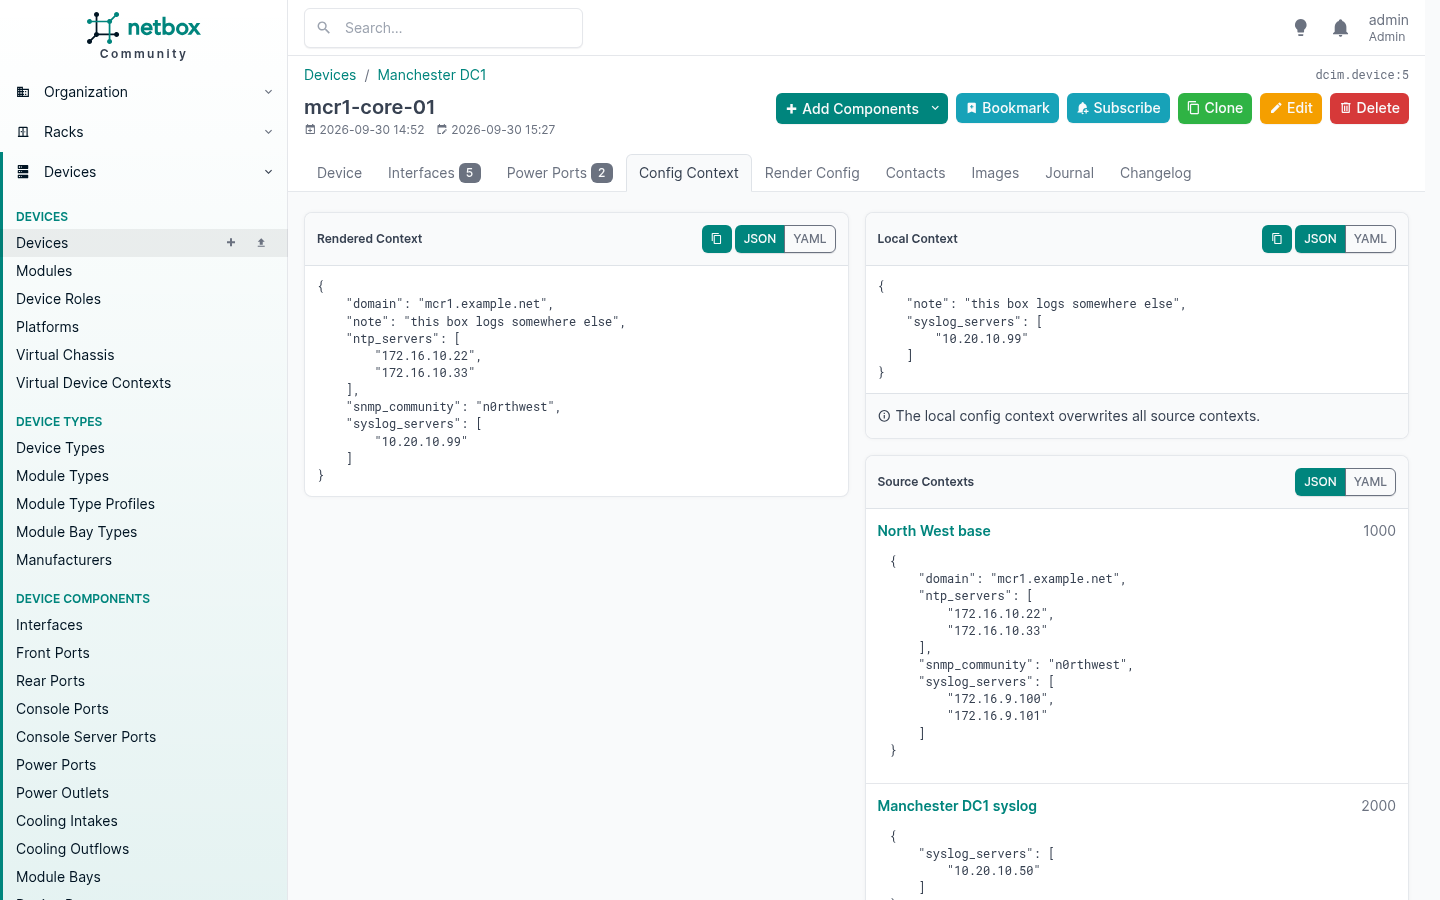
Il server syslog locale ha battuto sia l’override del site a peso 2000 sia la region a peso 1000. Tutto ciò su cui non diceva niente è stato comunque ereditato, quindi il dominio, i server NTP e la community sono passati intatti, e la chiave nuova è stata semplicemente aggiunta.
È la via di fuga per l’unico apparato davvero diverso, e il pannello ti dice chiaramente che sovrascrive tutti i source context. Se ti ritrovi a usarlo su molti apparati invece che su uno, hai trovato una caratteristica che quegli apparati condividono e volevi un context legato a quella.
Tre trappole
Un context senza ambito è globale. Creane uno e dimentica di assegnarlo a qualcosa, e si applica a ogni apparato e macchina virtuale che hai. È un comportamento documentato e ogni tanto è ciò che vuoi. È anche silenzioso.
Le chiavi non possono avere trattini se vuoi raggiungerle in modo semplice. I context data sono JSON quindi ntp-servers è perfettamente lecito, ma i nomi di variabile Jinja non sono chiavi JSON. {{ ntp-servers }} viene interpretato come una sottrazione e solleva UndefinedError: 'ntp' is undefined. Scrivi {{ ntp_servers }} contro dati con il trattino e ottieni una stringa vuota, HTTP 200, e nessun avviso da nessuna parte. Usa gli underscore nelle chiavi e il template ovvio funziona.
Un profilo può fermare i refusi. Un config context profile raggruppa context correlati e impone uno schema JSON sui loro dati al salvataggio. Ne ho dato uno con uno schema che richiede syslog_servers come array di stringhe IPv4, poi ho fatto i due errori che la gente fa davvero:
{"syslog-server": ["10.1.1.1"]}          singular, by accident
  400  Data does not conform to profile schema:
       'syslog-servers' is a required property

{"syslog_servers": [...], "syslog_port": 99999}
  400  Data does not conform to profile schema:
       99999 is greater than the maximum of 65535
Respinti dove qualcuno li ha fatti, invece che quattrocento apparati dopo.
Generare la configurazione
Context data più un template Jinja ti danno un file di configurazione. L’apparato è disponibile come device, il suo context unito è disponibile come variabili normali, e puoi percorrere i suoi componenti.
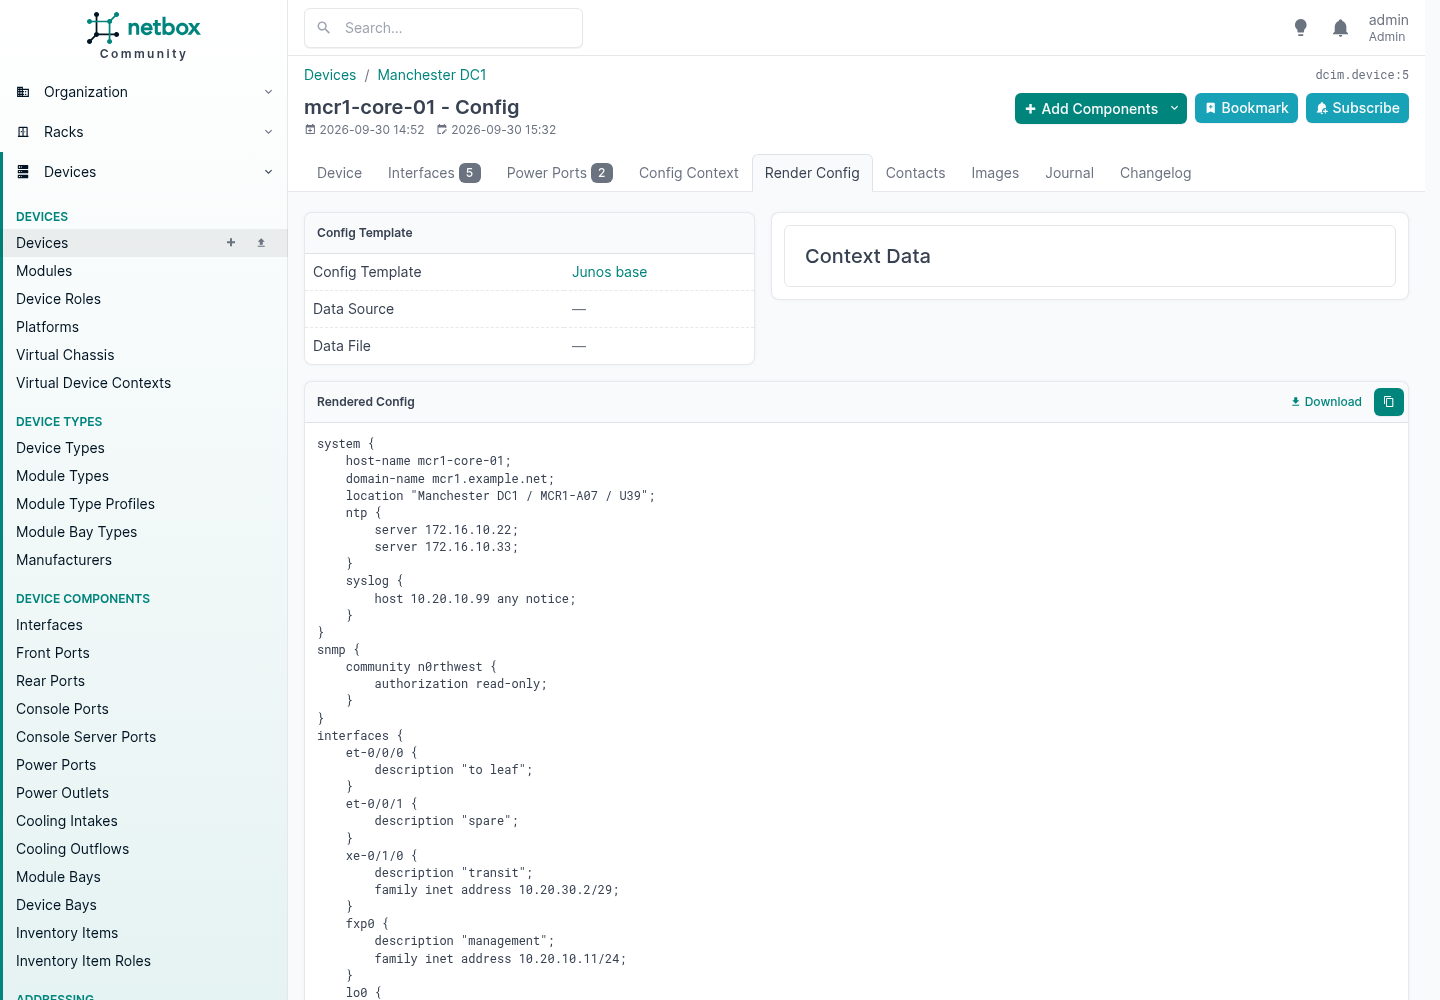
Tutto quello che c’è in quella pagina viene da un posto diverso, ed è proprio questo il punto:
| Riga | Da dove viene |
|---|---|
host-name mcr1-core-01 | l’apparato |
domain-name mcr1.example.net | il config context regionale |
location "Manchester DC1 / MCR1-A07 / U39" | il site, il rack e la posizione al suo interno |
server 172.16.10.22 | il context regionale, peso 1000 |
host 10.20.10.99 any notice | il local context dell’apparato, che batte sia il site sia la region |
family inet address 10.20.10.11/24 | l’indirizzo su quell’interfaccia, con la maschera come è stata scritta |
Il template viene risolto prima sull’apparato, poi sul ruolo, poi sulla platform, e la richiesta fallisce se nessuno dei tre ne ha uno. Quindi assegni un template a una platform una volta, e ogni apparato che fa girare quel software lo genera da lì, a meno che il suo ruolo o l’apparato stesso non dicano altrimenti. A questo serve una platform: il sistema operativo o la famiglia di software del vendor, non l’hardware.
NetBox genera. Non spinge. Portare il risultato sull’apparato è compito della tua automazione, e il giorno in cui un bug in un template avrebbe altrimenti riconfigurato quattrocento apparati, sarai contento che siano due sistemi diversi.
Plugin
Un plugin è un’applicazione Django installata accanto a NetBox. Può aggiungere modelli, aggiungere pagine, estendere entrambe le API, iniettare contenuto nei template esistenti, aggiungere voci di navigazione, aggiungere code di job in background e caricare altre app Django. C’è ben poco che non possa fare, perché sotto è semplicemente Django.
Installarne uno sono quattro comandi e un riavvio:
source /opt/netbox/venv/bin/activate
pip install netbox-topology-views netbox-qrcode
# add the package names to PLUGINS in configuration.py, then
python3 manage.py migrate
python3 manage.py collectstatic --no-input
sudo systemctl restart netbox netbox-rq
Sullo stack di container gli stessi pacchetti vanno in plugin_requirements.txt e ricostruisci l’immagine. In entrambi i casi, fissa le versioni e controlla prima la matrice di compatibilità, perché un plugin che non ha ancora raggiunto una release di NetBox si rifiuterà di avviare l’intera applicazione invece di disattivarsi.
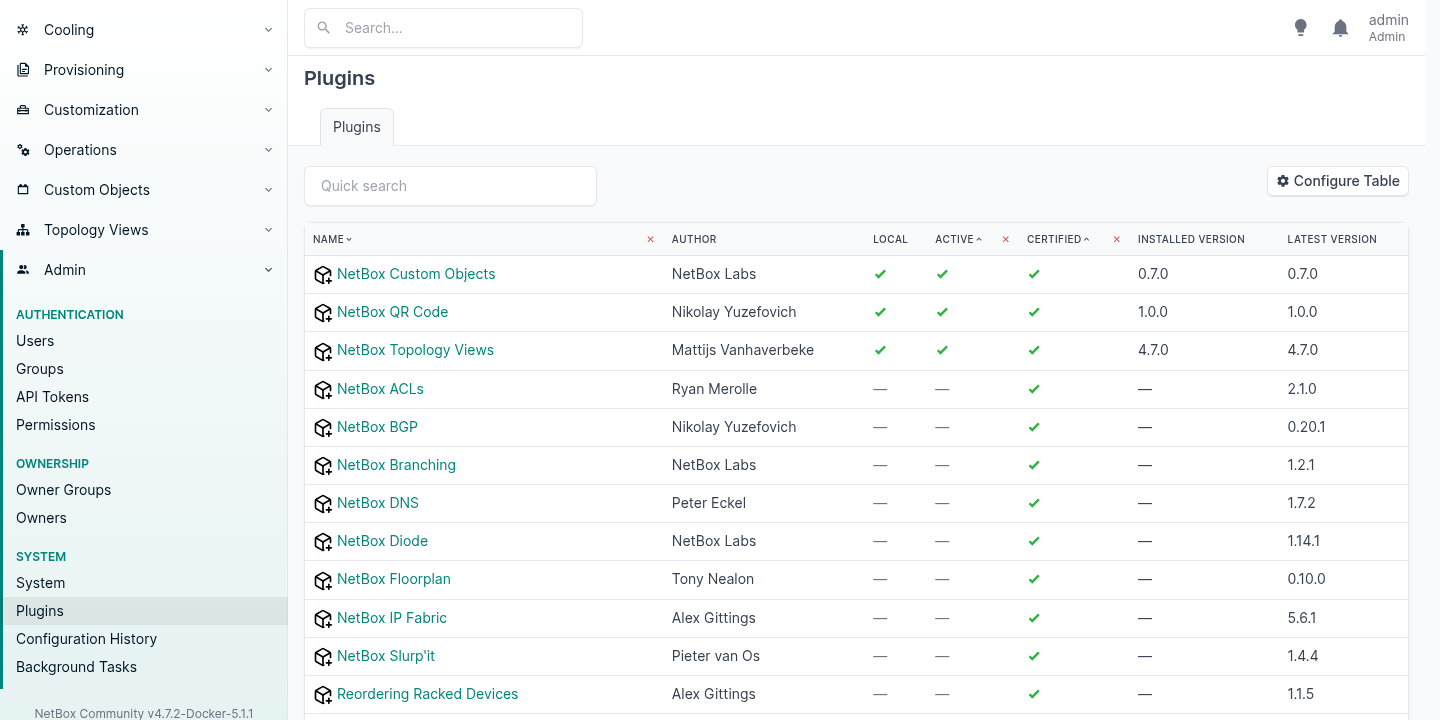
Il catalogo pubblicato ne elenca 31. Questi sono quelli che vale la pena conoscere, con la licenza con cui ciascuno viene effettivamente distribuito:
| Plugin | Cosa fa | Licenza |
|---|---|---|
| DNS | Zone, record e name server come fonte di verità | MIT |
| BGP | Sessioni, community e routing policy | Apache 2.0 |
| Topology Views | Mappe grafiche della topologia costruite dai tuoi cavi | Apache 2.0 |
| Floorplan | Mappe grafiche di site e location | LGPL 3.0 |
| QR Code | Codici su rack, apparati e cavi, per le etichette inventario | Apache 2.0 |
| ACLs | Access list e regole | Apache 2.0 |
| Prometheus SD | Fornisce a Prometheus l’elenco degli host direttamente da NetBox | MIT |
| Documents | Documenti allegati a circuiti e apparati | Apache 2.0 |
| Lifecycle | Fine vita dell’hardware, licenze e contratti | Apache 2.0 |
| Contract | Contratti e fatture | MIT |
| Reorder Rack | Unità rack con drag and drop | Apache 2.0 |
| Branching | Rami isolati e unibili dei tuoi dati | NetBox Limited Use |
| Custom Objects | Nuovi tipi di oggetto, definiti dall’interfaccia | NetBox Limited Use |
Prometheus SD è la forma onesta di tutta l’idea. NetBox sa cosa esiste, quindi lascia che sia NetBox a dirlo al sistema di monitoraggio, e smetti di mantenere un secondo elenco di host che deriva.
Una cosa da sapere prima di costruire sulle ultime due righe. NetBox in sé è Apache 2.0 e lo è da quando DigitalOcean l’ha pubblicato nel 2016, e oggi il progetto è curato da NetBox Labs insieme a un gruppo di maintainer volontari.21 NetBox Branching e NetBox Custom Objects no: sono distribuiti sotto la NetBox Limited Use License 1.0, che concede l’uso «only as part of a NetBox installation obtained from NetBox Labs or a NetBox distributor authorized by NetBox Labs, and only for your own internal use», e che non concede il diritto di usare il software «to provide a managed service or software products that includes, integrates with, or extends NetBox in a way that competes with any product or service of NetBox Labs». Se hai installato NetBox Community da GitHub e lo fai girare per conto di clienti, leggi tu stesso i termini prima di metterci dietro uno schema.10 La guida di installazione di NetBox raccomanda entrambi i plugin senza menzionarlo.11
Custom field
Un custom field aggiunge un attributo a un modello esistente. I valori sono salvati come JSON accanto a ogni oggetto, quindi niente migrazione e niente riavvio, e ci sono tredici tipi, compresi i riferimenti a uno o più oggetti verso altri record di NetBox.
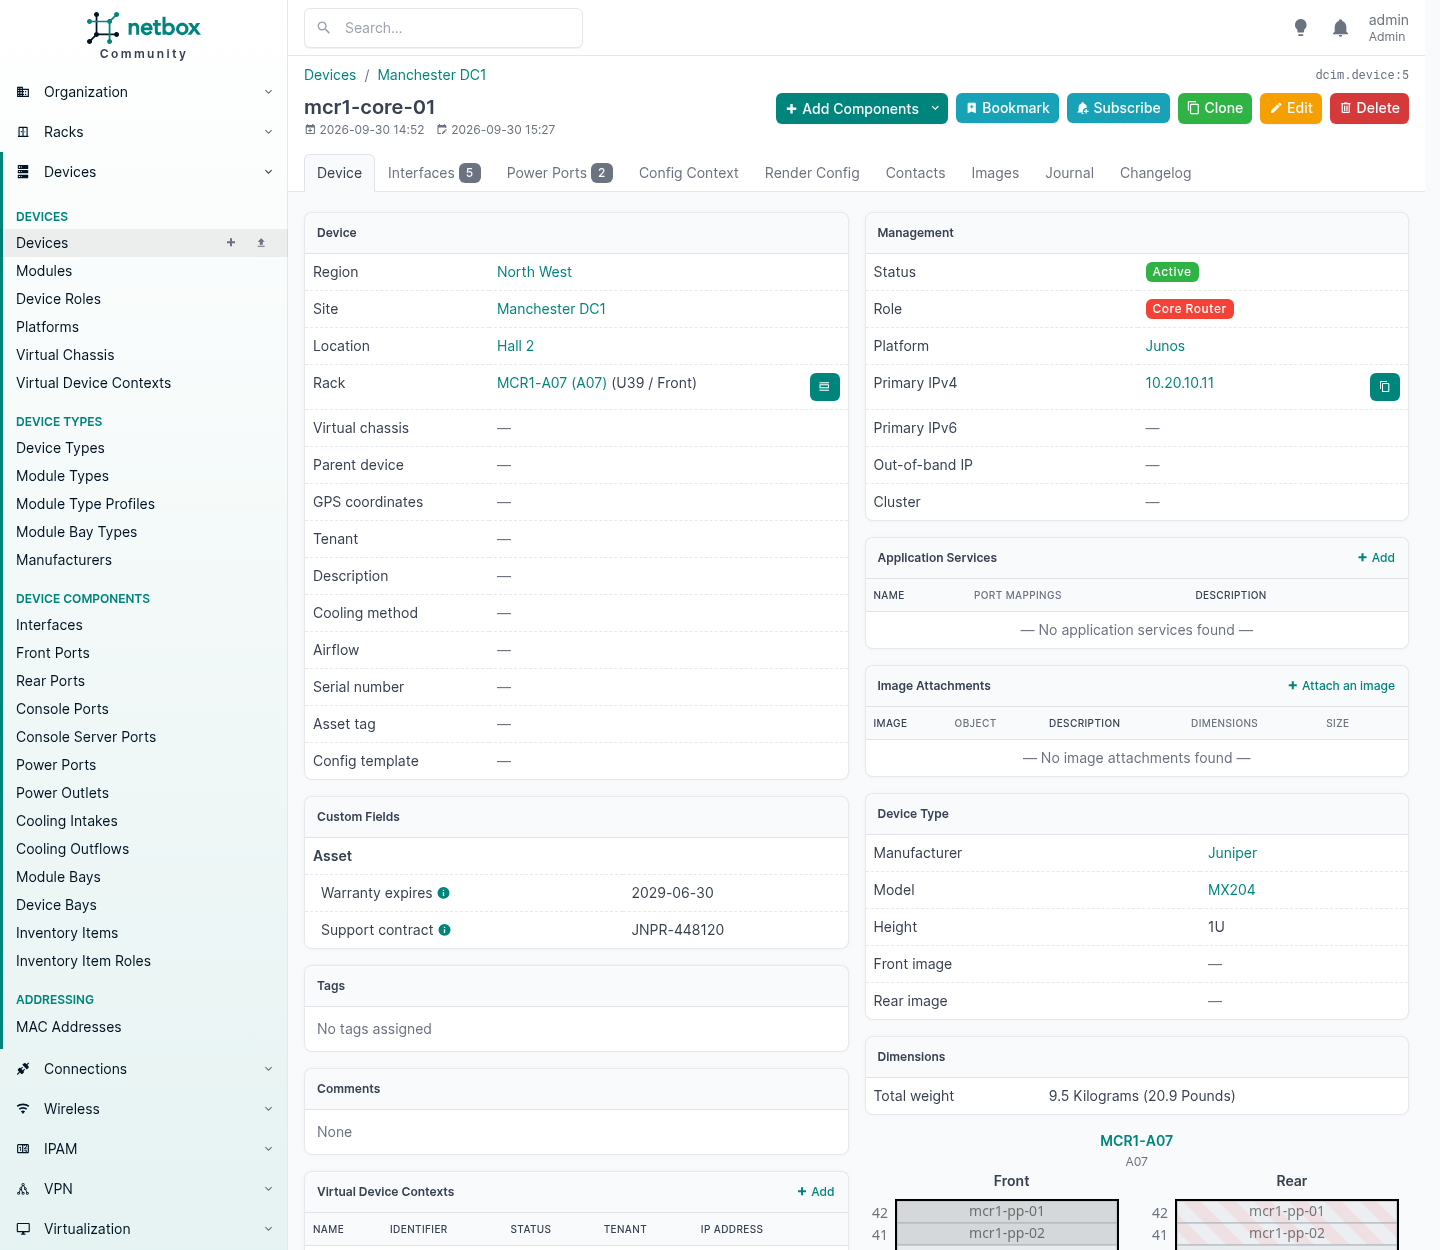
Due campi lì, raggruppati sotto un’intestazione «Asset» che ho scelto io. Nota il pannello Dimensions alla loro destra: 9,5 kg, che nessuno ha scritto su questo apparato. È venuto dal device type.
I custom field sono validati, ed è utile saperlo, perché è una differenza reale rispetto alla strada qui sotto. Ho dato al campo del contratto un’espressione regolare e l’API l’ha fatta rispettare:
PATCH {"custom_fields": {"support_contract": "nonsense"}}
  {"__all__": ["Invalid value for custom field 'support_contract':
                Value must match regex '^[A-Z]{2,4}-[0-9]{6}$'"]}
Due cose cambiate nella 4.7 contano su larga scala. Creare un campo con un valore predefinito, o cancellare un campo, deve riscrivere i dati salvati di ogni oggetto a cui si applica, quindi su una tabella grande quel lavoro viene passato a un job in background e il campo indica «provisioning» o «deleting» mentre gira. Un campo è attivo solo quando è active: durante entrambe le operazioni non compare sugli oggetti, nei moduli, nei filtri o in nessuna delle due API. Serve un worker in esecuzione, altrimenti resta in quello stato all’infinito.
Usa un custom field quando aggiungi un fatto sulla cosa in sé. Usa un config context quando il valore deve scendere a cascata. Usa la sezione successiva quando la cosa che ti serve non esiste.
Menu di selezione personalizzati, e sovrascrivere ciò che arriva di serie
Sotto questo titolo vivono due meccanismi diversi e risolvono problemi diversi. Uno è per i tuoi campi. L’altro riscrive quelli di NetBox.
Un choice set, per il tuo campo di selezione
Un custom field di tipo «selection» prende le sue opzioni da un choice set, che è un oggetto che gestisci dall’interfaccia come qualunque altro. Così «livello di assistenza» diventa un vero menu a tendina invece di testo libero che qualcuno scriverà in tre modi diversi.
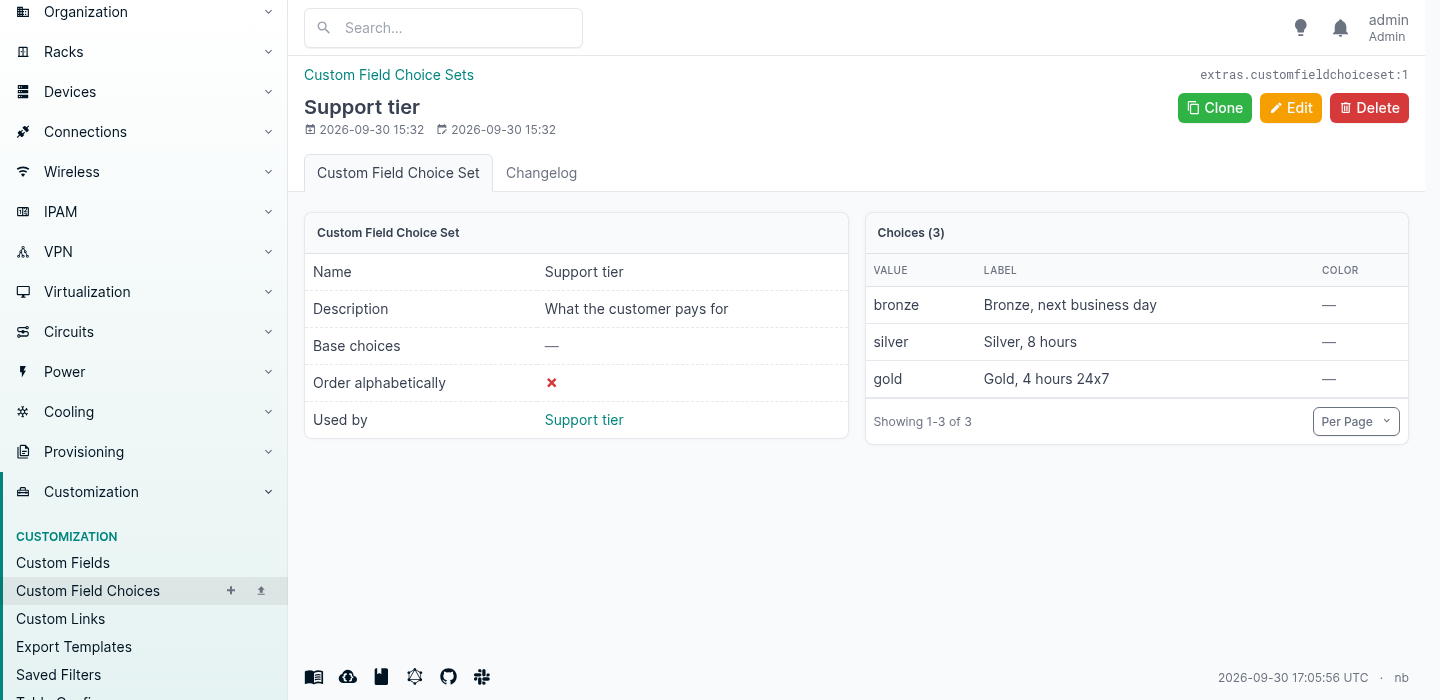
Viene fatto rispettare, anche tramite l’API:
PATCH {"custom_fields": {"support_tier": "platinum"}}
  {"__all__": ["Invalid value for custom field 'support_tier':
                Invalid choice (platinum) for choice set Support tier."]}
I choice set sono condivisi, quindi un set può alimentare lo stesso campo su più modelli, e cambiare l’elenco in un punto lo cambia ovunque.
FIELD_CHOICES, per i campi di NetBox
Questo è quello di cui la gente non sa l’esistenza. Diversi campi di scelta integrati di NetBox possono essere estesi o sostituiti da configuration.py, tra cui lo stato dell’apparato, del site, del rack, del circuito e molti altri.12
Aggiungi un segno più per aggiungere a ciò che arriva di serie. Lascialo fuori per sostituire l’elenco del tutto.
FIELD_CHOICES = {
    # add to what NetBox ships with
    'dcim.Device.status+': (
        ('burn-in', 'Burn-in', 'cyan'),
        {'value': 'awaiting-rma', 'label': 'Awaiting RMA', 'color': 'orange',
         'description': 'Faulty, with the vendor'},
    ),
    # replace the stock list outright
    'dcim.Site.status': (
        ('surveyed', 'Surveyed', 'purple'),
        ('building', 'Building out', 'orange'),
        ('active', 'Active', 'green'),
        ('closing', 'Closing', 'red'),
    ),
}
Ho messo esattamente questo su questa istanza. Lo stato dell’apparato è tornato con i sette valori di serie e i miei due:
offline, active, planned, staged, failed, inventory, decommissioning,
burn-in, awaiting-rma
e lo stato del site è tornato solo con i miei, l’elenco di serie sparito:
surveyed, building, active, closing
Una scelta può essere una semplice tupla di valore, etichetta e colore, oppure un dizionario che accetta anche una descrizione mostrata come sottotitolo nel modulo. E si comportano ovunque come valori nativi, perché per il resto di NetBox sono valori nativi:
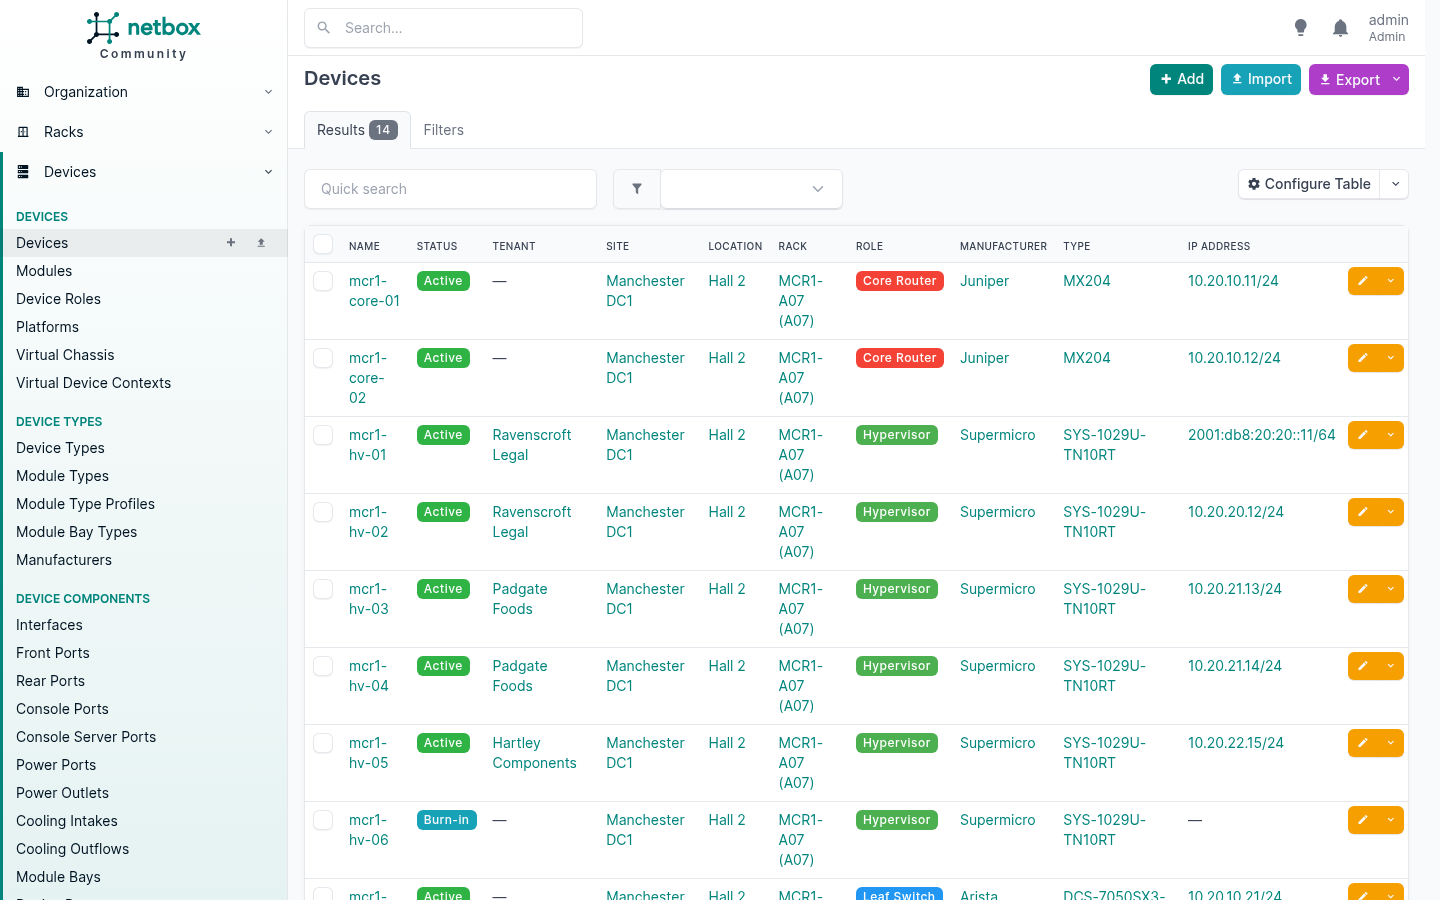
Quel badge è il mio stato, nel mio colore, che si ordina e si filtra come qualsiasi altro.
Tre cose da sapere prima di usarlo.
Sostituire cancella i valori di serie dal menu, non dal database. Ogni oggetto che ne ha già uno lo mantiene, ma il valore non viene più proposto e non sarà una scelta valida la prossima volta che qualcuno modificherà quell’oggetto. Se sostituisci un elenco, controlla che niente stia su un valore che hai appena tolto.
Vive nel file di configurazione, quindi richiede un riavvio e non è qualcosa che un utente dell’interfaccia può cambiare. Per un provider è il verso giusto: l’insieme di stati che la tua azienda riconosce è una decisione di governance, non da martedì pomeriggio.
Estendi prima di sostituire. I valori di serie sono ciò che ogni plugin, script e integrazione si aspetta di vedere. Aggiungere non costa niente. Sostituire è una decisione che ti porti dietro per sempre.
Custom object
Ecco una lacuna vera. NetBox modella cluster, macchine virtuali e dischi virtuali. Non modella il datastore su cui quei dischi vivono davvero, e per chiunque usi Proxmox o VMware è l’oggetto che collega lo storage che hai comprato al carico di lavoro che lo usa.
Il plugin Custom Objects ti permette di definire un nuovo tipo di oggetto dall’interfaccia o dall’API, senza scrivere codice. Quindi:
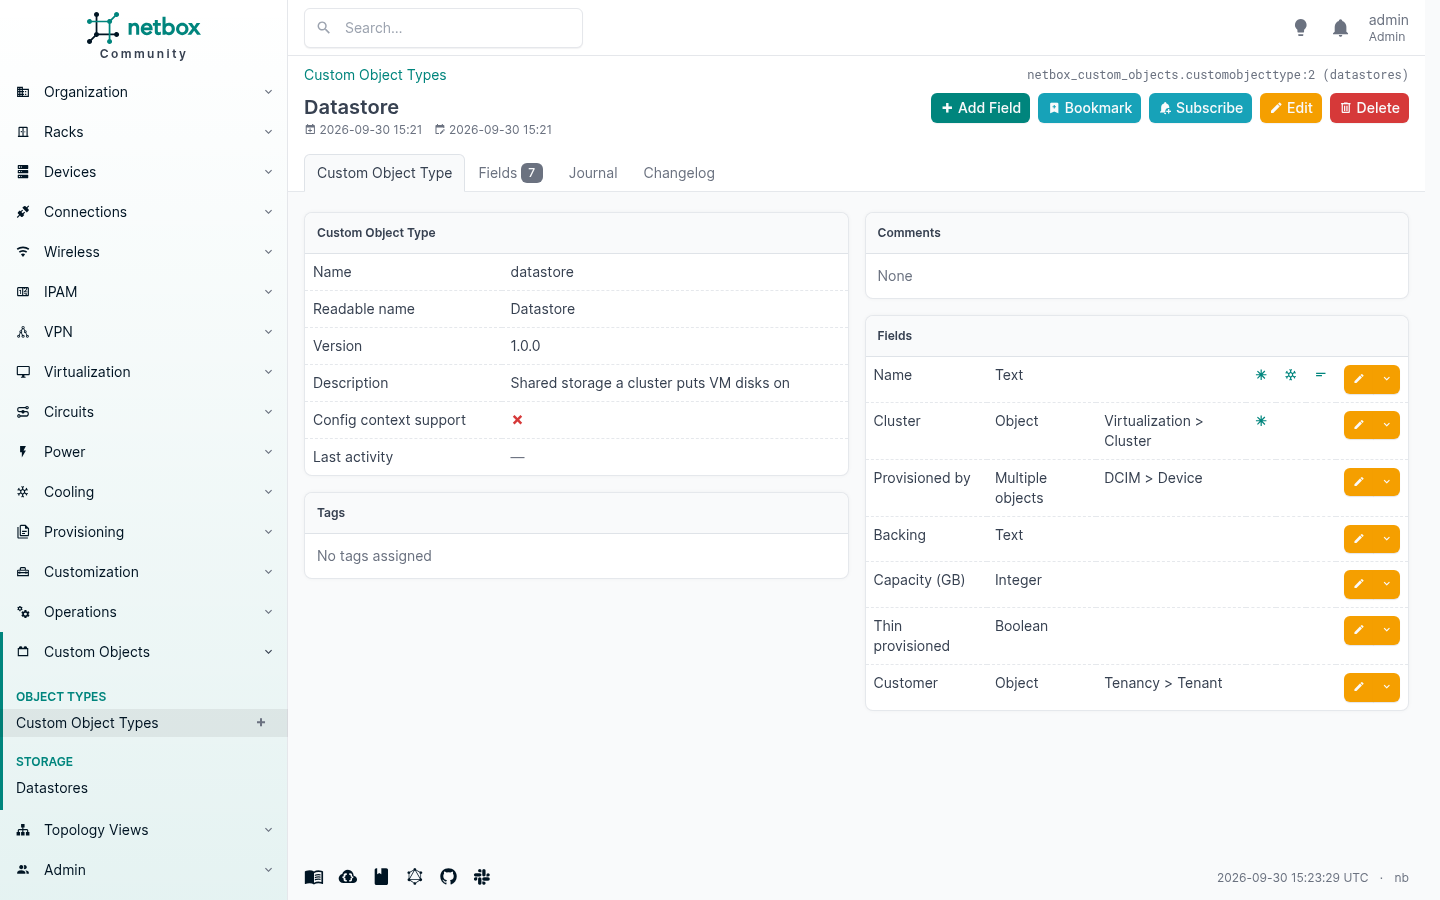
Sette campi, due dei quali sono tutto il senso. cluster è un riferimento a un singolo oggetto, un vero cluster di NetBox, impostato su protect così nessuno può cancellare un cluster da sotto il suo storage. provisioned_by è un riferimento a più oggetti, gli apparati che lo servono davvero.
Questo ti dà un oggetto di prima classe con la sua voce di navigazione, vista elenco, filtri, importazione ed esportazione:
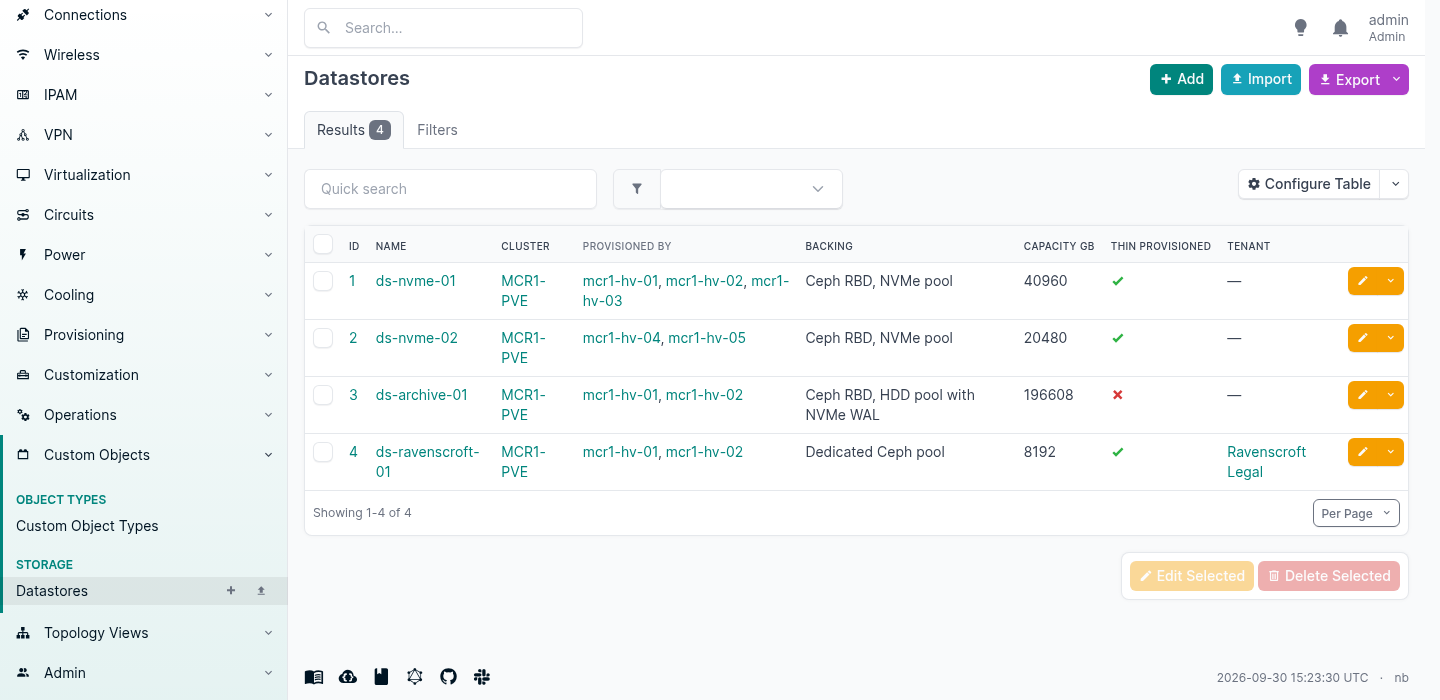
E siccome i riferimenti sono veri, la relazione compare anche dall’altro lato. Apri il cluster e i datastore sono elencati lì.
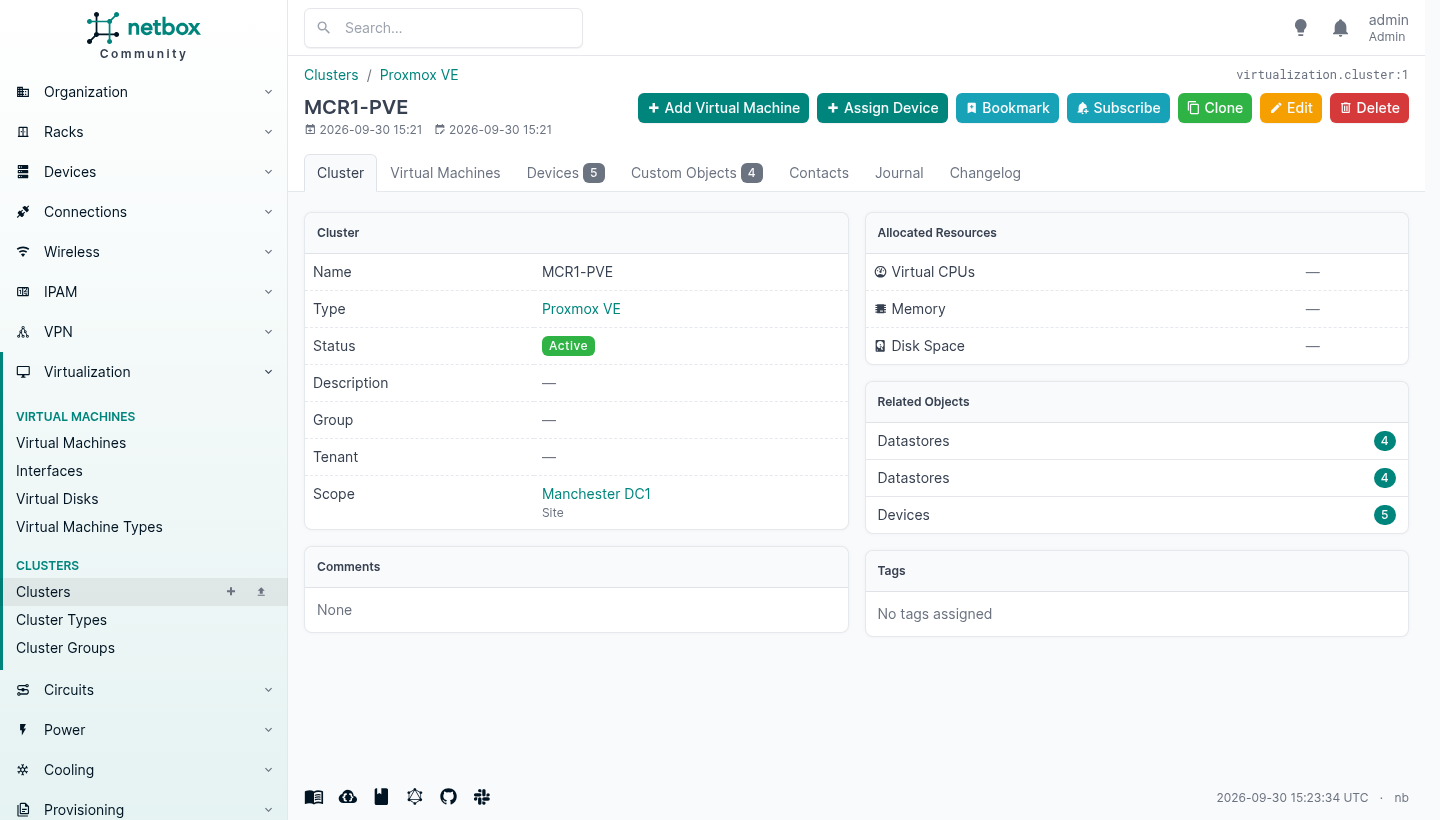
Un custom object type eredita quasi tutto ciò che rende un oggetto NetBox un oggetto NetBox: viste elenco e dettaglio, una voce di navigazione, endpoint REST, ricerca full-text, change log, journal, tag, segnalibri, importazione ed esportazione, event rule e notifiche. Niente di tutto ciò ha dovuto essere scritto.
Non è nemmeno un blob JSON che fa finta di essere una tabella. Il plugin esegue vero DDL, e ciò che compare in PostgreSQL è una vera tabella con veri vincoli:
                    Table "public.custom_objects_2"
     Column      |   Type   | Nullable |     Default
-----------------+----------+----------+------------------
 id              | bigint   | not null | identity
 name            | varchar  |          |
 cluster_id      | bigint   |          |
 backing         | varchar  |          |
 capacity_gb     | bigint   |          |
 thin_provisioned| boolean  |          |
Indexes:
    "custom_objects_2_name_key" UNIQUE CONSTRAINT, btree (name)
Foreign-key constraints:
    ... FOREIGN KEY (cluster_id) REFERENCES virtualization_cluster(id) ON DELETE RESTRICT
Il protect che avevo chiesto è diventato ON DELETE RESTRICT, e funziona: cancellare quel cluster torna con un 409 che nomina ciò che ne dipende.
Due cose da sapere prima di farci affidamento
La validazione è sul modulo, non sull’API. È quella che fregherebbe un’automazione. Ho dichiarato required, un’espressione regolare e limiti numerici sui campi di un custom object type, e poi ci ho scritto tramite la REST API:
| Cosa ho dichiarato | Cosa ho inviato | Risultato |
|---|---|---|
validation_regex | un valore che non corrisponde a niente | 201 Created |
required: true | il campo del tutto omesso | 201 Created |
validation_minimum: 1 | un numero negativo | 201 Created |
unique: true | un duplicato | 400, respinto |
on_delete_behavior: protect | cancellare l’oggetto referenziato | 409, respinto |
I due che hanno tenuto sono i due diventati vincoli del database. Gli altri esistono solo sul modulo web, quindi una persona che scrive è vincolata e una sincronizzazione notturna no. Confrontalo con il custom field di base più sopra, dove la stessa espressione regolare era fatta rispettare tramite l’API. Finché non cambia, metti tutto ciò da cui dipende una fattura dietro un vero vincolo.
Cancellare un tipo elimina una tabella. Cancellare un campo elimina una colonna. È DDL da un modulo web, eseguito da chiunque abbia il permesso, e la documentazione lo dice chiaramente.13 Limita chi può cancellarli.
Quando scrivere invece un plugin vero
Se l’oggetto conta, se l’automazione ci scrive, e se ti arrabbieresti a trovarci dentro spazzatura, scrivi il modello da te. Un plugin NetBox minimo è una PluginConfig, un modello, un serializer, un viewset, una tabella, un modulo, qualche vista e una mappa di URL, e sta sotto le duecento righe, per lo più dichiarazioni. Ereditare da PrimaryModel ti dà gratis tag, custom field, change log, journal, export template e ownership, e ogni vincolo che metti sul modello viene fatto rispettare ovunque, perché lo esegue il meccanismo di serializer di NetBox stesso.
Ci sono un template cookiecutter e un tutorial completo sui plugin mantenuti dalla community. Parti da quelli invece che da una directory vuota.
Ed è sotto la licenza che scegli tu, che nessuno potrà cambiare dopo.
Validazione personalizzata, e classi validator
Tutto quello che c’è sopra riguarda registrare ciò che c’è. Questo riguarda rifiutare di registrare ciò che non dovrebbe esserci.
NetBox valida ogni oggetto prima di scriverlo, e puoi aggiungere regole tue sopra. Ci sono tre meccanismi, vivono tutti in configuration.py, e insieme coprono quasi tutto ciò di cui ha bisogno uno standard interno.
Uno: regole semplici, niente codice
Un validator può essere una semplice mappa da nomi di campo a condizioni. Niente Python, ed è portabile tra installazioni perché sono solo dati.
CUSTOM_VALIDATORS = {
    'dcim.site': (
        {'description': {'required': True}},
    ),
    'dcim.device': (
        {'name': {'regex': r'^[a-z0-9]+-[a-z]+-([0-9]{2}|[a-z])$'}},
    ),
}
Le condizioni disponibili sono min, max, min_length, max_length, regex, required, prohibited, eq e neq. Puoi raggiungere un oggetto correlato con un percorso puntato, quindi region.name su un site è lecito, e puoi fare match su request.user.username, anche se la documentazione giustamente ti dice di usare i permessi per quello.
Entrambe quelle regole scattano subito:
POST a site with no description
  {"__all__": ["Custom validation failed for description:
                ['This field must not be empty.']"]}

POST a device named "Server1"
  {"__all__": ["Custom validation failed for name: ['Enter a valid value.']"]}
La seconda è uno standard di nomenclatura, fatto rispettare. Non scritto su una pagina wiki, non nella testa di qualcuno, non una cosa per cui il nuovo arrivato si prende una ramanzina in una review tre settimane dopo. Il database non la accetta.
Due: una classe validator, quando la regola è una frase
Le regole semplici controllano un campo contro una costante. Le vere regole interne di solito sono condizionali: questo conta solo quando quello. Per quelle erediti da CustomValidator, sovrascrivi validate() e chiami fail().
Ne ho messe tre in un modulo in /opt/netbox/netbox/house_rules.py:
from extras.validators import CustomValidator


class BillableKitNamesItsCustomer(CustomValidator):
    """Anything in a role we sell has to say whose it is."""
    BILLABLE_ROLES = {'hypervisor'}

    def validate(self, instance, request):
        role = getattr(instance, 'role', None)
        if role and role.slug in self.BILLABLE_ROLES and not instance.tenant:
            self.fail(
                f"A {role} is billable kit, so it must name the customer it belongs to.",
                field='tenant',
            )


class RackedDeviceNeedsAPosition(CustomValidator):
    """A device in a rack with no rack unit is a device nobody can find."""
    def validate(self, instance, request):
        if instance.rack and instance.position is None:
            if instance.device_type and instance.device_type.u_height:
                self.fail(
                    "A device in a rack needs a rack unit. Somebody has to find it.",
                    field='position',
                )


class CustomerPrefixNeedsATenant(CustomValidator):
    """A customer prefix that names no customer cannot be billed."""
    def validate(self, instance, request):
        role = getattr(instance, 'role', None)
        if role and role.slug == 'customer' and not instance.tenant:
            self.fail(
                "A customer prefix must be assigned to a tenant.",
                field='tenant',
            )
e le ho collegate tramite percorso puntato:
CUSTOM_VALIDATORS = {
    'dcim.device': (
        {'name': {'regex': r'^[a-z0-9]+-[a-z]+-([0-9]{2}|[a-z])$'}},
        'house_rules.BillableKitNamesItsCustomer',
        'house_rules.RackedDeviceNeedsAPosition',
    ),
    'ipam.prefix': (
        'house_rules.CustomerPrefixNeedsATenant',
    ),
}
Nota che un modello accetta una tupla di validator, regole semplici e classi mescolate liberamente, e girano tutte. Anche un singolo validator va passato come iterabile, ed è un modo facile per perdere cinque minuti.
Poi le regole fanno quello che dicono:
POST a hypervisor with no tenant
  {"tenant": ["A Hypervisor is billable kit, so it must name
              the customer it belongs to."]}

POST a device into a rack with no position
  {"position": ["A device in a rack needs a rack unit.
                Somebody has to find it."]}

POST a prefix with role "customer" and no tenant
  {"tenant": ["A customer prefix must be assigned to a tenant."]}

POST a leaf switch with no tenant
  accepted, because a leaf switch is not in BILLABLE_ROLES
Siccome fail() accetta un field, il messaggio finisce sulla casella giusta del modulo invece che in cima alla pagina, che è la differenza tra una regola che la gente impara e una regola che la gente detesta.
È anche la risposta alla lacuna nella sezione sui custom object. La validazione lì esisteva solo sul modulo web. Un CustomValidator gira nel livello del modello, quindi si applica all’interfaccia, alla REST API, alle mutation GraphQL, alle importazioni di massa e a qualsiasi cosa faccia uno script. C’è un solo posto dove scrivere la regola e nessun modo per aggirarla.
Tre: protection rule, per la cancellazione
CUSTOM_VALIDATORS protegge le scritture. PROTECTION_RULES protegge le cancellazioni, e accetta esattamente le stesse due forme.
PROTECTION_RULES = {
    'dcim.device': (
        {'status': {'eq': 'offline'}},
    ),
}
Questo dice che un apparato può essere cancellato solo quando è offline. Il che produce:
DELETE an active device
  {"detail": "Deletion is prevented by a protection rule:
              [\"Custom validation failed for status:
                ['Ensure this value is equal to offline.']\"]"}

set it to offline, then DELETE
  204 No Content
Due tasti di attrito tra qualcuno e un apparato in produzione, ed è l’assicurazione più economica dell’intera applicazione. Fai in modo che sia il processo di dismissione a sbloccare il pulsante di cancellazione.
Quella che ti fregherà
I dati esistenti non vengono controllati finché non li tocchi di nuovo. Aggiungere una regola non torna indietro a validare ciò che c’è già. Resta lì in silenzio finché qualcuno salva un oggetto che la viola, e allora riceve un errore su una decisione con cui non aveva niente a che fare.
L’ho visto succedere. mcr1-hv-06 era stato creato prima che scrivessi tutto questo, come hypervisor senza tenant. Stava lì tranquillissimo. Poi ho modificato la sua descrizione:
PATCH {"description": "touching it to trigger revalidation"}
  {"tenant": ["A Hypervisor is billable kit, so it must name
              the customer it belongs to."]}
La modifica non c’entrava niente con il tenant. La regola è scattata lo stesso, perché la validazione gira sull’intero oggetto.
È il comportamento corretto ed è anche il modo in cui una regola nuova diventa un ticket di assistenza. Prima di attivarne una, esegui una query per gli oggetti che la violerebbero e sistemali prima. L’API lo rende facile: la regola è un filtro, quindi chiedi gli apparati con quel ruolo e senza tenant, e hai il tuo elenco.
Attiva la regola dopo. Così cattura solo errori nuovi, che è il suo scopo.
Guidarlo da Ansible
Una fonte di verità che nessuno legge marcisce. La collection netbox.netbox è il modo in cui la maggior parte della gente lo evita, e funziona in entrambe le direzioni: NetBox dice ad Ansible cosa esiste, e Ansible dice a NetBox cosa ha costruito.
È alla versione 3.23.0, con licenza GPL-3.0, ed è stata scaricata da Galaxy oltre 13,4 milioni di volte. Contiene 91 moduli e un plugin di inventario.14 Tutto quello che segue è stato eseguito sulla stessa istanza, da un container con dentro solo ansible-core 2.21.4, pynetbox 7.8.0 e la collection.
L’inventario è una query, non un file
Questa è la metà che si ripaga il primo pomeriggio. nb_inventory costruisce il tuo inventario Ansible direttamente da NetBox:
plugin: netbox.netbox.nb_inventory
api_endpoint: http://netbox:8080
token: "{{ lookup('env', 'NETBOX_TOKEN') }}"
config_context: false
group_by:
  - sites
  - device_roles
  - tenants
  - racks
device_query_filters:
  - has_primary_ip: true
Questo produce quanto segue, senza che nessuno mantenga un elenco di host:
@sites_manchester-dc1:      @device_roles_hypervisor:
  |--mcr1-core-01             |--mcr1-hv-01
  |--mcr1-core-02             |--mcr1-hv-02
  |--mcr1-hv-01               |--mcr1-hv-03
  |--mcr1-hv-02               |--mcr1-hv-04
  ...                         |--mcr1-hv-05
@racks_MCR1-A07:            @tenants_ravenscroft-legal:
  |--mcr1-core-01             |--mcr1-hv-01
  |--mcr1-core-02             |--mcr1-hv-02
  ...                       @tenants_padgate-foods:
@device_roles_core-router:    |--mcr1-hv-03
  |--mcr1-core-01             |--mcr1-hv-04
  |--mcr1-core-02           @tenants_hartley-components:
                              |--mcr1-hv-05
Guarda la colonna di destra. Siccome la tenancy è impostata sugli apparati, ottieni gratis un gruppo per cliente, quindi --limit tenants_ravenscroft-legal esegue un play sugli apparati di un solo cliente. Aggiungi un apparato in NetBox ed è nel gruppo all’esecuzione successiva. Dismettine uno ed è sparito. Nessuno modifica niente.
Ogni host arriva con quello che NetBox sa di lui:
ansible_host     "2001:db8:20:20::11"
primary_ip4      "10.20.20.11"
primary_ip6      "2001:db8:20:20::11"
device_roles     ["hypervisor"]
sites            ["manchester-dc1"]
racks            ["MCR1-A07"]
tenants          ["ravenscroft-legal"]
device_types     ["sys-1029u-tn10rt"]
manufacturers    ["supermicro"]
status           {"label": "Active", "value": "active"}
Ventidue chiavi in tutto, e una merita attenzione prima che ti sorprenda. ansible_host è l’indirizzo IPv6, perché quell’apparato ha un v6 primario impostato. L’ho confrontato con altri due che hanno solo il v4 e sono tornati in v4, quindi la regola è che il plugin preferisce il v6 dove esiste un v6 primario. Il che è corretto, ed è anche il tipo di cosa che preferiresti scoprire adesso piuttosto che mentre ti chiedi perché un play si collega su un percorso a cui non avevi pensato.
Scrivere indietro
I moduli sono l’altra direzione, e quello che vale la pena avere è l’assegnazione degli IP, perché NetBox sa cosa è libero e il tuo playbook no.
- name: Rack the device
  netbox.netbox.netbox_device:
    netbox_url: "{{ nb_url }}"
    netbox_token: "{{ nb_token }}"
    data:
      name: mcr1-hv-07
      device_type: SYS-1029U-TN10RT
      device_role: Hypervisor
      site: Manchester DC1
      rack: MCR1-A07
      position: 14
      face: Front
      tenant: Hartley Components
    state: present

- name: Let NetBox pick the next free address out of the customer prefix
  netbox.netbox.netbox_ip_address:
    netbox_url: "{{ nb_url }}"
    netbox_token: "{{ nb_token }}"
    data:
      prefix: 10.20.22.0/24
      tenant: Hartley Components
      assigned_object:
        device: mcr1-hv-07
        name: eno1
    state: new
Nota cosa non c’è. Nessun indirizzo IP. Indichi il prefisso e NetBox ti restituisce il prossimo libero:
TASK [Let NetBox pick the next free address out of the customer prefix] ****
changed: [localhost]

"device   : mcr1-hv-07  (created)"
"interface: eno1  (created)"
"address  : 10.20.22.1/24  (allocated)"
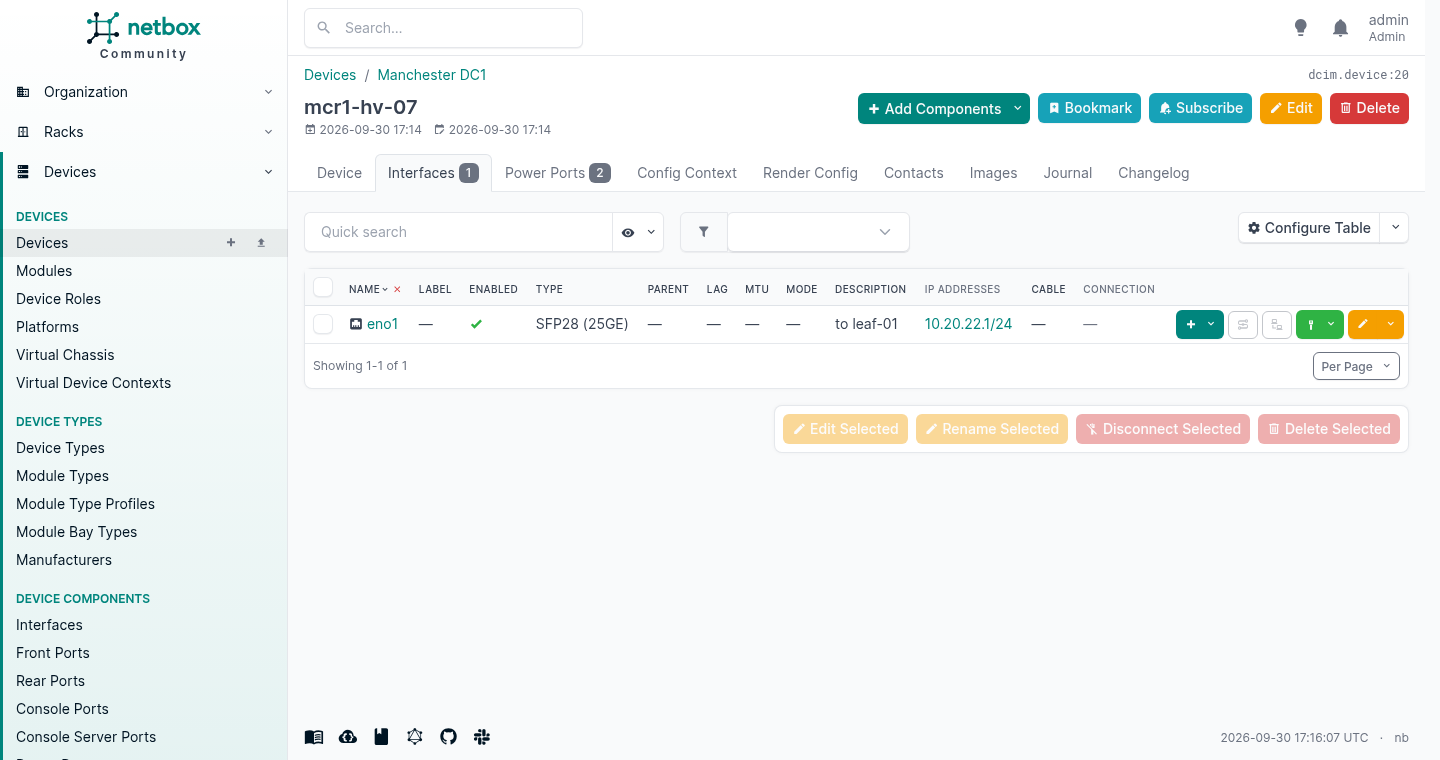
Ed è lì nell’interfaccia un secondo dopo, non ancora cablato a niente ma nel rack, con il tenant e con l’indirizzo:
La trappola in quel playbook
Eseguilo una seconda volta senza cambiare una riga e succede questo:
"device   : mcr1-hv-07  (already correct)"
"interface: eno1  (already correct)"
"address  : 10.20.22.2/24  (allocated)"
L’apparato e l’interfaccia sono idempotenti. L’indirizzo no, e non è un bug. state: present significa «fallo diventare così». state: new significa «dammene uno nuovo», ogni singola volta, ed è esattamente quello che ha fatto: due indirizzi su un’interfaccia dopo due esecuzioni.
Va bene quando stai davvero mettendo in servizio qualcosa di nuovo, e si mangerà in silenzio un prefisso se lo metti in un job che gira ogni notte. Assegna una volta e registra il risultato, oppure usa state: present con l’indirizzo che hai già. Il modulo fa quello che gli hai chiesto. La domanda è se gli hai chiesto quello che intendevi.
Non c’è solo Ansible
La collection riceve l’attenzione perché Ansible è dove sta già la maggior parte dei team di rete, ma il prodotto è l’API e sono tante le cose che la parlano.
| Cosa | Cos’è | Licenza |
|---|---|---|
pynetbox | Il client Python che usa la collection stessa | Apache 2.0 |
terraform-provider-netbox | Gestisce oggetti NetBox come risorse Terraform, mantenuto attivamente da e-breuninger | MPL 2.0 |
nornir_netbox | NetBox come inventario Nornir, per chi lavora in Python invece che in YAML | Apache 2.0 |
| Prometheus SD | Fornisce a Prometheus i target da raccogliere direttamente da NetBox | MIT |
go-netbox | Un client Go, anche se non viene toccato da maggio 2025 | vedi il repository |
| Diode | La pipeline di acquisizione di NetBox Labs per inserire dati scoperti | NetBox Limited Use |
Quello di Terraform è la voce interessante per chi gestisce già l’infrastruttura in quel modo, perché permette a un solo plan di creare la risorsa cloud e il record NetBox che la documenta, invece di lasciare la seconda metà alla memoria di qualcuno.15
Diode ha la stessa licenza di Branching e Custom Objects, quindi vale la stessa lettura prima di costruirci sopra.
Cosa compra davvero il pomeriggio
Tutto quello che c’è sopra mi ha preso una giornata su una macchina, e quasi tutta quella giornata è servita a caricare dati perché le schermate avessero qualcosa dentro. L’installazione è venti minuti in entrambi i modi. Le decisioni sono la parte che conta e si prendono tutte nella prima ora: i tenant prima di tutto, i device type prima degli apparati, i numeri sui tipi e non sugli apparati.
Quello che ottieni in cambio non è documentazione. È una distinzione che nessuno fa finché non ha avuto entrambe le cose: la documentazione è una cosa che scrivi e poi smetti di mantenere. Quello che ottieni è un database che si rifiuta di contenere una contraddizione: non ti lascia mettere due cose in una sola unità rack, o un rack in una location che appartiene a un altro site, o un apparato su un tipo che non esiste. Ognuno di quei rifiuti è una discussione che non farai tra sei mesi.
E ti dirà cose che nessuno gli ha chiesto. Quell’armadio è pieno al 28,6% di apparati e al 90,7% di potenza. Nessuno era partito per scoprirlo. È saltato fuori mettendo una volta un wattaggio su un device type, ed è la differenza tra mettere lì il prossimo ordine e scoprirlo a tue spese.
L’avvertenza onesta è la stessa che ha ogni fonte di verità. Vale solo quanto ti costa tenerla giusta, e l’unica versione di tutto questo che sopravvive a un trimestre pieno è quella in cui qualcosa si rompe in modo visibile quando i dati sono sbagliati. Collega il tuo monitoraggio, il tuo provisioning o le tue regole di firewall perché leggano da lì, e una voce sbagliata smette di essere un problema di documentazione a cui qualcuno prima o poi arriverà. Diventa un disservizio alle nove e mezza di un martedì, con un nome sopra. Sembra un costo. È tutto il meccanismo.
Nessuno ti ringrazierà nemmeno. Un registro corretto si vede come la migrazione che ha preso due settimane invece di un trimestre, l’audit che ha preso un pomeriggio, il cliente che ha avuto una risposta chiara al telefono. Niente di tutto questo compare in un report accanto al tuo nome.
Fallo lo stesso. L’alternativa è un’azienda che non sa descrivere sé stessa, e un’azienda che non sa descrivere sé stessa non viene gestita. Viene ricordata, da sempre meno persone ogni anno.
NetBox, Introduction — «Today, the open source project is stewarded by NetBox Labs and a team of volunteer maintainers», e l’origine in DigitalOcean nel 2015, open source da giugno 2016. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
NetBox, LICENSE.txt — Apache License 2.0, copyright DigitalOcean, LLC. Origine e gestione del progetto dall’introduzione. ↩︎ ↩︎
Nautobot v1.0.0 release notes — «a divergent fork of NetBox 2.10», pubblicate il 26 aprile 2021, e l’elenco di cosa aggiungeva rispetto a NetBox 2.10. ↩︎ ↩︎
Network to Code, “Why Did Network to Code Fork NetBox?”, 25 febbraio 2021 — le ragioni legate agli SLA e al supporto a lungo termine, la divergenza di visione, e «the NetBox project team suggested that we should consider forking». ↩︎
NetBox Labs è stata fondata nel 2023 come spin-out di NS1 dopo la sua acquisizione da parte di IBM, cofondata dal lead maintainer di NetBox Jeremy Stretch, e ha annunciato un Series A da 20 milioni di dollari nell’aprile 2023: NetBox Labs, “Let’s Go: Announcing NetBox Labs” e l’annuncio del Series A. ↩︎
NetBox Labs, NetBox Enterprise — l’edizione commerciale gestita in proprio, con «24/7 expert assistance from the NetBox Labs team»; NetBox Cloud è l’offerta ospitata. I termini specifici degli SLA non sono pubblicati su quella pagina. ↩︎
Stelle e fork, date di rilascio e licenze di entrambi i progetti lette dall’API di GitHub il 30 settembre 2026: netbox-community/netbox e nautobot/nautobot. Le release parallele 3.2.x e 2.4.x di Nautobot sono entrambe datate 28 settembre 2026. ↩︎
netbox-community/netbox-docker — lo stack di container della community, Apache 2.0. ↩︎
NetBox, Installation — la tabella delle versioni supportate, e le note di rilascio della v4.7 per i minimi di PostgreSQL e Redis alzati. Versione ed edizione lette da
netbox/release.yaml. ↩︎NetBox Limited Use License 1.0 — adottata da netbox-custom-objects e, identica, da netbox-branching. Entrambe le clausole citate sono testuali. ↩︎
NetBox, HTTP Server installation, “What’s Next?” — «Some of the most popular plugins include» NetBox Branching, NetBox Custom Objects, NetBox DNS e NetBox BGP, senza alcuna menzione dei termini di licenza. ↩︎
NetBox, Data Validation configuration —
FIELD_CHOICES, e il suffisso con il segno più che estende invece di sostituire: «To replace the available choices, specify the app, model, and field name separated by dots … To extend the available choices, append a plus sign». ↩︎netboxlabs/netbox-custom-objects documentation — «Deleting a Custom Object Type drops an entire database table and should be done with caution.» ↩︎
netbox.netbox su Ansible Galaxy e netbox-community/ansible_modules — versione 3.23.0, GPL-3.0, 91 moduli più il plugin di inventario
nb_inventory. Numero di download letto da Galaxy il 30 settembre 2026. Tutto ciò che è mostrato è stato eseguito con ansible-core 2.21.4 e pynetbox 7.8.0. ↩︎Licenze, attività e numero di stelle letti da ciascun progetto il 30 settembre 2026: pynetbox (Apache 2.0), terraform-provider-netbox (MPL 2.0, v6.0.0-rc.1 sul registry di Terraform), nornir_netbox (Apache 2.0), netbox-plugin-prometheus-sd (MIT), go-netbox (ultimo push il 9 maggio 2025) e Diode, che ha la stessa NetBox Limited Use License 1.0 di Branching e Custom Objects. ↩︎