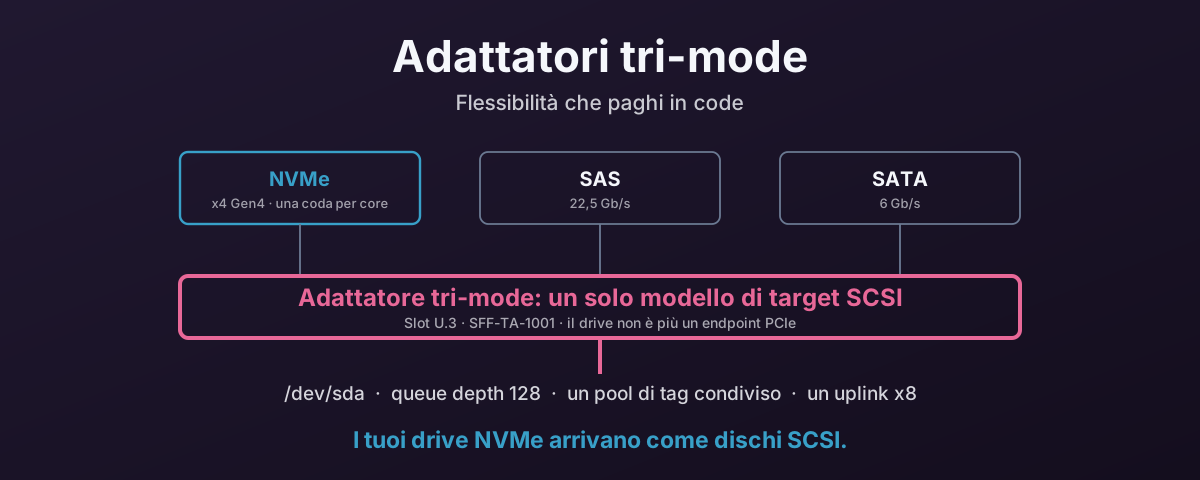
Lo slot che accetta qualsiasi cosa
L’argomento di vendita di un adattatore tri-mode è davvero buono, e vale la pena esporlo per bene prima di smontarlo.
Compra uno chassis con un backplane U.3 e un controller tri-mode, e ogni slot per drive diventa universale. Lo slot 0 può ospitare un drive SAS 24G, lo slot 1 un economico dispositivo di boot SATA, lo slot 2 un SSD NVMe Gen4, e l’adattatore negozia qualunque cosa si presenti. Broadcom chiama il silicio Tri-Mode SerDes; lo standard degli slot è SFF-TA-1001, noto come U.3, che definisce un connettore comune per SAS x1/x2, SATA e NVMe a x1, x2 o x4. Il lato gestione è SFF-TA-1005, Universal Backplane Management, che è il modo in cui l’enclosure capisce con cosa sta effettivamente parlando e accende i LED di attività giusti.
Per chiunque specifichi server, questo risolve un problema vero e fastidioso. Non devi più decidere il protocollo di storage al momento dell’ordine, né tenere due codici di chassis, né scoprire che gli slot compatibili NVMe sono i quattro a sinistra e i tuoi drive sono finiti negli altri venti. Un solo codice prodotto copre tutto il parco macchine, e un’installazione SAS può passare a NVMe un drive alla volta invece che uno chassis alla volta.
Niente di tutto questo è marketing. È il motivo per cui questi adattatori si vendono, e sarebbe sciocco far finta di no.
Ma la flessibilità non è gratis, e il conto non si paga in sterline. Si paga in code.
Cosa succede davvero al drive
Un SSD NVMe è un endpoint PCIe. In un server con collegamento diretto, le sue quattro lane arrivano al root complex della CPU, magari passando da un retimer o da uno switch PCIe, ma elettricamente e logicamente è un dispositivo sul bus PCIe. Il kernel lo enumera, ci lega il driver nvme, e da quel momento il driver parla direttamente con i registri del drive.
Metti lo stesso drive dietro un adattatore tri-mode e questo smette di essere vero.
Adesso le lane del drive terminano sul controller. La documentazione di Broadcom chiama il blocco in questione PCIe device bridge, e la parola bridge fa parecchio lavoro: non è uno switch trasparente che inoltra le transazioni della CPU a un drive che la CPU vede ancora. L’endpoint PCIe che il tuo host enumera è l’adattatore. Il drive è un target appeso dall’altra parte, e il firmware del controller rigenera ogni I/O.
Quindi l’adattatore non fa passare i tuoi comandi NVMe. Li termina, e parla con il drive al posto tuo.
Il che solleva la domanda di quale protocollo parli con te.
Il sistema operativo non vede mai un drive NVMe
Parla SCSI.
Collega un SSD NVMe a un HBA tri-mode Broadcom e non compare come /dev/nvme0n1. Compare come /dev/sdb, legato a mpt3sas, lo stesso driver che da più di dieci anni fa girare i controller SAS LSI. nvme list non restituisce niente. lsblk -o NAME,TRAN riporta come trasporto sas. Per ogni livello dello stack di storage sopra il driver, hai comprato un disco SAS.
Non è un bug né un limite del firmware in attesa di correzione. È il progetto. Presentare tutto come target SCSI è esattamente il modo in cui un solo adattatore serve tre protocolli: il controller normalizza SAS, SATA e NVMe in un unico modello di dispositivo, e l’host ottiene un solo driver, un solo percorso di enumerazione, un solo insieme di strumenti. La flessibilità del marketing e la presentazione SCSI in dmesg sono la stessa decisione architetturale vista dai due capi.
Le generazioni 9500 e 9600 aggiungono in effetti un meccanismo di passthrough perché gli strumenti del produttore possano raggiungere i comandi admin NVMe di un drive, e i componenti più recenti di Broadcom mostrano lo stato di salute dei drive molto meglio del 9400. Ma è un canale laterale di gestione. Il percorso dei dati, ogni lettura e scrittura che il tuo carico di lavoro emette, scorre ancora lungo lo stack SCSI.
E lo stack SCSI ha un modello di code che precede la flash di vent’anni.
Il modello di code a cui hai appena rinunciato
Questa è la parte che ti costa davvero prestazioni, e conviene essere precisi, perché «NVMe è più veloce di SAS» non è il motivo.
La decisione progettuale centrale di NVMe non era un filo più veloce. Era smettere di fingere che un dispositivo di storage sia una cosa sola e serializzata.
La specifica consente fino a 65.535 coppie di code di I/O, e quella cifra viene citata in ogni spiegazione di NVMe che si trovi in giro. È il numero sbagliato da tirare fuori. Nessun drive implementa niente di simile, quindi chiunque abbia davvero guardato un sistema in funzione può liquidare il confronto, e avrebbe ragione. Il numero vero è più piccolo, poco affascinante, e spiega meglio il punto.
Ecco allora un drive vero. Non un componente enterprise: un SSD OEM SK Hynix da 256 GB, del tipo saldato in un portatile di fascia media, in una macchina da 16 core.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Diciassette code: una coda admin, e sedici code di I/O per sedici core. Ognuna profonda 1023 comandi. La corrispondenza è uno a uno, ogni coda hardware è legata a esattamente una CPU:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Una CPU per coda, fino in fondo: la coda hardware 0 serve il core 1 e nient’altro.
Ecco cosa vuol dire in pratica «NVMe ha tante code». Non 65.535: una per core, quanti che siano i tuoi core. Linux crea una coppia di code per CPU fino a quante il controller ne concede, e i controller ne concedono molte più dei core di un server tipico, quindi in pratica il numero è quello dei core. Metti questo drive in una macchina da 64 core e ne ottieni 64.
È da quella suddivisione per core che vengono le prestazioni:
- Un core inserisce i comandi nella sua coda. Nessun lock, perché nessun altro core la tocca.
- Ogni coda ha il suo vettore MSI-X, con affinità per quel core.
- L’interrupt di completamento torna sul core che ha emesso l’I/O, dove stanno già le linee di cache che servono.
- Tutti e sedici i core possono avere I/O in volo nello stesso momento senza mai contendersi una struttura condivisa.
Il parallelismo cresce con il numero di core, e il lavoro di un core non finisce mai in coda dietro quello di un altro. Lo fa un drive consumer economico. È il minimo sindacale.
Adesso guarda cosa ottiene il drive dietro l’adattatore. I numeri qui sotto non sono stime: sono costanti nel driver mpt3sas del kernel mainline.
La queue depth per dispositivo viene impostata da ioc->max_nvme_qd, che il driver prende da ciò che riporta il firmware del controller e, in mancanza, da un default fissato a compilazione in drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. A un dispositivo capace di decine di migliaia di comandi in sospeso viene data una queue depth di 128, e nota che è meno profonda del default SAS di 254 che sta due righe sopra. Le capacità del drive non entrano mai nella decisione. Il numero viene dal controller.
Il numero di code hardware è peggio, e il driver lo dice apertamente. Da mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Leggilo con attenzione, perché ci sono tre cose distinte.
Il default è una sola coda hardware. nr_hw_queues = 1. Il multi-coda c’è solo sui controller gen35 con la funzione host_tagset attiva, e anche allora è quello che la cronologia dei commit del driver stesso descrive come code hardware multiple simulate: l’hardware del controller di I/O è una sola coda di invio con più code di risposta, e blk-mq ci viene adattato sopra.
Il numero di code viene dal controller, non dal numero di core. È reply_queue_count meno le code high-IOPS, cioè l’allocazione dei vettori MSI-X dell’adattatore. Non ha niente a che fare con quante CPU hai, e non cresce quando aggiungi drive. È l’esatto rovescio del drive di prima, dove il numero di code era il numero di core.
E il pool di tag è condiviso. host_tagset significa esattamente quello che dice: un solo pool di tag per tutto l’adattatore host, e quella riga di log dice «shared» ad alta voce. Ogni drive sulla scheda pesca dallo stesso insieme di posti per i comandi. Uno chassis da ventiquattro slot ha ventiquattro drive in competizione per i tag di un solo controller.
Mettili uno accanto all’altro. Quell’SSD del portatile aveva sedici code private da 1023, una per core, che rispondevano solo a lui. Lo stesso drive dietro l’adattatore ottiene una quota delle code di risposta della scheda, 128 comandi in sospeso, e ventitré vicini che pescano dallo stesso pool.
Quindi la perdita non è che SCSI sia lento. Lo SCSI moderno su blk-mq va bene. La perdita è strutturale:
- Le code appartengono all’adattatore, non al drive. Aggiungere drive divide una risorsa fissa invece di aumentarla.
- Il pool di tag è condiviso su tutto l’host. Un drive sotto carico pesante può affamare gli altri, in un modo che semplicemente non può succedere quando ogni drive ha le sue code.
- La profondità per dispositivo è limitata a 128, qualunque cosa il drive riesca a sostenere.
- La località degli interrupt si indebolisce. I completamenti arrivano sulla coda di risposta che il controller ha usato, non per forza sul core che ha inviato.
Con una queue depth di 1 o 2, un processo a thread singolo che legge ogni tanto, niente di tutto questo si nota. Misurerai la stessa latenza in entrambi i casi, entro il rumore. La penalità compare esattamente dove hai comprato NVMe perché ti aiutasse: molti core che emettono molti I/O concorrenti. Più è profondo il carico, più è grande la parte del drive che hai pagato e che non riesci a raggiungere.
L’uplink è un solo slot x8
Il modello di code è il problema sottile. Il tetto di banda è quello evidente, e lo puoi leggere nelle schede prodotto di Broadcom senza bisogno di un benchmark.
L’HBA della serie 9500 è una scheda PCIe Gen 4.0 x8. Le cifre pubblicate da Broadcom sono 13.700 MB/s in lettura sequenziale a 256K e 3M IOPS in lettura casuale a 4K. La stessa scheda prodotto dice che supporta fino a 32 dispositivi NVMe.
Metti quei due numeri uno accanto all’altro e la domanda si risponde da sola: quanti drive servono per esaurire l’adattatore?
Non molti, e meno ogni anno. Un SSD Gen4 x4 fa circa 7 GB/s. Un SSD Gen5 x4 ne fa circa 14. Sono entrambi componenti normali nel 2026: Gen4 è ciò di cui è pieno il mercato dell’usato U.2, e Gen5 è quello che trovi comprando nuovo.
| Tetto | Drive Gen4 per raggiungerlo | Drive Gen5 per raggiungerlo |
|---|---|---|
| HBA 9500: 13.700 MB/s sequenziali | 2 | 1 |
| HBA 9500: 3M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600: 6,4M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600: 1,1M IOPS in RAID 5 (4K RW) | ~1 | ~1 |
Rileggi la prima riga. Un solo SSD Gen5 raggiunge l’intero tetto sequenziale di un HBA 9500. Un drive, in una scheda dichiarata per trentadue. Tutto quello che viene dopo è capacità. Non prestazioni.
E l’ultima riga è quella che dovrebbe fermare un ordine d’acquisto: sul MegaRAID della generazione attuale, uno scaffale pieno di NVMe in RAID 5 rende più o meno quanto un drive di fascia media da solo.
I drive non si collegano nemmeno a x4
C’è un secondo strozzamento sotto l’uplink condiviso, facile da non vedere perché sta in una tabella di specifiche e non in un titolo.
La PERC 12 User’s Guide di Dell, che copre i controller tri-mode H965i, dice:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Ogni drive NVMe ha due lane, non quattro. Quindi prima di qualsiasi contesa per l’uplink, prima del pool di tag, prima della traduzione SCSI, un drive Gen4 è già sceso a circa 3,5 GB/s: metà di quello che può fare. Metti un drive Gen5 in quello slot e negozia al ribasso fino a Gen4 x2, rendendo più o meno un quarto della banda dichiarata.
Conviene essere precisi su cosa questo cambia e cosa no. Non significa che l’adattatore arrivi più lontano. Servono circa quattro drive limitati a x2 per riempire l’uplink del 9500 invece di due, ma solo perché ogni drive contribuisce la metà. Il collo di bottiglia si è spostato dall’uplink al collegamento del drive. Il totale che riesci a estrarre non è migliorato.
Con collegamento diretto, quegli stessi trentadue drive avrebbero ciascuno il proprio percorso x4 fino al root complex, alla generazione che drive e CPU riescono a negoziare.
La riga RAID 5 di quella tabella merita uno sguardo a sé, perché è il numero della stessa Broadcom ed è pubblicato senza giri di parole. Dalla scheda prodotto della serie 9600:
900K to 1.1M RAID 5 IOPS (4K RW)
Il RAID con parità nel firmware del controller è la cosa più costosa che puoi chiedere a una scheda tri-mode, e questa è la generazione attuale che lo fa. Vale la pena leggerlo prima che qualcuno specifichi un RAID 5 su ventiquattro drive NVMe e si aspetti le prestazioni di ventiquattro drive.
E una scheda x16?
L’obiezione ovvia a tutto quanto sopra è che il 9500 è una scheda x8 Gen4, e il tetto è un artefatto di un collegamento all’host stretto. Dai all’adattatore sedici lane Gen5 e il problema sparisce.
È un’obiezione onesta, e merita l’esempio più forte, non un fantoccio. Prendiamo allora la PERC13 H975i di Dell: la generazione attuale, e quanto di meglio offra il tri-mode. La sua guida utente indica «Gen 4 and Gen 5 PCIe x16 host interfaces», e StorageReview ha misurato 52,5 GB/s e 12,5M IOPS per controller, con fino a sedici drive NVMe.
Sono numeri seri, e cambiano parecchio il quadro. Rispetto ai 13.700 MB/s e ai 3M IOPS del 9500, sono circa quattro volte la banda e quattro volte gli IOPS, distribuiti su metà dei drive. Dell non ha solo allargato il tubo: ha anche dimezzato il fan-out, e il rapporto di sovrasottoscrizione è migliorato di conseguenza. Sugli IOPS in particolare, 12,5M su sedici drive sono circa 780K per drive, vicino a quanto rende un drive di fascia media da solo. A quel punto il controller non è davvero quello che ti frena.
Merito a chi lo merita, allora: una moderna scheda tri-mode x16 Gen5 è un pezzo di ingegneria molto migliore di una x8 Gen4, e se la banda era la tua unica obiezione, x16 in buona parte ti risponde.
Tre cose non le risolve.
I drive si collegano ancora a x2. Questa mi ha sorpreso. La guida della PERC13, che descrive un controller Gen5 x16, dice ancora:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Un collegamento all’host più largo non allarga i collegamenti a valle verso i drive. Ogni drive NVMe sul controller RAID tri-mode più nuovo e veloce che Dell venda è ancora collegato da due lane invece di quattro, e rinuncia ancora a metà della sua banda prima che succeda qualsiasi altra cosa.
Il modello di code non viene toccato per niente. Niente nella sezione sulle code di questo articolo dipende dalla larghezza del collegamento all’host. nr_hw_queues viene dall’allocazione delle code di risposta MSI-X del controller; la profondità per dispositivo di 128 è una costante di driver e firmware; il pool di tag è condiviso su tutto l’host perché lo dice host_tagset. Allarga il collegamento all’host a x16, x32, quanto vuoi: i drive sono ancora target SCSI che condividono le code della scheda, non c’è ancora /dev/nvme0n1, e non puoi ancora passare un drive a una VM.
E x16 non fabbrica banda: smista lane che avevi già. Questo è l’argomento che chiude davvero la questione. Sedici lane Gen5 in una PERC13 ti comprano 52,5 GB/s condivisi su sedici slot. Quelle stesse sedici lane collegate direttamente a quattro drive Gen5 a x4 ti comprano circa 56 GB/s su quattro slot: la stessa banda dalle stesse lane, solo che ogni drive ha il suo x4 completo, la sua coppia di code per core e un vero nodo dispositivo nvme.
Quindi il modo onesto di descrivere una scheda tri-mode x16 non è «un adattatore più veloce». È un multiplexer di lane: converte un budget fisso di lane in più slot per drive, e ti fa pagare la conversione con il modello di code. Se l’affare conviene dipende da una cosa sola. Slot o parallelismo.
Cosa succede quando riempi tutti gli slot
Il che ci porta al caso che conta davvero, perché nessuno compra uno chassis da 24 slot per metterci quattro drive.
Oltre il punto di saturazione, la linea aggregata è piatta. Aggiungere drive aggiunge capacità, e nient’altro, quindi le prestazioni per drive scendono come 1/N. Con popolazioni realistiche quell’aritmetica non perdona:
| Drive su un HBA 9500 | Aggregato | Per drive | Frazione di un drive Gen4 |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98% |
| 12 | 13,7 GB/s | 1,14 GB/s | 16% |
| 24 | 13,7 GB/s | 0,57 GB/s | 8% |
Guarda l’ultima riga. Ventiquattro drive NVMe dietro un HBA 9500 rendono circa 570 MB/s ciascuno. Un SSD SATA fa circa 550. Hai comprato ventiquattro drive NVMe, hai pagato un controller tri-mode per collegarli, e sei arrivato a una banda per drive da SATA.
L’aritmetica degli IOPS ha la stessa forma: 3M distribuiti su ventiquattro drive sono 125K ciascuno, contro il milione che un drive Gen4 di fascia media fa da solo, circa un ottavo di quello che possiedi.
La scheda x16 migliora parecchio la cosa ma non ne esce. Una PERC13 con tutti e sedici i drive fa 52,5 GB/s ÷ 16 = 3,3 GB/s per drive, circa il 23% di un drive Gen5, e questo prima che il collegamento x2 lo dimezzi di nuovo.
Con molti drive, due effetti sono peggiori di quanto suggerisca la divisione:
- La fame di tag è trasversale ai dispositivi. Il pool di tag condiviso dell’host significa che un solo drive sotto carico pesante può consumare posti che servono ad altri drive. Ventiquattro dispositivi, ciascuno autorizzato in teoria a 128 comandi in sospeso, ne vogliono 3.072 in tutto, pescati dal
can_queuedi un solo controller. Il blocco in testa alla coda tra drive distinti è un modo di guastarsi che semplicemente non esiste quando ogni drive possiede le sue code. - I rebuild colpiscono tutto. Un rebuild di parità su uno scaffale popolato satura l’unico uplink condiviso, quindi l’I/O in primo piano verso ogni altro drive della scheda peggiora nello stesso momento. Con i drive su lane indipendenti e il RAID software, il rebuild si contende la CPU, non un unico tubo.
Quando niente di tutto questo conta
C’è un contrappeso importante, ed è il motivo per cui tanti server tri-mode da 24 slot girano benissimo.
Il tetto dell’adattatore morde solo se qualcosa a valle può consumare più di quanto lui consegna. Un server con 2 × 25GbE ha 6,2 GB/s di rete: non riesce a riempire nemmeno un HBA 9500. Se quei ventiquattro drive sono un livello di capacità che serve file su quel collegamento, l’adattatore è lontanissimo dall’essere il collo di bottiglia e l’aritmetica per drive qui sopra è irrilevante.
Il momento in cui comincia a contare è quando il consumatore diventa più veloce della scheda: 100GbE (12,5 GB/s) ti mette da solo alla pari con l’intero tetto sequenziale di un 9500, e i carichi locali (database, compilazione, analytics, host di virtualizzazione con guest indaffarati) non hanno proprio una rete nel percorso.
Quindi la domanda da fare su uno scaffale popolato non è «l’adattatore è lento?» ma «cosa consumerà tutto questo, e può consumare più di quanto la scheda riesce a consegnare?» Se la risposta è un collegamento a 25GbE, smetti di preoccuparti. Se la risposta è 100GbE, NVMe-oF o un database locale, la scheda è il tuo collo di bottiglia e il numero di drive lo sta peggiorando.
Cos’altro sparisce
Oltre alla velocità, presentare un drive NVMe come disco SCSI significa che le parti specifiche per NVMe dei tuoi strumenti smettono di funzionare:
| Collegamento diretto | Dietro un adattatore tri-mode | |
|---|---|---|
| Nodo dispositivo | /dev/nvme0n1 | /dev/sdb |
| Driver | nvme | mpt3sas / mpi3mr |
nvme-cli | Funziona | Non ha con chi parlare |
| Dati di salute | Pagine di log SMART NVMe | Pagine di log SCSI tradotte |
| Gestione dei namespace | Sì | No |
| Aggiornamenti firmware | nvme fw-download | Strumento del produttore attraverso il controller |
| Format / sanitize | NVMe Format NVM | Equivalenti SCSI, se implementati |
| Code hardware | Una coppia per core (16 sulla macchina qui sopra) | Le code di risposta della scheda, condivise da ogni drive |
| Queue depth | 1023 per coda | 128 per dispositivo |
Una conseguenza coglie la gente impreparata abbastanza spesso da meritare una menzione a parte: non puoi passare un singolo drive a una macchina virtuale. Il PCIe passthrough richiede che il drive sia un endpoint PCIe con il suo gruppo IOMMU, e dietro un adattatore tri-mode non lo è: l’unico dispositivo PCIe presente è il controller. Puoi passare l’intero adattatore, con ogni drive collegato, o niente. Se il tuo piano prevedeva di assegnare drive NVMe specifici a guest specifici, la scelta del backplane ha già deciso per te.
Allora chi lo vuole davvero nel 2026?
È qui che l’argomento di vendita all’inizio di questo articolo deve affrontare una domanda più dura, perché il mondo per cui era stato pensato è in gran parte sparito.
Il tri-mode è nato quando NVMe era il livello costoso che aggiungevi a un’installazione SAS. Nel 2026 è il contrario: NVMe è il default, i drive enterprise U.2 sono abbondanti ed economici sul mercato dell’usato, e «SAS, SATA e NVMe misti in uno chassis» descrive sempre meno installazioni reali. Quindi chi lo sta davvero comprando?
Quasi nessuno, di proposito. La risposta onesta è che la maggior parte dei controller tri-mode non è stata scelta. È arrivata, perché il produttore del server ne monta uno, e il produttore ne monta uno perché un solo codice di backplane U.3 permette a lui di vendere configurazioni SAS, SATA e NVMe dallo stesso chassis. È una vittoria di filiera per l’OEM. Per le tue prestazioni non fa niente, e per questo non è mai stato venduto come se lo facesse.
Tre delle giustificazioni classiche non reggono più bene:
«Mi servono tipi di drive misti.» Raramente nello stesso chassis, e anche quando serve, il tri-mode non è l’unica strada. Un semplice HBA SAS per i dischi meccanici più NVMe collegati al root complex ti dà entrambi, senza penalizzare nessuno dei due. Un parco misto non implica un controller misto.
«Non ho abbastanza lane PCIe.» Questo era il vero argomento nel 2019, su piattaforme da 40 lane con 24 slot. Un Epyc Genoa o Turin a socket singolo ha 128 lane. Ventiquattro drive a x4 fanno 96. La scarsità che giustificava il raggruppamento dei drive dietro un controller è praticamente sparita, e dove non lo è, uno switch PCIe fa il lavoro senza terminare il protocollo.
«Gli slot devono essere universali.» Questo conviene separarlo con cura, perché è l’argomento usato più spesso per giustificare il componente sbagliato. U.3 è uno standard di backplane, non un requisito del controller. Un backplane U.3 può essere cablato direttamente alle lane PCIe della CPU invece che attraverso un controller tri-mode, e i produttori documentano entrambe le topologie. Puoi tenerti gli slot universali e togliere la tassa. Se hai ereditato un server tri-mode, la cosa singola più utile che puoi verificare è se il backplane può essere ricablato in diretta.
Cosa resta davvero:
- RAID hardware ad alta densità, dove una policy o la piattaforma lo richiedono: un requisito di audit, una matrice di supporto, un’installazione Windows o ESXi senza un livello software che faccia il lavoro. Questo è il vero mercato rimasto, è l’unico caso in cui stai comprando il motore RAID e non la connettività, e sul silicio attuale è un prodotto capace: sedici drive NVMe in RAID 5 hardware con una cache protetta da supercondensatore, da sedici lane, è qualcosa che il collegamento diretto non può offrire affatto.
- Capacità in massa su HDD SAS, dove il costo per TB appartiene ancora nettamente ai dischi meccanici. Ma quello è il lavoro di un semplice HBA SAS, e più economico.
- Numeri di slot molto grandi ed enclosure esterni, dove gli expander SAS arrivano più lontano e più in largo del PCIe.
- Carichi che non vanno mai in profondità. Se le tue queue depth restano a una cifra, niente di tutto questo si nota. Tanti sistemi reali vivono qui benissimo.
C’è anche un argomento puramente operativo: un solo tipo di enclosure, un solo driver, un solo ricambio sullo scaffale. Per un host di virtualizzazione generico vale qualcosa di concreto. Basta dargli un prezzo onesto contro il fatto che, secondo la tabella qui sopra, un solo drive Gen5 può raggiungere l’intero tetto sequenziale della scheda.
Quando è lo strumento sbagliato
Lo scambio peggiora in proporzione a quanta concorrenza ha il tuo carico di lavoro.
Ceph è il caso più chiaro. Un nodo di storage fa girare un OSD per drive, ciascuno con i suoi pool di thread, tutti a emettere I/O nello stesso momento, e poi i client di un intero cluster li sollecitano in parallelo. È il caso peggiore del pool di tag condiviso: ventiquattro demoni che si contendono i posti per i comandi di un solo controller, ogni drive limitato a 128 in sospeso, tutto incanalato in un solo uplink x8. Metti quei drive direttamente sul root complex e ogni OSD ha le sue code, i suoi tag e le sue lane. Un nodo Ceph tutto NVMe non dovrebbe avere un adattatore tri-mode nel percorso dei dati.
La stessa logica vale per i target NVMe-oF, dove riesporti i drive e ogni livello di serializzazione si somma; per i database con I/O asincrono profondo; e per qualsiasi cosa costruita su io_uring o SPDK, che esistono proprio per sfruttare le code per core che l’adattatore ti ha appena tolto.
La regola generale: più parallelismo il tuo software è stato scritto per sfruttare, più un adattatore tri-mode te lo fa pagare.
Come capire cosa hai
Se hai ereditato un server e vuoi sapere da che parte stai:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
L’ultimo stampa la riga Max SCSIIO MPT commands: N shared with nr_hw_queues = M citata prima. Se nvme list è vuoto su una macchina che ti hanno detto essere tutta flash NVMe, il motivo è l’adattatore.
In breve
Un adattatore tri-mode converte i tuoi drive NVMe in dischi SCSI. Quella conversione non è un effetto collaterale. È il modo in cui una scheda serve tre protocolli, ed è quello che stai comprando.
Quello a cui rinunci è specifico e misurabile: coppie di code per core sostituite dalle code di risposta condivise di un controller, una profondità per dispositivo di 128, un pool di tag diviso tra tutti i drive della scheda, un collegamento x2 dove il drive voleva x4, e un solo uplink condiviso dove prima ogni drive aveva il suo percorso fino al root complex. L’adattatore smette di essere un collegamento e diventa il collo di bottiglia, e sull’hardware attuale lo diventa in fretta: due drive Gen4 raggiungono un HBA 9500, quattro drive Gen5 raggiungono perfino una PERC13.
Un collegamento all’host più largo aiuta, una scheda x16 Gen5 ha circa quattro volte la banda e gli IOPS di una x8 Gen4, ma non cambia la forma. Compra slot, non parallelismo: le stesse sedici lane collegate direttamente a quattro drive rendono la stessa banda senza nessuna tassa sulle code. E non salva uno scaffale pieno. Ventiquattro drive dietro un 9500 ottengono circa 570 MB/s ciascuno, che è quello che fa un SSD SATA.
Nel 2019, quando NVMe era il livello che aggiungevi a un’installazione SAS e le piattaforme erano a corto di lane, era uno scambio ragionevole. Nel 2026 di solito non lo è. NVMe è il default, i drive U.2 usati costano poco, un Epyc a socket singolo ha lane in abbondanza, e l’unico vantaggio che regge ancora, gli slot universali, appartiene al backplane U.3, non al controller. Molto spesso puoi tenerti gli slot e togliere la tassa cablando il backplane direttamente alla CPU.
Quindi compra un adattatore tri-mode se stai comprando il suo motore RAID e ne hai bisogno. Non comprarlo per la flessibilità, e se ne hai ereditato uno in uno chassis pieno di NVMe, vai a vedere come è cablato quel backplane.
Non ha senso pagare due volte dei drive che poi non puoi usare come si deve.