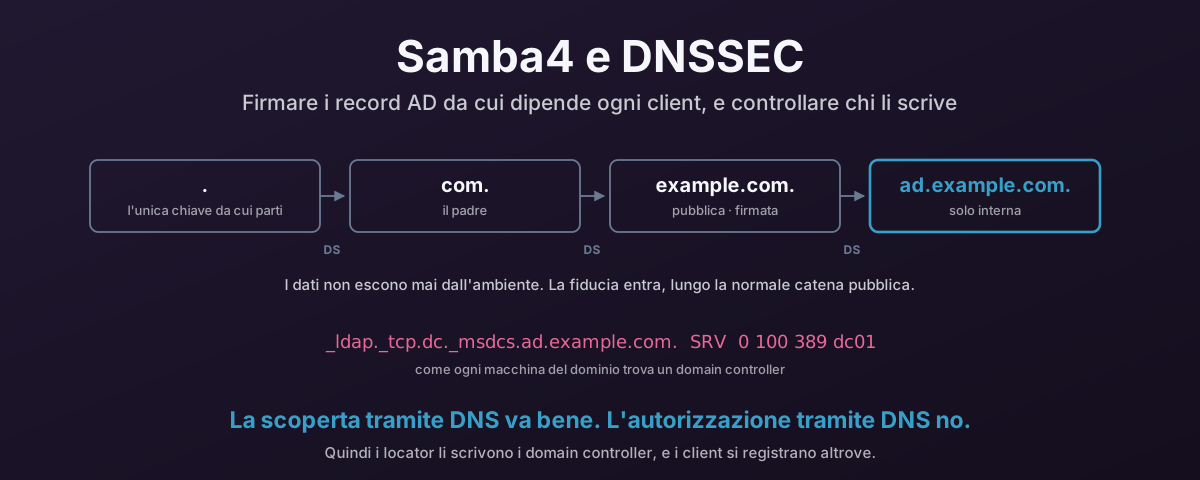
Ogni macchina di un dominio Active Directory trova il suo domain controller chiedendo a DNS. Non da un elenco configurato. Chiede un record SRV e va dove la risposta la manda. Il che rende una manciata di record sotto _msdcs la cosa più critica per la sicurezza dell’intera zona, e solleva due domande che meritano una risposta seria: come li firmi, e chi ha il permesso di scriverli. Nessuna delle due viene posta spesso, e a tutte e due si risponde male per impostazione predefinita.
Questo articolo risponde a entrambe per un domain controller Samba4. BIND con dlz_bind9 che serve la directory, inline signing, un primario nascosto che nessun client raggiunge mai, una delega dentro una zona pubblica perché la catena di fiducia arrivi fino alla radice, e gli aggiornamenti dinamici dei client tenuti ben lontani dai locator.
Ma la firma vale qualcosa solo se sai cosa protegge, e questo vuol dire partire un livello più in basso: da come viene risolto un nome in primo luogo. Quindi il primo terzo dell’articolo è la discesa dalla radice. Se la conosci già a memoria, salta a I due backend DNS di Samba.
Un resolver parte sapendo quasi nulla
Vale la pena di essere chiari su quanto poco un resolver sappia alla nascita, perché tutto il resto dell’articolo discende da questo.
Un resolver ricorsivo appena installato sa due cose. Conosce gli indirizzi dei root server: un file di hint, tredici nomi da a.root-servers.net a m.root-servers.net, serviti in anycast da molte più istanze di tredici. E, se valida, conosce una sola chiave pubblica: quella della radice.
Questa è tutta la configurazione incorporata. Ogni altro fatto che servirà mai (quali server sono autoritativi per uk, dove vive il tuo dominio, che indirizzo ha il tuo mail server) lo impara a runtime chiedendo, e poi lo tiene in cache finché non scade il suo TTL.
È un buon progetto. Nessuno deve distribuire un elenco dei name server di internet, e nessuna autorità centrale deve approvare una modifica alla tua zona. Ma ha una conseguenza di cui parla il resto dell’articolo: un resolver crede a quello che gli dice qualunque server a cui l’ha indirizzato la risposta precedente. Togli le firme e l’intera struttura è una catena di affermazioni, ciascuna autenticata solo dal fatto di essere arrivata dall’indirizzo indicato dalla risposta precedente. È un bel peso da appendere a un indirizzo del mittente.
La discesa lungo l’albero
Una ricerca non è una sola domanda. È una serie di rinvii giù per l’albero dei nomi, e ogni passo è una query separata a un server diverso.
Supponiamo che un client voglia dc01.ad.example.co.uk. Un resolver con la cache vuota fa questo:
- Chiede a un root server. La radice non conosce la risposta e non finge di conoscerla. Restituisce un rinvio (referral): una sezione answer vuota e, nella sezione authority, i record
NSdiuk, con gli indirizzi di quei name server come glue nella sezione additional. - Chiede a un server di
uk. Un altro rinvio, stavolta ai name server diexample.co.uk. - Chiede a un server di
example.co.uk. Sead.example.co.ukè delegato (e nel progetto più avanti lo è), un altro rinvio ancora. - Chiede a un server di
ad.example.co.uk. Questo è autoritativo per il nome, quindi risponde con il recordAe imposta il bit AA (authoritative answer).
Tre cose di questa discesa contano più avanti.
Il rinvio è la delega. Il padre di una zona non ne contiene il contenuto. Contiene record NS che dicono «chiedi là» e, una volta entrata in gioco la firma, un record DS che dice «ed ecco l’impronta della chiave che dovresti aspettarti quando lo fai». La delega è l’unico meccanismo strutturale che DNS possiede, ed è quello che userai per tenere interna una zona interna.
Quasi tutto finisce in cache. I rinvii della radice e dei TLD hanno TTL lunghi, quindi un resolver con la cache calda salta direttamente al passo tre o quattro. Ecco perché la cache di un resolver vale la pena di essere attaccata: avveleni una voce e hai dirottato tutto ciò che sta sotto di essa per tutto il TTL che hai scelto.
Il nome completo non viene inviato a ogni server. Con la QNAME minimisation, un resolver chiede alla radice solo di uk, non di dc01.ad.example.co.uk. Utile da sapere se un giorno vai a cercare i tuoi nomi interni in un log di query a monte. Non dovrebbero esserci.
Stub, ricorsivo, autoritativo
Tre parole che vengono usate come sinonimi e indicano lavori piuttosto diversi. La distinzione regge tutta la metà dell’articolo dedicata ad Active Directory, quindi vale la pena di fissarla.
| Cosa fa | Percorre l’albero? | Contiene dati di zona? | |
|---|---|---|---|
| Stub resolver | La libreria o il servizio locale che le tue applicazioni chiamano. Chiede a un solo server configurato e prende la risposta. | No | No |
| Forwarder | Passa le query a un altro resolver, mette in cache le risposte. | No | No |
| Resolver ricorsivo | Fa la discesa descritta sopra, mette in cache ogni passo, facoltativamente valida le firme. | Sì | No |
| Server autoritativo | Risponde per le zone che gli sono state affidate, e solo per quelle. Dice «non lo so» su tutto il resto. | No | Sì |
La riga importante è l’ultima. Un server autoritativo non ha nessun motivo di fare ricorsione, e un resolver ricorsivo non ha nessun motivo di essere autoritativo. Combinarli è il modo per ottenere una macchina che accetta domande arbitrarie dai client e allo stesso tempo contiene dati da cui quei client dipendono: esattamente la macchina che non vuoi sia il tuo domain controller.
Su un desktop Linux moderno c’è un altro livello di cui tenere conto. systemd-resolved esegue uno stub listener sull’indirizzo di loopback e scrive un resolv.conf che punta a se stesso, con options edns0 trust-ad. Quel trust-ad è quello da notare: dice allo stub di credere al bit AD (authenticated data) nelle risposte di quel server. Il bit AD da solo non prova nulla: è l’affermazione del resolver a monte di aver validato lui. Fidarsene è ragionevole quando il resolver a monte è tuo e il tratto fino a lui è affidabile, e non ha senso altrimenti.
Come vengono trovati davvero i servizi
Un record A risponde a una sola domanda: che indirizzo ha questo nome. Non dice nulla su quale porta usi il servizio, quale tra più server preferire, o cosa fare quando il primo è giù.
I record SRV rispondono a tutte e tre. Da RFC 2782, la forma è:
_service._proto.name. TTL IN SRV priority weight port target
Ogni campo si guadagna il suo posto:
- I prefissi con underscore tengono le etichette di servizio in uno spazio dei nomi tutto loro.
_tcpnon può mai collidere con un host che si chiama davverotcp, perché un nome host non può iniziare con un underscore. - Priority è l’ordine di failover: il valore più basso viene provato per primo. I server con un numero di priorità più alto vengono usati solo quando tutto ciò che sta sotto è irraggiungibile.
- Weight ripartisce il carico all’interno di una stessa priorità. Una coppia con peso 100 e peso 300 riceve circa un quarto e tre quarti dei client. È un’estrazione proporzionale, non un round-robin.
- Port libera il servizio da un numero noto a priori, ed è così che un client trova un server LDAP sulla 3268 senza che nessuno lo abbia scritto a mano.
- Target deve essere un nome con record
AoAAAA. RFC 2782 dice esplicitamente che non deve essere un CNAME, e che un singolo target.significa «questo servizio qui deliberatamente non è offerto»: una cosa utile da pubblicare apposta.
È questo che rende un dominio individuabile invece che configurato. Una macchina unita al dominio non ha un elenco dei tuoi domain controller. Ha un nome di dominio, e chiede.
I nomi che Active Directory pubblica
Un dominio AD, dal punto di vista di un client, è soprattutto un insieme di record SRV. L’albero sotto _msdcs è la parte interessante, perché è il modo in cui i client distinguono «un server LDAP» da «un domain controller di questo dominio» da «un global catalog di questa foresta»:
| Nome | Chi lo chiede |
|---|---|
_ldap._tcp.<domain> | Qualunque cosa voglia LDAP nel dominio |
_ldap._tcp.dc._msdcs.<domain> | Localizzazione dei domain controller: quello importante |
_ldap._tcp.pdc._msdcs.<domain> | Specificamente l’emulatore PDC |
_ldap._tcp.gc._msdcs.<forest> | Global catalog |
_kerberos._tcp.<domain>, _kerberos._udp.<domain> | Localizzazione del KDC, prima che esista qualunque ticket |
_kpasswd._tcp.<domain>, _kpasswd._udp.<domain> | Cambi di password |
_ldap._tcp.<site>._sites.dc._msdcs.<domain> | Localizzazione per sito: trovare un DC vicino |
Guarda a cosa serve quell’elenco. L’autenticazione Kerberos non può cominciare finché il client non ha trovato un KDC, e il KDC lo trova tramite DNS. La localizzazione per sito significa che la risposta decide anche contro quale datacenter un client si autentica.
La stessa idea, modernizzata
SRV ha un successore che vale la pena conoscere. I record SVCB e HTTPS (RFC 9460) generalizzano lo schema: parametri di servizio in DNS, tra cui ALPN, porta e suggerimenti di indirizzo, in un solo record. È così che un browser impara ad andare dritto su HTTP/3 senza un redirect. Il record HTTPS è già ampiamente diffuso. Il meccanismo è nello spirito lo stesso di SRV: è DNS a dire al client come raggiungere il servizio. Il che significa che l’argomento della sezione successiva vale anche per lui.
Tutto ciò che viene dopo la ricerca si fida della ricerca
Ecco il punto di svolta, ed è il motivo per cui un articolo sul DNS ha una sezione sulla sicurezza e non il contrario.
Una macchina unita al dominio si avvia e chiede dov’è un domain controller. Riceve un nome e una porta. Si connette lì, e poi comincia a fare tutte le cose che di solito consideriamo il livello di sicurezza: Kerberos, firma LDAP, channel binding, validazione dei certificati.
Quindi cosa succede se la risposta era una bugia?
Essere onesti su questo conta, perché la risposta non è «catastrofe immediata». Kerberos è stato progettato con l’autenticazione reciproca proprio perché un client non fosse in balìa della sua ricerca dei nomi: un host che non è in grado di produrre un ticket di servizio per il nome richiesto dal client non può completare lo scambio. Ricevi una risposta SRV che punta a una macchina senza chiave nel dominio e, per un client configurato in modo rigoroso, fallisce.
Il danno realistico è più sottile, e sta tutto negli spazi attorno a questo:
- Downgrade. Un client che ripiega su NTLM quando Kerberos non funziona è appena stato consegnato a chiunque abbia risposto.
- Relay e coercion. L’attaccante non ha bisogno di essere il DC. Essere il nome a cui un client si connette basta per cominciare a inoltrare quell’autenticazione da qualche parte dove serve.
- Denial of service che sembra un guasto. Fai puntare
_ldap._tcp.dc._msdcsa qualcosa che non risponde e il dominio è rotto a intermittenza, in un modo che per parecchio tempo nessuno diagnostica come DNS. - Tutto ciò che non ha alcuna autenticazione reciproca. Sincronizzazione dell’ora, syslog, monitoraggio, agenti di backup, quella cosa HTTP interna con
verify=False. Molti ambienti ne hanno più di quante vorrebbero ammettere.
Il principio generale è quello da portarsi a casa: DNS è un meccanismo di scoperta, non di autorizzazione. È del tutto ragionevole trovare un servizio per nome. Non è ragionevole concedere qualcosa sulla base di un nome, e il numero di sistemi che lo fanno in silenzio (allowlist basate sui PTR, ACL sui nomi host, «è sulla rete interna quindi deve essere nostro») è la vera superficie d’attacco.
Cosa risolve DNSSEC, e cosa no
DNSSEC esiste per rispondere a una sola domanda: questa risposta viene davvero, senza modifiche, dalla zona che possiede il nome?
Funziona (RFC 4033 e le due che la seguono) firmando, e concatenando le firme a qualcosa di cui ti fidi già:
- Ogni RRset di una zona firmata ha un
RRSIG: una firma su quell’insieme. - Le chiavi pubbliche della zona sono pubblicate come
DNSKEY. - La zona padre pubblica un record
DS: un hash della chiave della figlia. - Quel
DSè a sua volta firmato dal padre, la cui chiave è codificata nelDSdel suo padre, fino alla radice: e la chiave della radice è l’unica cosa che il tuo resolver conosceva dalla nascita.
Anche la negazione è firmata, cosa facile da trascurare e più importante di quanto sembri. Senza, «nome inesistente» è una risposta non autenticata che un attaccante può falsificare per far sparire qualcosa. NSEC e NSEC3 danno un «tra questi due nomi non esiste nulla» autenticato.
È una soluzione reale a un problema reale. L’avvelenamento della cache non è teorico: l’attacco di Kaminsky rese lo spoofing off-path così economico da imporre patch d’emergenza in tutta internet, e le mitigazioni che seguirono (randomizzazione della porta sorgente, mescolamento delle maiuscole 0x20) sono tutti tentativi di rendere più difficile indovinare, non di rendere verificabili le risposte. Il lavoro sui side channel da allora le ha erose più volte. Le firme sono l’unica cosa di quell’elenco che cambia le regole del gioco invece di alzare il prezzo.
Ora i limiti onesti, perché DNSSEC viene venduto male in entrambe le direzioni.
Non è riservatezza. La firma è autenticazione a chiave pubblica; ogni query e ogni risposta viaggiano ancora in chiaro. La privacy sul tratto del client è DoT, DoH o DoQ, e quelli sono un meccanismo diverso che risolve un problema diverso. Cifrare il tratto verso un resolver che non valida ti compra una conversazione privata con qualcosa a cui si può ancora mentire.
Non convalida il significato, solo l’origine. DNSSEC prova che il proprietario della zona ha pubblicato questo. Se il record è sbagliato, o malevolo, o è stato scritto da qualcuno a cui la zona ha sconsideratamente permesso di scriverlo, la firma viene applicata anche a quello con la stessa fedeltà. Firmare una zona che macchine non fidate possono scrivere non rende affidabile il contenuto: autentica la bugia. Tieni a mente questa frase; l’ultimo terzo dell’articolo ne è in sostanza la conseguenza.
Serve solo se qualcuno valida. Se il tuo resolver non valida, le firme sulle zone che interroghi sono decorazione. E se la validazione avviene su un resolver dall’altra parte della rete rispetto al client, il client si sta fidando del bit AD e del percorso: vedi trust-ad sopra.
E va gestito. Una firma scaduta non è una risposta degradata, è un SERVFAIL: il nome si spegne. Un DS nel padre che non corrisponde più alla chiave della figlia fa lo stesso. Questo è il costo onesto, e per questo l’automazione delle sezioni successive conta più della firma iniziale.
Perché un TLD interno inventato non si può firmare
Qui le decisioni sui nomi prese anni fa tornano con il conto, e vale la pena di spiegarlo per bene perché è il motivo per cui il progetto di questo articolo usa un dominio reale, di tua proprietà, per i nomi interni.
Guarda di nuovo come è costruita la catena: la chiave di una zona è garantita da un record DS nel suo padre. Quindi un resolver che valida può autenticare una zona interna solo se quella zona ha un padre disposto e in grado di pubblicare un DS per lei.
ad.corp.local non ha un padre del genere. Né ce l’hanno .lan, .home o qualunque altra cosa inventata il giorno in cui è stato creato il dominio:
.localè riservato a mDNS. Usarlo per il DNS unicast non significa solo non firmarlo: è una collisione documentata con il modo in cui ogni sistema operativo dell’edificio ha il diritto di comportarsi. Ha una sezione tutta sua qui sotto, perché gioca in un altro campionato rispetto agli altri tre..lan,.corp,.homesono stringhe non registrate. Non esiste un padre che contenga unDS, e le versioni per cui era stata fatta domanda sono state escluse dalla delega a causa del pasticcio delle collisioni di nomi negli ambienti privati.home.arpaè riservato come si deve alle reti domestiche, il che sembra ideale: ma la sua delega è deliberatamente insicura. Non esiste un percorso firmato fino a lui, per scelta di progetto..internalè stato messo da parte dall’ICANN proprio per questo uso, e risolve il problema delle collisioni. Non risolve questo: nessuna delega significa nessunDS, quindi nessuna catena.
Con una zona interna senza catena hai due opzioni: lasciarla non firmata, oppure configurare un trust anchor locale su ogni resolver che valida nell’ambiente e diventare la radice della tua isola privata. Una chiave che ora devi distribuire, monitorare e ruotare a mano, su ogni resolver, per sempre, con SERVFAIL sull’intero dominio come modalità di guasto.
C’è una risposta molto più semplice, ed è gratuita: fai della zona interna una delega dentro una zona pubblica che possiedi già e firmi già. ad.example.com, delegata da example.com. Il DS va nel padre pubblico. Ogni resolver che valida nell’ambiente autentica allora i nomi interni con il trust anchor che ha già, e tu non distribuisci nulla.
Il contenuto resta dentro. Solo la fiducia viene da fuori. Questa distinzione è il progetto del resto dell’articolo.
.local non è una scelta di stile
Uno di quei quattro merita una sezione a parte, perché è quello che la gente difende, e perché la difesa è sempre la stessa: funziona, lo usiamo da anni, qual è il problema.
Il problema è che .local non è una stringa non registrata che qualcuno un giorno potrebbe vendere. È uno spazio dei nomi che ha già un proprietario e un comportamento definito, e il comportamento non è «chiedi al server DNS». RFC 6762 §3 non usa mezzi termini:
Any DNS query for a name ending with “.local.” MUST be sent to the mDNS IPv4 link-local multicast address 224.0.0.251 (or its IPv6 equivalent FF02::FB).
Leggi cosa governa davvero quel MUST. Non è un’affermazione su chi possiede la stringa. È un’istruzione su dove va la query, e la risposta è un gruppo multicast sul link locale, non il tuo domain controller. La stessa sezione dice che i nomi sotto .local sono «meaningful only on the link where they originate», l’equivalente DNS di un indirizzo 169.254.
Quindi un client che segue correttamente la specifica non chiederà mai al tuo server DNS un nome .local. Grida sul filo e prende qualunque cosa risponda.
Ne nasce una serie di guasti dal sapore molto particolare:
- La risoluzione dipende dal client, non dal tuo DNS. macOS risolve
.localtramite Bonjour e l’ha sempre fatto;systemd-resolvedinstrada il dominiolocalverso mDNS per impostazione predefinita; Windows fa mDNS da Windows 10. Tre stack, tre insiemi di regole, e nessuno di loro consulta il tuo file di zona. - Si ferma al primo router. mDNS è link-local per progetto. Un nome che si risolve da una scrivania sulla stessa VLAN non si risolve da un altro piano, da un’altra sede o dalla VPN: è il ticket «in ufficio funziona, a casa no» che viene chiuso come «problema di rete» quattro volte prima che qualcuno legga la specifica.
- Il comportamento cambia sotto i tuoi piedi. Se una data macchina provi prima il multicast, prima l’unicast o entrambi in parallelo dipende dallo stack del resolver e dalla sua versione. Gli ambienti che hanno girato su
.local«senza problemi per anni» sono di solito ambienti in cui un aggiornamento della distro non ha ancora cambiato l’ordine. - Le prove mancano proprio dove le cerchi. Il log delle query del DC non mostra nulla, perché non è arrivato nulla. La gente passa giorni sul server, e la query non è mai uscita dal client.
- E non si può firmare, che è il punto di questa sezione. Nessun padre, nessun
DS, nessuna catena, nessun modo di pubblicarne una.
Ora metti tutto questo sotto un dominio Active Directory. Il realm deriva dal nome di dominio. I service principal derivano dal realm. I locator _msdcs (i record di cui parla tutto questo articolo) stanno sotto un suffisso che un client conforme è tenuto a risolvere gridando sul segmento locale. Stai costruendo Kerberos sopra uno spazio dei nomi che metà del tuo ambiente risolve con un protocollo pensato per trovare stampanti.
E uscirne costa caro, ed è questo che rende giusto non avere riguardi per la decisione originale. Su Samba non esiste una rinomina sul posto. Il percorso documentato è samba-tool domain backup rename seguito da un restore: prendi una copia rinominata del database, ne fai nascere un nuovo DC e riaggiungi da zero ogni altro DC, senza alcuna sovrapposizione consentita tra DC con il vecchio nome e DC con il nuovo. Non è il rendom di Windows, che almeno percorre i DC uno alla volta. È una ricostruzione con un nome più carino.
Quindi il riassunto onesto. .local per un dominio unicast non è una preferenza, una convenzione o un innocuo pezzo di eredità. È un conflitto documentato con un protocollo che è attivo di serie su ogni sistema operativo dell’edificio, e il conto arriva anni dopo sotto forma di guasti di risoluzione intermittenti e non riproducibili e, quando alla fine vuoi firmare la zona, sotto forma di ricostruzione del dominio.
Lo stesso errore, con un altro cappello
Già che ci siamo: la porta 5353.
mDNS ascolta sulla UDP 5353, e non è una porta di riserva che per caso è libera. Mettere su di essa un normale servizio DNS unicast, o far puntare i resolver a :5353 perché la 53 era occupata o richiedeva root, fa lo stesso danno dalla direzione opposta: ogni macchina del segmento che parla mDNS ora sta parlando con il tuo servizio di nomi, e il tuo servizio di nomi ora riceve service discovery multicast a cui non è mai stato pensato per rispondere. Il nome e la porta sono le due metà di uno stesso spazio dei nomi, ed entrambe appartengono già a qualcun altro.
.local sulla 53, o DNS unicast sulla 5353. Stesso fraintendimento, stessa classe di guasti intermittenti, stesse settimane del tempo di qualcun altro.
E sii onesto su cosa ti dice
Microsoft raccomandava .local ai tempi di Small Business Server, ed è per questo che così tanti ambienti se lo portano ancora dietro, e ha smesso di raccomandarlo molto tempo fa. Ereditare un dominio .local è sfortuna. La maggior parte di chi legge e ne ha uno non l’ha scelto, e la sezione qui sopra è un piano di migrazione, non un’accusa.
Metterne in piedi uno è tutta un’altra faccenda, e sarò diretto, perché ammorbidire la cosa non ha mai aiutato nessuno.
Chiunque metta in piedi .local per Active Directory o per il normale DNS unicast, o metta un servizio DNS sulla porta 5353, non è un professionista IT. Può avere il titolo. Non sta facendo il lavoro. RFC 6762 è pubblicata dal 2013, si legge in venti minuti, e la frase che chiude l’intera questione è nella sezione 3. Costruire il servizio dei nomi di un’azienda su uno spazio dei nomi che la specifica riserva al multicast link-local non è una decisione ingegneristica difendibile. È qualcuno che tira a indovinare nell’unica parte dello stack in cui tirare a indovinare produce guasti che nessuno riesce a riprodurre e di cui tutti danno la colpa alla rete.
Dovrebbe essere rimosso dal tuo reparto IT. Non spostato di lato, non incaricato del DNS sotto supervisione. Rimosso dalla funzione. Il ruolo esiste per sapere quale pacchetto va dove e con l’autorità di chi. Qualcuno che non ha letto il documento che governa lo spazio dei nomi scelto per ogni macchina dell’edificio non sta svolgendo quel ruolo, e tenercelo significa che la prossima decisione di questa portata verrà presa nello stesso modo.
E ogni sistema che ha toccato andrebbe sottoposto ad audit. Questa è la parte che la gente salta, ed è quella che conta di più. Una decisione così non è mai isolata. Qualcuno che non ha controllato RFC 6762 prima di dare il nome al dominio non ha controllato nient’altro, quindi vai a guardare cos’altro ha costruito. Aspettati di trovare:
- Server DNS aperti al mondo, forwarder che rispondono a chiunque chieda, e nessuna ACL da nessuna parte.
- Aggiornamento dinamico lasciato spalancato, e container di zona con permessi che nessuno ha rivisto da quando è stato creato il dominio.
- Certificati e Kerberos costruiti sopra nomi che non si sarebbero mai risolti in modo coerente, con i guasti coperti da file hosts.
- File hosts. Ovunque. Interi ambienti sono stati tenuti insieme da quelli, proprio perché
.localnon ha mai funzionato come si deve e qualcuno ha trovato un rimedio invece di una causa. - Regole firewall e account di servizio creati per far sparire i sintomi, ancora lì, che concedono ancora più di quanto qualcuno ricordi.
Non è vendetta. È lo scopo stesso di un segnale di competenza. Quando trovi una decisione presa senza leggere la specifica, la risposta corretta è presumere che le altre siano state prese allo stesso modo e andare a controllare: perché la stessa persona ha configurato la tua autenticazione, i tuoi certificati e il tuo controllo degli accessi, e ora hai una prova diretta di come affronta un problema che non capisce fino in fondo.
Ereditare questo pasticcio ti costa una migrazione. Tenere a libro paga chi lo sta ancora creando ti costa parecchio di più.
I due backend DNS di Samba
Un domain controller Samba AD conserva i suoi dati DNS nella directory stessa, e ci sono due modi per servirli.
SAMBA_INTERNAL è il server DNS di Samba, integrato nell’AD DC. Gestisce le zone AD e gli aggiornamenti dinamici autenticati con Kerberos, e passa tutto il resto a un forwarder. Samba lo descrive come capace di «the basic feature required in an AD» e lo raccomanda «for simple DNS setups», il che è corretto e va preso alla lettera. Ha una sezione tutta sua qui sotto, perché quello che non fa è più lungo e più interessante di quello che fa.
BIND9_DLZ usa BIND come server DNS, con il modulo dlz_bind9 di Samba caricato al suo interno. DLZ (Dynamically Loadable Zones) è un’interfaccia di BIND per appoggiare una zona su qualcosa di diverso da un file di zona. Il modulo risponde alle query di BIND leggendo direttamente da sam.ldb, quindi non c’è nessuna copia, nessun passo di esportazione e nessuna sincronizzazione che possa andare storta: BIND legge la directory mentre risponde.
Il server DNS interno non fa ricorsione: non può
Comincia dalla cosa che viene descritta male quasi sempre, anche da chi lo gestisce.
«Il DC è il nostro server DNS, fa la ricorsione per i client» non è quello che succede, perché il server DNS interno non può fare ricorsione in nessun modo. L’elenco delle funzionalità di Samba lo dice chiaramente. Il DNS interno non supporta:
- il funzionamento da resolver con cache
- le query ricorsive (ma può inoltrare a un altro nameserver DNS ricorsivo)
- la firma delle transazioni a chiave condivisa (TSIG)
- le stub zone
- i trasferimenti di zona
- il bilanciamento del carico Round Robin tra i DC
con lo scavenging e i conditional forwarder elencati anch’essi come non implementati.
Leggi le prime due insieme, perché sono tutta la storia. Non può risolvere, e non può tenere in cache. Quello che dns forwarder ti compra davvero è un relay: un client chiede al DC windowsupdate.com, il DC chiede a un vero resolver, la risposta torna indietro passando per il DC, e poi il DC la dimentica del tutto. Il client successivo fa la stessa domanda e tutto ricomincia da capo.
Torna alla tabella vista prima in questo articolo e nota di cosa si tratta: un forwarder senza la cache del forwarder. Ha i costi del ruolo (un salto in più, una dipendenza, una cosa che può essere giù) e nessuno dei suoi benefici.
Quindi un DC con SAMBA_INTERNAL che serve l’ambiente non è un server DNS nel senso che la gente intende. È un proxy senza cache verso un vero resolver, e l’hai messo sulla macchina che contiene la tua directory.
Perché è un rischio e non solo un’inefficienza
L’inefficienza è facile da vedere: ogni ricerca esterna dell’edificio diventa un andata e ritorno attraverso l’AD DC, in modo permanente, senza una cache che ne smussi l’effetto. Su un dominio tranquillo nessuno se ne accorge. È proprio per questo che sopravvive.
L’argomento di sicurezza è quello che vale la pena di fare, e ha tre parti.
Il listener sta nel processo sbagliato. Il DNS interno è un task di servizio dell’AD DC stesso, che gira con i privilegi della directory: non un demone separato con il proprio account come è named. Quindi la cosa che analizza UDP non autenticato da chiunque possa raggiungere la porta 53 gira dentro il processo che serve LDAP e Kerberos e possiede sam.ldb. BIND ha trent’anni di attenzioni ostili, un utente dedicato e l’abitudine di essere eseguito in una jail, proprio perché un listener DNS è un quartiere difficile. Il server interno di Samba è una funzione di comodità che si trova a vivere nei gioielli di famiglia.
Servire i client significa essere raggiungibile dai client. Per essere il server DNS dell’ambiente deve accettare query da ogni workstation, ogni stampante, ogni portatile di un consulente sulla VLAN ospiti che qualcuno ha collegato per sbaglio. È una superficie d’attacco ampia, sempre aperta e non autenticata sull’host di maggior valore che possiedi, e la tieni in piedi per risparmiare il costo di un resolver che potrebbe girare su un Raspberry Pi.
E un forwarder aperto al mondo è l’arma di qualcun altro. Un DC che inoltra per chiunque chieda è un forwarder aperto. Appena è raggiungibile da fuori della tua rete diventa un partecipante a riflessione e amplificazione, il che significa che il traffico e le segnalazioni di abuso arrivano entrambi al tuo domain controller. Non c’è un rate limiting a cui ricorrere, perché il server interno non ne ha.
Niente di tutto questo richiede una vulnerabilità di Samba per essere una cattiva idea. È una cattiva idea per come è fatta: mette un servizio non autenticato, esposto a internet per sbaglio e pieno di parsing nello stesso processo della tua directory, a fare un lavoro che la documentazione dice che non sa fare come si deve.
Cadrà prima, e si porterà dietro di più
Vale la pena di essere chiari su cosa questo argomento non è. Non è un’affermazione che il codice DNS di Samba abbia più bug di quello di BIND. BIND ha un lungo elenco di CVE, soprattutto perché è l’implementazione DNS più esaminata che esista, e contare gli advisory sarebbe un pessimo modo di scegliere tra i due.
Il confronto che conta è strutturale, e si riduce a tre domande con tre risposte scomode.
Chi può mandargli un pacchetto malformato? Con SAMBA_INTERNAL che serve l’ambiente: ogni workstation, ogni telefono sul wireless, tutto ciò che può instradare verso la porta 53 di quella macchina. Con il progetto di questo articolo: il signer. Un host, una chiave TSIG, allow-query limitato a lui. Non è una piccola differenza di grado. È la differenza tra un servizio esposto e uno di fatto irraggiungibile, e schiaccia qualunque differenza di qualità del codice tra le due implementazioni.
Cosa cade quando cade? È questa che decide la gravità. named è un demone separato con il proprio account; quando muore, il DNS si ferma e il domain controller continua ad autenticare. Il DNS interno di Samba è un task di servizio dentro l’AD DC, quindi qualunque cosa lo blocchi, lo esaurisca o lo faccia crollare sta succedendo dentro il processo che serve LDAP e Kerberos. Un problema DNS diventa un’interruzione della directory. E systemctl restart named costa un secondo, mentre riavviare un DC è un altro genere di mattinata.
Cosa puoi farci mentre succede? BIND ha il response rate limiting, allow-query, allow-recursion, blackhole, policy per vista e la possibilità di non rispondere affatto ai client. Il server interno ha dns forwarder e un file di log. Quando qualcosa comincia a martellarlo, non c’è nessuna manopola da girare.
Poi aggiungi la cache che manca. Ogni query di un client è un nuovo andata e ritorno verso l’esterno, quindi un’ondata di query costa al DC una ricerca a monte per ogni pacchetto invece di un hit in cache, e gliela costa nello stesso processo che sta cercando di emettere ticket Kerberos. Non serve un exploit per questo; serve una mattinata intensa, un’applicazione che si comporta male, o qualcuno che punta uno scanner sulla VLAN sbagliata. Se dura, si presenta come autenticazione lenta e nessuno pensa di guardare il DNS.
Quindi sì: anche con DLZ di mezzo, BIND è il posto più sicuro per questo. Il modulo DLZ dà effettivamente a named accesso ai dati di Samba, ed è una considerazione reale su cui questo articolo ha già insistito. Ma un crash di named è un’interruzione del DNS e non della directory, e in questo progetto quel named non riceve affatto query dall’ambiente. I bug sono un fatto di ogni codebase. Il raggio d’impatto e la raggiungibilità sono cose che scegli tu.
E non può costruire il progetto di questo articolo
C’è un motivo più semplice e più definitivo per cui qui non è il backend.
Niente trasferimenti di zona. La pipeline della sezione successiva (primario nascosto, signer, server autoritativi autonomi) comincia con un AXFR in uscita dal DC. SAMBA_INTERNAL non ha nulla con cui trasferire. Niente TSIG nemmeno, quindi manca perfino l’autenticazione di cui quel trasferimento avrebbe bisogno. E nessuna firma, e nessuna validazione di ciò che inoltra.
Quindi il riassunto onesto di SAMBA_INTERNAL: è il backend che ti permette di tirare su un dominio AD in laboratorio una domenica pomeriggio senza configurare BIND, ed è molto bravo in questo. Samba dice «simple DNS setups» e intende proprio quello. Non è un resolver, non è mai stato costruito per essere il servizio DNS di un ambiente, e nel momento in cui vuoi firma, trasferimenti, viste, ACL, cache o rate limiting, la risposta non è regolarlo. Quelle manopole non le ha. La risposta è BIND.
Se oggi lo usi con ogni client che punta al DC, la correzione non è urgente ma nemmeno facoltativa: dai ai client un vero resolver che valida, e imposta dns forwarder sul DC perché punti a quello, così il DC risponde per le sue zone e per nient’altro.
E questa è la parte su cui voglio essere chiaro, perché «non usare DLZ» viene ripetuto come se fosse una regola di hardening: DLZ non è l’esposizione. È il meccanismo di estrazione. Quello che conta non è quale modulo è caricato in BIND: è chi ha il permesso di parlare con quel BIND, e cosa succede alla zona dopo. Un BIND con backend DLZ che risponde solo a una richiesta di trasferimento dal tuo signer non è una superficie d’attacco in nessun senso interessante. Un DC con SAMBA_INTERNAL che riceve ogni ricerca di nomi da quattrocento portatili lo è eccome. Solo uno dei due compare nelle checklist di hardening, e non è quello che conta.
Due cose su DLZ sono vere e conviene pianificarle invece di temerle:
- Il modulo è legato alla versione di BIND. Samba distribuisce un
.soseparato per ogni versione di BIND, enamed.confne nomina uno in particolare. Un aggiornamento di versione maggiore di BIND significa che il modulo corrispondente deve essere al suo posto, altrimentinamednon parte. È una dipendenza di pacchettizzazione da testare in anticipo, non una proprietà di sicurezza. namedha bisogno di accedere ai dati di Samba, ed è per questo che Samba tiene una directory dedicata per le parti che servono a BIND invece di concedergli l’intera directory privata. La concessione dovrebbe essere ristretta: vale la pena di verificare che lo sia ancora sui tuoi DC, perché è l’unico punto in cui DLZ allarga davvero ciò che raggiungerebbe una compromissione dinamed.
Il motivo per cui DLZ è la scelta giusta qui è ciò che rende possibile: l’interfaccia DLZ di BIND supporta l’enumerazione di un’intera zona, ed è questo che rende possibile un trasferimento di zona da una zona con backend DLZ. Quel trasferimento è il primo salto della pipeline, ed è BIND a farlo, il che significa che il resto della pipeline è normale configurazione di BIND invece di qualcosa di esotico.
C’è un vincolo che dà forma a tutto ciò che viene dopo, e vale la pena di dirlo chiaramente perché è facile dare per scontato il contrario. Una zona DLZ non può essere firmata. ISC lo dice esplicitamente nell’ARM di BIND: DLZ «is unable to handle DNSSEC-signed data due to its limited API». Non puoi appendere una dnssec-policy all’istruzione dlz e considerarti a posto.
Quello che puoi fare (e che ISC suggerisce per DLZ nello stesso respiro) è farlo girare come primario nascosto, con la firma fatta da una normale zona BIND che trasferisce i dati al suo interno. È la sezione successiva, e il vincolo è il motivo per cui ha la forma che ha.
Vale la pena di sapere che questo è un vincolo di Samba e non una legge di Active Directory. Il server DNS di Microsoft fa la firma online di zone dinamiche integrate in AD da Windows Server 2012. La zona viene firmata sul posto, le chiavi private si replicano ai Key Master attraverso la replica di AD stessa, e gli aggiornamenti dinamici continuano a funzionare. Su Windows, «sign the AD partitions» è un’opzione reale e la risposta all’obiezione del continuo cambiamento è già incorporata. (Su Server 2008 R2 non lo era: potevi firmare una zona integrata in AD, ma non una che accettasse aggiornamenti dinamici, e ogni modifica significava rifirmare a mano: è da lì che viene la leggenda secondo cui le zone AD non si possono firmare.)
Samba non ha nulla di equivalente. Nessuno dei due backend firma: il server interno non ha affatto DNSSEC, e DLZ non può portare dati firmati. Quindi su Samba la pipeline di trasferimento e firma non è un progetto tra tanti. È la strada.
La pipeline di pubblicazione
Ora la sua forma. Quattro ruoli, e il DC sta in fondo, dove niente può raggiungerlo.
named sul DC o un host separato. I server autoritativi autonomi sono l’unica cosa che i client vedono mai, e sono secondari della zona firmata.1. Il domain controller: primario nascosto. BIND con dlz_bind9, autoritativo per le zone AD a partire dalla directory. Ricorsione disattivata. Nessun servizio rivolto ai client. allow-transfer limitato al solo signer, con TSIG. Dal punto di vista della rete il DC non serve affatto DNS, e l’unica cosa che lo interroga è la macchina successiva.
2. L’istanza di firma: una normale zona BIND che trasferisce i dati al suo interno. È qui che vivono inline-signing e la dnssec-policy, su una zona con lo stesso nome che contiene la copia trasferita. BIND tiene la copia non firmata che ha ricevuto e la copia firmata che pubblica come cose separate, e rifirma man mano che arrivano nuovi trasferimenti. Poiché si tratta di un trasferimento e non di un file condiviso, questa istanza può stare sul DC stesso (un secondo named sul proprio indirizzo) oppure su un host separato, e la configurazione è quasi identica in entrambi i casi.
Il compromesso è quello che sembra: sul DC hai una macchina in meno da gestire, mentre un host separato tiene le chiavi private lontane dalla macchina che contiene la directory. Sono entrambe difendibili, e la scelta non cambia nient’altro nella pipeline. Quello che conta è che la firma avvenga una volta sola, in un punto definito, sotto una policy delle chiavi: la differenza tra un DNSSEC che gestisci e un DNSSEC che scade alle tre del mattino.
3. I server autoritativi: l’unica cosa che i client vedono. Semplici secondari della zona firmata. Non contengono chiavi, non firmano e non hanno alcun percorso verso la directory. Se uno viene compromesso, l’attaccante ha una copia di una zona e nessuna possibilità di falsificare un nuovo record che superi la validazione.
4. I resolver. Resolver ricorsivi che validano per l’ambiente, che inoltrano in modo condizionale le zone interne a quei server autoritativi e percorrono l’albero pubblico per tutto il resto. Sono loro a cui punta il resolv.conf dei client.
Da questa disposizione derivano due proprietà che vale la pena di enunciare a sé, perché sono tutto il punto:
- La macchina che contiene la directory non è raggiungibile dalle macchine che la usano. Un domain controller è l’host di maggior valore dell’ambiente. Dargli un servizio di rete rivolto ai client, che risponde a UDP non autenticato da qualunque workstation, è un pessimo scambio per un servizio che altre macchine possono svolgere.
- La firma avviene una volta sola, in un punto definito. L’obiezione abituale alla firma di una zona AD è il continuo cambiamento: il contenuto cambierebbe troppo spesso perché le firme stiano al passo. Quell’obiezione è in realtà un’obiezione alla disposizione predefinita, non alla firma. Con la registrazione dei client spostata altrove, come la sezione successiva sostiene che debba essere, la zona AD cambia quando un domain controller viene promosso o retrocesso e praticamente mai altrimenti. Una zona scritta solo dai DC è una zona stabile, e firmare una zona stabile è una cosa banale. Tenere fuori i client non è solo un controllo di sicurezza; è ciò che rende la zona abbastanza tranquilla da firmarla senza problemi.
Come si collega davvero la firma
La forma qui sopra è la parte importante, ma «una normale zona BIND che trasferisce i dati al suo interno» merita di essere mostrata invece che descritta, perché il primo tentativo di solito si arena cercando di firmare direttamente la DLZ.
Sul DC, il lato DLZ resta volutamente noioso. Serve la directory, consegna la zona a esattamente un peer, e non fa nient’altro:
key "transfer-to-signer" {
    algorithm hmac-sha256;
    secret "...";
};

options {
    recursion no;
    allow-query { key transfer-to-signer; localhost; };
    allow-transfer { key transfer-to-signer; };
    notify no;
};

dlz "AD DNS Zone" {
    database "dlopen /usr/lib64/samba/bind9/dlz_bind9_18.so";
};
Nota che il .so porta nel nome la versione maggiore di BIND. È il legame di versione della sezione precedente reso concreto: un aggiornamento di BIND richiede che il modulo Samba corrispondente sia al suo posto prima che named possa partire.
Sul lato della firma, la zona è un normale secondario con le opzioni di firma aggiunte. Questa è la parte che non può stare sulla DLZ:
dnssec-policy "ad-internal" {
    keys {
        ksk lifetime P365D algorithm ecdsa256;
        zsk lifetime P90D  algorithm ecdsa256;
    };
};

zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 key transfer-to-signer; };
    file "ad.example.com.axfr";
    inline-signing yes;
    dnssec-policy "ad-internal";
    allow-transfer { key transfer-to-public; };
    also-notify { 192.0.2.20; 192.0.2.21; };
};
Che questo funzioni su un secondario è il dettaglio che regge tutto, e l’ARM lo dice direttamente:
If
yes, BIND 9 maintains a separate signed version of the zone. An unsigned zone is transferred in or loaded from disk and the signed version of the zone is served with, possibly, a different serial number.
Quindi BIND tiene due copie: quella non firmata che ha ricevuto, scritta in file, e quella firmata che serve, scritta accanto con l’estensione .signed. Arriva un trasferimento, la versione firmata viene rigenerata e i server a valle ricevono un notify, perché a quel punto è una zona del tutto ordinaria. inline-signing yes è in effetti il valore predefinito una volta collegata una dnssec-policy; è scritto qui sopra perché una configurazione che dice cosa fa vale una riga in più.
Il rollover delle chiavi arriva con la policy e non con un cron job. I rollover della ZSK non richiedono alcun intervento; quelli della KSK richiedono che il nuovo DS arrivi al padre, ed è l’automazione CDS/CDNSKEY di cui si parla più avanti. rndc dnssec -status ad.example.com ti dice a che punto del suo ciclo di vita è ogni chiave.
Se quel blocco gira sul DC o su un host a sé è solo questione di a quale indirizzo punta primaries. Sul DC è una seconda istanza di named su un secondo indirizzo, che trasferisce dalla prima tramite il loopback o un’interfaccia di gestione. Ecco cosa significa in pratica «BIND con DLZ può fare da signer»: stesso software, stessa macchina se vuoi, ma la firma avviene sulla copia trasferita invece che sulla zona DLZ.
L’unico intoppo operativo è il notify, ed è sul lato DLZ. Il manuale di ISC non gira intorno alla cosa: DLZ «has no built-in support for DNS notify», quindi i server secondari non vengono informati automaticamente delle modifiche alle zone nel database. Samba può cambiare un record nella directory e l’istanza DLZ non ha idea di doverlo dire a qualcuno.
Quindi il primo salto è un polling, non un push. Il signer si aggiorna secondo il timer SOA della zona che sta trasferendo, il che significa:
- La propagazione da una modifica sul DC a un record firmato e pubblicato è limitata da quell’intervallo di refresh, non da qualche secondo. Promuovi un DC e i suoi nuovi record
_msdcscompaiono a valle entro un refresh. - Quell’intervallo è la manopola da girare se il ritardo conta. È un compromesso con la frequenza con cui vuoi che la DLZ venga interrogata, e questo porta all’altra cosa che ISC dice di DLZ: fa ricerche nel database in tempo reale senza cache ed è «not recommended for use on high-volume servers».
- Entrambe sono argomenti a favore di questa topologia, non contro. L’unico client che l’istanza DLZ abbia mai è il signer, che chiede una volta per refresh. Il vero carico di query dell’ambiente finisce sui server autoritativi autonomi, che servono un semplice file di zona firmato alla massima velocità.
Tutto ciò che sta a valle del signer è convenzionale: i server autoritativi sono secondari della zona firmata, ricevono un notify come si deve e non toccano mai né la directory né una chiave.
I client non devono scrivere la zona che contiene i locator
Questa è quella importante, ed è una regola di progetto più che un’impostazione.
Active Directory registra i record in modo dinamico. Una macchina entra nel dominio e si registra; un DC si avvia e registra i record SRV che pubblicizzano i suoi servizi. Aggiornamento dinamico «sicuro» significa che quegli aggiornamenti sono autenticati: la macchina dimostra di essere chi dice di essere con le proprie credenziali, e c’è una ACL per record, quindi in generale una macchina può modificare solo un record che ha creato lei.
Leggilo con attenzione, perché la garanzia è più stretta di quanto sembri a prima vista. L’aggiornamento dinamico sicuro autentica chi sta scrivendo. Non valuta cosa significa il record. E l’insieme degli account autorizzati a scrivere è molto più ampio di quanto si creda: in una zona integrata in AD predefinita il gruppo Authenticated Users detiene Create All Child Objects sul container della zona nella directory, perché ADIDNS conserva ogni record come oggetto AD sotto CN=MicrosoftDNS,DC=DomainDnsZones. Non solo gli account macchina: qualunque account autenticato del dominio, compreso quello di chi stamattina ha aperto l’allegato della fattura.
Il che produce due modalità di guasto in una zona che contiene sia i record dei client sia i locator dei servizi:
I nomi che non esistono ancora non appartengono a nessuno. Le ACL per record proteggono un record che ha già un proprietario. Un nome mai registrato non ha un oggetto su cui far valere una ACL, quindi il primo account che lo crea se lo prende. È il meccanismo dietro l’intera famiglia di attacchi ADIDNS, il più affilato dei quali è un wildcard: crea * e ogni nome della zona che nessuno ha rivendicato esplicitamente (errori di battitura, host dismessi, wpad) si risolve verso l’attaccante. I record esistenti restano intatti, ed è proprio per questo che passa inosservato.
Il raggio d’impatto comprende i locator. I record sotto _msdcs sono il modo in cui ogni client del dominio trova un domain controller e un KDC. Sono i record più critici per la sicurezza che possiedi, e in un’installazione predefinita stanno nella stessa zona in cui quattrocento portatili scrivono ogni volta che ottengono un lease DHCP.
Quindi la regola: la zona che contiene i locator viene scritta dai domain controller, e da nient’altro. La registrazione dinamica dei client va da un’altra parte.
Quell’altra parte può essere una di due cose, ed entrambe vanno bene:
- Una sotto-zona delegata servita altrove. La zona AD contiene una delega
NSper, diciamo,dyn.ad.example.com, e i record finiscono su un server separato che accetta gli aggiornamenti. Le partizioni di Samba non ricevono mai una scrittura da un client. - Una zona separata in Samba con la propria ACL di aggiornamento. Sempre nella directory, ma una zona a sé, quindi una scrittura di un client non ha alcun percorso verso
_msdcso verso i record di un DC.
La prima dà la separazione più netta; la seconda è meno roba da gestire. Quello che viola la regola non è nessuna delle due. È il comportamento predefinito, in cui le due cose convivono. Che è come gira ancora la maggior parte dei domini, perché nessuno l’ha scelto e nessuno è tornato a guardarci.
E c’è un secondo dividendo, quello che riporta tutto alla pipeline. Una zona scritta solo dai domain controller è una zona che non cambia quasi mai: una promozione di un DC, una retrocessione, e per il resto silenzio. Tutto il continuo cambiamento di una zona AD predefinita è registrazione dei client. Toglila e con lei se ne va l’obiezione alla firma delle partizioni AD: non c’è nessun flusso di aggiornamenti che le firme debbano inseguire, quindi firmarla è routine invece che una lotta. La disciplina di scrittura e la firma sono la stessa decisione vista due volte.
Accanto a entrambe c’è un permesso da andare a controllare, e su un DC Microsoft è la correzione diretta. Poiché i record ADIDNS sono oggetti della directory, il diritto viene da una ACL di AD e non da qualcosa nel protocollo DNS: Authenticated Users che detiene Create All Child Objects sul container della zona. Restringerlo è la mitigazione più pulita per il problema dei nomi non rivendicati e del wildcard, e in molti ambienti il permesso si può togliere del tutto una volta che sai cosa ha davvero bisogno di registrarsi da sé. L’AD DNS di Samba conserva i suoi record nella directory allo stesso modo, quindi vale la stessa domanda: vai a vedere cosa concede davvero il container della tua zona.
Ma un momento: nel 2026 i client dovrebbero registrarsi?
Tutto quanto sopra presuppone che l’aggiornamento dinamico dei client sia qualcosa di cui hai bisogno e che stai cercando di rendere sicuro. Prima di accettarlo, vale la pena di porre la domanda che nessuno pone, perché la risposta è cambiata da quando questo comportamento è stato progettato.
La registrazione DNS dinamica è stata pensata per un desktop. Una scatola sotto una scrivania, un cavo di rete, un indirizzo tenuto per anni. In quel mondo una macchina che registrava il proprio nome era una cosa ordinata e sostanzialmente vera.
Ora guarda cos’è un client nel 2026. Si sveglia sul wifi di casa. Arriva in ufficio ed entra nel wireless aziendale. Finisce in una docking station e prende anche un indirizzo cablato. Qualcuno avvia la VPN e compare un adattatore tunnel con un terzo indirizzo. Va in un bar, si collega in tethering a un telefono, e la VPN torna su con un quarto. È una macchina, un nome, e una mezza dozzina di indirizzi in una giornata di lavoro: e per impostazione predefinita cercherà di registrarne parecchi.
Così la zona si riempie di affermazioni che un tempo erano vere.
- Windows registra ogni adattatore che ha, a meno che qualcuno non sia passato a togliere la spunta da Register this connection’s addresses in DNS interfaccia per interfaccia. Un portatile nel dock con la VPN attiva è una macchina con tre adattatori attivi e un’opinione su ciascuno.
- Più record A per lo stesso nome non sono uno stato d’errore, sono il risultato normale. Una ricerca li restituisce tutti, i client li provano nell’ordine che preferiscono, e le connessioni a quel nome falliscono in proporzione a quanti indirizzi sono morti. È il meccanismo dietro «l’assistenza remota vede la macchina un minuto sì e quello dopo no».
- Gli indirizzi VPN sono i peggiori, perché un indirizzo di tunnel vale per un’ora e il record gli sopravvive. Il tunnel cade, l’indirizzo del pool va a qualcun altro, e il nome ora punta a un collega.
- Le docking station confondono l’identità stessa. A meno che non sia configurato il pass-through dell’indirizzo MAC, il lease appartiene al dock e non al portatile, quindi in un ambiente con postazioni a rotazione nomi, lease e macchine si allontanano tra loro ogni giorno.
- E la proprietà lo rende permanente. Un record può essere aggiornato solo dall’account che l’ha creato. Quando un record è stato creato dal DHCP con una credenziale e più tardi la macchina cerca di aggiornarlo con la propria, l’aggiornamento fallisce, in silenzio, e l’indirizzo vecchio resta esattamente dov’è.
Nemmeno la pulizia è il salvataggio che sembra. Samba ha lo scavenging dalla 4.9, ma è disattivato per impostazione predefinita (dns zone scavenging = yes, con samba-tool dns zoneoptions --aging=1), e Samba stessa dice che «should only be enabled on new zones or new installations», perché le versioni più vecchie marcavano i record dinamici come statici e quelli statici come dinamici. Negli ambienti con più probabilità di essere pieni di spazzatura, quelli che girano da anni, lo strumento per ripulirli è proprio quello che ti consigliano di non attivare. Ha anche avuto un CVE tutto suo.
Quindi poni la domanda in modo diretto: cosa consuma davvero il record A di un portatile?
Nella maggior parte delle realtà, ben poco. Gli utenti si connettono ai server; i server non si connettono ai portatili. I veri consumatori sono gli strumenti di assistenza remota, l’RDP verso una workstation per nome, e l’inventario o il monitoraggio: e quasi tutti questi strumenti mantengono un proprio inventario e lavorano con un agente che si fa vivo da sé, perché non hanno mai potuto contare sul DNS per i client mobili.
Il che suggerisce di invertire il comportamento predefinito:
- Server e infrastruttura ricevono i record dal provisioning. Con NetBox e Ansible già in gioco, il record viene creato dalla stessa cosa che ha creato la macchina, è corretto per costruzione, e viene rimosso quando viene rimossa la macchina.
- La parte cablata e stabile dell’ambiente può ricevere i record dal DHCP se qualcosa ne ha davvero bisogno, con un’unica credenziale che li possiede così gli aggiornamenti non falliscono.
- I client mobili non registrano nulla. Sono consumatori del DNS, non editori. Se qualcosa deve raggiungere un portatile, gli serve un agente, non un record A.
Arrivi nello stesso posto in cui ti aveva portato l’argomento di sicurezza, da una direzione completamente diversa. Meno scrittori significa una superficie ADIDNS più piccola, una zona non piena di affermazioni scadute e, tornando alla pipeline, una zona abbastanza tranquilla da firmarla senza pensarci.
L’argomento di sicurezza dice che i client non devono scrivere la zona che contiene i locator. L’argomento operativo chiede perché scrivano nel DNS in primo luogo. Nel 2026, per una flotta che cambia indirizzo cinque volte al giorno, «non lo fanno» è una risposta perfettamente valida, e molto meno lavoro che rendere sicuro il loro disordine.
Viste separate, e da dove viene la fiducia
L’ultimo pezzo tiene insieme le due metà dell’articolo.
Ci sono due viste dello spazio dei nomi. Una zona pubblica, pubblicata su internet, con la manciata di nomi di cui il mondo ha bisogno. E una vista interna (il contenuto derivato da AD, ogni host unito al dominio, ogni locator di servizio, la topologia dei siti) che il mondo non ha alcun motivo di vedere. Quel contenuto è una mappa dell’ambiente, e dovrebbe essere irraggiungibile e non trasferibile dall’esterno.
Ma la fiducia per la vista interna viene dal lato pubblico, ed è questo che rende questo progetto migliore della solita isola di DNS interno:
example.comè pubblico e firmato, con il suoDSnel padre e una catena fino alla radice.ad.example.comè delegato da lui. Il padre pubblico pubblica la delega e unDSper la chiave della zona interna.- I server autoritativi interni servono
ad.example.comfirmato. I resolver interni lo validano (radice →com→example.com→ad.example.com) usando nient’altro che il trust anchor della radice che avevano già.
Nessun trust anchor locale. Nessuna isola. Nessuna chiave distribuita a mano. I dati non escono mai dall’edificio, e il percorso di validazione è quello pubblico di sempre. Quando aggiungi un resolver, valida correttamente i nomi interni senza alcuna configurazione DNSSEC.
Siamo onesti sul compromesso, perché ce n’è uno. Pubblicare una delega e un DS nella zona pubblica significa che l’esistenza di ad.example.com, e i nomi dei suoi name server, sono pubblici. Il contenuto no, e non lo è mai: ma hai detto al mondo che la zona esiste. In cambio, ogni resolver che possiedi valida i nomi interni rispetto alla vera radice. È un buon compromesso per la maggior parte degli ambienti, e dovrebbe essere deliberato e non una sorpresa.
Due cose da fare bene insieme a questo:
- Mantieni la vista interna non enumerabile e non trasferibile.
allow-transfersui server autoritativi interni è per il signer e per i tuoi secondari, nient’altro. E tieni presente che la negazione autenticataNSECpermette a chiunque possa interrogare la zona di percorrerla da cima a fondo;NSEC3alza quel costo, ma il vero controllo è che gli estranei non possano raggiungere affatto i server. - Automatizza il
DS. UnDSnel padre che smette di corrispondere alla chiave della figlia manda l’intero dominio interno inSERVFAIL.CDS/CDNSKEYesistono perché la figlia possa segnalare un cambio di chiave e il padre possa recepirlo senza che una persona modifichi un record durante un rollover. Se la zona padre sta presso un registrar o un provider che lo supporta, usalo; altrimenti la procedura di rollover va messa per iscritto prima del primo rollover, non durante.
Far validare davvero Windows e Linux
Tutto fin qui riguardava la pubblicazione di una zona che può essere verificata. Niente di tutto ciò fa qualcosa finché qualcosa dal lato del client non insiste a verificarla. Una zona firmata alla perfezione e un client che non controlla mai una firma producono esattamente la stessa esperienza di una zona non firmata, fino al giorno in cui non è più così.
La validazione può avvenire solo in due posti, e la differenza tra i due è la differenza tra un controllo di sicurezza e un suggerimento educato.
Validare sul resolver, e fidarsi del bit AD. Il client chiede a un resolver, il resolver fa la crittografia e riporta il risultato impostando un bit, AD (authenticated data), nella risposta. Il client crede al bit. È il modello che usa Windows, ed è forte solo quanto il percorso tra il client e il resolver, perché qualunque cosa possa rispondere al posto del resolver può impostare quel bit.
Validare sul client stesso. La macchina esegue il proprio resolver che valida, quindi il «percorso verso il resolver» è un socket di loopback dentro la macchina e non resta nulla da falsificare. È più forte, e su Linux è del tutto realizzabile.
Il default è niente
Prima di configurare qualunque cosa, vale la pena di vedere cosa fa di serie una normale workstation Linux. Questa è una macchina Fedora 44, systemd 259, mai toccata:
$ resolvectl status | head -3
Global
         Protocols: LLMNR=resolve -mDNS -DNSOverTLS DNSSEC=no/unsupported
  resolv.conf mode: stub

$ grep options /etc/resolv.conf
options edns0 trust-ad

$ dig +dnssec cloudflare.com A | grep flags
;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
Leggi quelle tre righe insieme, perché raccontano una piccola storia.
Lo stub è configurato con trust-ad: gli è stato detto di credere al bit AD. systemd-resolved riporta DNSSEC=no/unsupported, quindi non sta validando niente lui stesso. E la risposta per una zona firmata torna con i flag qr rd ra e nessun ad: niente in tutto quel percorso ha dichiarato di aver validato.
Non è una configurazione sbagliata. È il default. A un client si può dire di fidarsi di un’affermazione che nessuno nella catena sta facendo. Nessuno sta controllando niente. Vale la pena di rifletterci un minuto prima di configurare qualunque altra cosa.
Linux
Tre opzioni, in ordine crescente di quanto poco devi fidarti della rete.
1. systemd-resolved, che valida in locale. Un drop-in invece di modificare il file distribuito:
# /etc/systemd/resolved.conf.d/dnssec.conf
[Resolve]
DNSSEC=yes
DNSOverTLS=opportunistic
Poi systemctl restart systemd-resolved e conferma con resolvectl status che la riga ora dice DNSSEC=yes.
L’impostazione a cui fare attenzione è quella di mezzo. DNSSEC=allow-downgrade sembra un compromesso sensato e non è un controllo di sicurezza: lo dice resolved.conf(5) stesso:
Note that this mode makes DNSSEC validation vulnerable to “downgrade” attacks, where an attacker might be able to trigger a downgrade to non-DNSSEC mode by synthesizing a DNS response that suggests DNSSEC was not supported.
Un attaccante che può falsificare le risposte è esattamente l’attaccante che DNSSEC esiste per fermare, quindi una modalità che lui può disattivare falsificando una risposta non ti compra nulla contro di lui. O è yes o è decorazione.
2. Un vero resolver che valida sull’host. Il validatore di systemd-resolved è comodo più che accurato. Dove conta, fai girare Unbound o BIND sul loopback e fai puntare lo stub a lui:
# unbound: validate against the root anchor, refuse to be stripped
server:
    module-config: "validator iterator"
    auto-trust-anchor-file: "/var/lib/unbound/root.key"
    harden-dnssec-stripped: yes
    val-permissive-mode: no

# the internal zone is reached like any other name — no local anchor needed
forward-zone:
    name: "ad.example.com."
    forward-addr: 192.0.2.53
L’equivalente in BIND è una riga, dnssec-validation auto;, che usa la sua copia incorporata dell’anchor della radice e gestisce il rollover per te.
3. Su tutto l’ambiente, sui resolver che già gestisci. Sono la fase quattro della pipeline vista prima in questo articolo. La validazione avviene lì, i client si fidano del bit AD, e il tratto tra loro è la cosa da proteggere: con DoT, o con una rete su cui sei disposto a fare quell’assunzione.
E nota cosa non c’è in nessuna di queste configurazioni: un trust anchor per la zona interna. Poiché ad.example.com è una delega dentro una zona firmata pubblicamente, ognuna di queste valida i nomi interni attraverso la normale catena dalla radice. È il progetto della sezione precedente che si ripaga da solo. L’alternativa è spingere un anchor locale su ogni client e resolver dell’ambiente, e rispingerlo a ogni rollover.
Windows
Prima la cosa importante, perché viene fraintesa di continuo: il DNS Client di Windows non valida DNSSEC. Non esegue crittografia, non controlla nessuna firma e non ha alcun trust anchor. È uno stub resolver, e lo è sempre stato.
Quello che puoi fare è costringerlo a rifiutare le risposte che non sono state validate dal server per suo conto. È la Name Resolution Policy Table, e funziona per spazio dei nomi invece che a livello globale:
# Require validated answers for the internal zone
Add-DnsClientNrptRule -Namespace ".ad.example.com" `
    -DnsSecEnable -DnsSecValidationRequired

# What is actually in force on this machine, including from Group Policy
Get-DnsClientNrptPolicy -Effective
Get-DnsClientNrptRule
Per l’ambiente, la stessa cosa sta in Group Policy sotto Computer Configuration → Policies → Windows Settings → Name Resolution Policy: crea una regola per lo spazio dei nomi, spunta l’opzione DNSSEC e spunta il requisito che il client controlli che i dati siano stati validati dal server DNS.
Da qui seguono due cose, ed entrambe contano.
Qualcosa a monte deve comunque fare la validazione. La regola NRPT fa sì che il client pretenda il bit AD; non ne crea uno. Il resolver a cui puntano quei client deve essere un resolver che valida, altrimenti ogni nome di quello spazio dei nomi fallisce.
Ed è per questo che la regola NRPT ha accanto le opzioni IPsec. Microsoft le ha messe lì per il motivo spiegato all’inizio di questa sezione: pretendere un bit che qualunque attaccante sul percorso può impostare non è un granché come requisito. Se ti affidi al modello in cui valida il resolver su una rete non fidata, l’ultimo tratto va protetto: IPsec tra client e resolver, o DoT dove il resolver lo supporta.
Fallisce in chiusura, quindi introducilo in quest’ordine
Forzare la validazione trasforma una classe di compromissioni silenziose in una classe di interruzioni rumorose. È il compromesso giusto, ed è comunque un’interruzione: un RRSIG scaduto, un DS nel padre che non corrisponde più dopo un rollover, o un resolver che non riesce a raggiungere la zona padre producono tutti SERVFAIL, e un SERVFAIL per _ldap._tcp.dc._msdcs significa che il dominio è giù, non degradato.
Quindi fallo in quest’ordine:
- Attiva prima la validazione sui resolver, e lascia stare i client. Tieni d’occhio i
SERVFAILnei log dei resolver per un paio di settimane: è qui che trovi la zona rotta in silenzio da un anno. - Automatizza il
DSprima di forzare qualunque cosa, come detto nella sezione precedente. La maggior parte delle interruzioni DNSSEC autoinflitte è un rollover in cui il padre non è mai stato aggiornato. - Poi forza i client, uno spazio dei nomi alla volta, cominciando dalla tua workstation e da una OU di test invece che dall’intero ambiente.
Il guasto contro cui stai progettando è un client a cui viene consegnato un domain controller falso. Il guasto che rischi è un client a cui non viene consegnato niente. Il secondo è recuperabile ed evidente; il primo non è né l’una né l’altra cosa. Dell’interruzione sentirai parlare entro un minuto. Dell’altra cosa non avresti mai sentito parlare.
Cifrare l’ultimo tratto: DoT e DoH sui resolver interni
La sezione sulla validazione ha lasciato una cosa in sospeso. Nel modello in cui valida il resolver (quello che ti dà Windows) il client si fida di un singolo bit impostato dal resolver, e quel bit vale quanto il percorso su cui ha viaggiato. Qualcosa deve proteggere quel percorso.
BIND supporta nativamente entrambi i trasporti cifrati, quindi è un lavoro di configurazione e non di acquisti:
- DNS over TLS: un blocco
tlsrichiamato dalisten-on, per convenzione sulla porta 853. - DNS over HTTPS: lo stesso blocco
tlspiù un bloccohttp, sulla 443. - DoT in uscita, perché
forwardersaccetta un trasporto TLS per indirizzo o per l’intero elenco. - Trasferimenti di zona su TLS, perché anche l’istruzione
primariesdi una zonatype secondaryne accetta uno: cosa direttamente utile alla pipeline vista prima in questo articolo.
Prima di tutto, sii chiaro su cosa ti compra, perché DoT e DNSSEC vengono confusi di continuo e non sono alternativi. DNSSEC autentica i dati, fino alla zona che li ha pubblicati. DoT protegge la conversazione con il resolver. Il primo sopravvive a un resolver ostile e a una rete ostile tra resolver; il secondo impedisce alla macchina sul tuo wifi di leggere e riscrivere quello che il tuo portatile ha chiesto. Li vuoi entrambi, e nessuno dei due sostituisce l’altro. Cifrare il tratto verso un resolver che non valida è una conversazione privata con qualcosa a cui si può ancora mentire.
Servirlo
tls internal-resolver {
    key-file "/etc/pki/dns/resolver.key";
    cert-file "/etc/pki/dns/resolver.pem";
    protocols { TLSv1.3; };
};

http internal-doh {
    endpoints { "/dns-query"; };
};

options {
    dnssec-validation auto;

    listen-on          port  53                          { 192.0.2.53; };
    listen-on          port 853 tls internal-resolver    { 192.0.2.53; };
    listen-on          port 443 tls internal-resolver
                                 http internal-doh       { 192.0.2.53; };
    listen-on-v6       port 853 tls internal-resolver    { 2001:db8::53; };
};
Il certificato è il vero lavoro, ed è la parte che viene saltata. Un client che verifica (che è tutto il punto) ha bisogno di un certificato valido per il nome con cui è stato configurato, emesso da qualcosa di cui si fida già. Questo significa la tua CA interna e la tua automazione dei certificati esistente, non la parola chiave ephemeral. ephemeral genera un certificato autofirmato usa e getta; c’è perché tu possa dimostrare che il listener funziona, e non vale nulla per un client che controlla davvero.
Inoltrarci sopra
Se quei resolver inoltrano da qualche parte invece di percorrere l’albero da soli, anche il tratto a monte può essere cifrato, e qui c’è una distinzione da fare bene:
tls upstream {
    ca-file "/etc/pki/tls/certs/ca-bundle.crt";
    remote-hostname "dns.example.net";
};

options {
    forwarders port 853 tls upstream { 192.0.2.1; };
};
Senza remote-hostname ottieni cifratura senza autenticazione: il traffico è illeggibile per un osservatore passivo, e un attaccante attivo che può intercettare la connessione presenta semplicemente il proprio certificato. Con remote-hostname e ca-file, BIND verifica con chi sta parlando. La prima cosa vale qualcosa. Solo la seconda merita di essere chiamata un controllo.
La metà del client non è simmetrica
Qui un ambiente misto diventa scomodo, ed è il motivo per cui configurare entrambi i trasporti invece di sceglierne uno.
Linux fa DoT come si deve. systemd-resolved accetta DNSOverTLS=yes per la modalità rigorosa, e al server si può dare il nome con cui verificarlo:
[Resolve]
DNS=192.0.2.53#resolver.ad.example.com
DNSOverTLS=yes
DNSSEC=yes
Come per DNSSEC=, la trappola è l’impostazione di mezzo: DNSOverTLS=opportunistic ripiega sul testo in chiaro quando TLS non è disponibile, cosa che un attaccante in grado di interferire con la connessione può organizzare.
Windows fa DoH, e non DoT. Il supporto DoH lato client è arrivato con Windows 11 e Server 2022, configurato per server con un template:
$doh = "https://resolver.ad.example.com/dns-query"
netsh dnsclient add encryption server=192.0.2.53 dohtemplate=$doh
DoT, al momento in cui scrivo, è comparso solo nelle build Insider. Quindi sui Windows rilasciati l’opzione cifrata è DoH o niente, ed è esattamente per questo che la sezione NRPT più sopra ha ripiegato su IPsec.
Da qui l’idea di servire entrambi dalla stessa istanza di BIND. DoT per la flotta Linux e per qualunque altra cosa lo parli, DoH per Windows, un resolver, un certificato.
Quale, e dove
Per un resolver interno, DoT è il trasporto migliore e DoH è la risposta di compatibilità.
DoT sta su una porta tutta sua. Puoi vederlo, consentirlo, negarlo, e generare un allarme su qualunque cosa faccia DNS senza usarlo. Il vantaggio di DoH (essere indistinguibile dal normale traffico web sulla 443) è un beneficio reale su una rete ostile e un fastidio sulla tua, dove poter dire cosa è DNS è una funzione per cui hai pagato. Sull’ambiente che controlli, preferisci il trasporto che puoi osservare, e usa DoH perché Windows non ti lascia scelta, non perché sia migliore.
Già che ci sei: cifra i trasferimenti
La pipeline vista prima in questo articolo sposta la zona AD tramite AXFR, e la sezione sulle viste separate ha sottolineato che il suo contenuto è una mappa dell’ambiente. TSIG autentica quei trasferimenti; non li nasconde. Poiché l’istruzione primaries di un secondario accetta una configurazione TLS, anche il trasferimento può viaggiare su TLS: RFC 9103 se vuoi lo standard:
zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 port 853 tls xfr-tls key transfer-to-signer; };
    ...
};
Autenticato dalla chiave, cifrato dal trasporto. Se un qualunque salto di quella pipeline attraversa un collegamento tra sedi, un hypervisor che condividi o qualunque cosa su cui non metteresti volentieri un hub, valgono bene i venti minuti.
Cosa non risolve
- Non è validazione. Già detto sopra, e vale la pena di ripeterlo perché i vendor vendono «DNS sicuro» intendendo solo cifratura.
- Non nasconde nulla al resolver. Il resolver vede ogni query per intero. La cifratura protegge il percorso, non la riservatezza della ricerca nei confronti di chi gestisce il resolver: il che va bene quando chi lo gestisce sei tu.
- Non fa nulla per un client che non verifica il certificato, e le modalità opportunistiche sono degradabili proprio dall’attaccante che ti preoccupa.
- E non è un motivo per mettere un listener sul domain controller. Il DNS cifrato sul DC risolverebbe splendidamente il problema sbagliato. Il DC continua a non rispondere a nessuno.
Come controllare cosa hai
Comandi da eseguire sul tuo ambiente. Gli output sono la parte interessante, e un paio di essi tendono a essere una lettura scomoda la prima volta.
# Walk the tree yourself, one delegation at a time
dig +trace dc01.ad.example.com

# Validate, and show the chain being built
delv +rtrace +vtrace ad.example.com SOA

# Is the resolver you are pointed at actually validating?
# A deliberately broken test name must come back SERVFAIL, not an address
dig @<resolver> dnssec-failed.org A

# What does the estate advertise as a domain controller?
dig SRV _ldap._tcp.dc._msdcs.<domain>
dig SRV _kerberos._udp.<domain>

# Is a DC answering for names it has no business answering?
# Ask it for something it is not authoritative for. "recursion requested
# but not available" is the answer you want. An actual address means it is
# serving the estate — recursing if it is BIND, relaying to the forwarder
# if it is SAMBA_INTERNAL. Either way it should not be doing that.
dig @<dc> www.example.org A

# Is the DC configured as the estate's DNS relay?
grep -E 'dns forwarder|server services' /etc/samba/smb.conf

# Will a DC hand its zone to anybody who asks?
dig @<dc> AXFR ad.example.com

# Which backend is this DC running, and does named have the module?
grep -r dlz /etc/named.conf /var/lib/samba/bind-dns/ 2>/dev/null
samba-tool dns query <dc> <domain> @ ALL

# Is the internal zone chained to the public parent?
dig DS ad.example.com @<public-authoritative-for-example.com>

# What does the local stub actually do with the AD bit, and is the
# hop to the resolver encrypted?
resolvectl status                    # DNSSEC= and DNSOverTLS= per link
grep options /etc/resolv.conf        # trust-ad, trusting whom exactly?

# Did anything in the path claim to have validated? Look for "ad" in the flags
dig +dnssec ad.example.com SOA | grep flags

# Validate independently of whatever the local resolver believes
delv ad.example.com SOA              # "fully validated" is the line you want

# Is the resolver actually listening for DoT, and does its certificate
# match the name clients are configured with?
kdig +tls @192.0.2.53 ad.example.com SOA
openssl s_client -connect 192.0.2.53:853 \
    -servername resolver.ad.example.com </dev/null 2>/dev/null \
    | openssl x509 -noout -subject -dates
E su un client Windows, per vedere se sta pretendendo qualcosa:
Get-DnsClientNrptPolicy -Effective    # the rules actually in force
Resolve-DnsName ad.example.com -DnssecOk
Get-DnsClientDohServerAddress         # is the hop to the resolver encrypted?
I due che più spesso producono una sorpresa sono il controllo sulla ricorsione e il tentativo di AXFR. Se un DC risponde a uno dei due per un client qualsiasi, la pipeline di questo articolo non è in piedi, qualunque cosa dica il diagramma sul wiki.
Il terzo è resolvectl status su una macchina che nessuno ha toccato. DNSSEC=no/unsupported insieme a trust-ad in resolv.conf è lo stato normale di un desktop Linux, e significa che il lavoro di firma descritto sopra al momento non lo controlla nessuno.
La versione breve
Un resolver nasce conoscendo i root server e una chiave, e impara tutto il resto sentendoselo dire. I nomi si trovano scendendo lungo le deleghe, e i servizi si trovano chiedendo un record SRV: quindi quando un client comincia a fare Kerberos con un domain controller, l’identità di quel domain controller è arrivata da una risposta DNS. La scoperta tramite DNS è corretta e va bene. L’autorizzazione tramite DNS no, e una quantità sorprendente di infrastruttura la fa comunque in silenzio.
DNSSEC è ciò che rende verificabili quelle risposte: firme su ogni insieme, un DS in ogni padre, una catena fino a un unico trust anchor alla radice, e la negazione autenticata perché un nome non possa essere fatto sparire. Compra autenticazione dell’origine e integrità: non riservatezza, e non correttezza. Firma qualunque cosa dica la zona, ed è per questo che non può salvare una zona che macchine non fidate possono scrivere. E ha bisogno di un padre: un TLD interno inventato non ha dove mettere un DS, quindi .local, .lan, .internal e home.arpa ti lasciano o senza firma o a gestire un’isola privata di chiavi distribuite a mano.
Per un dominio Active Directory, questo produce un progetto più che un elenco di impostazioni. Usa una delega dentro una zona pubblica che possiedi, così la fiducia scende lungo la normale catena dalla radice mentre i dati non escono mai. Servi le partizioni AD con BIND e dlz_bind9 (DLZ non è il rischio, è il modo in cui tiri fuori la zona dalla directory) e lascia che il DC sia un primario nascosto che trasferisce verso l’esterno e non risponde a nessun altro. Una zona DLZ non può essere firmata, quindi la firma è una normale zona secondaria che contiene la copia trasferita, con inline-signing e una dnssec-policy: un secondo named sul DC se vuoi meno macchine, un host separato se vuoi le chiavi private lontane dalla directory. In entrambi i casi è firmata una volta sola, in un punto definito, sotto una policy delle chiavi, e il primo salto è un polling e non un push, perché DLZ non può inviare un notify. Pubblica da server autoritativi autonomi che non contengono chiavi e non hanno alcuna strada verso la directory.
E tieni i client fuori dalla zona che conta. L’aggiornamento dinamico sicuro autentica chi scrive, non il significato, e in una zona integrata in AD predefinita chi scrive è Authenticated Users, cioè ogni account, non solo ogni macchina: quindi una zona che contiene sia i record dei portatili sia i locator _msdcs è a un utente vittima di phishing di distanza da un client a cui viene detto, con una firma perfettamente valida, che il domain controller sta da un’altra parte. Le registrazioni dei client vanno in una sotto-zona, delegata all’esterno o separata in Samba, dove il peggio che un account compromesso può fare è mentire su se stesso.
Anche se la domanda migliore è se i client debbano registrarsi affatto. Un portatile del 2026 ha un indirizzo sul wifi di casa, un altro sul wireless dell’ufficio, un altro tramite il dock e un altro sulla VPN, e ne pubblicherà allegramente la maggior parte. Quello che consuma il record A di un portatile è quasi nulla: gli strumenti che devono raggiungere una workstation hanno un proprio inventario, perché il DNS non è mai stato affidabile per i client mobili. I record dei server dovrebbero venire dal provisioning, e la flotta non dovrebbe registrare un bel niente.
Poi fai in modo che qualcosa controlli le firme, perché nulla di quanto sopra vale qualcosa finché un client non rifiuta una risposta. Su Linux significa DNSSEC=yes in systemd-resolved, o un vero resolver che valida sul loopback: mai allow-downgrade, che un attaccante capace di falsificare le risposte può semplicemente disattivare falsificando una risposta. Su Windows significa accettare che il DNS client non valida mai nulla da sé, e usare una regola NRPT per fargli pretendere una risposta che il resolver ha validato, con l’ultimo tratto protetto perché quel requisito è un singolo bit. Attivalo prima sui resolver e tieni d’occhio i SERVFAIL, automatizza il DS, poi forza i client. Fallisce in chiusura, che è il verso giusto ed è comunque un’interruzione.
Niente di tutto questo è esotico. È delega, trasferimento e firma, le tre cose che il DNS ha sempre fatto, disposte in modo che la macchina che contiene la tua directory non sia la macchina che riceve domande dal parcheggio, e che quando qualcosa mente a un client, il client se ne accorga.