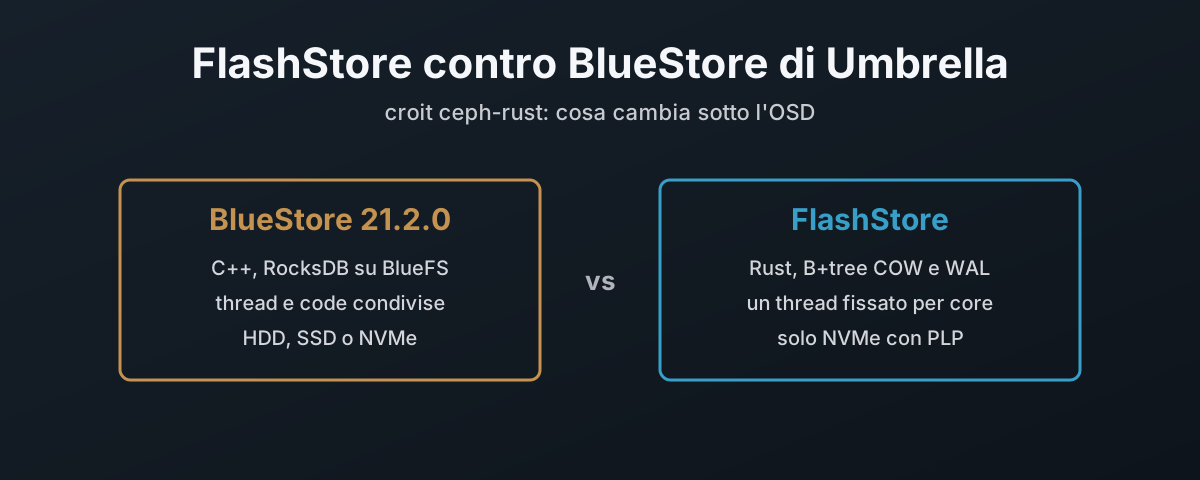
Lo dico subito: lavoro per croit, che l’ha scritto. Tutto quello che segue è letto dal codice sorgente e dalla documentazione pubblicati dei due progetti, linkati in fondo alla pagina, e dove la documentazione di croit non è d’accordo con il codice di croit, lo dico.
L’OSD di Ceph, riscritto da zero
croit ha pubblicato ceph-rust, un OSD di Ceph scritto da zero in Rust, con un object store suo chiamato FlashStore al posto di BlueStore1.
È entrato in anteprima pubblica il 9 novembre 2026, con la disponibilità generale prevista per il primo trimestre del 20271.
Non è un fork.
La regola del progetto è che il C++ di Ceph viene letto come riferimento, messo per iscritto come specifica con parole di croit, e poi implementato a partire dalla specifica2.
La dichiarazione che conta per chiunque usi Ceph è quella del sostituto diretto.
I tuoi monitor, i tuoi manager, la CLI ceph e i tuoi client restano come sono.
Un OSD FlashStore entra negli stessi pool e negli stessi placement group degli OSD classici già presenti, e cambi un disco alla volta1.
Quindi per un operatore la domanda è pratica. Se sostituisci un OSD BlueStore con uno FlashStore, cosa c’è di diverso sotto? Non in astratto, e non contro un BlueStore visto anni fa a una conferenza. Contro il BlueStore che usi davvero oggi se sei su Umbrella, Ceph 21.2.0, che è la release contro cui FlashStore è costruito e testato1.
Quindi il confronto qui è questo, e solo questo. Il BlueStore di Umbrella come lo descrivono il suo codice e la sua documentazione, contro FlashStore come lo descrivono il suo codice e i suoi registri delle decisioni.
Riguarda chiunque abbia cluster Ceph su NVMe, e chiunque abbia guardato quanti core gli costa un OSD. Non riguarda per niente i cluster su HDD, e il motivo viene fuori più avanti.
Cosa c’è nel repository
Il repository è uno snapshot in sola lettura dell’albero di sviluppo privato di croit. Niente issue tracker, niente pull request; gli aggiornamenti arrivano come nuovi commit di snapshot1. È la fase di anteprima, e serve a raccogliere il feedback della community mentre croit fa girare internamente i suoi casi di test di produzione prima di dichiararlo sicuro da usare. Lo sviluppo aperto arriva dopo la prima release di produzione, come succede nella maggior parte dei progetti open source sponsorizzati da un’azienda. Questo snapshot è datato 10 novembre 2026 e contiene circa 700.000 righe di Rust e oltre 450 architecture decision record, gli ADR, cioè i brevi documenti che registrano perché è stata fatta ogni scelta di progetto.
Per un confronto come questo, la parte utile sono gli ADR. Sono schietti, contengono misure, e registrano cosa è stato provato e buttato via oltre a cosa è rimasto.
| Componente | Cosa sostituisce | Anteprima | GA (prevista) |
|---|---|---|---|
| OSD FlashStore | ceph-osd + BlueStore | nov 2026 | Q1 2027 |
| librustyrados | librados | nov 2026 | Q1 2027 |
| librustyrbd | librbd | nov 2026 | Q1 2027 |
| Trasporto RDMA (RoCEv2) | niente in Umbrella | nov 2026 | Q1 2027 |
| CephFS2, RGW in Rust | MDS, RGW | Q1 2027 | Q2 2027 |
| ceph-mon, ceph-mgr | non sostituiti | n/d | n/d |
Vale la pena conoscere le licenze prima di costruirci sopra qualcosa. Il demone e gli strumenti sono LGPL-3.0-only, le librerie client sono MPL-2.0, e la documentazione è CC-BY-SA-4.03. Le librerie client sono passate a MPL perché un programma Rust possa linkarle staticamente senza gli obblighi di ri-linking che porta la LGPL, il che è una scelta ragionata e messa per iscritto come tale3.
Anteprima vuol dire quello che dice. Il README di croit stesso dice che serve per test e valutazione e che è «not yet recommended for production data»1. Neanch’io ci metterei ancora dati dei clienti, e niente nel resto di questo articolo cambia questo.
Due store, uno accanto all’altro
Un OSD ha due metà. La metà superiore parla il protocollo Ceph, possiede i placement group, fa peering, recovery e scrub. La metà inferiore, l’object store, trasforma «scrivi questi byte in questo oggetto» in blocchi su un disco e promette che sopravvivano a un’interruzione di corrente.
BlueStore è la metà inferiore di Umbrella. La sua documentazione dice che «reads and writes to the devices directly in a ‘raw’ fashion»4, e che consuma «raw block devices or partitions»5. I dati degli oggetti vanno direttamente sul block device. Tutto il resto, i metadati degli oggetti, l’OMAP e la sua contabilità interna, va in un database chiave/valore RocksDB incorporato, e RocksDB sta su BlueFS, un piccolo file system che BlueStore si porta dietro apposta56.
FlashStore butta via tutto questo. Un solo B+tree copy-on-write per shard dello store contiene tutto: collection, metadati degli oggetti, attributi estesi, mappe degli extent, OMAP, il log dei PG, i contatori di riferimento e persino la bitmap dell’allocatore7. Accanto ci sono un anello di write-ahead log di tipo redo e l’area dati. Niente RocksDB, niente BlueFS, e nessun secondo database da tarare.
L’altra grande separazione è il disco stesso. BlueStore passa per il block layer del kernel verso qualunque cosa gli dai. FlashStore parla con l’NVMe o con SPDK, un driver in userspace che toglie il device al kernel tramite vfio, o attraverso il kernel con io_uring89. SPDK è il backend predefinito. Il livello io_uring è quello che funziona dove vfio non funziona, ed è per questo che è quello su cui sono finito nella build su Proxmox.
Dove stanno i metadati
Si parte da qui. Quasi tutto il resto ne deriva.
| BlueStore di Umbrella | FlashStore | |
|---|---|---|
| Metadati degli oggetti | chiavi RocksDB | B+tree COW per shard |
| OMAP | chiavi RocksDB | lo stesso B+tree di default; LSM o RocksDB opzionali alla preparazione |
| Log dei PG | chiavi RocksDB | lo stesso B+tree |
| Stato dell’allocatore | allocatore hybrid, freelist in RocksDB | bitmap per shard, dentro l’albero |
| Device per i metadati | block.db e block.wal opzionali | nessuno, lo stesso NVMe |
| Checksum dei dati | crc32c ogni 4 KiB di default | crc32c ogni 4 KiB, nella mappa degli extent |
| Numero di store per OSD | uno | uno per core |
I default dal lato di BlueStore vengono direttamente dal file delle opzioni di Umbrella: RocksDB come backend chiave/valore, l’allocatore hybrid, checksum crc32c61011. Il checksum dei metadati di BlueStore «is handled by RocksDB and uses the crc32c algorithm», e per i dati gli costa «a checksum value (usually 4 bytes) for every 4 KB block of data»4. Sui checksum i due store sono d’accordo. FlashStore tiene un crc32c per ogni blocco da 4 KiB nella mappa degli extent e lo verifica in lettura7.
È sulla struttura che si separano. Il RocksDB di BlueStore è un log-structured merge tree, quindi scrive, poi compatta in background, riscrivendo dati che ha già scritto. L’albero di FlashStore viene aggiornato in copy-on-write e riversato su disco ai checkpoint: ogni cinque secondi finché c’è qualcosa di non persistito, o quando l’anello del WAL arriva a metà7.
Un’altra conseguenza è che FlashStore non ha un device veloce per i metadati, perché non gli serve.
Su Umbrella puoi mettere block.db su un disco più veloce, e BlueStore metterà «as much metadata as it can on the DB device»4.
FlashStore dà per scontato che ogni disco sia già un NVMe veloce, e tiene i metadati accanto ai dati.
È un’ipotesi giusta per l’hardware a cui punta. È anche esattamente il motivo per cui non c’è una strada per gli HDD.
L’OMAP è l’unico punto in cui FlashStore si copre. L’albero è il default, ma uno store si può preparare con un motore LSM di croit, o con RocksDB, dietro la stessa interfaccia12. Il motore OMAP si sceglie quando si crea lo store. Non lo cambi su un OSD in funzione.
Una scrittura da 4 KiB, in due modi
Ecco la differenza che sentiresti, se ne senti una.
Prendi una scrittura da 4 KiB su un oggetto in Umbrella con le impostazioni predefinite su flash.
bluestore_min_alloc_size_ssd è 4 KiB e bluestore_prefer_deferred_size_ssd è 0, quindi una scrittura intera da 4 KiB va su 4 KiB appena allocati1314.
BlueStore invia quella scrittura dei dati, e la transazione resta in STATE_AIO_WAIT finché il disco non dice di aver finito15.
Solo allora i metadati vengono messi in coda per RocksDB, e il thread di sync di RocksDB fa il flush del block device prima del commit16.
Poi il client riceve la conferma.
Due viaggi al device, in serie.
FlashStore li manda entrambi insieme. I dati vanno in un extent nuovo da 4 KiB e l’unità di WAL va nell’anello del log in parallelo. Il record del WAL contiene il crc32c di ogni nuovo blocco di dati, così il replay dopo un crash può capire se i dati sono arrivati7. La conferma parte, nell’ordine del log, quando i dati, l’unità di WAL e ogni transazione precedente sono durevoli7. La motivazione che l’ADR dà per questo progetto è «parallel commit gives one device latency per ack»7.
Due cose tengono onesto il confronto. Su un OSD carico entrambi gli store raggruppano i commit, quindi sotto carico il divario è minore di una latenza di device per scrittura. E un singolo viaggio al device su NVMe dura qualche decina di microsecondi. Se lo noti dipende da se i tuoi client aspettano sulla latenza a bassa queue depth, come spesso fanno i database su RBD, o spingono throughput, dove sparisce.
croit ha provato ad andare oltre, a una sola scrittura sul device per transazione, alla maniera di ZFS. L’hanno costruito, l’hanno misurato e l’hanno buttato via: il guadagno si vedeva solo a queue depth 1 e la complessità non ne valeva la pena17. Lo valuto più di qualunque grafico di benchmark. È un registro delle decisioni che dice «l’abbiamo costruito e non ne valeva la pena», in pubblico.
La scrittura sotto i 4 KiB
È nella scrittura più piccola che i due divergono davvero.
Diciamo che un client sovrascrive 512 byte in mezzo a un blocco che contiene già dati.
Umbrella usa ancora di default il suo percorso di scrittura originale; bluestore_write_v2, il rifacimento, è spento18.
Su quel percorso, una scrittura più piccola di min_alloc_size in un blocco già allocato diventa una scrittura differita19.
I dati viaggiano dentro la transazione di RocksDB come chiave con prefisso L, e vanno nella loro vera sede solo dopo che al client è stato detto che sono al sicuro2021.
Quindi i dati arrivano al disco due volte. La documentazione di Umbrella non lo nasconde: «writes smaller than min_alloc_size must first pass through the BlueStore WAL»4.
FlashStore non sovrascrive mai dati vivi sul posto, punto7. Gli oggetti fino a 2 KiB vanno oltre e vivono interamente nell’albero, quindi una sola scrittura nel WAL è tutto il commit7.
Questo significa anche che FlashStore non ha una coda di scritture differite da svuotare, nessun replay differito al mount e nessuna chiave L da ripulire.
Paga invece da un’altra parte: i blocchi liberati vengono trattenuti fino al checkpoint successivo, quindi lo spazio liberato arriva in ritardo fino a un intervallo di checkpoint7.
Thread contro core
La metà superiore dell’OSD differisce altrettanto.
Il ceph-osd di Umbrella è un classico server multithread, e ogni numero nella metà sinistra del diagramma qui sotto è uno dei suoi default su flash22.
Un’operazione attraversa diversi di quei pool lungo il percorso. Condividono stato dietro dei lock.
FlashStore tiene l’intero percorso su un solo core fissato e in polling, dalla scheda di rete al disco e ritorno23. Ogni placement group appartiene esattamente a un core, e così tutto ciò che il PG tocca: «no locks, no atomics, no shared mutable state»24. Il traffico tra core passa per anelli single-producer, e con il messaggio passa anche la sua proprietà.
Lo store segue la stessa divisione.
flashstore_store_shards ha come default uno shard per core, ognuno con il suo anello WAL, il suo albero e il suo allocatore, e un PG vive in esattamente uno shard257.
BlueStore è uno store per OSD con un solo RocksDB.
C’è un prezzo, e l’ADR lo dichiara: «idle cores burn CPU (accepted; optional adaptive sleep later)»23.
Lavori successivi hanno aggiunto l’idle adattivo e le attese temporizzate sul device, così un core non gira a vuoto per tutta la latenza del device a bassa queue depth8, ma il principio resta, e flashstore_cores ha come default 8 quando non fissi un intervallo25.
A FlashStore dai core interi.
Su un nodo di storage dedicato va bene. Su una macchina iperconvergente dove quegli stessi core fanno girare anche VM, è il primo conto da fare.
Il disco deve mantenere la sua promessa
BlueStore è scritto per gestire un disco che mente su quando i dati sono al sicuro. FlashStore si rifiuta proprio di avere a che fare con quel disco.
| BlueStore di Umbrella | FlashStore | |
|---|---|---|
| Cosa rende durevole una scrittura | flush del block device prima del commit di RocksDB | la scrittura completata su un disco con PLP |
| Flush sul percorso critico | sì | no |
| Disco con write cache volatile | usato, e con flush | mkfs lo rifiuta; controllo dell’host FAIL |
| Eccezione | non serve | solo in laboratorio: bit FUA su ogni scrittura durevole |
Il lato BlueStore è il thread di sync kv già citato16. Il lato FlashStore è l’ADR sulla durabilità e il controllo dell’host: PLP vuol dire che il disco non dichiara nessuna write cache volatile, quindi un completamento significa che i dati sono su supporto stabile2426.
È la scelta giusta per l’obiettivo, ma devi avere chiaro cosa esclude, perché quasi tutti gli NVMe consumer hanno una cache volatile e niente PLP, e così una buona parte del materiale «datacenter» venduto sul prezzo. Niente PLP, niente FlashStore. Qualunque cosa tu ne pensi per il resto.
Su cosa FlashStore non gira
Metti i requisiti uno accanto all’altro e il mercato a cui punta è evidente.
| BlueStore di Umbrella | FlashStore | |
|---|---|---|
| Supporti | HDD, SSD, NVMe | solo NVMe |
| Protezione da perdita di alimentazione | non richiesta | richiesta, mkfs si rifiuta senza |
| Formato dei settori | 512 B o 4 KiB | 4 KiB previsto, avviso altrimenti |
| Layout | partizioni, LVM tramite ceph-volume | namespace interi, niente partizioni |
| Device DB/WAL separato | supportato | non esiste |
| Cifratura a riposo | --dmcrypt tramite ceph-volume | fuori dallo scope |
| Client msgr1 | in ascolto di default | rifiutati, solo msgr2 |
| Cache tiering | deprecato, ancora presente | rifiutato, il pool diventa passivo |
| Requisiti del kernel | qualsiasi supportato | io_uring: Linux 5.19+, o il 5.14 di RHEL 9 con backport; hugepage per SPDK |
La colonna di BlueStore è quella di Umbrella: ceph-volume cifra i volumi logici «using dmcrypt by specifying the --dmcrypt flag»27, e ms_bind_msgr1 è ancora true di default28.
La colonna di FlashStore viene dal suo riferimento hardware e dalla sua decisione sullo scope2629.
Due di queste meritano più di una riga di tabella.
La cifratura a riposo è esclusa, con un motivo: SPDK scavalca dm-crypt, e una cifratura dentro lo store non è prevista. La risposta dell’ADR sono i dischi NVMe autocifranti, o la cifratura sopra lo store, al client o in RGW29. Se hai un requisito di conformità che nomina dm-crypt sull’OSD, oggi è un blocco.
msgr1 è escluso come rischio accettato. I client kernel più vecchi del 5.11 e librados precedenti a Nautilus non possono proprio parlare con un OSD FlashStore29. La maggior parte delle installazioni è ben oltre. Alcune no, ed è la vecchia macchina dimenticata nell’angolo che se ne accorge.
Dice al monitor di essere BlueStore
Questa è quella che fregherà qualcuno.
Di default, un OSD FlashStore si avvia e dice ai monitor osd_objectstore=bluestore30.
Non si nasconde. Aggiunge accanto le sue chiavi flashstore_version e flashstore_build30.
Il motivo è la compatibilità: un monitor Umbrella permette funzioni come le sovrascritture EC su un pool solo quando ogni suo OSD dichiara BlueStore, e moduli del manager come Prometheus e telemetry si basano sullo stesso valore30.
L’ADR dice esplicitamente che bluestore qui «is a compat value for mon/mgr feature gates, not a product name»30.
C’è un interruttore, flashstore_report_objectstore=flashstore, che rinomina tutto: i metadati, le chiavi bluestore_bdev_*, il perf logger, i comandi tell e i codici di salute BLUESTORE_*. Servono monitor modificati, e il default resta bluestore2530.
Le build di Ceph di croit hanno quelle modifiche, quindi lì FlashStore si dichiara flashstore e niente di quello che segue si applica.
Il nome bluestore c’è per i monitor e i manager standard che la gente usa oggi in produzione.
Capisco il perché.
Un controllo del monitor basato su una stringa è un progetto di Ceph, non di croit, e rifiutarsi di dire bluestore spegnerebbe funzioni su un cluster non modificato.
Questa è la trappola su un cluster standard.
Ogni dashboard, ogni script di inventario e ogni ceph osd count-metadata osd_objectstore che lanci conterà gli OSD FlashStore come BlueStore.
Durante una migrazione, proprio quando hai più bisogno di sapere quali OSD sono quali, il campo più ovvio non ti dice niente.
Quindi controlla flashstore_version in ceph osd metadata, non osd_objectstore.
Mettilo nel tuo runbook prima che entri il primo OSD FlashStore.
Stesse manopole, comportamento diverso
FlashStore legge molte delle opzioni esistenti di Ceph, e per lo più è una buona notizia. Non tutte le opzioni significano quello che significavano su Umbrella, e quelle che non lo fanno sono dove un cluster ben tarato ha una sorpresa.
| Opzione | BlueStore di Umbrella | FlashStore |
|---|---|---|
compression_mode, per pool | none, passive, aggressive, force | le stesse quattro, stesso significato |
compression_algorithm | snappy di default | snappy, zlib, zstd, lz4; livello zstd fisso a 1 |
bluestore_compression_max_blob_size_ssd | 64 KiB | blocchi da 64 KiB |
osd_memory_target | 4 GiB, cache regolate in automatico a caldo | letto una volta all’avvio, dimensiona le cache dello store, nessuna regolazione automatica |
osd_op_queue | mclock_scheduler | accettato e ignorato |
osd_mclock_* | attivi | accettati e ignorati |
csum_type | crc32c di default, varianti xxhash disponibili | crc32c fisso; qualsiasi altro valore scrive un avviso nel log31 |
La compressione corrisponde.
La modalità predefinita di BlueStore è none e il suo algoritmo predefinito è snappy3233; FlashStore implementa le stesse quattro modalità, le stesse opzioni di pool e la stessa divisione in blocchi da 64 KiB, e l’ADR nota che un blocco da 64 KiB comprimibile al 50% occupa lo stesso spazio su entrambi34.
Non era scontato che ci fosse. Il file dell’ADR si chiama ancora no-store-compression, dalla decisione originale, ribaltata quando croit ha fissato l’obiettivo di piena parità funzionale con il Ceph classico34.
La memoria non è in parità.
Umbrella regola in automatico le cache di BlueStore rispetto a osd_memory_target mentre gira3536.
FlashStore legge l’obiettivo una volta all’avvio, lo divide tra i suoi shard, e una modifica fatta con ceph config set ha effetto al riavvio successivo37.
Inoltre non tiene il processo dentro l’obiettivo: hugepage, buffer di rete e stato dei PG stanno fuori37.
Quindi osd_memory_target dimensiona le cache di FlashStore. Non limita la memoria dell’OSD nel modo a cui magari sei abituato.
E mClock viene ignorato del tutto37.
Non attenuato. Ignorato.
Non c’è uno scheduler delle operazioni da configurare, perché ogni core possiede i suoi PG.
Recovery e backfill vengono invece frenati da osd_max_backfills, osd_recovery_max_active e dalle opzioni di sleep37.
Se su Umbrella hai tarato dei profili mClock per una ricostruzione, quelle impostazioni non fanno niente su un OSD FlashStore, e niente te lo segnalerà.
Non c’è conversione, in nessuna direzione
Non puoi convertire un OSD BlueStore in uno FlashStore. La guida di migrazione di croit lo dice chiaramente: «There is no in-place conversion of a BlueStore device»38. Offre invece due sequenze, ed entrambe sono backfill38:
| Aggiungi, poi togli | Libera, poi aggiungi | |
|---|---|---|
| Serve | uno slot NVMe libero | niente di libero |
| Passo 1 | prepara FlashStore sul disco nuovo | ceph osd out, aspetta lo stato clean |
| Passo 2 | aspetta active+clean | ferma e fai il purge dell’OSD classico |
| Passo 3 | togli l’OSD classico | prepara FlashStore sul disco liberato |
| Rischio durante l’operazione | nessuno oltre il normale backfill | una copia in meno finché il backfill non finisce |
E non diventa più facile dopo. Il formato su disco di FlashStore ha dei feature bit, e un mount rifiuta un bit sconosciuto: «Every format change means mkfs; unknown bits refuse mount (no downgrade)»7. Quindi un cambio di formato in una release futura di FlashStore è lo stesso svuota-e-riempi della prima migrazione.
Una cosa che la documentazione sbaglia.
La checklist della guida di migrazione dice di assicurarsi che «the pools do not use erasure coding on croit-flashstore-osd OSDs»38.
La guida sull’erasure coding nello stesso snapshot dice che FlashStore serve i pool EC legacy di default, e il default del codice per l’EC ottimizzato è all3940.
Una delle due è obsoleta, e a giudicare dal codice è la guida di migrazione.
Leggerei comunque per intero la guida EC prima di mescolare pool EC tra i due tipi di OSD, perché il guasto che descrive è un PG che si degrada e un backfill che si blocca39.
Uno store fatto per i dischi che compriamo davvero
BlueStore è stato fatto per girare su tutto. Dischi rotanti, SSD economici, NVMe, partizioni, LVM, volumi cifrati, un device DB veloce davanti a un device dati lento. Quell’ampiezza è il motivo per cui è diventato il default, ed è il motivo per cui si porta dietro un percorso di scrittura differita, un flush prima di ogni commit, un database chiave/valore su un file system tutto suo, e un pool di thread per tenere in moto tutto questo. Ognuna di queste cose esiste perché qualche disco da qualche parte ne aveva bisogno.
FlashStore parte dall’estremo opposto. Dà per scontato che il disco sia NVMe, che abbia la protezione da perdita di alimentazione, e che sia abbastanza veloce da far diventare il software il collo di bottiglia. Poi butta via tutto ciò che esisteva solo per gli altri dischi.
È la scommessa giusta? Per i nuovi cluster all-flash, costruiti su NVMe enterprise come si deve, sì. È lì che stanno andando i cluster Ceph, e un OSD che spende i suoi core in lock, passaggi di mano e un database che compatta alle sue spalle sta pagando, ogni secondo di ogni giorno, per una flessibilità che un cluster del genere non userà mai.
Ma la scommessa ha un costo, e preferisco che tu lo veda prima di entrarci. Rinunci a HDD, dm-crypt, msgr1, regolazione della memoria a caldo e mClock. Su un cluster standard ottieni un OSD che dice ai tuoi monitor di essere BlueStore, perché i monitor e i manager di oggi non gli lasciano altra scelta; le build di croit non ne avranno bisogno. Ottieni un formato in cui non puoi convertire, e tra le cui versioni non puoi convertire. E lo ottieni in anteprima, da un solo vendor, che per caso è il mio datore di lavoro.
Quindi tratta il codice come la prova, non questo articolo e non il report di benchmark di croit. I registri delle decisioni sono pubblici e dicono cosa è stato misurato e cosa è stato buttato via. Leggili, costruisci un cluster di test sul materiale che installeresti davvero, e misura il tuo carico di lavoro. Se fa quello che dicono gli ADR sui tuoi dischi, lo saprai. Se non lo fa, saprai anche questo, e l’avrai scoperto su un cluster di test.
croit ceph-rust, README at snapshot 48f9014 — componenti, stato e roadmap, «not yet recommended for production data», compatibile sul filo con v21.2.0 e v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, green-field, no Crimson fork — «No fork, no linking of Ceph code»; sorgente di Ceph letto come riferimento, specifiche con parole proprie. ↩︎
ADR 0164, licences — demone e strumenti LGPL-3.0-only, librerie client MPL-2.0, documentazione CC-BY-SA-4.0, e il motivo della MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — accesso raw al device, device DB, «writes smaller than min_alloc_size must first pass through the BlueStore WAL», checksum. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore «consumes raw block devices or partitions»; RocksDB incorporato per i metadati interni. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— defaultrocksdb. ↩︎ ↩︎ADR 0021, storage engine — B+tree COW per shard, anello WAL, commit in parallelo, checkpoint, dati inline, rilasci trattenuti, «Every format change means mkfs». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, storage I/O — SPDK su vfio, modificato in due livelli con io_uring, idle temporizzato sul device. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkè il backend predefinito,kernelekernel-cmdlasciano l’NVMe al driver del kernel. ↩︎Ceph v21.2.0,
bluestore_allocator— defaulthybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— defaultcrc32c. ↩︎ceph-rust, croit-flashstore-tool usage — «fresh prepare/mkfs –omap-engine btree|lsm|rocksdb». ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— default 4 KiB. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— default 0. ↩︎Ceph v21.2.0,
BlueStore.cc, transaction state machine — gli aio in sospeso portano la transazione inSTATE_AIO_WAITprima che venga messa in coda per il commit chiave/valore. ↩︎Ceph v21.2.0,
BlueStore.cc, kv sync thread — «flush/barrier on block device» prima dell’invio a RocksDB. ↩︎ ↩︎ADR 0027, single-IO atomic commit, rejected — «gain only at QD1», costruito e rimosso. ↩︎
Ceph v21.2.0,
bluestore_write_v2— «Use faster write path», default false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— lettura di testa e coda, poi «chunk-aligned deferred overwrite». ↩︎Ceph v21.2.0,
BlueStore.cc, “journal deferred items” — la transazione differita viene scritta come chiave nella stessa transazione di RocksDB. ↩︎Ceph v21.2.0,
BlueStore.cc, key prefixes —PREFIX_DEFERRED = "L". ↩︎Default dei thread di Ceph v21.2.0 —
osd_op_num_shards_ssd8;osd_op_num_threads_per_shard_ssd2;osd_op_queuemclock_scheduler;ms_async_op_threads3; creazione dei thread inBlueStore.cc,bstore_kv_syncebstore_kv_final. ↩︎ADR 0006, thread-per-core runtime — un thread fissato in busy-polling per core, PG posseduti da un solo core, «idle cores burn CPU (accepted …)». ↩︎ ↩︎
ADR 0008, concurrency and durability — «no locks, no atomics, no shared mutable state»; PLP obbligatoria,
mkfsrifiuta i dischi senza PLP, eccezione FUA per il laboratorio. ↩︎ ↩︎ceph-rust docs, configuration reference —
flashstore_coresdefault 8,flashstore_store_shardsautomatico,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, hardware and host requirements — write cache volatile FAIL, LBA da 4 KiB, niente partizioni, requisiti di kernel e io_uring. ↩︎ ↩︎
Ceph Umbrella, ceph-volume encryption — «Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag». ↩︎Ceph v21.2.0,
ms_bind_msgr1— default true. ↩︎ADR 0168, encryption at rest, msgr1, cache tiering out of scope — «SPDK bypasses dm-crypt»; i client solo v1 «cannot reach croit-flashstore-osd». ↩︎ ↩︎ ↩︎
ADR 0019, report
osd_objectstore=bluestore— i controlli delle funzioni del monitor, le chiaviflashstore_*aggiuntive, e l’opzione di dichiarazioneflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— «csum_type {v} unsupported; using fixed crc32c per 4096-byte block». ↩︎Ceph v21.2.0,
bluestore_compression_mode— defaultnone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— defaultsnappy. ↩︎ADR 0059, per-pool store compression — stesse modalità e opzioni di BlueStore, livello zstd 1 fisso, spazio al 50% comprimibile «identical to BlueStore». ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— default 4 GiB. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— default true. ↩︎ADR 0062, memory target and mClock — obiettivo letto una volta, nessuna regolazione automatica, RSS non imposto; le opzioni mClock «ACCEPTED and IGNORED». ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migrate from classic — «There is no in-place conversion of a BlueStore device»; le due sequenze; la riga della checklist sull’EC. ↩︎ ↩︎ ↩︎
ceph-rust docs, erasure-coded pools —
ec_enable_poolsdefaultall,ec_enable_optimizeddefaultall, e come appare un pool declinato. ↩︎ ↩︎ceph-rust, OSD config defaults —
("ec_enable_optimized", "all"). ↩︎