Questa volta l’host esiste. Solo che è sull’hypervisor sbagliato
L’ultima volta il problema era che la macchina nominata nell’inventario non esisteva ancora: niente IP, niente SSH, niente Python, niente a cui collegarsi. Ogni task andava delegato altrove.
Una migrazione da VMware rovescia la situazione e non cambia niente. La macchina esiste, è accesa, la gente la usa. Comunque non ti ci colleghi mai. È un nome e un sacco di variabili che descrivono qualcosa da ricostruire altrove. Ogni task gira ancora sul nodo di controllo, e ora dall’altra parte ci sono due API invece di una.
Una nota su cosa sia questo articolo. È il progetto e il playbook, non un racconto dal fronte. Non l’ho ancora eseguito da capo a fondo su un parco di produzione. Tutto ciò che dico sul comportamento dei moduli è stato letto dal codice distribuito e verificato, e ho detto chiaramente dove un’affermazione viene dal sorgente e non da un’esecuzione. Quando ci avrò fatto una migrazione vera, i numeri e le sorprese avranno il loro articolo.
Versioni su cui è stato verificato:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
I frammenti qui sotto vengono da un solo playbook, migrate.yml, un inventario dinamico vSphere in inventory/vmware.vms.yml e un group_vars/all.yml. Ho reso generici i nomi di datacenter, nodi e storage per leggibilità.
La forma del lavoro
Cinque passi, e solo l’ultimo costa qualcosa.
L’ordine è tutto il progetto. La scoperta non cambia niente. Costruire la rete cambia solo Proxmox. Costruire i gusci cambia solo Proxmox, e un guscio senza disco costa poco da eliminare. Spostare i dischi è lento ma a caldo. Solo l’ultimo play spegne qualcosa.
Molla a metà e ogni guest sta ancora girando su VMware, intatto.
Due collezioni, e una sta per andare in pensione
Ti servono entrambe, e non per il motivo che immagineresti.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware è la collezione vecchia e ampia, e la stanno smontando. Il suo MANIFEST.json dichiara {"vmware.vmware": ">=2.5.0"} come dipendenza obbligatoria, quindi installare la prima tira dentro la seconda che tu l’abbia chiesto o no. I moduli traslocano uno alla volta, e quelli che usi in una migrazione sono a punti diversi del trasloco:
vmware_dvs_portgroup_info: ancora solo incommunity.vmware, ed è quello che legge le tue VLAN.vmware_vmotion: ancora solo incommunity.vmware.vmware_guest_powerstate: deprecato, rimosso incommunity.vmware7.0.0. Usavmware.vmware.vm_powerstate.vmware_vm_inventory: deprecato, rimosso nella 7.0.0. Usavmware.vmware.vms.
Ansible ti avvisa delle deprecazioni dei moduli alla prima esecuzione, il che è decente da parte sua:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Non ti avvisa del plugin di inventario, perché i plugin di inventario vengono letti prima che quel meccanismo sia attivo. Devi andare a leggerti il plugin.
C’è una terza trappola nella divisione. vmware.vmware.vm_portgroup_info sembra esattamente ciò che vuole una migrazione di rete: per VM, per NIC, ti dà il portgroup e la VLAN. Ma è costruito su ModuleRestBase e importa com.vmware.vapi, il che significa che sul nodo di controllo gli serve il vSphere Automation SDK, non solo pyVmomi. Anche il suo ritorno documentato è vecchio: il blocco RETURN promette name e vlan_id, mentre il codice costruisce in realtà portgroup_name e un dict vlan_info per il caso distribuito. Io ho preso un’altra strada, qui sotto, e non mi è servito nessuno dei due.
L’inventario è la scoperta
In questo playbook non c’è un play «vai a cercare le VM», perché quando gira il primo task l’inventario l’ha già fatto, con una sola query al property collector invece di un ciclo per VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
Il nome del file conta. Il verify_file del plugin rivendica solo i file che finiscono in vms.yml, vms.yaml, vmware_vms.yml o vmware_vms.yaml. Chiamalo vcenter.yml e in silenzio non è il tuo inventario.
search_paths filtra prima della query, non dopo. Su un parco grande è la differenza tra secondi e minuti, a differenza di filter_expressions, su cui la documentazione è esplicita: gira dopo la raccolta e «does not affect the speed of the inventory plugin».
filter_expressions scarta un host quando l’espressione è vera. config.template quindi rimuove i template, il che la prima volta si legge al contrario.
E la riga importante è config.hardware.device, che non compare in nessuna lista di proprietà predefinita. È l’intero inventario hardware della VM, e porta tre cose senza cui questa migrazione non può procedere: il MAC di ogni NIC, la chiave del dvportgroup a cui è collegata ogni NIC e il percorso nel datastore di ogni disco. Senza, torni a un ciclo di vmware_guest_info, un viaggio di andata e ritorno per VM.
I dispositivi tornano come JSON con il loro tipo vSphere conservato in _vimtype. Conviene saperlo perché è così che distingui una NIC da un disco. Ho controllato l’encoder invece di tirare a indovinare:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Quindi un blocco compose può portare i percorsi scomodi in hostvars piatte:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Quell’asimmetria è reale e frega la gente. Non c’è un tipo VirtualEthernetCard da cercare. Quella è la classe base astratta, e quello che vCenter ti consegna davvero è VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 o VirtualSriovEthernetCard. Non c’è una sottostringa comune a tutti. Avere un MAC, invece, è una cosa che fa solo una NIC.
Ogni modulo info nasconde il campo che ti serve
Questo è il filo conduttore di tutto il lavoro, e quando l’hai visto tre volte cominci a controllare ogni default prima di scrivere il task.
vmware_dvs_portgroup_info ha sei opzioni show_*. Cinque valgono true per default. La sesta è show_vlan_info, e vale false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Lasciala stare e ottieni la politica di MAC learning, la politica di teaming, l’ordine degli uplink e la politica delle porte per ogni portgroup del parco. Tutto tranne il tag VLAN, che è l’unico campo di cui una migrazione di rete chiede davvero. Quindi il task è rovesciato rispetto a come lo scriveresti d’istinto: accendi l’unica cosa, spegni le altre cinque.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Non è un caso isolato. vmware.vmware.vms ha gather_compute_objects, che popola cluster ed esxi_host: default false. community.vmware.vmware_vm_info ha show_allocated, il blocco che contiene CPU e memoria: default false. In tutti e tre i casi il campo costoso da raccogliere è quello di cui la migrazione ha bisogno, e il default protegge un uso di sola lettura per i report che non è quello in cui ti trovi.
vlan_id ha tre tipi diversi
Poi ottieni i tag VLAN e scopri che non hanno una forma sola. Direttamente da get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Un portgroup di accesso ti dà la stringa "100". Una PVLAN ti dà una stringa. Un trunk ti dà una lista di stringhe, ognuna "20" oppure "20-30". E ogni switch distribuito ha almeno un trunk, che tu ne abbia creato uno o no, perché il portgroup di uplink è un trunk che porta "0-4094".
Quindi | int non è a tua disposizione finché non hai buttato via le altre due forme:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Tre scarti, in quest’ordine. Via i trunk, via le PVLAN, e poi via i portgroup senza tag, il che si sbarazza anche dei gruppi di uplink e di tutto ciò che sta sulla VLAN 0.
Non traduco trunk e PVLAN in automatico e contesterei chiunque lo facesse. Un trunk VMware che atterra su Proxmox ha bisogno di una zona Q-in-Q oppure di una VNet VLAN-aware, e quale sia giusta dipende da cosa il guest si aspetta di vedere. È una decisione, non una corrispondenza. Il playbook li stampa e va avanti:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Replicare le VLAN in SDN
Una zona VLAN legata a un bridge, poi una VNet per VLAN con il suo tag.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
I nomi delle VNet sono corti e vincolati, quelli dei portgroup VMware no. Production-Web-Tier-VLAN100 è un nome di portgroup normalissimo e un nome di VNet impossibile. Quindi il nome viene generato (v100, dal tag) e l’originale leggibile va in alias, dove resta visibile nell’interfaccia e nell’output di pvesh. Ricavare il nome dalla VLAN invece che dal portgroup significa anche che la corrispondenza si può ricostruire a occhio sei mesi dopo.
Due portgroup sulla stessa VLAN collassano in una sola VNet. È corretto (erano lo stesso dominio di broadcast anche in VMware), ma devi vederlo succedere, ed è quello che fa unique(attribute='vlan_info.vlan_id'). Due portgroup chiamati prod-web e prod-web-b, entrambi sulla VLAN 100, producono un solo v100.
throttle: 1 non è prudenza, è il modulo. Ogni scrittura SDN in community.proxmox prende un lock globale del cluster, applica la configurazione in sospeso e lo rilascia: get_global_sdn_lock(), poi apply_sdn_changes_and_release_lock(). Lanciale in parallelo e si mettono in coda sul lock comunque; il throttle ti evita solo di fingere il contrario. Vale anche la pena sapere che il rollback in caso di errore dipende dalla versione: il modulo controlla is_lock_and_rollback_supported e, su PVE più vecchi, ti dice che non è riuscito a fare il rollback invece di farlo.
Una cosa estetica che ti farà dubitare di te stesso. Nella 1.6.0 proxmox_vnet emette l’intero dict dei parametri come warning di Ansible a ogni singola creazione:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
È una riga di debug che qualcuno ha dimenticato. È rumore, non un difetto.
Costruisci i gusci, senza dischi
Ora le VM, ed è qui che il progetto si guadagna lo stipendio. Ogni VM viene costruita in Proxmox con il numero giusto di CPU, la memoria giusta, il firmware giusto e le NIC giuste sulle VLAN giuste. Nessun disco.
Un guscio senza dischi si crea in fretta, si elimina gratis e, se qualcuno lo avvia per sbaglio, arriva a un prompt PXE. Puoi costruirne quattrocento in un pomeriggio, guardare il risultato, decidere che è sbagliato, eliminare tutto e rifarlo. Niente è stato copiato, niente è stato spento, e nessuno se n’è accorto.
I valori derivati sono dichiarazioni, non task. Ansible li valuta in modo pigro sull’host di turno, quindi ogni VM ottiene i suoi senza un solo set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
Il VMID viene dal MoID di vCenter. vm-42 diventa 20042. Conta più di quanto sembri: il play di cutover deve trovare la VM creata dal play di build, e una riesecuzione deve atterrare sulla stessa invece di costruirne in silenzio una seconda. Lasciare che l’API assegni il prossimo ID libero (che è ciò che succede se ometti vmid, e di cui ho scritto l’ultima volta) lo rende impossibile.
La memoria non ha bisogno di conversione. VMware riporta config.hardware.memoryMB e Proxmox vuole MB. I socket sì: VMware ti dà le vCPU totali e i core per socket, Proxmox vuole socket e core.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false apposta. Niente dovrebbe avviarsi da solo nel mezzo di una migrazione, men che meno una macchina i cui dischi vengono ancora scritti da un altro hypervisor.
Il firmware non è un dettaglio facoltativo. Un guest UEFI importato su una VM SeaBIOS si importa alla perfezione e poi si rifiuta di avviarsi, e ci perderai un’ora. config.firmware è efi o bios e corrisponde direttamente a ovmf e seabios. Un guest UEFI ha anche bisogno di un disco per le variabili EFI, che va creato insieme alla VM; più sotto il perché.
proxmox_kvm non corregge una NIC, e non te lo dice
L’ultima volta ho scritto che proxmox_kvm rinuncia a convergere invece di aggiornare. Ecco la versione più affilata, che mi ha morso mentre scrivevo questo articolo e su cui vale la pena essere precisi.
update vale false per default, quindi rieseguire su una VM che esiste già non fa niente. Va bene, ed è documentato. Ma imposta update: true e il modulo si rifiuta ancora di toccare alcuni parametri:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Li cancella dalla richiesta e va avanti. Quindi correggi una NIC nella mappatura dell’inventario, riesegui con update: true, guardi Ansible riportare changed, e la NIC è sbagliata esattamente come prima. Il changed è vero (qualcos’altro nel payload è stato aggiornato), ma non la cosa che stavi correggendo.
update_unsafe: true toglie la restrizione, e il nome è onesto. La stessa protezione copre i dischi, quindi su una VM con dei dischi un aggiornamento non sicuro è un buon modo per ritrovarsene una seconda copia. Non è un interruttore da toccare durante una migrazione.
La via d’uscita è non usare net per niente. Le NIC si montano con proxmox_nic, un modulo il cui unico compito è una singola interfaccia e che converge come si deve:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
È la stessa divisione a cui ero arrivato l’ultima volta: proxmox_kvm per definire la macchina, proxmox_disk e proxmox_nic per le cose che cambiano dopo. Il parametro è mac, non mac_addr.
efidisk0 non si può spostare fuori allo stesso modo (proxmox_disk non ha efitype né pre_enrolled_keys), quindi va messo alla creazione e deve essere giusto al primo colpo.
Porta con te il MAC. VMware distribuisce MAC da 00:50:56:... e Proxmox li accetta senza lamentarsi. Tenerli significa che le prenotazioni DHCP corrispondono ancora, le licenze legate al MAC si validano ancora e ogni regola firewall scritta su un MAC scatta ancora. Cambiarli significa una giornata di piccoli misteri. proxmox_nic accetta anche model: vmxnet3 se ti serve che il guest veda la stessa NIC di prima, ma su KVM virtio è la scheda migliore, e un guest Windows vorrà comunque driver nuovi.
Rifiutare invece di indovinare
Una NIC su un portgroup standard non ha affatto backing.port. Il suo backing è un NetworkBackingInfo con un deviceName. Non sarà nella mappa, e la cosa giusta da fare è fermarsi:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Due condizioni invece di una, perché la prima deve girare prima della seconda: map(attribute=...) su una NIC senza port esploderebbe sulla ricerca indefinita. Scarta prima quelle senza forma, poi controlla le altre contro la mappa.
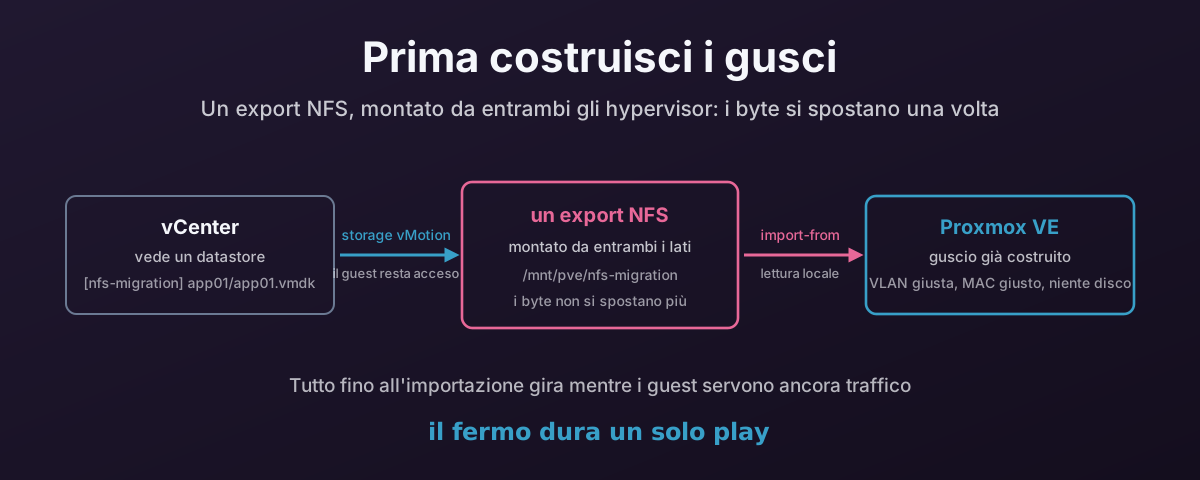
Un export, montato due volte
Ecco la parte che rende tutto economico.
Metti un export NFS dove entrambi gli hypervisor possano montarlo. vCenter vede un datastore chiamato nfs-migration; i nodi Proxmox montano lo stesso export e vedono /mnt/pve/nfs-migration. Ora sposta i VMDK lì con storage vMotion.
Lo storage vMotion è a caldo. Il guest continua a servire traffico per tutto il tempo. Niente passa dall’altra parte, non serve una finestra, e lo si può abbandonare a metà senza conseguenze oltre all’I/O sprecato. È di gran lunga la fase più lenta e non costa niente.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout vale 3600 per default: un’ora. Un VMDK da 2 TB non ce la fa, e il modo di fallire è subdolo: il task Ansible fallisce mentre il vMotion continua a girare in vCenter. Ora hai un playbook che dice di aver fallito e un parco che è ancora occupato. Impostalo su qualcosa che rispecchi il tuo storage reale.
throttle: 2, perché il collo di bottiglia non è il nodo di controllo. Lo storage vMotion è limitato dall’array e dalla rete. Sei alla volta non ti danno sei volte il throughput; ti danno sei migrazioni lente e un team storage arrabbiato.
Il modulo è idempotente nel modo che vuoi (imposta storage_vmotion_needed = False se la VM è già sul datastore di destinazione), quindi rieseguire per raccogliere i ritardatari è sicuro.
Quando questo finisce, i byte stanno su uno storage che Proxmox monta già. Per questo nient’altro deve copiarli. Mai.
Il cutover
Questo è l’unico play che costa un fermo, e l’ordine al suo interno non è negoziabile.
Prima, un problema facile da non vedere: l’inventario ora è vecchio. È stato raccolto prima del vMotion, quindi vm_disks contiene ancora i vecchi percorsi dei datastore. Importa da quelli e stai puntando Proxmox a un percorso che non vede.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Che è anche il motivo per cui la cache è disattivata nella configurazione dell’inventario. Una cache calda restituirebbe a refresh_inventory esattamente i dati vecchi che doveva sostituire. È un compromesso vero (vCenter non è veloce), ma un percorso sbagliato qui è un cutover fallito dentro una finestra, e il viaggio di andata e ritorno costa poco al confronto.
Poi spegni. Importare un VMDK che un host ESXi tiene ancora aperto ti dà nel migliore dei casi una copia coerente come dopo un crash:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest è uno spegnimento ordinato tramite VMware Tools; force: true ferma di forza tutto ciò che non si spegne entro il timeout. Sul modulo nuovo il parametro è timeout, non state_change_timeout come su quello deprecato.
Poi l’importazione, che è il perno:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
Il regex_replace fa la traduzione tra i due mondi. vCenter chiama un disco [nfs-migration] app01/app01.vmdk; Proxmox raggiunge lo stesso file in /mnt/pve/nfs-migration/app01/app01.vmdk. Stesso export, stessi byte, nessuna seconda copia. Tieni il descrittore .vmdk e ignori il -flat.vmdk accanto: qemu-img legge il descrittore e lo segue fino all’extent.
Tre cose su import_from che stanno tutte nel modulo e che vale tutte la pena sapere prima che si apra la finestra.
Scatta solo alla creazione. Nel ramo di aggiornamento:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Se scsi0 esiste già su quella VM, il parametro viene scartato e ottieni un normale aggiornamento. Quindi rieseguire dopo un’importazione andata male non reimporta. Non fa assolutamente niente, in silenzio, e riporta successo. Se un’importazione va storta, elimina il disco prima di riprovare.
timeout vale 600 secondi per default. Dieci minuti, per importare e convertire il disco di una macchina virtuale. La documentazione stessa del modulo dice di alzarlo; segui il consiglio.
E un percorso assoluto richiede root. La documentazione è brutale:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Il che si scontra in modo scomodo con il consiglio che ho dato l’ultima volta, e che confermo: usa un token API con ambito limitato, non root. Quel consiglio vale per ogni altra fase qui: scoperta, SDN, costruzione dei gusci, impostazione dell’ordine di avvio funzionano tutte con un token. Questo task no, e nessuna quantità di privilegi sul ruolo lo cambierà, perché la restrizione riguarda l’essere root dell’utente e non un permesso.
Ci sono tre uscite oneste, e nessuna quarta furba:
- PVE 9.x: usa
<storage>:import/<file>e resta sul token. - PVE 8.x: fai questo solo task come
root@pam, e solo questo. - PVE 8.x, niente root via API: lancia invece
qm importdiskvia SSH.
Il playbook prende le prime due tramite un flag, perché fingere il contrario sposterebbe solo il problema su chi lo lancia.
Infine l’ordine di avvio, che è un aggiornamento ordinario e quindi non toccato dalla restrizione di update_unsafe:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Niente avvia il guest. È voluto. Avvialo a mano, guardalo salire, e solo allora pensa a eliminare qualcosa in VMware.
Eseguirlo
Il tutto è un solo playbook, con tag per fase, perché questi non sono passi da eseguire insieme:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit ti è amico dall’inizio alla fine. Fai prima una VM. Fai un cluster. Il playbook non ha opinioni su quanto ne addenti, e l’inventario ti dà i gruppi gratis: power_poweredOn, cluster_<name>, più vmware_windows e vmware_linux dal blocco groups.
Controlla a cosa stai puntando prima di puntarci:
ansible-inventory --graph
ansible-inventory --host some-vm
A cosa starei ancora attento
Cose che mi aspetto di trovare quando questo incontrerà un parco vero, scritte adesso così non potrò dire dopo che le avevo viste arrivare:
- I guest Windows non si avviano puliti da un controller VirtIO SCSI se prima non c’è il driver.
virtio-scsi-singleè il controller giusto e quello sbagliato da dare a una VM Windows che non l’ha mai visto. È un problema a sé e niente di quanto sopra lo risolve. - VMware Tools va tolto prima del trasloco, non dopo.
- Snapshot. Una VM con una catena di snapshot ha più di un
.vmdkper disco, e importare la base ti dà lo stato precedente allo snapshot. Consolida prima. - L’ordine di
config.hardware.deviceè ciò che decide quale disco diventascsi0. Ovunque abbia guardato corrispondeva all’ordine del guest, ma lo verificherei su un server di database con più dischi prima di fidarmene in una finestra. - I dischi indipendenti e RDM non si spostano con storage vMotion come quelli normali.
Niente di tutto ciò cambia la forma. Costruisci prima i gusci, sposta i dischi mentre tutto è ancora acceso, e limita il fermo all’unico play che ne ha bisogno.