Il presupposto che Ansible di solito può fare
Quasi ogni modulo Ansible che hai usato funziona così: Ansible si collega all’host indicato nell’inventario, ci copia un piccolo programma Python, lo esegue e legge il risultato. L’host è la cosa che viene modificata e anche quella che fa il lavoro.
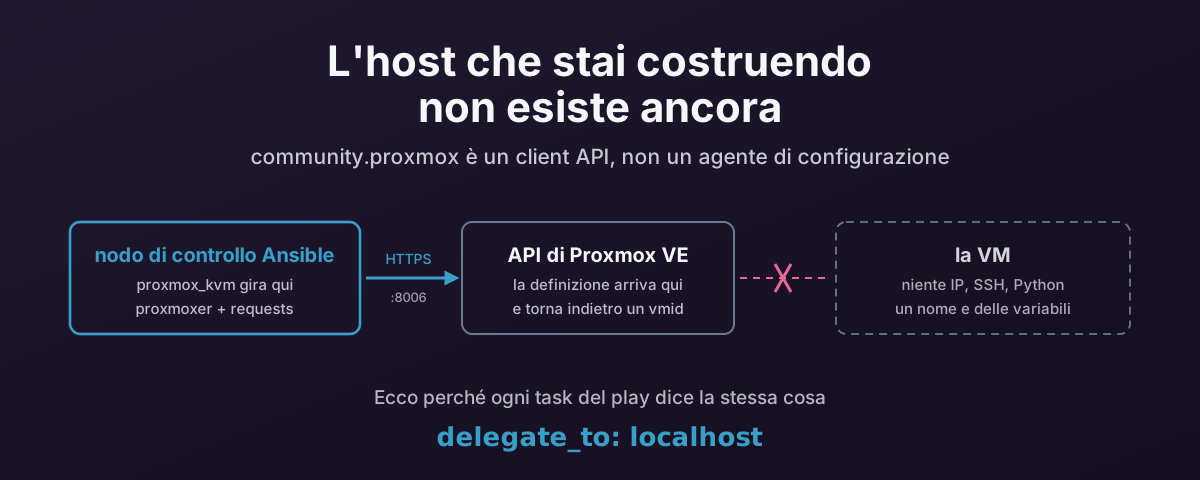
Creare una macchina virtuale rompe questo schema nel modo più elementare possibile. L’host che stai costruendo non esiste. Non ha un IP, né un demone SSH, né Python, né un sistema operativo. Non c’è niente a cui collegarsi.
Quindi community.proxmox non è un agente di configurazione. È un client API che si dà il caso venga distribuito come collezione Ansible. Per questo tutto ciò che c’è in questo articolo discende da quel solo fatto: dove girano i task, come fai entrare le credenziali, perché rieseguire non fa quello che ti aspetti e perché --check non ti dice la verità.
Gli esempi qui sono ridotti da un playbook che costruisce VM Windows e Linux a partire dai record di NetBox: proxmox-create-vms.yml. Ho reso generici i nomi di nodo, storage e bridge per leggibilità; la versione vera è in quel repository.
Tutto ciò che affermo sul comportamento dei moduli qui sotto è stato verificato su community.proxmox 1.6.0, la versione che ho installato:
$ ansible-galaxy collection list community.proxmox
# /home/damien/.ansible/collections/ansible_collections
Collection        Version
----------------- -------
community.proxmox 1.6.0
Prima cosa: la collezione si è spostata
Se stai leggendo un playbook vecchio o una risposta vecchia, i moduli si chiamavano community.general.proxmox_kvm. Ora vivono in una collezione dedicata, ed è lì che avviene lo sviluppo. La versione 1.6.0 include 47 moduli, che coprono Ceph, SDN, firewall, regole HA e l’ingresso nel cluster, niente dei quali esisteva ai tempi di community.general.
ansible-galaxy collection install community.proxmox
pip install 'proxmoxer>=2.0' requests
La dipendenza Python non è facoltativa e non è inclusa: la collezione dichiara requirements: ["proxmoxer >= 2.0", "requests"], e vanno installati ovunque il modulo venga davvero eseguito, che, come spiega la sezione successiva, non è il nodo Proxmox.
requirements.yml, se preferisci fissare la versione:
---
collections:
  - name: community.proxmox
    version: ">=1.6.0"
La collezione è testata con ansible-core dalla 2.17 alla 2.20. Rinominare i tuoi task community.general.proxmox_* in community.proxmox.proxmox_* è quasi tutta la migrazione.
Ogni task Proxmox gira su localhost
Due righe in cima al play fanno il grosso del lavoro, ed entrambe sembrano disattivare qualcosa di utile:
- name: Create Proxmox virtual machines
  hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
  gather_facts: false
  serial: 1
gather_facts: false non è un’ottimizzazione. La raccolta dei fact si collega all’host dell’inventario, e l’host dell’inventario è una VM che non è ancora stata costruita. Lasciala attiva e il play fallisce prima del primo task.
Poi ogni task Proxmox porta delegate_to: localhost:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    api_host: "{{ proxmox_api_ip }}"
    name: "{{ inventory_hostname }}"
    node: "{{ proxmox_api_host }}"
    ...
L’host dell’inventario ora è solo un nome e un sacco di variabili. inventory_hostname diventa il nome della VM; le sue variabili descrivono la macchina che vuoi. Niente si collega a lui. Il task gira sul nodo di controllo, che apre una sessione HTTPS verso api_host e invia la definizione di una VM.
Lo vedrai scritto anche come local_action:, che è la sintassi più vecchia per la stessa cosa. Il playbook di smantellamento in quel repository la usa ovunque. Sono equivalenti. delegate_to è la grafia attuale.
La via di fuga punta al nodo
Alcune cose devono davvero avvenire su un host Proxmox, e quei task delegano altrove:
- name: Fail if no ISO file exists for the OS
  delegate_to: "{{ proxmox_api_host }}"
  ansible.builtin.stat:
    path: "{{ iso | replace('isos:', '/mnt/pve/isos/template/') }}"
  register: iso_file
  failed_when: not iso_file.stat.exists
Quella è una vera connessione SSH verso un nodo vero, che controlla un percorso vero sullo storage condiviso, perché l’API accetta tranquillamente un riferimento a una ISO che non corrisponde a nessun file, e meglio scoprirlo adesso che all’avvio. Nota la chirurgia sulle stringhe che traduce un riferimento di storage PVE (isos:iso/debian.iso) in un percorso del filesystem. L’astrazione dello storage non è disponibile per stat.
Quindi un solo play ha task che girano in tre posti diversi, e confonderli è il modo più comune in cui questi playbook falliscono:
qm è l’unica parte che ha bisogno di SSH verso un hypervisor.Credenziali, e un valore predefinito che sta per cambiare
Le opzioni di autenticazione sono condivise da tutti i moduli della collezione tramite un frammento di documentazione, quindi sono le stesse ovunque: api_host, api_user, e poi api_password oppure la coppia api_token_id / api_token_secret. Tutte ricadono su variabili d’ambiente (PROXMOX_HOST, PROXMOX_USER, PROXMOX_PASSWORD, PROXMOX_TOKEN_ID, PROXMOX_TOKEN_SECRET, PROXMOX_VALIDATE_CERTS), che sono il modo più pulito per tenere i segreti del tutto fuori dal play.
Un token API è il default migliore. Ha un ambito limitato, si revoca senza cambiare la password di una persona e gli si possono dare esattamente i privilegi che servono al playbook invece di quelli che una persona si trova ad avere:
- name: Create Proxmox VM
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true
    ca_path: /etc/ssl/certs/pve-cluster-ca.pem
Imposta validate_certs esplicitamente, oggi. La documentazione della collezione lo dice chiaro:
Currently defaults to
falseand changes default totruewith community.proxmox 2.0.0.
Il che significa che un playbook che non lo nomina non sta validando il TLS in questo momento, e comincerà a validarlo (e quindi a fallire contro il certificato autofirmato con cui arriva ogni installazione nuova di Proxmox) nel momento in cui qualcuno lancia --upgrade. Meglio prendere quella decisione di proposito che vedersela piombare a metà di una build. Se tieni il certificato autofirmato, scrivi validate_certs: false e accetta il rilievo; se hai una catena come si deve, punta ca_path su di essa. In ogni caso resta scritto.
La creazione minima che funziona
Riduci il task di produzione a ciò che definisce davvero una macchina ed è leggibile:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true

    node: pve1
    name: "{{ inventory_hostname }}"
    cores: "{{ vcpus | int }}"
    memory: "{{ memory }}"
    machine: q35
    bios: ovmf
    ostype: l26
    scsihw: virtio-scsi-single
    scsi:
      scsi0: "vmdata:32,format=qcow2,discard=on,ssd=1"
    sata:
      sata0: "isos:iso/debian-13-netinst.iso,media=cdrom"
    net:
      net0: "virtio,bridge=vmbr0"
    efidisk0:
      storage: vmdata
      format: raw
      efitype: 4m
      pre_enrolled_keys: true
    boot: "order=scsi0;sata0"
    agent: "enabled=1,fstrim_cloned_disks=1"
    onboot: true
    tags:
      - production
Alcune cose di quella forma vale la pena saperle prima di scrivere la tua.
Le opzioni dei dispositivi sono sintassi PVE dentro lo YAML. scsi, sata, net, virtio, ide sono tutti di tipo dict, con chiavi scsi0, net0 e così via, e i valori sono le stringhe di opzioni separate da virgole prese pari pari da man qm: <storage>:<size>,option=value per un disco, [model=]<enum>,option=value per una NIC. Il modulo non li modella; li inoltra. Quando qualcosa viene rifiutato, la risposta è nel riferimento delle opzioni PVE, non nella documentazione di Ansible.
Li vedrai scritti anche come stringa JSON invece che come mappa YAML:
net: '{"net0":"virtio,bridge={{ vlan_bridge }}"}'
Funzionano entrambi. Ansible converte la stringa per un parametro di tipo dict. La forma JSON esiste perché è più facile generare un’intera struttura con una sola espressione Jinja. La forma a mappa è più facile da leggere sei mesi dopo.
boot ha due generazioni di sintassi. Il modulo accetta le vecchie lettere, dove boot: "cdn" significa «prova il disco, poi il CD-ROM, poi la rete». Il PVE attuale vuole una lista ordinata esplicita, boot: "order=scsi0;sata0;net0", che non lascia dubbi su quale disco. La forma vecchia funziona ancora. Quella esplicita è quella che vuoi nei lavori nuovi. Un vero tranello sepolto nella documentazione del modulo: l’avvio da rete richiede di impostare rng0 da PVE 8.3.5.
numa e numa_enabled sono parametri diversi. numa_enabled è il booleano che accende NUMA. numa è un dict che descrive una topologia (cpus, hostnodes, memory, policy). Scrivere numa: true è un errore di tipo, ed è un’ora persa con facilità. Se ti interessa perché tutto questo conta, l’allineamento NUMA su Proxmox tratta il problema di fondo.
machine: q35 e bios: ovmf sono i default giusti, non decorazione: l’argomento per intero.
Omettere vmid significa che il modulo chiede all’API il prossimo ID libero. Comodo, e la causa diretta della prossima cosa.
Perché serial: 1
«Prendi il prossimo ID disponibile, poi crea una VM con quello» sono due chiamate API con un buco in mezzo. Due worker che lo fanno contemporaneamente possono leggere lo stesso ID libero, e chi perde riceve un errore o, peggio, una sorpresa.
serial: 1 fa sì che la fase di creazione proceda un host alla volta. Non è veloce e non ha bisogno di esserlo. La parte costosa della costruzione di una VM avviene dopo che questo playbook ha passato la mano. Il play gemello che avvia le VM finite usa serial: 5, perché l’avvio non ha un contatore condiviso su cui fare a gara.
Se preferisci il parallelismo, assegna tu il VMID dalla tua fonte di verità e passalo esplicitamente. Allora non c’è nessuna lettura-modifica-scrittura e nessuna gara.
L’idempotenza non è quella che ti aspetti
Questa è la sezione da leggere due volte, perché proxmox_kvm non si comporta come ansible.builtin.package.
name non è un’identità. I nomi delle VM non sono unici in un cluster Proxmox, e il modulo lo dice. Con state: present e nessun vmid, se esiste già una VM con quel nome, il modulo esce con changed=false e msg: "VM with name <x> already exists" e non fa niente. Non confronta i tuoi parametri con la realtà. Non converge. Rinuncia.
update vale false per default. Quindi modificare memory: nel playbook e rieseguire non fa nulla. La VM tiene la memoria con cui è stata costruita, il task riporta successo e niente da nessuna parte ti dice che le due cose hanno preso strade diverse.
update: true rifiuta ancora i parametri interessanti. Dalla documentazione del modulo:
Because of the operations of the API and security reasons, I have disabled the update of the following parameters
net,virtio,ide,sata,scsi. Per example updatingnetupdate the MAC address andvirtiocreate always new disk…
update_unsafe: true toglie quella restrizione, e l’avvertimento non è di facciata:
Use this option with caution because an improper configuration might result in a permanent loss of data (for example disk recreated).
Quindi il disco che pensavi di ridimensionare può essere sostituito da uno nuovo e vuoto. Non ricorrere a questo: i parametri rifiutati hanno i loro moduli, ed è la prossima sezione.
E --check non copre niente di tutto questo. La collezione dichiara il supporto al check mode modulo per modulo, ed è incoerente esattamente nella direzione sbagliata:
| Modulo | check_mode | diff_mode |
|---|---|---|
proxmox_kvm | nessuno | nessuno |
proxmox_disk | nessuno | nessuno |
proxmox_template | nessuno | nessuno |
proxmox_snap | completo | nessuno |
proxmox_nic | completo | nessuno |
proxmox_pool | completo | nessuno |
La divisione non è «i moduli in sola lettura possono, quelli in scrittura no»: proxmox_nic crea ed elimina interfacce e rispetta il check mode benissimo. È che i tre moduli che trattano storage e ciclo di vita delle VM non lo fanno. Una corsa con --check di un playbook di build salta in silenzio la creazione della VM e poi riferisce su un mondo in cui la VM non è mai stata fatta, quindi ogni task successivo ragiona sullo stato sbagliato. Su un playbook di build, --check non è una rete di sicurezza, e trattarlo come tale è peggio che non lanciarlo.
Quindi fai dell’esistenza il cancello
Dato tutto questo, lo schema praticabile è smettere di chiedere al modulo di essere idempotente e decidere tu se costruire. Il playbook di produzione lo fa così:
- name: Check if VM is present or manually built
  delegate_to: localhost
  community.proxmox.proxmox_vm_info:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    config: current
  register: existing_vm
  ignore_errors: true
  failed_when: (existing_vm.proxmox_vms | length) == 0

- name: Configure Proxmox VM
  when: existing_vm is failed
  block:
    - name: Create Proxmox VM
      ...
proxmox_vm_info con config: current restituisce la VM e la sua configurazione attiva, oppure una lista vuota. failed_when trasforma «lista vuota» in un fallimento, ignore_errors: true impedisce a quel fallimento di chiudere il play, e when: existing_vm is failed diventa «la VM non c’è, costruiscila».
Usare un task fatto fallire apposta come booleano si legge male, e non fingerò il contrario. L’alternativa è when: (existing_vm.proxmox_vms | default([]) | length) == 0, che è onesta nell’essere un controllo di lunghezza e non ha bisogno di ignore_errors. Funzionano entrambe. La versione sopra è quella in produzione, e il suo unico vero vantaggio è che il risultato registrato porta con sé la configurazione esistente, che i task successivi possono leggere.
La parte importante è la forma, non la grafia: controlla, poi dirama, e tratta la creazione come un evento unico. La configurazione continuativa di una VM è un problema diverso dalla sua esistenza, e questo modulo è bravo solo nel secondo.
Dischi e NIC hanno i loro moduli
Ecco la cosa che ho glissato sopra, e cambia tutto il quadro: i parametri che proxmox_kvm si rifiuta di aggiornare non sono un buco nella collezione. Sono delegati. community.proxmox.proxmox_disk e community.proxmox.proxmox_nic aggiungono, modificano e rimuovono esattamente le cose che il modulo di creazione non tocca, usando come chiave gli stessi nomi scsi0 e net0 che hai usato quando hai costruito la VM.
Entrambi si comportano meglio di proxmox_kvm, e uno dei due è l’unico modulo di questo flusso di lavoro che si può provare a vuoto.
proxmox_nic: aggiungere, ritaggare o rimuovere un’interfaccia
- name: Move the VM's primary NIC to a new bridge and VLAN
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    interface: net0
    bridge: vmbr1
    tag: 120
    model: virtio
    mtu: 1
    queues: 4
    firewall: true
    state: present
interface è l’unica opzione obbligatoria oltre all’autenticazione (net[n] con n da 0 a 31), e state: present o absent ti danno aggiunta e rimozione. model vale virtio per default, che è la risposta giusta a meno che un guest non ce la faccia.
Il motivo per cui questo modulo esiste è l’indirizzo MAC. Ricorda perché proxmox_kvm si rifiuta di aggiornare net: «updating net update the MAC address». proxmox_nic lo risolve esplicitamente:
When not specified this module will keep the MAC address the same when changing an existing interface.
Quindi puoi ritaggare una VLAN, spostare un bridge, cambiare l’MTU o accendere il firewall senza che l’identità della NIC del guest cambi sotto i suoi piedi. Conta più di quanto sembri: un MAC nuovo invalida le prenotazioni DHCP, rompe tutto ciò che è licenziato su una NIC e disallinea il record dell’interfaccia in NetBox che il playbook di creazione ha scritto con tanta cura. Questo è il modulo che rende noiosa una modifica di rete del giorno 2.
Alcune opzioni da conoscere prima di averne bisogno:
rateè in MBps, MegaByte al secondo, non bit. La documentazione è esplicita e l’errore di un fattore otto è facilissimo da fare.link_down: truescollega l’interfaccia, descritto nella documentazione come «like pulling the plug». Un modo pulito per isolare una VM sospetta senza fermarla né toccare il guest.trunksprende una lista di ID VLAN da far passare, per un guest che fa il tagging da sé.mtu: 1non è un refuso e non è un MTU di 1 byte: significa «eredita l’MTU del bridge», e vale solo pervirtio.queuesimposta il multiqueue, da 0 a 16. Conviene farlo coincidere con il numero di vCPU su qualsiasi cosa muova traffico vero.
E supporta pienamente il check mode. --check su un task proxmox_nic ti dice la verità, il che ne fa l’unica parte di questo flusso che puoi provare in sicurezza. Anche i suoi messaggi sono propriamente idempotenti. Un’interfaccia invariata riporta Nic net0 unchanged on VM with vmid 103 invece di dichiarare una modifica.
proxmox_disk: l’intero ciclo di vita del disco
proxmox_disk è il modulo più grande dei tre, e il suo state fa cinque lavori diversi:
state | Cosa succede | Reversibile? |
|---|---|---|
present | crea il disco, o aggiorna le opzioni di uno esistente | non pertinente |
resized | lo ingrandisce: PVE non può ridurlo, e la documentazione dice di farlo a mano | no |
detached | diventa unused[n]; il volume e i suoi dati restano | sì |
moved | cambia lo storage sottostante, o passa il disco a un’altra VM | l’originale resta salvo delete_moved |
absent | rimosso dallo storage sottostante | no |
Lo scarto tra detached e absent è la rete di sicurezza che proxmox_kvm non ti dà mai. Scollegare è una modifica di configurazione; eliminare distrugge dati. Due parole diverse, due conseguenze diverse.
Aggiungere un secondo disco a una VM che esiste già:
- name: Add a data disk
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    storage: vmdata
    size: 200
    format: qcow2
    iothread: true
    aio: io_uring
    discard: "on"
    ssd: true
    backup: true
    state: present
create è la manopola che proxmox_kvm avrebbe dovuto avere. Controlla cosa può fare state: present:
regular(il default): crea il disco se manca, altrimenti ne aggiorna le opzioni.disabled: aggiorna solo le opzioni, e non crea mai. È quella da usare quando cambicacheoiothreadsu un disco che deve esistere già. Non può sorprenderti evocando un volume nuovo perché una chiave era scritta male.forced: crea sempre. Un disco esistente viene scollegato e lasciato inutilizzato, non eliminato.
Quest’ultimo comportamento è il dettaglio importante. create: forced è l’opzione dall’aria distruttiva, e comunque non distrugge niente: il vecchio volume sopravvive come unusedN e puoi ricollegarlo. Confrontalo con proxmox_kvm più update_unsafe, il cui modo di fallire documentato è un disco ricreato. Più o meno la stessa operazione, raggio dei danni molto migliore.
Ingrandire un disco:
- name: Grow the data disk by 100 GiB
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    size: "+100G"
    state: resized
Attento alle unità, perché size cambia significato con state. Con state: present sono GiB come numero nudo (size: 200). Con state: resized vuole un suffisso: +100G per aggiungere alla dimensione attuale, o 500G come obiettivo assoluto. Un solo parametro, due convenzioni, e se indovini male il fallimento è silenzioso.
Spostare un disco su un altro storage, cioè il caso della migrazione a caldo di un solo volume:
- name: Move the disk to NVMe storage
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    target_storage: nvme-pool
    bwlimit: 200000
    delete_moved: true
    timeout: 3600
    state: moved
target_storage sposta all’interno di una VM; target_vmid passa il disco a un’altra VM e richiede lo stesso storage su entrambe. Si escludono a vicenda. delete_moved vale false per default, quindi per default finisci con due copie e l’originale lasciato lì come inutilizzato: sicuro, e un buon modo per riempire un pool di storage se non ci torni mai.
timeout qui vale 600 per default, contro 30 in proxmox_kvm. Parametro dall’aspetto identico, differenza di venti volte, perché queste operazioni copiano dati. Alzalo per immagini grandi o storage lento: la documentazione lo dice sia per moved sia per import_from.
Il che porta all’opzione che fa di questo modulo la strada per V2V e immagini cloud:
import_from: "vmdata:9000/base-debian13.qcow2"
import_from costruisce il disco da un volume esistente invece di allocarne uno vuoto: <STORAGE>:<VMID>/<NAME>, oppure <STORAGE>:import/<NAME> usando la directory di importazione dello storage su PVE 9.x e successivi. Esclude size, e solo root può usare percorsi assoluti del filesystem.
Il resto della lista dei parametri è il motivo per collegare i dischi con questo modulo invece che in linea nella chiamata di creazione: cache, aio, iothread, discard, ssd, backup, detect_zeroes, e tutta la famiglia della limitazione di banda: iops, iops_rd, iops_wr, le loro varianti _max e _max_length, e i controlli di picco bps_*_max_length. Niente di tutto questo è raggiungibile tramite proxmox_kvm dopo la creazione.
Due avvertenze, entrambe dalla documentazione del modulo:
- Alcune modifiche alle opzioni richiedono un riavvio. «Some updates on options (like
cache) are not being applied instantly and require VM restart.» Un task verde significa che la configurazione è stata scritta, non che la VM in esecuzione si comporti diversamente. - Non supporta il check mode.
check_mode: none, comeproxmox_kvm. Quindi la collezione si spacca a metà: le modifiche alle NIC si possono provare con--check, quelle ai dischi no.
La divisione dei compiti
| Per fare questo | Usa |
|---|---|
| Creare la VM | proxmox_kvm, una volta, condizionato all’esistenza |
| Cambiare core, memoria, tag, agent, onboot | proxmox_kvm con update: true |
| Aggiungere, ritaggare, scollegare o rimuovere una NIC | proxmox_nic |
| Aggiungere, ingrandire, spostare, scollegare o rimuovere un disco | proxmox_disk |
| Snapshot | proxmox_snap (anche lui con check mode completo) |
| Qualsiasi cosa nessuno di loro esponga | qm set via SSH |
Cambiare un disco o una NIC tramite proxmox_kvm | niente: è a questo che serve update_unsafe, ed è il motivo per non usarlo |
Costruisci la VM con una chiamata proxmox_kvm minima, poi collega dischi e interfacce con i loro moduli. Sono più task, ed è la versione in cui le modifiche del giorno 2 hanno una strada che non passa da un’opzione il cui rischio documentato è perdere un disco.
Dove il modulo si ferma
proxmox_kvm ha una lista di parametri enorme e comunque non copre tutto ciò che qm sa fare. Invece di aspettare, il playbook di produzione scende alla CLI sul nodo:
- name: Set RNG source and better SPICE quality
  delegate_to: "{{ proxmox_api_host }}"
  become: true
  ansible.builtin.command:
    cmd: >-
      /usr/sbin/qm set {{ created_vm.vmid }}
      --rng0 source=/dev/urandom
      --spice_enhancements videostreaming=all
Non c’è niente di male. Non è idempotente in nessun senso utile (qm set è una scrittura, e riporterà changed a ogni esecuzione), ma è esplicito, è leggibile e non finge. Se un modulo acquisisce il parametro più avanti, cancelli il task.
Altre cose richiedono un secondo passaggio nel modulo con update: true, perché non si possono impostare nella stessa chiamata che crea la VM:
- name: Add SPICE-compatible USB device
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    node: "{{ proxmox_api_host }}"
    vmid: "{{ created_vm.vmid }}"
    usb:
      usb0: "spice,usb3=1"
    update: true
  when: spice_usb | default(false)
Nota che passa vmid, non name. Una volta che hai l’ID, usalo. È l’unico identificatore che l’API tratta come unico.
E per le cose che QEMU sa fare e per cui PVE non ha un’opzione, c’è args, che viene passato pari pari alla riga di comando di QEMU:
    args: >-
      -global scsi-hd.physical_block_size=4k
      -global scsi-hd.logical_block_size=4096
Quello presenta il disco virtuale come 4Kn invece che 512e, il che conta più di quanto sembri: dimensioni dei blocchi, 4Kn e 512e. Il modulo etichetta args come «for experts only», e il motivo è che PVE non lo valida e un flag sbagliato impedisce alla VM di avviarsi con un errore che arriva da QEMU invece che da Proxmox.
Il cluster non è coerente all’istante
- name: Let registration complete on cluster
  ansible.builtin.pause:
    seconds: 5
  when: created_vm.changed
Un pause in un playbook di solito puzza, e questo regge il peso. La chiamata di creazione ritorna quando l’API ha accettato la definizione, che non equivale a ogni nodo d’accordo sull’esistenza della VM, e il task immediatamente successivo vuole impostare un’ACL su /vms/<vmid>. Cinque secondi di pazienza costano meno di un ciclo di retry attorno a un errore che compare solo sotto carico.
Il playbook di smantellamento ha la stessa forma per lo stesso motivo: ferma, aspetta, poi elimina.
Rileggere ciò che hai costruito
proxmox_kvm documenta tre valori di ritorno: vmid, status e msg. In pratica ne vorrai un quarto, e non è nella documentazione.
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: "{{ created_vm.mac.net0 }}"
created_vm.mac esiste davvero (il modulo lo costruisce in get_vminfo() e lo riversa nel risultato), ma manca dal blocco RETURN documentato, il che significa che niente promette che continuerà a funzionare. Conviene sapere esattamente come si comporta, perché ci sono due trappole:
- Compare solo quando il modulo ha creato davvero la VM.
macviene assemblato solo nel percorso crea-e-distribuisci. Prendi il ramo «esiste già» e il risultato havmidemsge nient’altro. - Contiene solo le interfacce che hai passato. Il codice scorre i parametri che hai fornito e sceglie quelli che corrispondono a
net[0-9], poi rilegge dall’API la configurazione salvata di ciascuno. Nessun parametronet, nessuna chiavemac.
Ecco perché il playbook di produzione ha bisogno di entrambe le metà, e la seconda è brutta:
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: >-
      {{ created_vm.mac.net0 if created_vm is defined and created_vm.changed
         else ((existing_vm.proxmox_vms[0].config.net0 | split(','))[0] | split('='))[1] }}
Quando la VM esisteva già, non c’è mac, quindi il MAC va scavato fuori dalla stringa grezza della configurazione. net0 torna dall’API come virtio=AE:AE:5C:A8:89:85,bridge=vmbr0, quindi: dividi sulle virgole, prendi il primo campo, dividi su =, prendi la seconda metà. È chirurgia sulle stringhe di una risposta API, ed è il costo onesto di un modulo la cui forma di ritorno dipende dal ramo che ha preso.
Se ti serve il MAC in modo affidabile in entrambi i casi, prendilo sempre da proxmox_vm_info e analizza una forma sola invece di due.
Guidarlo da una fonte di verità
Guarda di nuovo la riga che apre il play:
hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
Quella è la vera architettura, e vale la pena dirla chiaramente: le VM da costruire non sono una lista in un file di variabili. Sono gli host del tuo inventario il cui stato registrato dice che dovrebbero esistere e ancora non esistono.
L’inventario qui è NetBox. Una VM si richiede creando un record NetBox con stato planned, con CPU, memoria, disco, VLAN, proprietario e piattaforma. Il playbook seleziona le macchine planned, le costruisce, assegna un IP, scrive il DNS e poi porta il record a staged, e a quel punto quell’host non corrisponde più allo schema di host del play, e un handler aggiorna l’inventario perché il play successivo veda il nuovo stato:
handlers:
  - name: Refresh inventory
    ansible.builtin.meta: refresh_inventory
Il campo di stato è una macchina a stati, il playbook è una transizione al suo interno, e tutto si può rieseguire perché un host che è già andato avanti non viene più selezionato. È una proprietà molto migliore di qualsiasi idempotenza a livello di modulo, ed è il motivo per cui il task di creazione può permettersi di essere un colpo solo.
community.proxmox include anche un suo plugin di inventario, che costruisce un inventario a partire dal cluster: la scelta giusta quando la fonte di verità è Proxmox. Qui è il contrario: NetBox fa testo e Proxmox è dove la sua intenzione si realizza. È un articolo intero a sé e lo scriverò separatamente.
Toglierla di nuovo
La creazione senza smantellamento è mezzo ciclo di vita, e il percorso di rimozione ha la sua trappola: non puoi eliminare una VM in esecuzione:
- name: Force stop the VM if it is running
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: stopped
    force: true
    timeout: 10

- name: Allow the cluster to stop the VM before removing it
  ansible.builtin.pause:
    seconds: 10

- name: Remove the VM from the cluster
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: absent
    force: true
    timeout: 10
state: stopped è uno spegnimento ordinato, e l’interazione con timeout è documentata e da imparare a memoria: se il timeout scade con force: true la VM viene spenta di colpo; con force: false invece il task fallisce. Una finestra ordinata di dieci secondi seguita da una staccata della spina è una politica ragionevole per una macchina che si sta smantellando, e una pessima per qualsiasi altra cosa.
Lo smantellamento completo (proxmox-remove-vms.yml) poi disfa il resto del record: DNS, l’IP assegnato, le interfacce NetBox, la VM NetBox e le voci obsolete in known_hosts. Avvolge il blocco in ignore_errors: true, il che è difendibile in uno smantellamento. Stai rimuovendo cose che potrebbero essere già sparite, e una macchina eliminata a metà è peggio di un log rumoroso.
Cosa cambierei in una build da zero
Avendo letto il sorgente del modulo e non solo la sua documentazione, cinque cose:
- Usa un token API, non
api_userpiùapi_password. Ambito limitato, revocabile, e non appartiene mai a una persona. - Imposta
validate_certsesplicitamente, prima che la 2.0.0 te lo cambi sotto il naso. - Assegna tu il VMID dalla fonte di verità. Elimina la gara lettura-modifica-scrittura, ti permette di togliere
serial: 1e dà a ogni task successivo un identificatore stabile invece di un nome che non è unico. - Crea la VM nuda, poi collega dischi e NIC con
proxmox_diskeproxmox_nic. Più task, ma ogni disco e ogni interfaccia hanno poi un modulo che li può cambiare in seguito (compresocreate: disabledper modifiche alle sole opzioni estate: detachedinvece dell’eliminazione) invece di una configurazione che si può cambiare solo tramiteupdate_unsafe. - Prendi il MAC da
proxmox_vm_infoin un solo posto, così c’è una forma sola da analizzare invece di una condizione tra un valore di ritorno documentato e uno no.
E non ricorrere a --check su un playbook di build. Il modulo che conta non lo può rispettare.
Una prova a vuoto che dice sempre sì è peggio di nessuna prova a vuoto, perché le crederai.
Riferimenti
- Documentazione della collezione community.proxmox — tutti i 47 moduli
- community.proxmox su GitHub — dove vive il sorgente citato sopra;
plugins/modules/proxmox_kvm.pyè il file da leggere quando la documentazione è ambigua - Documentazione del modulo
proxmox_kvm— la lista dei parametri, e gli avvertimenti suupdate/update_unsafecitati sopra - Documentazione del modulo
proxmox_vm_info—config: currenteconfig: pending - Riferimento delle opzioni
qmdi PVE — la vera specifica di ogni stringascsi[n],net[n]ebootche fai passare - proxmoxer — il client Python su cui è costruita la collezione
- damo2929/ansible-example — i playbook da cui vengono questi estratti, compresi l’inventario guidato da NetBox, la generazione DHCP e la build degli hypervisor