वह स्विच जो आप नहीं ख़रीदते
Ceph वाले तीन-नोड Proxmox क्लस्टर को नोड्स के बीच तेज़ नेटवर्क चाहिए। आम जवाब है 100 Gbit का स्विच, और आम आपत्ति है उसकी क़ीमत।
तीन नोड के लिए एक और जवाब है: उन्हें त्रिकोण में सीधे एक-दूसरे से केबल करें और उसके पार रूट करें। स्टोरेज पाथ में कोई स्विच ही नहीं।
किसी भी डिज़ाइन का सबसे सस्ता हिस्सा वह है जो आप ख़रीदते ही नहीं, और वही अकेला हिस्सा है जो कभी ख़राब नहीं होता।
इससे चार चीज़ें मिलती हैं।
स्विच का ख़र्च ख़त्म हो जाता है। आपको नेटवर्क कार्ड और तीन केबल चाहिए, न कि उतने ही पोर्ट वाला 100 या 200 Gbit स्विच।
डेटा पाथ में कोई single point of failure नहीं। जो स्विच ख़राब हो जाए या रीबूट हो, वह पूरे क्लस्टर का east-west ट्रैफ़िक साथ ले जाता है। सीधे एक-दूसरे से जुड़े नोड्स को इमारत में कहीं और किसी स्विच के साथ क्या होता है, इससे कोई फ़र्क़ नहीं पड़ता।
भारी ट्रैफ़िक अपने ही तारों पर रहता है। Live migration और Ceph replication मेश पर रहते हैं, दफ़्तर और मैनेजमेंट ट्रैफ़िक से होड़ नहीं करते।
इसे बढ़ाना वायरिंग का काम है, पोर्ट-बजट का नहीं। बीच में कोई ऐसा बॉक्स नहीं जो bandwidth या पोर्ट की गिनती की छत बने, इसलिए जब तक हर सर्वर में एक ख़ाली PCIe स्लॉट है, फ़ैब्रिक बढ़ता रहता है। OpenFabric नए लिंक पर ख़ुद ही रूट करने लगता है।
और एक ईमानदार सीमा, क्योंकि वह इन चार फ़ायदों से ज़्यादा मायने रखती है। Full mesh में हर नोड-जोड़ी के बीच एक केबल चाहिए। तीन नोड यानी तीन केबल। चार यानी छह। पाँच यानी दस। वायरिंग नोड्स की गिनती से तेज़ बढ़ती है, और यह डिज़ाइन किसी छोटे क्लस्टर से आगे switched तरीक़े, जैसे leaf-spine, पर गए बिना नहीं टिकता।
तीन नोड ठीक वही जगह है जहाँ full mesh समझ में आता है। उससे आगे, हर नोड पर दो मेश पोर्ट के साथ, जो आप अब भी बना सकते हैं वह एक ring है, और उसे एक ऐसी चीज़ चाहिए जिससे यह बिल्ड वैसे बचता है। वह नीचे बताया गया है।
क्या बनता है
तीन Proxmox VE होस्ट, हर एक में दो समर्पित 100 Gbit इंटरफ़ेस, त्रिकोण में केबल किए गए ताकि हर नोड के दो सीधे पड़ोसी हों।
रूटिंग Proxmox SDN चलाता है। प्रोटोकॉल OpenFabric है: वह मेश के पार सबसे अच्छा पाथ निकालता है, और जब कोई केबल निकाली जाए या लिंक गिर जाए तो बचे हुए पाथ से रीरूट कर देता है। किसी को लॉग इन नहीं करना पड़ता।
फ़ैब्रिक 10.10.10.0/24 में रहता है, जो सिर्फ़ मेश के लिए आरक्षित है: मैनेजमेंट, गेस्ट, स्टोरेज एड्रेसिंग या किसी बाहरी चीज़ के लिए नहीं।
| नोड | मेश एड्रेस | मेश इंटरफ़ेस |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
हर नोड को एक /32 मिलता है, subnet का कोई टुकड़ा नहीं।
Bridged मेश के बजाय routed मेश का यही मतलब है। एड्रेस नोड की पहचान है, OpenFabric उसे advertise करता है, और दोनों फ़िज़िकल लिंक उस तक पहुँचने के बस रास्ते हैं।
उसे रखने के लिए Proxmox एक dummy loopback इंटरफ़ेस बनाता है।
वायरिंग
Active fibre DAC केबल, त्रिकोण में, और हर नोड पर दोनों मेश इंटरफ़ेस पर jumbo frames चालू।
| केबल | कहाँ से | कहाँ तक |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
Copper DAC के बजाय active fibre, दो वजहों से जो नेटवर्क के बारे में नहीं, रैक के बारे में हैं:
- केबल मैनेजमेंट। Active fibre DAC copper से पतले और कहीं ज़्यादा लचीले होते हैं, इसलिए साफ़ रूट होते हैं और सर्वरों के पीछे ढेर नहीं बनते।
- एयरफ़्लो। चेसिस के पीछे कम केबल का मतलब है front-to-back एयरफ़्लो में कम रुकावट, जो तब मायने रखता है जब कई high-speed लिंक उन्हीं कुछ रैक यूनिट में आते हैं।
दो नेटवर्क, एक नहीं
मेश अकेला नेटवर्क नहीं है, और उसे अकेला बनना भी नहीं चाहिए।
हर नोड का nic0 एक 2.5 Gbit स्विच पर है, जो Proxmox को vmbr0 ब्रिज के रूप में दिखता है।
उस पर वेब इंटरफ़ेस, एडमिन एक्सेस और क्लाइंट ट्रैफ़िक चलता है। फ़ैब्रिक बनाते समय भी आप इसी रास्ते का इस्तेमाल करते हैं, इसीलिए इसे फ़ैब्रिक से स्वतंत्र होना ज़रूरी है।
nic0 को जानबूझकर फ़ैब्रिक से बाहर रखा गया है। फ़ैब्रिक नोड बनाते समय सिर्फ़ nic1 और nic2 चुने जाते हैं।
मेश तीन चीज़ें ले जाता है:
- Ceph। Hyper-converged स्टोरेज के लिए नोड-से-नोड replication, recovery और backfill।
- क्लाइंट वर्चुअल नेटवर्किंग। VXLAN पर आधारित VNet गेस्ट नेटवर्क को तीनों नोड्स पर फैलाते हैं, routed मेश को underlay की तरह इस्तेमाल करते हुए।
- Corosync, दूसरे रास्ते के रूप में। क्लस्टर membership ट्रैफ़िक मैनेजमेंट नेटवर्क और मेश दोनों पर चलता है, ताकि quorum किसी एक के अकेले बचे रहने पर निर्भर न हो।
चेंज टिकट पर लिखने लायक़ नियम: मैनेजमेंट और क्लाइंट एक्सेस हर समय 2.5 Gbit स्विच के ज़रिए उपलब्ध रहते हैं, 100 Gbit इंटरफ़ेस किसी भी हालत में हों।
सब कुछ वेब इंटरफ़ेस से
यह बिल्ड पूरी तरह Proxmox वेब इंटरफ़ेस में किया गया है। यह सोचा-समझा फ़ैसला है, टूलिंग की सीमा नहीं।
जानबूझकर इस्तेमाल नहीं किया गया:
/etc/network/interfacesको हाथ से एडिट करना।- FRR कॉन्फ़िगरेशन फ़ाइलों को हाथ से एडिट करना।
- बिल्ड के तरीक़े के रूप में
vtysh।
आप जो SDN ऑब्जेक्ट परिभाषित करते हैं, उनसे Proxmox नीचे का नेटवर्क और रूटिंग कॉन्फ़िगरेशन ख़ुद बनाता है। अगर कोई चीज़ सच में इंटरफ़ेस में सेट नहीं हो सकती, तो उसे कमांड लाइन पर चुपचाप ठीक करने के बजाय prerequisite के रूप में बताना चाहिए। वेब इंटरफ़ेस खोलने वाले अगले व्यक्ति को पता नहीं चलेगा कि आपने क्या किया।
कमांड-लाइन आउटपुट नीचे सिर्फ़ सबूत के रूप में आता है, बिल्ड के कदम के रूप में कभी नहीं।
बिल्ड
1. Proxmox वेब इंटरफ़ेस खोलें और Datacentre → SDN → Fabrics पर जाएँ।
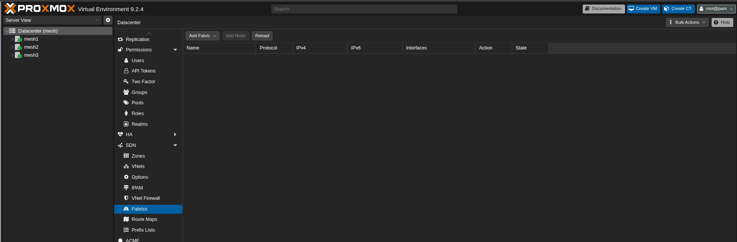
2. फ़ैब्रिक जोड़ें। उसे नाम दें, मेश prefix दें, और timers सेट करें।
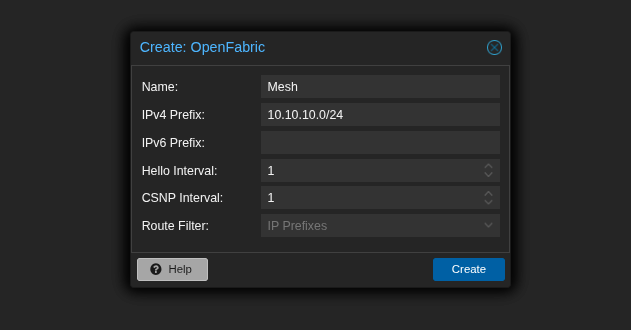
Hello और CSNP interval 1 होने पर कुछ बदलते ही state जितनी जल्दी हो सके अपडेट होती है, और इतने छोटे फ़ैब्रिक पर यही चाहिए।
क़ीमत है control-plane पर ज़्यादा बातचीत। दो-दो लिंक वाले तीन नोड पर इसका कोई मतलब नहीं, पर फ़ैब्रिक कभी बढ़े तो इस पर दोबारा सोचना चाहिए।
3. हर नोड को Add node से जोड़ें। उसे मेश रेंज से एक एड्रेस दें और जो इंटरफ़ेस हिस्सा लेते हैं उन पर टिक करें।
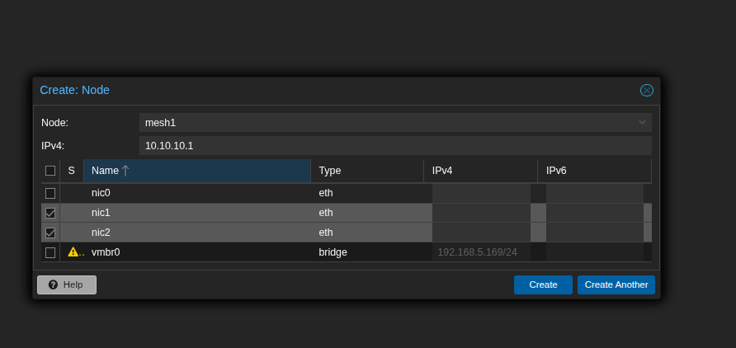
ध्यान दें किस पर टिक नहीं है: nic0 बाहर रहता है, और vmbr0 मैनेजमेंट एड्रेस रखता है।
पहले दो नोड के लिए Create another और आख़िरी पर Create इस्तेमाल करें।
4. लागू करने से पहले नतीजा जाँचें।
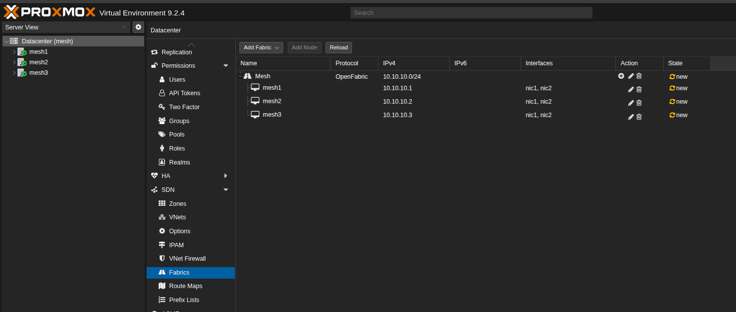
तीन नोड, तीन एड्रेस, हर एक पर nic1, nic2, और सब new के रूप में चिह्नित: अभी तक कुछ भी लिखा नहीं गया है।
5. SDN कॉन्फ़िगरेशन लागू करें।
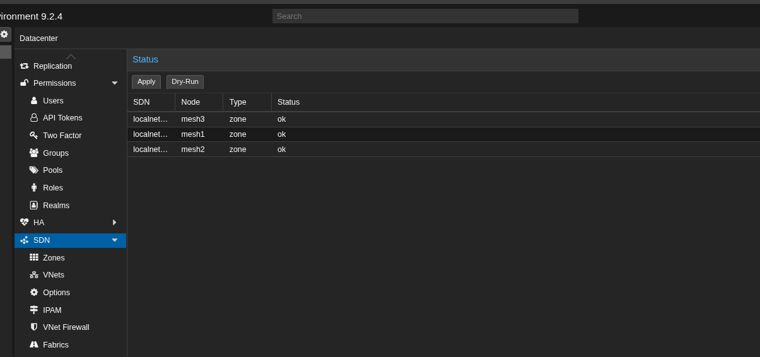
अगर आप पहले देखना चाहें कि यह क्या करने वाला है, तो Apply के बगल में Dry-Run है।
कैसे पता चले कि यह चल गया
Status व्यू में तीनों नोड पर zone और fabric दोनों एंट्री ok दिखनी चाहिए, और लागू करने के लिए कोई बदलाव बाक़ी नहीं होना चाहिए।
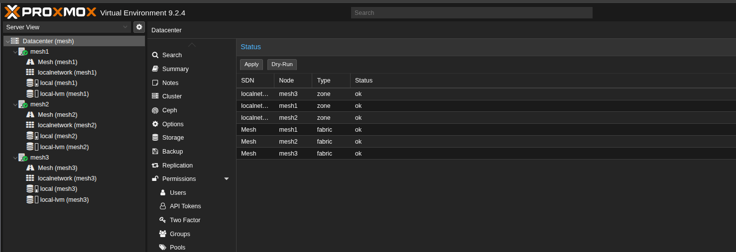
फिर किसी नोड के अपने नज़रिए से फ़ैब्रिक जाँचें।
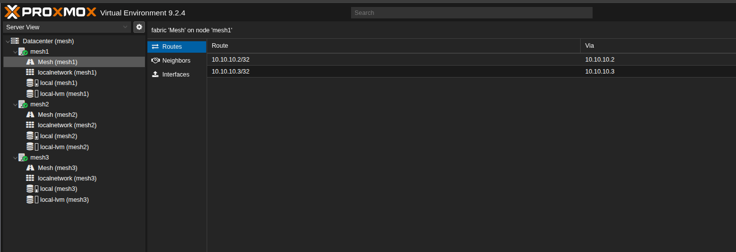
पहले routes: हर नोड के पास बाक़ी हर नोड के लिए एक /32 होना चाहिए, और Via कॉलम बताता है कि वह किस पड़ोसी का इस्तेमाल कर रहा है।
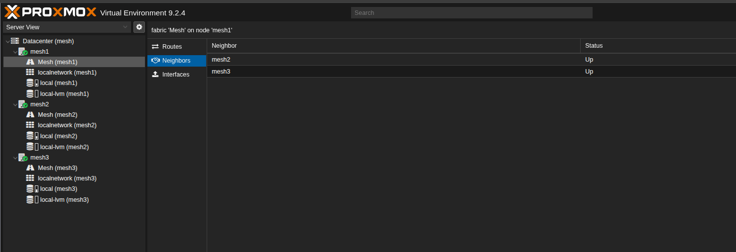
फिर पड़ोसी। तीन-नोड त्रिकोण पर दो, दोनों Up।
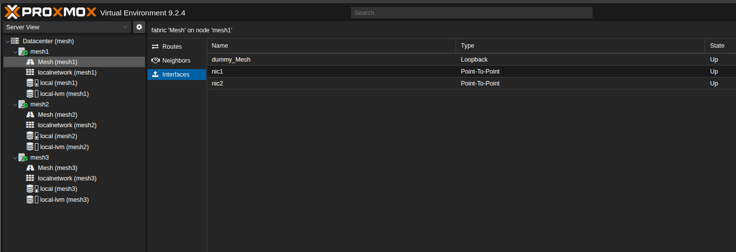
फिर इंटरफ़ेस, जहाँ इस चीज़ की बनावट दिखती है: dummy_Mesh router एड्रेस रखने वाला loopback है, और nic1 और nic2 broadcast segment के बजाय Point-To-Point हैं।
आख़िर में, शुरू से अंत तक साबित करें।
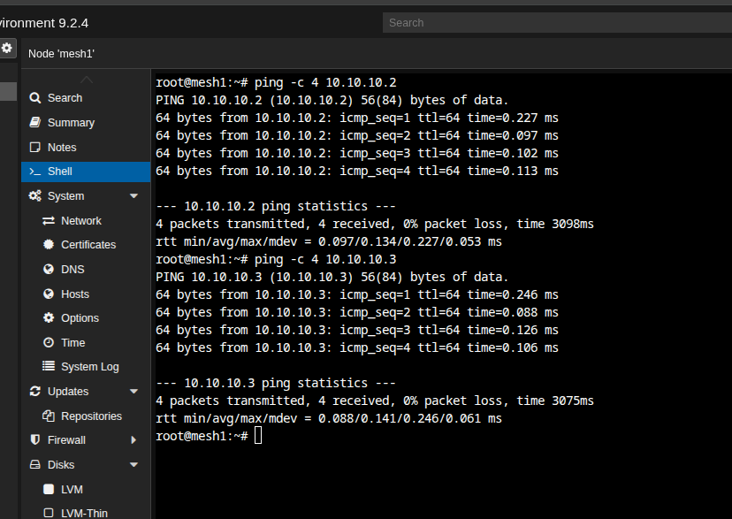
कोई loss नहीं, और औसत 0.134 ms और 0.141 ms। दोनों पड़ोसी एक सीधे hop की दूरी पर हैं, त्रिकोण यही देता है।
वह जाँच जो कोई स्क्रीनशॉट नहीं दिखा सकता: एक केबल निकालें और पक्का करें कि सब कुछ फिर भी पहुँच में है। Point-to-point लिंक की एक जोड़ी के बजाय routed मेश चुनने की पूरी वजह यही है। इसलिए, यही अकेली जाँच है जो मायने रखती है।
तीन नोड से आगे: Ring
त्रिकोण एक full mesh है। हर नोड का बाक़ी हर नोड से सीधा केबल है, हर hop एक hop है, और कोई नोड कभी ऐसा ट्रैफ़िक नहीं ढोता जो उसका अपना न हो।
तीन नोड पर हर नोड के दो मेश पोर्ट आपको यही गुण देते हैं, और चार पर ठीक यही आप खो देते हैं। थोड़ा नहीं। पूरा। चार नोड के full mesh को हर नोड पर तीन पोर्ट चाहिए। दो के साथ, ज़्यादा से ज़्यादा आप एक ring वायर कर सकते हैं।
Ring ट्रैफ़िक का मॉडल बदल देता है। आस-पास के नोड्स के बीच अब भी सीधा केबल है, पर ring के आमने-सामने वाले नोड्स के बीच नहीं: उनका ट्रैफ़िक किसी बीच वाले नोड से होकर जाना पड़ता है। और उस नोड को अपने दोनों मेश इंटरफ़ेस के बीच पैकेट forward करने को तैयार होना चाहिए, जो Linux डिफ़ॉल्ट रूप से नहीं करता। Kernel ip_forward को “Forward Packets between interfaces” के रूप में दर्ज करता है, “Default: 0 (disabled)” के साथ।
इसे मेश इंटरफ़ेस के लिए चालू करें, और सिर्फ़ उन्हीं के लिए:
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
मान लेने के बजाय उन्हें पढ़कर देखें:
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
यहाँ हर इंटरफ़ेस वाली सेटिंग ही सही दायरा है, और वह अपने आप काम करती है। Global net.ipv4.ip_forward कोई prerequisite नहीं है। Kernel का forwarding वाला फ़ैसला पैकेट पाने वाले इंटरफ़ेस की अपनी वैल्यू पढ़ता है:
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET उस डिवाइस की सेटिंग लौटाता है, global वाली के साथ उसका AND नहीं। इसलिए nic1 और nic2 फ़ैब्रिक का transit ट्रैफ़िक forward करते हैं, जबकि nic0 और vmbr0 ठीक वही रहते हैं जो उन्हें होना चाहिए: होस्ट इंटरफ़ेस जो रूट नहीं करते। Global स्विच चालू करने से बॉक्स का हर इंटरफ़ेस router बन जाएगा, दफ़्तर के नेटवर्क की ओर वाला भी। इस डिज़ाइन को इसकी कोई ज़रूरत नहीं।
Global IPv4 स्विच के बारे में एक बात जानने लायक़ है, भले ही आप उसे सेट नहीं कर रहे: net.ipv4.ip_forward एक bulk setter है, इसीलिए kernel डॉक्यूमेंटेशन चेतावनी देता है कि इसे बदलना “resets all configuration parameters to their default state”। अगर होस्ट पर कोई और चीज़ कभी इसे लिखे, तो वह इन हर-इंटरफ़ेस वैल्यू को ओवरराइट कर देती है। यह जानना अच्छा है, इससे पहले कि आप पूरी दोपहर यह सोचने में लगा दें कि transit क्यों बंद हो गया।
IPv6 अपवाद है, और वही अकेली जगह है जहाँ global स्विच की जगह है। Kernel डॉक्यूमेंटेशन conf/all/forwarding के नीचे यह सीधे कहता है:
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
इसलिए ऊपर वाले साफ़-सुथरे हर-इंटरफ़ेस तरीक़े का कोई IPv6 बराबर नहीं है। अगर फ़ैब्रिक IPv6 ले जाता है, तो आप forwarding को globally चालू करते हैं और फिर उसे force_forwarding से सीमित करते हैं, जिसका दस्तावेज़ कहता है “Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding”। ध्यान दें कि वही ओवरराइट वाला व्यवहार उलटी दिशा में भी लागू होता है: conf.all.forwarding को 0 करने से हर इंटरफ़ेस पर force_forwarding रीसेट हो जाता है।
ऊपर का बिल्ड फ़ैब्रिक का IPv6 prefix ख़ाली छोड़ता है, इसलिए इनमें से कुछ भी यहाँ लागू नहीं होता। यह तभी मायने रखता है जब आप एक जोड़ें।
ध्यान दें कि forwarding क्या नहीं बदलता: OpenFabric पहले से हर नोड का /32 advertise कर रहा था और पहले से ring के पार का पाथ निकाल रहा था। Forwarding छूटी हुई अनुमति है, छूटी हुई अक़्ल नहीं। Routing table शुरू से सही थी। Kernel बस router की तरह काम करने से मना कर रहा था।
त्रिकोण की तुलना में ring की क़ीमत:
- Transit ट्रैफ़िक। चार-नोड ring पर दो तिरछी जोड़ियाँ किसी बीच वाले नोड से होकर जाती हैं, इसलिए उनका ट्रैफ़िक उस नोड के अपने ट्रैफ़िक के साथ उसकी लिंक bandwidth भी खाता है। Ceph इसे सबसे पहले महसूस करता है, क्योंकि replication पड़ोसी-से-पड़ोसी नहीं, सब-से-सब होता है।
- एक अतिरिक्त hop की latency उन रास्तों पर, बिना स्विच वाले डिज़ाइन के आम sub-millisecond आँकड़ों के ऊपर।
- ख़राबी के लिए कम गुंजाइश। एक टूटा लिंक ring को chain बना देता है: अब भी पूरी तरह जुड़ा हुआ, पर लंबे रास्तों और ज़्यादा transit के साथ। दूसरा टूटना क्लस्टर को दो हिस्सों में बाँट देता है। त्रिकोण एक टूटने को बिना किसी transit के झेल लेता है।
और यह इस तरह बिगड़ता है जिसे बताने से आसान चित्र में दिखाना है। पाँचवाँ नोड जोड़ें और क्लस्टर की हर नोड-जोड़ी में से आधी किसी और के forward करने पर निर्भर हो जाती है:
इस डिज़ाइन की असली छत यही है, और वह routing प्रोटोकॉल नहीं है। OpenFabric ठीक संभाल लेता है। बात यह है कि हर नोड पर पोर्ट की गिनती तय है, इसलिए तीन नोड के बाद हर नया बॉक्स आपके ट्रैफ़िक का और हिस्सा किसी और के transit में बदल देता है।
और ईमानदार बात, क्योंकि यह उस बिल्ड के लिए मायने रखती है जो अब तक सिर्फ़ वेब इंटरफ़ेस से हुआ है: sysctl वेब इंटरफ़ेस का काम नहीं है। पहले तय किए गए नियम के हिसाब से, यह एक prerequisite है जिसे बताना चाहिए, कमांड लाइन पर चुपचाप ठीक करने वाली चीज़ नहीं। इसे runbook में लिखें, क्योंकि SDN पैनल खोलने वाले अगले व्यक्ति को एक स्वस्थ फ़ैब्रिक दिखेगा और ज़रा भी इशारा नहीं मिलेगा कि ring /etc/sysctl.d की एक फ़ाइल पर टिका है।
इसे वापस हटाना
हटाना उसी इंटरफ़ेस में बिल्ड का उलटा है: मेश के लिए बनाए गए SDN ऑब्जेक्ट हटाएँ, कॉन्फ़िगरेशन लागू करें, और पक्का करें कि मैनेजमेंट एक्सेस पर कोई असर नहीं पड़ा।
nic0 और 2.5 Gbit स्विच उसी आख़िरी कदम के लिए हैं। अगर मेश को रोलबैक करने में आपका वेब इंटरफ़ेस जा सकता है, तो डिज़ाइन शुरू करने से पहले ही ग़लत था।
शुरू करने से पहले
- मैनेजमेंट एक्सेस सच में मेश से स्वतंत्र है। इसे जाँचें, मान न लें।
- किसी भी SDN बदलाव से पहले तीनों नोड स्वस्थ हैं।
- नोड के नाम, इंटरफ़ेस के नाम और केबलिंग लिखी हुई है, क्योंकि एक होस्ट का
nic1दूसरे परnic2होना पूरी दोपहर बर्बाद करता है। - दोनों मेश इंटरफ़ेस पर jumbo frames सेट हैं, और MTU underlay पर VXLAN के overhead का हिसाब रखता है।
- मेश रेंज आरक्षित है और कहीं और इस्तेमाल में नहीं है।
संदर्भ
- Proxmox VE — Software-Defined Network — SDN Fabrics का डॉक्यूमेंटेशन। Fabrics “provide automated routing between nodes in a cluster”, OpenFabric “based on IS-IS and optimized for the spine-leaf topology common in data centers” है, हर नोड को एक अनोखा Router-ID चाहिए, और “a dummy ’loopback’ interface with the router-id is automatically created”
- Proxmox VE — Cluster Manager — Corosync नेटवर्किंग और redundant लिंक, जिन पर दो-रास्ते वाला membership डिज़ाइन टिका है
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — hyper-converged क्लस्टर के लिए नेटवर्क की अपेक्षाएँ
- Linux kernel — IP sysctl documentation —
ip_forwardऔर उसका डिफ़ॉल्ट 0, हर इंटरफ़ेस वालाforwardingनियंत्रण, और यह चेतावनी कि global स्विच बदलने से हर इंटरफ़ेस का कॉन्फ़िगरेशन रीसेट हो जाता है