एक Rust OSD, उसी दिन जिस दिन वह आया
croit ने 9 नवंबर 2026 को FlashStore OSD को public preview में डाला1।
यह Rust में शुरू से लिखा गया एक Ceph OSD है, जिसमें BlueStore की जगह इसका अपना object store है, और यह Ceph का wire protocol बोलता है।
दावा यह है कि यह उस cluster में सीधे बैठ जाता है जो आप पहले से चला रहे हैं: आपके monitors, आपके managers, आपका ceph CLI और आपके clients जैसे हैं वैसे ही रहते हैं, और आप एक बार में एक drive बदलते हैं1।
यह दावा ज़्यादातर लोगों से ज़्यादा एक Proxmox shop के लिए मायने रखता है।
एक hyperconverged Proxmox VE नोड पर Ceph कोई अलग से install करने वाली चीज़ नहीं है।
वह Proxmox GUI से आता है, Proxmox की अपनी repositories से, Proxmox का build और patch किया हुआ, और पूरा काम pveceph चलाता है।
अगर किसी और का OSD उसके अंदर बिना कुछ तोड़े बैठ सकता है, तो आपको tooling छोड़े बिना एक नया storage engine मिल जाता है।
अगर नहीं बैठ सकता, तो आपको यह कड़वे तरीके से पता चलता है, उस नोड पर जो आपकी VMs भी चला रहा है।
तो मैंने आज़माया।
मैं croit के लिए काम करता हूँ, जो FlashStore बनाते हैं। इसीलिए मैंने इसे आने के दो दिन के अंदर आज़माया, और इसीलिए नीचे कुछ भी नरम नहीं किया गया है। यह एक preview है, README कहती है कि यह “not yet recommended for production data”1, और यह असली hardware पर इसमें क्या लगा उसका ब्योरा है, कोई brochure नहीं।
छोटा जवाब: यह चलता है। इसे लिखते समय एक stock Proxmox VE 9.2 नोड पर आठ FlashStore OSDs एक VM को RBD pool दे रहे हैं, HEALTH_OK के साथ। लंबा जवाब यह है कि इसके लिए दो ऐसे fixes लगे जिनका documentation में ज़िक्र नहीं है, एक Proxmox के Ceph config रखने के तरीके की वजह से और एक Proxmox के kernel की वजह से, और बाकी post वही fixes हैं और वे कैसे मिले। अगर आपको बस इसे चालू करना है, तो अंत के पास एक script है जो यह सब करती है, और वह इसी नोड पर चलाई गई है।
मशीन
Lab एक अकेला नोड है, pve2, मेरे घर के LAN पर, और यह 2021 का एक घटिया Minisforum B550 mini PC है।
Single-node Ceph वैसे नहीं है जैसे आप production चलाएँगे, और आगे वाला CRUSH rule उसी की कीमत है, लेकिन यहाँ का हर कदम उस नोड पर भी वैसा ही है जिसके पड़ोसी हों।
| Proxmox VE | pve-manager 9.2.26, kernel 7.0.14-28-pve, Debian 13.7 |
| मशीन | Minisforum B550 mini PC, 2021; board खुद को BESSTAR TECH B550, BIOS 5.17 बताता है |
| CPU | AMD Ryzen 7 5700G, 8 cores, 16 threads, 1 NUMA node |
| Memory | 58 GiB |
| OSD drives | 8 × Intel Optane P4800X 375 GB (6 Dell-branded, 2 Intel retail) |
| Optanes तक PCIe | आठों एक Broadcom PEX880xx switch के पीछे, APU से एक अकेले PCIe 3.0 x16 link पर |
| Boot drive | WD SN750 512 GB, VG pve, इस सब से बाहर रखा गया |
| Network | एक 2.5 GbE port, vmbr0 |
| FlashStore | snapshot-2026-11-10, upstream commit c5792750020e2 |
Optanes इसलिए हैं क्योंकि FlashStore की दो पक्की शर्तें हैं जिन पर बहुत सी drives fail होती हैं।
Drive में power-loss protection होना चाहिए, और namespace 4096-byte blocks इस्तेमाल करे, पूरे namespace के रूप में, उस पर कोई partition या filesystem न हो1।
FlashStore किसी write को तभी acknowledge करता है जब वह drive पर durable हो, इसलिए जो drive volatile cache के साथ durability के बारे में झूठ बोलती है उसे mkfs पर मना कर दिया जाता है3।
हर P4800X अपने Identify data में कोई volatile write cache नहीं बताती (vwc 0), यानी drive खुद कह रही है कि cache किसी acknowledged write को खो नहीं सकता।
इसलिए इस गहरी पड़ताल में सीमा mini PC की है, FlashStore की नहीं और drives की नहीं। आठ cores का मतलब हर OSD के लिए एक और कुछ भी फ़ालतू नहीं, 58 GiB को Ceph और VMs दोनों को खिलाना है, और आठ Optanes एक PCIe 3.0 link बाँटती हैं क्योंकि APU के पास देने को बस इतना ही है। नीचे के हर आँकड़े को इस मशीन की इजाज़त के रूप में पढ़ें।
Umbrella, वरना कुछ नहीं
FlashStore एक समय में एक Ceph release के लिए बनता है।
Branch यह तय करती है: main Ceph 21.2.0 Umbrella बोलती है, और एक v20.2.4 branch 20.2.4 Tentacle बोलती है4।
Daemon शुरू होते समय cluster की release जाँचता है और अपनी window से बाहर वाली release को मना कर देता है4।
Release page के packages main से बने हैं, और binary खुद यही कहती है: croit-flashstore-osd 21.2.0 umbrella।
Proxmox VE 9 तीन Ceph repositories देता है, और उनमें से सिर्फ़ एक मेल खाती है।
Tentacle Proxmox का default है, तो क्या वही सुरक्षित चुनाव है?
वही है जो नहीं चलेगा।
Proxmox repository में Tentacle 20.2.5-pve1 तक है, और FlashStore की Tentacle branch ठीक 20.2.4 को निशाना बनाती है।
Proxmox की repository में Umbrella 21.2.0-pve1 है, वही release जिसे main निशाना बनाती है।
Proxmox यह नहीं छिपाता कि Umbrella क्या है।
PVE/Ceph/Releases.pm उसे unsupported => 1 के साथ सूचीबद्ध करती है5, और GUI wizard उसे चुनते ही साफ़ शब्दों में यही कहता है।
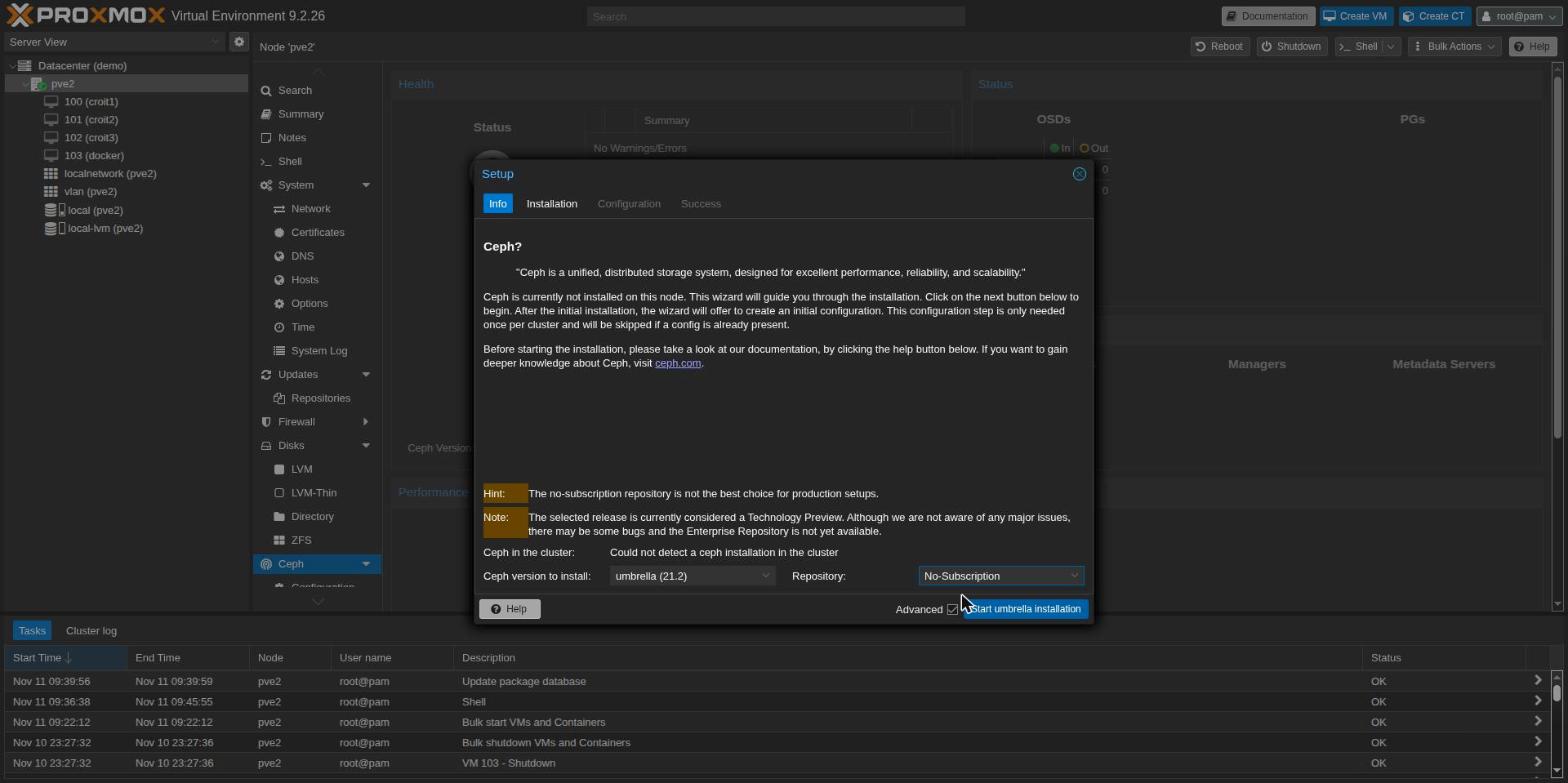
“Technology Preview”, कोई enterprise repository नहीं, और installer apt को छूने से पहले terminal में दूसरी बार पूछता है, continue (y/N)?।
यह सही मात्रा में चेतावनी है, और इसे पूरे stack के बारे में एक बयान की तरह पढ़ना चाहिए: एक preview Ceph release पर एक preview OSD।
Install stock Proxmox है। Datacenter → Ceph → Install, version Umbrella, repository No-Subscription, फिर public network और पहला monitor।
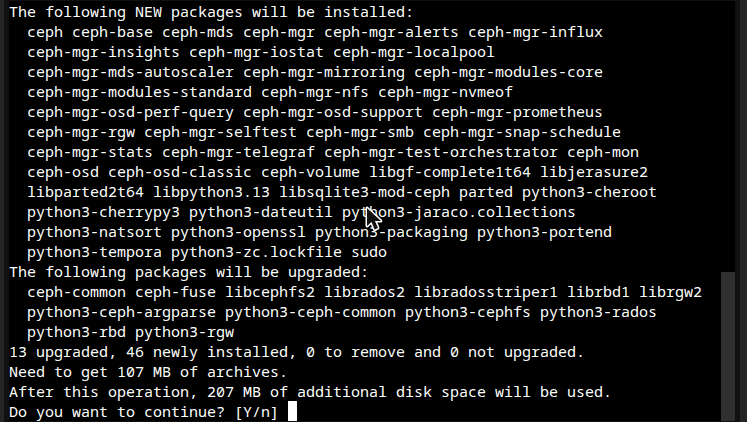
तेरह packages upgrade हुए, 46 नए, 107 MB download हुआ।
उस सूची में एक चीज़ Umbrella में नई है: ceph-osd के बगल में ceph-osd-classic।
यहाँ दोनों में से कोई इस्तेमाल नहीं होता, क्योंकि कोई classic OSD कभी बनाया ही नहीं जाता।
लगभग एक मिनट बाद mon.pve2 और mgr.pve2 चल रहे थे, ceph versions ने 21.2.0 … umbrella बताया, और health OK थी, अभी store करने को कुछ नहीं था।
512 Bytes पर चार Drives
आठ में से चार Optanes एक lab VM को pass through की गई थीं और अभी भी 512-byte format में थीं, उन पर पुराने ZFS labels थे। दो और का format सही था पर labels वही थे। दोनों का इलाज सीधा है: उन्हें VM से हटाओ, 4 KiB पर format करो, labels मिटाओ।
P4800X 4096 bytes बिना metadata के LBA format 3 के रूप में देती है, जिसे nvme id-ns lbaf 3 : ms:0 lbads:12 बताता है।
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
पहली कोशिश fail हुई, और बाद की एक और भी।
दोनों बार nvme format Interrupted system call के साथ लौटा और drive अभी भी 512 bytes पर थी।
Kernel log में कारण है:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
Opcode 0x2 Get Log Page है और 0x6 Identify।
दोनों में से कोई format नहीं है।
P4800X पूरे medium को format करती है, और यहाँ इसमें प्रति drive 345 से 351 seconds लगे।
जब तक यह चलता है, controller दूसरे admin commands का जवाब नहीं देता, तो जो भी drive से सवाल पूछता है वह इंतज़ार करता है।
Kernel के 60-second admin timeout के बाद वह हार मान लेता है और controller को reset करता है, और reset format को मार देता है।
| कोशिश | Drive तक क्या पहुँचा | नतीजा |
|---|---|---|
| nvme0, पहली | 09:53:04 पर एक Get Log Page, Ceph install के बीच | रुका, अभी भी 512 B |
| nvme0, एक unit में | कुछ नहीं | 345 s में 4 KiB |
| nvme1 | मेरा अपना nvme list, progress देखते हुए | रुका, अभी भी 512 B |
| nvme2, nvme3 | कुछ नहीं | 351 s और 350 s में 4 KiB |
| nvme1, अकेले | कुछ नहीं | 346 s में 4 KiB |
इलाज यह है कि हर format को एक transient unit में लंबे timeout के साथ चलाएँ, एक बार में एक drive, और ख़त्म होने तक drives को छुएँ नहीं:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
इस तरह progress की अकेली जाँच journal है, और controller तक कुछ नहीं पहुँचता।
फिर आठों nvme list में 4 KiB दिखाने लगीं।
Package
Release page पर .deb और .rpm packages हैं, उनमें Debian 13 trixie भी, जिस पर Proxmox VE 9 बना है2।
एक ही build हर distribution के लिए है, जिसे glibc 2.34 या नया चाहिए6।
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
इसे हाथ से जाँचें।
sha256sum -c इस download को नहीं जाँच सकता, क्योंकि checksum file इसे debian-trixie/flashstore_…_amd64.deb कहती है जबकि asset का नाम flashstore_…_debian-trixie_amd64.deb है।
Hashes मेल खाते हैं, दोनों तरफ़ ce1fb352…26c8, तो file ठीक है और सिर्फ़ सूची assets से मेल नहीं खाती।
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
यह Proxmox के अपने ceph-osd और ceph-osd-classic के बगल में साफ़ install हुआ।
Package एक छोटा ceph-osd.target सिर्फ़ उन hosts पर install करता है जिनमें यह नहीं है6, और Proxmox में पहले से है, तो FlashStore units उसी target से जुड़ती हैं जिससे classic units जुड़तीं।
इसके ख़िलाफ़ script लिखने से पहले package के बारे में तीन बातें जानने लायक हैं:
| Docs क्या कहते हैं | Package असल में क्या है | |
|---|---|---|
| Package का नाम | apt remove flashstore …6 | croit-flashstore-osd, asset file flashstore_… है |
| Store backends | main का production feature set knet,spdk,rdma,mimalloc है1 | SPDK नहीं: --check बताता है “SPDK NVMe driver: compiled out” |
flashstore_dev के मान | spdk:<pci>, या development builds में file:7 | kernel tier, kernel:/dev/…, इस build में अकेला असली store path है |
बीच वाली पंक्ति मायने रखती है।
SPDK tier, यानी user-space NVMe driver जिसे drive का vfio-pci से bind होना चाहिए, प्रकाशित Debian package में नहीं है।
उसमें kernel tier है: drive kernel के अपने nvme driver पर रहती है और FlashStore io_uring के ज़रिए उससे बात करता है।
Source दिखाता है कि यह compile होकर अंदर है, क्योंकि knet feature kernel-nvme को खींच लाता है8, जबकि host check की summary line इसे “compiled out of this build” कहती है।
वह line ग़लत है।
जो पाठक उस पर भरोसा करेगा वह वहीं रुक जाएगा।
Host Check क्या कहता है
croit-flashstore-osd --check सिर्फ़ पढ़ता है और कुछ भी लिखने से पहले चलता है।
यह build, CPU, memory, IOMMU, हर NVMe controller, NIC, kernel और config जाँचता है, और हर finding के लिए सटीक fix छापता है9।
इस नोड पर इसने 115 checks चलाए, और यह अच्छा है: हर finding के साथ उसे ठीक करने वाला command आता है, जिसने बहुत सारी खुदाई बचा दी।
| Finding | नतीजा | मैंने क्या किया |
|---|---|---|
| Hugepages: कोई reserved नहीं | FAIL | जो 16 GiB माँगा वह reserve किया, /etc/sysctl.d में स्थायी |
| SN750 boot drive: volatile write cache | FAIL | कुछ नहीं, यह OSD का उम्मीदवार नहीं है |
vfio-pci loaded नहीं | WARN | कुछ नहीं, इस build में इस्तेमाल करने को SPDK नहीं है |
| memlock limit 8 MiB | WARN | कुछ नहीं, यह shell को मापता है; unit LimitMEMLOCK=infinity set करती है |
कोई isolcpus / nohz_full नहीं | WARN | दर्ज किया, latency tuning |
IOMMU translated, iommu=pt नहीं | WARN | दर्ज किया |
init_on_alloc=1 | WARN | दर्ज किया, वह कहता है बड़े reads पर CPU का 15 से 20 % लगता है |
| 2.5 GbE port, default NIC rings, पाँच CPUs पर IRQs | WARN | दर्ज किया |
| 8 × P4800X: कोई VWC नहीं, 4096+0 active, x4 at 8 GT/s, ख़ाली | OK | |
| SEND_ZC और fixed buffers के साथ io_uring, kernel 7.0 | OK |
दूसरे FAIL के लिए तैयार रहें।
Check box के हर controller को गिनता है, और boot SSD में write cache है, तो वह power-loss test में fail होता है, जबकि वही check उसे सही-सही “in use, not a candidate” बताता है।
Tutorial कहता है exit 0 का मतलब कोई FAIL नहीं9।
किसी भी host पर जो consumer SSD से boot होता है, और बहुत से Proxmox hosts ऐसे हैं, --check exit 0 नहीं दे सकता, चाहे आप कुछ भी ठीक करें।
Script exit code पर नहीं, हर check की line पर लिखें।
Tuning वाले WARNs वैसे ही रहे। हर एक के लिए kernel command line बदलनी पड़ती है और reboot करना पड़ता है, और यह एक deployment है, benchmark नहीं। किसी के इस box से कोई आँकड़ा बताने से पहले यही सही सूची है जिस पर काम करना है।
आठ OSDs के लिए cores और hugepages
FlashStore thread-per-core चलता है, और check साफ़ बताता है इसका मतलब क्या है: “one core = one shard/PG owner”, प्रति OSD ज़्यादा से ज़्यादा 8 cores, और हर OSD core अपने physical core पर, किसी SMT sibling के साथ बाँटे बिना।
आठ physical cores और आठ OSDs का मतलब हर एक को एक core, flashstore_lcores = 0 से 7 तक, और SMT siblings Proxmox और VMs के लिए छोड़ दिए।
Config में यह डालकर दोबारा चलाने पर check हर core plan को OK बताता है।
Hugepages को फिर से देखें।
Check प्रति OSD 2048 MiB माँगता है, जो daemon का default --mem है, तो आठ OSDs को 16 GiB reserved चाहिए।
चलते समय हर OSD ने अपने 2048 में से 512 MiB इस्तेमाल किए।
यह kernel backend के लिए croit के अपने design note से मेल खाता है, जो अपने payload allocator के लिए --mem का एक चौथाई रखता है10।
तो इस box पर, आठों चलते हुए, 12 GiB RAM hugepages के रूप में reserved बैठी है जिसे कोई छूता नहीं, उस host पर जिसे VMs को भी खिलाना है।
एक storage नोड को फ़र्क नहीं पड़ता।
एक Proxmox नोड पर वह memory एक VM थी, और आगे उसे घटाकर उतना किया गया है जितना OSDs इस्तेमाल करते हैं।
क्या मैं पूछ सकता हूँ कि यह ceph.conf क्यों नहीं पढ़ पाता?
Drives format हो गईं, package अंदर, host check साफ़, और पहला OSD शुरू नहीं हुआ।
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
Proxmox पर /etc/ceph/ceph.conf एक symlink है जो /etc/pve/ceph.conf की ओर इशारा करता है, और /etc/pve pmxcfs है, वह cluster filesystem जो हर नोड का config एक जैसा रखता है।
वहाँ की files root:www-data 0640 हैं, और pmxcfs इसे file के हिसाब से बदलने नहीं देता11।
Proxmox के अपने Ceph daemons काम चला लेते हैं क्योंकि वे root के रूप में शुरू होते हैं, config पढ़ते हैं, और फिर ceph user पर आ जाते हैं, जो हर ceph-osd@ unit पर --setuser ceph --setgroup ceph करता है।
FlashStore की unit root के रूप में शुरू नहीं होती।
वह पहले instruction से ही User=ceph है, ExecStartPre समेत12, तो वह file को कभी पढ़ ही नहीं पाती।
क्या मैं पूछ सकता हूँ कि Debian के लिए बना एक package, एक drop-in product के लिए, सबसे आम Debian-आधारित Ceph platform पर क्यों नहीं आज़माया गया? मैं यह नहीं पूछ रहा कि किसने। pveceph अपना config pmxcfs पर रखता है, और pveceph से चलने वाले नोड पर हर FlashStore OSD अपनी पहली शुरुआत पर इससे टकराएगा।
Daemon में जवाब पहले से बना हुआ है।
उसका source एक classic --setuser/--setgroup drop बताता है: “started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file”13।
तो एक drop-in जो unit को उसी तरह शुरू करे जैसे Proxmox अपने OSDs शुरू करता है, काफ़ी होना चाहिए।
पूरा काफ़ी नहीं था। सीधे root के रूप में शुरू करने पर अगला इनकार drive से आया।
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
Unit का CapabilityBoundingSet CAP_DAC_OVERRIDE को छोड़ देता है12, तो root को आम file permissions मानने पड़ते हैं, और namespace nodes ceph:ceph के हैं।
Root के रूप में शुरू करना और group को ceph रखना दोनों को ढक लेता है: config file root की है, ceph group drive खोलता है, और daemon कुछ और करने से पहले ceph पर आ जाता है।
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
Daemon अपने log में drop की पुष्टि करता है: set uid:gid to 64045:64045 (ceph)।
एक छोटा fix भी है, SupplementaryGroups=www-data, और मैंने उसे इस्तेमाल नहीं किया।
वह OSD को /etc/pve के नीचे की हर group-readable file पढ़ने देता, सिर्फ़ Ceph config नहीं।
एक OSD का cluster के बाकी configuration को पढ़ने से कोई लेना-देना नहीं, और ऊपर वाला drop-in उसे उससे ज़रा भी ज़्यादा नहीं देता जितना Proxmox अपने OSDs को देता है।
फिर device nodes।
FlashStore के docs कहते हैं namespace node ceph के लिए writable होना चाहिए, “(udev rule)”14, और package कोई rule नहीं देता।
यह rule drives को model से पहचानता है, तो numbering चाहे जो करे यह boot drive को नहीं पकड़ सकता:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
udevadm trigger के बाद सोलह Optane nodes ceph:ceph 0660 थे और SN750 root पर रही।
वह Passthrough जो यह Kernel नहीं करेगा
Kernel tier के दो modes हैं, और आप जो node देते हैं वही उनमें से चुनता है।
kernel:/dev/ngXnY NVMe commands सीधे io_uring के ज़रिए drive को भेजता है, जिसे croit kernel-cmd कहते हैं।
kernel:/dev/nvmeXnY block device पर O_DIRECT reads और writes करता है, जिसे kernel या direct कहा जाता है10।
croit ने अपने हर परखे हुए cell में kernel-cmd को आगे मापा10, और README का अपना quick start इसे इस्तेमाल करता है1, तो मैंने यही configure किया।
Permissions ठीक होने पर daemon ceph पर आया, अपना config पढ़ा, और पहले read पर रुक गया:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
वही probe एक मिनट पहले activate में pass हुआ था, जिसके पास अभी भी root की capabilities थीं।
तो सवाल यह है कि क्या यह kernel एक unprivileged process को /dev/ngXnY पर I/O commands भेजने देता है।
इसका जवाब FlashStore के बिना दिया जा सकता है, वही read nvme-cli से, ceph के रूप में:
| किसके रूप में | /dev/ng0n1 पर command | नतीजा |
|---|---|---|
ceph | Identify Namespace | अनुमति |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | अनुमति |
आठों Optanes ने यही जवाब दिया, उन दो समेत जिन्हें मैंने कभी format या reset नहीं किया था, जो Dell की जगह Intel का firmware चला रही थीं। तो यह drives नहीं हैं और सुबह के formats भी नहीं।
Upstream कहता है कि यह चलना चाहिए।
Linux 7.0 में nvme_cmd_allowed() एक unprivileged process को I/O command भेजने देता है जब drive का Commands Supported and Effects log उसे supported और बिना असामान्य effects के बताता है, और writable open सिर्फ़ उन commands के लिए माँगता है जो data लिखते या बदलते हैं15।
P4800X का effects log Read को supported बताता है, 00000001, और कुछ नहीं।
Read की अनुमति है।
Proxmox का kernel upstream वाला नहीं है।
इस build के उसके changelog में ठीक इसी रास्ते पर एक backported fix है, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), जो देखने में उस ioctl से अलग ioctl को ढकता है जिसे मैंने परखा।
मैंने यह पक्का नहीं किया है कि 7.0.14-28-pve kernel का कौन सा बदलाव फ़र्क डालता है, और मैं अंदाज़ा नहीं लगाऊँगा।
जो पक्का है वह बर्ताव है: इस kernel पर unprivileged NVMe passthrough I/O मना है।
FlashStore के पास मना किए गए passthrough के लिए एक fallback है, और वह नहीं चला।
croit का design note कहता है कि जब Identify मना हो, तो kernel-cmd device अपने block node पर direct I/O पर आ जाता है और startup पर यह बताता है10।
यहाँ Identify की अनुमति है और Read की नहीं, तो fallback कभी trigger नहीं होता और OSD रुक जाता है।
Direct I/O को फ़र्क नहीं पड़ता। प्रति OSD एक line है:
flashstore_store_backend = kernel
इसके साथ osd.0 चालू हो गया।
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
2.4 seconds में active।
OSDs को Prepare करना और शुरू करना
हर OSD को Ceph config में एक section मिलता है, जिसका Proxmox पर मतलब /etc/pve/ceph.conf को edit करना है, और इसे हाथ से करना ठीक है।
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
Device को PCI address से नाम दिया जाता है, /dev/nvme0n1 से नहीं, और spdk: prefix का यहाँ मतलब SPDK नहीं है।
Kernel backend set होने पर daemon हर शुरुआत पर sysfs में address देखता है और controller के मौजूदा nodes ढूँढता है10।
यहाँ यह मायने रखता है।
SN750 boot drive अक्टूबर में nvme7 थी और अब nvme8 है, और generic node minors भी drive के क्रम का पालन नहीं करते, ng1n1 minor 0 पर और ng0n1 minor 2 पर।
जो config /dev/nvme4n1 कहता है वह reboot के बाद किसी और drive की ओर इशारा कर सकता है।
जो config 0000:0b:00.0 कहता है वह नहीं कर सकता।
फिर हर drive के लिए एक command, जो store लिखता है और OSD को monitor के साथ register करता है:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
दो seconds, root के रूप में।
prepare bootstrap key /var/lib/ceph/bootstrap-osd/ceph.keyring से पढ़ता है16, जिसे pveceph सिर्फ़ तब लिखता है जब वह पहली बार अपना कोई OSD बनाता है, तो बिना classic OSDs के इसे पहले लाना पड़ता है:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
छह drives पहली बार में prepare हुईं। दो मना कर दी गईं:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk और blkid दोनों ने उन दो drives को ख़ाली बताया था।
उन पर एक पुराने lab के LVM volume group का text metadata area था, जो कब का हटाया जा चुका था, और आगे वाला label पहले ही शून्य किया जा चुका था।
FlashStore का probe पहले 8 KiB और 64 KiB और 256 KiB वाले हिस्से पढ़ता है17, जो आम tools से आगे है, और वह सही था।
किसी भी चीज़ वाली drive को मना करना, जब तक --wipe न कहा जाए, ठीक वही है जो एक OSD tool को करना चाहिए।
उन्हें मिटाना drives के मालिक का फ़ैसला है, tool का नहीं।
फ़ैसला होने के बाद --wipe ने दोनों को लगभग दो seconds में prepare किया, और वे आगे वाले install के बाद जुड़ीं, इसीलिए panel screenshot और install के आँकड़े छह दिखाते हैं।
फिर उन्हें शुरू करें:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
हर OSD ने खुद को host=pve2 के नीचे device class nvme के साथ रखा।
वे cluster को अपने बारे में क्या बताते हैं, उसे एक बार पढ़ना चाहिए:
| Field | Monitor और manager | FlashStore OSDs |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| किसने बनाया | Proxmox, -pve1 packages | croit, उस upstream v21.2.0 commit से जिसका README नाम लेती है1 |
osd_objectstore | bluestore, हर bluestore_bdev_* field भरा हुआ | |
| असल में यह क्या है | FlashStore, कोई BlueFS नहीं, कोई RocksDB नहीं |
BlueStore वाला जवाब जानबूझकर है।
flashstore_report_objectstore का default bluestore है क्योंकि classic monitors कुछ features तभी चालू करते हैं जब हर OSD यह बताए, तो default एक mixed cluster को चलाए रखता है7।
यह सच नहीं है, और cluster का metadata पढ़कर उस पर भरोसा करने से पहले यह जानना चाहिए।
Proxmox उन्हें क्या समझता है
Proxmox OSD panel छहों को दिखाता है, up और in, class nvme, version 21.2.0, हर एक 344 GiB।
वह उन्हें FileStore भी कहता है।
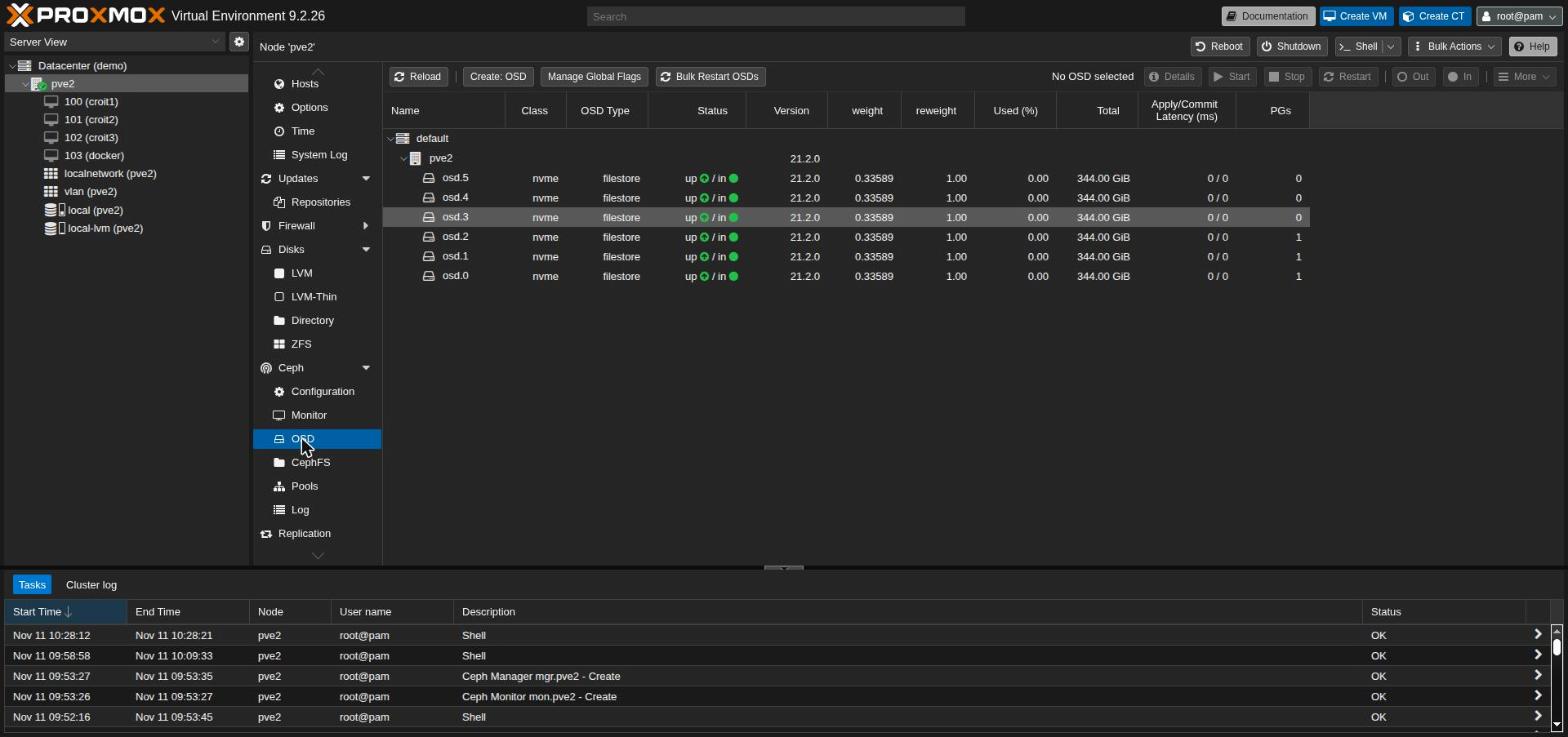
FileStore वह object store है जिसकी जगह BlueStore आया।
Proxmox यह label PVE/API2/Ceph/OSD.pm में तय करता है: अगर OSD के metadata में bluefs key है तो वह BlueStore है, और बाकी सब FileStore18।
FlashStore में BlueFS नहीं है, क्योंकि उसके नीचे कोई RocksDB नहीं, तो वह एक field में BlueStore बताता है और दूसरे से FileStore का label पाता है।
दोनों में से कोई सही नहीं।
और panel वहीं है जहाँ ज़्यादातर Proxmox admins सबसे पहले देखते हैं।
Idle पर latency columns 0 / 0 दिखाते हैं।
नीचे वाले install के दौरान ceph osd perf ने छहों पर 0 से 3 ms की commit latencies बताईं।
Panel में Start, Stop और Restart ceph-osd@N चलाते हैं, classic unit, जो चल नहीं रही19।
इसलिए panel इन OSDs को देखने की जगह है, इन्हें चलाने की नहीं।
Daemons को छूने वाली किसी भी चीज़ के लिए systemctl … croit-flashstore-osd@N और CLI इस्तेमाल करें, और इन पर Create: OSD और Destroy से दूर रहें।
एक Pool, एक Storage और एक Fisher-Price OS (Windows) VM
Cluster का पहला PG, manager का .mgr pool, OSDs चालू होते ही undersized+degraded पर बैठ गया।
दोष अकेले नोड का है।
Default replicated_rule हर copy को अलग host पर रखता है, और host एक ही है।
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Failure domain osd और device class nvme वाला rule20 हर copy को अलग OSD पर रखता है, और PG seconds में active+clean हो गया।
तीन या ज़्यादा hosts वाले असली cluster पर host rule रखें और यह छोड़ दें।
उसके बाद सब कुछ सामान्य Proxmox GUI है।
Ceph → Pools → Create: नाम flashstore, size 3, min size 2, rule replicated_osd, Add as Storage पर tick।
नीचे वाले load test के लिए बाद में यह size 2, min size 1 पर गया।
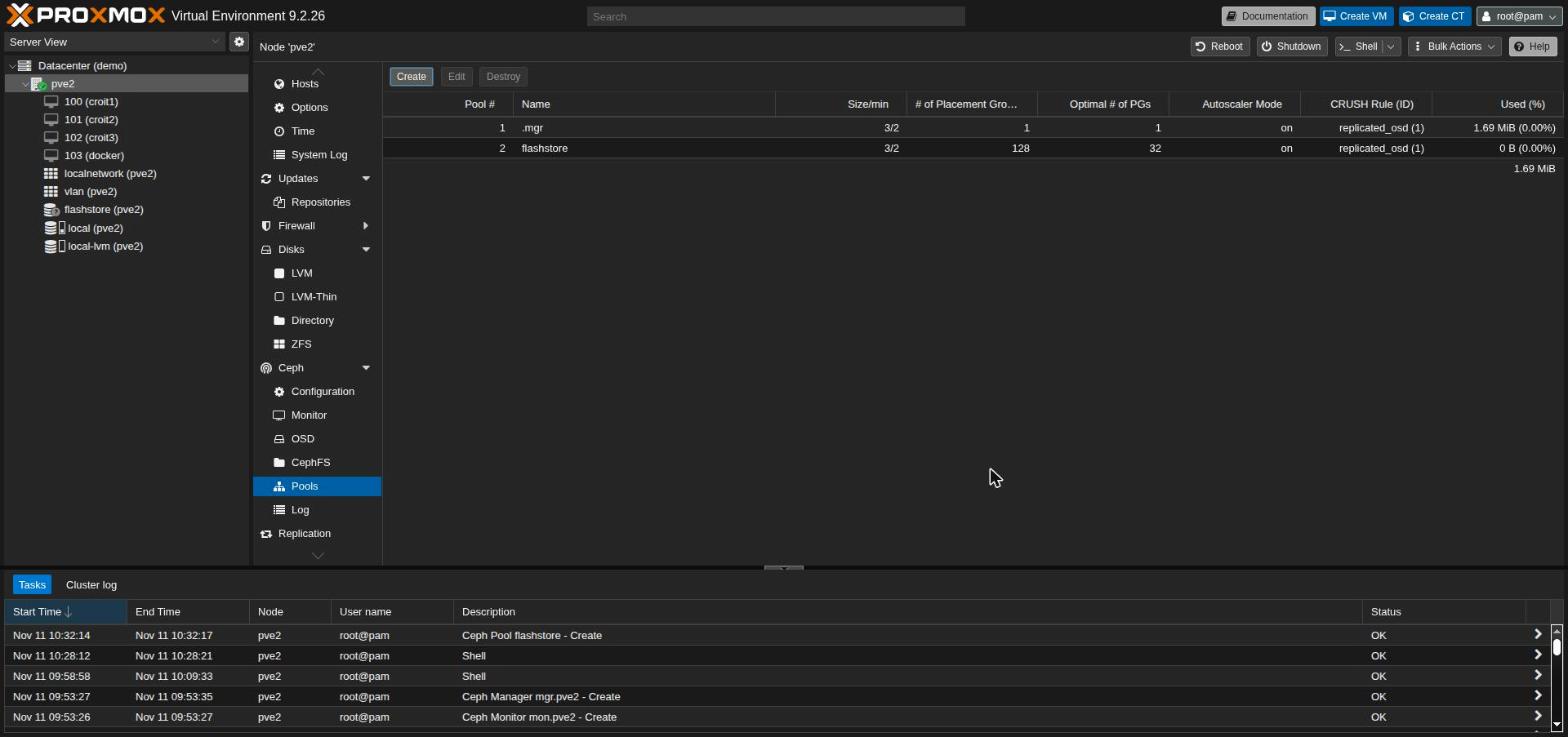
Proxmox ने pool और RBD storage definition एक ही बार में बनाई, और flashstore tree में 654 GiB इस्तेमाल लायक के साथ आया, जो 2 TiB raw को तीन copies से भाग देकर, overhead घटाकर है।
129 PGs active+clean हुए, और autoscaler ने थोड़ी देर बाद नए pool को 128 से 32 पर ला दिया।
Test guest एक Fisher-Price OS (Windows) VM है।
यह पसंद नहीं है, यह वह है जो ग्राहकों का बड़ा हिस्सा असल में अपने Proxmox pools पर चलाता है, तो वही load है जो गिना जाता है: 16 GiB memory, 4 cores, flashstore पर 60 GiB disk, discard और iothread चालू।
यह disk से बहुत बात करता है और उसके साथ अकुशल है, और यही बात है: storage test को वह guest चाहिए जो disk पर सबसे ज़्यादा टिकता है।
Install के पहले पंद्रह मिनट में हर दस seconds पर pool का नमूना:
| Pool writes | active रहते median 9.3 MB/s, peak 302 MB/s |
| Write operations | peak 2,486 प्रति second |
| Pool reads | peak 60 MB/s |
| इस्तेमाल हुई raw जगह | छह OSDs में 35 GiB |
| Health | सभी 90 नमूनों में HEALTH_OK |
| OSD restarts | 0 |
| OSD resident memory | बाद में हर एक 565 से 871 MiB |
ये एक installer के आँकड़े हैं, VM और OSDs एक ही host पर और tuning WARNs अनछुए, और ये FlashStore की रफ़्तार के बारे में कुछ नहीं कहते। ये जो कहते हैं वह यह है कि एक classic Proxmox client ने Rust OSDs पर एक operating system install चलाया, 35 GiB raw, बिना किसी गड़बड़ी के, और यही वह दावा है जिसे परखने यह post निकली थी।
Load में यह क्या करता है
Install साबित करता है कि यह चलता है। यह नहीं बताता कि VM इस्तेमाल करने में कैसी है।
तो VM पर CrystalDiskMark 9.0.321 तीन बार चला: Real World Performance [+Mix] profile, Read&Write [+Mix], C: पर 16 GiB file और 70/30 read और write mix, एक बार तीन passes पर और दो बार नौ पर। वह profile सब कुछ एक thread पर एक बार में एक request चलाता है, जो एक desktop या छोटा database असल में करता है, datasheet नहीं।
तब तक setup install से आगे बढ़ चुका था। VM में छह cores थे, और pool को GUI में size 2, min size 1 और 256 PGs पर बदला जा चुका था। Min size 1 के साथ size 2 एक box पर lab setting है: एक copy बचने पर pool ऐसे writes लेता रहता है जिन्हें एक failure खो सकता है। और कहीं, 3 और 2 रखें।
Disk Proxmox के default पर थी, कोई cache नहीं, जो Proxmox 2 से default है22।
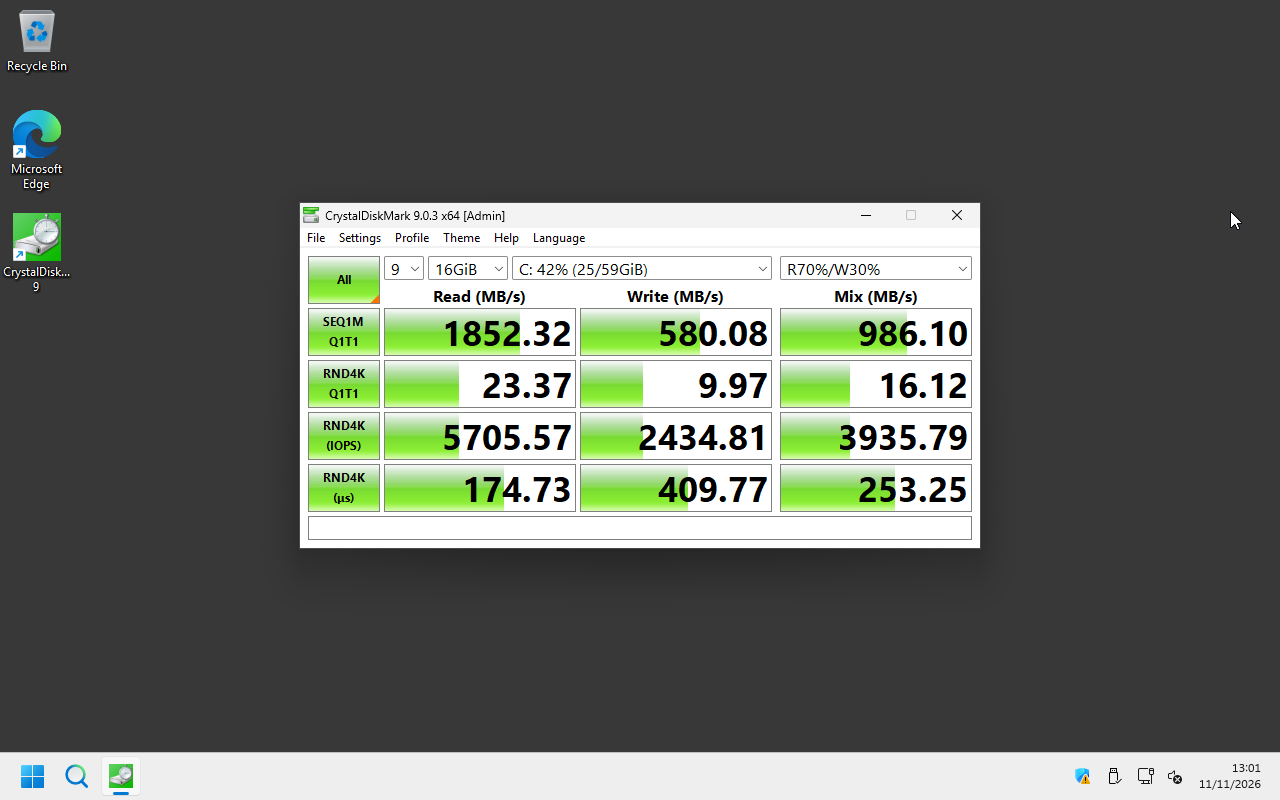
| Real World Performance [+Mix], 16 GiB | 3 passes | 9 passes | फिर से 9 passes |
|---|---|---|---|
| SEQ1M Q1T1 read | 1,279.71 MB/s | 1,675.33 MB/s | 1,852.32 MB/s |
| SEQ1M Q1T1 write | 563.67 MB/s | 576.65 MB/s | 580.08 MB/s |
| SEQ1M Q1T1 mix | 1,043.75 MB/s | 1,043.28 MB/s | 986.10 MB/s |
| RND4K Q1T1 read | 5,342 IOPS, 186.57 µs | 5,659 IOPS, 176.17 µs | 5,706 IOPS, 174.73 µs |
| RND4K Q1T1 write | 2,419 IOPS, 412.51 µs | 2,405 IOPS, 414.79 µs | 2,435 IOPS, 409.77 µs |
| RND4K Q1T1 mix | 3,938 IOPS, 253.13 µs | 3,826 IOPS, 260.49 µs | 3,936 IOPS, 253.25 µs |
Writes और small-block latency हर run में लगभग 1% के अंदर रहते हैं। Sequential read तीनों में 45% चढ़ता है। यह पहला संकेत है कि read column वह नहीं माप रहा जो दिखता है।
तीनों के दौरान host का हर पाँच seconds पर नमूना लिया गया, आठ Optanes के लिए /proc/diskstats से, pool के लिए ceph status से और हर process और thread के लिए /proc से, और दोनों नज़रिए एक ही कहानी नहीं बताते।
Writes: drive छोटा हिस्सा है
| एक बार में एक 4 KiB random write, आख़िरी run | |
|---|---|
| प्रति write समय, VM को दिखा | 409.77 µs |
| प्रति write समय, हर Optane पर | 17 µs |
| हर VM write पर Optanes तक पहुँचे writes | 4.05: दो copies, लगभग दो writes हर एक |
| बड़े sequential writes | VM से 580 MB/s, Optanes पर 1.14 GB/s, दूसरी copy इसे दोगुना करती है |
एक छोटे write में drive 5% से कम है। बाकी 393 µs सफ़र है: QEMU, librbd, OSD में messenger, खुद OSD, और दूसरी copy का इंतज़ार। इनमें से कुछ भी यहाँ अलग से नहीं मापा गया, तो मैं हर टुकड़े पर कोई संख्या नहीं रखूँगा। जो यह कहता है वह यह है कि इस box पर एक-एक करके I/O के लिए Optanes सीमा नहीं हैं, और तेज़ drive उस 410 को ज़्यादा नहीं हिलाएगी। सीमा client पर चली गई है, वह librbd जो Proxmox देता है, और जब croit का अपना librustyrbd यहाँ deploy होगा तो इस पर और आएगा।
Reads: cache, Optanes नहीं
आख़िरी run में 4 KiB random read pass ने पूरी 16 GiB file पर प्रति second 5,700 reads किए, और आठ Optanes ने कुछ भी नहीं पढ़ा।
Sequential pass pool पर 2.2 GB/s तक पहुँचा जबकि drives के अपने reads 755 MB/s से शून्य पर गिर गए।
CrystalDiskMark guest के cache को बायपास करता है और QEMU में disk का कोई cache नहीं, तो काम करने वाली memory OSDs में है।
flashstore_obj_cache इस build में default रूप से चालू है, size 2 पर file में हर OSD का हिस्सा लगभग 2 GiB है, और हर OSD लगभग 2.6 GiB तक बढ़ चुका था।
FlashStore अपने hits नहीं बताता, तो इसे साबित नहीं, लगभग पक्का कहें।
इसीलिए sequential read हर run के साथ बढ़ा: file का ज़्यादा हिस्सा पहले से वहाँ था।
Read column को store का नहीं, cache का आँकड़ा मानें।
CPU: cores कहाँ गए
| आख़िरी run, cores में | Host busy | OSDs | Guest vCPUs | librbd और Ceph client | QEMU |
|---|---|---|---|---|---|
| Passes के बीच idle | 20 से 24% | 3.3 | 0.1 | 0.03 | 0.03 |
| 4 KiB random write | 30% | 3.9 | 0.38 | 0.20 | 0.08 |
| 4 KiB random read | 30% | 3.6 | 0.47 | 0.39 | 0.15 |
| Sequential mix | 41 से 53% | 3.8 | 1.5 से 2.3 | 0.5 | 0.12 |
VM के तीन columns उसके threads से आते हैं: QEMU guest के vCPUs को नाम देता है, और librbd के messenger और worker threads उसी process के अंदर चलते हैं।
OSD column मुश्किल से हिलता है। आठ polling OSDs कुछ न करते हुए 3.3 cores लेते हैं और पूरे ज़ोर पर 3.9, तो 16-thread box पर किसी VM के कुछ माँगने से पहले CPU का पाँचवाँ हिस्सा जा चुका है। और कुछ भी अपनी सीमा के पास नहीं आया। सबसे व्यस्त अकेला thread 47% पर एक guest vCPU था, और librbd का सबसे व्यस्त 15% से नीचे रहा। एक बार में एक request पर सीमा इंतज़ार है, काम नहीं, और CPU का आँकड़ा इंतज़ार नहीं दिखा सकता।
Memory: peak के लिए योजना बनाएँ
| तीनों runs में | |
|---|---|
| Health | हर नमूने में HEALTH_OK, हर PG active+clean, कोई OSD restart नहीं |
| इस्तेमाल में hugepages | शुरू से अंत तक 4 GiB |
| देने के लिए बची host memory, एक 16 GiB VM चलते हुए | 3.1 से 4.0 GiB |
Hugepage वाली पंक्ति फिर से budget वाला section है, इस बार load में: प्रति OSD 512 MiB, और बाकी 12 GiB कभी नहीं छुए गए।
आम memory वह संख्या है जिस पर नज़र रखनी है, क्योंकि ऊपर वाला cache उसी से बना है। एक बार read के file खींच लेने पर हर OSD लगभग 2.5 GiB पर बैठा, और 58.7 GiB host पर Ceph ने इतना रखा:
| Peak पर Ceph की memory, default 4 GiB target | |
|---|---|
| OSD processes, आठों मिलाकर | 19.9 GiB, हर एक 2.4 से 2.6 GiB |
| OSDs के लिए reserved hugepages | 16 GiB, उसमें से 4 GiB इस्तेमाल |
| Monitor और manager | 0.3 GiB |
| कुल | 36.2 GiB, host का 62% |
| Host के देने को बचा, एक 16 GiB VM चलते हुए | 3.6 GiB |
यह वापस आती है, लेकिन किसी ऐसे समय पर नहीं जो मुझे दिखा।
यह idle gaps समेत 25 मिनट तक 19.9 GiB पर रही, फिर आख़िरी run के अंत में 13.9 GiB पर गिरी, और host के पास फिर से देने को 10.2 GiB थे।
उस सब के दौरान osd_memory_target प्रति OSD अपने default 4 GiB पर था, तो एक भी hugepage गिनने से पहले आठ OSDs 32 GiB के हक़दार थे।
जिस नोड को VMs भी चलानी हैं, उस पर drives से पहले peak ही वह budget है जिसे निकालना है, और वहीं 12 बेकार GiB hugepages सबसे ज़्यादा चुभते हैं।
एक साथ तीन VMs, तंग budget पर
एक VM बहुत जगह छोड़ती है। तीन पर budget सही होना चाहिए। तो पहले दो settings बदलीं।
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
Target को और कुछ नहीं चाहिए: हर OSD ने seconds में नया मान बताया, और फिर भी उन्हें एक-एक करके restart किया गया, अगले से पहले सभी 257 PGs वापस active+clean।
Hugepages में एक पेच है।
हर OSD शुरू होने से पहले croit-flashstore-prep एक पूरा --mem ख़ाली चाहता है, 2048 MiB, और कम हो तो pool बढ़ा देता है, लेकिन उसे कभी घटाता नहीं।
घटाने के बाद osd.7 को restart करने पर pool सीधे वापस ऊपर गया:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
तो restart या reboot के बाद बचने वाली न्यूनतम सीमा है OSDs जितना इस्तेमाल करते हैं उतना और एक शुरुआत का margin: 2,816 pages, 5.5 GiB, उन 16 GiB के मुक़ाबले जो check माँगता है। नीचे वाली setup script अब ठीक इतना ही reserve करती है। आठों चालू होने पर वापस 2,048 पर घटाने से अगले restart तक 1.5 GiB और मिलते हैं।
फिर VM के तीन clones ने, हर एक 10 GiB पर, एक ही समय में CrystalDiskMark चलाया: Real World Performance [+Mix], तीन passes, लेकिन 16 GiB की जगह हर एक 1 GiB file पर। इससे read column पहले से भी ज़्यादा cache का आँकड़ा बन जाता है, तो writes पढ़ें।
| CrystalDiskMark, एक साथ तीन VMs | VM 104 | VM 105 | VM 106 | तीनों | अकेली एक VM |
|---|---|---|---|---|---|
| SEQ1M Q1T1 write | 346.99 MB/s | 318.99 MB/s | 446.98 MB/s | 1,113 MB/s | 580.08 MB/s |
| SEQ1M Q1T1 read | 796.05 MB/s | 905.03 MB/s | 1,160.93 MB/s | 2,862 MB/s | 1,852.32 MB/s |
| RND4K Q1T1 write | 1,901 IOPS | 1,928 IOPS | 1,862 IOPS | 5,691 IOPS | 2,435 IOPS |
| RND4K Q1T1 write latency | 524.56 µs | 517.00 µs | 535.42 µs | 409.77 µs | |
| RND4K Q1T1 read | 3,773 IOPS | 3,916 IOPS | 3,909 IOPS | 11,598 IOPS | 5,706 IOPS |
| RND4K Q1T1 mix | 2,978 IOPS | 3,027 IOPS | 3,411 IOPS | 9,416 IOPS | 3,936 IOPS |
तीन VMs को एक के 2.3 गुना छोटे writes मिले, और हर एक ने इसके लिए latency में लगभग 27% चुकाया। कारण अब भी Optanes नहीं थीं। वे 17 µs प्रति write पर 20,900 writes प्रति second के peak पर पहुँचीं, एक VM वाले वही 17 µs, और आठों में सबसे व्यस्त 14% व्यस्त थी।
| Host, पूरे run में हर पाँच seconds | Default 4 GiB target, एक VM | 1 GiB target, तीन VMs |
|---|---|---|
| सबसे बड़ा OSD process | 2.7 GiB | peak पर 1.15 GiB, बाद में 0.8 |
| आठों OSD processes मिलाकर | 19.9 GiB | peak पर 8.0 GiB, बाद में 5.8 |
| Reserved hugepages | 16 GiB, 4 इस्तेमाल | 4 GiB, सब इस्तेमाल |
| VMs को दी गई memory | 16 GiB | 30 GiB |
| देने को बची host memory, सबसे कम पर | 3.1 GiB | 14.8 GiB |
| Swap में बढ़त | कोई नहीं | कोई नहीं |
तो FlashStore खुद को osd_memory_target पर टिकाए रखता है।
एक read pass के peak पर यह 15% ऊपर गया और वापस नीचे आया, cache अपना काम budget के अंदर कर रहा था, बाहर नहीं।
Target और घटाने के बीच, उसी box पर 26 GiB VMs को वापस मिले।
| CPU cores में, तीन VMs | Host busy | OSDs | Guests | librbd और Ceph client | QEMU |
|---|---|---|---|---|---|
| तीन Fisher-Price OS (Windows) boots | 81 से 89% | 3.4 से 3.6 | 6.3 से 7.9 | 0.4 से 0.7 | 0.3 |
| Benchmark | 42 से 73% | 3.7 से 4.5 | 1.2 से 4.0 | 0.4 से 1.6 | 0.2 से 0.4 |
| बाद में idle | 20 से 24% | 3.3 | 0.3 | 0 | 0 |
तीन guests को boot करने ने उन्हें benchmark करने से ज़्यादा CPU लिया। नीचे का storage कभी उसके पास नहीं आया, जो mini PC की सीमा है, जैसा हमेशा होना ही था।
यह सब, एक Script में
ऊपर का सब कुछ एक script में है। उसे उन drives के PCI addresses दें जिन्हें आप OSDs बनाना चाहते हैं और बाकी वह करती है, उसी क्रम में जिसमें इस post ने किया, दोनों Proxmox fixes अंदर बने हुए।
flashstore-pve-setup.sh: एक Proxmox VE नोड पर FlashStore OSDslspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| यह जाँचती है | यह लिखती है | यह चलाती है |
|---|---|---|
| Proxmox VE 9 और Ceph 21.2.0 Umbrella | bootstrap-osd keyring | ceph के रूप में एक passthrough read, kernel-cmd या kernel चुनने के लिए |
| हर drive: NVMe, कोई write cache नहीं, mounted, partitioned या held नहीं | root-फिर---setuser drop-in | हर drive पर prepare और systemctl enable --now |
| उन हिस्सों में कोई data नहीं जो FlashStore का अपना probe पढ़ता है | हर drive के लिए एक udev rule, serial number से मिलाया | host check, सिर्फ़ उस पर रुकते हुए जो OSDs को चाहिए |
| 4 KiB blocks | हर drive के लिए एक [osd.N] section, हर एक को एक physical core | package download, release के SHA-256 के सामने जाँचा |
जब तक आप न कहें, कुछ भी नष्ट नहीं होता।
--format-4k उस drive को दोबारा format करता है जो 4 KiB पर नहीं है, एक बार में एक, अपनी unit में ताकि कुछ उसे न रोके, और --wipe उसे data वाली drive पर लिखने देता है।
--single-node replicated_osd rule जोड़ता है, और इसे दोबारा चलाने पर जो drives पहले से OSDs हैं उन्हें छोड़ देता है।
इसे यहाँ परखा गया, सिर्फ़ लिखा नहीं गया।
इसने SN750 को उसके write cache पर मना किया, osd.7 की drive को तब मना किया जब उस पर अभी भी store था, और फिर, osd.7 के purge होने और उसके nodes root को लौटाए जाने के बाद, उसे 10.5 seconds में शून्य से दोबारा बनाया, kernel backend खुद चुनते हुए।
यह जो नहीं करेगी वह है Ceph install करना।
उस कदम में आपसे एक Technology Preview स्वीकार करने को कहा जाता है, और यह आपका फ़ैसला है, script का नहीं।
क्या ठीक होना चाहिए
इनमें से कुछ भी एक ठाने हुए admin को नहीं रोकता, और यह सब एक व्यस्त admin को रोक देगा। हर बात एक बयान है जो croit package download करने वाले हर व्यक्ति से करता है, और हर एक से मैं पहली कोशिश में टकराया।
| कहाँ | क्या होता है | क्या ठीक करेगा |
|---|---|---|
| systemd unit | User=ceph pmxcfs नहीं पढ़ सकता, तो pveceph नोड पर OSD कभी शुरू नहीं होता | root-फिर---setuser start ship करें, या एक Proxmox drop-in |
| kernel-cmd fallback | सिर्फ़ Identify मना होने पर fallback; PVE के kernel पर Read मना है और OSD रुक जाता है | किसी भी मना किए गए passthrough I/O पर direct I/O पर fallback |
| udev | docs ceph को namespace nodes देने वाला rule माँगते हैं; कोई ship नहीं होता | configured devices से जुड़ा एक rule ship करें |
--check summary | kernel NVMe को “compiled out” कहता है जबकि वही अकेला compiled store path है | label ठीक करें |
--check exit code | boot SSD PLP test में fail होती है, तो exit 0 तक पहुँचा नहीं जा सकता | सिर्फ़ configured या candidate devices को गिनें |
| hugepages | प्रति OSD 2048 MiB का आकार, और prep हर शुरुआत पर इतना ख़ाली चाहता है; kernel backend 512 इस्तेमाल करता है | kernel backend को उतना रखें जितना वह इस्तेमाल करता है, और prep भी उतना ही माँगे |
sha256sums.txt | file के नाम release assets से मेल नहीं खाते | उन्हें प्रकाशित नामों से रखें |
| package का नाम | docs कहते हैं apt remove flashstore; package croit-flashstore-osd है | एक नाम, या docs में सही नाम |
flashstore_dev reference | सिर्फ़ spdk: और file: सूचीबद्ध | kernel: और kernel backend के साथ spdk: को document करें |
इनमें से कुछ भी नया काम नहीं है। Daemon में privilege drop, direct backend और fallback logic पहले से हैं। बस उन्हें उस platform के लिए जोड़ा नहीं गया है जिस पर ज़्यादातर लोग इसे पहले आज़माएँगे।
Preview वहीं है जहाँ यह पता चलता है
इन सब findings के लिए preview सही जगह है, और उन्हें छोड़ने के लिए ग़लत जगह। Preview इसी के लिए है: कोई उसे घर ले जाता है, उस hardware पर लगाता है जो उसके पास सच में है, और लिखता है कि वह कहाँ गिरता है। जो हिस्से मायने रखते हैं वे टिके रहे। Store milliseconds में चालू हुआ, OSDs किसी और की tooling से बने cluster में जुड़े, और एक operating system install बिना किसी गड़बड़ी के उन पर गया।
जिस चीज़ ने उसे लड़खड़ाया वह daemon के आसपास का सब कुछ था। एक ऐसे filesystem पर config file जिसे unit पढ़ नहीं सकी, एक kernel जो उस call को ना कहता है जिसे upstream अनुमति देता है, एक boot drive जिसे check गिनना बंद नहीं करता। इनमें से कुछ भी कठिन नहीं है। यह सब उस software के बीच का फ़र्क है जो चलता है और जो आपके box पर चलता है, और इसे पाटने का अकेला तरीका उन boxes पर परखना है जो लोगों के पास हैं, न कि उन पर जो आपने इसके लिए बनाए।
इस सब के बावजूद, यह एक आशाजनक शुरुआत है। एक घटिया mini PC पर, client की तरफ़ अभी भी classic librbd और आठों drives एक PCIe 3.0 link पर, Optanes से यहाँ BlueStore से ज़्यादा काम लिया जाता है। जैसे-जैसे यह विकसित होगा मैं इस पर लौटूँगा और गहराई में जाऊँगा, जैसे-जैसे stack का ज़्यादा हिस्सा बदला जाएगा, और CephFS2 पर भी एक नज़र के साथ।
“Drop-in” एक वादा है जो उस admin से किया जाता है जिसके पास source पढ़ने का समय नहीं। Proxmox के monitors, Proxmox का GUI, Proxmox का kernel और किसी और का package, यही ठीक वह स्थिति है जिसके लिए वह वादा है। अब यह उसे लगभग निभाता है। नौ छोटे fixes और यह निभा देगा, और मैं बुधवार सुबह उन्हें ढूँढने वाला होना पसंद करूँगा, बजाय उस ग्राहक के जो उन्हें शुक्रवार रात ढूँढता है।
croit/ceph-rust README — 9 नवंबर 2026 से public preview, “not yet recommended for production data”, requirements, quick start, production feature set, परखा गया Ceph commit। ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — यहाँ इस्तेमाल हुए packages,
flashstore_…_debian-trixie_amd64.debऔरsha256sums.txtसमेत। ↩︎ ↩︎croit/ceph-rust — hardware requirements — volatile write cache check, hugepages, kernel version के notes। ↩︎
croit/ceph-rust — branches and versions —
mainv21.2.0 को निशाना बनाती है,v20.2.4v20.2.4 को; “The daemon refuses a cluster release outside its supported window.” ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellarelease => '21.2'औरunsupported => 1के साथ सूचीबद्ध। ↩︎croit/ceph-rust — build and install packages — distributions, glibc 2.34,
ceph-osd.targetका संभाल,apt removeवाली line। ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstoreऔर इसका defaultbluestoreक्यों है। ↩︎ ↩︎croit-flashstore-osd Cargo.toml — line 29,
knet = [… "kernel-nvme"]। ↩︎croit/ceph-rust — first OSD tutorial — सिर्फ़ पढ़ने वाला host check; “Exit 0 means no FAIL.” ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — दोनों kernel modes, मापी गई तुलना, payload allocator budget,
spdk:address resolution और सिर्फ़-Identify fallback (amendment 6)। Release वाली शाम ही repository में जोड़ा गया। ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) —
/etc/pveके नीचे का cluster filesystem और उसकी तय ownership और permissions। ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activate, औरCAP_DAC_OVERRIDEके बिना एकCapabilityBoundingSet। ↩︎ ↩︎croit-flashstore-osd privdrop.rs — classic
--setuser/--setgroupprivilege drop। ↩︎croit/ceph-rust — prepare the host — “the namespace node must be readable and writable by user
ceph(udev rule)”। ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), unprivileged NVMe passthrough का नियम। ↩︎croit/ceph-rust — security — “
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring”। ↩︎croit/ceph-rust — prepare, activate and list — non-empty device probe और
--wipe। ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypeतभीbluestoreहै जब metadata मेंbluefsहो, नहीं तोfilestore। ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()osd.Nको systemd unitceph-osd@Nसे जोड़ता है। ↩︎Ceph documentation — CRUSH maps — replicated rules, failure domains और device classes। ↩︎
CrystalDiskMark — Crystal Dew World का disk benchmark; “Various measure mode (Peak/Real World/Demo)”। ↩︎
Proxmox VE wiki — Performance Tweaks — disk cache modes: “cache=none seems to be the best performance and is the default since Proxmox 2.X”। ↩︎