Skip to content
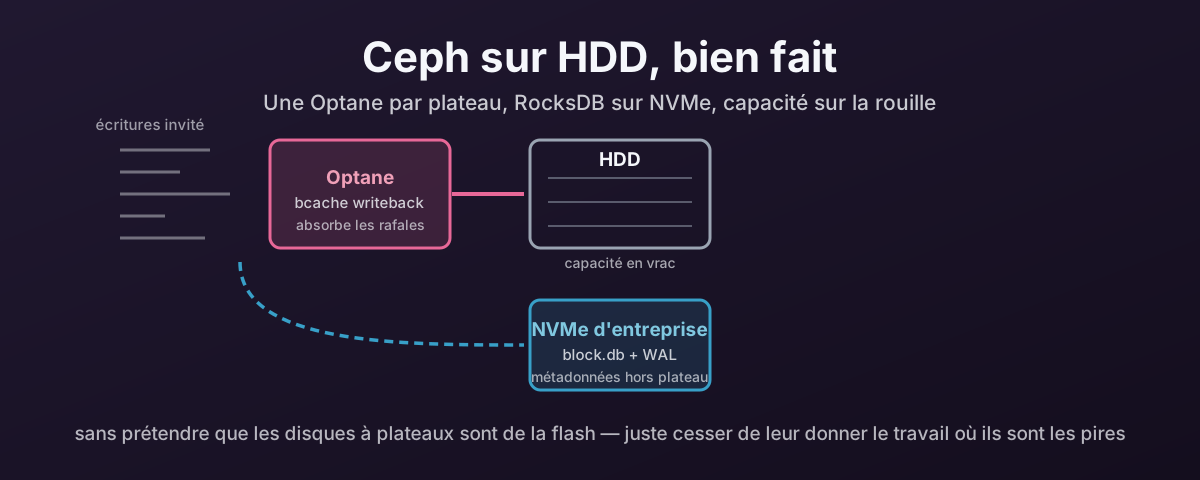
Trois paliers de stockage : Optane absorbant les écritures, NVMe tenant les métadonnées Ceph, et HDD fournissant la capacité en vrac

Rendre rapides les clusters Ceph Proxmox sur HDD — métadonnées sur NVMe, une Optane par plateau, et ce que ça vous coûte

Le prix de la flash a rendu le tout-NVMe difficile à justifier, et les HDD d’entreprise méritent un nouveau regard. En tirer une latence acceptable sur du Ceph Proxmox hyper-convergé veut dire sortir RocksDB du plateau, apparier chaque disque avec sa propre Optane par bcache — Optane précisément, parce que l’endurance de la NAND est mauvaise pour ce travail — et être honnête sur les modes de défaillance que ça achète.
7 aoĂ»t 2026 Â· 41 min Â· 8526 mots Â· Damien Dye
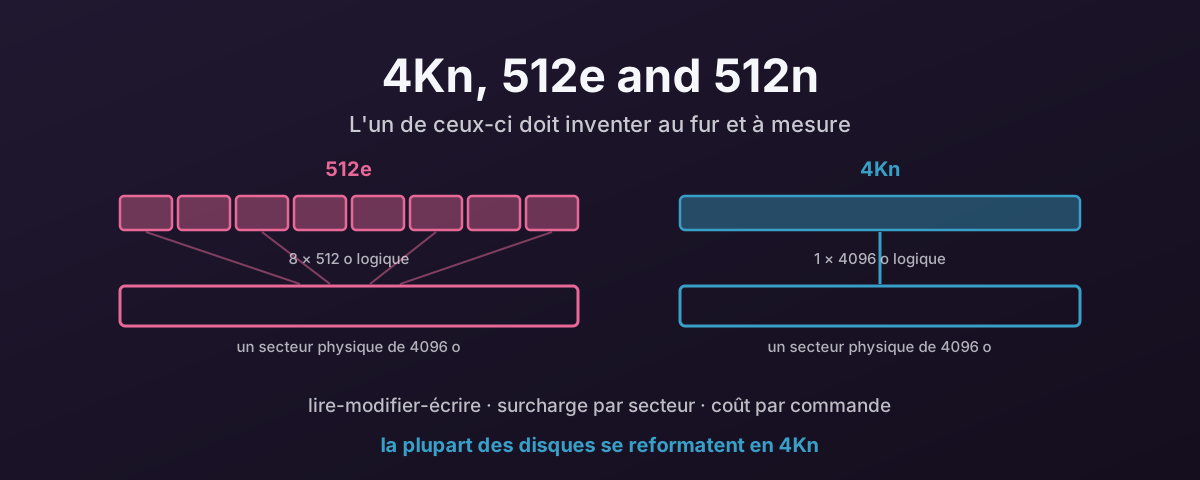
Huit blocs logiques de 512 octets mappés sur un secteur physique de 4K, à côté d'un mappage 4K un-pour-un

4Kn, 512e et 512n — pourquoi le 4K natif l'emporte, et ce que coûte l'émulation

Les disques 512e présentent des secteurs de 512 octets qu’ils n’ont pas, et le micrologiciel comble la différence à chaque écriture non alignée. Ce que cela coûte sur le support, dans l’hôte et en amplification d’écriture — pourquoi les écritures directes synchrones sont le pire cas — et comment convertir un parc en 4Kn.

7 aoĂ»t 2026 Â· 30 min Â· 6208 mots Â· Damien Dye
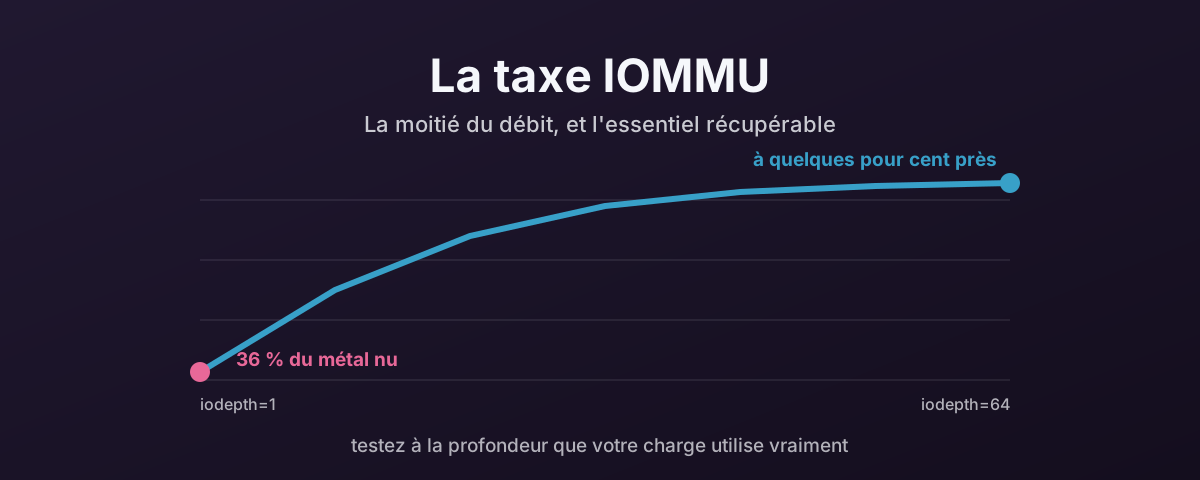
Une courbe montant de 36 pour cent du métal nu à la profondeur de file 1 jusqu'à quelques pour cent près à la profondeur de file 32

Performance du passthrough PCIe sur Proxmox VE — la taxe IOMMU et comment la réduire

Pourquoi les périphériques PCIe perdent du débit quand on les passe à une VM par VFIO, et les étapes de réglage pratiques qui en récupèrent l’essentiel.

7 aoĂ»t 2026 Â· 22 min Â· 4582 mots Â· Damien Dye
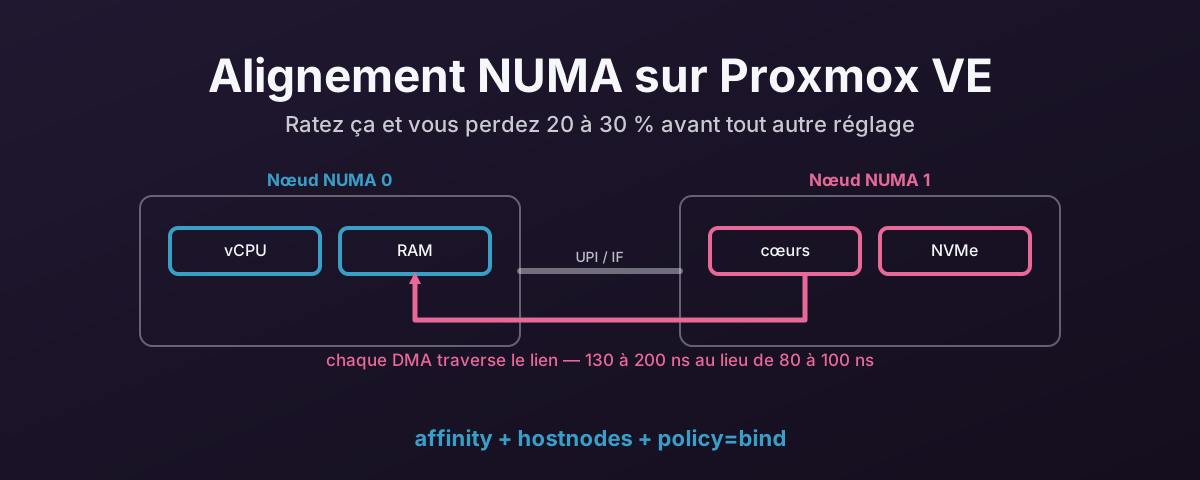
Deux sockets CPU avec un chemin DMA traversant le lien inter-socket qui les relie

Alignement NUMA sur Proxmox VE — pourquoi ça compte et comment bien le faire

Sur les systèmes multi-sockets, une VM dont les vCPU sont sur un nœud NUMA et l’équipement en passthrough sur un autre perd 20 à 30 % de débit avant même que vous ayez regardé quoi que ce soit d’autre.

7 aoĂ»t 2026 Â· 10 min Â· 2006 mots Â· Damien Dye
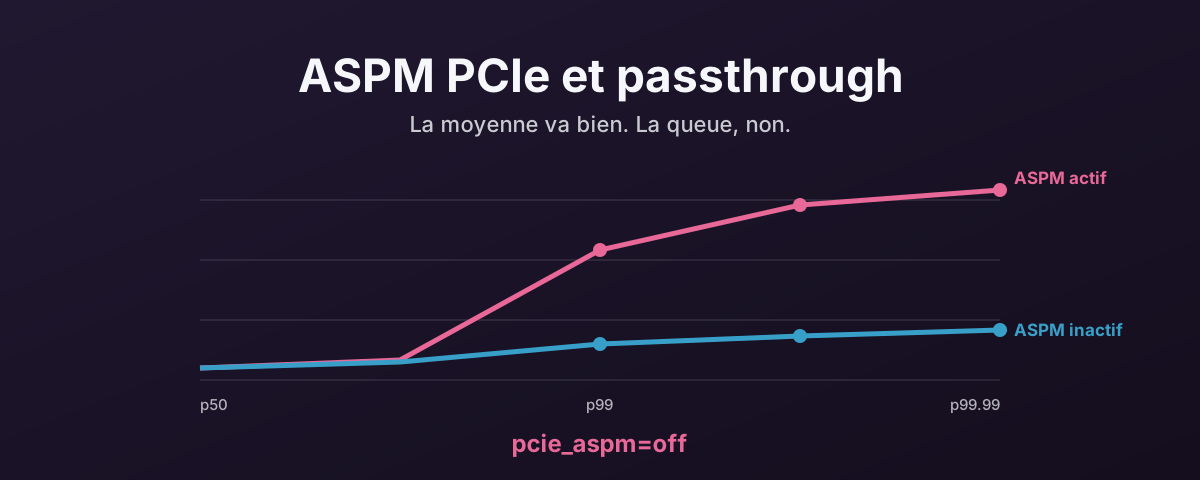
Une courbe de percentiles de latence qui reste plate jusqu'au p90 puis grimpe brutalement, à côté d'une autre qui reste plate

L'ASPM PCIe et pourquoi le désactiver pour le passthrough

L’Active State Power Management économise quelques watts sur les liens PCIe au repos. Sous passthrough VFIO, il ajoute une gigue de latence difficile à diagnostiquer et facile à corriger.

7 aoĂ»t 2026 Â· 9 min Â· 1867 mots Â· Damien Dye
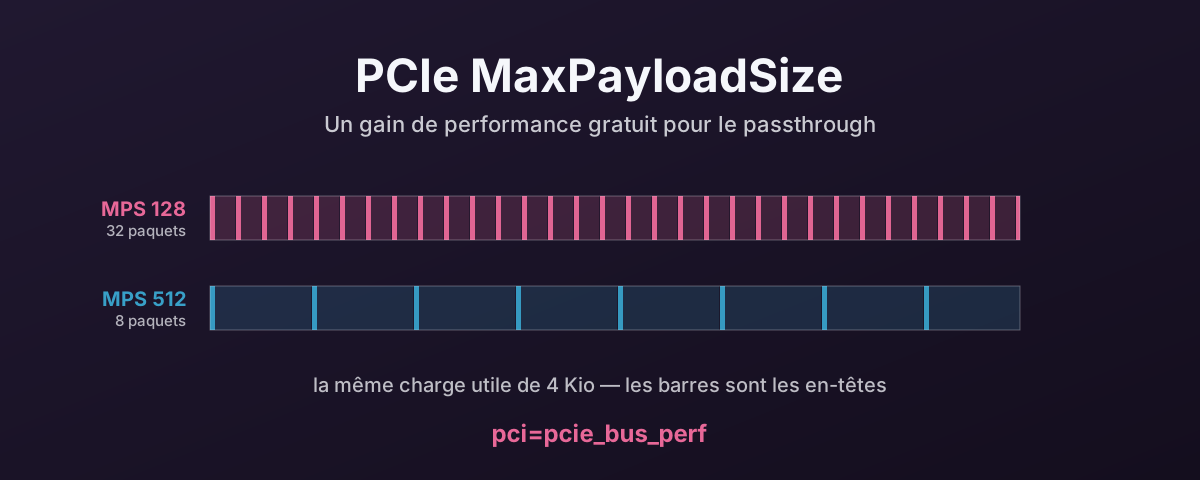
La même charge utile de 4 Kio dessinée en 32 paquets à MPS 128 et 8 paquets à MPS 512

PCIe MaxPayloadSize — un gain de performance gratuit pour le passthrough

Le root complex virtuel de QEMU se rabat par défaut sur des charges utiles TLP de 128 octets. La plupart des équipements gèrent 256 ou 512. Un seul paramètre noyau corrige ça.

7 aoĂ»t 2026 Â· 8 min Â· 1605 mots Â· Damien Dye