Faire tourner un LLM sur le NPU Ryzen AI, dans un conteneur
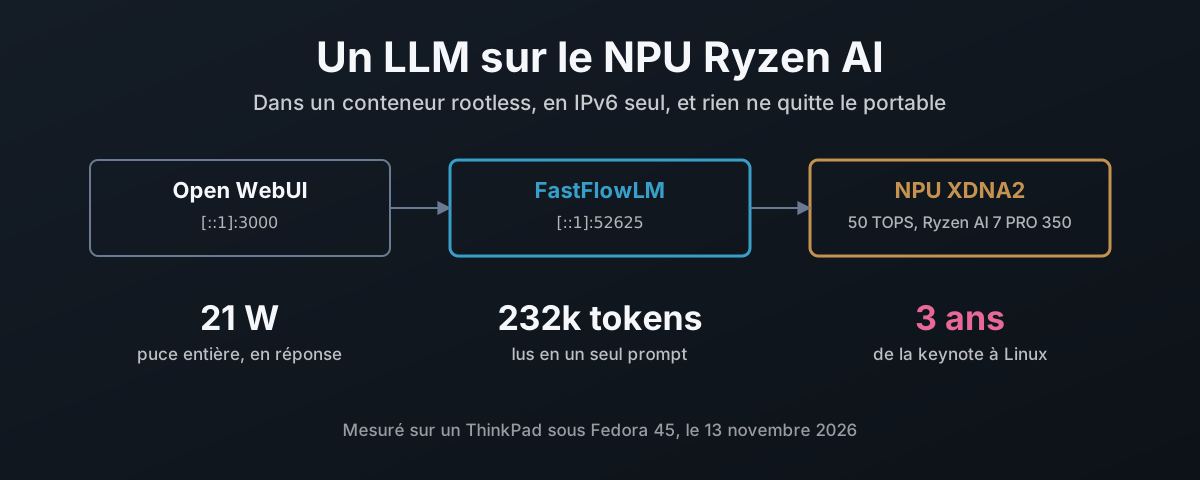
Le NPU d’un portable Ryzen AI, ce sont 50 TOPS qui dorment sur la plupart des installations Linux. Ce billet montre comment compiler le pilote amdxdna d’AMD en ne gardant que le module noyau sur l’hôte, compiler FastFlowLM avec le runtime XRT d’AMD dans un conteneur podman rootless accordé à ce pilote, tout lier au loopback IPv6 et le lancer au démarrage avec Quadlet. Puis ce que ça donne : neuf modèles mesurés, un test de contexte à 232 000 tokens, la transcription vocale Whisper à dix fois le temps réel, Open WebUI et les 7 000 tokens cachés qu’il ajoutait à chaque message, et la vitesse et l’énergie du NPU mesurées face à llama.cpp sur l’iGPU Radeon 860M. Pour finir, la chronologie : trois ans entre l’annonce de Ryzen AI par AMD et un modèle de langage sur son NPU sous Linux, livré par un projet qu’AMD n’a pas lancé, pendant que l’effort partait vers Copilot+ sur le Fisher-Price OS (Windows) au lieu du data centre et des outils Linux dont se servent vraiment les professionnels de l’IA.