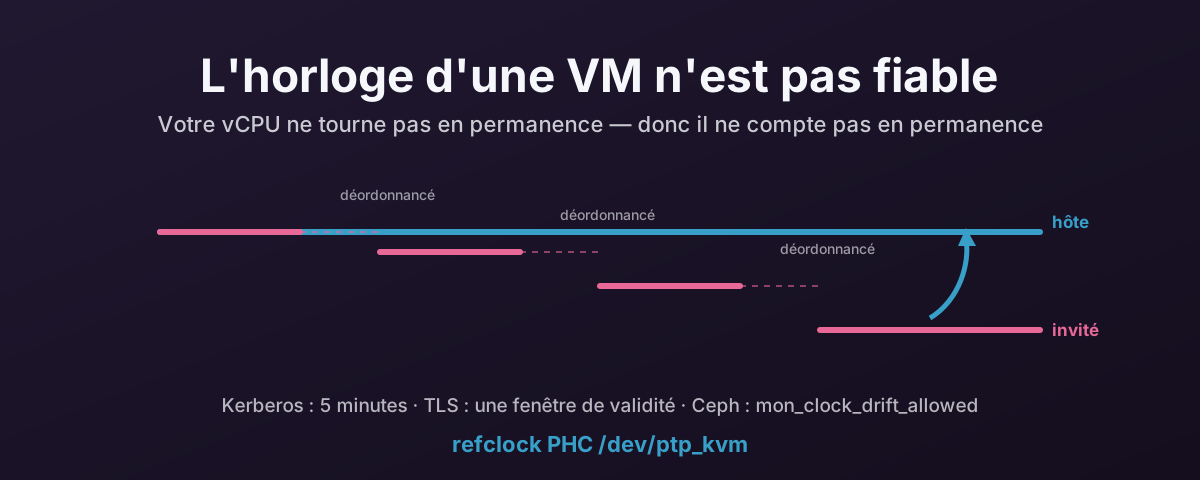
L’hypothèse que fait toute horloge
L’horloge d’un ordinateur fonctionne en comptant quelque chose de régulier et en faisant confiance au fait que ça continue de compter. Un quartz oscille, un compteur s’incrémente, et le logiciel calcule combien de temps a passé.
La virtualisation casse la partie confiance.
La documentation KVM du noyau sur la mesure du temps résume le problème en une phrase : « the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption » — le système d’exploitation virtuel ne tourne pas avec 100 % du CPU, alors qu’il peut très bien le supposer. Tout ce qui suit découle de là.
Votre vCPU ne tourne pas en permanence
Un vCPU est un thread sur l’hôte. Il tourne quand l’ordonnanceur de l’hôte le décide.
Quand il ne tourne pas, l’invité n’est pas simplement inactif — il est absent. Il ne peut pas compter, il ne peut pas traiter une interruption de timer, et il n’a aucun moyen de savoir combien de temps il est resté parti. L’hôte comptabilise ça comme du steal time, ce qui est le nom honnête pour « du temps qui vous est arrivé au lieu de vous servir ».
Les interruptions de timer sont l’endroit où ça fait le plus mal. Un invité qui demande un tick périodique demande à l’hôte de délivrer des interruptions à cadence fixe, et l’hôte ne peut pas toujours s’exécuter. Encore la documentation du noyau : « the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind » — le moteur de virtualisation de l’hôte peut ne pas délivrer le bon nombre d’interruptions par seconde, et l’heure de l’invité prend alors du retard.
Plus la cadence de tick est élevée, pire c’est, et un hôte surengagé aggrave encore les choses. C’est aussi pour ça qu’un hôte chargé dégrade l’heure d’invités tranquilles. Ils font tous la queue pour les mêmes cœurs physiques.
Les compteurs ne sont pas à vous non plus
Si les ticks périodiques ne sont pas fiables, la réponse évidente est de lire un compteur à la place. Ça pose d’autres problèmes.
Le TSC est le rapide, et la documentation du noyau est franche à son sujet : « The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times » — le TSC est une horloge locale au CPU dans la plupart des implémentations, et les TSC de CPU différents peuvent démarrer à des moments différents. Sa cadence peut varier avec les états d’énergie du processeur, et sur les pièces anciennes il s’arrête complètement quand le cœur se met au repos. Un vCPU qui migre d’un cœur physique à un autre peut donc lire un compteur en désaccord avec celui qu’il lisait une microseconde plus tôt.
Les solutions de rechange sont mauvaises autrement. Le HPET, le PIT et le timer ACPI PM sont tous des équipements émulés, donc chaque lecture est un piège vers l’hyperviseur. Correct, et assez coûteux pour qu’un invité qui lit l’horloge dans une boucle serrée s’en aperçoive.
C’est pour ça que les horloges paravirtuelles existent. Sur KVM, kvm-clock laisse l’hôte publier sa propre mesure du temps dans une structure partagée que l’invité lit directement : pas de piège, pas de comptage, aucune hypothèse sur le fait que l’invité était éveillé.
C’est aussi pour ça qu’il faut laisser la clocksource de l’invité tranquille au lieu de forcer tsc ou hpet parce qu’un message de forum disait que c’était plus rapide.
Migration, instantanés et suspension
La migration à chaud, la restauration d’instantané et la suspension/reprise font toutes la même chose à l’horloge d’un invité : elles l’arrêtent, puis la redémarrent ailleurs.
Ce que l’invité voit n’est pas une dérive, c’est un saut. L’horloge valait une chose, et maintenant elle en vaut une autre, avec rien entre les deux. Migrer vers un hôte dont le TSC tourne à une autre fréquence aggrave le tout.
Les sauts comptent parce que les logiciels qui corrigent les horloges sont faits pour corriger une dérive, pas une téléportation.
Ce n’est pas un problème propre à KVM
Il est tentant de lire tout ce qui précède comme une faiblesse de KVM. Ce n’en est pas une.
Tous les hyperviseurs livrent une horloge paravirtuelle, parce que tous les hyperviseurs ont le même problème de structure : KVM a kvm-clock, Hyper-V a sa page TSC de référence, VMware a un compteur de performance factice plus une synchro par les Tools, Xen a sa pvclock. Ce sont quatre implémentations indépendantes d’un seul contournement.
La conclusion de la documentation du noyau elle-même, c’est qu’il n’existe pas de solution parfaite ici. Seulement des compromis entre précision, performance et complexité.
Si vous préférez l’entendre d’un éditeur plutôt que de développeurs noyau, la limite de support de Microsoft pour l’heure de haute précision est remarquablement franche. Pour revendiquer une précision de 50 ms sur un système Windows virtualisé, l’une des exigences énoncées est que « the one-day average CPU utilization of the host must not exceed 90% » — l’utilisation CPU moyenne de l’hôte sur une journée ne doit pas dépasser 90 %. Pour 1 ms, l’hôte doit rester sous les 80 %.
Relisez ça : la précision de l’horloge de l’invité est documentée comme conditionnée par la charge de l’hôte. Ce n’est pas une bizarrerie Windows, c’est la même physique que celle décrite par la doc du noyau, couchée par écrit comme une limite de support.
Pourquoi NTP dans l’invité est le mauvais outil
NTP est bon à ce pour quoi il a été conçu : une machine avec un vrai oscillateur qui avance ou retarde un peu, corrigée en mesurant l’aller-retour vers un serveur distant et en tirant doucement l’horloge locale.
Chacune de ces hypothèses est fragile dans une VM.
L’oscillateur local n’est pas légèrement faux, il est par intermittence absent. La mesure de l’aller-retour est prise par un processus qui peut être déordonnancé entre la lecture de l’horloge et l’envoi du paquet, ce qui corrompt la mesure elle-même. Et les corrections nécessaires après une migration sont des sauts, qu’un algorithme de correction progressive gère mal ou refuse tout court.
chrony s’en sort bien mieux que ntpd ici. Il corrige plus vite, tolère les sauts, et il est honnête sur sa propre incertitude. Mais il résout quand même le mauvais problème : tirer l’heure à travers un réseau depuis un serveur de strate 2 à 20 ms de là, alors que l’heure correcte est posée dans l’hyperviseur, de l’autre côté d’une simple frontière mémoire.
Ce que vous obtenez en pratique, c’est un invité à peu près juste, occasionnellement à des dizaines ou des centaines de millisecondes, et jamais capable de vous dire lequel des deux.
Ce que le décalage casse vraiment
Personne ne s’intéresse aux horloges pour elles-mêmes. On s’y intéresse quand quelque chose cesse de marcher.
Kerberos et Active Directory
Kerberos dépend du temps par conception, parce que la validité d’un ticket s’exprime comme une fenêtre temporelle.
La documentation du krb5.conf du MIT définit clockskew comme « the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid » — le décalage maximal en secondes que la bibliothèque tolérera avant de considérer qu’un message Kerberos est invalide, et la valeur par défaut est de 300 secondes, soit cinq minutes.
Franchissez ça et l’authentification ne se dégrade pas, elle échoue.
Comme l’authentification Active Directory est du Kerberos, ça veut dire les ouvertures de session du domaine, net use, les connexions SQL Server, Exchange, les partages de fichiers — le lot.
Cinq minutes semblent généreuses jusqu’à ce qu’un invité recule après une restauration d’instantané.
TLS
Un certificat porte une fenêtre de validité : notBefore et notAfter.
Un invité dont l’horloge retarde rejettera un certificat émis ce matin parce que, pour ce qu’il en sait, le certificat n’est pas encore valide.
Un invité dont l’horloge avance en rejettera un qui n’a en réalité pas expiré.
La même arithmétique gouverne la fraîcheur OCSP et CRL, les revendications nbf/exp des JWT, et les codes TOTP de l’authentification multifacteur, qui vivent dans des fenêtres de 30 secondes.
Une horloge décalée de 45 secondes est une panne d’authentification avec un message d’erreur très déroutant.
Ceph
Les moniteurs Ceph tiennent à ça plus qu’à presque tout le reste de la pile, parce que leur consensus en dépend.
Le contrôle de santé MON_CLOCK_SKEW se déclenche quand « the clocks on hosts running Ceph Monitor daemons are not well-synchronized » — les horloges des hôtes qui font tourner des démons Ceph Monitor ne sont pas bien synchronisées. Précisément, quand le décalage dépasse mon_clock_drift_allowed.
Le conseil de la documentation est de se synchroniser avec ntpd ou chrony sur plusieurs sources, et elle note que la synchronisation entre moniteurs compte particulièrement.
Vous pouvez augmenter mon_clock_drift_allowed, mais la doc est claire : ça doit rester « significantly below the mon_lease interval » — nettement en dessous de l’intervalle mon_lease. À ce titre, c’est un petit budget, et le dépenser pour masquer un problème de mesure du temps de l’hyperviseur n’est pas un bon marché.
Tout le reste
Les journaux de plusieurs hôtes cessent de se corréler, ce qui transforme la chronologie d’un incident en devinette. La réplication de bases de données et le consensus distribué — etcd, Galera, tout ce qui fait des baux de leader — deviennent grincheux. Les fenêtres de sauvegarde et de supervision glissent hors alignement avec la chose qu’elles étaient censées observer.
Les invités Windows se décalent autrement
Windows mérite sa propre note, parce que son service de temps a été bâti avec d’autres objectifs et ça se voit.
Microsoft dit tout net que les versions antérieures à Windows 10 1607 / Server 2016 « can’t guarantee highly accurate time » — ne peuvent pas garantir une heure de haute précision. Ce que le service de temps Windows fournissait sur ces versions, c’était « the necessary time accuracy to satisfy Kerberos version 5 authentication requirements » — la précision nécessaire pour satisfaire les exigences d’authentification de Kerberos version 5, et une heure « loosely accurate », vaguement juste, pour les machines d’une même forêt AD. Plus serré que ça était « outside of the design specification… and weren’t supported » — hors de la spécification de conception, et non supporté.
Autrement dit, les Windows anciens visent à rester dans la fenêtre Kerberos de cinq minutes, pas à être justes. Ce qui va très bien jusqu’à ce que quelque chose dans votre parc ait besoin de mieux. Une machine Windows virtualisée décalée de 90 secondes s’authentifiera sans broncher tout en écrivant des journaux qui ne peuvent être corrélés avec rien.
Windows 10 et Server 2016 et au-delà savent faire 1 s, 50 ms ou même 1 ms — mais seulement dans les conditions citées plus haut, y compris les limites d’utilisation CPU de l’hôte. Microsoft note aussi que « anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy » — tout ce qui introduit une asymétrie réseau, comme une liaison satellite unidirectionnelle ou une forte charge CPU sur le système cible, nuira à la précision. Un vCPU en concurrence, c’est une forte charge CPU sur le système cible sous un autre nom.
Il n’y a pas de ptp_kvm pour Windows. Ce dont vous disposez à la place :
- Les enlightenments d’horloge Hyper-V. Proxmox les expose déjà aux invités Windows.
PVE::QemuServer::CPUConfigposehv_timeà côté dehv_vapic,hv_spinlocks,hv_relaxedethv_synic.hv_timeest l’horloge paravirtuelle, et c’est l’équivalent côté Windows dekvm-clock. C’est actif par défaut pour les VM typées Windows ; il n’y a rien à activer. - L’agent invité QEMU. Avec l’agent installé, l’hôte peut pousser son heure dans l’invité après une reprise ou une restauration d’instantané, ce qui traite le cas du saut, celui que NTP gère le plus mal.
- Choisissez une seule autorité. L’échec classique de Windows en VM, c’est deux sources de temps qui se battent : la synchro hôte vers invité et la synchro par la hiérarchie du domaine, toutes deux à corriger la même horloge en sens contraire. Pour un invité joint au domaine, laissez la hiérarchie du domaine gagner et arrêtez de lui pousser l’heure depuis l’hôte. Pour un invité autonome, la synchro par l’hôte convient. Jamais les deux.
Si vous voulez savoir exactement ce que votre hyperviseur raconte à une VM donnée au sujet du temps, demandez-le-lui au lieu de deviner :
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
Le correctif sur QEMU/KVM : ptp_kvm
Pour les invités Linux sur KVM il existe une vraie réponse, et ce n’est pas « plus de serveurs NTP ».
ptp_kvm laisse l’invité demander l’heure à l’hôte, directement, par un hypercall — KVM_HC_CLOCK_PAIRING sur x86, et un appel firmware équivalent sur arm64.
Le noyau présente ça comme un équipement d’horloge matérielle PTP, donc depuis l’espace utilisateur ça ressemble à n’importe quelle autre source d’horloge de précision, et chrony peut s’en servir comme horloge de référence.
Les propriétés qui comptent :
- Pas de réseau. Pas de gigue, pas d’asymétrie, pas de strate, pas de paquets. Le chemin est une frontière mémoire.
- Sous la microseconde. La précision est bornée par l’hypercall, pas par un aller-retour à travers un centre de données.
- Ça contourne la partie cassée. L’invité ne compte rien et n’estime aucun aller-retour. Il lit une valeur que l’hôte a calculée avec une horloge qui, elle, tournait tout du long.
Mise en œuvre
Appliquez ceci à toutes les VM Linux qui ont le pilote. L’hyperviseur hôte a besoin d’un NTP ou d’un PTP qui marche, de son côté. ptp_kvm remet à l’invité l’heure de l’hôte, donc il hérite de l’erreur de l’hôte.
1. Charger le module noyau au démarrage.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Lui donner un nom stable et laisser chrony le lire.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
Le lien symbolique compte parce que la numérotation des équipements PTP n’est pas stable. /dev/ptp0 peut être l’horloge d’une NIC à un démarrage et l’horloge KVM au suivant. Filtrer sur clock_name attrape la bonne à chaque fois.
3. Pointer chrony dessus, et retirer les pools.
Éditez /etc/chrony/chrony.conf sur Debian et Ubuntu, ou /etc/chrony.conf sur la famille RHEL. Supprimez les lignes pool et mettez :
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Retirer les pools n’est pas du rangement facultatif. Les laisser demande à chrony de réconcilier une référence locale sous la microseconde avec des serveurs Internet à des dizaines de millisecondes, et les sources Internet ne peuvent que rendre la réponse pire.
4. Redémarrer et vérifier.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Vérification
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
Dans chronyc sources, la refclock PHC apparaît comme #* PHC0 une fois sélectionnée. Le # marque une référence matérielle locale plutôt qu’un pair réseau, et le * marque celle qui est en service.
Si vous la voyez listée mais pas sélectionnée, chrony ne l’a pas acceptée : vérifiez les permissions sur l’équipement et que le groupe chrony de la règle udev correspond à l’utilisateur sous lequel chrony tourne réellement sur votre distribution.
Réserves
- L’hôte doit être juste. Ceci met l’invité d’accord avec l’hôte, ce qui n’est utile que si l’hôte est d’accord avec la réalité. Donnez aux hyperviseurs du vrai NTP ou PTP.
- Il faut le mettre sur tous les invités. Un parc où la moitié des VM utilisent
ptp_kvmet l’autre moitié des pools Internet est un parc à deux autorités de temps. - La migration à chaud passe très bien, et c’est tout l’intérêt. Après migration, l’invité lit l’horloge de son nouvel hôte. Pourvu que les hôtes soient d’accord entre eux, l’invité ne voit jamais de saut.
- KVM seulement. C’est un hypercall KVM. Les hyperviseurs imbriqués ou étrangers ne présenteront pas l’équipement, et la règle udev ne se déclenchera tout simplement pas. C’est un échec propre plutôt qu’une mauvaise réponse silencieuse.
Ce qu’il ne faut pas faire
- Ne forcez pas la clocksource. Laissez
kvm-clocktranquille. Forcertscouhpetsur la ligne de commande noyau de l’invité échange une horloge paravirtuelle conçue pour cette situation contre un compteur qui n’a jamais été à vous. - Ne lancez pas
ntpdateouhwclockdepuis cron. C’est un saut d’horloge à heure fixe, exactement ce que détestent les bases de données et Kerberos. - Ne gardez pas les pools « en secours ». Avec une refclock qui marche, ce ne sont pas un secours, c’est un deuxième avis venu d’une source moins bonne.
- N’augmentez pas
mon_clock_drift_alloweden croyant avoir corrigé. Vous avez dépensé une part d’un budget qui existe pour la réalité du réseau, afin de tolérer un problème dont la solution est connue.
Ce dernier point mérite d’être dit franchement : élargir le seuil ne répare pas l’horloge. Ça déplace l’alarme pour qu’elle arrête de sonner.
Références
- Linux kernel — KVM timekeeping — pourquoi l’heure de l’invité prend du retard, le problème d’horloge locale du TSC, et la conclusion qu’il n’existe que des compromis
- Linux kernel — PTP_KVM — l’interface d’hypercall derrière l’équipement d’horloge PTP
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, le côté x86 de la chose - chrony — chrony.conf — la directive
refclocket les options du pilote PHC - MIT Kerberos — krb5.conf —
clockskewet sa valeur par défaut de 300 secondes - Microsoft — support boundary for high accuracy time — les cibles de précision, et les conditions d’utilisation CPU de l’hôte pour les systèmes virtualisés
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowedet sa relation avecmon_lease