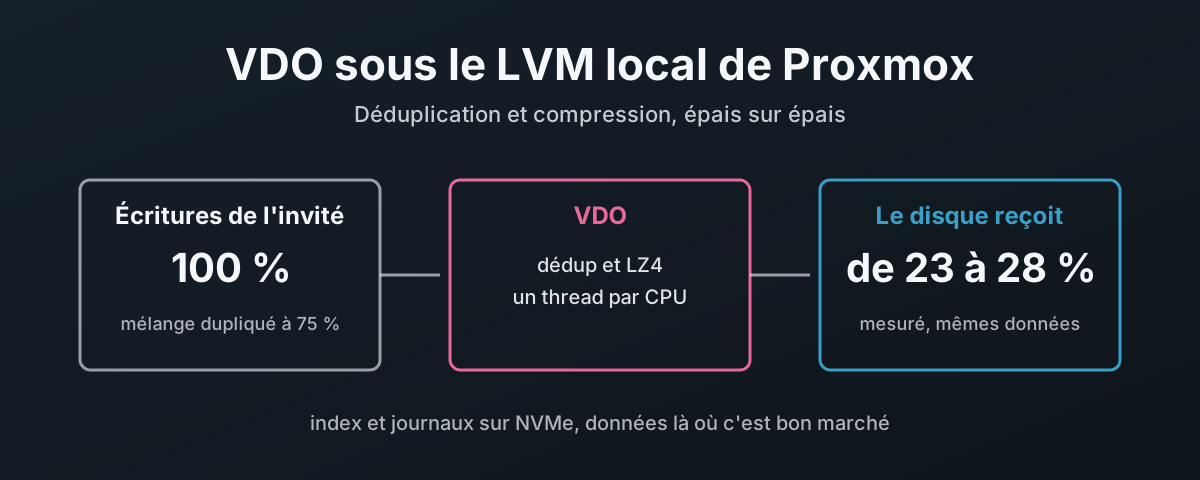
Moins d’octets atteignent le disque
VDO est la couche de déduplication et de compression du noyau Linux. Il se place sous un groupe de volumes et travaille par blocs de 4 Kio. Tout bloc qu’il a déjà vu, il ne le stocke qu’une fois.
Pour le matériel, la conséquence est simple. Moins d’octets atteignent le disque. J’ai écrit à travers VDO un mélange dupliqué à 75 % et compressible à 50 %, 30 secondes à chaque fois, et les compteurs du disque lui-même disaient qu’il avait reçu de 23 à 28 % de ce que l’invité avait écrit. Six clones complets d’un disque de modèle ont ajouté 8 blocs de données à eux tous. Trente-deux kilo-octets.
Moins d’octets, c’est moins d’usure, et moins de travail pour tout cache sur le disque ou sur le contrôleur placé devant. Pour y arriver, il faut payer en CPU et en latence, et sur un disque rapide ce coût est mesuré plus bas face à la même Optane sans VDO du tout. Sur des disques à plateaux lents, ce même coût disparaît dans les temps de recherche, et c’est là que ça devient intéressant.
Deux règles guident tout ce qui suit. La pile est épaisse sur épaisse : rien au-dessus de VDO, ni VDO lui-même, ne peut promettre plus d’espace que n’en a le disque. Et les métadonnées de VDO, son index et ses journaux, peuvent vivre sur NVMe pendant que les données vivent sur quelque chose de plus lent.
Chaque chiffre ici vient d’un seul hôte Proxmox VE 9.2, un Ryzen 7 5700G avec 16 CPU, noyau 7.0.14-25-pve, LVM 2.03.31 et les outils vdo 8.3.1.1 de Debian, sur deux disques Intel Optane effacés ensuite.
Ce qu’est VDO et où il se place
Le noyau décrit dm-vdo comme une cible device-mapper qui « provides block-level deduplication, compression, and thin provisioning »1. Chaque bloc de 4 Kio entrant est haché. Si un bloc identique est déjà stocké, VDO enregistre une référence au lieu d’une copie. Les blocs qui ne sont pas des doublons passent par LZ4 et sont regroupés à plusieurs par bloc physique, et les blocs entièrement à zéro ne sont pas stockés du tout2.
LVM pilote l’ensemble.
lvcreate --type vdo crée un pool VDO, qui contient les blocs réels, et un LV VDO au-dessus, avec la taille virtuelle que vous lui demandez2.
Un groupe de volumes épais se place sur le LV VDO, et Proxmox l’utilise comme un stockage lvm ordinaire.
| Couche | Nom dans le labo | Ce qu’elle fait |
|---|---|---|
| Disques de VM | vm-9901-disk-0 et ainsi de suite | LV épais, créés par Proxmox |
| Groupe de volumes | vdovg, 35 Gio | LVM simple, ce que lit le stockage lvm de Proxmox |
| LV VDO | vdolab/vdolv, 35 Gio virtuels | déduplication, LZ4, blocs à zéro écartés |
| Pool VDO | vdolab/vdopool, 40 Gio | les blocs réels, les métadonnées et l’index de VDO |
| Physique | nvme8n1 | VG vdolab |
Épais sur épais, ou rien
VDO est un provisionneur fin à part entière : le LV VDO peut recevoir n’importe quelle taille virtuelle. Faites-le plus grand que ce que le pool peut contenir, et le groupe de volumes au-dessus est épais sur une promesse, c’est-à-dire du fin sur fin descendu d’une couche. C’est exactement ce que j’ai fait au premier montage, un LV VDO de 120 Gio sur un pool de 40 Gio, et Proxmox affichait un tiers du stockage libre pendant que VDO était plein.
Dimensionnez donc le LV VDO à ce que le pool peut réellement adresser, pas plus.
lvcreate affiche ce chiffre, « can address 36.00 GB » sur ce pool de 40 Gio, et la block map de VDO pour l’espace logique est prise sur la même place, alors je lui ai donné 35 Gio.
Puis je l’ai prouvé à la dure. Un seul disque de VM prenant chaque extent que Proxmox voulait bien donner, 34 Gio, rempli de bout en bout de données aléatoires dont VDO ne peut rien faire :
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
Le disque s’est arrêté à sa propre fin, comme doit le faire un disque épais. VDO avait encore 1,9 Gio de libre, plus que le 1 Gio qu’il restait à Proxmox à allouer. Le chiffre de Proxmox est la vraie limite, et VDO ne peut pas manquer de place le premier.
Ce que vous abandonnez, c’est la surallocation : l’espace que la déduplication économise apparaît comme du disque jamais écrit, pas comme des disques supplémentaires pour Proxmox. C’est le bon compromis pour ce billet, qui parle du matériel. Et n’y mettez pas non plus de pool lvmthin. Deux couches fines, ce sont deux comptabilités3.
Ce qu’il coûte avant de stocker un octet
VDO tient un index de déduplication, l’index UDS, sur le pool lui-même.
Un pool vide de 40 Gio affichait 4,0 Gio utilisés et 36,0 Gio disponibles.
vdolistmetadata, du même paquet vdo, liste chaque bloc de métadonnées du périphérique, et explique presque tout :
| Région | Blocs de 4 Kio | Taille |
|---|---|---|
| Index UDS | 679 127 | 2,59 Gio |
| Journal de récupération | 32 768 | 128 Mio |
| Compteurs de références et journaux, 18 slabs | 6 372 | 25 Mio |
| Espace trop petit pour un dix-neuvième slab | 336 555 | 1,28 Gio |
| Total | environ 4,0 Gio |
La ligne du reste mérite d’être connue : les slabs font 2 Gio, alors dimensionnez le pool en slabs entiers plus le surcoût, ou le reste est tout simplement inutilisé.
La RAM est l’autre facture. Elle se paie que le pool soit occupé ou au repos :
| Coût | Règle de lvmvdo(7) | Ce pool de 40 Gio |
|---|---|---|
| Fixe | 38 Mio | 38 Mio |
| Cache de la block map | 1,15 Mio par Mio de cache, 150 Mio minimum | 150 Mio (128 Mio par défaut) |
| Espace physique | 268 Mio par Tio | 11 Mio |
| Index UDS (dense) | 250 Mio minimum, le défaut | 256 Mio |
| Total | environ 455 Mio |
L’index dense par défaut couvre une fenêtre de déduplication d’environ 256 Gio, puisqu’un index dense avec 1 Gio de RAM « maintains a 1 TiB deduplication window »2. Le cache de block map de 128 Mio est dimensionné pour « efficient access to 100 GB of logical space at a time », et la documentation du noyau en fait la valeur la plus importante à ajuster quand l’ensemble de travail grandit1.
Monter la pile
Laisser LVM voir un PV sur un LV
Le groupe de volumes repose sur un LV, et par défaut LVM ignore les LV comme volumes physiques.
devices/scan_lvs active cela, et la référence de LVM porte l’avertissement qui va avec : « Caution is required to avoid using PVs that belong to guest images stored on LVs »4.
Sans cela, un invité qui utilise LVM dans son propre disque verrait ses groupes de volumes apparaître sur l’hôte.
Le filtre change donc aussi. Même modification. Le filtre d’origine de cet hôte ne rejetait que les zvols ZFS et les périphériques RBD. J’ai ajouté un rejet pour chaque disque de VM Proxmox :
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
La même référence dit que scan_lvs « does not enable autoactivation of layered VGs »4.
Proxmox n’en a pas besoin. Son plugin LVM active chaque disque avec lvchange -aey au démarrage de la VM5.
Je l’ai testé dans l’état où un démarrage laisse les choses, tout désactivé puis les mêmes exécutions udev de pvscan : le VG sous VDO est remonté, et qm start a activé lui-même le disque de la VM.
Le piège est en dessous. Avec le VG sous VDO incomplet, le même qm start a échoué avec Volume group "vdovg" not found.
Le pool VDO, épais, avec ses réglages sur la ligne de création
Le formateur est dans le paquet vdo de Debian6 :
# apt install vdo
Ensuite le pool.
-L est l’espace réel, -V la taille virtuelle, gardée dans ce que le pool peut adresser.
La répartition des threads et la taille de discard vont sur la même ligne, parce qu’on ne peut changer ni l’une ni l’autre ensuite sans arrêter toutes les VM du pool :
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
La répartition des threads est celle mesurée plus bas pour un hôte à 16 CPU ; max_discard=4096 a sa propre section.
Le groupe de volumes et le stockage Proxmox
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 compte, et c’est expliqué plus bas.
Ce que la déduplication a économisé
J’ai écrit des choses qu’un hôte Proxmox stocke réellement et lu les compteurs de blocs de VDO après chacune.
logical blocks used est ce que les couches du dessus ont écrit ; data blocks used est ce que VDO a stocké. Les deux comptent des blocs de 4 Kio.
| Ce qui a été écrit | Blocs logiques ajoutés | Blocs de données ajoutés | Économisé |
|---|---|---|---|
| rootfs Rocky Linux 10, ext4 sur un disque de 4 Gio | 114 505 | 60 537 | 47 % |
Six clones complets de celui-ci (qm clone --full, environ 4 s chacun) | 6 291 456 | 8 | 99,9999 % |
| ISO Proxmox Datacenter Manager 1.1, 1,36 Gio | 356 172 | 351 965 | 1,2 % |
Sa reconstruction -auto, à peu près les mêmes octets | 356 399 | 40 | 99,99 % |
| 4 Gio de zéros | 1 048 575 | 0 | 100 % |
| 1 Gio de données aléatoires | 262 143 | 262 144 | 0 % |
Chaque clone a écrit les 4 Gio, zéros compris, parce qu’un clone complet sur un LV épais copie chaque bloc. VDO a stocké les zéros comme rien et le reste comme des références.
VDO est excellent sur les données qu’il a déjà vues. Et sur le rien du tout. Il ne sert à rien sur des données déjà compressées ou chiffrées, et c’est pourquoi le premier ISO, surtout du squashfs, n’a économisé que 1,2 %.
Avec le modèle et ses six clones en place, Proxmox affichait le stockage utilisé à 80,01 %, 28 Gio de disques épais sur 35. Le disque contenait 4,3 Gio, et l’essentiel était l’index. Sur un stockage épais, c’est tout l’intérêt : Proxmox compte ce qui a été alloué, et le disque porte ce qui est réellement différent.
Ce que le disque reçoit vraiment
Les économies sur disque sont un instantané. Le matériel, lui, se soucie du flux.
J’ai donc mesuré les octets qui atteignaient le disque pendant l’écriture : fio pendant 30 secondes, le compteur d’écriture du disque dans /sys/block avant et après, la même Optane avec et sans VDO, deux fois chacune.
Le compteur est honnête. Sur l’ensemble des essais, il totalisait 794 Go, et le « Data Units Written » SMART du disque lui-même a bougé de 794 Go aussi.
| Charge, 30 s | Sans VDO | Avec VDO, 16 threads | Octets qui atteignent le disque |
|---|---|---|---|
| Écriture aléatoire 4k, QD32, 4 jobs, 75 % dupliqué, 50 % compressible | 582 013 IOPS, p99 244 µs | 460 887 IOPS, p99 1,05 ms | 28 % |
| Écriture 128k, QD8, 75 % dupliqué, 50 % compressible | 2 345 Mio/s, p99 490 µs | 2 179 Mio/s, p99 1,02 ms | 23 % |
| Écriture aléatoire 4k, QD32, 4 jobs, données aléatoires | 571 721 IOPS | de 272 366 à 381 005 IOPS | de 59 à 100 % |
| Écriture 128k, QD8, données aléatoires | 2 346 Mio/s | de 1 051 à 1 854 Mio/s | 100 % |
Sur un mélange réaliste, VDO a conservé de 79 à 93 % du débit du disque nu et lui a envoyé un quart des octets. Sur des données entièrement aléatoires, il n’économise rien et coûte cher, et les deux passes divergeaient tellement que je ne donne que la fourchette.
La latence de queue, c’est le traitement de VDO lui-même, pas le disque. Un p99 d’environ une milliseconde, contre un quart de milliseconde à nu.
L’Optane n’a pas de cache à soulager
Ces disques le disent eux-mêmes : vwc 0 dans nvme id-ctrl, write through dans /sys/block.
Une Optane écrit sur place sans étage DRAM ni SLC, donc sur ce matériel le gain se mesure en octets et en usure, pas en cache de disque qui se remplit plus lentement.
Un SSD NAND avec un cache SLC, ou un contrôleur RAID avec un cache en write-back, c’est là que moins d’octets achète aussi de la réactivité. C’est la section RAID6 plus bas.
Caler les threads de VDO sur les CPU
D’origine, LVM donne dix threads à VDO : un logique, un physique, une zone de hachage, deux CPU, quatre de soumission bio, un d’acquittement. Sur un hôte à 16 CPU, cela laisse la majeure partie de la machine au repos pendant que le travail de block map de VDO fait la queue derrière un unique thread logique.
La documentation du noyau explique les réglages1. Les threads logiques possèdent chacun « a disjoint section of the block map », les threads physiques « a disjoint section of the data blocks », et les deux « can increase throughput », tandis que les threads en trop « can waste resources and increase contention ». Les threads logiques montent jusqu’à 60, les physiques jusqu’à 16, et le pool a besoin d’au moins un slab par thread physique. Avec 18 slabs, celui-ci a de la marge.
| Répartition | logical | physical | hash | cpu | bio | ack | Total |
|---|---|---|---|---|---|---|---|
| Défauts de LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Calée sur 16 CPU | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Le double | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Chaque répartition a passé les mêmes tâches fio deux fois, en alternance, avec des données aléatoires, plus la lecture simultanée des sept disques clones, comme sept VM qui démarrent ensemble :
| Test, moyenne de deux passes | Défauts | Calée sur 16 CPU | Le double |
|---|---|---|---|
| Écriture aléatoire 4k, QD32, 4 jobs | 292 466 IOPS | 365 314 IOPS | 302 461 IOPS |
| p99 écriture aléatoire 4k, 4 jobs | de 2,1 à 3,7 ms | de 1,5 à 1,6 ms | de 2,1 à 2,2 ms |
| Écriture séquentielle 1M | 1 153 Mio/s | 1 729 Mio/s | 1 507 Mio/s |
| Lecture aléatoire 4k, QD32, 4 jobs | 507 450 IOPS | 503 827 IOPS | 485 263 IOPS |
| Sept disques clones lus en même temps | 7,5 s | 3,1 s | 3,4 s |
Calée sur le nombre de CPU, la répartition gagne presque tout : un quart d’écritures parallèles en plus, moitié plus en écriture séquentielle, sept disques lus 2,4 fois plus vite, et une queue plus serrée. Doubler encore est pire sur toute la ligne. C’est la contention contre laquelle la documentation met en garde. Les défauts étaient aussi les moins stables, la lecture des sept disques variant de 6,1 à 8,8 s d’une passe à l’autre.
Du coup, la règle est un thread VDO par CPU, réparti entre les types comme ci-dessus, avec les threads physiques plafonnés par le nombre de slabs.
Ce que VDO coûte sur du matériel rapide
La même Optane sans VDO, face à VDO avec ses threads calés, données aléatoires, moyenne de deux passes :
| Test | Optane, sans VDO | VDO, 16 threads |
|---|---|---|
| Écriture aléatoire 4k, QD1 | 42 294 IOPS, 19,4 µs | 55 806 IOPS, 12,1 µs |
| Écriture aléatoire 4k, QD32 | 142 416 IOPS | 144 292 IOPS |
| Écriture aléatoire 4k, QD32, 4 jobs | 572 293 IOPS | 365 314 IOPS |
| Lecture aléatoire 4k, QD1 | 55 276 IOPS, 14,4 µs | 27 988 IOPS, 31,4 µs |
| Lecture aléatoire 4k, QD32, 4 jobs | 586 463 IOPS | 503 827 IOPS |
| Écriture séquentielle 1M, QD8 | 2 348 Mio/s | 1 729 Mio/s |
| Sept disques de modèle lus en même temps | 11,1 s | 3,1 s |
Lisez-le franchement. Une lecture aléatoire isolée prend plus de deux fois plus de temps à travers VDO. Les écritures aléatoires parallèles perdent plus d’un tiers, les écritures séquentielles un quart. Sur un disque aussi rapide, les 17 µs de travail supplémentaire de VDO par lecture font l’essentiel de la lecture.
L’écriture en QD1 plus rapide à travers VDO n’est pas un cadeau. Loin de là. VDO acquitte une écriture avant qu’elle soit sur le disque, et la documentation du noyau dit clairement que « unflushed writes may or may not persist after a crash »1. Ce chiffre mesure un acquittement. Un invité qui fait des flush, comme tout système de fichiers, obtient la durabilité qu’il demande.
La ligne des sept disques est celle que VDO gagne haut la main, et il vaut la peine de dire clairement pourquoi. Sept copies simples doivent lire 28 Gio d’octets réels, zéros compris. VDO lit un seul jeu de blocs partagés et saute les zéros.
Sur de la flash rapide, VDO échange donc de la latence contre des octets. Chacune de ces microsecondes est un coût fixe, cela dit, et il ne grandit pas quand le disque en dessous devient plus lent.
Mettre les métadonnées de VDO sur NVMe
VDO n’a pas de périphérique de métadonnées séparé. Tout vit sur l’unique LV du pool. Mais le code source de dm-vdo montre que la disposition est fixe, et un LV peut être construit à partir de morceaux sur différents disques.
Le code de formatage place les racines de la block map depuis le début de la région de données, puis le résumé des slabs et le journal de récupération depuis la fin, et remplit le milieu de slabs7.
L’index UDS se trouve avant tout cela, juste après le bloc de géométrie.
vdolistmetadata l’a confirmé sur le pool du labo :
| Blocs | Quoi | Où |
|---|---|---|
| de 0 à 679 188 | géométrie, index UDS, super bloc, racines de la block map | les 2,59 premiers Gio |
| dans chaque slab de 2 Gio | données, feuilles de la block map, 130 blocs de références et un journal de slab de 224 blocs | répartis dans tout le pool |
| de 10 452 928 à 10 485 695 | journal de récupération | les 128 derniers Mio, à peu près |
| de 10 485 696 à 10 485 759 | résumé des slabs | les tout derniers 256 Kio |
Construisez donc le LV du pool en trois morceaux : la tête sur NVMe, le milieu sur le disque lent, la queue sur NVMe.
Convertissez-le ensuite en pool VDO, ce que lvmvdo(7) documente pour un LV existant2.
Ici, nvme6n1 tient le rôle du NVMe et nvme8n1 celui du disque lent :
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Vérifiez ensuite que VDO a mis ses métadonnées là où sont les extents :
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Un extent fait 1 024 blocs. La tête NVMe correspond aux extents 0 à 767, blocs 0 à 786 431, ce qui couvre l’index et les racines, avec environ 420 Mio des données du premier slab embarqués au passage. La queue NVMe correspond aux extents 10 176 à 10 239, blocs 10 420 224 et suivants, ce qui couvre le journal de récupération et le résumé des slabs.
Quelle part du travail de VDO se déplace avec elles, par passe de 30 secondes, compté par périphérique :
| Charge | I/O d’écriture NVMe | I/O d’écriture disque de données | Part du NVMe |
|---|---|---|---|
| Écriture aléatoire 4k, 75 % dupliqué, 50 % compressible | de 388 430 à 538 223 | de 3,42 à 3,63 millions | de 10 à 13 % |
| Écriture 128k, 75 % dupliqué, 50 % compressible | de 458 214 à 634 167 | de 3,30 à 3,53 millions | de 12 à 15 % |
| Écriture aléatoire 4k, données aléatoires | de 181 457 à 384 507 | de 3,25 à 8,49 millions | de 4 à 5 % |
| Lecture aléatoire 4k | 0 écriture, 2 % des lectures | 0 |
À peu près un dixième des opérations d’écriture : le journal de récupération, les mises à jour de l’index, et cette tranche du slab 0 sur la tête NVMe. Ce sont de petites écritures de métadonnées éparpillées, le genre qu’un disque à plateaux gère le plus mal. Sur NVMe, elles ne sont rien.
Deux limites.
Les métadonnées propres à chaque slab, compteurs de références, journaux de slab et feuilles de la block map, vivent dans les slabs et restent avec les données.
Et je n’ai pas testé l’agrandissement d’un pool séparé. Le journal est placé depuis la fin, donc après tout lvextend, relancez vdolistmetadata et regardez où il est allé avant de lui faire confiance.
VDO sur bcache : un NVMe, deux rôles
bcache est l’autre façon de mettre de la flash devant des disques lents. C’est ce que je fais déjà tourner sous Ceph sur des disques à plateaux, avec chaque réglage expliqué dans le billet sur bcache. La question est donc ce que VDO fait à un cache bcache quand il est posé dessus.
Un seul NVMe assure les deux rôles de flash, découpé en deux partitions :
| Périphérique | Taille | Rôle |
|---|---|---|
nvme8n1p1 | 32 Gio | cache bcache, writeback |
nvme8n1p2 | 8 Gio | tête et queue de VDO : index, racines, journal de récupération, résumé des slabs |
nvme6n1 | 349 Gio | périphérique de stockage de bcache, là où vivent les données |
/dev/bcache0 | 349 Gio | le milieu du pool VDO, les slabs |
Les deux disques sont encore des Optane, donc nvme6n1 tient le rôle du disque à plateaux.
Gardez-le en tête pour chaque chiffre ci-dessous. Le périphérique de stockage est rapide ici, donc ceci mesure ce qui atteint le cache, pas le temps qu’un disque à plateaux met à le vider.
Les partitions et le jeu de cache, avec les réglages de ce billet :
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Ces lignes echo tiennent jusqu’au prochain redémarrage. La règle udev du billet sur bcache est ce qui les rend permanentes.
Ensuite le pool, découpé comme plus haut, avec nvme8n1p2 pour les deux extrémités et bcache0 pour le milieu :
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata a affiché les mêmes plages de blocs que le montage séparé, donc l’index et les deux journaux sont sur nvme8n1p2.
vdovg et le stockage Proxmox se posent dessus exactement comme avant.
Ce qui atteint le cache
La comparaison oppose un LV de 8 Gio directement sur bcache0 à un LV de 8 Gio dans vdovg, les mêmes tâches fio pendant 30 secondes, deux fois, avec le cache vidé et propre entre chaque passe.
Les compteurs des périphériques dans /sys/class/block disent où sont allés les octets.
| 75 % dupliqué, 50 % compressible, 30 s | bcache seul | VDO sur bcache |
|---|---|---|
| Écriture aléatoire 4k, QD32, 4 jobs | 212 222 et 205 585 IOPS | 390 206 et 304 757 IOPS |
| p99 | 1,89 et 2,04 ms | 1,45 et 2,54 ms |
| Écrit par l’invité | 24,29 et 23,53 Gio | 44,67 et 34,88 Gio |
| Écrit dans le cache bcache | 25,00 et 24,26 Gio | 11,48 et 10,44 Gio |
| Écrit sur la partition de métadonnées de VDO | 1,18 et 0,59 Gio | |
| Écritures dans le cache par octet de l’invité | 103 % | 26 et 30 % |
| Restant sale dans le cache à la fin | 6,0 et 6,5 Gio | 5,5 et 5,2 Gio |
| Écriture 128k, QD8 | 2 001 et 1 985 Mio/s | 1 878 et 1 416 Mio/s |
| Écritures dans le cache par octet de l’invité, 128k | 101 % | 24 et 27 % |
bcache seul plafonnait à environ 210 000 petites écritures par seconde, et il écrivait chaque octet dans le cache plus 3 % des siens. Mettez VDO devant et le cache n’a reçu qu’un quart des octets. À la première passe, le même cache a alors porté 390 206 écritures par seconde, presque deux fois plus, et a quand même fini avec moins de données sales en attente pour le disque lent. Le cache était la limite. VDO l’a déplacée.
La seconde passe est la plus honnête pour un pool qui a déjà servi. Par défaut, fio initialise ses générateurs de la même façon à chaque passe8, donc la passe deux a écrit des données que l’index avait déjà vues, et qui pointaient vers des blocs entre-temps libérés par discard. VDO traite l’index comme des indices et lit chaque bloc candidat pour vérifier que c’est vraiment un doublon avant de le partager9. Pendant un test en écriture seule, cette seconde passe a relu 7,11 Gio depuis le cache et 1,20 Gio depuis le disque de données. La première avait lu 0,12 Gio. Un conseil périmé n’est pas gratuit, et sur un pool où les VM vont et viennent, il y en aura toujours un peu.
Les données aléatoires sont l’autre face :
| Données aléatoires, 30 s | bcache seul | VDO sur bcache |
|---|---|---|
| Écriture aléatoire 4k, QD32, 4 jobs | 205 984 et 203 066 IOPS | 203 186 et 85 882 IOPS |
| p99 | 2,04 et 2,15 ms | 5,7 et 17,7 ms |
| Écriture 128k, QD8 | 2 038 et 2 017 Mio/s | 878 et 357 Mio/s |
| Lecture aléatoire 4k, QD1 | 36 609 et 36 639 IOPS, 21,6 µs | 26 345 et 26 202 IOPS, 33,6 et 33,7 µs |
| Lecture aléatoire 4k, QD32, 4 jobs | 471 585 et 471 730 IOPS | 335 461 et 336 941 IOPS |
Rien à économiser, donc VDO n’est que du surcoût, et sur la passe à l’index périmé il a plus que divisé par deux les petites écritures. Toutes les lectures des deux colonnes venaient du cache. Les 12 µs que VDO ajoute par-dessus sont le même coût fixe qu’il ajoute sur l’Optane nue.
Là où les données se répètent, les deux s’empilent donc bien. Le cache reçoit un quart des octets, tient plus longtemps face à une rafale, et a moins à réécrire vers les disques à plateaux. Là où elles ne se répètent pas, bcache se porte mieux tout seul.
Sur du RAID6 matériel à disques durs : raisonné, pas mesuré
Je n’ai pas d’hôte RAID6 à disques durs pour tester, donc cette section est un raisonnement bâti sur les mesures ci-dessus. Mesurez votre propre grappe avant de vous y fier.
| Sur du RAID6 à disques durs | Ce que VDO change |
|---|---|
| Écritures qui atteignent la grappe | environ un quart, sur un mélange comme celui mesuré |
| Cache en write-back du contrôleur | se remplit à un quart du rythme, donc tient environ quatre fois plus longtemps face à une rafale |
| Coût CPU de VDO | 17 µs par lecture, perdues dans un temps de recherche de 5 à 10 ms |
| Écritures du journal de récupération | à peu près un dixième des I/O d’écriture, petites et forcées sur disque : mettez-les sur NVMe |
| Recherches dans l’index | surveillez dedupe advice timeouts dans vdostats ; sur un stockage lent, VDO peut renoncer à chercher et écrire le doublon quand même |
| Lire un clone du début à la fin | plus lent : ses blocs renvoient vers ceux du modèle, éparpillés sur la grappe |
Les deux premières lignes sont la réponse matérielle. Tant que le cache du contrôleur, sur batterie ou sur flash, a de la place, l’invité voit la latence du cache. Quand il est plein, l’invité voit les plateaux. Envoyez-lui un quart des octets et le même cache offre environ quatre fois plus de marge, et a quatre fois moins à vider. La section bcache plus haut, c’est cela mesuré avec un cache logiciel à la place de celui du contrôleur.
La troisième explique pourquoi VDO a davantage sa place sur des disques lents que sur des rapides. Sur l’Optane, VDO a doublé la latence de lecture. Sur des disques à 7 200 tr/min, le même coût fixe disparaît dans un seul temps de recherche.
Les trois dernières sont les coûts. Une tempête de démarrage de clones identiques va plus vite, mais un seul clone lu de bout en bout va plus lentement, parce que la déduplication l’éparpille. Et les petites écritures de VDO lui-même tombent aussi sur la grappe, ce qui plaide pour la disposition séparée vue plus haut : index et journal sur NVMe, slabs sur le RAID6.
Supprimer un disque : faites faire le discard à Proxmox
Supprimer un LV libère ses extents dans LVM. Cela ne dit pas à VDO que les blocs sont inutilisés, donc VDO les garde. La documentation du noyau dit pourquoi c’est important : « If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space »1. Sur un stockage épais, il ne peut pas manquer de place, mais des blocs non libérés restent de l’espace disque retenu pour des données qui n’appartiennent à personne.
L’option on-volume-remove discard=1 du stockage est la solution. Proxmox la décrit comme émettant des « discard (TRIM) requests before removal »5 :
| Suppression | Blocs VDO libérés |
|---|---|
stockage lvm simple, un disque contenant 1 Gio | 0 |
avec on-volume-remove discard=1, le même | 262 140, le Gio entier |
C’est lent sur un gros disque, en revanche.
Supprimer le disque de 34 Gio du test de remplissage a pris 262,6 s à Proxmox, alors que blkdiscard sur le même genre de données a traité 15 Gio en 2,25 s.
Pour tout ce qui est gros, faites donc un blkdiscard du disque d’abord, puis supprimez-le.
La taille de discard compte aussi. Le max_discard par défaut de VDO est d’un bloc de 4 Kio par requête1 :
| Discard de 15 Gio de données aléatoires | Durée | CPU (sys) |
|---|---|---|
max_discard=1, le défaut | 8,06 s | 8,06 s |
max_discard=4096, 16 Mio | 2,25 s | 0,00 s |
Dans les invités, activez l’option Discard du disque pour que leur TRIM atteigne le stockage10, et lancez fstrim à intervalles réguliers.
Là où il mérite sa place
| Convient | Ne convient pas |
|---|---|
| beaucoup de VM issues des mêmes quelques modèles | bases de données et travail lié à la latence en profondeur de file |
| RAID6 à disques durs derrière un cache de contrôleur en write-back | un hôte tout NVMe qui a besoin de chaque microseconde |
| données sur disques à plateaux avec un NVMe pour les métadonnées de VDO | données déjà compressées : médias, sauvegardes, ISO |
| bcache devant des données sur plateaux, là où les données se répètent | bcache devant des données qui ne se répètent pas |
| disques dont l’endurance en écriture est la limite | disques d’invités chiffrés, qui ne se dédupliquent jamais |
| un hôte avec un demi-gigaoctet de RAM libre par pool | un petit pool, où l’index mange un dixième |
| Réglage | Défaut | À régler sur | Modifiable ensuite |
|---|---|---|---|
Taille virtuelle de VDO -V | ce que vous demandez | pas plus que ce que le pool peut adresser | agrandir seulement, jamais réduire |
| Threads de VDO | 10, un logique | un par CPU, répartis comme ci-dessus | seulement avec les VM du pool arrêtées |
max_discard | 1, soit 4 Kio | 4096, soit 16 Mio | seulement avec les VM du pool arrêtées |
on-volume-remove sur le stockage | non défini | discard=1 | oui, pvesm set |
| Discard sur chaque disque virtuel | désactivé | activé | oui, disque par disque |
scan_lvs et le filtre | 0, aucun rejet des disques de VM | 1, disques de VM rejetés | oui, dans lvm.conf |
Rien de tout cela n’est difficile. Rien de tout cela n’est le défaut.
L’écriture la moins chère est celle qu’on n’envoie jamais
Ce qui me frappe avec VDO, c’est à quel point il est mal vendu. On le présente comme un moyen de mettre sur un disque plus que ce que le disque contient, et c’est la chose la moins utile qu’il fasse. Je l’ai fait par accident au premier montage, et Proxmox affichait un tiers du stockage libre pendant que VDO était plein. La surallocation est un prêt, et le disque le rappelle à pleine vitesse d’écriture.
La vraie valeur est dans la ligne que la plupart des gens ne mesurent jamais. Un quart des octets qui atteignent le disque, c’est un quart de l’usure et un cache de contrôleur qui tient quatre fois plus longtemps. Ce n’est pas de la capacité. C’est le matériel qui travaille moins pour le même résultat, et c’est la seule sorte d’économie qui ne vous revient pas dans la figure.
Cela coûte du CPU, et sur de la flash rapide cela coûte de la latence, et les deux sont fixes. Voilà le compromis, dit franchement : du temps processeur dépensé pour que la partie lente et chère de la machine travaille moins. Sur des disques à plateaux derrière un contrôleur RAID ou un bcache, avec l’index et le journal sur un NVMe, le calcul tombe bien. Sur un hôte tout Optane, la plupart du temps, non.
Et il ne s’occupera pas de lui-même. Chaque défaut qui compte est mauvais pour ce travail : dix threads sur seize CPU, une taille de discard qui brûle un cœur, une taille virtuelle qu’on peut fixer à n’importe quoi, et rien dans la configuration du stockage pour dire à Proxmox de rendre l’espace. Rien de tout cela n’est caché. Tout est dans la documentation.
Alors montez-le épais, une fois, correctement, avec les réglages sur la ligne de création et les métadonnées là où elles doivent être. Faites-le et le disque fait un quart du travail. Sautez cette étape et vous avez acheté une couche de plus qui promet plus qu’elle n’a.
Linux kernel documentation — dm-vdo — la cible « provides block-level deduplication, compression, and thin provisioning » ; « If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space » ; « unflushed writes may or may not persist after a crash » ; le cache de block map de 128 Mo permet « efficient access to 100 GB of logical space at a time » ; les paramètres de threads, leurs limites et les conseils de réglage ; maxDiscard « in 4096-byte blocks ». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — pool VDO et LV VDO, la conversion d’un LV existant avec
lvconvert --type vdo-pool, l’usage mémoire, l’index dense et sa fenêtre de 1 Tio par Gio de RAM, et « You cannot reduce the size of a VDOPoolLV ». ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()coupe la transmission du discard quand le périphérique de données ne peut pas prendre un chunk fin entier, ce que fait le défaut de VDO sous un pool fin. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: « Caution is required to avoid using PVs that belong to guest images stored on LVs » et « This option does not enable autoactivation of layered VGs ». ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — la propriété
on-volume-remove, « Use ‘discard=1’ to issue discard (TRIM) requests before removal » ; les volumes sont activés un par un aveclvchange -aeyplutôt qu’avecvgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — « Management tools for Virtual Data Optimizer », version 8.3.1.1-1, qui fournit
vdoformat,vdostatsetvdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()crée la partition de la block map au début, les partitions du résumé des slabs et du journal de récupération à la fin, et le dépôt de slabs avec ce qui reste. ↩︎fio documentation — randrepeat — « Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true. » ↩︎
Linux kernel documentation — Design of dm-vdo — « vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one. » ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — « For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive. » ↩︎