Le switch que vous n’achetez pas
Un cluster Proxmox de trois nœuds avec Ceph veut un réseau rapide entre les nœuds. La réponse habituelle est un switch 100 Gbit/s, et l’objection habituelle est ce qu’il coûte.
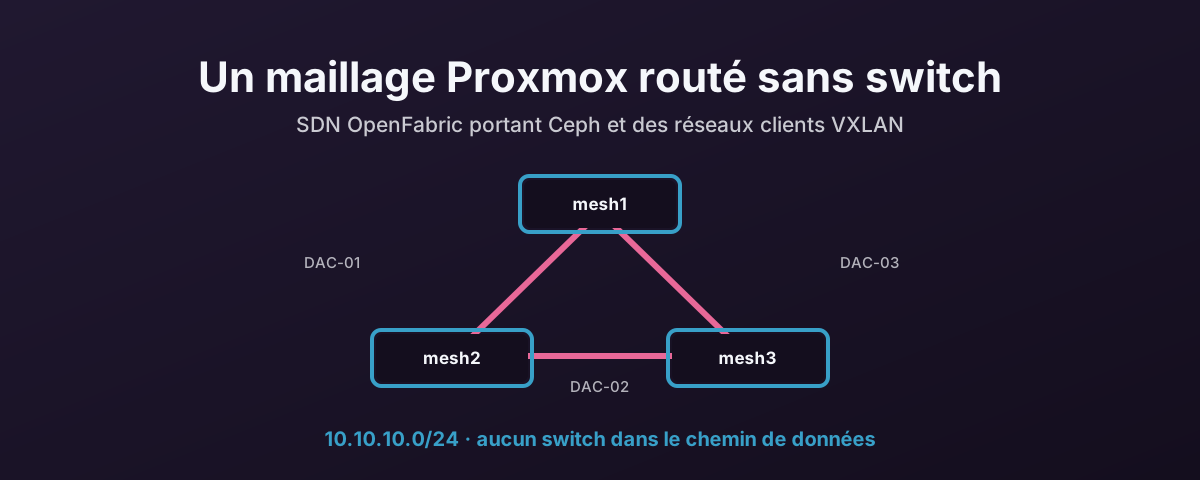
Il y a une autre réponse pour trois nœuds : les câbler droit les uns aux autres en triangle et router à travers. Aucun switch dans le chemin de stockage.
Le composant le moins cher d’un montage est celui que vous n’achetez pas, et c’est le seul qui ne tombe jamais en panne.
Ça vous rapporte quatre choses.
Le coût du switch disparaît. Il vous faut des cartes réseau et trois câbles, pas un switch 100 ou 200 Gbit/s avec le nombre de ports qui va avec.
Le chemin de données n’a aucun point de défaillance unique. Un switch qui tombe ou qui redémarre emporte avec lui tout le trafic est-ouest du cluster. Des nœuds câblés directement entre eux se moquent de ce qui arrive à un switch ailleurs dans le bâtiment.
Le gros trafic est sur ses propres fils. La migration à chaud et la réplication Ceph restent sur le maillage au lieu de se battre avec le trafic bureautique et d’administration.
L’agrandir est un travail de câblage, pas de budget de ports. Il n’y a pas de boîte centrale qui joue le plafond de bande passante ou de nombre de ports, donc le fabric grandit tant que chaque serveur a un slot PCIe libre. OpenFabric route sur les nouveaux liens tout seul.
Et une limite honnête, parce qu’elle compte plus que les quatre avantages. Un maillage complet demande un câble entre chaque paire de nœuds. Trois nœuds, c’est trois câbles. Quatre, c’est six. Cinq, c’est dix. Le câblage grandit plus vite que le nombre de nœuds, et ce montage ne survit pas au-delà d’un petit cluster sans passer à quelque chose de commuté, comme du leaf-spine.
Trois nœuds, c’est exactement là où un maillage complet a du sens. Au-delà, avec deux ports de maillage par nœud, ce que vous pouvez encore construire est un anneau — et ça demande une chose que ce montage évite par ailleurs, traitée plus bas.
Ce qui se construit
Trois hôtes Proxmox VE, chacun avec deux interfaces 100 Gbit/s dédiées, câblés en triangle de sorte que chaque nœud a deux voisins directs.
Le SDN de Proxmox fait le routage. OpenFabric est le protocole : il détermine le meilleur chemin à travers le maillage, et quand un câble est débranché ou qu’un lien tombe, il reroute par le chemin restant. Personne ne se connecte.
Le fabric vit dans 10.10.10.0/24, réservé au maillage et à rien d’autre — ni l’administration, ni les invités, ni l’adressage du stockage, ni quoi que ce soit d’externe.
| Nœud | Adresse de maillage | Interfaces de maillage |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
Chaque nœud reçoit un /32, pas une tranche du sous-réseau.
C’est tout l’intérêt d’un maillage routé plutôt que ponté. L’adresse identifie le nœud, OpenFabric l’annonce, et les deux liens physiques ne sont que des chemins pour l’atteindre.
Proxmox crée une interface de bouclage factice pour la porter.
Le câblage
Des câbles DAC en fibre active, en triangle, avec les trames jumbo activées sur les deux interfaces de maillage de chaque nœud.
| Câble | De | Vers |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
De la fibre active plutôt que du DAC cuivre, pour deux raisons qui tiennent à la baie plutôt qu’au réseau :
- La gestion des câbles. Les DAC en fibre active sont plus fins et bien plus souples que le cuivre, donc ils se rangent proprement et ne s’entassent pas derrière les serveurs.
- Le flux d’air. Moins de volume de câble derrière le châssis, c’est moins de perturbation du flux d’air avant-arrière, ce qui compte quand plusieurs liens à haut débit atterrissent dans les mêmes quelques unités de baie.
Deux réseaux, pas un
Le maillage n’est pas le seul réseau, et il ne doit pas le devenir.
Chaque nœud a nic0 sur un switch 2,5 Gbit/s, présenté à Proxmox comme le pont vmbr0.
Il porte l’interface web, l’accès d’administration et le trafic client. C’est aussi le chemin que vous utilisez pendant la construction du fabric, et c’est pour ça qu’il doit en être indépendant.
nic0 est délibérément laissé hors du fabric. Seules nic1 et nic2 sont sélectionnées à la création des nœuds du fabric.
Le maillage porte trois choses :
- Ceph. La réplication de nœud à nœud, la récupération et le backfill du stockage hyperconvergé.
- Le réseau virtuel client. Des VNets sur VXLAN étirent les réseaux invités sur les trois nœuds, en utilisant le maillage routé comme underlay.
- Corosync, comme second chemin. Le trafic d’appartenance au cluster passe par le réseau d’administration et par le maillage, donc le quorum ne dépend pas de la survie de l’un ou de l’autre seul.
La règle qui mérite d’être écrite sur le ticket de changement : l’administration et l’accès client restent disponibles par le switch 2,5 Gbit/s à tout moment, quel que soit l’état des interfaces 100 Gbit/s.
Tout par l’interface web
Ce montage se fait entièrement dans l’interface web de Proxmox. C’est un choix délibéré, pas une limite de l’outillage.
Pas utilisé, exprès :
- Éditer
/etc/network/interfacesà la main. - Éditer les fichiers de configuration FRR à la main.
vtyshcomme méthode de construction.
Proxmox génère la configuration réseau et de routage sous-jacente à partir des objets SDN que vous définissez. Si quelque chose ne peut vraiment pas se régler dans l’interface, ça mérite d’être signalé comme prérequis plutôt que corrigé en douce en ligne de commande. La personne suivante qui ouvrira l’interface web ne saura pas que vous l’avez fait.
La sortie en ligne de commande n’apparaît ci-dessous que comme preuve, jamais comme étape de construction.
La construction
1. Ouvrez l’interface web de Proxmox et allez dans Datacenter → SDN → Fabrics.
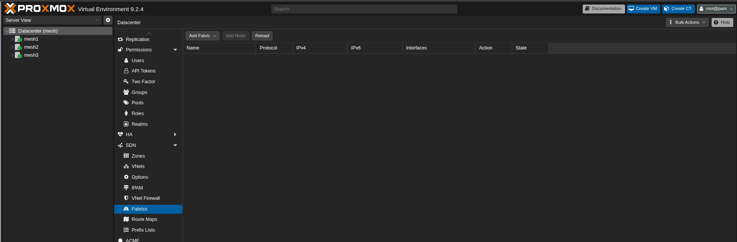
2. Ajoutez le fabric. Nommez-le, donnez-lui le préfixe du maillage, et réglez les temporisations.
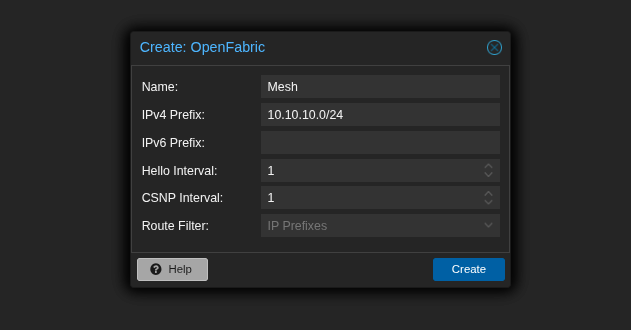
Des intervalles Hello et CSNP à 1 mettent l’état à jour aussi vite que possible quand quelque chose change, ce qui est ce que vous voulez sur un fabric de cette taille.
Le prix, c’est plus de bavardage sur le plan de contrôle. Sans importance sur trois nœuds à deux liens chacun, à reconsidérer si le fabric grandit un jour.
3. Ajoutez chaque nœud avec Add node. Donnez-lui une adresse dans la plage du maillage et cochez les interfaces qui participent.
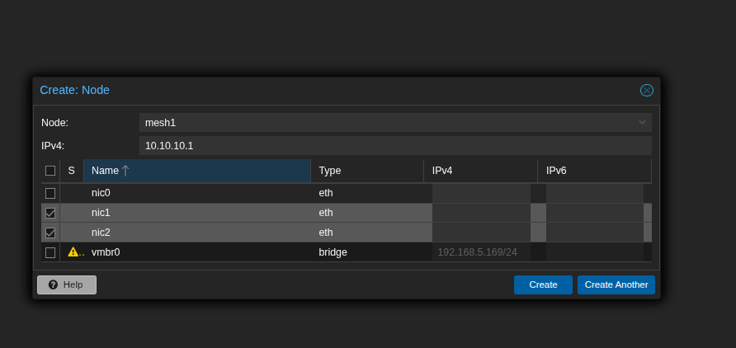
Notez ce qui n’est pas coché : nic0 reste dehors, et vmbr0 garde l’adresse d’administration.
Utilisez Create another pour les deux premiers nœuds et Create sur le dernier.
4. Vérifiez le résultat avant de l’appliquer.
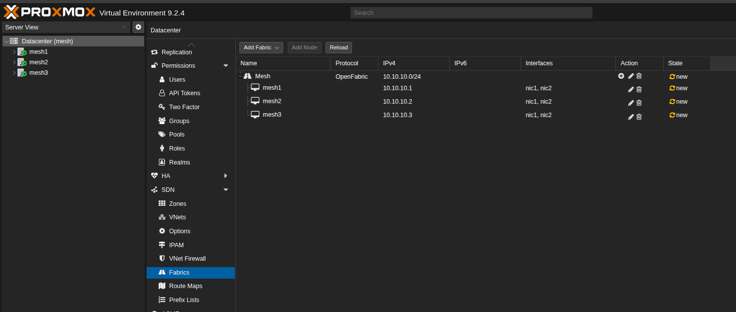
Trois nœuds, trois adresses, nic1, nic2 sur chacun, tous marqués new — rien n’a encore été écrit.
5. Appliquez la configuration SDN.
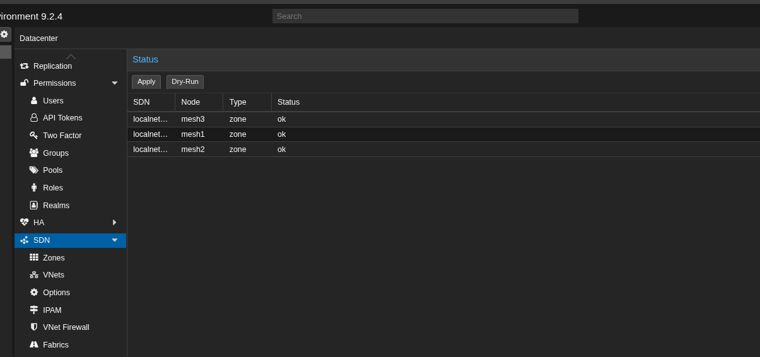
Il y a un Dry-Run à côté d’Apply si vous préférez voir d’abord ce qu’il compte faire.
Savoir que ça a marché
La vue de statut doit montrer les entrées de zone et de fabric à ok sur les trois nœuds, et plus aucun changement en attente d’application.
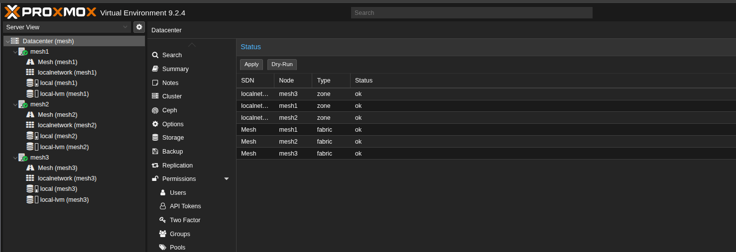
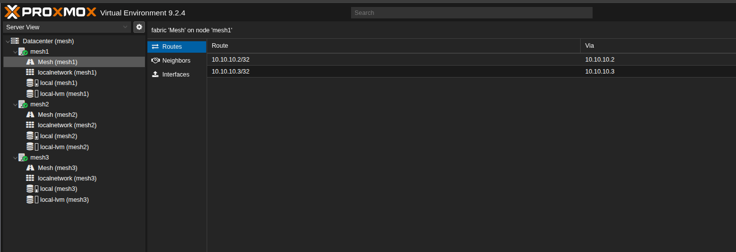
Vérifiez ensuite le fabric du point de vue d’un nœud lui-même.
Les routes d’abord — chaque nœud doit avoir un /32 vers chacun des autres, et la colonne Via vous dit quel voisin il emprunte.
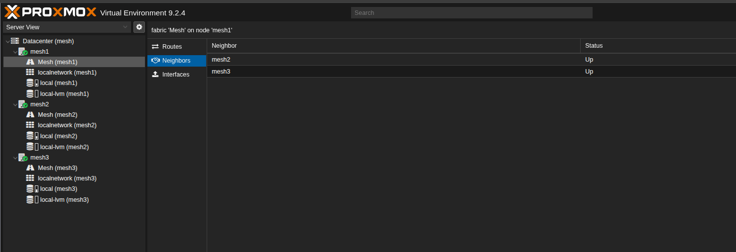
Les voisins ensuite. Deux, tous les deux Up, sur un triangle de trois nœuds.
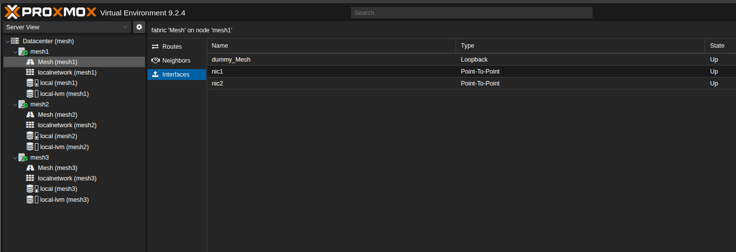
Puis les interfaces, où la forme de la chose apparaît : dummy_Mesh comme bouclage portant l’adresse du routeur, et nic1 et nic2 en Point-To-Point plutôt qu’en segments de diffusion.
Enfin, prouvez-le de bout en bout.
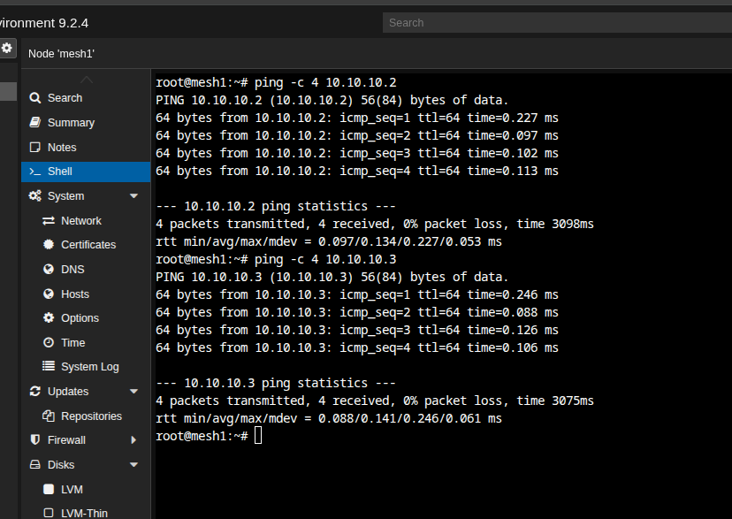
Aucune perte, et des moyennes de 0,134 ms et 0,141 ms. Les deux voisins sont à un saut direct, ce qu’un triangle vous donne.
Le contrôle qui vaut la peine et qu’aucune capture ne peut montrer : débranchez un câble et confirmez que tout reste joignable. C’est toute la raison de choisir un maillage routé plutôt qu’une paire de liens point à point. À ce titre, c’est le seul test qui compte.
Au-delà de trois nœuds : l’anneau
Un triangle est un maillage complet. Chaque nœud a un câble direct vers chaque autre nœud, chaque saut est un saut unique, et aucun nœud ne porte jamais de trafic qui n’est pas le sien.
Cette propriété est ce que deux ports de maillage par nœud vous achètent à trois nœuds, et c’est exactement ce que vous perdez à quatre. Pas une partie. Toute. Un maillage complet de quatre nœuds demande trois ports chacun. Avec deux, le maximum que vous puissiez câbler est un anneau.
Un anneau change le modèle de trafic. Les nœuds voisins ont toujours un câble direct, mais les nœuds opposés sur l’anneau n’en ont pas — leur trafic doit traverser un nœud intermédiaire. Et ce nœud doit accepter de faire suivre des paquets entre ses deux interfaces de maillage, ce que Linux ne fait pas par défaut. Le noyau documente ip_forward comme « Forward Packets between interfaces » avec « Default : 0 (disabled) » — faire suivre les paquets entre interfaces, par défaut 0, désactivé.
Activez-le pour les interfaces de maillage, et pour elles seules :
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
Relisez-les au lieu de supposer :
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
Le réglage par interface est la bonne portée ici, et il marche tout seul. Le net.ipv4.ip_forward global n’est pas un prérequis. La décision de forwarding du noyau lit la valeur propre de l’interface de réception :
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET renvoie le réglage de cet équipement, pas un ET avec le réglage global. Donc nic1 et nic2 font suivre le trafic de transit du fabric pendant que nic0 et vmbr0 restent exactement ce qu’elles doivent être : des interfaces d’hôte qui ne routent pas. Activer l’interrupteur global ferait de chaque interface de la machine un routeur, y compris celle qui regarde votre réseau de bureau. Ce montage n’a aucun besoin de ça.
Une chose à savoir sur l’interrupteur IPv4 global même si vous ne le posez pas : net.ipv4.ip_forward est un régleur en bloc, et c’est pour ça que la documentation du noyau prévient que le changer « resets all configuration parameters to their default state » — remet tous les paramètres de configuration à leur valeur par défaut. Si quoi que ce soit d’autre sur l’hôte l’écrit un jour, ça écrase ces valeurs par interface. Bon à savoir avant de passer un après-midi à chercher pourquoi le transit s’est arrêté.
IPv6 est l’exception, et c’est le seul endroit où l’interrupteur global a sa place. La documentation du noyau le dit directement sous conf/all/forwarding :
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
Il n’y a donc pas d’équivalent IPv6 de l’approche propre par interface ci-dessus. Si le fabric porte de l’IPv6, vous activez le forwarding globalement puis vous en limitez la portée avec force_forwarding, documenté comme « Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding » — activer le forwarding sur cette interface seulement, quel que soit le réglage de conf/all/forwarding. Notez que le même écrasement s’applique en sens inverse : poser conf.all.forwarding à 0 remet force_forwarding à zéro sur toutes les interfaces.
Le montage ci-dessus laisse le préfixe IPv6 du fabric vide, donc rien de tout ça ne s’applique ici — ça ne compte que si vous en ajoutez un.
Notez ce que le forwarding ne change pas : OpenFabric annonçait déjà le /32 de chaque nœud et calculait déjà le chemin à travers l’anneau. Le forwarding est la permission qui manquait, pas l’intelligence qui manquait. La table de routage était juste depuis le début. Le noyau refusait simplement de jouer au routeur.
Ce que coûte l’anneau, par rapport au triangle :
- Le trafic de transit. Sur un anneau de quatre nœuds, les deux paires diagonales traversent un nœud intermédiaire, donc leur trafic consomme la bande passante des liens de ce nœud en plus de la sienne. Ceph s’en aperçoit en premier, parce que la réplication va de tous vers tous plutôt que de voisin à voisin.
- Un saut de latence en plus sur ces chemins, par-dessus les valeurs habituelles sous la milliseconde du montage sans switch.
- Moins de marge en cas de panne. Un lien cassé transforme un anneau en chaîne : toujours entièrement connecté, mais avec des chemins plus longs et plus de transit. Une deuxième coupure partitionne le cluster. Un triangle tolère une coupure sans aucun transit.
Et ça empire d’une façon plus facile à dessiner qu’à décrire. Ajoutez un cinquième nœud et la moitié des paires de nœuds du cluster dépend de quelqu’un d’autre pour faire suivre :
C’est le vrai plafond de ce montage, et ce n’est pas le protocole de routage. OpenFabric s’en sort très bien. C’est que le nombre de ports par nœud est fixe, donc au-delà de trois nœuds, chaque nouvelle machine convertit une part supplémentaire de votre trafic en transit pour quelqu’un d’autre.
Et la note honnête, parce qu’elle compte pour un montage qui n’a utilisé que l’interface web jusqu’ici : un sysctl n’est pas une action d’interface web. Selon la règle posée plus haut, ça en fait un prérequis à signaler plutôt qu’une chose à corriger discrètement en ligne de commande — écrivez-le dans la procédure, parce que la personne suivante qui ouvrira le panneau SDN verra un fabric en bonne santé et aucun indice qu’un anneau dépend d’un fichier dans /etc/sysctl.d.
Faire marche arrière
La suppression, c’est le montage à l’envers, dans la même interface : supprimez les objets SDN créés pour le maillage, appliquez la configuration, et confirmez que l’accès d’administration est intact.
Cette dernière étape est la raison d’être de nic0 et du switch 2,5 Gbit/s. Si revenir en arrière sur le maillage pouvait vous coûter l’interface web, le montage était mauvais avant même que vous ne commenciez.
Avant de commencer
- L’accès d’administration est vraiment indépendant du maillage. Vérifiez-le, ne le supposez pas.
- Les trois nœuds sont en bonne santé avant tout changement SDN.
- Les noms de nœuds, les noms d’interfaces et le câblage sont écrits, parce que
nic1sur un hôte qui estnic2sur un autre, c’est un mauvais après-midi. - Les trames jumbo sont réglées sur les deux interfaces de maillage, et le MTU tient compte de la surcharge de VXLAN sur l’underlay.
- La plage du maillage est réservée et n’est utilisée nulle part ailleurs.
Références
- Proxmox VE — Software-Defined Network — la documentation des SDN Fabrics. Les fabrics « provide automated routing between nodes in a cluster », OpenFabric est « based on IS-IS and optimized for the spine-leaf topology common in data centers », chaque nœud a besoin d’un Router-ID unique, et « a dummy ’loopback’ interface with the router-id is automatically created »
- Proxmox VE — Cluster Manager — le réseau de Corosync et les liens redondants, derrière le choix d’une appartenance à deux chemins
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — les attentes réseau d’un cluster hyperconvergé
- Linux kernel — IP sysctl documentation —
ip_forwardet sa valeur par défaut de 0, le contrôleforwardingpar interface, et l’avertissement que changer l’interrupteur global remet à zéro la configuration par interface