Le problème
C’est apparu lors d’une mission client où nous concevions un déploiement Proxmox VE avec passthrough NVMe pour une charge sensible à la latence.
Le client avait fait ses propres tests avant l’appel.
Sur l’hôte, fio contre le disque NVMe rapportait 700K IOPS en lecture aléatoire avec une latence d’achèvement sous les 10 µs.
Dans la VM, avec le même disque et le même test, ils en obtenaient à peu près la moitié.
Ils avaient déjà vérifié les choses évidentes. Le disque n’avait pas changé. Le micrologiciel n’avait pas changé. L’emplacement PCIe n’avait pas bougé. Ils commençaient à se demander si le passthrough n’était pas la mauvaise approche du tout.
Ce ne l’était pas. Ce qu’ils voyaient est la taxe IOMMU. Elle prend les gens au dépourvu parce que personne ne vous en parle avant que vous vous soyez engagé dans la conception de passthrough. La bonne nouvelle est que l’essentiel de la surcharge est récupérable une fois que vous comprenez d’où elle vient.
Plongée en profondeur
Les problèmes qu’il a fallu résoudre
Donner à une VM un accès direct à un périphérique PCIe physique semble simple. En pratique, c’est l’un des problèmes les plus durs de la virtualisation des systèmes. Quelques choses qui marchent automatiquement sur métal nu deviennent dangereuses quand un périphérique est partagé entre un hôte et un invité.
Isolation DMA
C’est le problème fondamental.
Les périphériques PCIe ne passent pas par le CPU pour lire et écrire la mémoire. Ils utilisent l’accès direct à la mémoire (DMA). Ils écrivent droit à des adresses physiques de RAM. Sur métal nu, c’est bien. Le périphérique et le système d’exploitation se font confiance.
Sous virtualisation, la VM invitée a sa propre vue de la mémoire physique. Les adresses que le pilote de l’invité donne au contrôleur NVMe sont des adresses physiques d’invité. Elles ne correspondent pas aux mêmes emplacements dans la RAM de l’hôte. Si le périphérique les utilise directement, il lit et écrit la mauvaise mémoire. Cela corrompt l’hôte, d’autres VM, ou les deux.
Pire, un pilote d’invité malveillant ou bogué pourrait délibérément programmer le périphérique pour faire du DMA dans n’importe quelle partie de la mémoire de l’hôte. C’est en pratique un accès root à toute la machine sans jamais exploiter un bogue d’hyperviseur.
La solution est l’IOMMU — une unité de traduction matérielle (Intel VT-d, AMD-Vi) qui siège entre chaque périphérique PCIe et la mémoire principale. Elle tient ses propres tables de pages, séparées de celles du CPU. Chaque requête DMA du périphérique passe par l’IOMMU, qui traduit les adresses physiques d’invité en adresses physiques d’hôte et bloque tout accès en dehors des régions de mémoire allouées à l’invité.
Sans l’IOMMU, un passthrough sûr est impossible. Avec, le périphérique est contenu.
Groupement de périphériques
L’IOMMU n’isole pas les périphériques individuels. Elle isole des groupes.
La spécification PCIe définit les Access Control Services (ACS) qui régissent si des périphériques sur le même bus peuvent se parler directement — DMA pair-à-pair — sans passer par le complexe racine où siège l’IOMMU. Si deux périphériques partagent un commutateur PCIe qui n’applique pas les ACS, un périphérique peut faire du DMA dans l’espace mémoire de l’autre, contournant l’IOMMU entièrement.
Le noyau groupe les périphériques qui peuvent potentiellement s’atteindre sans application de l’IOMMU en un seul groupe IOMMU. Si votre contrôleur NVMe partage un groupe avec un autre périphérique, ne passer que le NVMe casse le modèle d’isolation. L’autre périphérique du groupe pourrait encore servir de canal détourné autour de l’IOMMU.
Le matériel de qualité serveur, avec un vrai support ACS sur chaque pont et commutateur, donne en général à chaque périphérique son propre groupe. Les cartes grand public et stations de travail regroupent souvent plusieurs périphériques parce que le complexe racine PCIe n’implémente pas les ACS sur chaque port.
Proxmox porte un correctif noyau — pcie_acs_override — qui dit au noyau de traiter chaque périphérique comme isolé quel que soit le support ACS matériel.
Cela marche en pratique, mais c’est mentir au noyau sur la topologie matérielle.
Sur un système de production, des groupes propres adossés à de vrais ACS matériels sont toujours préférables.
Livraison des interruptions
Sur métal nu, quand un contrôleur NVMe achève une opération IO, il tire une interruption MSI-X directement vers le CPU. Le CPU la traite en quelques centaines de nanosecondes.
Sous virtualisation, cette interruption doit atteindre l’invité, pas l’hôte. L’approche naïve est de piéger chaque interruption dans l’hyperviseur, de déclencher une sortie de VM, d’injecter l’interruption dans l’invité, et de reprendre. Cela marche, mais chaque sortie de VM coûte 5 à 20 µs. À IOPS élevés — des centaines de milliers d’interruptions par seconde — la surcharge est substantielle.
La solution matérielle est les interruptions postées. L’APICv d’Intel et l’AVIC d’AMD permettent à l’IOMMU d’écrire l’interruption directement dans la page APIC virtuelle de l’invité sans causer de sortie de VM du tout. L’invité voit l’interruption comme si elle venait de matériel sur métal nu. La surcharge tombe à quelques centaines de nanosecondes.
Toutes les plateformes ne prennent pas en charge les interruptions postées. Les CPU plus anciens, certains chipsets de station de travail et certaines versions de BIOS n’exposent pas la capacité. Quand elles sont absentes, chaque interruption passe par le chemin lent, et il n’y a pas de contournement logiciel.
Réinitialisation du périphérique
Quand une VM s’éteint ou plante, le périphérique passé doit revenir à un état propre et connu. Sinon il ne peut être ni réassigné à une autre VM, ni récupéré par l’hôte.
Sur métal nu, le système d’exploitation fait un arrêt ordonné du pilote du périphérique. Sous passthrough, l’invité peut planter, l’utilisateur peut forcer l’arrêt de la VM, ou l’hyperviseur peut tuer le processus. Le périphérique pourrait être en plein transfert avec des opérations DMA en vol.
PCIe définit le Function Level Reset (FLR) pour cela — une façon de réinitialiser une seule fonction de périphérique sans affecter le reste du bus. Les contrôleurs NVMe prennent en général le FLR en charge et le gèrent bien. Les GPU y sont notoirement mauvais, mais c’est un autre article.
Si le FLR n’est pas pris en charge, le repli est une réinitialisation de bus secondaire, qui réinitialise tout ce qui est derrière ce pont PCIe. Si le pont a d’autres périphériques dessus, ils sont tous réinitialisés aussi. Dans le pire cas, un redémarrage complet de l’hôte est le seul moyen de récupérer le périphérique.
Surcharge de traduction d’adresses
L’IOMMU résout le problème de sûreté. À ce titre, elle n’est pas optionnelle. Mais elle en introduit un de performance.
Chaque opération DMA passe désormais par un niveau de traduction d’adresses supplémentaire. L’IOMMU a son propre TLB — l’IOTLB — et quand il touche, la surcharge est petite. Quand il manque, l’IOMMU doit parcourir ses tables de pages, et cela ajoute une vraie latence à chaque opération IO affectée.
C’est la taxe IOMMU. Le reste de cet article porte sur la compréhension d’où elle vient et comment la réduire.
Mappage des BAR et espace d’adressage
Chaque périphérique PCIe expose un ou plusieurs Base Address Registers (BAR) qui mappent les registres internes et la mémoire du périphérique dans l’espace d’adressage MMIO de l’hôte. Le CPU de l’hôte accède au périphérique par ces mappages. Pour que le passthrough marche, l’hyperviseur doit présenter ces mappages correctement à l’invité.
Traditionnellement, les tailles de BAR étaient fixées au démarrage par le BIOS et tenaient dans la fenêtre MMIO 32 bits héritée sous les 4 Go. Cela marchait quand les BAR étaient petits. Les GPU modernes ont changé le tableau. Un framebuffer de 24 Go a besoin d’un BAR de 24 Go, qui ne tient pas dans un espace d’adressage 32 bits.
Le Resizable BAR (ReBAR) — aussi commercialisé sous le nom d’AMD Smart Access Memory (SAM) — est une capacité PCIe qui permet de renégocier la taille du BAR après le démarrage. Pour les GPU, c’est une fonction importante. Au lieu d’accéder au framebuffer par une fenêtre de 256 Mo et de le paginer par morceaux, l’hôte mappe toute la VRAM d’un coup.
Pour le NVMe, l’impact direct est plus petit. Les BAR d’un contrôleur NVMe font en général de 16 à 64 Ko pour le jeu de registres du contrôleur (BAR0). La spécification NVMe définit un Controller Memory Buffer (CMB) qui peut exposer un BAR plus grand pour des files de soumission résidant sur l’hôte, mais la plupart des disques ne l’implémentent pas. Le ReBAR ne change pas le débit NVMe comme il le fait pour les GPU.
La raison pour laquelle il compte dans un contexte de passthrough NVMe est l’environnement PCIe partagé. Si vous passez un disque NVMe à côté d’un GPU sur le même hôte, le BAR redimensionné du GPU a besoin d’espace d’adressage au-dessus de la limite des 4 Go. Le BIOS, l’IOMMU et la topologie PCIe virtuelle doivent tous l’accommoder. Se tromper dans l’allocation d’espace d’adressage veut dire que des périphériques ne s’initialisent pas, et le passthrough NVMe échoue en même temps que tout le reste.
Exposition à la coupure de courant
Sur un disque virtuel, l’hyperviseur et la couche de stockage gèrent l’ordre des écritures et la cohérence en cas de plantage. Avec le passthrough, l’invité parle directement à la flash. Si l’hôte perd le courant en pleine écriture, ce que le micrologiciel du contrôleur NVMe fait — ou ne fait pas — de son cache d’écriture détermine si vous perdez des données.
Les disques NVMe d’entreprise portent des condensateurs de protection contre la coupure de courant (PLP) qui vident le cache d’écriture en sûreté lors d’une panne de courant. Les disques grand public sans PLP peuvent ne pas le faire. Avec le passthrough, il n’y a pas de filet de sécurité de l’hyperviseur entre l’invité et le matériel.
Pour une charge de production, un disque d’entreprise avec PLP n’est pas optionnel.
Compromis d’exploitation
Le passthrough retire aussi des capacités que les disques virtuels fournissent.
Un périphérique passé est physiquement boulonné à un hôte donné. La VM ne peut pas être migrée à chaud tant que le périphérique est attaché. Dans un cluster Proxmox avec HA, une panne de nœud veut dire que la VM tombe et démarre à froid sur un autre nœud. Il n’y a pas de bascule transparente.
Le disque est aussi invisible à vzdump et à Proxmox Backup Server.
Il ne sera inclus ni dans les instantanés de VM ni dans les sauvegardes planifiées.
Une stratégie de sauvegarde séparée — au niveau de l’invité, du système de fichiers ou de l’application — doit être en place avant que la charge parte en production.
Comment le passthrough VFIO marche réellement
Quand vous passez un périphérique PCIe à une VM, l’hyperviseur remet à l’invité le contrôle direct des registres MMIO du périphérique. Le pilote de l’invité parle au contrôleur NVMe comme s’il tournait sur métal nu. Cette partie est quasi native. L’accès aux registres MMIO passe par les Extended Page Tables (EPT sur Intel, NPT sur AMD) et s’achève en général sans sortie de VM.
Le chemin DMA est là où le coût apparaît. Chaque opération DMA passe par l’IOMMU pour la traduction d’adresses, et comme décrit plus haut, cette traduction a un prix. Surtout sur les manques d’IOTLB.
Pourquoi les tests paraissent pires que la réalité
Voici où la plupart des gens se trompent dans leurs tests.
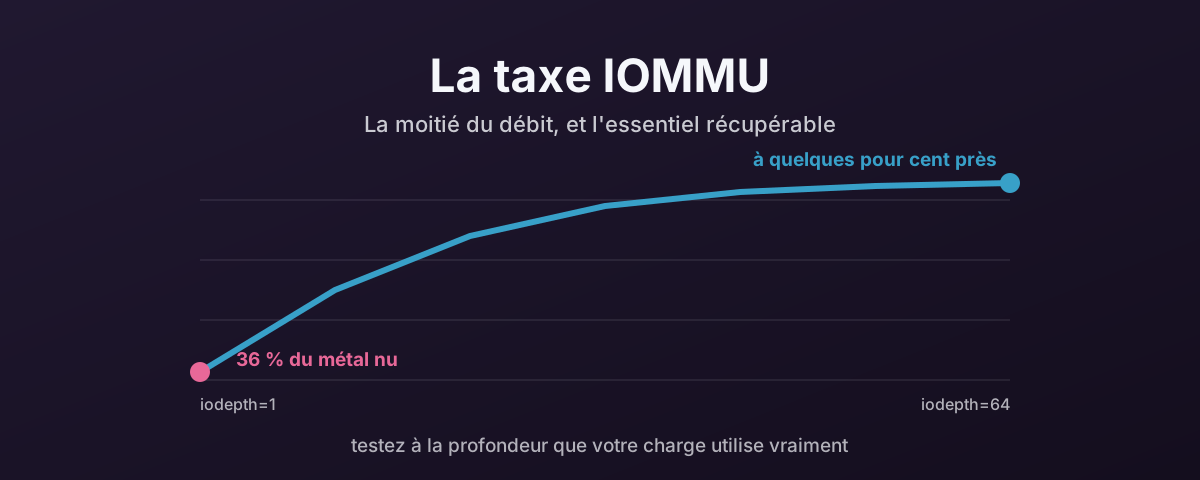
Un fil de forum Proxmox qui a motivé cet article avait des utilisateurs faisant tourner fio avec iodepth=1.
À cette profondeur de file, fio soumet une IO, attend qu’elle s’achève, puis soumet la suivante.
Le test ne mesure que la latence par IO.
Chaque microseconde de surcharge IOMMU apparaît en entier.
Les chiffres de ce fil racontent l’histoire clairement.
La latence d’achèvement sur métal nu tournait autour de 10 µs en moyenne.
Dans la VM, elle tournait autour de 28 µs.
Ces ~18 µs par IO en plus sont la surcharge de traduction IOMMU.
À iodepth=1, cela divise directement le débit par deux, parce que le débit vaut 1 / latence quand il n’y a qu’une seule IO en vol.
Poussez la profondeur de file à 32 ou 64 — ce qui est la façon dont les disques NVMe sont conçus pour fonctionner — et le tableau change. Avec plusieurs IO en vol, la surcharge IOMMU est amortie sur toutes. Le contrôleur traite des achèvements pendant que de nouvelles traductions se font. Le débit récupère à quelques pour cent près du métal nu.
L’enseignement pratique est celui-ci. Si votre charge tourne à des profondeurs de file au-dessus de 4, la pénalité de débit IOMMU est probablement négligeable. Cela couvre la plupart des charges de base de données, de virtualisation et de stockage. Si votre charge est sensible à la latence à basses profondeurs de file — certaines applications temps réel, opérations de métadonnées synchrones — vous la sentirez.
Faites tourner vos tests à des profondeurs de file réalistes avant de conclure que le passthrough est trop lent :
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Comparez les percentiles de clat (latence d’achèvement) et les chiffres d’IOPS.
À iodepth=32 avec quatre tâches, l’écart devrait être de quelques points de pourcentage à un chiffre, pas de 50 %.
Alignement NUMA
Cela a son propre article. Voir Alignement NUMA sur Proxmox VE — pourquoi cela compte et comment bien le faire.
La version courte : sur les systèmes multi-socket, chaque périphérique PCIe est câblé à un socket donné. Si le disque NVMe est sur le nœud NUMA 1 et que les vCPU de la VM sont épinglés au nœud 0, chaque achèvement DMA traverse le lien inter-socket. Cela ajoute 50 à 100 ns par opération. À IOPS élevés, la différence de débit entre NUMA aligné et désaligné est de 20 à 30 %.
Vérifiez avec cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, puis épinglez les vCPU de la VM à des cœurs du même nœud avec le paramètre affinity dans la configuration de la VM.
Sur les systèmes mono-socket, ce n’est pas un souci.
Gestion de l’alimentation par état actif PCIe (ASPM)
Cela a son propre article. Voir PCIe ASPM et pourquoi il faut le désactiver pour le passthrough.
La version courte : l’ASPM permet aux liens PCIe d’entrer dans des états de basse consommation quand ils sont inactifs.
Sous passthrough, l’hôte contrôle encore le lien physique mais l’invité possède le périphérique.
Quand l’invité soumet une IO et que le lien est endormi, le temps de réveil ajoute de la latence.
Le symptôme est un large étalement de vos percentiles de clat. Le p99 peut être 5 à 10 fois plus haut que la moyenne alors que la moyenne paraît bonne.
Désactivez-le sur l’hôte avec pcie_aspm=off dans la ligne de commande noyau.
Ajoutez aussi disable_idle_d3=1 aux options du module vfio-pci si votre contrôleur NVMe a des soucis de récupération d’état d’alimentation. Le Samsung 990 EVO Plus est un coupable connu.
MaxPayloadSize (MPS)
Cela a son propre article. Voir PCIe MaxPayloadSize — un gain de performance gratuit pour le passthrough.
La version courte : les périphériques PCIe transfèrent les données en Transaction Layer Packets.
Le complexe racine virtuel de QEMU met par défaut une charge utile maximale de 128 octets.
La plupart des périphériques prennent en charge 256 ou 512 octets.
Ajouter pci=pcie_bus_perf à la ligne de commande noyau de l’hôte fixe le MPS au maximum que le bus parent de chaque périphérique permet.
C’est une petite amélioration de débit — quelques pour cent à un chiffre — mais elle est gratuite et sans inconvénient.
Resizable BAR et ouverture MMIO
Le problème de mappage des BAR décrit plus haut a des étapes pratiques côté BIOS et côté VM.
D’abord, activez Above 4G Decoding dans le BIOS. Cela permet de mapper les BAR dans l’espace d’adressage au-dessus de la limite des 4 Go, ce qui est requis pour tout périphérique à grands BAR. Activez-le même pour un passthrough NVMe seul. Il n’a pas d’inconvénient et évite des ennuis si vous ajoutez un GPU ou un autre périphérique à grand BAR plus tard.
Si le ReBAR est disponible dans le BIOS, activez-le aussi. Il n’affectera pas la performance NVMe directement, mais il permet aux GPU sur le même hôte d’utiliser leur mappage de framebuffer complet.
Côté VM, le complexe racine virtuel Q35 de QEMU a besoin d’une fenêtre MMIO 64 bits assez grande pour que l’invité voie les BAR redimensionnés. Par défaut, OVMF alloue une fenêtre relativement petite. Pour un passthrough NVMe seul, c’est bien. Les BAR NVMe tiennent confortablement. Mais si la VM a à la fois un NVMe et un GPU passés, augmentez l’ouverture MMIO :
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Cela dit à OVMF d’allouer 64 Go d’espace MMIO 64 bits, assez pour la plupart des framebuffers de GPU à côté du petit BAR du contrôleur NVMe.
Le support du ReBAR par QEMU s’améliore mais n’est toujours pas sans accroc. Certains GPU AMD (Vega et plus récents) déclenchent des erreurs de pilote (Code 43 sous Windows) avec le ReBAR activé sous QEMU. Si vous tombez là-dessus, désactivez le ReBAR dans le BIOS en première étape. Le passthrough NVMe ne sera pas affecté dans un sens ou dans l’autre.
Pour ce que fait le Resizable BAR du côté GPU de la barrière, et pourquoi Intel le traite comme obligatoire sur Arc alors que NVIDIA l’active par jeu, voir PCIe Resizable BAR et les GPU modernes.
Gestion des interruptions
Le problème de livraison des interruptions décrit plus haut a une étape de réglage pratique. Les interruptions postées (APICv sur Intel, AVIC sur AMD) peuvent ne pas être activées par défaut.
Vérifiez si elles sont actives :
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Sur les systèmes AMD EPYC, activez l’AVIC dans le module KVM s’il n’est pas activé par défaut :
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Sur les systèmes Intel, l’APICv avec interruptions postées est en général activé automatiquement quand VT-d est actif.
Si votre plateforme ne prend pas en charge les interruptions postées, il n’y a pas de contournement logiciel. C’est une capacité matérielle. Mais il vaut de vérifier qu’elle est réellement activée avant de supposer que le chemin lent est inévitable.
Affinité des interruptions et alignement des files
Les contrôleurs NVMe utilisent plusieurs paires de files de soumission et d’achèvement. En général une par cœur de CPU. Quand les vCPU de la VM ne s’alignent pas avec les cœurs physiques qui gèrent les interruptions NVMe, les achèvements doivent traverser les cœurs par des interruptions inter-processeurs. Cela ajoute de la latence.
Dans l’invité, vérifiez combien de files IO le pilote NVMe a créées et comment elles sont mappées :
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idéalement, l’interruption de chaque file IO NVMe devrait être affinitée au vCPU qui soumet à cette file. La plupart des pilotes NVMe modernes gèrent cela automatiquement. Mais il vaut de le vérifier, surtout si vous avez épinglé des vCPU à la main ou réduit le nombre de vCPU en dessous du nombre de files du contrôleur.
Toujours utiliser Q35, pas i440fx
Cela mérite son propre article. Voir Toujours utiliser Q35, pas i440fx.
La version courte : i440fx présente un bus PCI hérité plat. Q35 présente un vrai complexe racine PCIe. Les périphériques passés sur i440fx apparaissent comme du PCI hérité, ce qui casse la livraison d’interruptions multi-file MSI-X. Les contrôleurs NVMe ont besoin de MSI-X pour leur architecture d’une file par cœur. Sans lui, tous les achèvements d’IO passent par une seule interruption et vous obtenez un goulot d’étranglement à IOPS élevés qu’aucune quantité de réglage noyau ne corrigera.
Dans Proxmox 8.x et plus récent, Q35 est le défaut pour les nouvelles VM. Si vous faites du passthrough sur une VM plus ancienne encore en i440fx, changez-la. RHEL 10 a formellement rendu i440fx obsolète, et l’écosystème KVM plus large suit.
Tout mettre ensemble
Voici un résumé des étapes de réglage par ordre d’impact.
Alignement NUMA — assurez-vous que le disque NVMe et les vCPU de la VM sont sur le même nœud NUMA. Cela seul peut représenter une différence de débit de 20 à 30 % sur les systèmes multi-socket.
ASPM coupé — ajoutez pcie_aspm=off à la ligne de commande noyau de l’hôte.
Élimine la gigue de latence due aux transitions d’état d’alimentation des liens PCIe.
Profondeurs de file réalistes — testez à iodepth=32 ou plus, pas à iodepth=1.
La surcharge IOMMU qui domine à basses profondeurs de file est amortie à des profondeurs réalistes.
Interruptions postées — vérifiez que l’APICv (Intel) ou l’AVIC (AMD) est actif. Réduit la surcharge par interruption de microsecondes à nanosecondes.
Optimisation du MPS — ajoutez pci=pcie_bus_perf à la ligne de commande noyau de l’hôte.
Fixe le MaxPayloadSize au maximum que la topologie prend en charge.
Gestion de l’alimentation vfio-pci — ajoutez disable_idle_d3=1 si votre contrôleur NVMe a des soucis d’état d’alimentation sous passthrough.
Une ligne de commande noyau hôte combinée pour un nœud Proxmox faisant du passthrough NVMe sur un système AMD EPYC ressemblerait à quelque chose comme :
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Pour Intel :
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Quand le passthrough n’en vaut pas la peine
Avant de s’engager sur cette voie, il vaut de se demander si vous avez réellement besoin du passthrough NVMe du tout.
VirtIO-SCSI et VirtIO-BLK avec un disque virtuel adossé au NVMe sont déjà très efficaces. La surcharge par rapport au passthrough est en général de 5 à 10 % sur la latence. La différence de débit est négligeable pour la plupart des charges.
Le passthrough a du sens quand vous avez besoin que le système d’exploitation invité gère le périphérique directement. Cela inclut la surveillance SMART, les mises à jour de micrologiciel, le contrôle du TRIM/discard, et des fonctions NVMe précises comme les réservations. Il a aussi du sens pour les charges sensibles à la latence où même quelques microsecondes comptent. Certains moteurs de base de données et l’ingestion de données en temps réel entrent dans cette catégorie.
Pour tout le reste, les compromis d’exploitation vus plus haut — perte de la migration à chaud, perte des instantanés et de l’intégration des sauvegardes — l’emportent d’ordinaire sur le petit gain de performance.
Il n’y a rien de malin à choisir le chemin le plus dur quand le plus facile fait le travail.
Vérifier vos changements
Après avoir appliqué les étapes de réglage, vérifiez que tout marche comme prévu :
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Comparez les résultats de la VM à votre référence métal nu antérieure.
À iodepth=32, vous devriez voir un débit à 5 % près du métal nu.
Les moyennes de latence d’achèvement devraient être à 10-15 µs près des chiffres de l’hôte.
Si l’écart est encore grand, vérifiez d’abord l’alignement NUMA.
C’est le facteur le plus souvent négligé.
Il ne coûte aussi rien qu’un changement de configuration, ce qui en fait le meilleur genre de problème avec lequel rester.
Références
- Linux kernel PCI documentation — MPS and MRRS tuning options — la source qui fait autorité pour
pcie_bus_perf,pcie_bus_safe, et les paramètres liés - Proxmox VE Administration Guide — PCI(e) Passthrough — la documentation Proxmox officielle sur la configuration du passthrough de périphériques VFIO
- Proxmox Forum — NVMe Passthrough Performance — la discussion communautaire qui a motivé cet article