Ce qu’est le MPS
Les équipements PCIe transfèrent les données dans des paquets appelés Transaction Layer Packets (TLP). Chaque TLP a un en-tête et une charge utile. La taille maximale de cette charge utile est la MaxPayloadSize (MPS).
Le MPS est négocié entre un équipement et son pont amont pendant l’entraînement du lien. La valeur négociée est la plus petite entre ce que l’équipement gère et ce que le pont autorise. Chaque pont et chaque switch sur le chemin entre l’équipement et le root complex a sa propre capacité MPS. Le MPS final d’un équipement est fixé par le point le plus étroit de la chaîne.
Les valeurs courantes de MPS sont 128, 256 et 512 octets. Certains équipements gèrent 1024 voire 4096 octets, mais en pratique 256 ou 512 est la norme pour les contrôleurs NVMe et les cartes réseau. Les GPU gèrent souvent 256 octets.
Pourquoi ça compte
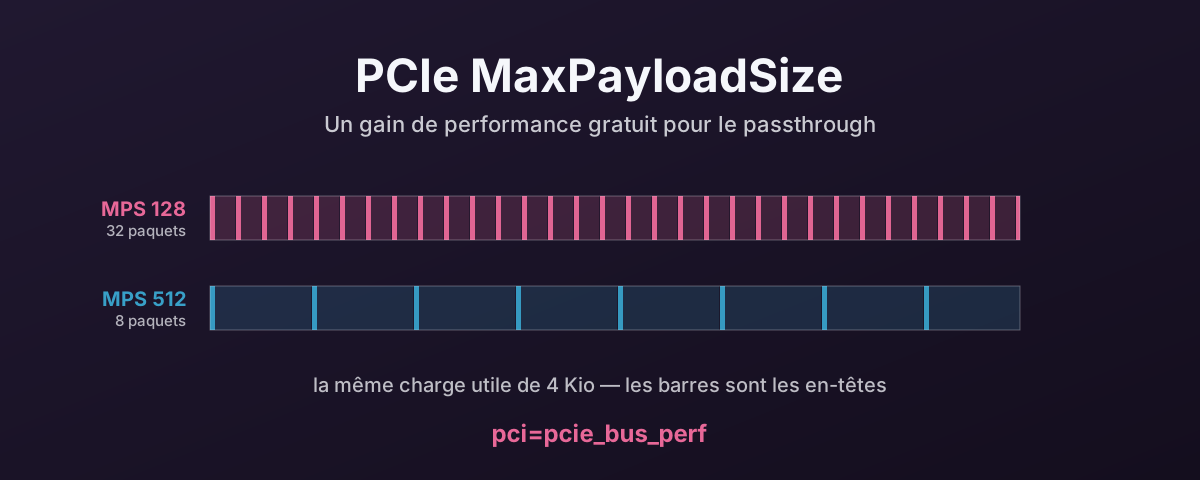
Un MPS plus grand, c’est moins de paquets pour la même quantité de données. Une E/S de 4 Kio transférée à MPS 128 demande 32 TLP. Le même transfert à MPS 512 en demande 8.
Chaque TLP transporte une surcharge de protocole — l’en-tête, le CRC, le tramage. Moins de TLP, c’est moins de surcharge de protocole par octet transféré. À haut débit, cette différence est mesurable. Pas spectaculaire. Mais réelle. Et c’est la même surcharge, payée sur chaque paquet.
Le MPS influe aussi sur la façon dont le lien PCIe est utilisé. Des charges utiles plus petites font passer au lien plus de temps sur les en-têtes que sur les données. Des charges utiles plus grandes déplacent le rapport vers les données utiles.
L’impact sur la latence est plus faible que sur le débit. Une seule lecture de 4 Kio à MPS 128 contre 512 ne montrera pas d’écart de latence digne d’être mesuré, parce que les TLP sont pipelinés. Mais poussez de forts IOPS avec beaucoup de transferts en vol et la surcharge moindre d’un MPS plus grand finit par compter.
Le problème sous passthrough
Sur du matériel nu, le BIOS règle le MPS pendant le POST en fonction de la topologie PCIe. Un BIOS serveur moderne règle en général le MPS au maximum que la topologie supporte, souvent 256 ou 512 octets.
Sous QEMU, le root complex du chipset Q35 virtuel a sa propre capacité MPS.
Par défaut, il présente un MPS bas.
La politique MPS par défaut du noyau Linux (pcie_bus_default) règle le MPS de chaque équipement sur celui de son pont parent, ce qui dans une topologie virtuelle veut dire la valeur par défaut du root complex de QEMU. Souvent 128 octets.
Du coup, un équipement capable de charges utiles de 512 octets tourne à 128 parce que le root complex virtuel a fixé le plafond.
Comment corriger — côté hôte
Dites au noyau de régler le MPS au maximum que le bus parent de chaque équipement supporte :
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Ceci règle le MPS de chaque équipement sur la plus grande valeur que son bus parent autorise. Ça règle aussi le MRRS (Max Read Request Size) en conséquence. Le source du noyau dit que ça garantit que le MPS d’un équipement ne dépasse pas celui de son parent. Ça garde la chaîne cohérente tout en obtenant les meilleures tailles de transfert.
Après redémarrage, vérifiez le nouveau MPS :
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Vous devriez voir MaxPayload 256 bytes ou MaxPayload 512 bytes au lieu du 128 par défaut.
Les autres options du noyau
Le noyau propose quatre politiques MPS, chacune réglée par le paramètre de démarrage pci= :
pcie_bus_tune_off — ne pas toucher au MPS du tout.
On garde ce que le BIOS a réglé.
Sur du matériel nu avec un bon BIOS, c’est souvent très bien.
Sous QEMU, le BIOS est OVMF ou SeaBIOS, qui n’optimisent pas forcément le MPS.
pcie_bus_default — la valeur par défaut du noyau.
Règle le MPS de chaque équipement sur celui de son pont amont.
Prudent et sûr, mais ne maximise pas les performances.
pcie_bus_safe — règle le MPS sur la plus grande valeur supportée par tous les équipements du système.
Utile pour les systèmes fermés où vous connaissez tous les équipements et où rien ne sera branché à chaud.
Un peu plus agressif que le défaut.
pcie_bus_perf — règle le MPS équipement par équipement sur la plus grande valeur que le bus parent autorise.
Chaque équipement obtient le meilleur MPS que sa topologie locale supporte.
C’est le bon choix pour le passthrough parce qu’il optimise chaque chemin indépendamment.
pcie_bus_peer2peer — règle le MPS à 128 octets sur tout.
Tous les équipements se parlent à la plus petite taille commune.
S’utilise quand des équipements doivent faire du DMA directement entre eux (GPU vers GPU, GPU vers carte réseau via RDMA).
Sans intérêt pour un passthrough classique.
pcie_bus_perf est le bon pour le passthrough.
Comment corriger — côté invité
Vous pouvez aussi mettre pci=pcie_bus_perf dans la configuration de démarrage du noyau invité.
Que ça ait un effet pratique dépend de la façon dont QEMU présente la topologie PCIe virtuelle.
Le root complex virtuel plafonne ce que l’invité peut négocier.
À l’usage, c’est la correction côté hôte qui tient. L’hôte possède l’équipement physique, et son réglage MPS fixe la taille réelle des TLP sur le fil. Le réglage de l’invité ne touche que la topologie virtuelle dans la VM, et savoir si ça change le comportement réel dépend de la façon dont QEMU présente le chemin PCIe pour cet équipement.
Réglez-le sur l’hôte. Le régler aussi dans l’invité ne fera pas de mal, mais ne comptez pas dessus seul.
Ce qu’est le MRRS
La Max Read Request Size (MRRS) est liée mais distincte. Le MPS limite la quantité de données qu’un équipement peut envoyer dans un TLP. Le MRRS limite la quantité de données qu’un équipement peut demander dans une requête de lecture.
Un équipement avec un MRRS de 4096 peut émettre une seule requête de lecture de 4 Kio. La réponse revient en plusieurs TLP, chacun d’au plus la taille du MPS. Un MRRS plus élevé veut dire que l’équipement peut demander plus de données par transaction, ce qui réduit le nombre de TLP de requête de lecture sur le bus.
pci=pcie_bus_perf règle à la fois le MPS et le MRRS à leurs valeurs optimales.
Vous n’avez pas besoin de les régler séparément.
Face aux autres réglages
L’écart de MPS entre 128 et 512 octets a moins d’impact sur les performances que l’alignement NUMA ou l’ASPM. C’est typiquement une amélioration de débit de quelques pour cent. Vous ne le verrez pas dans des tests de latence à faible profondeur de file.
Mais c’est une optimisation gratuite. Un paramètre noyau, aucun inconvénient, aucun risque de compatibilité. Il n’y a aucune raison de ne pas le régler sur un système qui fait du passthrough.
Ça ne coûte rien, et vous avez déjà payé le matériel. Autant avoir ce que vous avez acheté.
Références
- Kconfig PCI du noyau Linux — options de réglage MPS et MRRS — source faisant autorité pour les quatre politiques MPS
- Linux Plumbers Conference 2017 — MPS contre MRRS (PDF) — la présentation de Sinan Kaya sur la gestion MPS/MRRS dans le noyau