Ce qu’est le NUMA
NUMA veut dire Non-Uniform Memory Access, accès mémoire non uniforme. Sur un système mono-socket, tous les cœurs CPU accèdent à l’ensemble de la RAM du système par le même contrôleur mémoire. Le temps d’accès est le même quel que soit le cœur qui fait la demande et l’endroit où siègent les données en mémoire physique.
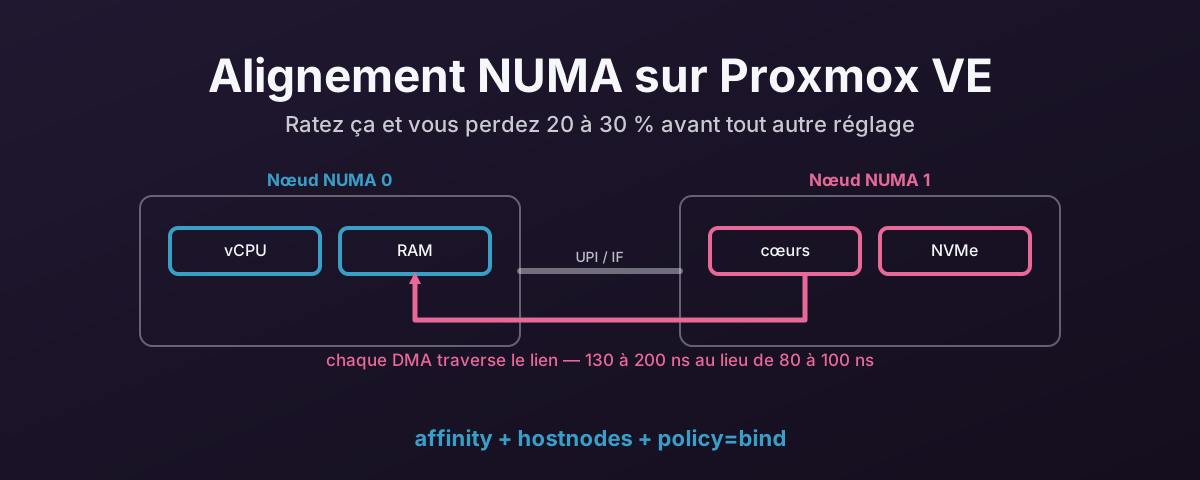
Sur un système multi-sockets, chaque socket CPU a son propre contrôleur mémoire et sa propre banque de RAM. Un cœur du socket 0 accède rapidement à la RAM rattachée au socket 0 — c’est la mémoire locale. Il peut aussi accéder à la RAM rattachée au socket 1, mais cette demande doit traverser le lien inter-socket (Intel UPI, AMD Infinity Fabric). C’est de la mémoire distante, et c’est plus lent.
Le noyau appelle nœud NUMA l’ensemble d’un socket et de sa mémoire locale. Un système bi-socket AMD EPYC a au moins deux nœuds NUMA. Certains processeurs EPYC exposent quatre nœuds NUMA par socket (un par CCD), ce qui donne huit nœuds sur une carte bi-socket.
L’écart de performance entre accès local et accès distant n’a rien de subtil. L’accès local tourne autour de 80 à 100 ns. L’accès distant autour de 130 à 200 ns. C’est une pénalité de 50 à 100 % par opération mémoire. Prise seule, c’est un très petit chiffre. Payée sur chaque accès mémoire pendant toute la vie de la VM, elle cesse d’être petite.
Pourquoi ça compte pour la virtualisation
Quand Proxmox crée une VM, il alloue des vCPU et de la RAM. Par défaut, ces vCPU peuvent être ordonnancés sur n’importe quel cœur physique de n’importe quel socket. La RAM de la VM peut être allouée depuis le pool mémoire de n’importe quel nœud NUMA.
Si l’ordonnanceur met un vCPU sur le socket 0 alors que la RAM de la VM est sur le socket 1, chaque accès mémoire de ce vCPU traverse le lien inter-socket. Si les vCPU rebondissent entre les sockets — ce qu’ils feront s’ils ne sont pas épinglés — le motif d’accès mémoire devient un fouillis. Certains accès sont locaux, d’autres distants, et les performances de la VM sautillent en conséquence.
Pour des charges générales — un serveur web, un serveur de fichiers, une VM bureautique — c’est souvent supportable. La surcharge est là mais elle se répartit sur beaucoup d’opérations et ne domine pas.
Pour des charges intensives en E/S — bases de données, serveurs de stockage, tout ce qui fait beaucoup d’E/S disque ou réseau — la pénalité se cumule. Chaque achèvement de DMA, chaque livraison d’interruption, chaque copie de tampon passe par la mémoire. Si ces accès traversent les sockets, la surcharge s’accumule vite.
Pourquoi ça compte pour le passthrough
Les équipements PCIe sont physiquement câblés à un socket CPU donné. Chaque socket a son propre root complex PCIe. Le disque NVMe du connecteur 3 est peut-être sur les lignes PCIe du socket 0. Le GPU du connecteur 5 est peut-être sur celles du socket 1.
Quand un équipement fait du DMA, les données vont dans la mémoire rattachée au nœud NUMA vers lequel l’IOMMU les dirige. Si la RAM de la VM est allouée depuis le nœud local de l’équipement, l’écriture DMA va directement en mémoire locale. Si la RAM est sur l’autre nœud, chaque opération DMA traverse le lien inter-socket.
Pour un disque NVMe qui fait des centaines de milliers d’IOPS, cette pénalité de 50 à 100 ns par opération s’additionne.
À iodepth=32 en lectures aléatoires de 4 Kio, l’écart de débit entre NUMA aligné et mal aligné peut atteindre 20 à 30 %.
Et ça, c’est avant d’avoir regardé la surcharge IOMMU, l’ASPM, le MPS ou quoi que ce soit d’autre.
La même chose vaut pour les cartes réseau, les GPU et tout autre équipement passé en passthrough. Le trafic DMA de l’équipement doit atterrir en mémoire locale, et les vCPU qui traitent ce trafic doivent être sur le même nœud.
Comment vérifier votre topologie
Trouver sur quel nœud NUMA se trouve un équipement
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Ceci renvoie le numéro du nœud NUMA.
Si ça renvoie -1, le noyau n’a pas pu déterminer le nœud. Ça arrive parfois avec des équipements derrière certains switches PCIe.
Dans ce cas, tracez la topologie PCIe à la main avec lspci -tv et faites correspondre le port racine au socket.
Voir votre disposition NUMA complète
numactl --hardware
Ceci vous montre chaque nœud NUMA, combien de cœurs CPU s’y trouvent, combien de mémoire y est rattachée, et la distance (coût relatif) entre les nœuds.
Exemple de sortie sur un système EPYC bi-socket :
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
La table des distances vous donne le coût relatif. 10, c’est local. 32, c’est distant. Des nombres plus élevés veulent dire plus de sauts. Sur des configurations EPYC à quatre nœuds par socket, certaines paires de nœuds sont à 32 et d’autres à 16, selon le CCD sur lequel elles se trouvent.
Faire correspondre les équipements aux nœuds
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Ceci vous donne une image complète des équipements et de leurs nœuds. Cherchez vos contrôleurs NVMe, vos cartes réseau et les GPU que vous passez en passthrough.
Comment aligner une VM sous Proxmox
Épingler les vCPU sur le bon nœud
Dans le fichier de configuration de la VM (/etc/pve/qemu-server/<vmid>.conf) :
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
Le paramètre affinity épingle les vCPU de la VM sur des cœurs physiques précis.
Réglez-le sur la plage de cœurs du même nœud NUMA que votre équipement en passthrough.
Si votre NVMe est sur le nœud 1 et que le nœud 1 a les cœurs 16 à 31, mettez affinity: 16-31.
Si la VM n’a besoin que de 8 vCPU, épinglez sur un sous-ensemble : affinity: 16-23.
Allouer la mémoire depuis le bon nœud
Activer numa: 1 dans la configuration de la VM dit à Proxmox de présenter une topologie NUMA à la VM.
QEMU tentera d’allouer la mémoire de la VM depuis le nœud NUMA où les vCPU sont épinglés.
Pour un contrôle explicite, vous pouvez fixer la topologie NUMA dans la configuration de la VM :
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Ceci dit à QEMU de lier le premier nœud NUMA de la VM (le nœud 0 du point de vue de l’invité) au nœud NUMA hôte 0, en utilisant les cœurs 0 à 7 et 16 Gio de mémoire.
Le policy=bind garantit que la mémoire est allouée strictement depuis ce nœud plutôt que de se rabattre sur d’autres nœuds si le pool local est sous pression.
Vérifier l’épinglage
Après avoir démarré la VM, vérifiez que les vCPU tournent bien là où vous le pensez :
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Erreurs courantes
Ne pas épingler du tout
Si vous ne réglez pas affinity, les vCPU de la VM peuvent être ordonnancés sur n’importe quel cœur.
L’ordonnanceur du noyau les déplacera entre les nœuds selon l’équilibrage de charge.
Chaque fois qu’un vCPU migre d’un nœud à l’autre, toutes les données sur lesquelles il travaillait dans le cache de l’ancien nœud deviennent distantes.
Pour des VM générales, c’est acceptable. Pour des VM en passthrough qui font beaucoup d’E/S, non.
Épingler sur le mauvais nœud
Vérifiez le nœud NUMA de l’équipement avant d’épingler.
Ne supposez rien.
Sur certaines cartes mères, la numérotation physique des connecteurs ne correspond pas au nœud NUMA de façon évidente.
Vérifiez toujours avec cat /sys/bus/pci/devices/.../numa_node.
Sur-souscrire un nœud
Si vous épinglez trop de VM sur le même nœud NUMA, les cœurs de ce nœud deviennent sur-souscrits et le pool mémoire local s’épuise. Quand la mémoire déborde sur le nœud distant, vous obtenez le pire des deux mondes : des vCPU épinglés avec de la mémoire distante.
Équilibrez le placement de vos VM entre les nœuds. Si vous avez deux nœuds NUMA et quatre VM, répartissez-les équitablement.
Oublier l’allocation mémoire
Épingler les vCPU sans contrôler aussi l’allocation mémoire ne vous donne que la moitié du bénéfice.
Les vCPU sont sur le bon nœud mais la mémoire n’y est peut-être pas.
Utilisez policy=bind ou, au minimum, activez numa: 1 pour que l’allocation de QEMU suive l’épinglage CPU.
Systèmes mono-socket
Sur un système mono-socket, tout est sur le nœud NUMA 0. Il n’y a qu’un contrôleur mémoire et un seul jeu de lignes PCIe. L’alignement NUMA n’est pas un sujet.
Vous pouvez quand même mettre numa: 1 dans la configuration de la VM — ça ne fera pas de mal — mais ça n’aidera pas non plus.
Un socket, un contrôleur mémoire, rien à aligner.
Gardez l’effort pour une machine qui en a deux.
Ainsi, les gains décrits ici ne valent que pour les systèmes multi-sockets, là où le lien inter-socket existe.
Références
- Guide d’administration Proxmox VE — configuration CPU et NUMA — la documentation officielle sur l’épinglage des vCPU et les options NUMA
- Documentation NUMA du noyau Linux — la référence sur la politique mémoire du noyau
- AMD EPYC série 7003 — guide de réglage BIOS et charges de travail (doc 58002) — la documentation d’AMD sur le NUMA par socket et la topologie CCD/CCX