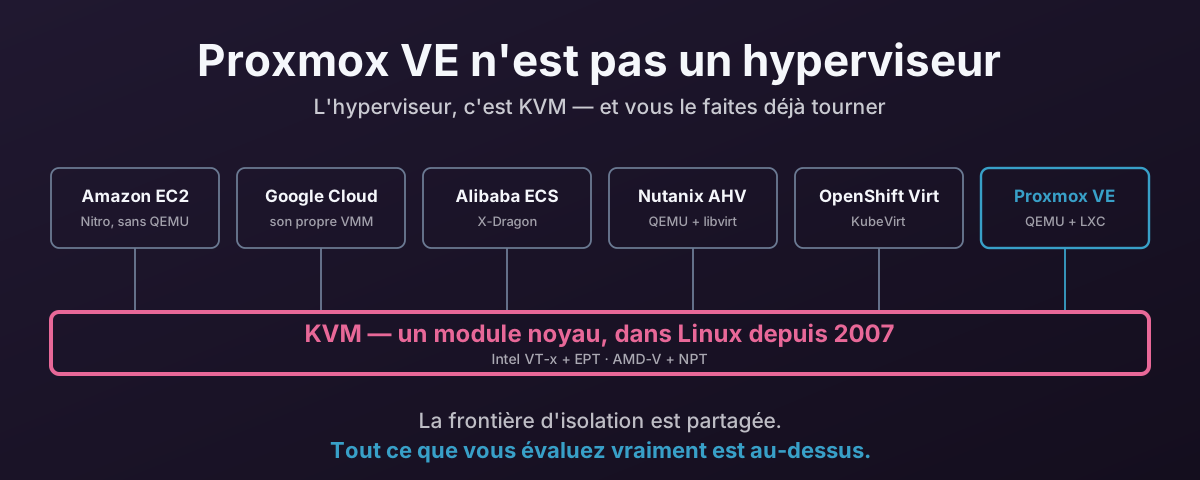
La question par laquelle commence toute évaluation de Proxmox
« Proxmox est-il vraiment de niveau entreprise ? »
Ça revient dans presque toutes les conversations de migration, et l’inquiétude qui se cache dessous ne porte presque jamais sur l’interface web. Personne ne craint sérieusement qu’un tableau de bord dans un navigateur corrompe ses données. Ce que les gens demandent, c’est si la chose qui se tient entre une machine virtuelle et le matériel — le composant qui doit tenir un locataire hors de la mémoire d’un autre, pour toujours, sans une seule erreur — est une pièce d’ingénierie sérieuse ou un projet communautaire devenu populaire.
C’est exactement la bonne chose dont s’inquiéter. Elle est juste visée à la mauvaise couche, parce que Proxmox VE ne contient pas d’hyperviseur.
L’hyperviseur, c’est KVM. Il fait partie de Linux, il y est depuis 2007, et si votre organisation utilise EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean ou Nutanix, vous le faites déjà tourner en production aujourd’hui — vous n’avez simplement jamais eu à y penser, parce que quelqu’un d’autre possédait les couches au-dessus.
Ce billet parle de ce que ce socle commun veut vraiment dire. Les deux moitiés : la part de l’argument qui tient réellement, et celle qui se fait surjouer dans les présentations d’éditeurs.
Proxmox VE est une couche de gestion
La virtualisation sur Linux, ce sont quatre couches distinctes, construites et maintenues par quatre groupes de gens différents.
1. Les extensions matérielles de virtualisation. Intel VT-x avec EPT, ou AMD-V avec NPT. Du silicium. C’est ce qui permet à un invité de faire tourner son propre noyau à la vitesse native avec ses propres tables de pages, sans que rien n’émule d’instructions.
2. KVM — l’hyperviseur.
Des modules noyau : kvm.ko pour le cœur indépendant de l’architecture, plus kvm-intel.ko ou kvm-amd.ko pour les extensions du fondeur. C’est le composant qui possède la frontière d’isolation. Il met en place les structures de contrôle de machine virtuelle de l’invité, traite les VM exits, gère les tables de pages de second niveau, et délivre les interruptions.
3. Le VMM — le moniteur de machine virtuelle, en espace utilisateur. Sur Proxmox VE, c’est QEMU. Il construit la carte mère virtuelle : chipset, topologie PCIe, disques, NIC, ports série, firmware. KVM fait tourner le CPU ; QEMU décide du matériel que l’invité croit avoir.
4. La couche de gestion.
C’est Proxmox VE : pve-manager et pveproxy pour l’API et l’interface, qemu-server pour transformer un fichier de configuration de VM en ligne de commande QEMU, pve-container pour LXC, pmxcfs par-dessus Corosync pour la configuration de cluster répliquée, pve-ha-manager pour le fencing et le redémarrage, plus la pile pare-feu et SDN.
Ces quatre couches existent aussi sur la plateforme que vous quittez, à faire les mêmes quatre travaux — vCenter est la couche 4, VMkernel la couche 2 — et je reviendrai sur cette comparaison une fois les pièces sur la table.
Ce que Proxmox maintient vraiment
Proxmox VE possède la couche 4 entièrement. Ce serait faux de dire qu’il se contente d’empaqueter les couches 2 et 3, et c’est la mélecture la plus fréquente de ce que fait l’entreprise.
pve-qemu porte 78 correctifs contre le QEMU amont dans son fichier de série au moment où j’écris :
debian/patches/series. L’essentiel de la file est de l’ingénierie propre à Proxmox, et l’ensemble siège dans la couche 3 — aucun de ces correctifs ne touche kvm.ko.Ils construisent aussi leur propre noyau, et maintiennent l’empaquetage ou des correctifs pour la plus grande partie de la pile alentour — pve-edk2-firmware pour OVMF, plus lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm et ceph.
La vraie frontière est donc : toute la couche 4, de l’ingénierie substantielle dans la couche 3, et un noyau qu’ils compilent. Ce qu’ils n’ont pas fait, c’est écrire un hyperviseur. Le code KVM de la couche 2 est du Linux amont.
Et rien de tout ça n’est un reproche fait à Proxmox. À ce titre, c’est la raison pour laquelle une entreprise de la taille de Proxmox peut être chargée du travail. Une petite société viennoise ne s’est pas assise pour écrire un hyperviseur de zéro ; elle a bâti sur un hyperviseur qu’Intel, AMD, Red Hat, Google, Amazon et IBM payaient déjà des ingénieurs pour maintenir, et a dépensé son propre effort sur la couche au-dessus et sur le travail d’intégration que cette couche demande. C’est là qu’une équipe de cette taille peut faire une différence, et la file de correctifs montre qu’elle la fait.
Ce qu’est réellement KVM
KVM veut dire Kernel-based Virtual Machine, et le nom est exact : c’est une fonction du noyau, pas un programme.
Chargez les modules et Linux gagne un équipement caractère, /dev/kvm, plus un petit jeu d’appels ioctl dessus — KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Cette interface est tout le contrat de l’hyperviseur. Tout ce qui sait ouvrir un descripteur de fichier et appeler ioctl peut créer des machines virtuelles.
Il a été écrit par Avi Kivity chez Qumranet et fusionné dans Linux 2.6.20, sorti en février 2007 — il y a dix-neuf ans. Red Hat a racheté Qumranet en 2008, et KVM est livré dans chaque version du noyau depuis, à la cadence habituelle de neuf à dix semaines. Il a été porté bien au-delà du x86 : arm64, POWER, s390 sur IBM Z, et RISC-V.
Le point d’architecture important, c’est pourquoi il est petit.
KVM n’a pas d’ordonnanceur, parce que Linux en a un. Un vCPU est un thread hôte ordinaire, et l’ordonnanceur complètement équitable le pose sur un cœur comme n’importe quel autre thread. Il n’a pas de gestionnaire de mémoire, parce que Linux en a un. La RAM invitée est une projection ordinaire en espace utilisateur, donc elle peut être paginée, adossée à des hugepages, ou placée sur un nœud NUMA avec la même machinerie que n’importe quel processus. Il n’a pas de pile de pilotes, ni de couche bloc, ni de pile réseau, ni de système de fichiers, parce que Linux les avait déjà tous et que ce sont ceux contre lesquels votre fabricant de matériel teste.
C’est ça, le vrai argument de maturité, et il est bien plus fort qu’un numéro de version. Chaque amélioration de l’équilibrage NUMA, chaque changement d’io_uring, chaque pilote réseau, chaque contournement d’errata CPU qui atterrit dans Linux atterrit sous vos machines virtuelles, parce qu’il n’y a pas de noyau d’hyperviseur séparé vers lequel quiconque devrait le porter.
L’argument du type 1 trace la ligne au mauvais endroit
L’objection qui suit, à tous les coups, c’est que KVM n’est « qu’un hyperviseur de type 2 ». Il tourne sur un système d’exploitation hôte, contrairement à ESXi, qui tourne sur le métal nu.
Cette taxinomie a trente ans de plus que la virtualisation matérielle, et la chose autour de laquelle elle traçait une ligne n’est plus là où chacun croit.
Ce qui se passe vraiment quand un vCPU tourne
QEMU appelle ioctl(vcpu_fd, KVM_RUN). Le contrôle passe dans kvm.ko, qui charge l’état CPU de l’invité et exécute VMLAUNCH. De cette instruction jusqu’au VM exit suivant, l’invité s’exécute directement sur le cœur physique, en mode invité, avec ses propres tables de pages actives via EPT, à pleine vitesse matérielle. Il n’y a rien en dessous qui interprète quoi que ce soit. Le « système hôte » n’est pas dans le chemin. Il ne tourne même pas sur ce cœur.
Quand l’invité fait quelque chose qui demande un traitement, le CPU sort vers l’hôte — et atterrit dans kvm.ko, dans le noyau, exactement au niveau de privilège qu’occupe le VMkernel d’ESXi. La plupart des exits sont résolus là même et réentrés sans que l’espace utilisateur soit jamais impliqué.
ESXi a exactement la même séparation
Regardez maintenant la plateforme qui est censée prouver la distinction.
La documentation d’architecture de VMware décrit VMkernel comme « a POSIX-like operating system » — un système d’exploitation de type POSIX — qui fournit « process creation and control, signals, file system, and process threads ». C’est un système d’exploitation, de la description de son propre auteur. Et une VM en marche sur ESXi n’est pas une chose à l’intérieur du noyau — c’est un groupe de processus userworld : un VMM par CPU virtuel, qui virtualise les instructions de l’invité et gère sa mémoire, et un processus VMX par VM, qui traite les I/O vers les équipements non critiques pour la performance et parle au gestionnaire d’instantanés et à la console distante.
Lisez ça en pensant à QEMU. Contexte d’exécution par vCPU dans le noyau, processus en espace utilisateur par VM qui fait l’émulation d’équipements et la gestion. VMware a fait la séparation pour la même raison que tout le monde.
Hyper-V n’est pas différent. La documentation de Microsoft est explicite : le Virtual Machine Worker Process, vmwp.exe, est « a user mode component of the virtualization stack », un composant en mode utilisateur de la pile de virtualisation, engendré par VM, et tous les équipements émulés y sont implémentés — tournant dans la partition racine, qui est Windows. Même Xen, l’architecture à laquelle la taxinomie va le mieux, a besoin d’un Linux généraliste dans dom0 pour fonctionner, et prend son modèle d’équipements pour les invités pleinement virtualisés chez QEMU.
Alors, où est la ligne ?
Le critère n’a jamais été « est-ce que ça utilise l’espace utilisateur ». La taxinomie de Goldberg, du début des années 1970, demande si l’hyperviseur est une application qui tourne sur un système d’exploitation préexistant, lequel possède déjà le matériel et fait l’ordonnancement. Ça, c’est un hyperviseur de type 2, hébergé : VMware Workstation, VirtualBox, Parallels Desktop, QEMU tout seul sans accélération. Vous installez un système généraliste, puis vous installez un programme dessus, et ce programme demande de la mémoire et du temps CPU au système comme n’importe quel autre programme.
Ce n’est pas ce qu’est KVM. kvm.ko n’est pas un programme au-dessus de Linux. Il fait partie de Linux, s’exécute au même niveau de privilège que le code qui possède le matériel, et quand un invité sort il atterrit là directement. Il n’y a pas de système hôte sous l’hyperviseur. Le noyau est l’hyperviseur. Proxmox VE livre ce noyau comme le système, exactement comme ESXi livre VMkernel comme le système.
Et la version « il a besoin de l’espace utilisateur, donc c’est du type 2 » ne peut pas être sauvée, parce qu’appliquée avec constance elle attrape tout le monde. Aucune VM ne tourne sur ESXi sans son processus VMX, aucune sur Hyper-V sans vmwp.exe, aucune sur Xen en invité HVM sans QEMU. Un test qui met tous les hyperviseurs du commerce dans le même seau ne distingue rien du tout.
| Noyau qui possède la virtualisation CPU et mémoire | Modèle d’équipements en espace utilisateur, par VM | A besoin d’un système hôte préexistant ? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX par VM | Non |
| Microsoft Hyper-V | l’hyperviseur plus la partition racine Windows | vmwp.exe | Non |
| Xen | l’hyperviseur Xen plus dom0 Linux | QEMU, dans dom0 ou dans un stub domain | Non |
| KVM | kvm.ko | QEMU | Non |
| VirtualBox, VMware Workstation | le noyau de l’hôte, via un pilote installé | l’application elle-même | Oui |
Quatre produits, une seule forme — puis une cinquième ligne qui est réellement différente. Cette dernière ligne est ce que « type 2 » a été inventé pour décrire, et c’est la seule où quelque chose d’autre était déjà aux commandes du matériel.
La taxinomie trace donc bien encore une ligne. Elle ne la trace simplement pas là où l’argument le suppose : KVM et ESXi sont du même côté. Appeler KVM du type 2, c’est emprunter un mot à la catégorie VirtualBox et l’appliquer à quelque chose qui est, architecturalement, dans la catégorie ESXi.
Ce qui laisse l’étiquette sans aucun travail utile dans une évaluation, puisque les deux produits entre lesquels vous choisissez sont dans la même case. Ce qui diffère n’est pas le numéro de type. C’est qu’un éditeur a aussi écrit le noyau et ne vous laissera pas le lire — une distinction de licence et de transparence déguisée en schéma d’architecture. Nutanix le montre commercialement : il livre le même code KVM que Proxmox et décrit AHV comme un hyperviseur de type 1 sur métal nu. Même code, étiquette opposée, service marketing différent.
Il y a bien une vraie inquiétude cachée dans l’accusation, et elle mérite un meilleur nom : un noyau généraliste fait un millier de travaux qu’un noyau à usage unique ne fait pas, ce qui fait plus de code et plus de surface d’attaque à côté de la frontière d’isolation. C’est légitime et mesurable, et j’y reviens vers la fin.
Où le travail se fait vraiment
Le seul endroit où l’instinct du « c’est sur un système hôte » a un vrai fond, c’est le traitement des exits, donc il vaut la peine d’être clair sur ce qui part où.
| L’invité fait ceci | Traité par | Coût |
|---|---|---|
| Touche une page pas encore projetée dans EPT/NPT | kvm.ko, dans le noyau | Un exit, des microsecondes |
| Écrit dans son APIC local | Le CPU lui-même, via APICv/AVIC | Souvent aucun exit du tout |
| Envoie une interruption inter-processeurs | Interruptions postées, en matériel | Souvent aucun exit |
Émet sur une file virtio-net avec vhost-net | Thread noyau, aucun passage par l’espace utilisateur | Un coup de sonnette |
| Lit un registre sur un e1000 ou un contrôleur IDE émulé | Jusqu’à QEMU | Un exit plus un aller-retour en espace utilisateur |
Seule la dernière ligne ressemble à la caricature du type 2 — et c’est aussi celle qu’on supprime par conception, en utilisant des équipements virtio et en ne présentant pas de matériel hérité émulé dont on n’a pas besoin. C’est le même raisonnement que derrière le choix de Q35 plutôt qu’i440fx : moins d’accès registre piégés, moins d’équipements hérités à parcourir.
Le système hôte est une fonctionnalité, pas du lest
L’autre moitié de ce bilan n’arrive jamais jusqu’à l’argument, alors la voici : un nœud Proxmox est une machine sur laquelle vous pouvez vraiment travailler. C’est du Debian, donc toute l’archive Debian est à un apt install.
- La supervision que vous faites déjà tourner — un exporteur de nœud Prometheus,
smartmontools, votre agent existant — plutôt que ce que l’appliance choisit d’exposer. - Du diagnostic quand quelque chose est lent :
fio,iperf3,nvme-cli,perf,bpftrace. - Des agents de sauvegarde de n’importe quel éditeur qui livre un binaire Linux.
- De la gestion de configuration, pour que l’hyperviseur siège dans le même inventaire Ansible que tout le reste au lieu d’être un cas particulier.
fwupdpour le firmware, sur du matériel dont le fabricant alimente LVFS.
Rien de tout ça ne demande un format de greffon, un paquet signé, ou la bénédiction de l’éditeur. Comparez avec le modèle ESXi, où le shell est délibérément restreint, où le code tiers arrive sous forme de VIB, et où il n’y a aucun gestionnaire de paquets vers lequel se tourner.
Ça atteint la pile de stockage
Les agents de supervision sont la version ennuyeuse de la chose. La documentation de stockage de Proxmox liste les greffons natifs — dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS — puis ajoute une phrase à prendre au pied de la lettre :
you may use all storage technologies available for Debian Linux
C’est une affirmation sur l’endroit où se trouve la frontière, et le mécanisme derrière elle est générique : amenez un équipement bloc sur chaque nœud, mettez du LVM dessus, ajoutez-le comme stockage LVM avec shared activé. C’est exactement ainsi que marchent les chemins Fibre Channel et iSCSI pris en charge, donc tout ce qui sait produire un équipement bloc partagé peut emprunter la même route.
NVMe over TCP ou RDMA est le cas qui vaut d’être connu, parce qu’il est rapide, actuel, et absent de cette liste de greffons. nvme-tcp et nvme-rdma sont des pilotes hôtes Linux dans l’arbre — NVMe/TCP est dans la branche principale depuis la 5.0 — donc il n’y a rien à compiler. nvme-cli est un paquet Debian (nvme discover, puis nvme connect), et nvmetcli configure la cible nvmet intégrée au noyau à l’autre bout. Un namespace connecté apparaît en /dev/nvmeXnY, et à partir de là c’est un équipement bloc ordinaire.
ATA over Ethernet fait le même point depuis l’autre extrémité du spectre — ancien, obscur, tout aussi absent de la liste des greffons. Le pilote aoe est dans la branche principale ; aoetools vous donne aoe-discover et aoe-stat ; vblade transforme n’importe quel fichier ou équipement bloc d’une autre machine en cible. Même route, même résultat.
Ce n’est ni une API de greffon, ni un SDK, ni un programme de certification. C’est ce qui arrive quand la couche de stockage de l’hyperviseur est la couche bloc de Linux.
Les réserves honnêtes, parce que ça se lit comme un tour de passe-passe jusqu’à ce qu’il soit 3 h du matin. Aucun de ces deux transports n’est un type de stockage Proxmox testé, donc l’intégration et ses modes de défaillance — comportement de reconnexion, multipath, délais sous charge — sont à vous d’assumer et à vous de tester avant que quoi que ce soit d’important n’y vive. Et l’AoE est un protocole de couche 2 nu, non routable et sans authentification, donc il a sa place sur un VLAN de stockage isolé et nulle part ailleurs. NVMe/TCP a au moins un modèle de découverte et peut être routé, ce qui est une grande partie de la raison pour laquelle c’est celui vers lequel se tourner aujourd’hui.
Qui d’autre fait tourner KVM
C’est de là que vient l’affirmation « vous le faites déjà tourner ». Chaque plateforme ci-dessous fait tourner le même module noyau.
| Plateforme | Où vous la croisez | La partie KVM | Le VMM en espace utilisateur |
|---|---|---|---|
| Amazon EC2 (Nitro) | Cloud public | Module noyau KVM | Sur mesure — QEMU retiré, modèle d’équipements dans les cartes Nitro |
| AWS Lambda, Fargate | Sans serveur | /dev/kvm | Firecracker — un moniteur de microVM minimal en Rust |
| Google Compute Engine | Cloud public | KVM depuis le lancement | Le VMM maison de Google, délibérément pas QEMU |
| Alibaba Cloud ECS | Cloud public | KVM simplifié (X-Dragon) | Sur mesure, avec réseau et stockage déportés sur une carte MoC |
| Oracle Cloud (OCI) | Cloud public | Oracle Linux KVM — la même pile qu’Oracle livre sur site | Lignée QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Cloud public | KVM standard | QEMU |
| Nutanix AHV | HCI sur site | KVM standard | QEMU avec libvirt et Open vSwitch |
| OpenStack (Nova) | Cloud privé | KVM standard | QEMU via libvirt — le pilote par défaut et le mieux testé |
| Apache CloudStack, OpenNebula, oVirt | Sur site | KVM standard | QEMU via libvirt |
| OpenShift Virtualization, SUSE Harvester | Kubernetes | KVM standard | QEMU dans un pod, via KubeVirt |
| Proxmox VE | Sur site | KVM standard | QEMU, avec LXC à côté pour les conteneurs |
Tout le monde garde la moitié noyau et réécrit la moitié espace utilisateur
Les hyperscalers n’ont pas forké KVM. Ils ont forké le travail de QEMU.
AWS a déplacé EC2 de Xen vers l’hyperviseur Nitro, bâti sur le module noyau KVM avec QEMU jeté entièrement. Le modèle d’équipements vit dans des cartes Nitro dédiées à la place, et c’est ainsi qu’ils obtiennent une performance indiscernable du métal nu. Chaque type d’instance EC2 de la génération actuelle fait tourner ça. Séparément, Lambda et Fargate font tourner Firecracker, un VMM en Rust bâti pour l’occasion qui parle au même /dev/kvm.
Google fait tourner chaque VM Compute Engine sur KVM depuis le lancement de Compute Engine, et a écrit son propre VMM en espace utilisateur plutôt que d’utiliser QEMU, explicitement pour éviter l’énorme matrice d’invités, d’équipements et de modes de QEMU. Ils sont aussi allés dans l’autre sens et ont durci le module noyau en amont, en retirant des équipements émulés dont personne n’avait besoin et en resserrant le jeu d’instructions émulées. Ce travail est dans le KVM que vous faites tourner.
Alibaba a fait la même chose avec X-Dragon : un hyperviseur KVM allégé avec la virtualisation réseau et stockage déportée sur une carte MoC à base de FPGA.
Nutanix AHV, c’est KVM plus libvirt plus QEMU plus Open vSwitch plus l’orchestration de Nutanix — de tous les produits commerciaux de cette liste, le plus proche parent de Proxmox VE. Une couche 4 différente, et une facture très différente.
Proxmox VE garde QEMU exprès
Il est tentant de lire le tableau comme un classement, avec AWS et Google en haut pour avoir remplacé QEMU. C’est la mauvaise lecture, parce que leur contrainte n’est pas la vôtre.
AWS et Google font tourner un seul profil matériel, à une échelle où un unique bug d’émulation d’équipement est un événement à l’échelle de la flotte, et ils contrôlent chaque frontière d’image invitée qui les intéresse. Dans ce monde-là, l’étendue de QEMU est presque intégralement un passif, donc le supprimer est manifestement juste.
Vous n’êtes pas dans ce monde-là.
Vous avez une appliance de 2013 qui veut un e1000. Vous avez une VM Windows dont le type de machine doit rester figé jusqu’à la fin de ses jours. Vous avez un GPU à passer, un contrôleur SAS émulé pour satisfaire un installeur, un magasin de variables UEFI à préserver. QEMU est exactement ce qui permet à une plateforme généraliste de dire oui à tout ça.
Ce qu’AWS appelle une surface d’attaque est ce que vous appelez une matrice de compatibilité. Les deux descriptions sont exactes ; la différence, c’est de savoir si vous choisissez vos charges de travail.
Ça explique aussi la forme de cette file de correctifs. AWS et Google ont résolu la sauvegarde et les instantanés en dehors du VMM, dans leurs propres services de stockage. Proxmox n’avait pas de service de stockage où les résoudre, alors ils les ont mis dans QEMU — et c’est pourquoi savevm-async et le pilote bloc PBS existent comme correctifs plutôt que comme produits.
Et ça vaut d’être su pour une raison pratique : les parties de Proxmox VE qui vous manqueraient le plus sont celles qui ne sont pas en amont. Vos configurations de VM sont du texte brut et vos images de disque sont des formats standard, donc une machine se déplacera. Mais un instantané qui inclut l’état de la RAM, et une chaîne incrémentale de Proxmox Backup Server, dépendent du fork QEMU de Proxmox. C’est une dépendance bien plus légère qu’un hyperviseur propriétaire — le fork est public, en AGPL, et vous pouvez lire chaque correctif dedans — mais elle n’est pas nulle, et « aucun enfermement au niveau logiciel » devrait porter cette note de bas de page.
Alors — est-ce de niveau entreprise ?
La forme paresseuse de cet argument ne marche pas, et il vaut mieux le dire franchement. « AWS utilise KVM, donc Proxmox VE est de niveau entreprise » est un non-sequitur : ça prend une affirmation sur une couche et l’applique discrètement à un produit entier.
Voici la version qui tient.
Ce qui est partagé, c’est la couche la plus difficile à réussir et la plus dangereuse à rater. La virtualisation du CPU et de la mémoire, et la frontière d’isolation entre locataires, c’est la partie où un bug est une brèche plutôt qu’une panne. Ce code est relu par des ingénieurs payés par Amazon, Google, Red Hat, Intel, AMD, IBM et Alibaba, et ses bugs sont trouvés par les organisations qui exploitent les plus grandes flottes qui existent — généralement avant que le noyau ne vous parvienne. Quand une vulnérabilité d’évasion d’invité arrive, le correctif vient par la mise à jour de noyau normale que vous alliez appliquer de toute façon. Vous n’attendez pas le cycle de publication d’un seul éditeur pour un hyperviseur que lui seul peut voir.
Ce qui n’est pas partagé, c’est tout ce qui est au-dessus de la frontière. Ce qui veut dire que la question s’effondre en deux questions bien plus faciles à répondre :
- La couche de gestion est-elle assez bonne pour votre façon d’exploiter ?
- Pouvez-vous acheter du support dessus à des conditions vivables ?
Les deux peuvent être testées dans une preuve de concept et écrites dans un contrat. Aucune ne demande de la foi en un hyperviseur.
C’est une bien meilleure position que celle que suppose la question de départ — qu’on vous demanderait de faire confiance à un hyperviseur inédit venu d’un petit éditeur. Ce n’est pas le cas. Le code propre à Proxmox est une couche de gestion surtout en Perl et de plus en plus en Rust, plus cette file de correctifs contre QEMU, et remarquez où les correctifs atterrissent : le modèle d’équipements et le chemin de sauvegarde, pas la frontière d’isolation.
Il vaut aussi la peine de savoir ce que coûte une défaillance de la couche propre à Proxmox. Les processus QEMU sont des processus indépendants ordinaires sur l’hôte, donc pveproxy qui s’écroule n’arrête pas une seule machine virtuelle. C’est un périmètre d’impact très différent de celui d’une perte du composant qui possède la frontière d’isolation.
Ce que « le même hyperviseur » ne vous achète pas
C’est là que les documents de confiance des éditeurs s’arrêtent d’habitude, ce qui vous dit quelque chose sur les gens à qui ils sont destinés. C’est la moitié la plus utile.
Ça ne vous achète pas la fiabilité d’AWS. La disponibilité de Nitro n’a que très peu à voir avec KVM. Elle vient du plan de contrôle, du tissu réseau, du service de stockage, de la gestion de capacité et de la pratique opérationnelle autour. La fiabilité de votre cluster viendra de la conception de votre quorum Corosync, de votre configuration de fencing, de votre choix de stockage et de votre redondance réseau. KVM n’a d’avis sur aucun de ces points. Partager un hyperviseur avec un hyperscaler ne fait pas hériter de son exploitation.
Ça ne vous achète pas la surface d’attaque de Nitro, et c’est là qu’atterrit la moitié légitime de l’accusation du type 2.
Vous faites tourner QEMU sur un noyau généraliste, et historiquement c’est dans le modèle d’équipements de QEMU que vivaient les évasions de VM mémorables — VENOM, dans un contrôleur de disquette émulé dont personne ne se servait, en est l’exemple canonique. Google pouvait noter à l’époque que Compute Engine n’était pas touché justement parce qu’il ne fait pas tourner QEMU. Vous, vous le faites tourner, donc les contrôles compensatoires sont à vous : préférez virtio au matériel émulé, ne présentez pas d’équipements dont vous n’avez pas besoin, laissez les profils AppArmor tranquilles, et patchez QEMU avec la même discipline que le noyau. Les correctifs extra/ de Proxmox sont eux qui font exactement ça pour vous, et c’est une chose raisonnable à vérifier qu’ils font toujours.
Ça ne rend pas le comportement des VM portable d’une plateforme à l’autre.
Le choix du modèle de CPU, le versionnage du type de machine, la compatibilité de migration à chaud et le comportement de l’horloge se décident tous dans les couches 3 et 4, et ils diffèrent partout. Un cluster de générations de CPU mélangées vous punira encore d’avoir mis le type de CPU à host, et les horloges invitées dérivent encore quel que soit le logo sur la plateforme. Même hyperviseur n’est pas même comportement.
Ça ne répond pas à la question du support — celle dont les achats se soucient réellement, et à juste titre. Proxmox VE est en AGPLv3 et libre d’usage en production. L’abonnement achète le dépôt testé pour l’entreprise et le support éditeur, à partir de 120 € par socket et par an. Le support de Proxmox lui-même est assuré aux heures ouvrables autrichiennes, donc une couverture permanente vient de partenaires plutôt que de Vienne. croit, où je travaille, est l’un de ces partenaires, et couvre 24 h/24, 365 jours par an. C’est une négociation commerciale, pas un risque technique — et que ce soit une négociation commerciale, c’est tout l’intérêt de ce qui précède.
Ce qu’il faut vraiment évaluer à la place
Si l’hyperviseur est réglé, une preuve de concept devrait passer son temps sur la couche qui est réellement propre à Proxmox VE :
- Le fencing et la haute disponibilité. Coupez l’alimentation d’un nœud qui héberge des invités HA et chronométrez le redémarrage. Puis faites-le à deux nœuds et confirmez que les restants se comportent comme vous l’attendez quand le quorum est perdu.
- La migration à chaud entre générations de CPU. Avec le modèle de CPU que vous comptez réellement standardiser, pas
host. - La sauvegarde et, plus important, la restauration. Les temps de restauration sous charge, pas les temps de sauvegarde. Personne n’a jamais été remercié pour une sauvegarde rapide.
- Le modèle de permissions. Savoir si vous pouvez donner à une équipe applicative la console et le contrôle d’alimentation sur ses propres VM et rien d’autre, assez finement pour satisfaire un auditeur.
- L’API. Tout ce que fait l’interface web est un appel d’API ; si votre automatisation ne sait pas la piloter, la plateforme ne collera pas à votre façon de travailler.
- Le chemin de mise à jour. Une montée de version majeure sur le cluster de test, avant d’avoir 400 VM dessus.
Aucune de ces questions ne porte sur KVM. C’est bien tout le propos.
L’hyperviseur est la partie réglée. Passez la preuve de concept sur les parties qui ne le sont pas.
Références
KVM lui-même
- KVM API documentation — l’interface ioctl de
/dev/kvm, qui est tout le contrat de l’hyperviseur - Linux 2.6.20 release notes — la version dans laquelle KVM a été fusionné, février 2007
- Some KVM developments — LWN, janvier 2007, sur KVM dans les jours qui ont suivi son arrivée dans la branche principale
Comment les autres hyperviseurs sont bâtis
- Interpreting virtual machine monitor and executable failures — la description par Broadcom lui-même d’une VM ESXi en marche comme « several processes or userworlds », avec un VMM par vCPU et un VMX par VM
- The Architecture of VMware ESXi (PDF) — le livre blanc qui appelle VMkernel « a POSIX-like operating system », avec des processus, des signaux, un système de fichiers et des threads. Lié via un miroir parce que l’URL VMware d’origine n’a pas survécu à la réorganisation Broadcom, ce qui est en soi un petit commentaire sur la continuité des éditeurs
- Hyper-V architecture — Microsoft sur le Virtual Machine Worker Process comme composant en mode utilisateur, un par VM, où vivent tous les équipements émulés
- The Nutanix Bible — AHV architecture — AHV décrit comme KVM avec libvirt, QEMU et Open vSwitch
Qui fait tourner KVM, et comment ils l’ont changé
- 7 ways we harden our KVM hypervisor at Google Cloud — Google sur l’exécution de KVM sans QEMU, et le durcissement amont qu’ils ont fait
- The AWS Nitro System — quels types d’instances EC2 font tourner l’hyperviseur Nitro
- AWS EC2 Virtualization 2017 : Introducing Nitro — le compte rendu de Brendan Gregg sur la transition de Xen à KVM, toujours le plus clair sur le sujet
- Firecracker — le VMM minimal d’AWS basé sur KVM, derrière Lambda et Fargate
- Alibaba Cloud’s sixth-generation ECS instances — l’hyperviseur X-Dragon et le déport MoC
- KubeVirt — le modèle QEMU/KVM dans un pod derrière OpenShift Virtualization et Harvester
- OpenStack Nova hypervisor support matrix — KVM comme pilote de référence
Ce que Proxmox maintient
- The Proxmox GitHub organisation — 89 dépôts, dont
pve-qemu,pve-kernel,pve-edk2-firmwareet l’empaquetage delxc,zfsonlinux,openvswitch,libiscsi,corosync-pveetceph pve-qemupatch series — les 78 correctifs comptés plus haut, et le moyen le plus rapide de voir exactement ce que Proxmox ajoute à QEMU- Proxmox VE storage documentation — la liste des greffons natifs, quels types de stockage sont partagés, et la phrase sur l’usage de toutes les technologies de stockage disponibles pour Debian Linux
nvme-clietnvmetcli— l’outillage hôte et cible NVMe-oF ;aoetoolsetvbladepour l’équivalent ATA over Ethernet. Tous dans Debian trixie, sur lequel Proxmox VE 9 est bâti- Proxmox VE pricing and subscription tiers — ce que couvre l’abonnement
Divulgation : je travaille pour croit, un Proxmox Gold Partner. Les affirmations techniques ci-dessus sont sourcées et vérifiables ; le paragraphe commercial est la partie où j’ai un intérêt, alors traitez-le en conséquence.