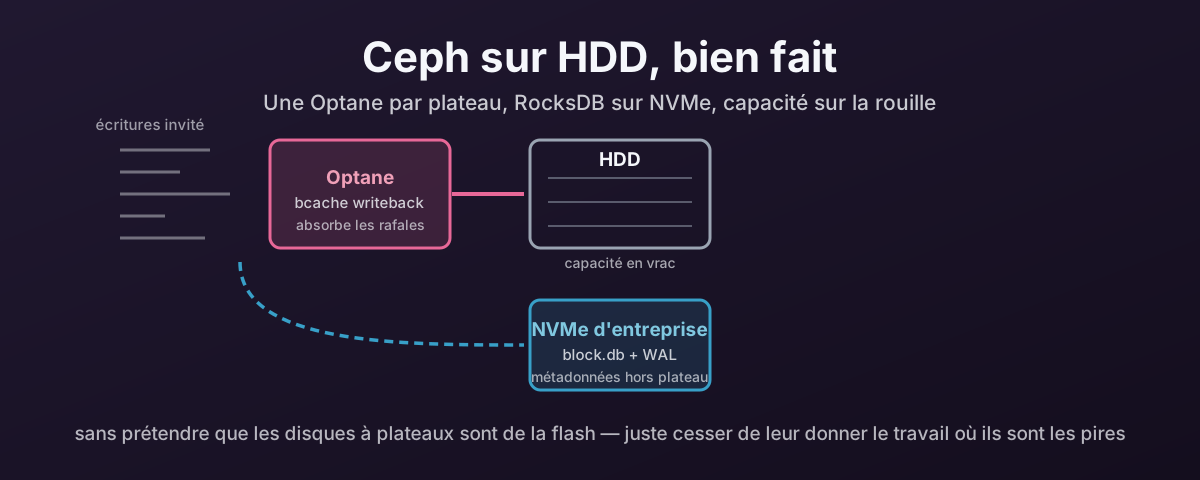
Pourquoi les HDD reviennent au menu
Pendant des années, le conseil était assez simple pour tenir sur un post-it : mettez tout sur des SSD.
Ce conseil était juste, et il était aussi bon marché. Ni l’un ni l’autre n’est tout à fait vrai maintenant. L’offre de NAND s’est resserrée, la demande d’IA a poussé le prix de la flash vers le haut, et le NVMe de grande capacité est devenu difficile à justifier pour un déploiement Proxmox soucieux des coûts — le genre qui doit être opérationnel, fiable, et aussi peu cher que l’honnêteté le permet.
Les HDD d’entreprise sont de nouveau intéressants pour la raison qu’ils l’ont toujours été : la capacité par livre, et rien d’autre n’en approche.
Le hic est que quiconque a fait tourner des VM sur des disques à plateaux sait à quel point cela peut mal tourner. Cette expérience est réelle, et c’est d’ordinaire la faute de l’architecture plutôt que des disques.
Blâmer les disques est plus facile, notez bien. C’est aussi faux, et c’est cher, parce que cela pousse les gens à acheter de la flash dont ils n’avaient pas besoin.
Tout ce qui suit suppose Proxmox avec des OSD Ceph hyper-convergés, parce que c’est là que les décisions de disposition mordent réellement.
Le problème est la latence, pas le débit
Un HDD d’entreprise moderne déplace parfaitement bien de grandes données séquentielles. Ce n’a jamais été le goulot d’étranglement.
Un disque d’entreprise à 7,2k tr/min livre quelque part autour de 80 à 100 IOPS de travail aléatoire, parce que chaque opération aléatoire attend un déplacement de tête et une rotation de plateau. Ce nombre n’a quasiment pas bougé en vingt ans. C’est de la mécanique, pas de l’électronique. Un SSD d’entreprise d’entrée de gamme en est à trois ou quatre ordres de grandeur.
Donnez au même disque un travail séquentiel et c’est un périphérique utile. Le taux d’opérations double à peu près, à environ 200 IOPS, mais chacune de ces opérations porte maintenant un grand bloc parce que la tête est déjà au bon endroit et peut continuer à diffuser. Vous obtenez donc un vrai débit, 150 à 250 Mo/s, à un prix par téraoctet que rien d’autre ne touche.
C’est là l’asymétrie importante, et ce n’est pas « les HDD sont lents ». Un disque à plateaux est bon en travail séquentiel et désespérant en travail aléatoire, et les deux nombres ne sont proches que parce que la chose bornée est le nombre d’opérations, pas les octets.
Ce qui fixe tout le cahier des charges. Vous n’essayez pas de rendre le disque plus rapide. Vous ne le pouvez pas. Vous essayez de faire en sorte qu’il passe son temps dans le mode où il est déjà compétent, et de garder le petit trafic aléatoire loin de lui. À ce titre, tout ce qui suit est cette seule idée appliquée deux fois.
Le problème est que les machines virtuelles ne génèrent pas la charge où les HDD sont bons. Elles génèrent des mises à jour de métadonnées, des écritures de journal, de petits vidages synchrones, de la journalisation, de l’entretien de système de fichiers, et des rafales d’activité aléatoire d’une douzaine d’invités à la fois qui arrivent entrelacées au disque.
Ceph ajoute sa propre couche à cela. Chaque écriture porte des mises à jour de métadonnées RocksDB à côté des données. Si tout cela atterrit sur des plateaux nus, les disques passent leur temps à se déplacer au lieu de servir, et vous obtenez le symptôme que chaque administrateur reconnaît : une attente d’E/S élevée, des invités poussifs, une réactivité incohérente, et un cluster qui paraît bien plus lent que ne le suggère sa fiche de capacité.
Les propres conseils matériels de Ceph sont directs sur où cela mène. Ils avertissent de « consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB » — de bien peser l’avantage apparent du coût par gigaoctet des gros HDD contre les limites d’IOPS par To — et disent que les disques au-dessus de 8 To « may be best suited for storage of large files / objects that are not at all performance-sensitive ».
Il vaut de faire cette arithmétique, parce que les disques qui rendent ceci économique en premier lieu sont de grands disques. 20 To et plus. Un disque de 20 To fait encore ses 80 à 100 IOPS aléatoires, parce que la capacité ne vous achète aucune opération. Il offre donc environ 4 à 5 IOPS aléatoires par téraoctet, là où un disque de 8 To en gère à peu près onze, et un de 2 To quarante.
À la propre mesure de Ceph, alors, un plateau de 20 To est bien à l’intérieur du territoire où il vous dit de ne pas mettre de charges sensibles à la performance.
Ce n’est pas un argument contre leur achat. C’est la raison pour laquelle le reste de ce billet existe. La conception ci-dessous est exactement ce qui rend un plateau de 20 To viable pour du stockage de VM, en faisant en sorte que le petit travail aléatoire ne l’atteigne jamais.
Sortir les métadonnées du plateau
Le changement de plus grande valeur pour un cluster sur HDD est de cesser de faire stocker au plateau la comptabilité de Ceph.
BlueStore garde trois choses par OSD : les données elles-mêmes sur block, la base de métadonnées RocksDB sur block.db, et le journal d’écriture anticipée sur block.wal. Par défaut, les trois vivent sur le même périphérique. Mettez block.db sur NVMe à la place et une grande quantité de petites E/S aléatoires quitte le disque entièrement.
La documentation matérielle de Ceph le dit clairement : « HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD » — les OSD HDD peuvent voir une amélioration notable de la latence d’écriture en déchargeant WAL+DB sur un SSD.
Utilisez du vrai NVMe d’entreprise ici, pas de la flash grand public. La raison n’est pas les chiffres de test d’affiche. C’est une latence stable sous charge soutenue, et la protection contre la coupure de courant. La documentation de Ceph est directe : « Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP) » — les SSD de classe entreprise sont les meilleurs pour Ceph, ils ont la protection contre la coupure de courant — et « bargain client-class or off-brand SSDs are a false economy » — les SSD grand public à prix cassé ou sans marque sont une fausse économie.
Les disques de la classe Samsung PM9A3 et Micron 7450 Pro sont le genre de chose qui a sa place ici. Sous pression d’écriture, Ceph se soucie de la cohérence bien plus que des chiffres de pointe, et c’est exactement ce qui sépare un disque d’entreprise d’un disque grand public rapide.
Dimensionner block.db, et ce que coûte le débordement
Trompez-vous de taille et le bénéfice s’évapore en silence, parce que quand block.db se remplit, RocksDB n’échoue pas — il déborde de nouveau sur le périphérique lent, exactement là où il aurait été sans le NVMe.
C’est le pire des deux mondes : vous avez acheté la flash et vous vous déplacez encore sur le plateau.
Les conseils Ceph actuels :
| Charge | block.db en fraction de block |
|---|---|
| RBD / bloc — disques de VM | 1 % à 2 % |
| RGW / objet | au moins 4 % |
| Recommandation générale en déchargeant WAL+DB | au moins 2,5 % |
Le stockage de VM Proxmox est la ligne RBD, donc 1-2 % est le chiffre de planification honnête, et 2,5 % est un endroit confortable où se tenir.
Passez cela contre un disque de 20 To et les nombres attirent votre attention :
block.db pour un OSD de 20 To | |
|---|---|
| À 1 % | 200 Go |
| À 2 % | 400 Go |
| À 2,5 % | 500 Go |
Prenez cela avec les paliers de niveau RocksDB ci-dessous et 300 Go par OSD est le point d’atterrissage sensé. Le palier utile le plus proche du milieu de la fourchette.
Ce qui change ce qu’est réellement le périphérique de métadonnées partagé. Huit OSD de 20 To veulent 2,4 To de NVMe entre eux ; quinze d’entre eux, le maximum annoncé par Ceph derrière un seul NVMe, veulent 4,5 To. Sur des disques aussi grands, c’est la capacité de DB qui décide combien d’OSD siègent derrière un périphérique, pas le ratio. Vous manquerez de gigaoctets bien avant de manquer de la bénédiction de Ceph.
Il y a une subtilité de plus à connaître, parce qu’elle rend le dimensionnement intuitif faux. La structure en niveaux de RocksDB veut dire qu’une partition DB ne peut pleinement utiliser que des tailles correspondant aux sommes de ses niveaux — produisant historiquement des paliers utiles autour de 3 Go, 30 Go et 300 Go, les tailles intermédiaires n’offrant rien de plus que le palier en dessous. Arrondir 18 Go à 30 Go est souvent gratuit en pratique ; l’arrondir à 20 Go ne vous achète rien de plus que 3 Go dans le pire cas.
Vérifiez le débordement une fois que le cluster a tourné un moment, pas au premier jour. C’est un problème à apparition lente.
Vous n’avez pas besoin d’un périphérique WAL séparé
Celui-ci économise une partition et beaucoup de tripatouillage.
Si vous spécifiez un périphérique DB et aucun périphérique WAL explicite, Ceph met le WAL sur le périphérique rapide avec la DB automatiquement. La documentation indique que « whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device » — chaque fois qu’un périphérique DB est spécifié mais pas un WAL explicite, le WAL sera implicitement colocalisé avec la DB sur le périphérique plus rapide.
Donc « mettez la DB et le WAL sur NVMe » est le bon objectif, mais c’est un argument, pas deux. Un block.wal séparé n’a de sens que si vous avez un troisième palier plus rapide où le mettre.
Couper le cache d’écriture du HDD
Petit, sans éclat, et facile à rater.
La documentation de Ceph note que la performance d’un OSD « may be dramatically increased … by disabling this write cache » — peut être dramatiquement augmentée en désactivant ce cache d’écriture — sur les HDD. Le cache volatil dans le disque réordonne et retarde les écritures d’une façon qui combat la sémantique de vidage de Ceph, et le couper rend d’ordinaire les choses plus rapides plutôt que plus lentes.
Cela devient obligatoire plutôt que conseillé dès que bcache est en jeu, ce qui est la section suivante.
Pendant que vous y êtes : vous n’avez pas besoin d’un HBA capable de RAID. Ceph le dit directement : « You do not need an RoC (RAID-capable) HBA » — vous n’avez pas besoin d’un HBA capable de RAID. Donnez les disques aux OSD.
Une Optane par plateau
Sortir les métadonnées du disque corrige le régime établi. Cela ne corrige pas les rafales, parce qu’une rafale de petites écritures synchrones doit encore être acquittée, et le plateau acquitte encore à la vitesse du plateau.
C’est pour cela que bcache existe, et ce qui le fait marcher ici est l’Optane.
Ce qui compte n’est pas la capacité. C’est le comportement sous charge d’écriture. Face à la NAND, l’Optane offre une très faible latence, une très haute endurance, et aucune des falaises de ramasse-miettes qui rendent imprévisible la performance de cache d’écriture d’un SSD une fois qu’il a servi un moment. Absorber du trafic petit, en rafales, lourd en écriture est la chose où il est le meilleur au monde.
La disposition qui compte : une Optane par HDD, chaque paire son propre périphérique bcache. Pas une Optane partagée sur une étagère de disques.
L’appariement est un choix délibéré, et il achète deux choses.
Pas de contention. Chaque plateau obtient à lui seul toute la latence et la profondeur de file d’une Optane, plutôt que de faire la queue derrière les rafales de sept autres OSD.
Un domaine de défaillance que Ceph sait déjà survivre. Un cache d’écriture partagé tient des données sales pour chaque OSD derrière lui, donc le perdre les perd tous à la fois ; apparié un-pour-un, perdre une Optane coûte exactement un OSD. Cette distinction est la conséquence la plus importante de cette conception, et elle a son propre traitement dans ce que vous abandonnez.
Ceci doit être de l’Optane. Pas de la NAND.
Le mot « Optane » n’est pas une préférence de marque ni un agrément ici. Substituer un NVMe NAND — si cher soit-il — construit quelque chose qui s’use, et la raison est l’endurance.
Regardez où siège le périphérique de cache. Parce que cette conception coupe le contournement séquentiel de bcache — le sequential_cutoff=0 dans la règle ci-dessous — chaque écriture vers cet OSD passe par lui : pas seulement les rafales, tout. Cela fait du cache le périphérique au plus fort cycle de service du nœud, à qui l’on demande d’absorber le volume d’écriture d’un disque à plateaux entier pour la vie de la machine.
L’endurance se cite en écritures de disque par jour, et l’écart n’est pas incrémental :
| Périphérique | Endurance notée |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| NAND d’entreprise à forte écriture, haut de gamme | environ 10 DWPD |
| NAND d’entreprise à usage mixte | 3 DWPD ou moins |
| NAND d’entreprise grand public — classe PM9A3, 7450 Pro | environ 1 DWPD |
L’Optane est entre dix et cent fois l’endurance de la NAND que vous mettriez sinon là. Mettez un disque à 1 DWPD dans la seule position qui reçoit chaque écriture du cluster et vous n’avez pas construit un cache, vous avez construit un consommable.
C’est pire que ne le suggère le tableau, parce que la NAND souffre d’amplification d’écriture en interne et l’Optane non. Le DWPD noté d’un disque NAND est ce qu’il encaisse à l’interface ; ce que ses cellules absorbent réellement est plus grand. Le nombre de l’Optane n’a pas besoin d’un tel astérisque.
Les reconstructions sont là où cela se teste. Le backfill pousse des téraoctets d’écritures à travers les nœuds survivants dans une fenêtre comprimée, chaque octet à travers leurs périphériques de cache — un événement d’endurance, pas seulement de latence, arrivant exactement quand vous voulez le moins qu’un second périphérique lâche.
Les deux paliers de flash veulent donc des disques différents, pour des raisons différentes :
| Palier | Volume d’écriture | Ce dont le périphérique a besoin |
|---|---|---|
| DB/WAL | petit — RocksDB seulement | Un NVMe d’entreprise rapide. Faible latence, IOPS aléatoires élevés, PLP. La NAND d’entreprise est la bonne technologie ; un PM9A3 ou 7450 Pro est le bon achat |
| Cache d’écriture | tout | PLP et endurance dans les dizaines de DWPD. La NAND est la mauvaise technologie à tout prix |
Acheter un seul genre de disque pour les deux travaux est l’erreur que cette section existe pour prévenir — mais ne lisez pas la première ligne comme une permission d’économiser, parce que un faible volume d’écriture n’est pas une faible exigence.
Le périphérique DB/WAL doit encore être un NVMe vraiment rapide, pour trois raisons qui n’ont rien à voir avec combien d’octets le traversent.
Il sert chaque OSD derrière lui à la fois, donc la file qu’il voit est quatre ou quinze jeux de trafic de métadonnées, pas la valeur d’un seul disque.
Sa latence atterrit directement sur vos clients. Les recherches RocksDB sont sur le chemin critique pour trouver des objets, pour le peering et pour le scrub, et ce sont de petites lectures aléatoires. La charge où l’écart entre un NVMe rapide et un médiocre est le plus large. Chaque microseconde est multipliée par chaque OSD qui en dépend.
Et la compaction se fait en rafales. RocksDB réécrit périodiquement ses niveaux, transformant un brassage régulier en un pic concentré de lectures et d’écritures. Un périphérique qui gère la moyenne et cale sur le pic cale chaque OSD derrière lui au même moment.
Les propres ratios de Ceph sont l’indice. Il permet trois fois plus d’OSD derrière un NVMe que derrière un SSD SATA, et c’est l’interface et la classe de périphérique qui parlent, pas la capacité. Utilisez du NVMe.
Donc : le périphérique de cache doit être de l’Optane, le périphérique DB/WAL peut être de la NAND, et aucune de ces positions n’est là où vous économisez de l’argent.
Quelle Optane : une M10 de 32 Go ferait souvent l’affaire
Rien de cela ne veut dire que la plus grosse Optane est la bonne. Le périphérique dont vous avez besoin est décidé par votre charge d’écriture — mais il se trouve que le marché de l’occasion peut le décider pour vous de toute façon. L’arithmétique compte quand même, parce qu’elle vous dit ce que vous sur- ou sous-achetez.
Partez de ce à quoi sert le cache. Il tient une rafale, pas un disque. À writeback_percent=40, un périphérique de 32 Go donne à peu près 13 Go de tampon sale, ce qui est un très grand nombre de petites écritures synchrones.
Ne soyez donc pas rebuté par le ratio. Un module de 32 Go devant un disque de 20 To en est 0,16 %, ce qui paraît absurde jusqu’à ce que vous vous rappeliez que c’est un absorbeur de rafales plutôt qu’un cache d’ensemble de travail essayant de tenir des données chaudes. Un périphérique de 375 Go devant le même disque en est 1,9 %, ce qui est simplement plus de marge que vous n’en utiliserez.
Ce qui met le bas de gamme en jeu. Voici le petit module grand public face à la pièce de centre de données, parce que l’écart n’est pas là où les gens l’attendent :
| Optane Memory M10 32 Go | Optane DC P4800X 375 Go | |
|---|---|---|
| Lecture aléatoire, 4K | 240 000 IOPS | 550 000 IOPS |
| Écriture aléatoire, 4K | 65 000 IOPS | comparable à la lecture |
| Lecture séquentielle | 1 200 Mo/s | 2 400 Mo/s |
| Écriture séquentielle | 290 Mo/s | 2 000 Mo/s |
| Latence typique | — | sous 10 µs |
| Endurance | 365 TBW | 12,3 PBW — 30 DWPD |
| Interface | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 ou AIC |
Regardez d’abord la ligne des IOPS d’écriture. La petite M10 fait 65 000 écritures aléatoires par seconde ; le plateau derrière elle en fait 80. Même l’Optane la moins chère est à peu près 650 fois le disque qu’elle cache, donc sur l’axe de la performance l’argument est clos avant de commencer. Les IOPS supplémentaires de la pièce DC n’ont nulle part où aller quand il y a un disque à 7,2k en aval.
La ligne qui décide l’achat est l’endurance, où l’écart est de 34×. Traduite en budget quotidien sur une vie de cinq ans :
| Périphérique | Écritures soutenables par jour, sur cinq ans |
|---|---|
| M10 32 Go — 365 TBW | environ 200 Go/jour |
| P4800X 375 Go — 12,3 PBW | environ 6,7 To/jour |
Sous 200 Go d’écritures par jour, une M10 de 32 Go tient toute la vie du montage. Au double de cela, vous obtenez deux ans et demi. Vraiment lourd en écriture et la pièce DC gagne son prix — pas pour les IOPS, que vous ne pouvez pas utiliser, mais pour la trentaine de fois plus d’écriture qu’elle tolère.
Alors mesurez plutôt que de deviner. nvme smart-log sur un périphérique de cache existant vous donne data_units_written ; échantillonnez-le à une semaine d’écart, divisez, et comparez au TBW noté de ce que vous envisagez. bcache garde ses propres totaux sous /sys/block/bcacheN/bcache/stats_total/ si vous préférez le lire là.
Deux réserves sur la M10. Ses chiffres aléatoires sont cités sur une étendue de 8 Go plutôt que sur tout le périphérique, donc sur un cache que vous comptez faire tourner substantiellement plein, traitez-les comme le bout optimiste. Et c’est une pièce grand public ne portant aucune revendication de PLP d’entreprise — le média de l’Optane est écrit sur place sans tampon DRAM dans le chemin d’écriture, ce qui est pourquoi ces modules se comportent bien mieux à une coupure de courant soudaine que la NAND grand public ne le ferait, mais « se comporte bien en pratique » n’est pas une spécification. Si vous voulez la garantie par écrit, achetez une pièce de série DC.
Le plancher est la bande passante, pas la capacité — sautez les modules de 16 Go
Il y a une seconde contrainte, indépendante de tout ce qui précède, et elle disqualifie la pièce la moins chère de la gamme.
Le cache doit être plus rapide que le disque en séquentiel, sinon c’est un étranglement. La M10 de 16 Go ne l’est pas, et c’est le module qui vous tentera le plus parce qu’il est presque gratuit :
| Écriture séquentielle | |
|---|---|
| Optane Memory M10 16 Go | 150 Mo/s |
| Optane Memory M10 32 Go | 290 Mo/s |
| Optane DC P4800X 375 Go | 2 000 Mo/s |
| Un HDD d’entreprise à 7,2k | 150-250 Mo/s |
Lisez la première et la dernière ligne ensemble. Un module de 16 Go écrit en séquentiel à peu près à la même vitesse que le disque à plateaux qu’il est censé accélérer, et plus lentement qu’un bon. Il reste énormément plus rapide en travail aléatoire — 35 000 IOPS d’écriture aléatoire contre les 80 du disque — mais sur un flux séquentiel il est au mieux à égalité et au pire un plafond sous ce que le disque nu gérait sans aide.
Et cette conception vous garantit d’atteindre ce plafond, parce que couper le contournement séquentiel envoie tout par le cache, faisant de la propre bande passante d’écriture séquentielle du cache le plafond dur de tout l’OSD. La récupération est là où cela mord le plus fort : backfiller un OSD de 20 To est à peu près aussi séquentiel que cette charge le devient, et le plafonner à 150 Mo/s rend une reconstruction déjà lente plus lente.
La ligne M10 a donc un plancher à 32 Go, et c’est un plancher de bande passante plutôt que de capacité. L’arithmétique de capacité disait que 32 Go était ample ; l’arithmétique de bande passante écarte les 16 Go quelle que soit la petitesse de ce que vous aviez à stocker. Les deux tests doivent passer, et la pièce bon marché échoue à celui que les gens ne vérifient pas.
Quoi que vous envisagiez, mettez son chiffre d’écriture séquentielle à côté de 250 Mo/s avant de l’acheter.
Acheter un produit que personne ne fabrique plus
L’Optane est abandonnée. Intel a mis fin à l’activité en 2022, passant en pertes 559 millions de dollars de stock et arrêtant le développement. Il n’y a pas de nouvelle production et pas de réapprovisionnement ; l’offre totale ne fait que baisser à partir d’ici.
Ce qui pose une question évidente, parce qu’il y en a une quantité surprenante en vente. Comprendre d’où elle vient vous dit ce que vous achetez.
C’est du stock de pièces de rechange de service OEM en cours de liquidation. Les trois grands fabricants de serveurs ont stocké de l’Optane comme pièces de rechange pour prendre en charge les plateformes où ils l’ont vendue. Ces plateformes sont arrivées en fin de vie et sont sorties du support, donc les pièces qui les soutenaient sont devenues du stock mort du jour au lendemain — des entrepôts de pièces pour des machines que personne n’est plus contractuellement obligé de réparer. Ce stock est ce qui afflue sur AliExpress et chez les reconditionneurs.
Deux conséquences, et les deux sont de bonnes nouvelles.
Une grande partie est inutilisée plutôt que retirée. Les pièces de rechange de service ont attendu sur une étagère une défaillance qui n’est jamais venue, donc le chiffre d’usure à l’arrivée est souvent en pratique zéro — pas « quelques années de service léger » mais jamais écrit. Vérifiez plutôt que de faire confiance : nvme smart-log vous donne percentage_used et data_units_written, et sur du vrai stock de pièces de rechange ceux-là devraient être étonnamment bas. Tout ce qui montre une vraie usure est une pièce retirée vendue pour autre chose, mais même alors la marge d’endurance veut qu’une Optane usée puisse avoir plus de vie devant elle qu’un disque NAND neuf de même capacité.
Cela explique quelles capacités vous trouverez. Les pièces de rechange OEM étaient stockées pour des serveurs, ce qui veut dire des pièces de centre de données. Voici toute la gamme, et notez où commence le fleuron :
| Pièce | Capacités | Forme |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 Go | M.2 2280, grand public |
| Optane SSD 800P | 58, 118 Go | M.2 2280, grand public |
| Optane SSD P1600X | 58, 118 Go | M.2 2280, pièce de démarrage et de cache de centre de données |
| Optane SSD DC P4801X | 100, 200, 375 Go | M.2 110 mm ou U.2 |
| Optane SSD DC P4800X | 375 Go au plus petit, 750 Go, 1,5 To | U.2 ou carte additionnelle |
| Optane SSD P5800X | 400 Go, 800 Go, 1,6 To | U.2 ou carte additionnelle |
En théorie, les petites pièces M.2 sont la réponse élégante — la M10, la 800P, la P1600X et la P4801X de 100 Go font toutes le travail, et à bas prix. En pratique le marché ne les a pas, parce que personne n’a mis en entrepôt des modules accélérateurs de bureau comme pièces de rechange de serveur. Ce qui est listé est du 375 Go et au-dessus, du matériel de classe P4800X.
Alors prévoyez d’acheter plus de capacité que le rôle n’en a besoin, parce que c’est ce qui est en vente. Ce n’est pas un mauvais résultat. Sur-acheter un périphérique de cache vous met sur du 30 DWPD et une latence sous 10 µs quand votre charge en demandait une fraction, et pour un plateau de 20 To que vous comptez garder des années, c’est le bon sens dans lequel se tromper. Cela veut bien dire que le prix d’entrée est plus haut que l’arithmétique ne le suggère, et que le dimensionnement ci-dessus devient une vérification contre le sous-achat plutôt qu’une liste de courses.
Trois choses à prévoir, puisque c’est une liquidation plutôt qu’une chaîne d’approvisionnement :
Achetez vos pièces de rechange avec le montage. Un pool fini est en train d’être écoulé. Quand un périphérique lâche dans trois ans, vous ne commanderez pas un remplacement, vous en chasserez un — alors chiffrez les pièces de rechange maintenant, pendant que le stock est là.
Attendez-vous à du micrologiciel OEM et vérifiez le namespace. Les pièces d’un programme de rechange d’un fabricant portent souvent le micrologiciel de ce fabricant et peuvent arriver formatées à une taille de LBA ou avec des réglages de métadonnées convenant à ce pour quoi elles étaient stockées. Confirmez avec nvme id-ns avant de bâtir dessus, et soyez prêt à nvme format vers un format simple de 4096 octets.
Il n’y a ni garantie, ni support, ni plus de mises à jour de micrologiciel. La propre note de support d’Intel couvre ce que la fermeture veut dire pour les périphériques déjà en service, ce qui est la position dans laquelle tout ce que vous achetez est déjà. Vérifier que la pièce arrivée est la pièce de l’annonce est à votre charge.
bcache ne remplace pas le déchargement DB/WAL
Il vaut de le dire explicitement, parce que c’est l’endroit évident pour essayer d’économiser et cela ne marche pas : vous avez encore besoin de block.db sur NVMe. Les deux couches, pas l’une ou l’autre.
L’Optane est un cache d’écriture. C’est tout ce qu’elle est. Elle raccourcit le chemin d’acquittement des écritures qui vont vers le disque, et elle ne fait rien d’autre.
RocksDB ne fait pas qu’écrire. Ceph lit ses métadonnées sans cesse — pour trouver des objets, pour servir le peering, pour répondre aux scrubs — et un cache d’écriture n’offre exactement rien en lecture une fois les données vidées de lui. Le cache ne retire pas non plus le trafic de métadonnées ; il le diffère et le regroupe, donc chaque mise à jour RocksDB arrive quand même au plateau à terme, se disputant les mêmes déplacements. Et la compaction transforme un brassage modeste en bien plus de trafic de périphérique que les écritures qui l’ont causé.
Les deux changements corrigent donc des problèmes différents et aucun ne se substitue à l’autre :
| Ce qu’il corrige | Ce qu’il ne fait pas | |
|---|---|---|
block.db sur NVMe | les métadonnées vivent sur flash — lectures et écritures, en permanence hors du plateau | rien pour une rafale d’écritures d’invité |
| Optane via bcache | la latence d’acquittement des rafales pour les écritures de données | rien pour les lectures de métadonnées ; ne fait que différer les écritures de métadonnées |
Sautez le déchargement de DB et gardez l’Optane, et RocksDB est de retour sur le plateau avec ses lectures servies à 80 IOPS. Sautez l’Optane et gardez le déchargement de DB, et le régime établi est décent mais les rafales calent encore à la vitesse du plateau.
La règle udev, ligne par ligne
Les réglages de bcache vivent dans sysfs, et sysfs les réinitialise chaque fois que le périphérique est enregistré — ce qui est à chaque démarrage. Ils ont donc leur place dans une règle udev plutôt que dans un script que quelqu’un doit se rappeler de lancer :
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" correspond à chaque périphérique bcache du nœud, donc une seule règle couvre toutes les paires. ACTION=="add|change" veut dire qu’elle se réapplique chaque fois qu’un périphérique apparaît ou est rattaché, pas seulement au démarrage.
Ce que fait chaque réglage, et pourquoi :
cache_mode=writeback — tout l’intérêt. Dans le writethrough par défaut, une écriture n’est pas acquittée avant d’atteindre le HDD, donc le cache ne fait rien pour la latence d’écriture. En writeback, l’Optane acquitte et le plateau rattrape plus tard.
sequential_cutoff=0 — par défaut, bcache détecte les E/S séquentielles et les route droit au-delà du cache une fois qu’elles passent 4 Mo, sur la théorie que le disque d’appui gère bien le séquentiel. Zéro désactive ce contournement pour que tout soit caché. Sur un nœud hyper-convergé c’est le bon choix : ce qui paraît séquentiel à un périphérique bcache cesse d’être séquentiel au plateau une fois que plusieurs OSD s’entrelacent, et vous voulez chaque écriture acquittée à la vitesse de l’Optane quoi qu’il arrive. Cela porte cependant une obligation — sans contournement, la propre bande passante d’écriture séquentielle du périphérique de cache devient le plafond de tout l’OSD, ce qui est pourquoi les modules de 16 Go sont disqualifiés.
congested_read_threshold_us=0 — bcache surveille la latence de son propre périphérique de cache et se met à le contourner quand il le juge congestionné, avec un défaut de 2000 µs pour les lectures. L’Optane ne se congestionne pas comme la NAND, donc c’est bcache qui remet en question un périphérique qu’il a mal mesuré. Zéro coupe le suivi.
writeback_rate=81920 et writeback_rate_minimum=20480 — le taux de vidage de fond, en secteurs par seconde, donc à peu près une cible de 40 Mo/s avec un plancher de 10 Mo/s. Un contrôleur PD déplace le taux réel entre les deux. La cible est fixée près de ce qu’un plateau peut absorber en séquentiel, et le plancher empêche le contrôleur d’étrangler le vidage vers zéro et de laisser les données sales s’accumuler indéfiniment. Les deux sont des points de départ plutôt que des constantes — comment les changer est plus bas.
writeback_percent=40 — quelle part du cache bcache laissera rester sale avant de repousser fort, contre un défaut de 10. Quarante vous donne un tampon de rafale bien plus profond. Cela veut aussi dire que jusqu’à 40 % de cette Optane tient l’unique copie de données du système, ce qui est le compromis, et c’est la raison pour laquelle la disposition d’une-par-plateau compte. C’est la valeur qui vaut le plus d’être revisitée une fois que vous avez observé une vraie charge.
Changer les valeurs de remplissage et de vidage plus tard
Les 40 % et les deux taux ci-dessus sont les valeurs qui tournent ici, pas des constantes universelles. Ce sont la première chose que vous voudrez déplacer une fois que vous aurez observé une vraie charge, alors il vaut de savoir qu’il y a deux endroits où les changer, faisant deux choses différentes.
sysfs le change maintenant. La règle udev le change au prochain démarrage. Vous voulez les deux, et dans cet ordre.
Changez-le en vie, sur un périphérique :
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Ou sur chaque paire du nœud :
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
Le taux de vidage marche pareil. Les deux valeurs sont en secteurs par seconde, donc celles-ci divisent par deux la cible et le plancher :
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Cela prend effet immédiatement et survit exactement jusqu’à ce que le périphérique soit réenregistré. La documentation du noyau est explicite : ces réglages « do not persist across reboot » — ne persistent pas au redémarrage — ce qui est toute la raison pour laquelle la règle udev existe.
Une fois que vous êtes content d’une valeur, éditez la règle et rechargez-la sans redémarrer :
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
C’est là qu’ACTION=="add|change" gagne sa place. Le déclencheur envoie un événement change aux périphériques déjà présents, donc la règle se réapplique à un nœud en marche au lieu d’attendre le prochain démarrage. Si la règle n’avait correspondu qu’à add, cette commande ne ferait rien.
Puis relisez les valeurs, parce qu’une faute de frappe dans une règle udev échoue en silence :
grep . /sys/block/bcache*/bcache/writeback_percent
Savoir dans quel sens les déplacer
Ne réglez pas ceci depuis des premiers principes — bcache expose ce dont vous avez besoin sous le même répertoire sysfs.
dirty_data est celui à surveiller : combien de données siègent actuellement dans le cache et nulle part ailleurs. Les docs le décrivent comme « continuously updated unlike the cache set’s version, but may be slightly off » — continuellement mis à jour contrairement à la version de l’ensemble de cache, mais peut être légèrement décalé — ce qui va bien pour cet usage. Échantillonnez-le au fil d’une journée de travail normale et d’une fenêtre de sauvegarde.
cache_hits, cache_misses et cache_hit_ratio vous disent si le cache est utilisé, avec la réserve qu’« a partial hit is counted as a miss » — un succès partiel est compté comme un manque. bypassed compte les E/S qui sont passées entièrement à côté du cache — avec sequential_cutoff=0 cela devrait être proche de plat, donc un nombre qui grandit veut dire que quelque chose contourne encore.
Tous ceux-là viennent comme des totaux courants plus des versions qui décroissent sur le dernier jour, la dernière heure et les cinq dernières minutes, ce qui rend celles à courte fenêtre bien plus utiles pour repérer un problème que le chiffre à vie.
À partir de là :
| Symptôme | Bouton | Sens |
|---|---|---|
| Les rafales calent — les écritures heurtent la latence du plateau en pleine rafale | writeback_percent | vers le haut, pour un tampon plus profond |
| Plus de données exposées sur le cache que vous n’êtes à l’aise avec | writeback_percent | vers le bas |
dirty_data bloqué au plafond pendant le travail ordinaire | writeback_rate | vers le haut — le tampon n’est pas le problème, le drainage l’est |
| Le vidage de fond en concurrence avec les lectures d’invité sur le plateau | writeback_rate | vers le bas |
dirty_data qui monte sur des jours plutôt que des heures | writeback_rate_minimum | vers le haut, pour que le contrôleur ne puisse pas ralentir au pas |
Si dirty_data reste bloqué au plafond quoi que vous fassiez, aucun bouton n’est la réponse — le cluster écrit plus vite que les plateaux ne peuvent absorber, et les corrections honnêtes sont plus de plateaux ou moins d’écritures.
Un fichier à laisser tranquille : writeback_running. Le mettre à off arrête entièrement le writeback, et la documentation dit qu’il est « only meant for benchmarking » — destiné seulement au test de performance. Sur un OSD de production, cela veut dire que les données sales s’accumulent jusqu’à ce que le cache soit plein et ne se drainent jamais.
Ce que vous abandonnez
La plupart des exposés de cette conception s’arrêtent aux bonnes nouvelles. Voici les parties qui vous feront réellement mal, et chacune vaut d’être connue avant de bâtir plutôt qu’après.
Perdre l’un ou l’autre périphérique de flash détruit l’OSD. Pas l’arrête — le détruit. Les deux périphériques tiennent un état qui n’existe nulle part ailleurs : block.db tient le RocksDB qui donne sens à block, et un cache en writeback tient chaque écriture pas encore vidée. La documentation du noyau ne prend pas de gants sur le second : « In writeback mode you’ll lose data if something happens to your SSD » — en mode writeback vous perdrez des données s’il arrive quelque chose à votre SSD. Dans un cas comme dans l’autre, l’OSD ne revient pas, il est recréé et backfillé.
Ce sont donc la même classe de risque, et il vaut d’être clair là-dessus plutôt que de traiter le cache comme l’effrayant. L’Optane n’est pas un périphérique plus dangereux que le NVMe. Deux choses les séparent, et aucune n’est la sévérité par OSD.
La première est le rayon d’explosion, et c’est toute la justification de l’appariement. Une Optane par plateau veut dire qu’une défaillance de cache coûte un OSD — une perte d’un seul disque, qui est exactement l’événement qu’un pool répliqué existe pour absorber, et que Ceph gère sans que personne ne soit alerté. Le périphérique DB/WAL est partagé, donc le perdre coûte chaque OSD derrière lui à la fois, ce qui est une défaillance corrélée dont la réplication ne vous protège pas. Même défaillance, un périphérique contre cinq.
La seconde est comment la défaillance se présente, et celle-là est un piège d’exploitation. Quand un cache meurt en writeback, le périphérique d’appui s’arrête et retourne des erreurs d’E/S, ce qui va bien — Ceph marque l’OSD comme tombé et continue. Le mauvais cas est un redémarrage où le périphérique d’appui remonte sans son cache attaché. Il ressemble alors à un système de fichiers montable auquel il manque simplement chaque écriture sale, ce qui est corrompu plutôt que simplement périmé. Un block.db manquant échoue bruyamment et l’OSD refuse de démarrer ; un cache manquant peut échouer en silence et vous laisser monter l’épave. Traitez un périphérique d’appui bcache comme non montable sans son cache, et ne laissez jamais rien vous le monter serviablement.
bcache ne garantit pas à lui seul un writeback sûr à la coupure de courant. C’est là que le cache d’écriture du HDD cesse d’être une optimisation et devient une exigence — coupez-le, et faites tourner un noyau assez récent pour avoir la gestion FUA, pour que les écritures synchrones soient honorées à travers la pile plutôt qu’acquittées tôt quelque part au milieu. Un périphérique de cache sans protection contre la coupure de courant aggrave le problème, parce qu’il peut perdre des données qu’il a déjà rapportées comme sûres.
Ce qui fait du ratio DB/WAL le nombre qui compte. Ceph permet 4 à 5 OSD HDD par SSD SATA et pas plus de 15 par NVMe, et avertit de « balancing the risk of reducing costs by placing too many responsibilities into too few failure domains » — équilibrer le risque de réduire les coûts en plaçant trop de responsabilités dans trop peu de domaines de défaillance. Contrairement au palier de cache, il n’y a pas d’appariement disponible pour contenir celui-ci — le partage est l’intérêt du périphérique.
Sur des disques de 20 To, c’est toute la conversation, parce que la reconstruction est énorme. Un OSD tombé, c’est 20 To à backfiller ; aux 150-250 Mo/s qu’un plateau soutient, étranglé pour que la récupération n’affame pas les invités, vous en avez pour bien plus d’une journée d’opération dégradée pour un seul disque. Perdez un périphérique DB partagé en portant cinq et il y a 100 To à déplacer.
Le ratio n’est donc pas vraiment une décision de coût. C’est une décision sur combien de temps vous êtes prêt à tourner dégradé, et combien de trafic de reconstruction le cluster peut porter tout en servant encore des VM.
La conception dépend d’un périphérique que personne ne fabrique plus. C’est celui sans réponse technique. L’Optane est la bonne pièce pour la position de cache et rien d’actuel ne la remplace — la NAND ne peut pas prendre le volume d’écriture, et la mémoire basée sur CXL vers laquelle Intel a pivoté n’est pas un remplacement direct pour un cache de bloc. La parade est donc commerciale plutôt qu’astucieuse, elle est traitée plus haut, et le résumé honnête est que cette architecture a une date de fin quelque part dans le futur.
Rien de tout cela ne fait d’un cluster HDD un cluster tout-flash. Un trafic d’écriture aléatoire soutenu qui dépasse le taux de vidage remplira le cache, et une fois plein vous écrivez à la vitesse du plateau avec des couches en plus dans le chemin. Cette conception absorbe les rafales et retire la surcharge de métadonnées. Elle ne fabrique pas d’IOPS.
Ce que ça donne au total
Trois paliers, chacun faisant la seule chose où il est le meilleur — et les trois sont requis :
- L’Optane absorbe les rafales d’écriture aléatoire, un périphérique par plateau. Ce doit être de l’Optane, parce que chaque écriture la traverse et que l’endurance de la NAND est mauvaise pour cette position
- Un NVMe d’entreprise rapide tient RocksDB et le WAL, partagé sur une poignée d’OSD à un ratio que vous avez choisi délibérément plutôt qu’accepté
- Les HDD fournissent la capacité en vrac, libérés des métadonnées comme des rafales
L’intérêt n’est pas de prétendre que les disques à plateaux sont de la flash. C’est de cesser de leur envoyer le travail où ils sont les pires, pour que la capacité que vous avez réellement payée soit utilisable.
C’est tout le tour de main, et il n’y a rien d’astucieux là-dedans. Mettez chaque travail sur le périphérique qui y est bon, et cessez de payer deux fois pour ceux qui ne le sont pas.
Pour un cluster Proxmox hyper-convergé qui a besoin de capacité multi-téraoctet sans le prix du tout-flash, c’est une conception défendable. Bâtie correctement, elle paraît bien plus rapide que des HDD nus, elle échoue de façons que Ceph est bâti pour gérer, et l’argent va là où il change le résultat.
Deux choses liées à lire à côté de celle-ci : le travail sur la taille de secteur dans 4Kn, 512e et 512n compte beaucoup pour ce que les plateaux font des écritures qui les atteignent, et si vous bâtissez ceci sur des nœuds à attache directe, le maillage sans commutateur couvre le côté réseau d’un petit cluster Ceph.
Références
- Ceph — Hardware Recommendations — l’avertissement IOPS-par-To sur les gros HDD, « HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD », les ratios de 4 à 5 HDD par SSD SATA et ≤15 par NVMe, la protection contre la coupure de courant sur les SSD d’entreprise, la désactivation du cache d’écriture HDD, et l’inutilité d’un HBA RoC
- Ceph — BlueStore Configuration Reference —
block.dbà 1-2 % deblockpour RBD et au moins 4 % pour RGW, la recommandation générale de 2,5 %, le débordement de nouveau sur le périphérique primaire, les tailles de niveau RocksDB derrière les paliers de 3/30/300 Go, et le WAL implicitement colocalisé avec la DB - Linux kernel — bcache admin guide — les modes de cache,
sequential_cutoffet son défaut de 4 Mo, le défaut de congestion de lecture de 2000 µs,writeback_rateen secteurs par seconde, le contrôleur PD dewriteback_percent, les compteursdirty_data/cache_hit_ratio/bypassedet leurs versions décroissantes sur le jour, l’heure et les cinq minutes, l’avertissement quewriteback_runningest « only meant for benchmarking », l’affirmation que ces réglages « do not persist across reboot », et « in writeback mode you’ll lose data if something happens to your SSD » - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240 000 IOPS en lecture aléatoire et 65 000 en écriture aléatoire à 4K sur une étendue de 8 Go, 1200/290 Mo/s en séquentiel, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — les 150 Mo/s en écriture séquentielle et 35 000 IOPS en écriture aléatoire qui mettent cette pièce sous un disque à plateaux en débit séquentiel
- PC Perspective — Optane SSD DC P4800X performance — les 550K IOPS en lecture aléatoire 4K de la pièce de 375 Go, 2400/2000 Mo/s en séquentiel, une latence typique sous 10 µs, et 12,3 PBW à 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — les petites pièces M.2 de centre de données, pour l’échelle de capacité
- StorageReview — Intel Optane SSD P5800X — la note de 100 DWPD, les 30 DWPD du P4800X, et la comparaison contre les disques NAND d’entreprise plafonnant autour de 10 DWPD pour les pièces à forte écriture et 3 ou moins pour l’usage mixte
- Bcache — ArchWiki — les modes de défaillance pratiques, dont un périphérique d’appui remontant sans son cache après un redémarrage, et les exigences de sûreté à la coupure de courant autour du cache d’écriture HDD et de FUA
- Intel — Optane business update — la fermeture, et ce qu’elle veut dire pour la garantie et le support sur les périphériques déjà en service, qui est la position dans laquelle tout ce que vous achetez sur le marché du recyclage est déjà