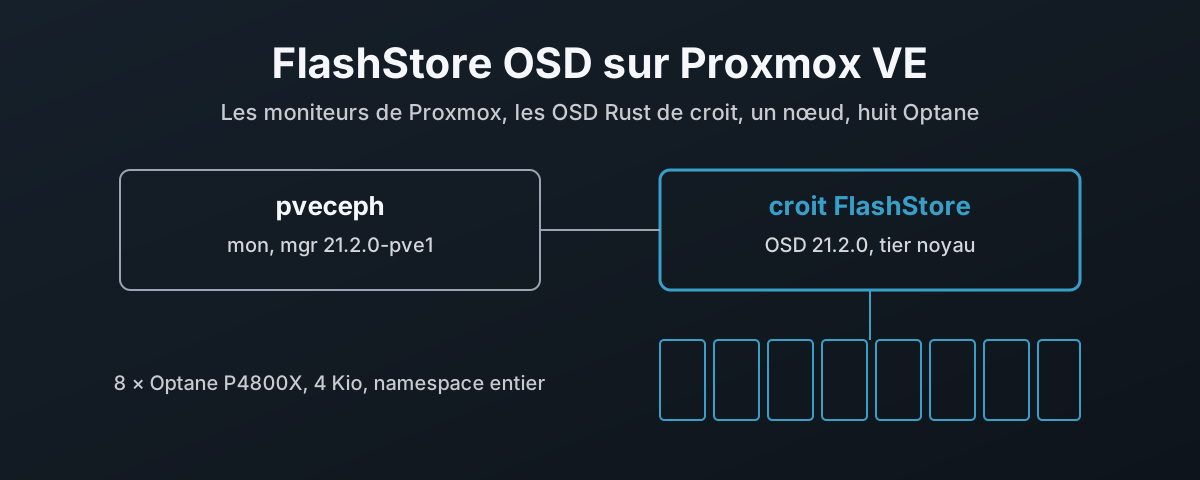
Un OSD en Rust, le jour de sa sortie
croit a mis FlashStore OSD en préversion publique le 9 novembre 20261.
C’est un OSD Ceph écrit de zéro en Rust, avec son propre magasin d’objets à la place de BlueStore, et il parle le protocole réseau de Ceph.
La promesse, c’est qu’il s’insère dans un cluster que vous exploitez déjà : vos moniteurs, vos gestionnaires, votre CLI ceph et vos clients restent tels quels, et vous remplacez un disque à la fois1.
Cette promesse compte plus pour une boutique Proxmox que pour la plupart des autres.
Sur un nœud Proxmox VE hyperconvergé, Ceph ne s’installe pas à part.
Il sort de la GUI de Proxmox, des dépôts de Proxmox, compilé et patché par Proxmox, et le tout est piloté par pveceph.
Si un OSD venu d’ailleurs peut s’installer là-dedans sans rien casser, vous gagnez un nouveau moteur de stockage sans renoncer à l’outillage.
S’il ne le peut pas, vous l’apprenez à la dure, sur un nœud qui fait aussi tourner vos VM.
Alors je l’ai essayé.
Je travaille pour croit, qui fait FlashStore. C’est pour cela que je l’ai essayé moins de deux jours après sa sortie, et c’est aussi pour cela que rien de ce qui suit n’est adouci. C’est une préversion, le README dit qu’il est « not yet recommended for production data »1, et ceci est le compte rendu de ce qu’il a fallu sur du vrai matériel, pas une brochure.
Réponse courte : ça marche. Huit OSD FlashStore servent un pool RBD à une VM sur un nœud Proxmox VE 9.2 de série au moment où j’écris, en HEALTH_OK. La réponse longue, c’est qu’il a fallu deux correctifs que la documentation ne mentionne pas, l’un à cause de la façon dont Proxmox range sa configuration Ceph, l’autre à cause du noyau de Proxmox, et le reste de cet article porte sur ces correctifs et sur la façon dont ils ont été trouvés. Si vous voulez seulement le faire tourner, un script vers la fin fait tout cela, et il a tourné sur ce nœud.
La machine
Le labo est un seul nœud, pve2, sur mon réseau domestique, et c’est un mini PC Minisforum B550 bas de gamme de 2021.
Ceph sur un seul nœud, ce n’est pas comme ça qu’on fait de la production, et la règle CRUSH plus bas en est le prix, mais chaque étape ici est la même sur un nœud qui a des voisins.
| Proxmox VE | pve-manager 9.2.26, noyau 7.0.14-28-pve, Debian 13.7 |
| Machine | mini PC Minisforum B550, 2021 ; la carte s’annonce BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 cœurs, 16 threads, 1 nœud NUMA |
| Mémoire | 58 Gio |
| Disques OSD | 8 × Intel Optane P4800X 375 Go (6 sous marque Dell, 2 Intel en boîte) |
| PCIe vers les Optane | les huit derrière un seul switch Broadcom PEX880xx, sur une seule liaison PCIe 3.0 x16 depuis l’APU |
| Disque de démarrage | WD SN750 512 Go, VG pve, tenu à l’écart de tout ceci |
| Réseau | un port 2,5 GbE, vmbr0 |
| FlashStore | snapshot-2026-11-10, commit amont c5792750020e2 |
Les Optane sont là parce que FlashStore a deux exigences strictes que beaucoup de disques ne remplissent pas.
Le disque doit avoir une protection contre les coupures de courant, et le namespace doit utiliser des blocs de 4096 octets, en namespace entier, sans partition ni système de fichiers dessus1.
FlashStore acquitte une écriture quand elle est durable sur le disque, donc un disque qui ment sur la durabilité avec un cache volatil est refusé dès mkfs3.
Chaque P4800X déclare ne pas avoir de cache d’écriture volatil dans ses données Identify (vwc 0), ce qui revient au disque lui-même qui dit que son cache ne peut pas perdre une écriture acquittée.
Du coup, c’est le mini PC qui est le facteur limitant de cette plongée en profondeur, pas FlashStore ni les disques. Huit cœurs, c’est un par OSD et aucun de reste, 58 Gio doivent nourrir Ceph et les VM à la fois, et huit Optane se partagent une liaison PCIe 3.0 parce que l’APU n’a rien de plus à offrir. Lisez chaque chiffre plus bas comme ce que cette machine permet.
Umbrella ou rien
FlashStore est compilé pour une seule version de Ceph à la fois.
C’est la branche qui décide : main parle Ceph 21.2.0 Umbrella, et une branche v20.2.4 parle 20.2.4 Tentacle4.
Le démon vérifie la version du cluster au démarrage et refuse celle qui sort de sa fenêtre4.
Les paquets de la page de release sont compilés depuis main, et le binaire le dit lui-même : croit-flashstore-osd 21.2.0 umbrella.
Proxmox VE 9 propose trois dépôts Ceph, et un seul correspond.
Tentacle est le choix par défaut de Proxmox, alors est-ce le choix sûr ?
C’est celui qui ne marchera pas.
Le dépôt Proxmox porte Tentacle jusqu’à 20.2.5-pve1, et la branche Tentacle de FlashStore vise exactement 20.2.4.
Umbrella dans le dépôt de Proxmox, c’est 21.2.0-pve1, la version même que vise main.
Proxmox ne cache pas ce qu’est Umbrella.
PVE/Ceph/Releases.pm la liste avec unsupported => 15, et l’assistant de la GUI le dit en toutes lettres dès que vous la choisissez.
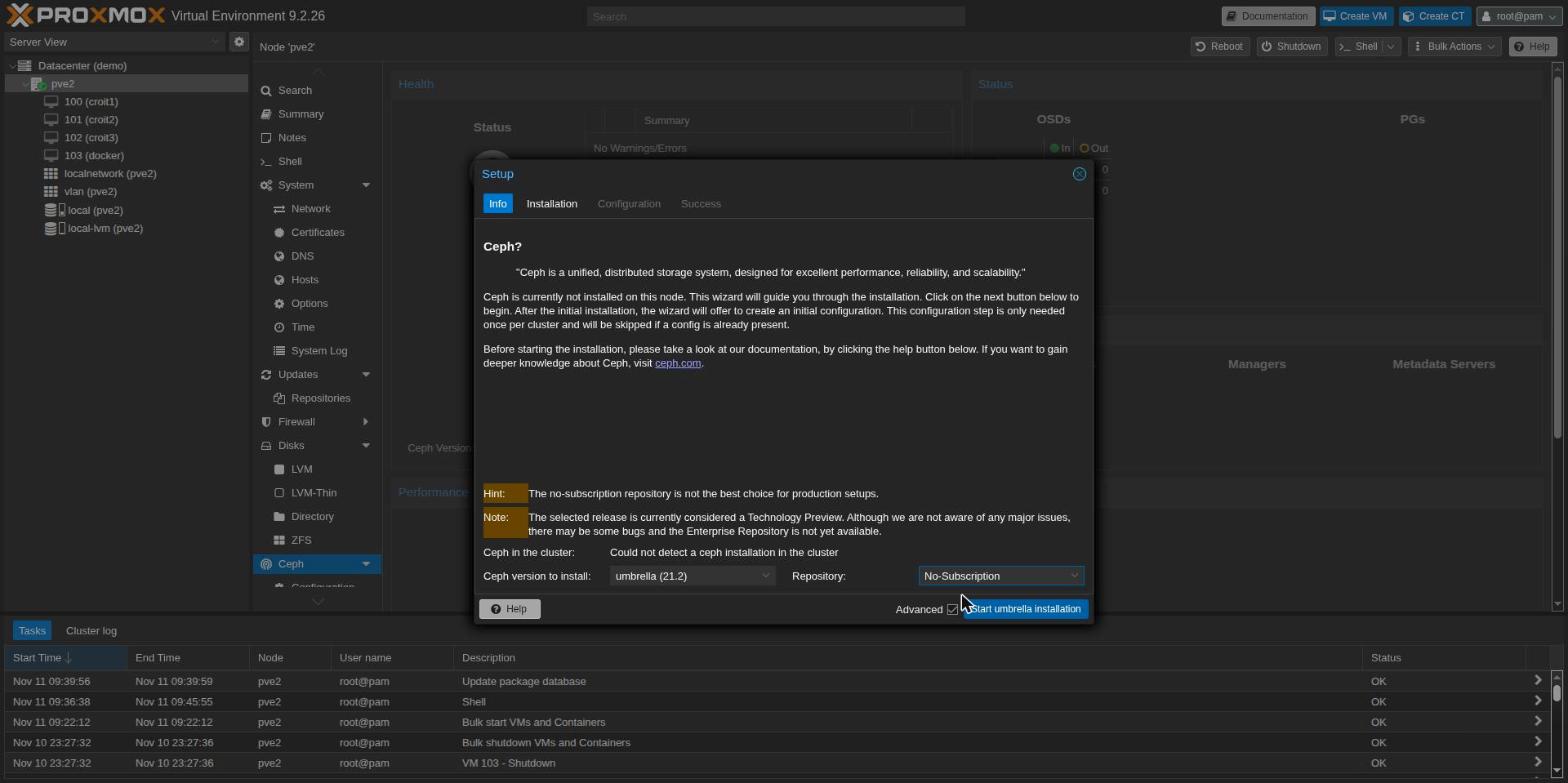
« Technology Preview », pas de dépôt entreprise, et l’installateur redemande dans le terminal, continue (y/N)?, avant de toucher à apt.
C’est la bonne dose d’avertissement, et elle vaut d’être lue comme un constat sur toute la pile : un OSD en préversion sur une version de Ceph en préversion.
L’installation est du Proxmox de série. Datacenter → Ceph → Install, version Umbrella, dépôt No-Subscription, puis le réseau public et le premier moniteur.
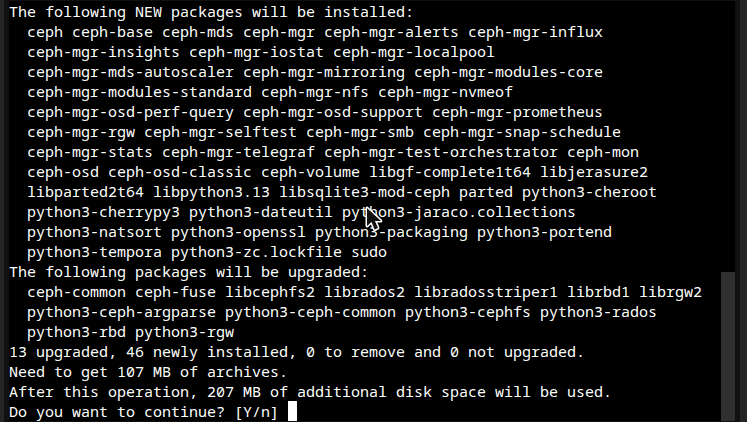
Treize paquets mis à jour, 46 nouveaux, 107 Mo téléchargés.
Une chose dans cette liste est nouvelle avec Umbrella : ceph-osd-classic à côté de ceph-osd.
Aucun des deux ne sert ici, car aucun OSD classique n’est jamais créé.
Environ une minute plus tard, mon.pve2 et mgr.pve2 tournaient, ceph versions annonçait 21.2.0 … umbrella, et la santé était OK, sans rien à stocker pour l’instant.
Quatre disques à 512 octets
Quatre des huit Optane avaient été passés à une VM de labo et étaient encore au format 512 octets, avec de vieux labels ZFS dessus. Deux autres avaient le bon format et les mêmes labels. Le correctif est simple dans les deux cas : les retirer de la VM, formater en 4 Kio, effacer les labels.
Le P4800X propose 4096 octets sans métadonnées en format LBA 3, que nvme id-ns affiche comme lbaf 3 : ms:0 lbads:12.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
La première tentative a échoué, et une suivante aussi.
Les deux fois, nvme format est revenu avec Interrupted system call et le disque était toujours à 512 octets.
Le journal du noyau donne la raison :
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
L’opcode 0x2 est Get Log Page et 0x6 est Identify.
Aucun des deux n’est le formatage.
Un P4800X formate tout le support, et cela a pris de 345 à 351 secondes par disque ici.
Pendant ce temps, le contrôleur ne répond pas aux autres commandes d’administration, donc tout ce qui pose une question au disque attend.
Au bout du délai d’administration de 60 secondes du noyau, celui-ci abandonne et réinitialise le contrôleur, et la réinitialisation tue le formatage.
| Tentative | Ce qui a atteint le disque | Résultat |
|---|---|---|
| nvme0, la première | un Get Log Page à 09:53:04, en pleine installation de Ceph | interrompu, toujours 512 o |
| nvme0, dans une unité | rien | 4 Kio en 345 s |
| nvme1 | mon propre nvme list, pour voir l’avancement | interrompu, toujours 512 o |
| nvme2, nvme3 | rien | 4 Kio en 351 s et 350 s |
| nvme1, seul | rien | 4 Kio en 346 s |
Le correctif consiste à lancer chaque formatage dans une unité transitoire avec un long délai, un disque à la fois, et à laisser les disques tranquilles jusqu’à la fin :
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
Ainsi, le seul suivi de l’avancement passe par le journal, et rien n’atteint le contrôleur.
Les huit affichaient ensuite 4 KiB dans nvme list.
Le paquet
La page de release porte des paquets .deb et .rpm, dont un pour Debian 13 trixie, la base de Proxmox VE 92.
Un seul build sert toutes les distributions, à condition d’avoir glibc 2.34 ou plus récent6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Vérifiez à la main.
sha256sum -c ne peut pas vérifier ce téléchargement, parce que le fichier de sommes le nomme debian-trixie/flashstore_…_amd64.deb alors que l’asset s’appelle flashstore_…_debian-trixie_amd64.deb.
Les empreintes concordent, ce1fb352…26c8 des deux côtés, donc le fichier est bon et seule la liste est décalée par rapport aux assets.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Il s’est installé proprement à côté des ceph-osd et ceph-osd-classic de Proxmox.
Le paquet n’installe un ceph-osd.target minimal que sur les hôtes qui n’en ont pas6, et Proxmox en a déjà un, donc les unités FlashStore se rattachent à la même cible que le feraient les classiques.
Trois choses à savoir sur le paquet avant d’écrire des scripts autour :
| Ce que dit la doc | Ce qu’est le paquet | |
|---|---|---|
| Nom du paquet | apt remove flashstore …6 | croit-flashstore-osd, le fichier de l’asset est flashstore_… |
| Backends de stockage | l’ensemble de fonctionnalités de production de main est knet,spdk,rdma,mimalloc1 | pas de SPDK : --check affiche « SPDK NVMe driver: compiled out » |
Valeurs de flashstore_dev | spdk:<pci>, ou file: dans les builds de développement7 | le tier noyau, kernel:/dev/…, est le seul vrai chemin de stockage de ce build |
C’est la ligne du milieu qui compte.
Le tier SPDK, le pilote NVMe en espace utilisateur qui exige que le disque soit lié à vfio-pci, n’est pas dans le paquet Debian publié.
Ce qui s’y trouve, c’est le tier noyau : le disque reste sur le pilote nvme du noyau et FlashStore lui parle via io_uring.
Le source montre qu’il est compilé, parce que la fonctionnalité knet tire kernel-nvme8, même si la ligne de synthèse du contrôle de l’hôte le dit « compiled out of this build ».
Cette ligne est fausse.
Un lecteur qui la croit s’arrêterait là.
Ce que dit le contrôle de l’hôte
croit-flashstore-osd --check est en lecture seule et s’exécute avant que quoi que ce soit ne soit écrit.
Il contrôle le build, le CPU, la mémoire, l’IOMMU, chaque contrôleur NVMe, la carte réseau, le noyau et la configuration, et affiche le correctif exact pour chaque constat9.
Sur ce nœud, il a fait 115 contrôles, et il est bon : chaque constat vient avec la commande qui le corrige, ce qui m’a épargné pas mal de recherches.
| Constat | Résultat | Ce que j’ai fait |
|---|---|---|
| Hugepages : aucune réservée | FAIL | réservé les 16 Gio demandés, rendus persistants dans /etc/sysctl.d |
| Disque de démarrage SN750 : cache d’écriture volatil | FAIL | rien, ce n’est pas un candidat OSD |
vfio-pci non chargé | WARN | rien, ce build n’a pas de SPDK pour s’en servir |
| limite memlock de 8 Mio | WARN | rien, il mesure le shell ; l’unité fixe LimitMEMLOCK=infinity |
pas d’isolcpus / nohz_full | WARN | noté, réglage de latence |
IOMMU en traduction, pas iommu=pt | WARN | noté |
init_on_alloc=1 | WARN | noté, coûte de 15 à 20 % de CPU sur les grosses lectures, d’après lui |
| port 2,5 GbE, anneaux de carte réseau par défaut, IRQ sur cinq CPU | WARN | noté |
| 8 × P4800X : pas de VWC, 4096+0 actif, x4 à 8 GT/s, libres | OK | |
| io_uring avec SEND_ZC et tampons fixes, noyau 7.0 | OK |
Prévoyez le second FAIL.
Le contrôle compte tous les contrôleurs de la machine, et le SSD de démarrage a un cache d’écriture, donc il échoue au test de protection contre les coupures, alors même que le contrôle le marque à juste titre « in use, not a candidate ».
Le tutoriel dit que le code de sortie 0 signifie aucun FAIL9.
Sur tout hôte qui démarre sur un SSD grand public, ce qui fait beaucoup d’hôtes Proxmox, --check ne peut pas sortir en 0, quoi que vous corrigiez.
Scriptez sur les lignes de chaque contrôle, pas sur le code de sortie.
Les WARN de réglage sont restés. Chacun exige une modification de la ligne de commande du noyau et un redémarrage, et ceci est un déploiement, pas un benchmark. C’est la bonne liste à traiter avant que quiconque ne cite un chiffre tiré de cette machine.
Cœurs et hugepages pour huit OSD
FlashStore fonctionne en thread par cœur, et le contrôle explique ce que cela veut dire : « one core = one shard/PG owner », au plus 8 cœurs par OSD, et chaque cœur d’OSD sur son propre cœur physique plutôt que partagé avec un frère SMT.
Huit cœurs physiques et huit OSD, cela fait un cœur chacun, flashstore_lcores = 0 à 7, les frères SMT étant laissés à Proxmox et aux VM.
Relancé avec cela dans la configuration, le contrôle marque chaque plan de cœurs OK.
Regardez à nouveau les hugepages.
Le contrôle demande 2048 Mio par OSD, ce qui est le --mem par défaut du démon, donc huit OSD exigent 16 Gio réservés.
En service, chaque OSD a utilisé 512 Mio sur ses 2048.
Cela correspond à la note de conception de croit pour le backend noyau, qui réserve un quart de --mem à son allocateur de charge utile10.
Donc sur cette machine, avec les huit OSD en service, 12 Gio de RAM restent réservés en hugepages auxquelles rien ne touche, sur un hôte qui a aussi des VM à nourrir.
Un nœud de stockage n’y verrait rien.
Sur un nœud Proxmox, cette mémoire, c’était une VM, et plus bas elle est ramenée à ce qu’utilisent les OSD.
Puis-je demander pourquoi il ne peut pas lire ceph.conf ?
Les disques formatés, le paquet installé et le contrôle de l’hôte au propre, le premier OSD refusait de démarrer.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
Sur Proxmox, /etc/ceph/ceph.conf est un lien symbolique vers /etc/pve/ceph.conf, et /etc/pve est pmxcfs, le système de fichiers de cluster qui garde la configuration de chaque nœud synchronisée.
Les fichiers y sont en root:www-data 0640, et pmxcfs ne vous laisse pas changer cela fichier par fichier11.
Les démons Ceph de Proxmox s’en accommodent parce qu’ils démarrent en root, lisent la configuration, puis passent à l’utilisateur ceph, ce que fait --setuser ceph --setgroup ceph sur chaque unité ceph-osd@.
L’unité de FlashStore ne démarre pas en root.
Elle est en User=ceph dès la première instruction, ExecStartPre compris12, donc elle n’arrive jamais à lire le fichier.
Puis-je demander pourquoi un paquet compilé pour Debian, pour un produit présenté comme un remplacement direct, n’a pas été essayé sur la plateforme Ceph basée sur Debian la plus répandue qui soit ? Je ne demande pas qui. pveceph garde sa configuration sur pmxcfs, et chaque OSD FlashStore sur un nœud géré par pveceph se heurtera à cela à son premier démarrage.
Le démon a déjà la réponse intégrée.
Son source décrit un abandon de privilèges classique --setuser/--setgroup : « started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file »13.
Un drop-in qui démarre l’unité comme Proxmox démarre ses propres OSD devrait donc suffire.
Pas tout à fait. Démarré en simple root, le refus suivant venait du disque.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
Le CapabilityBoundingSet de l’unité omet CAP_DAC_OVERRIDE12, donc root est tenu aux permissions de fichiers ordinaires, et les nœuds du namespace appartiennent à ceph:ceph.
Démarrer en root avec le groupe ceph couvre les deux : root possède le fichier de configuration, le groupe ceph ouvre le disque, et le démon passe à ceph avant de faire quoi que ce soit d’autre.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
Le démon confirme l’abandon dans son propre journal : set uid:gid to 64045:64045 (ceph).
Il existe un correctif plus court, SupplementaryGroups=www-data, et je ne l’ai pas utilisé.
Il laisserait l’OSD lire tous les fichiers lisibles par le groupe sous /etc/pve, pas seulement la configuration Ceph.
Un OSD n’a rien à faire dans le reste de la configuration du cluster, et le drop-in ci-dessus ne lui donne rien de plus que ce que Proxmox donne aux siens.
Ensuite, les nœuds de périphérique.
La doc de FlashStore dit que le nœud du namespace doit être accessible en écriture à ceph, « (udev rule) »14, et le paquet n’en livre aucune.
Celle-ci reconnaît les disques par modèle, donc elle ne peut pas attraper le disque de démarrage, quoi que fasse la numérotation :
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Après udevadm trigger, les seize nœuds Optane étaient en ceph:ceph 0660 et le SN750 restait à root.
Le passthrough que ce noyau refuse
Le tier noyau a deux modes, et c’est le nœud que vous nommez qui choisit.
kernel:/dev/ngXnY envoie les commandes NVMe directement au disque via io_uring, ce que croit appelle kernel-cmd.
kernel:/dev/nvmeXnY fait des lectures et écritures O_DIRECT sur le périphérique bloc, ce qu’on appelle kernel ou direct10.
croit a mesuré kernel-cmd devant dans chaque cas testé10, et le démarrage rapide du README l’utilise1, c’est donc ce que j’ai configuré.
Les permissions réglées, le démon est passé à ceph, a lu sa configuration, et s’est arrêté à la première lecture :
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
La même sonde était passée une minute plus tôt dans activate, qui avait encore les capacités de root.
La question est donc de savoir si ce noyau laisse un processus non privilégié envoyer des commandes d’E/S sur /dev/ngXnY.
On peut y répondre sans FlashStore, avec la même lecture via nvme-cli, en tant que ceph :
| En tant que | Commande sur /dev/ng0n1 | Résultat |
|---|---|---|
ceph | Identify Namespace | autorisé |
ceph | Read, LBA 0, 4 Kio | Permission denied |
root | Read, LBA 0, 4 Kio | autorisé |
Les huit Optane ont donné la même réponse, y compris deux que je n’avais jamais formatés ni réinitialisés, qui tournent avec le firmware d’Intel et non celui de Dell. Ce ne sont donc pas les disques, et ce ne sont pas les formatages du matin.
L’amont dit que cela devrait marcher.
Dans Linux 7.0, nvme_cmd_allowed() laisse un processus non privilégié envoyer une commande d’E/S quand le journal Commands Supported and Effects du disque la marque comme prise en charge sans effets inhabituels, et n’exige une ouverture en écriture que pour les commandes qui écrivent ou modifient des données15.
Le journal d’effets du P4800X marque Read comme pris en charge, 00000001, et rien d’autre.
La lecture est autorisée.
Le noyau de Proxmox n’est pas celui de l’amont.
Son changelog pour ce build inclut un correctif rétroporté sur exactement ce chemin, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), qui à première vue couvre un autre ioctl que celui que j’ai testé.
Je n’ai pas identifié quel changement du noyau 7.0.14-28-pve fait la différence, et je ne vais pas deviner.
Ce qui est certain, c’est le comportement : sur ce noyau, les E/S NVMe en passthrough non privilégiées sont refusées.
FlashStore a un repli pour un passthrough refusé, et il ne s’est pas déclenché.
La note de conception de croit dit que lorsque Identify est refusé, un périphérique kernel-cmd bascule en E/S directes sur son nœud bloc et l’annonce au démarrage10.
Ici, Identify est autorisé et Read ne l’est pas, donc le repli ne se déclenche jamais et l’OSD s’arrête à la place.
Les E/S directes s’en moquent. C’est une ligne par OSD :
flashstore_store_backend = kernel
Avec cela, osd.0 a démarré.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Actif en 2,4 secondes.
Préparer et démarrer les OSD
Chaque OSD a une section dans la configuration Ceph, ce qui sur Proxmox veut dire éditer /etc/pve/ceph.conf, et le faire à la main ne pose aucun problème.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
Le périphérique est désigné par son adresse PCI, pas par /dev/nvme0n1, et le préfixe spdk: ne veut pas dire SPDK ici.
Avec un backend noyau, le démon cherche l’adresse dans sysfs à chaque démarrage et trouve les nœuds actuels du contrôleur10.
Ici, cela compte.
Le disque de démarrage SN750 était nvme7 en octobre et il est nvme8 maintenant, et les mineurs des nœuds génériques ne suivent pas non plus l’ordre des disques, avec ng1n1 au mineur 0 et ng0n1 au mineur 2.
Une configuration qui dit /dev/nvme4n1 peut désigner un autre disque après un redémarrage.
Une configuration qui dit 0000:0b:00.0 ne le peut pas.
Ensuite, une commande par disque, qui écrit le magasin et enregistre l’OSD auprès du moniteur :
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Deux secondes, en root.
prepare lit la clé de bootstrap dans /var/lib/ceph/bootstrap-osd/ceph.keyring16, que pveceph n’écrit que la première fois qu’il crée un OSD à lui, donc sans OSD classique il faut d’abord aller la chercher :
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Six disques préparés du premier coup. Deux ont été refusés :
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk et blkid avaient tous deux déclaré ces deux disques vides.
Ce qu’il y avait dessus, c’était la zone de métadonnées texte d’un groupe de volumes LVM d’un ancien labo, supprimé depuis longtemps, dont le label en tête avait déjà été mis à zéro.
La sonde de FlashStore lit les 8 premiers Kio et les zones à 64 Kio et 256 Kio17, plus loin que ne regardent les outils habituels, et elle avait raison.
Refuser un disque qui contient quoi que ce soit, sauf ordre de --wipe, c’est exactement ce que doit faire un outil d’OSD.
Les effacer est une décision qui revient au propriétaire des disques, pas à l’outil. Une fois la décision prise, --wipe a préparé les deux en deux secondes environ, et ils ont rejoint le cluster après l’installation plus bas, ce qui explique pourquoi la capture du panneau et les chiffres de l’installation en montrent six.
Ensuite, on les démarre :
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Chaque OSD s’est placé sous host=pve2 avec la classe de périphérique nvme.
Ce qu’ils disent d’eux-mêmes au cluster vaut d’être lu une fois :
| Champ | Moniteur et gestionnaire | OSD FlashStore |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Compilé par | Proxmox, paquets -pve1 | croit, depuis le commit amont v21.2.0 que nomme le README1 |
osd_objectstore | bluestore, avec chaque champ bluestore_bdev_* rempli | |
| Ce que c’est vraiment | FlashStore, sans BlueFS, sans RocksDB |
La réponse BlueStore est délibérée.
flashstore_report_objectstore vaut bluestore par défaut parce que les moniteurs classiques n’activent certaines fonctionnalités que lorsque tous les OSD le déclarent, donc la valeur par défaut garde un cluster mixte en état de marche7.
Ce n’est pas vrai, et il vaut mieux le savoir avant de lire les métadonnées du cluster et de les croire.
Ce qu’en fait Proxmox
Le panneau OSD de Proxmox les liste tous les six, up et in, classe nvme, version 21.2.0, 344 Gio chacun.
Il les appelle aussi FileStore.
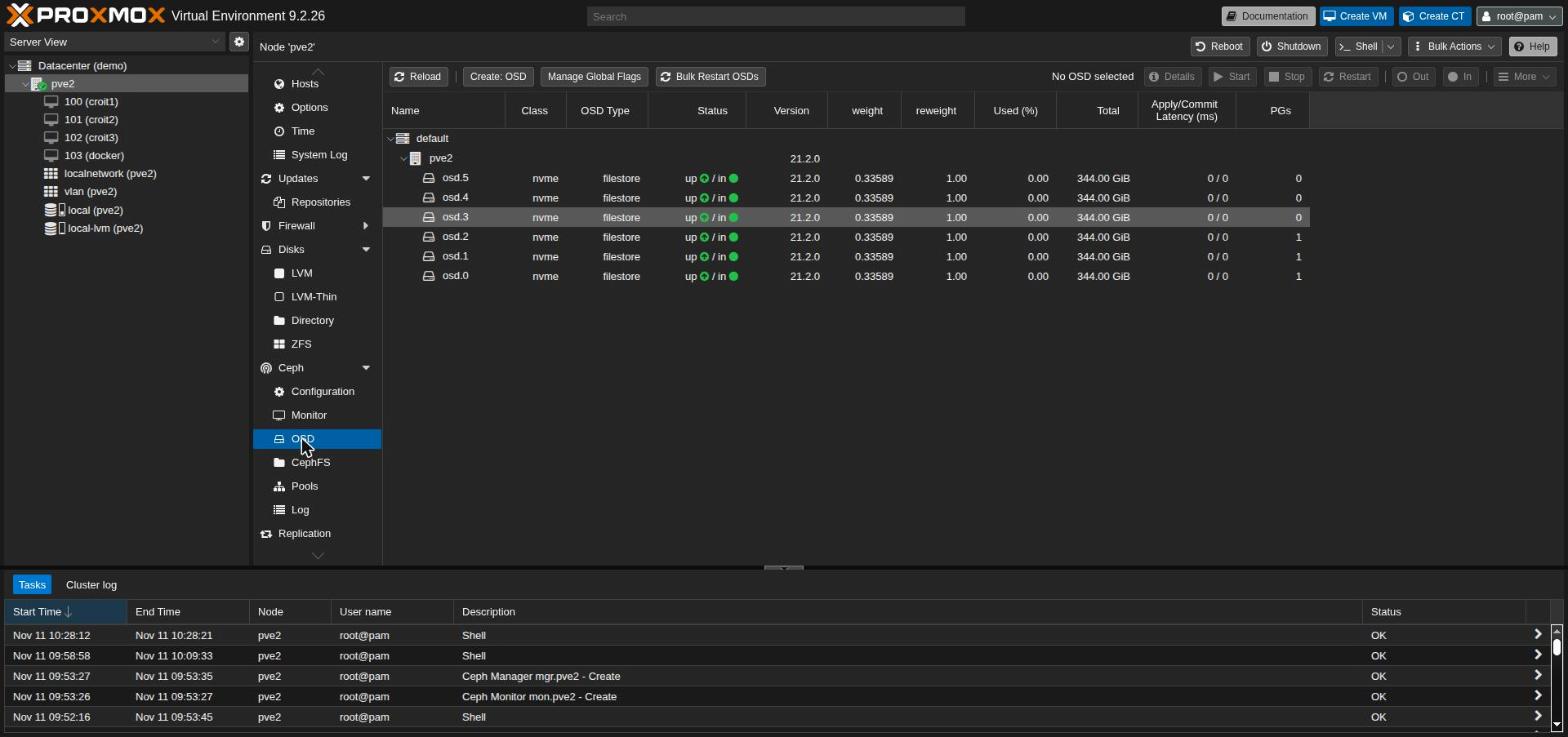
FileStore est le magasin d’objets que BlueStore a remplacé.
Proxmox déduit l’étiquette dans PVE/API2/Ceph/OSD.pm : si les métadonnées de l’OSD ont une clé bluefs, c’est BlueStore, et tout le reste est FileStore18.
FlashStore n’a pas de BlueFS, puisqu’il n’y a pas de RocksDB dessous, donc il déclare BlueStore dans un champ et se fait étiqueter FileStore à partir d’un autre.
Aucun des deux n’est juste.
Et le panneau est l’endroit où la plupart des admins Proxmox regardent en premier.
Les colonnes de latence affichent 0 / 0 au repos.
Pendant l’installation décrite plus bas, ceph osd perf a rapporté des latences de commit de 0 à 3 ms sur les six.
Start, Stop et Restart dans le panneau pilotent ceph-osd@N, l’unité classique, qui n’est pas ce qui tourne19.
Le panneau est donc une vue sur ces OSD, pas une commande.
Utilisez systemctl … croit-flashstore-osd@N et la CLI pour tout ce qui touche aux démons, et ne touchez surtout pas à « Create: OSD » ni à Destroy sur ceux-ci.
Un pool, un stockage et une VM Fisher-Price OS (Windows)
Le premier PG du cluster, celui du pool .mgr du gestionnaire, est resté undersized+degraded dès que les OSD ont démarré.
La faute au nœud unique.
La replicated_rule par défaut place chaque copie sur un hôte différent, et il n’y a qu’un hôte.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Une règle avec le domaine de défaillance osd et la classe de périphérique nvme20 place chaque copie sur un OSD différent, et le PG est passé active+clean en quelques secondes.
Sur un vrai cluster de trois hôtes ou plus, gardez la règle par hôte et sautez cette étape.
Tout ce qui suit, c’est la GUI de Proxmox comme d’habitude.
Ceph → Pools → Create : nom flashstore, size 3, min size 2, règle replicated_osd, Add as Storage coché.
Il est passé plus tard en size 2, min size 1, pour le test de charge plus bas.
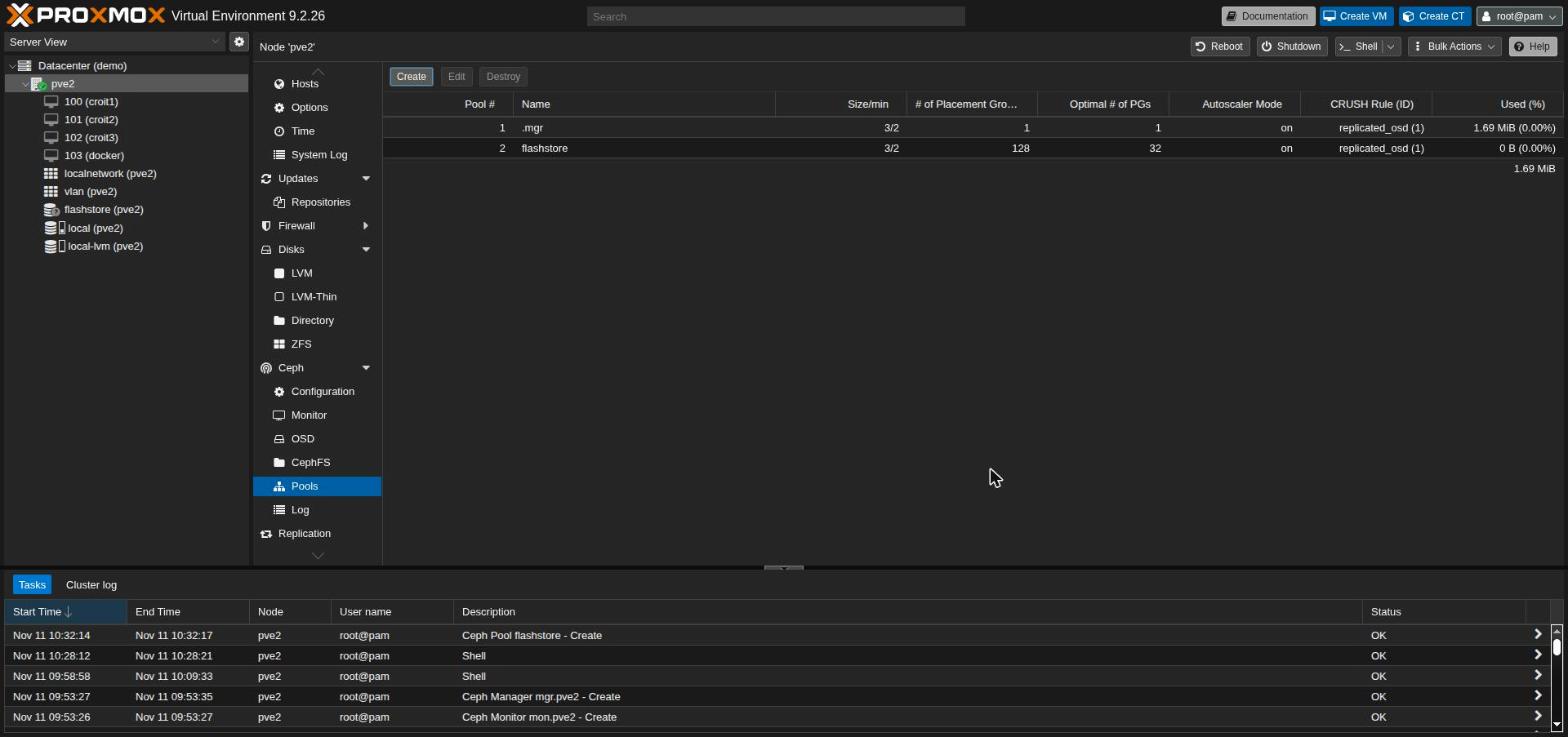
Proxmox a créé le pool et la définition de stockage RBD d’un coup, et flashstore est apparu dans l’arborescence avec 654 Gio utilisables, soit les 2 Tio bruts divisés par trois copies, moins le surcoût.
129 PG sont passés active+clean, et l’autoscaler a ramené le nouveau pool de 128 à 32 peu après.
L’invité de test est une VM Fisher-Price OS (Windows).
Ce n’est pas une préférence, c’est ce qu’une grande partie des clients font réellement tourner sur leurs pools Proxmox, donc c’est la charge qui compte : 16 Gio de mémoire, 4 cœurs, un disque de 60 Gio sur flashstore avec discard et iothread activés.
Il est aussi bavard avec le disque et l’utilise de façon inefficace, et c’est tout l’intérêt : un test de stockage veut l’invité qui sollicite le disque le plus fort.
Échantillonnage du pool toutes les dix secondes pendant les quinze premières minutes de l’installation :
| Écritures du pool | médiane 9,3 Mo/s en activité, pic à 302 Mo/s |
| Opérations d’écriture | pic à 2 486 par seconde |
| Lectures du pool | pic à 60 Mo/s |
| Espace brut utilisé | 35 Gio sur six OSD |
| Santé | HEALTH_OK sur les 90 échantillons |
| Redémarrages d’OSD | 0 |
| Mémoire résidente des OSD | de 565 à 871 Mio chacun ensuite |
Ce sont des chiffres d’installateur, avec la VM et les OSD sur le même hôte et les WARN de réglage intacts, et ils ne disent rien de la vitesse de FlashStore. Ce qu’ils disent, c’est qu’un client Proxmox classique a mené l’installation d’un système d’exploitation sur des OSD en Rust, 35 Gio bruts, sans un défaut, ce qui est précisément ce que cet article voulait tester.
Ce qu’il fait sous charge
Une installation prouve que ça marche. Elle ne vous dit pas ce que la VM donne à l’usage.
La VM a donc eu droit à CrystalDiskMark 9.0.321, trois fois : le profil Real World Performance [+Mix], Read&Write [+Mix], un fichier de 16 Gio sur C : et un mélange de 70 % de lectures et 30 % d’écritures, une fois en trois passes et deux fois en neuf. Ce profil envoie tout une requête à la fois, sur un seul thread, ce que fait réellement un poste de travail ou une petite base de données, pas une fiche technique.
Entre-temps, la configuration avait changé depuis l’installation. La VM avait six cœurs, et le pool avait été passé dans la GUI à size 2, min size 1 et 256 PG. Size 2 avec min size 1 est un réglage de labo sur une seule machine : avec une seule copie restante, le pool continue d’accepter des écritures qu’une seule panne peut alors faire perdre. Partout ailleurs, gardez 3 et 2.
Le disque était sur le réglage par défaut de Proxmox, sans cache, qui est le défaut depuis Proxmox 222.
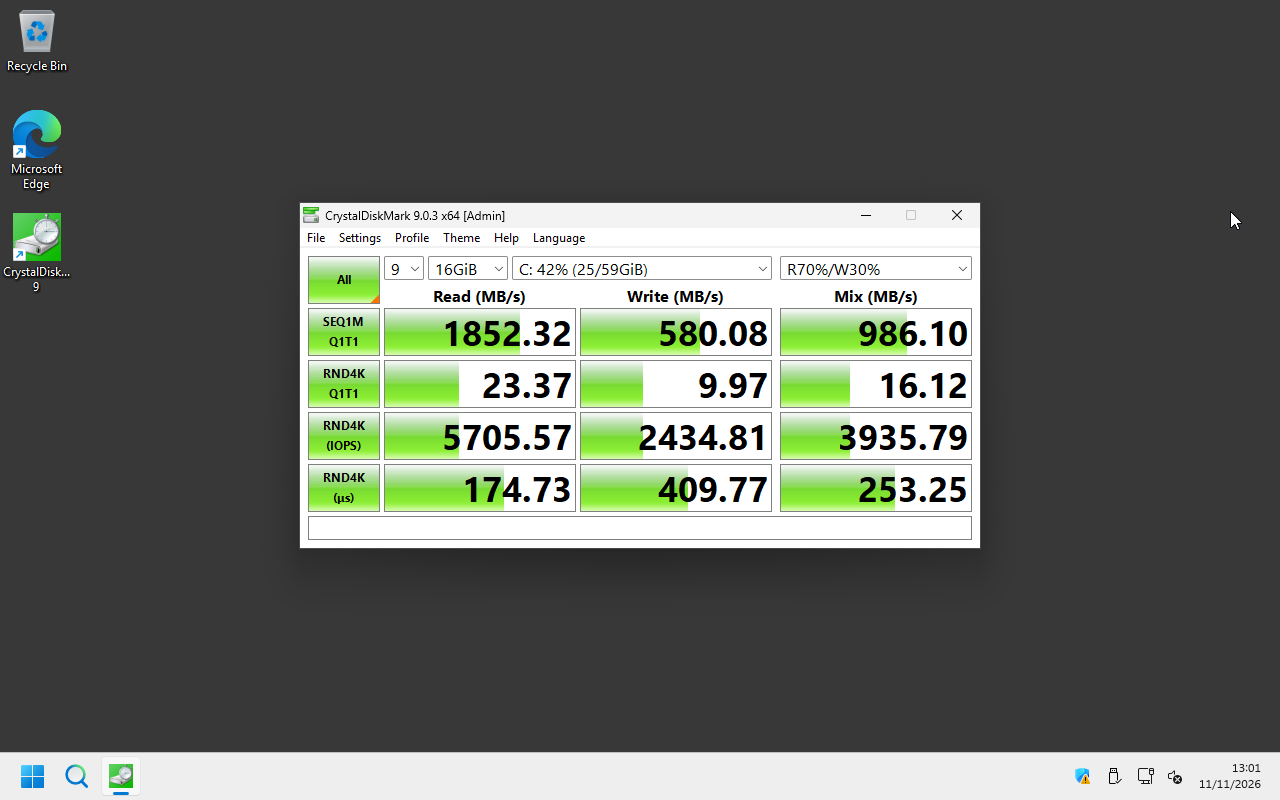
| Real World Performance [+Mix], 16 Gio | 3 passes | 9 passes | 9 passes, à nouveau |
|---|---|---|---|
| SEQ1M Q1T1 lecture | 1 279,71 Mo/s | 1 675,33 Mo/s | 1 852,32 Mo/s |
| SEQ1M Q1T1 écriture | 563,67 Mo/s | 576,65 Mo/s | 580,08 Mo/s |
| SEQ1M Q1T1 mixte | 1 043,75 Mo/s | 1 043,28 Mo/s | 986,10 Mo/s |
| RND4K Q1T1 lecture | 5 342 IOPS, 186,57 µs | 5 659 IOPS, 176,17 µs | 5 706 IOPS, 174,73 µs |
| RND4K Q1T1 écriture | 2 419 IOPS, 412,51 µs | 2 405 IOPS, 414,79 µs | 2 435 IOPS, 409,77 µs |
| RND4K Q1T1 mixte | 3 938 IOPS, 253,13 µs | 3 826 IOPS, 260,49 µs | 3 936 IOPS, 253,25 µs |
Les écritures et la latence des petits blocs restent à environ 1 % d’un test à l’autre. La lecture séquentielle grimpe de 45 % sur les trois. C’est le premier signe que la colonne de lecture ne mesure pas ce qu’elle semble mesurer.
L’hôte a été échantillonné toutes les cinq secondes pendant les trois tests, depuis /proc/diskstats pour les huit Optane, ceph status pour le pool et /proc pour chaque processus et chaque thread, et les deux points de vue ne racontent pas la même histoire.
Écritures : le disque est la petite partie
| Une écriture aléatoire de 4 Kio à la fois, dernier test | |
|---|---|
| Temps par écriture, vu par la VM | 409,77 µs |
| Temps par écriture, sur chaque Optane | 17 µs |
| Écritures arrivant aux Optane par écriture de la VM | 4,05 : deux copies, à peu près deux écritures chacune |
| Grosses écritures séquentielles | 580 Mo/s depuis la VM, 1,14 Go/s sur les Optane, la deuxième copie double le chiffre |
Le disque représente moins de 5 % d’une petite écriture. Les 393 µs restantes, c’est le trajet : QEMU, librbd, le messenger jusqu’à l’OSD, l’OSD lui-même et l’attente de la deuxième copie. Rien de tout cela n’a été mesuré séparément ici, je ne mettrai donc pas de chiffre sur chaque morceau. Ce que cela dit en revanche, c’est que sur cette machine les Optane ne sont pas la limite pour des E/S une à une, et qu’un disque plus rapide ne ferait pas beaucoup bouger ces 410. La limite est passée du côté client, la librbd livrée par Proxmox, et la suite viendra quand la librustyrbd de croit sera déployée ici.
Lectures : le cache, pas les Optane
Lors du dernier test, la passe de lecture aléatoire de 4 Kio a fait 5 700 lectures par seconde sur tout le fichier de 16 Gio, et les huit Optane n’ont rien lu du tout.
La passe séquentielle a atteint 2,2 Go/s au pool pendant que les lectures des disques eux-mêmes tombaient de 755 Mo/s à zéro.
CrystalDiskMark contourne le cache de l’invité et le disque n’en a aucun dans QEMU, donc la mémoire qui fait le travail est dans les OSD.
flashstore_obj_cache est activé par défaut dans ce build, la part du fichier de chaque OSD est d’environ 2 Gio en size 2, et chaque OSD avait grossi jusqu’à environ 2,6 Gio.
FlashStore ne rapporte pas ses hits, donc disons quasi certain plutôt que prouvé.
C’est aussi pour cela que la lecture séquentielle a progressé à chaque test : une plus grande part du fichier était déjà là.
Lisez la colonne de lecture comme un chiffre de cache, pas comme un chiffre du store.
CPU : où sont passés les cœurs
| Dernier test, en cœurs | Hôte occupé | OSD | vCPU de l’invité | librbd et client Ceph | QEMU |
|---|---|---|---|---|---|
| Au repos entre les passes | 20 à 24 % | 3,3 | 0,1 | 0,03 | 0,03 |
| Écriture aléatoire 4 Kio | 30 % | 3,9 | 0,38 | 0,20 | 0,08 |
| Lecture aléatoire 4 Kio | 30 % | 3,6 | 0,47 | 0,39 | 0,15 |
| Mixte séquentiel | 41 à 53 % | 3,8 | 1,5 à 2,3 | 0,5 | 0,12 |
Les trois colonnes de la VM viennent de ses threads : QEMU nomme les vCPU de l’invité, et les threads messenger et worker de librbd tournent dans le même processus.
La colonne des OSD bouge à peine. Huit OSD en polling coûtent 3,3 cœurs à ne rien faire et 3,9 à plein régime, donc sur une machine à 16 threads un cinquième du CPU est parti avant qu’une VM demande quoi que ce soit. Rien d’autre n’a approché sa limite. Le thread le plus occupé était un vCPU de l’invité à 47 %, et le plus occupé de librbd est resté sous 15 %. Avec une requête à la fois, la limite est l’attente, pas le travail, et un chiffre de CPU ne peut pas montrer une attente.
Mémoire : prévoyez le pic
| Sur les trois tests | |
|---|---|
| Santé | HEALTH_OK dans chaque échantillon, chaque PG active+clean, aucun redémarrage d’OSD |
| Hugepages utilisées | 4 Gio du début à la fin |
| Ce qui reste à distribuer pour l’hôte, avec une VM de 16 Gio en marche | 3,1 à 4,0 Gio |
La ligne des hugepages, c’est la section sur le budget, cette fois sous charge : 512 Mio par OSD, et les 12 Gio restants jamais touchés.
La mémoire ordinaire est le chiffre à surveiller, parce que le cache ci-dessus en est fait. Une fois qu’une lecture avait chargé le fichier, chaque OSD restait à environ 2,5 Gio, et voici ce que Ceph occupait sur un hôte de 58,7 Gio :
| Mémoire de Ceph au pic, cible par défaut de 4 Gio | |
|---|---|
| Processus OSD, les huit ensemble | 19,9 Gio, de 2,4 à 2,6 Gio chacun |
| Hugepages réservées aux OSD | 16 Gio, dont 4 Gio utilisés |
| Moniteur et gestionnaire | 0,3 Gio |
| Total | 36,2 Gio, 62 % de l’hôte |
| Ce qui reste à distribuer pour l’hôte, avec une VM de 16 Gio en marche | 3,6 Gio |
Elle revient, mais selon aucun calendrier que j’aie pu voir.
Elle est restée à 19,9 Gio pendant 25 minutes, pauses comprises, puis est tombée à 13,9 Gio à la fin du dernier test, et l’hôte avait de nouveau 10,2 Gio à distribuer.
osd_memory_target était pendant tout cela à sa valeur par défaut de 4 Gio par OSD, donc huit OSD avaient droit à 32 Gio avant même de compter une seule hugepage.
Sur un nœud qui doit aussi faire tourner des VM, c’est le pic qu’il faut budgéter avant les disques, et c’est là que les 12 Gio de hugepages inutilisés font le plus mal.
Trois VM à la fois, avec un budget plus serré
Une VM laisse beaucoup de place. À trois, le budget doit être juste. Deux réglages ont donc changé d’abord.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
La cible ne demande rien d’autre : chaque OSD a annoncé la nouvelle valeur en quelques secondes, et ils ont quand même été redémarrés un par un, les 257 PG revenant en active+clean avant le suivant.
Les hugepages ont un piège.
Avant chaque démarrage d’OSD, croit-flashstore-prep veut un --mem entier de libre, 2048 Mio, et agrandit le pool s’il en manque, mais ne le réduit jamais.
Le redémarrage d’osd.7 après la réduction a fait remonter le pool aussitôt :
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Le plancher qui survit à un redémarrage ou à un reboot, c’est donc ce qu’utilisent les OSD plus la marge d’un démarrage : 2 816 pages, 5,5 Gio, contre les 16 Gio que demande le contrôle. Le script d’installation plus haut réserve désormais exactement cela. Réduire à nouveau à 2 048 une fois les huit démarrés rapporte encore 1,5 Gio jusqu’au prochain redémarrage.
Ensuite, trois clones de la VM, à 10 Gio chacun, ont lancé CrystalDiskMark en même temps : Real World Performance [+Mix], trois passes, mais sur un fichier de 1 Gio chacun au lieu de 16 Gio. La colonne de lecture est donc plus que jamais un chiffre de cache, alors lisez les écritures.
| CrystalDiskMark, trois VM à la fois | VM 104 | VM 105 | VM 106 | Les trois | Une VM seule |
|---|---|---|---|---|---|
| SEQ1M Q1T1 écriture | 346,99 Mo/s | 318,99 Mo/s | 446,98 Mo/s | 1 113 Mo/s | 580,08 Mo/s |
| SEQ1M Q1T1 lecture | 796,05 Mo/s | 905,03 Mo/s | 1 160,93 Mo/s | 2 862 Mo/s | 1 852,32 Mo/s |
| RND4K Q1T1 écriture | 1 901 IOPS | 1 928 IOPS | 1 862 IOPS | 5 691 IOPS | 2 435 IOPS |
| RND4K Q1T1 latence d’écriture | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 lecture | 3 773 IOPS | 3 916 IOPS | 3 909 IOPS | 11 598 IOPS | 5 706 IOPS |
| RND4K Q1T1 mixte | 2 978 IOPS | 3 027 IOPS | 3 411 IOPS | 9 416 IOPS | 3 936 IOPS |
Trois VM ont obtenu 2,3 fois les petites écritures d’une seule, et chacune l’a payé d’environ 27 % de latence. Les Optane n’en étaient toujours pas la cause. Elles ont culminé à 20 900 écritures par seconde à 17 µs chacune, les mêmes 17 µs qu’avec une VM, et la plus occupée des huit l’était à 14 %.
| Hôte, toutes les cinq secondes pendant le test | Cible par défaut 4 Gio, une VM | Cible 1 Gio, trois VM |
|---|---|---|
| Plus gros processus OSD | 2,7 Gio | 1,15 Gio au pic, 0,8 ensuite |
| Les huit processus OSD ensemble | 19,9 Gio | 8,0 Gio au pic, 5,8 ensuite |
| Hugepages réservées | 16 Gio, 4 utilisés | 4 Gio, tous utilisés |
| Mémoire donnée aux VM | 16 Gio | 30 Gio |
| Ce qui reste à distribuer pour l’hôte, au plus bas | 3,1 Gio | 14,8 Gio |
| Croissance du swap | aucune | aucune |
FlashStore respecte donc bien osd_memory_target.
Il l’a dépassé de 15 % au pic d’une passe de lecture et est repassé en dessous, le cache faisant son travail dans le budget plutôt qu’en dehors.
Entre la cible et la réduction, 26 Gio sont revenus aux VM sur la même machine.
| CPU en cœurs, trois VM | Hôte occupé | OSD | Invités | librbd et client Ceph | QEMU |
|---|---|---|---|---|---|
| Trois démarrages de Fisher-Price OS (Windows) | 81 à 89 % | 3,4 à 3,6 | 6,3 à 7,9 | 0,4 à 0,7 | 0,3 |
| Benchmark | 42 à 73 % | 3,7 à 4,5 | 1,2 à 4,0 | 0,4 à 1,6 | 0,2 à 0,4 |
| Au repos ensuite | 20 à 24 % | 3,3 | 0,3 | 0 | 0 |
Démarrer trois invités a plus sollicité le CPU que les benchmarker. Le stockage en dessous n’en a jamais approché, et c’est le mini PC qui fixe la limite, comme il était écrit qu’il le ferait.
Tout cela, en un seul script
Tout ce qui précède tient dans un seul script. Donnez-lui les adresses PCI des disques que vous voulez comme OSD et il fait le reste, dans l’ordre de cet article, avec les deux correctifs Proxmox intégrés.
flashstore-pve-setup.sh : des OSD FlashStore sur un nœud Proxmox VElspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Il vérifie | Il écrit | Il exécute |
|---|---|---|
| Proxmox VE 9 et Ceph 21.2.0 Umbrella | le trousseau bootstrap-osd | une lecture en passthrough en tant que ceph, pour choisir kernel-cmd ou kernel |
| chaque disque : NVMe, sans cache d’écriture, ni monté, ni partitionné, ni tenu | le drop-in qui démarre en root puis passe par --setuser | prepare et systemctl enable --now pour chaque disque |
| aucune donnée dans les zones que lit la sonde de FlashStore | une règle udev par disque, par numéro de série | la vérification de l’hôte, qui ne s’arrête que sur ce dont les OSD ont besoin |
| des blocs de 4 Kio | une section [osd.N] par disque, un cœur physique chacune | le téléchargement du paquet, vérifié contre le SHA-256 de la version |
Rien n’est détruit sans que vous le demandiez.
--format-4k reformate un disque qui n’est pas en 4 Kio, un à la fois dans sa propre unité pour que rien ne l’interrompe, et --wipe l’autorise à écraser un disque qui contient des données.
--single-node ajoute la règle replicated_osd, et une nouvelle exécution saute les disques qui sont déjà des OSD.
Il a été testé ici, pas seulement écrit.
Il a refusé le SN750 à cause de son cache d’écriture, refusé le disque d’osd.7 tant qu’il contenait encore un store, puis, osd.7 purgé et ses nœuds de périphérique rendus à root, l’a reconstruit à partir de rien en 10,5 secondes, en choisissant tout seul le backend kernel.
Ce qu’il ne fera pas, c’est installer Ceph.
Cette étape vous demande d’accepter une Technology Preview, et c’est votre décision, pas celle d’un script.
Ce qui est à corriger
Rien de tout cela n’arrête un admin déterminé, et tout cela arrêterait un admin débordé. Chaque point est une affirmation que croit fait à quiconque télécharge le paquet, et je me suis heurté à chacun dès le premier essai.
| Où | Ce qui se passe | Ce qui corrigerait |
|---|---|---|
| unité systemd | User=ceph ne peut pas lire pmxcfs, donc l’OSD ne démarre jamais sur un nœud pveceph | livrer le démarrage en root puis --setuser, ou un drop-in Proxmox |
| repli kernel-cmd | ne se replie que si Identify est refusé ; sur le noyau de PVE, c’est Read qui l’est, et l’OSD s’arrête | se replier en E/S directes sur toute E/S passthrough refusée |
| udev | la doc exige une règle qui donne à ceph les nœuds du namespace ; aucune n’est livrée | en livrer une calée sur les périphériques configurés |
synthèse de --check | dit que le NVMe noyau est « compiled out » alors que c’est le seul chemin de stockage compilé | corriger le libellé |
code de sortie de --check | le SSD de démarrage échoue au test PLP, donc le 0 est inatteignable | ne noter que les périphériques configurés ou candidats |
| hugepages | 2048 Mio par OSD, et prep les veut libres à chaque démarrage ; le backend noyau en utilise 512 | dimensionner le backend noyau selon son usage, et que prep demande la même chose |
sha256sums.txt | les noms de fichiers ne correspondent pas aux assets de la release | les nommer comme publiés |
| nom du paquet | la doc dit apt remove flashstore ; le paquet est croit-flashstore-osd | un seul nom, ou le bon dans la doc |
référence de flashstore_dev | ne liste que spdk: et file: | documenter kernel: et spdk: avec un backend noyau |
Rien de tout cela n’est du travail neuf. Le démon a déjà l’abandon de privilèges, le backend direct et la logique de repli. Ils n’ont simplement pas été reliés pour la plateforme sur laquelle la plupart des gens l’essaieront en premier.
C’est dans une préversion qu’on découvre cela
Une préversion est le bon endroit pour chacun de ces constats, et le mauvais endroit pour les y laisser. C’est à cela que sert une préversion : quelqu’un la ramène chez lui, la met sur le matériel qu’il a vraiment, et note où elle tombe. Ce qui compte a tenu. Le magasin a démarré en quelques millisecondes, les OSD ont rejoint un cluster construit par l’outillage de quelqu’un d’autre, et l’installation d’un système d’exploitation s’est faite dessus sans un défaut.
Ce qui l’a fait trébucher, c’est tout ce qu’il y a autour du démon. Un fichier de configuration sur un système de fichiers que l’unité ne pouvait pas lire, un noyau qui dit non à un appel que l’amont autorise, un disque de démarrage que le contrôle ne voulait pas cesser de compter. Rien de tout cela n’est difficile. Tout cela fait la différence entre un logiciel qui marche et un logiciel qui marche sur votre machine, et la seule façon de combler l’écart, c’est de tester sur les machines que les gens ont plutôt que sur celles que vous avez construites pour lui.
Malgré tout, c’est un début prometteur. Sur un mini PC bas de gamme, avec encore la librbd classique côté client et les huit disques sur une seule liaison PCIe 3.0, les Optane travaillent ici plus dur que sous BlueStore. À mesure que cela évolue, j’y reviendrai pour creuser davantage, à mesure qu’une plus grande partie de la pile sera remplacée, avec aussi un regard sur CephFS2.
« Remplacement direct » est une promesse faite à un admin qui n’a pas le temps de lire le source. Les moniteurs de Proxmox, la GUI de Proxmox, le noyau de Proxmox et un paquet de quelqu’un d’autre, c’est exactement la situation à laquelle s’adresse cette promesse. Elle est presque tenue aujourd’hui. Neuf petits correctifs et elle le sera, et je préfère être celui qui les a trouvés un mercredi matin plutôt qu’un client qui les trouve un vendredi soir.
croit/ceph-rust README — en préversion publique depuis le 9 novembre 2026, « not yet recommended for production data », exigences, démarrage rapide, ensemble de fonctionnalités de production, commit Ceph testé. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — les paquets utilisés ici, dont
flashstore_…_debian-trixie_amd64.debetsha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — contrôle du cache d’écriture volatil, hugepages, notes sur les versions du noyau. ↩︎
croit/ceph-rust — branches and versions —
mainvise v21.2.0,v20.2.4vise v20.2.4 ; « The daemon refuses a cluster release outside its supported window. » ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellalisté avecrelease => '21.2'etunsupported => 1. ↩︎croit/ceph-rust — build and install packages — distributions, glibc 2.34, gestion de
ceph-osd.target, la ligneapt remove. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstoreet pourquoi il vautbluestorepar défaut. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — ligne 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — le contrôle de l’hôte en lecture seule ; « Exit 0 means no FAIL. » ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — les deux modes noyau, la comparaison mesurée, le budget de l’allocateur de charge utile, la résolution des adresses
spdk:et le repli limité à Identify (amendement 6). Ajouté au dépôt le soir même de la release. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — le système de fichiers de cluster sous
/etc/pve, avec son propriétaire et ses permissions fixes. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activate, et unCapabilityBoundingSetsansCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — l’abandon de privilèges classique
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — « the namespace node must be readable and writable by user
ceph(udev rule) ». ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), la règle du passthrough NVMe non privilégié. ↩︎croit/ceph-rust — security — «
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring». ↩︎croit/ceph-rust — prepare, activate and list — la sonde de périphérique non vide et
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypene vautbluestoreque si les métadonnées portentbluefs, sinonfilestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()associeosd.Nà l’unité systemdceph-osd@N. ↩︎Ceph documentation — CRUSH maps — règles répliquées, domaines de défaillance et classes de périphérique. ↩︎
CrystalDiskMark — Crystal Dew World’s disk benchmark ; “Various measure mode (Peak/Real World/Demo)”. ↩︎
Proxmox VE wiki — Performance Tweaks — the disk cache modes : “cache=none seems to be the best performance and is the default since Proxmox 2.X”. ↩︎