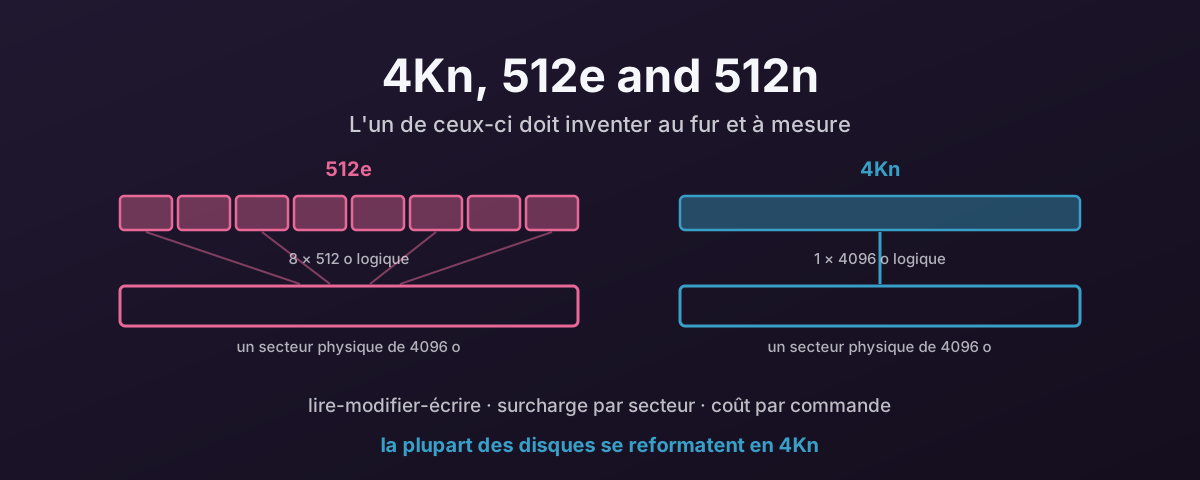
Trois façons pour un disque de se présenter
Un disque a deux tailles de bloc, et la différence entre elles est toute l’histoire.
Le secteur physique est ce dans quoi le support travaille réellement — la plus petite unité que le disque peut lire ou écrire sans faire de travail supplémentaire. Le bloc logique est ce dans quoi le disque dit à l’hôte qu’il travaille — l’unité que l’hôte adresse.
Il y a trois combinaisons dans la nature.
512n — 512 natif. Les deux tailles sont de 512 octets. C’est le vieux monde : disques durs d’avant 2010, et rien que vous achèteriez neuf aujourd’hui à une taille qui vaille la peine.
512e — émulation de 512 octets. Le secteur physique est de 4096 octets, mais le disque rapporte des blocs logiques de 512 octets et traduit dans le micrologiciel. Cela existe pour une seule raison : la compatibilité avec les systèmes d’exploitation, les chargeurs d’amorçage et les applications qui ont toujours supposé 512. Assez sensé comme ingénierie, et la racine de la quasi-totalité des ennuis qui suivent.
4Kn — 4K natif. Les deux tailles sont de 4096 octets. Le disque dit la vérité, l’hôte l’adresse dans l’unité que le support utilise, et aucune couche de traduction ne se glisse entre les deux.
Ce que le 512e fait à chaque écriture non alignée
Une lecture est bon marché dans les trois cas. Le disque lit le secteur de 4K et rend la tranche de 512 octets que vous avez demandée.
C’est aux écritures que la fiction devient chère.
Si l’hôte écrit un seul bloc logique de 512 octets, le disque ne peut pas écrire 512 octets. Le support n’a pas une telle unité. Alors il fait ceci à la place :
- Lire tout le secteur physique de 4096 octets.
- Fusionner les 512 octets de nouvelles données dedans.
- Réécrire tout le secteur de 4096 octets.
C’est un lire-modifier-écrire, et cela transforme une petite écriture en une lecture plus une écriture. Sur un disque à plateaux, cela veut dire attendre que le plateau revienne. Une rotation complète à 7 200 tr/min, c’est quelque chose comme 8 ms que vous n’aviez pas budgétés. Sur la flash, le coût est d’une autre nature, et il ne disparaît pas quand l’écriture finit. Celui-là a sa propre section plus bas.
Le désalignement est la version de ceci qui mord le plus fort. Si une partition commence à un décalage impair de 512 octets — le classique étant la vieille convention des 63 secteurs — alors chaque écriture de système de fichiers 4K est à cheval sur deux secteurs physiques. Ce n’est pas un lire-modifier-écrire, c’en est deux, à chaque écriture, pour toujours, jusqu’à ce que quelqu’un repartitionne le disque.
L’amplification d’écriture sur la flash
Sur un disque dur, le lire-modifier-écrire vous coûte une rotation et puis c’est fini. Sur la flash, il vous coûte de la vie du disque, et c’est une facture que vous payez une fois et continuez de payer.
L’amplification d’écriture est le rapport entre ce qui a réellement été écrit sur la NAND et ce que l’hôte a demandé d’écrire. Un rapport de 1,0 voudrait dire que le disque a écrit exactement ce qu’on lui a donné. Ce n’est jamais 1,0, parce que la flash ne peut pas réécrire sur place : le disque programme une page fraîche, marque l’ancienne comme périmée, et le ramasse-miettes relocalise plus tard les pages survivantes pour qu’un bloc entier puisse être effacé. Ces relocalisations sont aussi des écritures.
Le 512e ajoute une couche évitable par-dessus cela, et la raison est un détail à énoncer clairement : la couche de traduction du disque mappe en unités d’environ 4 Ko quelle que soit la taille de bloc logique qu’elle annonce. Un disque rapportant des blocs de 512 octets suit encore des unités de 4 Ko en interne.
Donc une écriture de 512 octets de l’hôte devient, à l’intérieur du disque : lire l’unité de mappage de 4 Ko, y fusionner les 512 octets, programmer une nouvelle unité de 4 Ko. 4096 octets atteignent la NAND pour que 512 octets aient pu changer. Huit fois l’écriture, pour cette écriture.
Le désalignement est moins dramatique par écriture et pire au total. Une écriture de 4 Ko à cheval sur deux unités de mappage les salit toutes deux, donc 8 Ko sont programmés pour 4 Ko de données. C’est une amplification de 2× à chaque écriture, en permanence, jusqu’à ce que la table de partitions soit corrigée.
Les effets en cascade sont ce qui rend cela important plutôt que simplement négligé :
- Plus d’écritures NAND veut dire que le ramasse-miettes tourne plus souvent, et ses relocalisations sont elles-mêmes de l’amplification.
- Un cache d’écriture SLC se remplit plus tôt, donc le disque tombe plus tôt dans son régime établi plus lent et le débit d’écriture soutenu chute.
- Les cycles programmation/effacement sont consommés en proportion de ce qui a atteint la NAND, pas de ce que l’hôte a envoyé. Doublez l’amplification et vous avez divisé par deux la vie du disque pour la même charge.
- Les notes d’endurance — TBW, DWPD — sont indiquées contre les écritures de l’hôte. L’amplification grignote cette marge en silence, et le disque s’use avant l’arithmétique de garantie que vous aviez faite à l’achat.
Les écritures directes et synchrones sont le pire cas
La plupart du temps, le cache de pages cache tout cela. Le noyau accumule les petites écritures, les fusionne, et émet des IO de 4 Ko ou plus vers le disque, donc le lire-modifier-écrire n’arrive jamais.
Deux drapeaux retirent cette protection, et les applications qui tiennent à la durabilité mettent les deux.
O_DIRECT contourne le cache de pages.
Il n’y a désormais plus rien entre l’application et le disque pour fondre une écriture de 512 octets en quelque chose de la taille d’un secteur.
O_SYNC ou O_DSYNC exige que l’écriture soit sur un support stable avant que l’appel ne revienne.
Cela empêche le disque d’absorber l’écriture dans un tampon volatil et de la combiner avec ses voisines plus tard.
Mettez-les ensemble et chaque écriture de 512 octets est un cycle complet de lire-modifier-écrire qui doit finir maintenant, seul, sans rien contre quoi l’amortir. C’est là que l’amplification sur un disque 512e approche son 8× théorique, et c’est exactement le schéma que produisent un journal de commit de base de données, un ZIL de ZFS ou un WAL BlueStore de Ceph.
La protection contre la coupure de courant est ce qui sauve cela sur le matériel d’entreprise. Un disque avec PLP peut acquitter une écriture synchrone dès qu’elle est dans un tampon DRAM adossé à un condensateur, qui est durable, et coalescer quand même en interne avant de programmer la NAND. Un disque grand public sans PLP doit atteindre la flash avant de pouvoir répondre, donc il paie le plein coût par écriture. Une raison de plus pour laquelle le PLP n’est pas optionnel pour ce genre de charge.
Dans Proxmox, le mode de cache décide lequel de ceux-ci vous obtenez :
cache=noneestO_DIRECT— le défaut de PVE, et le bon choix pour du tout-flash HA. Le cache de pages de l’hôte est hors du chemin, donc les schémas d’écriture de l’invité atteignent le disque tels que l’invité les a émis.cache=directsyncestO_DIRECTplusO_DSYNC— chaque écriture synchrone. C’est un réglage de niche pour des disques dédiés aux journaux de base de données et inutilisable pour des charges générales.
Sur un périphérique d’appui 512e, cache=directsync avec un invité qui commite en enregistrements de 512 octets est à peu près l’arrangement le moins efficace disponible : pas de coalescence de l’hôte, pas de coalescence du disque, et un lire-modifier-écrire par commit.
Et voici la partie qui rend le 4Kn structurel plutôt que simplement préférable.
O_DIRECT exige que le décalage, la longueur et le tampon soient alignés sur la taille de bloc logique du disque.
Sur un disque 512e, c’est 512 octets, donc une écriture directe de 512 octets est légale et le disque la paie en silence.
Sur 4Kn, le bloc logique est 4096, donc la plus petite écriture directe que le noyau acceptera est de 4 Ko.
Le schéma pathologique cesse d’être quelque chose que vous devez éviter et devient quelque chose que la pile ne peut pas exprimer.
Surcharge sur le support
Le deuxième coût est structurel, et c’est la raison pour laquelle l’Advanced Format existe tout court.
Un secteur n’est pas que ses données. Sur un disque dur, chacun porte une marque de synchronisation pour que la tête sache où le secteur commence, un intervalle pour que les secteurs consécutifs ne se percutent pas, un marqueur d’adresse, et un champ ECC pour corriger les erreurs de lecture.
Avec des secteurs de 512 octets, vous payez tout cela huit fois pour chaque 4K de données. Avec un secteur de 4K, vous le payez une fois.
Cela a deux conséquences, et la seconde compte plus que la première :
- Une partie du plateau qui était de la surcharge devient de la capacité utilisable. C’était la motivation annoncée de l’industrie pendant la transition vers l’Advanced Format, dans les faibles pourcentages à un chiffre.
- Le champ ECC peut être bien plus grand pour la même surcharge totale. Un code fort protégeant 4096 octets corrige bien plus que huit codes faibles protégeant chacun 512 octets. À mesure que la densité surfacique grimpait, cela a cessé d’être un luxe et est devenu le seul moyen de garder des taux d’erreur acceptables.
La flash n’a ni marques de synchronisation ni intervalles de rotation, mais la même logique s’applique un niveau plus haut : la NAND est programmée en pages, les pages sont bien plus grandes que 512 octets, et les tables de mappage du disque ont une entrée par unité adressable. Des blocs logiques plus petits veulent dire plus de métadonnées pour suivre la même capacité.
Surcharge dans l’hôte : commandes et interruptions
Le troisième coût est celui que les gens ratent, parce qu’il n’est pas du tout sur le disque.
La taille de bloc logique fixe le plancher de la petitesse d’une IO. Sur un disque logique de 512 octets, un système de fichiers ou une application est libre d’émettre une écriture de 512 octets, et chacune est une IO complète : une commande construite et soumise, une écriture de sonnette, une entrée dans la file d’achèvement, et une interruption pour dire qu’elle a fini.
Chacune de celles-ci a un coût fixe qui se moque de la quantité de données impliquée. Déplacez 4 Ko en huit commandes de 512 octets et vous payez ce coût huit fois. Déplacez-le en une commande de 4K et vous le payez une fois.
Deux réserves honnêtes, parce que c’est là que l’argument est d’ordinaire exagéré.
Pour les grandes IO, la taille de bloc logique ne change rien au nombre de commandes. Une seule commande peut décrire beaucoup de blocs, donc une écriture séquentielle de 1 Mo est une commande que les blocs fassent 512 octets ou 4K. L’économie n’est réelle que là où de petites IO sont émises.
Là où de petites IO sont émises, cependant, l’effet n’est pas subtil : chacune de ces huit requêtes est une que le noyau doit construire, ordonnancer et achever, chacune avec sa propre interruption MSI-X et sa transition utilisateur-vers-noyau, et à des profondeurs de file élevées, c’est ainsi qu’on obtient une tempête d’interruptions. Dans une VM, c’est encore pire, parce que chacune de ces interruptions est aussi un changement de contexte de l’invité.
Et les contrôleurs NVMe modernes regroupent les interruptions, donc le nombre d’interruptions n’est pas simplement le nombre de commandes. Le travail de soumission et d’achèvement par commande demeure, cependant, et à quelques centaines de milliers d’IOPS le coût CPU par commande est une fraction mesurable d’un cœur. C’est la même arithmétique que les interruptions postées dans la série passthrough — de petits coûts fixes multipliés par un très grand nombre.
4Kn, métadonnées de secteur et RAID matériel
Passer à un format 4096 + 0 a une conséquence qui prend les gens au dépourvu, et elle retombe carrément sur le RAID matériel.
Certains contrôleurs RAID et baies de stockage n’utilisent pas du tout de simples secteurs de 512 ou 4096 octets. Ils formatent les disques à une taille étendue — 520 ou 528 octets, ou les équivalents 4K comme 4104, 4160 et 4224 — parce que ces octets supplémentaires par secteur sont là où le contrôleur garde ses propres métadonnées. Ce sont des informations de protection T10-PI/DIF, ou des données d’intégrité du fabricant, stockées en ligne avec les données mêmes qu’elles décrivent.
Un format 4096 + 0 n’a nulle part où les mettre. Le secteur est des données, de bout en bout, et c’est tout l’intérêt de le choisir.
Un contrôleur qui veut des métadonnées en ligne a donc trois options, et aucune n’est gratuite :
- Refuser le disque.
- Le reformater en un format étendu, défaisant le travail 4Kn que vous venez de faire.
- Garder ses métadonnées ailleurs sur le disque.
La troisième est là où la flash vous punit. Des métadonnées écrites séparément des données qu’elles décrivent sont une seconde écriture, à un décalage différent, atterrissant dans une unité de mappage différente. Une autre page NAND programmée pour chacune que vous vouliez réellement écrire. C’est l’amplification de la section précédente, réintroduite délibérément, pour porter des métadonnées d’intégrité que le disque aurait pu tenir en ligne pour rien si vous l’aviez laissé dans un format étendu.
Vous ne pouvez pas avoir les deux. Soit le secteur porte les métadonnées du contrôleur, soit il ne porte que vos données.
Ce qui fait que la flash a plutôt sapé les arguments pour le RAID matériel
Le reste de ceci est du jugement plutôt que du mécanisme, alors prenez-le comme tel.
Un contrôleur RAID matériel est un RAID logiciel tournant sur un processeur dédié. Le « matériel » est un CPU, un peu de DRAM et une batterie. Pas une façon fondamentalement différente de calculer la parité. Ce qu’il vous achetait historiquement était un cache d’écriture adossé à une batterie et un déchargement de la parité, et sur la flash les deux arguments ont mal faibli. Le NVMe d’entreprise a déjà son propre cache protégé contre la coupure de courant, et le contrôleur devient un plafond de bande passante devant des périphériques qui peuvent chacun saturer plusieurs gigaoctets par seconde.
Il vous coûte aussi des choses que vous voulez désormais activement :
- L’état du périphérique disparaît. Le détail SMART, les indicateurs d’usure et les journaux du fabricant qui vous laissent calculer l’amplification d’écriture sont tous derrière une abstraction opaque.
- Pas de sommes de contrôle de bout en bout. Un contrôleur vérifie la parité, ce qui détecte un disque manquant, pas une mauvaise réponse d’un disque présent. ZFS et Ceph font la somme de contrôle des données elles-mêmes et peuvent vous dire quelle copie est fausse — une corruption silencieuse qu’un contrôleur laisse passer tout droit. À ce titre, le contrôleur résout le mauvais problème.
- Les métadonnées du fabricant sur les disques lient la baie à une famille de contrôleurs, ce qui est son propre genre de peu fiable quand c’est le contrôleur qui lâche.
- Le RAID à parité fait son propre lire-modifier-écrire sur les écritures de bande partielle, s’empilant par-dessus tout ce qui précède.
Pour Ceph, ce n’est même pas une préférence. Les propres conseils hyper-convergés de Proxmox sont que les disques doivent être présentés en mode HBA ou pass-through, pas derrière un contrôleur RAID, et ZFS veut exactement la même chose pour les mêmes raisons.
L’arrangement qui découle de tout cela est donc : un HBA plutôt qu’un contrôleur RAID, des disques formatés 4Kn avec zéro métadonnée, et la redondance plus les sommes de contrôle faites par ZFS ou Ceph, qui peuvent réellement vous dire quand un disque a menti. Si quelque chose dans votre parc a vraiment besoin d’un format de secteur étendu, c’est un « soit l’un soit l’autre » délibéré à régler pendant que les disques sont encore vides. Pas quelque chose à découvrir une fois les OSD construits.
Où le 512e mord réellement
Il serait malhonnête de prétendre que le 512e ruine un système moderne, parce que d’ordinaire non.
Une pile Linux à jour lit la taille de secteur physique, aligne les partitions dessus — parted et sfdisk le font tous deux par défaut maintenant — et utilise des blocs de système de fichiers de 4K.
Dans cette configuration, l’hôte émet des IO de 4K alignées sur 4K, le disque n’a jamais besoin d’un lire-modifier-écrire, et le 512e ne vous coûte presque rien.
Les problèmes sont précis :
- Partitions désalignées, d’ordinaire héritées d’une vieille installation ou d’une image clonée. Deux lire-modifier-écrire à chaque écriture.
- ZFS avec
ashift=9sur un disque 512e, parce que ZFS a cru le 512 rapporté. Chaque écriture d’enregistrement devient un lire-modifier-écrire, et vous ne pouvez pas changerashiftaprès coup — le pool doit être reconstruit. - Applications qui écrivent des enregistrements de 512 octets avec O_DIRECT, contournant la coalescence du cache de pages. Certaines bases de données et beaucoup de logiciels sur mesure font cela.
- Tout ce qui fait confiance à la taille logique pour être la vraie. C’est le tort réel dans l’émulation : elle distribue un nombre qui est faux, et les choses en aval prennent des décisions avec.
Le 4Kn retire toute la catégorie. Le disque ne peut pas mentir sur une taille de secteur qu’il n’a pas.
Il vaut d’être franc sur la taille du prix, cependant. Les propres conseils de Seagate sont que le 4Kn vaut clairement d’être poursuivi quand la pile est pleinement optimisée pour le 4K et que vous comptez chaque IOPS — un palier tout-flash réglé, disons. En dessous, sur un Linux moderne correctement aligné, la différence de performance pour des IO alignées est souvent petite. L’autre argument est la cohérence du parc : un parc uniformément 4Kn n’a pas de surprises de format mélangé, et personne n’a à se rappeler quels disques mentent.
La plupart des disques peuvent être convertis — si le fabricant le permet
C’est la partie qu’on rate : le 512e est souvent un réglage de format, pas une propriété du matériel. Un très grand nombre de disques SAS et SATA d’entreprise, et la plupart des NVMe d’entreprise, sortent en rapportant 512 octets et se reformateront volontiers en 4Kn.
Tout ce qui suit détruit chaque octet du périphérique. Il n’y a pas de conversion sur place.
NVMe — nvme-cli
Regardez d’abord ce que le namespace prend en charge :
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Vous voulez un format avec Data Size 4096 et Metadata Size 0, marqué comme le meilleur et pas actuellement en usage. Puis appliquez-le :
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
La taille de métadonnées compte autant que la taille de donnée. Certains formats d’usine réservent des octets supplémentaires par secteur — 520, ou 4160 — pour porter des métadonnées de protection T10-PI/DIF de bout en bout. Si rien dans votre pile ne les consomme, c’est du remplissage sur chaque secteur, alors choisissez le format à zéro métadonnée et débarrassez-vous-en. Choisir un format porteur de métadonnées par accident vous donne aussi un disque qui se comporte différemment de celui que vous vouliez créer, et combiner un changement de taille de secteur avec un changement de PI peut forcer un formatage complet lent plutôt qu’un rapide.
Pour tout un hôte de disques, faites une boucle. Cela a besoin de shopt -s extglob pour les globs étendus, et cela ne sélectionne que les formats qui sont en 4096/0 et pas en usage :
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Deux choses là-dedans font plus de travail qu’il n’y paraît.
Le glob correspond aux namespaces — nvme0n1, nvme12n3 — et délibérément ne correspond pas aux partitions comme nvme0n1p1, parce que le motif finit après les chiffres qui suivent le n. C’est la différence entre reformater un namespace et faire quelque chose d’irrécupérable à un système en marche.
Et la sélection ne convertit jamais qu’un disque qui offre réellement ce que vous avez demandé. Tout le reste tombe à -1 et est sauté, ce qui couvre trois cas distincts :
- Le disque n’offre que 512. Aucun format de 4096 octets n’existe, donc il n’y a rien vers quoi convertir et la boucle le laisse tranquille. Elle n’essaie pas, et elle n’échoue pas à mi-chemin.
- Le disque est déjà en 4Kn. Le format 4096/0 est celui en usage, et
(?!.*in use)l’exclut — donc un second passage sur le même hôte est sans effet. Pas de reformatage inutile de chaque disque. - Les seuls formats 4096 portent des métadonnées. Un format 4096 + 8 ne satisfait pas
Metadata Size: 0, donc la boucle ne vous remettra pas en silence un disque T10-PI que vous n’avez pas demandé.
Autrement dit, elle échoue de façon fermée. Quand elle n’est pas sûre, elle saute.
Une note de portabilité : ces anticipations ont besoin du mode -P (PCRE) du grep GNU. Sur un système où grep est autre chose, le motif ne correspond à rien et chaque disque est sauté. Agaçant, mais au moins ça se trompe dans le sens sûr.
Lisez la boucle avant de la lancer, tout de même.
Là où elle correspond bien, elle reformate sans autre demande. nvme format --force ne demande pas deux fois.
Elle a sa place dans le provisionnement, sur une machine dont les disques ne contiennent rien, jamais sur un hôte avec un OSD, un pool ou un disque de VM en vie.
Sur FreeBSD, l’équivalent est nvmecontrol, où -f est l’index de format :
nvmecontrol format -f 1 nvme0ns1
SAS et SATA — openSeaChest
L’openSeaChest de Seagate est multiplateforme, libre, et marche aussi sur les disques d’autres fabricants.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Cette phrase de confirmation n’est pas moi qui dramatise. C’est la chaîne littérale que l’outil exige, et la partie « may render the drive inoperable » est réelle. Un formatage de bas niveau interrompu par une coupure de courant peut laisser un disque qui a besoin d’un autre formatage avant de marcher tout court.
En dessous, l’opération diffère selon le transport : SAS et SCSI utilisent Format Unit, SATA utilise Set Sector Configuration Ext — le chemin de format rapide — et NVMe utilise NVM Format. Pour un disque SAS, vous pouvez piloter Format Unit directement, et notez que cette option prend la chaîne de confirmation la plus courte :
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Deux options différentes, deux chaînes de confirmation différentes — inversez-les et l’outil refuse.
Là où le disque prend en charge un format rapide, la taille de secteur change en secondes plutôt qu’en heures ; le disque fait ensuite son travail d’intégrité et de fond après, et écrire vos vraies données dessus réduit ce temps de fond. Un formatage complet écrit des zéros de bout en bout et peut prendre de nombreuses heures à des jours sur un gros disque à plateaux.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI — sg_format
Pour tout ce qui parle SCSI, sg3_utils fera le même travail :
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format vous donne un compte à rebours de 15 secondes avant de s’engager, que --quick saute.
Sa documentation avertit aussi d’un échec précis à connaître : si le changement de taille de bloc réussit mais que le formatage échoue ensuite, le disque peut finir dans un état « format corrupt » et a besoin d’un autre formatage pour s’en remettre.
Avant de convertir quoi que ce soit
- Vérifiez le chemin d’amorçage. Un disque 4Kn comme périphérique de démarrage a besoin d’UEFI et d’un système d’exploitation qui le prend en charge. Le Linux moderne va bien. Le vieux Windows non, et certains contrôleurs RAID matériels refusent encore le 4Kn entièrement.
- Faites-le avant que le disque ne contienne quoi que ce soit. Le rétrofit veut dire évacuer, convertir, restaurer.
- Faites-en un, puis vérifiez. Convertissez un seul disque, confirmez les tailles rapportées, puis faites le reste.
- Attendez-vous à des heures sur un disque à plateaux sans format rapide. Ne lancez pas un formatage de bas niveau sur une machine dont vous avez besoin bientôt.
Vérifier ce que vous avez
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical est un disque 512e.
Des nombres qui correspondent veulent dire natif — 512n si les deux sont 512, 4Kn si les deux sont 4096.
Et vérifiez que les partitions s’alignent réellement :
parted /dev/sda align-check optimal 1
ZFS, Ceph et disques virtuels
ZFS — réglez ashift=12 explicitement à la création d’un pool, et ne vous fiez pas à la taille rapportée par le disque, parce que sur 512e il vous dira 9 et se trompera. Cela ne peut pas être changé plus tard.
Ceph — la taille d’allocation minimale de BlueStore devrait être de 4 Ko sur flash. Le Ceph moderne met 4096 par défaut, mais les versions plus anciennes mettaient plus haut par défaut — autour de 16 Ko sur SSD et 64 Ko sur HDD — et cela convient mal aux disques de VM RBD, parce qu’ils émettent beaucoup de petites écritures aléatoires de 4 Ko et qu’une écriture de 4 Ko atterrissant dans une unité d’allocation de 16 ou 64 Ko à la fois amplifie l’écriture et gaspille le reste en remplissage. C’est fixé à la création de l’OSD, donc cela doit être réglé avant de créer ou de reconstruire :
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Il y a un bluestore_min_alloc_size_hdd correspondant. Les OSD existants gardent ce avec quoi ils ont été construits, donc le changer veut dire les reconstruire.
Disques virtuels — un invité voit ce que l’hyperviseur présente, pas le disque sous-jacent, donc un disque 4Kn sous une VM remet quand même à l’invité des blocs de 512 octets à moins que vous ne disiez le contraire. Garder la pile 4K de bout en bout veut dire dire à QEMU de présenter du 4K, ce qui dans Proxmox est une ligne d’argument brute dans /etc/pve/qemu-server/<vmid>.conf :
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Cette ligne est ce qui force réellement QEMU en 4Kn pour ces disques — -global l’applique à chaque périphérique scsi-hd de la VM, donc l’invité se voit dire 4096 pour la taille de bloc logique et physique et partitionne et s’aligne en conséquence.
Ne mettez pas toute la chaîne entre guillemets. Proxmox analyse args: avec Text::ParseWords::shellwords, donc ceci :
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
se réduit à un seul argument — les guillemets sont honorés et retirés, et QEMU se voit remettre une longue option inanalysable plutôt que quatre. Sans guillemets, la même ligne se découpe en -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, ce qui est ce que vous voulez. C’est une erreur facile à faire parce que mettre des guillemets est le bon instinct sur une ligne de commande, et l’échec — une VM qui ne démarre pas, se plaignant de l’option — ne ramène pas aux guillemets.
Faites ceci avant d’installer le système d’exploitation invité. Changer la taille de bloc d’un disque sous un système déjà installé peut le laisser non amorçable, parce que la disposition des partitions et le chargeur d’amorçage ont été écrits pour des secteurs de 512 octets. Notez aussi qu’args: est une trappe d’échappement d’expert hors de la gestion de l’interface, et que l’interaction avec la migration à chaud et les instantanés vaut d’être revérifiée contre la documentation Proxmox à jour.
Quand l’invité dit 512 et l’hôte dit 4K
C’est le cas qui vaut d’être compris correctement, parce que c’est ce que vous obtenez par défaut après avoir fait tout le travail ci-dessus.
QEMU présente des blocs logiques de 512 octets à l’invité à moins qu’on ne lui dise le contraire, quel que soit le périphérique d’appui. Vous pouvez donc convertir chaque disque de l’hôte en 4Kn, et les VM par-dessus se verront quand même dire 512 — et elles le croiront.
L’invité partitionne alors sur des limites de 512 octets parce qu’il le peut, et émet des IO de 512 octets parce qu’il le peut. Mais le périphérique hôte a désormais réellement un bloc logique de 4096 octets, et il n’acceptera pas une écriture de 512 octets. Quelque chose doit réconcilier les deux, et ce quelque chose est l’hôte : QEMU lit les 4 Ko environnants, y fusionne les 512 octets de l’invité, et réécrit le tout.
Vous n’avez pas retiré l’émulation. Vous l’avez déplacée du micrologiciel du disque vers votre hyperviseur, où elle coûte du CPU hôte et un tampon de rebond au lieu de cycles de disque.
Avec cache=none, ce n’est pas non plus une pénalité douce. O_DIRECT contre un périphérique 4Kn exige des décalages et des longueurs alignés sur 4 Ko, donc une écriture d’invité de moins de 4K ne peut pas simplement être passée telle quelle — l’alignement doit être corrigé dans QEMU avant même que l’IO ne soit émise.
Et le cas du désalignement revient un niveau plus haut. Un invité partitionné avec une granularité de 512 octets met ses écritures de système de fichiers de 4 Ko à des décalages à cheval sur deux blocs hôte de 4 Ko, donc chacune devient deux lire-modifier-écrire sur l’hôte. Même échec qu’une partition désalignée sur un disque 512e nu, sauf qu’il se produit maintenant dans une VM où personne ne le cherche.
La règle est donc : si l’hôte est en 4Kn, présentez aussi du 4K à l’invité, et faites-le avant que le système d’exploitation ne soit posé.
L’exception est la prise en charge par l’invité, qui est toute la raison pour laquelle le 512e existe :
- Les invités Linux gèrent le 4Kn sans histoire.
- Windows prend en charge le 4Kn pour les volumes de données depuis Windows 8 et Server 2012, et démarrer depuis du 4Kn veut de l’UEFI.
- Tout ce qui est plus ancien — Windows 7 et avant — ne peut pas faire de 4Kn du tout. Pour ceux-là, un disque virtuel présentant du 512 est le prix pour les faire tourner, et l’hôte fera la réconciliation. Si cela compte, gardez ces invités sur un stockage où cela vous coûte le moins plutôt que sur votre palier le plus rapide.
Vérifiez ce avec quoi l’invité a réellement fini, depuis l’intérieur de l’invité :
lsblk -o NAME,LOG-SEC,PHY-SEC
512 là sur un hôte 4Kn veut dire que la réconciliation ci-dessus se produit à chaque écriture non alignée.
Références
- OpenZFS — Workload Tuning —
ashift, pourquoi2^ashiftest la plus petite IO possible sur un vdev, et l’observation que « many devices misreport their sector sizes » nvme-formatman page —--lbaf,--namespace-id,--seset--forcesg_formatman page —--sizeavec--format, l’option de format rapide, et l’avertissement format-corrupt- openSeaChest — les utilitaires de disque libres de Seagate, dont
--setSectorSizeet--showSupportedFormats - openSeaChest wiki — Format, Fast Format, And Sector Sizes — quel transport utilise quelle commande, et quand le format rapide s’applique
nvmecontrol(8)— l’équivalent FreeBSD- Linux block layer documentation — comment le noyau modélise les tailles de bloc logique et physique