La baie qui accepte tout
L’argumentaire de l’adaptateur tri-mode est franchement bon, et il mérite d’être posé correctement avant d’être démonté.
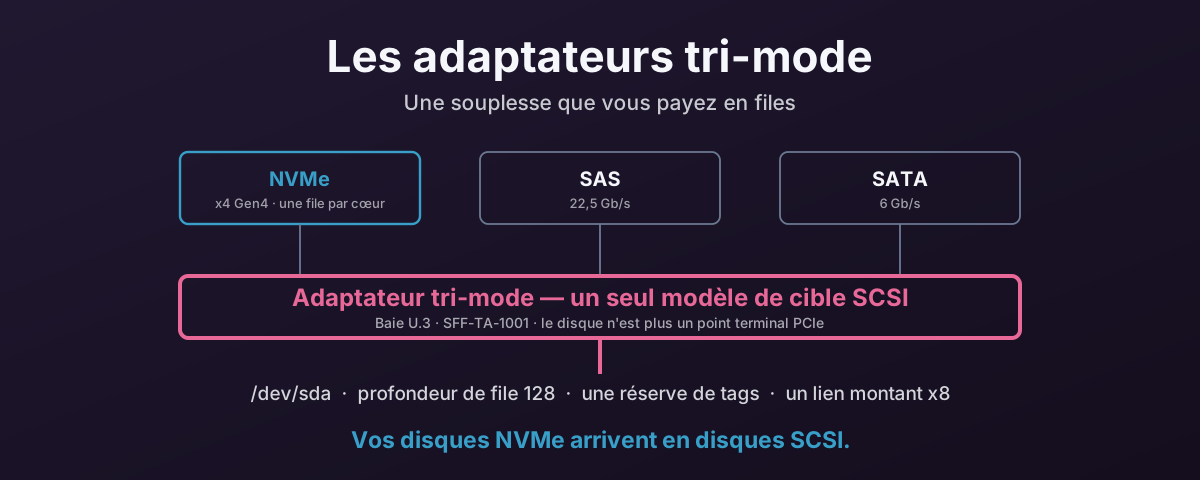
Achetez un châssis avec un fond de panier U.3 et un contrôleur tri-mode, et chaque baie de disque devient universelle. L’emplacement 0 peut accueillir un disque SAS 24G, l’emplacement 1 un SATA d’amorçage bon marché, l’emplacement 2 un SSD NVMe Gen4, et l’adaptateur négocie avec ce qui se présente. Broadcom appelle le silicium Tri-Mode SerDes ; le standard de baie est SFF-TA-1001, connu sous le nom d’U.3, qui définit un connecteur commun pour le SAS x1/x2, le SATA et le NVMe en x1, x2 ou x4. Côté gestion, c’est SFF-TA-1005, Universal Backplane Management, par lequel l’enceinte détermine à quoi elle parle réellement et pilote les bonnes LED d’activité.
Pour qui spécifie des serveurs, ça résout un problème réel et agaçant. Vous n’avez plus à décider du protocole de stockage au moment du bon de commande, ni à garder deux références de châssis, ni à découvrir que les baies capables de NVMe sont les quatre de gauche et que vos disques sont partis dans les vingt autres. Une seule référence couvre le parc, et un parc SAS peut passer au NVMe un disque à la fois plutôt qu’un châssis à la fois.
Rien de tout ça n’est du marketing. C’est la raison pour laquelle ces adaptateurs se vendent, et il serait bête de prétendre le contraire.
Mais la souplesse n’est pas gratuite, et la facture ne se paie pas en livres. Elle se paie en files.
Ce qui arrive vraiment au disque
Un SSD NVMe est un point terminal PCIe. Dans un serveur en attachement direct, ses quatre lignes vont au root complex du CPU — à travers un retimer ou un switch PCIe, mais électriquement et logiquement c’est un équipement sur le bus PCIe. Le noyau l’énumère, attache le pilote nvme, et à partir de là le pilote parle directement aux registres du disque.
Mettez le même disque derrière un adaptateur tri-mode et ce n’est plus vrai.
Les lignes du disque se terminent maintenant au contrôleur. La documentation de Broadcom appelle le bloc concerné le PCIe device bridge, et le mot pont travaille beaucoup : ce n’est pas un switch transparent qui transmet les transactions de votre CPU à un disque qu’il verrait encore. L’adaptateur est le point terminal PCIe que votre hôte énumère. Le disque est une cible accrochée de l’autre côté, et le firmware du contrôleur réémet chaque I/O.
L’adaptateur ne fait donc pas passer vos commandes NVMe. Il les termine, et parle au disque en votre nom.
Ce qui pose la question du protocole qu’il parle, lui, à vous.
Le système d’exploitation ne voit jamais de disque NVMe
Il parle SCSI.
Branchez un SSD NVMe sur un HBA tri-mode Broadcom et il n’apparaît pas en /dev/nvme0n1. Il apparaît en /dev/sdb, attaché à mpt3sas — le même pilote qui fait tourner les contrôleurs LSI SAS depuis plus d’une décennie. nvme list ne renvoie rien. lsblk -o NAME,TRAN rapporte le transport comme sas. Pour toutes les couches de la pile de stockage au-dessus du pilote, vous avez acheté un disque SAS.
Ce n’est pas un bug ni une limite de firmware en attente de correction. C’est le montage voulu. Présenter tout comme une cible SCSI est exactement la façon dont un adaptateur sert trois protocoles : le contrôleur normalise le SAS, le SATA et le NVMe en un seul modèle d’équipement, et l’hôte obtient un pilote, un chemin d’énumération, un jeu d’outils. La souplesse du marketing et la présentation SCSI dans dmesg sont la même décision d’architecture vue par les deux bouts.
Les générations 9500 et 9600 ajoutent bien un mécanisme de passthrough pour que l’outillage du fabricant atteigne les commandes d’administration NVMe d’un disque, et les pièces récentes de Broadcom exposent bien mieux la santé des disques que ne le faisait la 9400. Mais c’est un canal latéral de gestion. Le chemin de données — chaque lecture et chaque écriture que votre charge de travail émet — passe toujours par la pile SCSI.
Et la pile SCSI a un modèle de files qui précède la flash de vingt ans.
Le modèle de files que vous venez d’abandonner
C’est la partie qui vous coûte vraiment de la performance, et elle mérite de la précision, parce que « le NVMe est plus rapide que le SAS » n’en est pas la raison.
La décision centrale de conception du NVMe n’était pas un fil plus rapide. C’était d’arrêter de faire comme si un équipement de stockage était une chose unique et sérialisée.
La spécification autorise jusqu’à 65 535 paires de files d’I/O, et ce chiffre est cité dans toutes les vulgarisations NVMe qui existent. C’est le mauvais nombre à saisir. Aucun disque n’en implémente quoi que ce soit d’approchant, donc quiconque a réellement regardé un système en marche peut balayer la comparaison — et il aurait raison. Le vrai nombre est plus petit, sans gloire, et il fait mieux passer l’idée.
Voici donc un vrai disque. Pas une pièce d’entreprise : un SSD OEM SK Hynix de 256 Go, du genre soudé dans un portable de milieu de gamme, dans une machine à 16 cœurs.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Dix-sept files : une file d’administration, et seize files d’I/O pour seize cœurs. Chacune profonde de 1023 commandes. La correspondance est de un pour un — chaque file matérielle est liée à exactement un CPU :
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Un CPU par file, jusqu’en bas — la file matérielle 0 sert le cœur 1 et rien d’autre.
Voilà ce que « le NVMe a beaucoup de files » veut dire en pratique. Pas 65 535 — une par cœur, quel que soit le nombre de cœurs. Linux crée une paire de files par CPU jusqu’à ce que le contrôleur accorde, et les contrôleurs accordent bien plus que ce qu’un serveur type a de cœurs, donc en pratique le nombre de cœurs est le nombre. Mettez ce disque dans une machine à 64 cœurs et vous en obtenez 64.
Cette division par cœur, c’est de là que vient la performance :
- Un cœur soumet dans sa propre file. Pas de verrou, parce qu’aucun autre cœur n’y touche.
- Chaque file a son propre vecteur MSI-X, affiné sur ce cœur.
- L’interruption d’achèvement retombe sur le cœur qui a émis l’I/O, là où les lignes de cache concernées sont déjà.
- Les seize cœurs peuvent être en vol en même temps sans jamais se disputer une structure partagée.
Le parallélisme croît avec votre nombre de cœurs, et le travail d’aucun cœur ne fait jamais la queue derrière celui d’un autre. Un disque grand public bon marché fait ça. C’est le minimum vital.
Regardez maintenant ce que le disque obtient derrière l’adaptateur. Les nombres ci-dessous ne sont pas des estimations — ce sont des constantes du pilote mpt3sas de la branche principale.
La profondeur de file par équipement est posée depuis ioc->max_nvme_qd, que le pilote prend de ce que rapporte le firmware du contrôleur, et à défaut il se rabat sur une valeur par défaut fixée à la compilation dans drivers/scsi/mpt3sas/mpt3sas_base.h :
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Un équipement capable de dizaines de milliers de commandes en cours se voit attribuer une profondeur de file de 128 — et remarquez qu’elle est moins profonde que la valeur SAS par défaut de 254 posée deux lignes au-dessus. Les capacités propres du disque n’entrent jamais dans la décision. Le nombre vient du contrôleur.
Le nombre de files matérielles est pire, et le pilote est franc là-dessus. Depuis mpt3sas_scsih.c :
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Lisez ça attentivement, parce que trois choses distinctes se passent.
La valeur par défaut est une file matérielle. nr_hw_queues = 1. Le multi-file n’arrive que sur les contrôleurs gen35 avec la fonction host_tagset activée, et même là c’est ce que l’historique des commits du pilote décrit lui-même comme des files matérielles multiples simulées — le matériel du contrôleur d’I/O est une file de soumission unique avec plusieurs files de réponse, et blk-mq est plaqué par-dessus.
Le nombre de files vient du contrôleur, pas du nombre de cœurs. C’est reply_queue_count moins les files à IOPS élevées — l’allocation de vecteurs MSI-X de l’adaptateur. Ça n’a rien à voir avec le nombre de CPU que vous avez, et ça n’augmente pas quand vous ajoutez des disques. C’est l’inverse exact du disque ci-dessus, où le nombre de files était le nombre de cœurs.
Et la réserve de tags est partagée. host_tagset veut dire exactement ce qu’il dit : une réserve de tags pour l’adaptateur hôte entier, et cette ligne de journal dit « shared » tout haut. Chaque disque de la carte puise dans le même jeu d’emplacements de commande. Un châssis à vingt-quatre baies a vingt-quatre disques en concurrence sur les tags d’un seul contrôleur.
Mettez les deux côte à côte. Ce SSD de portable avait seize files privées de 1023, une par cœur, ne répondant qu’à lui-même. Le même disque derrière l’adaptateur reçoit une part des files de réponse de la carte, 128 commandes en cours, et vingt-trois voisins qui puisent dans la même réserve.
La perte n’est donc pas que le SCSI est lent. Le SCSI moderne sur blk-mq va très bien. La perte est structurelle :
- Les files appartiennent à l’adaptateur, pas au disque. Ajouter des disques divise une ressource fixe au lieu de l’augmenter.
- La réserve de tags est partagée à l’échelle de l’hôte. Un disque sous forte charge peut affamer les autres d’une façon qui ne peut tout simplement pas arriver quand chaque disque a ses propres files.
- La profondeur par équipement est plafonnée à 128, quoi que le disque puisse soutenir.
- La localité des interruptions est affaiblie. Les achèvements arrivent sur la file de réponse qu’a utilisée le contrôleur, pas forcément sur le cœur qui a soumis.
Pour une profondeur de file de 1 ou 2 — un processus mono-thread qui fait des lectures occasionnelles — rien de tout ça ne se voit. Vous mesurerez la même latence dans les deux cas, au bruit près. La pénalité apparaît exactement là où vous aviez acheté du NVMe pour aider : beaucoup de cœurs qui émettent beaucoup d’I/O concurrentes. Plus la charge est profonde, plus vous avez payé de disque que vous ne pouvez pas atteindre.
Le lien montant, c’est un seul emplacement x8
Le modèle de files est le problème subtil. Le plafond de bande passante est le problème évident, et vous pouvez le lire sur les fiches produit de Broadcom sans avoir besoin d’un banc d’essai.
Le HBA de la série 9500 est une carte x8 PCIe Gen 4.0. Les chiffres publiés par Broadcom pour elle sont 13 700 Mo/s en lecture séquentielle 256K et 3 M IOPS en lecture aléatoire 4K. La même fiche dit qu’elle prend en charge jusqu’à 32 équipements NVMe.
Mettez ces deux nombres l’un à côté de l’autre et la question se répond d’elle-même : combien faut-il de disques pour être à court d’adaptateur ?
Pas beaucoup, et moins chaque année. Un SSD Gen4 x4 fait environ 7 Go/s. Un SSD Gen5 x4 fait environ 14. Les deux sont des pièces ordinaires en 2026 — le Gen4 est ce dont le marché U.2 d’occasion est plein, et le Gen5 est ce que vous obtenez en achetant neuf.
| Plafond | Disques Gen4 pour l’atteindre | Disques Gen5 pour l’atteindre |
|---|---|---|
| HBA 9500 — 13 700 Mo/s séquentiel | 2 | 1 |
| HBA 9500 — 3 M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600 — 6,4 M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600 — 1,1 M IOPS RAID 5 (4K RW) | ~1 | ~1 |
Relisez la ligne du haut. Un seul SSD Gen5 atteint tout le plafond séquentiel d’un HBA 9500. Un disque, dans une carte prévue pour trente-deux. Tout ce qui vient après, c’est de la capacité. Pas de la performance.
Et la ligne du bas est celle qui devrait arrêter un bon de commande : sur le MegaRAID de la génération actuelle, un tiroir plein de NVMe en RAID 5 délivre à peu près ce qu’un disque grand public fait tout seul.
Les disques ne s’établissent même pas en x4
Il y a un second étranglement sous le lien montant partagé, facile à rater parce qu’il siège dans un tableau de spécifications plutôt que dans un titre.
Le guide utilisateur PERC 12 de Dell, qui couvre les contrôleurs tri-mode H965i, dit :
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Chaque disque NVMe obtient deux lignes, pas quatre. Donc avant toute concurrence sur le lien montant, avant la réserve de tags, avant la traduction SCSI, un disque Gen4 est déjà descendu à environ 3,5 Go/s — la moitié de ce qu’il sait faire. Mettez un disque Gen5 dans cette baie et il négocie vers du Gen4 x2 et délivre à peu près le quart de sa bande passante nominale.
Il faut être précis sur ce que ça change et ce que ça ne change pas. Ça ne veut pas dire que l’adaptateur va plus loin. Il faut environ quatre disques limités à x2 pour remplir le lien montant de la 9500 au lieu de deux, mais seulement parce que chaque disque apporte moitié moins. Le goulet a bougé du lien montant vers le lien du disque. Le total que vous pouvez extraire ne s’est pas amélioré.
En attachement direct, ces mêmes trente-deux disques auraient chacun leur propre chemin x4 vers le root complex, à la génération que le disque et le CPU savent négocier.
La ligne RAID 5 de ce tableau mérite qu’on s’y arrête, parce que c’est le chiffre de Broadcom lui-même et qu’il est publié sans enjolivure. Depuis la fiche de la série 9600 :
900K to 1.1M RAID 5 IOPS (4K RW)
Le RAID à parité dans le firmware du contrôleur est la chose la plus coûteuse que vous puissiez demander à une carte tri-mode, et voilà la génération actuelle en train de le faire. À lire avant que quelqu’un ne spécifie du RAID 5 sur vingt-quatre disques NVMe en attendant la performance de vingt-quatre disques.
Et une carte x16 ?
L’objection évidente à tout ce qui précède, c’est que la 9500 est une carte x8 Gen4 et que le plafond est un artefact d’un lien hôte étroit. Donnez à l’adaptateur seize lignes de Gen5 et le problème disparaît.
C’est une objection légitime, et elle mérite le meilleur exemple plutôt qu’un homme de paille. Prenons donc la PERC13 H975i de Dell — la génération actuelle, et à peu près ce que le tri-mode fait de mieux. Son guide utilisateur spécifie « Gen 4 and Gen 5 PCIe x16 host interfaces », et StorageReview a mesuré 52,5 Go/s et 12,5 M IOPS par contrôleur, face à seize disques NVMe au maximum.
Ce sont des chiffres sérieux, et ils changent le tableau nettement. Face aux 13 700 Mo/s et 3 M IOPS de la 9500, c’est environ quatre fois la bande passante et quatre fois les IOPS, réparties sur deux fois moins de disques. Dell n’a pas seulement élargi le tuyau — ils ont aussi divisé l’éventail par deux, et le taux de surréservation s’en est trouvé amélioré. Sur les IOPS en particulier, 12,5 M sur seize disques font environ 780K par disque, ce qui est proche de ce qu’un disque grand public délivre tout seul. À ce moment-là, le contrôleur n’est vraiment pas ce qui vous retient.
Rendons donc à César : une carte tri-mode x16 Gen5 moderne est une bien meilleure pièce d’ingénierie qu’une x8 Gen4, et si la bande passante était votre seule objection, le x16 y répond en grande partie.
Trois choses qu’elle ne corrige pas.
Les disques s’établissent toujours en x2. C’est celle qui m’a surpris. Le guide de la PERC13, qui décrit un contrôleur Gen5 x16, dit encore :
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Un lien hôte plus large n’élargit pas les liens des disques en aval. Chaque disque NVMe sur le contrôleur RAID tri-mode le plus récent et le plus rapide que Dell vende est encore raccordé par deux lignes au lieu de quatre, et abandonne encore la moitié de sa bande passante avant que quoi que ce soit d’autre n’arrive.
Le modèle de files n’est absolument pas touché. Rien dans la section files de ce billet n’est fonction de la largeur du lien hôte. nr_hw_queues vient de l’allocation de files de réponse MSI-X du contrôleur ; la profondeur de 128 par équipement est une constante du pilote et du firmware ; la réserve de tags est partagée à l’échelle de l’hôte parce que host_tagset le dit. Élargissez le lien hôte en x16, x32, ce que vous voudrez — les disques restent des cibles SCSI qui partagent les files de la carte, il n’y a toujours pas de /dev/nvme0n1, et vous ne pouvez toujours pas passer un disque à une VM.
Et le x16 ne fabrique pas de bande passante — il éventaille des lignes que vous aviez déjà. C’est l’argument qui tranche vraiment. Seize lignes Gen5 dans une PERC13 vous achètent 52,5 Go/s partagés sur seize baies. Ces mêmes seize lignes câblées directement à quatre disques Gen5 en x4 vous achètent environ 56 Go/s sur quatre baies — la même bande passante depuis les mêmes lignes, sauf que chaque disque obtient ses quatre lignes entières, sa propre paire de files par cœur, et un vrai nœud d’équipement nvme.
La façon honnête de décrire une carte tri-mode x16 n’est donc pas « un adaptateur plus rapide ». C’est un multiplexeur de lignes : il convertit un budget de lignes fixe en davantage de baies de disques, et vous facture le modèle de files pour la conversion. Que le marché soit bon ou non dépend d’une seule chose. Des baies ou du parallélisme.
Ce qui se passe quand vous remplissez toutes les baies
Ce qui nous amène au cas qui compte vraiment, parce que personne n’achète un châssis 24 baies pour y mettre quatre disques.
Passé le point de saturation, la ligne agrégée est plate. Ajouter des disques ajoute de la capacité, et rien d’autre — donc la performance par disque tombe en 1/N. Cette arithmétique est impitoyable à des remplissages réalistes :
| Disques sur un HBA 9500 | Agrégé | Par disque | Fraction d’un disque Gen4 |
|---|---|---|---|
| 2 | 13,7 Go/s | 6,9 Go/s | 98 % |
| 12 | 13,7 Go/s | 1,14 Go/s | 16 % |
| 24 | 13,7 Go/s | 0,57 Go/s | 8 % |
Regardez la ligne du bas. Vingt-quatre disques NVMe derrière un HBA 9500 délivrent environ 570 Mo/s chacun. Un SSD SATA en fait à peu près 550. Vous avez acheté vingt-quatre disques NVMe, payé un contrôleur tri-mode pour les raccorder, et vous êtes arrivé à une bande passante par disque de classe SATA.
L’arithmétique des IOPS a la même forme : 3 M répartis sur vingt-quatre disques font 125K chacun, contre le 1 M qu’un disque Gen4 grand public tient à lui seul — environ un huitième de ce que vous possédez.
La carte x16 améliore ça considérablement mais n’y échappe pas. Une PERC13 avec ses seize disques au complet, c’est 52,5 Go/s ÷ 16 = 3,3 Go/s par disque, soit environ 23 % d’un disque Gen5 — et ça avant que le lien x2 ne le divise encore par deux.
Deux effets aux forts nombres de disques sont pires que ce que la division laisse croire :
- La famine de tags traverse les équipements. La réserve de tags partagée à l’échelle de l’hôte fait qu’un seul disque sous forte charge peut consommer des emplacements dont d’autres disques ont besoin. Vingt-quatre équipements autorisés chacun nominalement à 128 commandes en cours en veulent 3 072 à eux tous, tirés du
can_queued’un seul contrôleur. Le blocage de tête de file entre disques distincts est un mode de défaillance qui n’existe tout simplement pas quand chaque disque possède ses files. - Les reconstructions frappent tout. Une reconstruction de parité sur un tiroir peuplé sature l’unique lien montant partagé, donc l’I/O de premier plan vers tous les autres disques de la carte se dégrade en même temps. Avec des disques sur des lignes indépendantes et du RAID logiciel, la reconstruction se dispute du CPU, pas un tuyau unique.
Quand rien de tout ça ne compte
Il y a un contrepoids important, et c’est la raison pour laquelle beaucoup de serveurs tri-mode 24 baies tournent parfaitement bien.
Le plafond de l’adaptateur ne mord que si quelque chose en aval peut consommer plus qu’il ne délivre. Un serveur avec 2 × 25GbE a 6,2 Go/s de réseau — il ne peut même pas remplir un HBA 9500. Si ces vingt-quatre disques sont un étage de capacité qui sert des fichiers sur ce lien, l’adaptateur n’est nulle part près du goulet et l’arithmétique par disque ci-dessus n’a aucun intérêt.
Le moment où ça commence à compter, c’est quand le consommateur devient plus rapide que la carte : le 100GbE (12,5 Go/s) vous met à lui seul au niveau de tout le plafond séquentiel d’une 9500, et les charges locales — bases de données, compilation, analytique, hôtes de virtualisation avec des invités chargés — n’ont aucun réseau dans le chemin.
La question à poser sur un tiroir peuplé n’est donc pas « est-ce que l’adaptateur est lent » mais « qu’est-ce qui va consommer ça, et est-ce que ça peut consommer plus que la carte ne délivre ? » Si la réponse est un lien 25GbE, arrêtez de vous inquiéter. Si la réponse est du 100GbE, du NVMe-oF ou une base de données locale, la carte est votre goulet et le nombre de disques l’aggrave.
Ce qui disparaît aussi
Au-delà du débit, présenter un disque NVMe comme un disque SCSI veut dire que les parties spécifiquement NVMe de votre outillage cessent de marcher :
| Attachement direct | Derrière un adaptateur tri-mode | |
|---|---|---|
| Nœud d’équipement | /dev/nvme0n1 | /dev/sdb |
| Pilote | nvme | mpt3sas / mpi3mr |
nvme-cli | Marche | Rien à qui parler |
| Données de santé | Pages de journal SMART NVMe | Pages de journal SCSI traduites |
| Gestion des namespaces | Oui | Non |
| Mises à jour de firmware | nvme fw-download | Outil fabricant via le contrôleur |
| Format / sanitize | NVMe Format NVM | Équivalents SCSI, si implémentés |
| Files matérielles | Une paire par cœur (16 sur la machine ci-dessus) | Les files de réponse de la carte, partagées par tous les disques |
| Profondeur de file | 1023 par file | 128 par équipement |
Une conséquence prend les gens de court assez souvent pour la signaler à part : vous ne pouvez pas passer un disque individuel à une machine virtuelle. Le passthrough PCIe exige que le disque soit un point terminal PCIe avec son propre groupe IOMMU, et derrière un adaptateur tri-mode il n’en est pas un — le seul équipement PCIe présent est le contrôleur. Vous pouvez passer l’adaptateur entier, avec tous les disques qui y sont accrochés, ou rien. Si votre plan consistait à confier des disques NVMe précis à des invités précis, la décision du fond de panier a déjà tranché pour vous.
Alors qui veut vraiment de ça en 2026 ?
C’est ici que l’argumentaire du début de ce billet doit affronter une question plus dure, parce que le monde pour lequel il a été conçu a largement disparu.
Le tri-mode a été conçu quand le NVMe était l’étage cher qu’on ajoutait à un parc SAS. En 2026 c’est l’inverse : le NVMe est le défaut, les disques U.2 d’entreprise sont abondants et bon marché sur le marché de l’occasion, et « du SAS, du SATA et du NVMe mélangés dans un châssis » décrit de moins en moins de déploiements réels. Alors qui l’achète vraiment ?
Presque personne — délibérément. La réponse honnête, c’est que la plupart des contrôleurs tri-mode n’ont pas été choisis. Ils sont arrivés, parce que le constructeur du serveur en livre un, et il en livre un parce qu’une référence unique de fond de panier U.3 lui permet à lui de vendre des configurations SAS, SATA et NVMe depuis le même châssis. C’est un gain de chaîne d’approvisionnement pour le constructeur. Ça ne fait rien pour votre performance, et à ce titre ça n’a jamais été vendu comme tel.
Trois des justifications classiques ne tiennent plus très bien :
« J’ai besoin de types de disques mélangés. » Rarement dans le même châssis, et même quand c’est le cas, le tri-mode n’est pas la seule voie. Un simple HBA SAS pour les disques mécaniques plus du NVMe câblé au root complex vous donne les deux, sans pénaliser ni l’un ni l’autre. Un parc mélangé n’implique pas un contrôleur mélangé.
« Je n’ai pas assez de lignes PCIe. » C’était le vrai argument en 2019, sur des plateformes à 40 lignes avec 24 baies. Un Epyc Genoa ou Turin mono-socket a 128 lignes. Vingt-quatre disques en x4, ça fait 96. La pénurie qui justifiait d’agréger des disques derrière un contrôleur a quasiment disparu, et là où elle subsiste, un switch PCIe fait le travail sans terminer le protocole.
« Les baies doivent être universelles. » Celle-là mérite d’être démêlée soigneusement, parce que c’est l’argument le plus souvent utilisé pour justifier le mauvais composant. L’U.3 est un standard de fond de panier, pas une exigence de contrôleur. Un fond de panier U.3 peut être câblé droit aux lignes PCIe du CPU au lieu de passer par un contrôleur tri-mode, et les constructeurs documentent les deux topologies. Vous pouvez garder les baies universelles et supprimer la taxe. Si vous avez hérité d’un serveur tri-mode, la chose la plus utile que vous puissiez vérifier est de savoir si le fond de panier peut être recâblé en direct.
Ce qui reste vraiment :
- Le RAID matériel à forte densité, quand la politique ou la plateforme l’exige — une exigence d’audit, une matrice de support, un déploiement Windows ou ESXi sans couche logicielle pour faire le travail. C’est le vrai marché restant, c’est le seul cas où vous achetez le moteur RAID plutôt que la connectique, et sur le silicium actuel c’est un produit capable : seize disques NVMe en RAID 5 matériel avec un cache protégé par supercondensateur, à partir de seize lignes, c’est quelque chose que l’attachement direct ne sait pas offrir du tout.
- De la capacité SAS en vrac, là où le £/To appartient encore nettement aux disques mécaniques. Mais c’est le travail d’un simple HBA SAS, et moins cher.
- De très grands nombres de baies et des enceintes externes, là où les expandeurs SAS vont plus loin et plus large que le PCIe.
- Des charges qui ne vont jamais en profondeur. Si vos profondeurs de file tiennent sur un chiffre, rien de tout ça ne se voit. Beaucoup de systèmes réels vivent là très heureux.
Il y a aussi un argument purement opérationnel — un type d’enceinte, un pilote, une pièce de rechange sur l’étagère — et pour un hôte de virtualisation généraliste ça vaut quelque chose de réel. Chiffrez-le juste honnêtement face au fait que, d’après le tableau ci-dessus, un seul disque Gen5 peut atteindre tout le plafond séquentiel de la carte.
Quand c’est le mauvais outil
Le marché tourne mal en proportion de la concurrence que votre charge de travail comporte.
Ceph est le cas le plus clair. Un nœud de stockage fait tourner un OSD par disque, chacun avec ses propres pools de threads, tous à émettre des I/O en même temps — et puis tout un cluster de clients les sollicite en parallèle. C’est le pire cas de la réserve de tags partagée : vingt-quatre démons en concurrence sur les emplacements de commande d’un seul contrôleur, chaque disque plafonné à 128 en cours, tout canalisé par un seul lien montant x8. Mettez ces disques droit sur le root complex et chaque OSD obtient ses propres files, ses propres tags et ses propres lignes. Un nœud Ceph tout-NVMe ne devrait pas avoir d’adaptateur tri-mode dans le chemin de données.
La même logique s’applique aux cibles NVMe-oF, où vous réexportez des disques et où chaque couche de sérialisation s’ajoute ; aux bases de données à I/O asynchrone profonde ; et à tout ce qui repose sur io_uring ou SPDK, qui existent précisément pour exploiter les files par cœur que l’adaptateur vient de retirer.
La règle générale : plus votre logiciel a été écrit pour exploiter du parallélisme, plus l’adaptateur tri-mode vous le facture.
Comment savoir ce que vous avez
Si vous avez hérité d’un serveur et voulez savoir de quel côté vous êtes :
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
La dernière affiche la ligne Max SCSIIO MPT commands: N shared with nr_hw_queues = M citée plus haut. Si nvme list est vide sur une machine dont on vous a dit qu’elle est tout-flash NVMe, l’adaptateur en est la cause.
La version courte
Un adaptateur tri-mode convertit vos disques NVMe en disques SCSI. Cette conversion n’est pas un effet de bord. C’est ainsi qu’une carte sert trois protocoles, et c’est ce que vous achetez.
Ce que vous abandonnez est précis et mesurable : des paires de files par cœur remplacées par les files de réponse partagées d’un contrôleur, une profondeur de 128 par équipement, une réserve de tags divisée entre tous les disques de la carte, un lien x2 là où le disque voulait du x4, et un lien montant partagé là où chaque disque avait auparavant son propre chemin vers le root complex. L’adaptateur cesse d’être une connexion et devient le goulet, et sur le matériel actuel il le devient vite : deux disques Gen4 atteignent un HBA 9500, quatre disques Gen5 atteignent même une PERC13.
Un lien hôte plus large aide bien — une carte x16 Gen5 a environ quatre fois la bande passante et les IOPS d’une x8 Gen4 — mais ça ne change pas la forme. Ça achète des baies, pas du parallélisme : ces mêmes seize lignes câblées droit à quatre disques délivrent la même bande passante sans aucune taxe de files. Et ça ne sauve pas un tiroir plein. Vingt-quatre disques derrière une 9500 obtiennent environ 570 Mo/s chacun, ce que fait un SSD SATA.
En 2019, quand le NVMe était l’étage qu’on ajoutait à un parc SAS et que les plateformes manquaient de lignes, c’était un marché raisonnable. En 2026 il ne l’est généralement plus. Le NVMe est le défaut, les disques U.2 d’occasion sont bon marché, un Epyc mono-socket a des lignes à revendre, et le seul avantage qui tient encore — des baies de disques universelles — appartient au fond de panier U.3, pas au contrôleur. Vous pouvez très souvent garder les baies et supprimer la taxe en câblant le fond de panier droit au CPU.
Alors achetez un adaptateur tri-mode si vous achetez son moteur RAID et qu’il vous en faut un. Ne l’achetez pas pour la souplesse, et si vous en avez hérité d’un dans un châssis plein de NVMe, allez donc voir comment ce fond de panier est câblé.
Ça n’a aucun sens de payer deux fois pour des disques que vous ne pouvez ensuite pas utiliser correctement.