50 TOPS à se tourner les pouces
Chaque portable Ryzen AI vendu ces deux dernières années contient un Neural Processing Unit (NPU), un bloc de silicium conçu uniquement pour les calculs qui font tourner les modèles d’IA. Sur le mien, un ThinkPad avec un Ryzen AI 7 PRO 350, AMD l’annonce à jusqu’à 50 TOPS, des milliers de milliards d’opérations par seconde1. Vous l’avez payé. Sur une installation Linux standard, il ne fait rien.
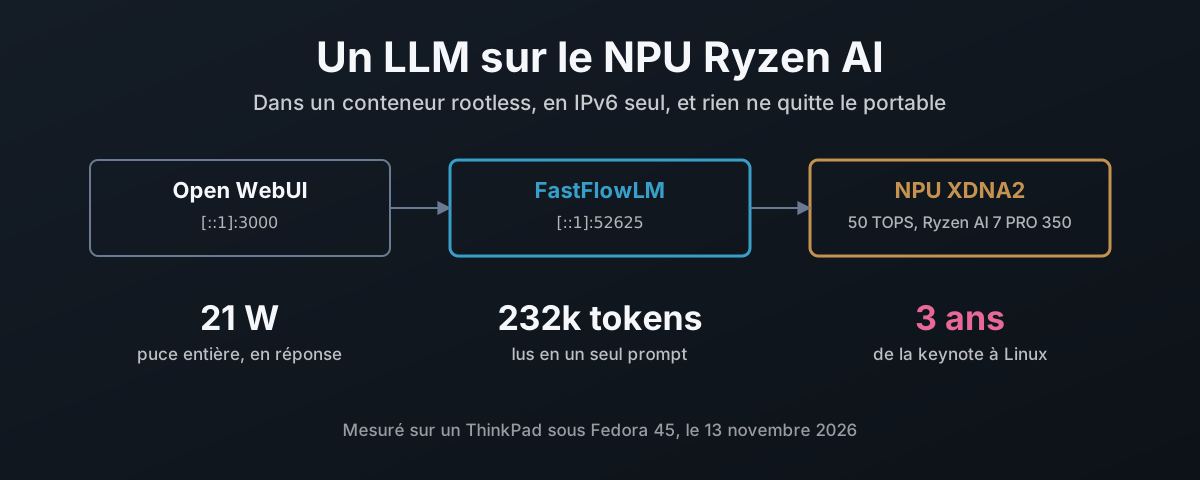
Ça a changé cette année. Une fois configuré, le NPU fait tourner un modèle de langage de 4 milliards de paramètres derrière une fenêtre de chat, plus la transcription vocale, le tout sur le portable, sans compte, sans abonnement et sans que rien ne quitte la machine, ce qui, pour tout ce que vous préféreriez ne pas taper sur le site de quelqu’un d’autre, est tout l’intérêt. La puce entière consomme environ 21 W pendant qu’elle répond, et moins de 9 W au repos.
| Ce qui tourne | Où | Adresse |
|---|---|---|
| Qwen 3.5 4B, contexte de 256k tokens | NPU, dans un conteneur | http://[::1]:52625/v1 |
Transcription vocale : Whisper d’OpenAI, whisper-v3:turbo | NPU, même conteneur | la même, /audio/transcriptions |
| Open WebUI, la page de chat | CPU, dans un conteneur | http://[::1]:3000 |
| pilote noyau amdxdna, firmware | hôte | /dev/accel/accel0 |
Deux règles ont façonné le montage. Seuls le pilote noyau et son firmware vont sur l’hôte ; chaque framework de modèle tourne dans un conteneur podman rootless. Et chaque service n’écoute que sur le loopback IPv6, sans rien du tout en IPv4. Les deux se sont révélées moins de travail que de faire les choses à la va-vite, et les deux ont attrapé des problèmes que j’aurais sinon livrés tels quels.
Ce qu’il faut sous Linux
Le NPU de cette puce est la deuxième génération d’AMD, XDNA2. Ça compte, parce que le logiciel qui y fait tourner des modèles de langage prend en charge les puces XDNA2 (séries Ryzen AI 300 et 400, Strix Halo) et pas la première génération des Ryzen 7040 et 80402. Vérifiez la vôtre avant de commencer :
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Quatre couches séparent ce périphérique d’une réponse dans le chat, et la répartition entre l’hôte et le conteneur est toute la conception :
| Couche | Ce que c’est | Vit sur |
|---|---|---|
amdxdna | pilote noyau, crée /dev/accel/accel03 | hôte, via DKMS |
| firmware du NPU | npu_7.sbin, 1.1.2.64 sur cette puce | hôte, depuis linux-firmware |
XRT + plugin amdxdna | la bibliothèque runtime d’AMD et son backend NPU | conteneur |
| FastFlowLM | le runtime LLM, kernels NPU compris | conteneur |
Le noyau 7.x livre amdxdna dans l’arbre, mais AMD le développe d’abord dans son propre dépôt, et le
plugin en espace utilisateur doit correspondre au module noyau auquel il parle4. L’écart entre les deux
n’est pas petit. Sur ce portable :
| Dans l’arbre, 7.2.15 et 7.3.3 de Fedora | Hors arbre, amd/xdna-driver à 24dfd686 | |
|---|---|---|
| Interface du pilote | 0.105 | 0.19 |
| Version du module | aucune | 2.27.0_20261113 |
| ID PCI de NPU qu’il prend en charge | 6 | 8 |
| Fichiers firmware qu’il demande | 7 | 59 |
| Firmware que charge cette puce | 17f0_10/npu_7.sbin, 1.1.2.64 | le même fichier |
Neuf versions d’interface d’écart, et Linux 7.3, la version la plus récente, en est toujours à 0.10. La seule
chose sur laquelle ils s’accordent est le firmware, et celui-ci vient du linux-firmware de Fedora, pas de l’un ou
l’autre pilote. Je compile donc les deux moitiés à partir d’un seul commit de amd/xdna-driver, je mets le module sur l’hôte,
et j’intègre l’espace utilisateur correspondant dans l’image.
Le pilote : tout compiler, ne garder que la partie noyau
amd/xdna-driver embarque XRT comme sous-module git, et sa compilation produit des RPM pour XRT et un
paquet de plugin. Le paquet de plugin contient aussi les sources du pilote, qu’il enregistre auprès de
DKMS (Dynamic Kernel Module Support, ce qui recompile un module pour chaque nouveau noyau).
Rien de tout ça n’est difficile :
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
Sous Fedora 45, le script de dépendances se termine sur une erreur. Ignorez-la :
| Il demande | Ce qui se passe | Ça compte ? |
|---|---|---|
protobuf-devel | conflit avec un protobuf3-compiler installé | non, XRT saute juste un outil de traçage sans lui |
redhat-lsb | ce paquet n’existe pas, Fedora l’a abandonné | non |
| tout le reste | déjà installé |
La dernière version étiquetée là-bas date de février, donc main sert de canal de publication. Je suis passé
d’une compilation de mai à celle de novembre : 550 commits, XRT de 2.23 à 2.27.
La mise à jour supprime le pilote qu’elle vient d’installer
Ma première tentative de mise à jour a carrément fait disparaître le module. RPM exécute le script d’installation
du nouveau paquet, qui compile et enregistre le nouveau pilote auprès de DKMS, puis exécute le script de
désinstallation de l’ancien paquet. Ce script de désinstallation lit la version du pilote dans un fichier que le nouveau paquet a
déjà écrasé, et il désenregistre donc la version qui vient d’être installée. La sortie de dnf
le dit en deux lignes, l’une après l’autre :
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Rien n’a échoué, rien n’est passé au rouge, et le démarrage suivant aurait tranquillement chargé ce que le noyau
livrait à la place. Puis-je demander pourquoi un script de désinstallation tourne lors d’une mise à jour sans vérifier s’il s’agit
d’une mise à jour ? RPM donne cette réponse à chaque scriptlet en premier argument. C’est un seul if.
C’est aussi la raison pour laquelle l’hôte ne reçoit plus du tout les RPM. Les sources du pilote sont une archive tar dans le paquet de plugin, donc je les en sors et je les donne directement à DKMS :
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Pas de redémarrage. C’est Linux, et rien n’a le périphérique ouvert à ce stade, donc le module s’échange
à chaud. DKMS le
recompile ensuite pour chaque noyau que dnf installe ; quand la 7.3.3 est arrivée, il était compilé avant même que
j’aie redémarré dessus.
Vérifiez que c’est bien la compilation DKMS qui est chargée et pas celle de l’arbre, et que le firmware est assez récent. FastFlowLM veut la 1.1.0.0 ou plus2 :
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS met le module propre au noyau de côté au lieu de le supprimer, dans
/var/lib/dkms/xrt-amdxdna/original_module/, donc retirer la compilation DKMS le remet en place.
Encore une chose à laisser tranquille : amd_iommu=off sur la ligne de commande du noyau désactive le NPU2.
FastFlowLM dans un conteneur
FastFlowLM est le runtime qui rend le NPU utile pour les modèles de langage. C’est une ligne de commande façon Ollama et un serveur compatible OpenAI, écrits pour XDNA2, et il est passé sous l’organisation ROCm d’AMD cette année6. Le runtime est sous licence MIT. Les kernels NPU qu’il livre sont des binaires fermés, libres d’utilisation et de redistribution sans modification7. Je préférerais qu’ils soient ouverts, et je le dis, mais ils sont dans le dépôt et rien ne doit être récupéré ailleurs.
L’image compte trois étapes sur Fedora 45 : XRT issu de la compilation du pilote, FastFlowLM compilé contre lui, puis un runtime avec seulement ce dont il a besoin. La partie qui compte :
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Chacune de ces options est là parce que quelque chose cassait sans elle :
| Problème | Correctif |
|---|---|
| Les scripts du plugin compilent un module noyau, qui a sa place sur l’hôte | --noscripts, et les sources du pilote et le firmware exclus |
| RPM 6, dans Fedora 45, impose par défaut la vérification des signatures8, et un RPM compilé soi-même n’est pas signé | --nosignature : je l’ai compilé, je sais d’où il vient |
Les bibliothèques de XRT sont dans lib64, qui n’est pas dans le chemin de l’éditeur de liens | /etc/ld.so.conf.d/xrt.conf dans l’image |
FastFlowLM trouve XRT via pkg-config, et le setup.sh de XRT ne règle pas le chemin | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig dans l’étape de compilation |
L’image finale pèse 609 MB, et son tag porte le commit du pilote,
fastflowlm:v1.0.12-xdna24dfd686. Un health check le compare au commit que déclare le module
chargé et échoue s’ils diffèrent. Une image compilée pour le mauvais pilote est la seule panne
ici vraiment déroutante à diagnostiquer, donc elle est attrapée avant d’en arriver là.
Le conteneur reçoit un seul périphérique, le NPU, et la limite de mémoire verrouillée dont FastFlowLM a besoin pour épingler ses tampons :
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
L’autotest d’AMD, xrt-smi validate, a mesuré le NPU à 51 TOPS sur une multiplication de matrices. Ce sont les
50 de la boîte, tenus.
Démarrage au boot, en IPv6 seulement
Quadlet transforme un court fichier .container en service systemd9. En unité utilisateur, il tourne
en rootless, sous mon compte, et avec le lingering activé il démarre au boot sans que personne soit connecté10 :
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 règle la fenêtre de contexte, et le test de contexte plus bas explique
pourquoi elle est si grande. -a whisper-v3:turbo charge un second modèle à côté du modèle de chat, un modèle qui
transforme la parole en texte ; il a sa propre section.
Trois lignes là-dedans ont été apprises à la dure :
| Ligne | Sans elle |
|---|---|
StopSignal=SIGINT | FastFlowLM ignore SIGTERM, le signal d’arrêt de podman, et se fait tuer dix secondes plus tard |
--host ::1 | il écoute sur 127.0.0.1, en IPv4 |
::1, pas [::1] | la forme entre crochets n’est pas analysée ; les crochets vont dans une URL |
Prouvez l’adresse plutôt que de lui faire confiance :
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost marche toujours pour tout ce qui le résout d’abord en ::1, ce que font le /etc/hosts de Fedora
et Chrome.
Ce que ça donne, mesuré
Neuf modèles passés au benchmark propre à FastFlowLM, le décodage étant la vitesse à laquelle la réponse défile :
| Modèle | Décodage, contexte 1k | Décodage, contexte 8k | Lecture du prompt, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2 009 tok/s |
qwen3.5:2b | 32 | 29 | 1 533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
La vitesse de lecture est de cinq à huit tokens par seconde, donc chacun de ces modèles garde de l’avance sur vous. Le décodage
est à peu près divisé par deux chaque fois que le modèle double, ce qui est attendu quand la limite est la bande passante mémoire
et non le calcul. J’utilise qwen3.5:4b. Phi-4 mini est plus rapide, mais Qwen 3.5 tient sa vitesse à mesure que la conversation s’allonge,
gère les images et les appels d’outils, et garde un cache de prompt qui évite de relire tout l’historique à
chaque tour. Ça tranche.
256 000 tokens de contexte
Qwen 3.5 est conçu pour une fenêtre de 262 144 tokens11, et FastFlowLM prend 32 768 par défaut. Au-delà de cette
limite, il fait quelque chose qu’il vaut mieux savoir : il journalise Max length reached, stopping prefilling
et ferme la connexion sans réponse et sans erreur, si bien que la fenêtre de chat reste là avec une réponse
vide et qu’on vous laisse deviner qui est tombé, du modèle, du serveur ou du navigateur.
Je l’ai donc relevée avec -c 262144 et je l’ai testée correctement. Un code caché dans la première ligne d’un
prompt de 232 250 tokens, environ 175 000 mots, demandé à la fin :
| Contexte 8k | Contexte 232k | |
|---|---|---|
| Réponse | correcte | correcte, AMBER-FALCON-7731 |
| Lecture du prompt | 657 tok/s | 210 tok/s |
| Attente du premier mot | 12 secondes | 18,4 minutes |
| Décodage | 15 tok/s | 2,4 tok/s |
| Mémoire réservée | ~5 GB | ~12,7 GB |
Ça marche. C’est lent. Et la mémoire est réservée que vous utilisiez la fenêtre ou non. Avec 90 GB dans la machine, je paie volontiers ce prix pour qu’un long copier-coller reçoive une réponse au lieu d’être ignoré en silence.
Le GPU peut-il aider ?
La même puce a une Radeon 860M, donc la question évidente est de savoir si elle peut prendre une partie de la charge. Répartir un seul modèle entre le NPU et le GPU, lire le prompt sur l’un et écrire la réponse sur l’autre, aucun runtime Linux ne le fait aujourd’hui. Faire tourner un second runtime sur le GPU, si, alors j’ai mesuré ça.
« Efficace » veut dire ici vitesse et énergie ensemble. Le pilote amdgpu rapporte la puissance du package pour
la puce entière sans root, et le pilote amdxdna rapporte le NPU seul, donc chaque essai
ci-dessous a été échantillonné quatre fois par seconde. Même modèle en 4 bits partout.
Des runtimes GPU que j’ai regardés, un seul a marché :
| Runtime | Résultat sur la 860M |
|---|---|
| llama.cpp, backend Vulkan12 | fonctionne ; image de 881 MB |
| llama.cpp, backend ROCm | voit le GPU, puis fait une segfault au premier travail, avec ou sans forçage de version du GPU ; image de 23 GB |
| MLC-LLM, Vulkan13 | son compilateur fait une segfault en compilant l’architecture Qwen 3.5 |
| vLLM, SGLang | pas essayés : faits pour des GPU de data centre et de nombreux utilisateurs, pas pour un iGPU à 8 unités |
Et le NPU face à celui qui a marché :
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Au repos, modèle chargé | 8,6 W | 16,0 W, contre 9,7 W quand il est arrêté |
| Lecture du prompt, ~6k tokens | 557 tok/s à 23,8 W | 411 tok/s à 46,1 W |
| Énergie par token de prompt | 0,043 J | 0,112 J |
| Décodage | 18,2 tok/s à 21,0 W | 23,5 tok/s à 40,7 W |
| Énergie par token généré | 1,16 J | 1,73 J |
Le GPU écrit les réponses environ 29 % plus vite. Il brûle deux fois la puissance pour ça. Le NPU lit les prompts plus vite et avec moins de la moitié de l’énergie. Le chiffre le plus important est celui du repos : le serveur GPU chargé et ne faisant rien coûte 6,3 W de plus que la même machine avec le serveur arrêté, toute la journée. Faire tourner les deux en même temps a fait passer le NPU de 18,2 à 14,2 tokens par seconde et le GPU de 23,5 à 13,9, parce qu’ils partagent la même mémoire. De ce fait, le conteneur GPU existe, mais je le lance quand je veux un second modèle, et il n’est pas activé au démarrage.
Le NPU lui-même a consommé moins de 2 W à chaque essai. L’essentiel des 21 W, c’est le CPU et la mémoire qui l’alimentent. C’est le plafond à surveiller dans les futures versions de FastFlowLM.
La transcription vocale sur le NPU aussi
Whisper est le modèle de reconnaissance vocale d’OpenAI : de l’audio en entrée, du texte en sortie, dans 99 langues, et publié sous licence MIT, donc il tourne n’importe où sans rien demander à personne14. Large-v3 est la version pleine taille actuelle. Turbo est le même modèle avec son décodeur, la moitié qui écrit le texte, ramené de 32 couches à 4. La fiche du modèle présente le compromis sans détour : « way faster, at the expense of a minor quality degradation ». Avec 809 millions de paramètres, il fait un cinquième de la taille du modèle de chat.
FastFlowLM le livre déjà converti pour le NPU sous le nom whisper-v3:turbo, un téléchargement de 623 MB, et
le charge à côté du modèle de chat avec -a whisper-v3:turbo. Il ne sert pas Whisper seul ;
il faut aussi un modèle de chat chargé. L’audio part vers l’endpoint de transcription standard d’OpenAI
et le texte revient.
| 19,6 secondes de parole | |
|---|---|
| Première requête, chargement de Whisper | 6,2 s |
| Ensuite | 2,0 s, environ dix fois le temps réel |
| Puissance de la puce entière | ~24,7 W |
| Exactitude | tous les mots justes |
Écrits avec la fausse orthographe anglaise américaine, attention : « color » et « program ». L’API de Whisper accepte un prompt, et un
prompt rédigé dans la véritable orthographe britannique, l’anglais d’Angleterre, d’où vient la langue,
suffit à corriger ça :
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
On ne devrait pas avoir à corriger ces modèles du tout. Whisper a été entraîné sur 99 langues et écrit pourtant l’anglais à l’américaine à moins qu’on lui dise le contraire, parce que ceux qui l’ont construit traitent leur orthographe comme la norme et celle de tous les autres comme une option qu’il faut demander. C’est ce pénible réflexe américain de se croire la norme, que le reste du monde déteste, et il est intégré comme un biais. Le prompt système du modèle de chat porte la même consigne, dans la section ci-dessous, pour la même raison.
Une fenêtre de chat, et 7 000 tokens que vous n’avez jamais tapés
Open WebUI est l’interface web15, dans son propre conteneur, liée à [::1]:3000 de la même
façon et pointée vers le NPU. Son bouton micro envoie vers Whisper sur le NPU au lieu de son
choix par défaut, qui aurait téléchargé un modèle et l’aurait fait tourner sur le CPU.
Le premier message que je lui ai envoyé faisait vingt mots. Il est arrivé au NPU sous la forme d’un prompt de 7 223 tokens, parce qu’Open WebUI 0.13 joint les définitions de tous ses outils intégrés (mémoire, notes, agenda, automatisations, recherche web) à chaque message, et qu’un admin les reçoit tous.
| Même question de vingt mots | Prompt envoyé au NPU | Attente du premier mot |
|---|---|---|
| Outils intégrés activés, par défaut | 7 223 tokens | ~12 s |
| Outils intégrés désactivés pour le modèle | 127 tokens | moins de 1 s |
Pour un modèle local, ce réglage par défaut devrait être désactivé. Douze secondes, à chaque réponse.
Il m’a aussi affirmé avec aplomb qu’il était « trained by Google » et tournait « on Google’s advanced infrastructure ». C’est un modèle Qwen, fait par Alibaba, qui tourne sur un portable. C’est un non-sens complet, et ça ne devrait pas arriver.
Ce n’est pas la configuration. Un modèle ne voit que le texte qu’on lui envoie, et le nom dans la liste déroulante est une étiquette pour le serveur, jamais transmise au modèle. Cette réponse vient donc du modèle seul, et il s’est trompé sur le seul fait le concernant qui ne devrait jamais faire de doute. C’est un défaut de conception, et il revient à celui qui a livré le modèle.
Alibaba savait comment l’empêcher. Le modèle de chat de Qwen 2.5 ouvrait chaque conversation par « You are Qwen, created by Alibaba Cloud » sauf si vous lui donniez autre chose16. Qwen 3 a supprimé cette ligne17, et Qwen 3.5 est livré sans elle aussi18. Rien ne l’a remplacée, et à en juger par cette réponse, le modèle n’a jamais appris la chose assez bien pour s’en sortir seul. Demandez à un modèle 4B « what are you? » sans prompt et il se rabat sur la réponse la plus courante dans ses données d’entraînement, qui est celle de quelqu’un d’autre.
Est-ce un détail ? Non. Un modèle qui vous dira, en toute confiance, qui l’a construit et dans quel data centre il tourne, et se trompera sur les deux, fera pareil avec tout ce qu’il ne peut pas vérifier. Ici, vous connaissez la bonne réponse. La plupart du temps, vous ne la connaîtrez pas.
Il faut donc le lui dire, dans un prompt système :
| Question « what are you, and what are you running on? » | Réponse |
|---|---|
| Sans prompt système | « a large language model trained by Google… Google’s advanced infrastructure » |
| Avec un prompt système | « Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM » |
Le même prompt lui dit d’écrire en anglais britannique, là encore à cause de ce réflexe américain que Whisper a aussi. Une fois prévenu, il le fait. Il ne peut toujours pas vous dire quel jour on est. Un modèle sans calendrier et sans internet devine les dates et l’actualité récente, et il ne le dit pas toujours, quoi que demande le prompt.
Trois ans pour faire tourner de l’IA sous Linux
AMD a présenté Ryzen AI sur scène en janvier 2023 comme « the first dedicated artificial intelligence hardware in an x86 processor »19. Comptez à partir de cette keynote :
| Quand | Ce qui s’est passé sous Linux | Après la keynote |
|---|---|---|
| 4 janvier 2023 | Ryzen AI annoncé, dans le Ryzen 7040 | |
| 25 janvier 2024 | amd/xdna-driver publié sur GitHub4 | 1 an |
| 24 mars 2025 | amdxdna dans Linux mainline, 6.1420 | 2 ans 2 mois |
| 27 mars 2025 | cette puce, le Ryzen AI 7 PRO 350, est lancée1 | 2 ans 2 mois |
| 11 mars 2026 | FastFlowLM 0.9.35, sa première version Linux native21 | 3 ans 2 mois |
| 11 août 2026 | FastFlowLM 1.0.0, désormais sous ROCm d’AMD6 | 3 ans 7 mois |
| aujourd’hui | toujours aucun runtime LLM pour les 7040 et 80402 | 3 ans 10 mois |
Trois ans et deux mois pour faire tourner un modèle de langage sur le NPU sous Linux, tout simplement, et ce n’est pas le logiciel d’AMD qui l’a fait. C’est FastFlowLM, un projet né hors de l’entreprise et intégré sous ROCm cette année. Ses notes de version Linux s’ouvrent sur « The wait is finally over », puis disent qu’il utilise « the exact same recipe you already know and love on Windows »21. Le Fisher-Price OS (Windows) l’a eu en premier, et ils l’ont dit. Le Ryzen AI Software d’AMD dit toujours, dans ses notes de version actuelles, « Model generation is not supported on Linux in this release »22.
Ceux qui ont acheté la première génération sont encore plus mal lotis. Un portable Ryzen 7040 de 2023 a un NPU qu’aucun runtime de modèle de langage sous Linux ne touchera, et rien de publié ne dit qu’il y en aura un. Même badge.
Puis-je demander pourquoi ? Pas qui, pourquoi. Qu’est-ce qui, dans le processus d’AMD, a permis de vendre une puce avec IA dans son nom alors que le logiciel pour utiliser cette IA sous Linux est arrivé des années plus tard, de l’extérieur ? La fiche technique dit « Up to 50 TOPS »1. Le badge dit Ryzen AI. Ce sont deux déclarations faites à la personne qui achète le portable, et pendant la première année de cette puce sous Linux, aucune des deux ne valait quoi que ce soit.
Visé sur Copilot, pas sur le data centre
Ce n’est pas qu’AMD trouve Linux difficile. Dans le data centre, Linux est de première classe et AMD le sait : El Capitan, au Lawrence Livermore, ce sont des processeurs AMD EPYC et des accélérateurs AMD Instinct, c’était l’ordinateur le plus rapide du monde jusqu’en juin de cette année23, et il tourne sous TOSS, la version de Red Hat Linux propre à Livermore24. Vous imaginez AMD vendre un accélérateur Instinct et dire à l’acheteur que le logiciel Linux suivrait un jour, et viendrait de quelqu’un d’autre ? Ce serait non. AMD a même écrit le pilote noyau de ce NPU et l’a fait entrer dans mainline. La dernière couche, celle qui fait faire au matériel le travail pour lequel il a été vendu, est le morceau qu’on a laissé attendre.
Ça n’aurait jamais dû être un projet pour portables. La même architecture XDNA est entrée dans une carte de data centre la même année, l’Alveo V70, vendue comme « the first Alveo production card leveraging AMD XDNA architecture with AI Engines »25. Construisez une seule pile logicielle pour l’AI Engine, Linux d’abord comme le reste du data centre, et le portable l’obtient gratuitement. Le serveur aussi. Un petit accélérateur sobre est exactement ce qu’on veut distribuer à des machines virtuelles, une tranche chacune, pour les petits modèles qui n’ont pas besoin d’un GPU entier. Le noyau n’a appris à le faire que cette année, en découpant un NPU en fonctions virtuelles sur les nouvelles puces AIE426. Sur le NPU de ce portable, il ne peut pas le faire du tout.
À la place, l’effort est allé au Fisher-Price OS (Windows), et à Copilot. AMD a lancé la génération de cette puce comme des processeurs qui « Unlock Transformational AI Experiences for Windows Copilot+ PCs »27. Presque personne n’a suivi. Les machines Copilot+ représentaient 2,3 % des PC Fisher-Price OS (Windows) vendus au premier trimestre 2025, et les nouvelles fonctions Copilot de Microsoft tournent de toute façon dans le cloud : « only one of its new AI capabilities actually requires an NPU »28. Microsoft annonce aussi que ce qu’il gagne auprès des fabricants de PC baisse de 7 % sur une « lower PC market demand », avec « roughly 30% of the installed base still on Windows 10 »29. Le NPU visait donc un système d’exploitation vers lequel les gens ne migrent pas, pour faire tourner un assistant qu’ils n’ont pas demandé, qui la plupart du temps n’utilise pas le NPU.
Ce n’est pas non plus là que l’IA se construit. Ceux dont c’est le métier tournent sous Linux, parce que c’est là que tournent leurs outils. TensorFlow dit clairement que la 2.10 « was the last TensorFlow release that supported GPU on native-Windows »30. Le serveur de modèles vLLM « does not support Windows natively »31. JAX range sa compilation Fisher-Price OS (Windows) parmi les expérimentales, et son support AMD sous « AMD GPU (Linux) »32. Là où le Fisher-Price OS (Windows) fait tourner ces outils, c’est via WSL 2, qui selon la propre description de Microsoft est « an actual Linux kernel inside a managed VM »33. AMD a visé avec sa puce d’IA le seul poste de travail que la profession de l’IA n’utilise pas. Le prendre en charge à moitié ne suffit pas, AMD.
Ensuite, AMD se vend aux investisseurs comme une entreprise d’IA. Le 11 novembre 2025, sa présidente-directrice générale a dit qu’AMD « is uniquely positioned to lead the next generation of high-performance and AI computing », dans un communiqué qui se vante d’avoir fait croître son « AI PC portfolio 2.5x since 2024 » et se termine sur « full-stack AI solutions »34. Full stack. Sur le PC IA de ce billet, le sommet de cette pile est venu d’un projet qu’AMD n’a pas lancé, et sur la première génération il n’est jamais venu. Une entreprise d’IA dont la propre puce d’IA a attendu trois ans pour faire tourner de l’IA sur le système d’exploitation sur lequel repose son activité data centre ? Risible.
Un support de première classe est simple à décrire. Il fonctionne le jour où vous achetez la machine, sur le système d’exploitation que vous utilisez, venant de l’entreprise qui vous a vendu la puce. Ce NPU n’y est pas encore. J’ai acheté le portable pour le reste et le NPU est venu avec, ce qui est la seule raison pour laquelle ceci est un compte rendu et pas une réclamation. Quiconque en a acheté un pour l’IA du badge, et tourne sous Linux, a acheté une promesse tenue en retard, et par quelqu’un d’autre.
Possédez le silicium que vous avez payé
Le NPU est venu avec le portable. Tel qu’il est vendu, c’est le morceau qui rend la machine prête pour l’IA, et l’IA proposée est celle de quelqu’un d’autre, dans le data centre de quelqu’un d’autre, qui lit ce que vous tapez pour pouvoir être payée autrement. Rien dans le matériel n’exige cet arrangement. Un modèle 4B sur 21 W répond à une question, lit un copier-coller de 175 000 mots si vous lui en laissez le temps, et note ce que vous dites, et rien de tout ça ne quitte le bureau.
Ce n’est pas un logiciel fini, et chaque aspérité ci-dessus a coûté une heure à trouver et une ligne ou deux à corriger. C’est ce que coûte l’open source quand on le fait vraiment tourner. Ça reste une meilleure affaire que de relouer la même capacité, et l’heure vous achète de savoir comment ça marche.
Les conteneurs gardent l’ensemble honnête. Rien sur l’hôte qu’un module noyau et son firmware, un périphérique passé à un conteneur, une adresse que personne d’autre ne peut atteindre, et une vérification qui échoue dès que les morceaux cessent de correspondre. Ça a pris une journée. Ça continuera de marcher, parce que je sais pourquoi chaque ligne est là, et la vérification me dira le matin où l’une d’elles cessera d’être vraie.
AMD — Ryzen AI 7 PRO 350 — 8 cœurs, 16 threads, Radeon 860M, « NPU TOPS: Up to 50 TOPS », date de lancement « 3/27/2025 ». ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — XDNA2 seulement (Ryzen AI 300/400, Strix Halo), pas XDNA1 ; firmware NPU 1.1.0.0 ou plus ; ne pas activer
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — le pilote d’accélérateur dans l’arbre pour les NPU AMD. ↩︎
amd/xdna-driver — pilote, sous-module XRT et plugin ; compiler le paquet de base XRT à partir du sous-module fourni pour qu’il fonctionne avec le plugin ; dépôt créé le 25 janvier 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; idem dans la v7.2. ↩︎ROCm/FastFlowLM — runtime LLM sur NPU pour XDNA2, serveur compatible OpenAI, intégré à ROCm depuis la v1.0.0 ; la version utilisée ici est la v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — conditions applicables aux binaires de kernels NPU fournis. ↩︎
RPM 6.0.0 release notes — « RPM defaults to enforcing signature checking ». ↩︎
podman-systemd.unit(5) — les unités Quadlet
.container, dontAddDevice=,Ulimit=,StopSignal=etExec=. ↩︎loginctl(1) —
enable-lingerlance un gestionnaire utilisateur au démarrage et le garde actif après la déconnexion. ↩︎Qwen/Qwen3.5-4B — « Context Length: 262,144 natively » ; couches hybrides Gated DeltaNet et attention à portes. ↩︎
ggml-org/llama.cpp — l’image de conteneur
server-vulkanutilisée pour les essais sur GPU, build 12352. ↩︎mlc-ai/mlc-llm — testé avec les paquets nightly 0.26. ↩︎
openai/whisper-large-v3-turbo — « a state-of-the-art model for automatic speech recognition (ASR) and speech translation » ; élagué à partir de large-v3, « the number of decoding layers have reduced from 32 to 4 » ; 809M paramètres ; licence MIT. ↩︎
open-webui/open-webui — version v0.13.3 utilisée ici. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — le message système par défaut du modèle de chat : « You are Qwen, created by Alibaba Cloud. You are a helpful assistant. » ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — modèle de chat sans message système par défaut. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — modèle de chat sans message système par défaut. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 janvier 2023 : « AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor. » ↩︎
Kernel Newbies — Linux 6.14 — publié le lundi 24 mars 2025 ; « an amdxdna driver for AMD NPUs ». ↩︎
FastFlowLM v0.9.35 release notes — 11 mars 2026 : « The wait is finally over… FastFlowLM is officially available natively on Linux! » ↩︎ ↩︎
AMD — Ryzen AI Software release notes — problèmes connus : « Model generation is not supported on Linux in this release. » ↩︎
TOP500 — June 2026 — « LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list » ; El Capitan « is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators ». ↩︎
LLNL — TOSS : Speeding Up Commodity Cluster Computing — « a fully functional cluster operating system, based on Red Hat Linux ». ↩︎
AMD — Alveo V70 — « the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency ». ↩︎
Linux — accel/amdxdna : Add basic support for AIE4 devices — « Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement ». La table du pilote ne donne des entrées de fonctions virtuelles qu’à ces puces ; le NPU de ce portable est
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 juin 2024 : « AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs ». ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 décembre 2025 : les systèmes Copilot+ « made up just 2.3 percent of Windows machines sold in the first quarter of 2025 » ; « only one of its new AI capabilities actually requires an NPU ». ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 juillet 2026, citant la conférence de résultats de Microsoft : « Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand » ; « roughly 30% of the installed base still on Windows 10 ». ↩︎
TensorFlow — Install TensorFlow with pip — « TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows. » ↩︎
vLLM — GPU installation — « vLLM does not support Windows natively ». ↩︎
JAX — Installation — wheels CPU pour « Windows, x86_64 (experimental) » ; sections GPU pour NVIDIA, Google Cloud TPU, Mac et « AMD GPU (Linux) ». ↩︎
Microsoft — Comparing WSL versions — « the use of an actual Linux kernel inside a managed VM ». ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 novembre 2025 : « AMD is uniquely positioned to lead the next generation of high-performance and AI computing » ; « AMD has expanded its AI PC portfolio 2.5x since 2024 » ; « AMD delivers full-stack AI solutions ». ↩︎