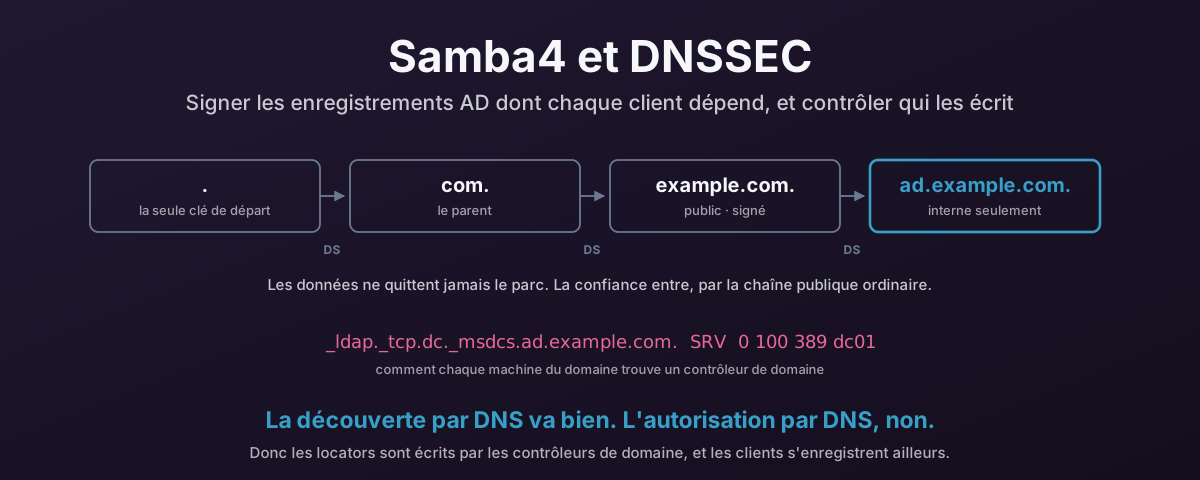
Chaque machine d’un domaine Active Directory trouve son contrôleur de domaine en demandant à DNS. Pas depuis une liste configurée. Elle demande un enregistrement SRV, et elle va là où la réponse l’envoie. Ce qui fait d’une poignée d’enregistrements sous _msdcs la chose la plus critique pour la sécurité de la zone, et soulève deux questions qui méritent une bonne réponse : comment les signez-vous, et qui a le droit de les écrire. Ni l’une ni l’autre n’est souvent posée, et les deux reçoivent par défaut une mauvaise réponse.
Ce billet répond aux deux pour un contrôleur de domaine Samba4. BIND avec dlz_bind9 qui sert l’annuaire, signature en ligne, un primaire caché qu’aucun client n’atteint jamais, une délégation à l’intérieur d’une zone publique pour que la chaîne de confiance remonte jusqu’à la racine, et les mises à jour dynamiques des clients tenues bien à l’écart des locators.
Mais signer ne vaut quelque chose que si vous savez ce que ça protège, et ça veut dire commencer un cran plus bas — à la façon dont un nom est résolu, tout court. Le premier tiers de ce billet est donc la descente depuis la racine. Si vous maîtrisez déjà ça parfaitement, sautez aux deux backends DNS de Samba.
Un résolveur naît en ne sachant presque rien
Il vaut la peine d’être clair sur le peu de choses avec lequel un résolveur naît, parce que tout le reste de ce billet en découle.
Un résolveur récursif fraîchement installé sait deux choses. Il connaît les adresses des serveurs racine — un fichier d’amorçage, treize noms de a.root-servers.net à m.root-servers.net, servis en anycast depuis bien plus d’instances que treize. Et, s’il valide, il connaît une clé publique : celle de la racine.
C’est toute la configuration intégrée. Chaque autre fait qu’il servira un jour — quels serveurs font autorité pour uk, où vit votre domaine, quelle adresse a votre serveur de messagerie — est appris à l’exécution en demandant, puis mis en cache jusqu’à l’expiration de son TTL.
C’est une bonne conception. Personne n’a à livrer une liste des serveurs de noms de l’internet, et aucune partie centrale n’a à approuver un changement dans votre zone. Mais elle a une conséquence qui est le sujet du reste de ce billet : un résolveur croit ce qu’on lui dit, par le serveur que la réponse précédente lui a désigné. Retirez les signatures et toute la structure est une chaîne d’assertions, chacune authentifiée seulement par le fait qu’elle est arrivée de l’adresse que la dernière réponse a nommée. C’est beaucoup de poids à faire porter à une adresse de retour.
La descente de l’arbre
Une recherche n’est pas une seule question. C’est une série de renvois vers le bas de l’arbre des noms, et chaque étape est une requête distincte à un serveur différent.
Disons qu’un client veut dc01.ad.example.co.uk. Un résolveur au cache froid fait ceci :
- Demander à un serveur racine. La racine ne connaît pas la réponse et ne fait pas semblant. Elle renvoie un renvoi : une section de réponse vide, et dans la section d’autorité les enregistrements
NSpouruk, avec les adresses de ces serveurs de noms en glue dans la section additionnelle. - Demander à un serveur
uk. Un autre renvoi, cette fois vers les serveurs de noms deexample.co.uk. - Demander à un serveur
example.co.uk. Siad.example.co.ukest délégué — et dans la conception plus loin dans ce billet il l’est — un renvoi de plus. - Demander à un serveur
ad.example.co.uk. Celui-ci fait autorité pour le nom, donc il répond avec l’enregistrementAet pose le bit AA (réponse faisant autorité).
Trois choses à propos de cette descente comptent plus loin.
Le renvoi est la délégation. Le parent d’une zone ne détient pas son contenu. Il détient des enregistrements NS qui disent « demandez là-bas », et — une fois la signature entrée en jeu — un enregistrement DS qui dit « et voici l’empreinte de la clé à laquelle vous devez vous attendre en le faisant ». La délégation est le seul mécanisme structurel qu’a le DNS, et c’est la chose que vous utiliserez pour garder une zone interne interne.
Presque tout ça est mis en cache. Les renvois de la racine et des TLD ont de longs TTL, donc un résolveur au cache chaud saute directement à l’étape trois ou quatre. C’est pourquoi le cache d’un résolveur vaut d’être attaqué : empoisonnez une entrée et vous avez redirigé tout ce qui est en dessous pour la durée du TTL que vous avez choisi.
Le nom complet n’est pas envoyé à chaque serveur. Sous la minimisation du QNAME, un résolveur ne demande à la racine que uk, pas dc01.ad.example.co.uk. Bon à savoir si vous cherchez un jour vos noms internes dans un journal de requêtes en amont. Ils ne devraient pas y être.
Stub, récursif, autoritatif
Trois mots employés de façon interchangeable qui désignent des travaux bien différents. La distinction est porteuse pour la moitié Active Directory de ce billet, alors il vaut la peine de la clouer.
| Ce qu’il fait | Descend l’arbre ? | Détient des données de zone ? | |
|---|---|---|---|
| Résolveur stub | La bibliothèque ou le service local que vos applications appellent. Demande à un serveur configuré et prend la réponse. | Non | Non |
| Transitaire | Passe les requêtes à un autre résolveur, met les réponses en cache. | Non | Non |
| Résolveur récursif | Fait la descente ci-dessus, met chaque étape en cache, valide éventuellement les signatures. | Oui | Non |
| Serveur autoritatif | Répond pour les zones qu’on lui a données, et celles-là seulement. Dit « je ne sais pas » pour tout le reste. | Non | Oui |
La ligne importante est la dernière. Un serveur autoritatif n’a rien à faire à faire de la récursion, et un résolveur récursif n’a rien à faire à être autoritatif. Les combiner, c’est ainsi que vous obtenez une machine qui va à la fois accepter des questions arbitraires de clients et détenir des données dont ces clients dépendent — ce qui est exactement la machine que vous ne voulez pas que votre contrôleur de domaine soit.
Sur un poste Linux moderne, il y a une autre couche à connaître. systemd-resolved fait tourner un écouteur stub sur l’adresse de bouclage et écrit un resolv.conf qui pointe vers lui-même, avec options edns0 trust-ad. Ce trust-ad est celui à remarquer : il dit au stub de croire le bit AD (données authentifiées) dans les réponses de ce serveur. Le bit AD ne prouve rien à lui seul — c’est l’affirmation du résolveur amont que lui a validé. Le croire est raisonnable quand l’amont est le vôtre et que le saut vers lui est digne de confiance, et sans valeur autrement.
Comment les services sont réellement trouvés
Un enregistrement A répond à une seule question : quelle adresse ce nom a-t-il. Il ne dit rien sur quel port est le service, lequel de plusieurs serveurs préférer, ni quoi faire quand le premier est en panne.
Les enregistrements SRV répondent aux trois. Depuis la RFC 2782, la forme est :
_service._proto.name. TTL IN SRV priority weight port target
Chaque champ gagne sa place :
- Les préfixes en tiret bas gardent les libellés de service dans un espace de noms à eux.
_tcpne peut jamais entrer en collision avec un hôte réellement appelétcp, parce qu’un nom d’hôte ne peut pas commencer par un tiret bas. - Priority est l’ordre de bascule — le plus bas est essayé d’abord. Les serveurs à un numéro de priorité plus élevé ne sont utilisés que quand tout ce qui est en dessous est injoignable.
- Weight partage la charge au sein d’une priorité. Une paire à weight 100 et weight 300 reçoit environ un quart et trois quarts des clients. C’est un tirage proportionnel, pas du tourniquet.
- Port libère le service d’un numéro bien connu, ce qui est ainsi qu’un client trouve un serveur LDAP sur 3268 sans que personne ne le code en dur.
- Target doit être un nom avec des enregistrements
AouAAAA. La RFC 2782 est explicite : il ne doit pas être un CNAME, et une cible unique de.veut dire « ce service n’est délibérément pas offert ici » — une chose utile à publier volontairement.
C’est ce qui rend un domaine localisable plutôt que configuré. Une machine jointe au domaine n’a pas de liste de vos contrôleurs de domaine. Elle a un nom de domaine, et elle demande.
Les noms qu’Active Directory publie
Un domaine AD est, du point de vue d’un client, surtout un ensemble d’enregistrements SRV. L’arbre sous _msdcs est la partie intéressante, parce que c’est ainsi que les clients distinguent « un serveur LDAP » d’« un contrôleur de domaine pour ce domaine » d’« un catalogue global pour cette forêt » :
| Nom | Ce qui le demande |
|---|---|
_ldap._tcp.<domain> | Tout ce qui veut du LDAP dans le domaine |
_ldap._tcp.dc._msdcs.<domain> | Localisation d’un contrôleur de domaine — le gros morceau |
_ldap._tcp.pdc._msdcs.<domain> | L’émulateur PDC précisément |
_ldap._tcp.gc._msdcs.<forest> | Catalogue global |
_kerberos._tcp.<domain>, _kerberos._udp.<domain> | Localisation du KDC, avant qu’aucun ticket n’existe |
_kpasswd._tcp.<domain>, _kpasswd._udp.<domain> | Changements de mot de passe |
_ldap._tcp.<site>._sites.dc._msdcs.<domain> | Localisation par site — trouver un DC qui est près |
Regardez à quoi sert cette liste. L’authentification Kerberos ne peut pas commencer tant que le client n’a pas trouvé de KDC, et il trouve le KDC par DNS. La localisation par site veut dire que la réponse décide aussi contre quel centre de données un client s’authentifie.
La même idée, modernisée
SRV a un successeur à connaître. Les enregistrements SVCB et HTTPS (RFC 9460) généralisent le motif : des paramètres de service dans le DNS, dont l’ALPN, le port et des indices d’adresse, dans un seul enregistrement. C’est ainsi qu’un navigateur apprend à aller droit vers HTTP/3 sans redirection. L’enregistrement HTTPS est déjà largement déployé. Le mécanisme est le même dans l’esprit que SRV : le client se fait dire, par DNS, comment atteindre le service. Ce qui veut dire que l’argument de la section suivante s’y applique tout autant.
Tout ce qui suit la recherche fait confiance à la recherche
Voici le pivot, et c’est la raison pour laquelle un billet sur le DNS a une section sécurité plutôt que l’inverse.
Une machine jointe au domaine démarre et demande où est un contrôleur de domaine. Elle obtient un nom et un port. Elle s’y connecte, et alors elle se met à faire toutes les choses qu’on considère normalement comme la couche de sécurité : Kerberos, signature LDAP, liaison de canal, validation de certificat.
Alors que se passe-t-il si la réponse était un mensonge ?
Être juste là-dessus compte, parce que la réponse n’est pas « catastrophe instantanée ». Kerberos a été conçu avec une authentification mutuelle justement pour qu’un client ne soit pas à la merci de sa recherche de nom : un hôte qui ne peut pas produire de ticket de service pour le nom que le client a demandé ne peut pas achever l’échange. Obtenez une réponse SRV pointant vers une machine sans clé dans le domaine et, pour un client configuré strictement, ça échoue.
Le dommage réaliste est plus subtil, et il est tout entier dans les interstices autour de ça :
- Rétrogradation. Un client qui se rabat sur NTLM quand Kerberos ne marche pas vient d’être remis à quiconque a répondu.
- Relais et coercition. L’attaquant n’a pas besoin d’être le DC. Être le nom auquel un client se connecte suffit pour commencer à relayer cette authentification quelque part où elle est utile.
- Déni de service qui a l’air d’une panne. Pointez
_ldap._tcp.dc._msdcsvers quelque chose qui ne répond pas et le domaine est cassé par intermittence d’une façon que personne ne diagnostique comme du DNS pendant un bon moment. - Tout ce qui n’a aucune authentification mutuelle. Synchro d’heure, syslog, supervision, agents de sauvegarde, ce truc HTTP interne avec
verify=False. Bien des parcs en ont plus qu’ils n’aimeraient l’admettre.
Le principe général est celui à retenir : le DNS est un mécanisme de découverte, pas un mécanisme d’autorisation. Il est tout à fait raisonnable de trouver un service par son nom. Il n’est pas raisonnable d’accorder quoi que ce soit sur la foi d’un nom, et le nombre de systèmes qui le font discrètement — listes d’autorisation par PTR, ACL par nom d’hôte, « c’est sur le réseau interne donc c’est à nous » — est la vraie surface d’attaque.
Ce que DNSSEC corrige, et ce qu’il ne corrige pas
DNSSEC existe pour répondre à une question : cette réponse vient-elle vraiment de la zone qui possède le nom, sans modification ?
Il fonctionne (RFC 4033 et les deux qui suivent) en signant, et en chaînant les signatures à quelque chose auquel vous faites déjà confiance :
- Chaque RRset d’une zone signée a un
RRSIG— une signature sur cet ensemble. - Les clés publiques de la zone sont publiées en
DNSKEY. - La zone parente publie un enregistrement
DS: un condensé de la clé de l’enfant. - Ce
DSest lui-même signé par le parent, dont la clé est condensée dans leDSde son parent, jusqu’à la racine — et la clé de la racine est la seule chose que votre résolveur connaissait en naissant.
Le déni est signé lui aussi, ce qui est facile à négliger et compte plus qu’il n’y paraît. Sans lui, « aucun nom de ce type » est une réponse non authentifiée qu’un attaquant peut forger pour faire disparaître quelque chose. NSEC et NSEC3 donnent un « rien n’existe entre ces deux noms » authentifié.
C’est une vraie correction pour un vrai problème. L’empoisonnement de cache n’est pas théorique : l’attaque de Kaminsky a rendu l’usurpation hors chemin assez bon marché pour forcer un correctif d’urgence sur tout l’internet, et les mesures d’atténuation qui ont suivi — randomisation du port source, mélange de casse 0x20 — sont toutes des tentatives de rendre la devinette plus difficile, pas de rendre les réponses vérifiables. Le travail sur les canaux auxiliaires depuis les a rognées à répétition. Les signatures sont la seule chose de cette liste qui change la donne plutôt que d’en relever le prix.
Maintenant les limites honnêtes, parce que DNSSEC est survendu dans les deux sens.
Ce n’est pas de la confidentialité. Signer, c’est de l’authentification à clé publique ; chaque requête et chaque réponse est encore en clair sur le fil. La confidentialité sur le saut client, c’est DoT, DoH ou DoQ, et ce sont un mécanisme différent qui résout un problème différent. Chiffrer le saut vers un résolveur qui ne valide pas vous achète une conversation privée avec quelque chose à qui on peut encore mentir.
Il ne valide pas le sens, seulement l’origine. DNSSEC prouve que le propriétaire de la zone a publié ceci. Si l’enregistrement est faux, ou malveillant, ou a été écrit par quelqu’un que la zone a imprudemment autorisé à l’écrire, la signature s’y applique tout aussi fidèlement. Signer une zone que des machines non fiables peuvent écrire ne rend pas le contenu digne de confiance — ça authentifie le mensonge. Retenez cette phrase ; le dernier tiers de ce billet en est essentiellement la conséquence.
Il n’aide que si quelqu’un valide. Si votre résolveur ne valide pas, les signatures sur les zones que vous interrogez sont de la décoration. Et si la validation a lieu à un résolveur de l’autre côté du réseau par rapport au client, le client fait confiance au bit AD et au chemin — voir trust-ad plus haut.
Et il faut l’exploiter. Une signature expirée n’est pas une réponse dégradée, c’est un SERVFAIL — le nom s’éteint. Un DS dans le parent qui ne correspond plus à la clé de l’enfant fait pareil. C’est le coût honnête, et à ce titre l’automatisation des sections suivantes compte plus que la signature initiale.
Pourquoi une TLD interne inventée ne peut pas être signée
C’est ici que des décisions de nommage prises il y a des années reviennent avec une facture, et il vaut la peine de le détailler parce que c’est la raison pour laquelle la conception de ce billet utilise un domaine réel, possédé, pour les noms internes.
Regardez à nouveau comment la chaîne est construite : la clé d’une zone est garantie par un enregistrement DS dans son parent. Donc un résolveur validant ne peut authentifier une zone interne que si cette zone a un parent capable et disposé à publier un DS pour elle.
ad.corp.local n’a pas de tel parent. Ni .lan, .home, ni rien d’autre inventé le jour où le domaine a été provisionné :
.localest réservé au mDNS. L’utiliser pour du DNS unicast n’est pas seulement non signé, c’est une collision documentée avec la façon dont chaque système d’exploitation du bâtiment a le droit de se comporter. Il a sa propre section plus bas, parce qu’il joue dans une autre catégorie que les trois autres..lan,.corp,.homesont des chaînes non enregistrées. Il n’y a pas de parent pour détenir unDS, et les versions demandées ont été retirées de la délégation à cause du bazar des collisions de noms dans les parcs privés.home.arpaest proprement réservé aux réseaux domestiques, ce qui semble idéal — mais sa délégation est délibérément non sécurisée. Il n’y a pas de chemin signé jusqu’à lui, par conception..internala été mis de côté par l’ICANN pour exactement cet usage, et il résout le problème de collision. Il ne résout pas celui-ci : pas de délégation veut dire pas deDS, donc pas de chaîne.
Vos options avec une zone interne non chaînée sont de la laisser non signée, ou de configurer un point d’ancrage de confiance local sur chaque résolveur validant du parc et de devenir la racine de votre propre île privée — une clé que vous devez désormais distribuer, surveiller et faire rouler à la main, sur chaque résolveur, pour toujours, avec un SERVFAIL sur tout le domaine comme mode de défaillance.
Il y a une réponse bien plus facile, et elle est gratuite : faites de la zone interne une délégation à l’intérieur d’une zone publique que vous possédez déjà et signez déjà. ad.example.com, déléguée depuis example.com. Le DS va dans le parent public. Chaque résolveur validant du parc authentifie alors les noms internes avec le point d’ancrage de confiance qu’il a déjà, et vous ne distribuez rien.
Le contenu reste à l’intérieur. Seule la confiance vient de l’extérieur. Cette distinction est la conception dans tout le reste de ce billet.
.local n’est pas un choix de style
L’une de ces quatre mérite sa propre section, parce que c’est celle que les gens défendent, et parce que la défense est toujours la même : ça marche, on l’utilise depuis des années, où est le problème.
Le problème, c’est que .local n’est pas une chaîne non enregistrée que quelqu’un pourrait un jour vendre. C’est un espace de noms qui a déjà un propriétaire et un comportement défini, et le comportement n’est pas « demander au serveur DNS ». La RFC 6762 §3 n’est pas tendre à ce sujet :
Any DNS query for a name ending with “.local.” MUST be sent to the mDNS IPv4 link-local multicast address 224.0.0.251 (or its IPv6 equivalent FF02::FB).
Lisez ce que ce MUST gouverne réellement. Ce n’est pas une affirmation sur qui possède la chaîne. C’est une instruction sur où va la requête — et la réponse est un groupe multicast sur le lien local, pas votre contrôleur de domaine. La même section dit que les noms sous .local n’ont « meaningful only on the link where they originate » — de sens que sur le lien où ils naissent, l’équivalent DNS d’une adresse 169.254.
Donc un client qui suit correctement la spécification ne demandera jamais à votre serveur DNS un nom .local. Il crie sur le fil et prend ce qui répond.
Ça produit un ensemble de défaillances d’une saveur très particulière :
- La résolution dépend du client, pas de votre DNS. macOS résout
.localpar Bonjour et l’a toujours fait ;systemd-resolvedroute le domainelocalvers mDNS par défaut ; Windows fait du mDNS depuis Windows 10. Trois piles, trois jeux de règles, et votre fichier de zone n’est consulté par aucune d’elles. - Ça s’arrête au premier routeur. Le mDNS est lien-local par conception. Un nom qui résout à un bureau sur le même VLAN ne résout pas depuis un autre étage, un autre site, ou le VPN — c’est le ticket « marche au bureau, casse à la maison » qui est fermé en « souci réseau » quatre fois avant que quelqu’un ne lise la spec.
- Le comportement change sous vos pieds. Qu’une machine donnée essaie le multicast d’abord, l’unicast d’abord, ou les deux en parallèle dépend de la pile de résolution et de sa version. Les parcs qui ont tourné sur
.local« très bien pendant des années » sont d’habitude des parcs où une mise à jour de distribution n’a pas encore changé l’ordre. - La preuve manque là où vous la cherchez. Le journal de requêtes du DC ne montre rien, parce que rien n’est arrivé. Les gens passent des jours sur le serveur, et la requête n’a jamais quitté le client.
- Et ça ne peut pas être signé, ce qui est le propos de cette section. Pas de parent, pas de
DS, pas de chaîne, aucun moyen d’en publier une.
Maintenant mettez ça sous un domaine Active Directory. Le royaume est dérivé du nom de domaine. Les principaux de service sont dérivés du royaume. Les locators _msdcs — les enregistrements dont parle tout ce billet — siègent sous un suffixe qu’un client conforme est tenu de résoudre en criant sur le segment local. Vous bâtissez Kerberos par-dessus un espace de noms que la moitié de votre parc résout avec un protocole conçu pour trouver des imprimantes.
Et la sortie coûte cher, ce qui rend la décision d’origine digne d’être regardée sans sentimentalisme. Il n’y a pas de renommage en place sur Samba. Le chemin documenté est samba-tool domain backup rename suivi d’une restauration : vous prenez une copie renommée de la base de données, réamorcez un nouveau DC à partir d’elle, et rajoutez chaque autre DC de zéro, sans chevauchement permis entre les DC à l’ancien nom et au nouveau nom. Ce n’est pas le rendom de Windows, qui au moins parcourt les DC un à un. C’est une reconstruction avec un plus joli nom.
Donc le résumé honnête. .local pour un domaine unicast n’est pas une préférence, une convention, ou un innocent brin d’héritage. C’est un conflit documenté avec un protocole livré activé sur chaque système d’exploitation du bâtiment, et la facture arrive des années plus tard sous forme de défaillances de résolution intermittentes et non reproductibles — et, quand vous voudrez enfin signer la zone, sous forme d’une reconstruction de domaine.
La même erreur, sous un autre chapeau
Tant qu’on y est : le port 5353.
Le mDNS écoute sur UDP 5353, et ce n’est pas un port de rechange qui se trouve être libre. Poser un service DNS unicast normal dessus, ou pointer les résolveurs vers :5353 parce que le 53 était occupé ou demandait root, fait le même dégât depuis l’autre direction — chaque machine consciente du mDNS sur ce segment parle maintenant à votre service de noms, et votre service de noms traite maintenant de la découverte de services multicast qu’il n’a jamais été censé traiter. Le nom et le port sont deux moitiés d’un seul espace de noms, et les deux appartiennent déjà à quelqu’un d’autre.
.local sur le 53, ou du DNS unicast sur le 5353. Même malentendu, même classe de défaillance intermittente, mêmes semaines du temps de quelqu’un d’autre.
Et soyez honnête sur ce que ça dit
Microsoft a recommandé .local à l’époque de Small Business Server, ce qui est pourquoi tant de parcs le portent encore, et a cessé de le recommander il y a longtemps. Hériter d’un domaine .local est de la malchance. La plupart des gens qui lisent ceci et en ont un ne l’ont pas choisi, et la section ci-dessus est un plan de migration plutôt qu’une accusation.
Le déployer est une tout autre affaire, et je vais être franc là-dessus, parce que l’adoucir n’a aidé personne.
Quiconque déploie .local pour Active Directory ou pour du DNS unicast standard, ou pose un service DNS sur le port 5353, n’est pas un professionnel de l’informatique. Il peut en avoir le titre. Il ne fait pas le travail. La RFC 6762 est publiée depuis 2013, elle se lit en vingt minutes, et la phrase qui règle toute la question est dans la section 3. Bâtir le service de noms d’une entreprise sur un espace de noms que la spécification réserve au multicast lien-local n’est pas une décision d’ingénierie défendable. C’est quelqu’un qui devine dans la seule partie de la pile où deviner produit des défaillances que personne ne peut reproduire et que tout le monde met sur le dos du réseau.
Il devrait être retiré de votre service informatique. Pas déplacé de côté, pas mis à s’occuper du DNS sous supervision. Retiré de la fonction. Le rôle existe pour savoir quel paquet va où et sur l’autorité de qui. Quelqu’un qui n’a pas lu le document qui gouverne l’espace de noms qu’il a choisi pour chaque machine du bâtiment ne remplit pas ce rôle, et le garder dedans veut dire que la prochaine décision de cette taille sera prise de la même façon.
Et chaque système qu’il a touché devrait être audité. C’est la partie que les gens sautent, et c’est celle qui compte le plus. Une décision comme celle-ci n’est jamais isolée. Quelqu’un qui n’a pas vérifié la RFC 6762 avant de nommer le domaine n’a rien vérifié d’autre non plus — alors allez voir ce qu’il a bâti d’autre. Attendez-vous à trouver :
- Des serveurs DNS ouverts au monde, des transitaires qui répondent à quiconque demande, et aucune ACL nulle part.
- La mise à jour dynamique laissée grande ouverte, et des conteneurs de zone avec des permissions que personne n’a revues depuis la création du domaine.
- Des certificats et du Kerberos bâtis par-dessus des noms qui n’allaient jamais résoudre de façon cohérente, les défaillances recouvertes par des fichiers hosts.
- Des fichiers hosts. Partout. Des parcs entiers ont tenu grâce à eux justement parce que
.localn’a jamais marché correctement et que quelqu’un a trouvé un contournement au lieu d’une cause. - Des règles de pare-feu et des comptes de service créés pour faire disparaître les symptômes, toujours en place, accordant encore plus que personne ne se rappelle.
Ce n’est pas de la rancune. C’est ce à quoi sert un signal de compétence. Quand vous trouvez une décision prise sans lire la spec, la bonne réponse est de supposer que le reste a été pris de la même façon et d’aller vérifier — parce que la même personne a configuré votre authentification, vos certificats et votre contrôle d’accès, et vous avez maintenant une preuve directe de sa façon d’aborder un problème qu’elle ne comprend pas entièrement.
Hériter de ce bazar vous coûte une migration. Employer la personne qui le crée encore vous coûte considérablement plus.
Les deux backends DNS de Samba
Un contrôleur de domaine AD Samba stocke ses données DNS dans l’annuaire lui-même, et il y a deux façons de les servir.
SAMBA_INTERNAL est le serveur DNS propre à Samba, intégré au DC AD. Il gère les zones AD et les mises à jour dynamiques authentifiées par Kerberos, et il passe tout le reste à un transitaire. Samba le décrit comme supportant « the basic feature required in an AD » — la fonction de base requise dans un AD — et le recommande « for simple DNS setups », pour des installations DNS simples, ce qui est juste et à prendre au pied de la lettre. Il a sa propre section plus bas, parce que ce qu’il ne fait pas est plus long et plus intéressant que ce qu’il fait.
BIND9_DLZ fait tourner BIND comme serveur DNS, avec le module dlz_bind9 de Samba chargé dedans. DLZ — Dynamically Loadable Zones — est une interface de BIND pour adosser une zone à autre chose qu’un fichier de zone. Le module répond aux requêtes de BIND directement depuis sam.ldb, donc il n’y a pas de copie, pas d’étape d’export, et pas de synchronisation qui puisse mal tourner : BIND lit l’annuaire pendant qu’il sert.
Le serveur DNS interne ne fait pas de récursion — il ne peut pas
Commençons par la chose qui est presque toujours décrite de travers, y compris par les gens qui l’exploitent.
« Le DC est notre serveur DNS, il fait de la récursion pour les clients » n’est pas ce qui se passe, parce que le serveur DNS interne ne peut pas du tout faire de récursion. La propre liste de fonctionnalités de Samba le dit clairement. Le DNS interne ne supporte pas :
- d’agir comme résolveur de cache
- les requêtes récursives (mais il peut transiter vers un autre serveur de noms DNS récursif)
- la signature de transaction à clé partagée (TSIG)
- les zones stub
- les transferts de zone
- l’équilibrage de charge en tourniquet entre DC
le nettoyage (scavenging) et les transitaires conditionnels étant listés comme non implémentés eux aussi.
Lisez les deux premières ensemble, parce que c’est toute l’histoire. Il ne peut pas résoudre, et il ne peut pas mettre en cache. Ce que dns forwarder vous achète réellement est un relais : un client demande windowsupdate.com au DC, le DC demande à un vrai résolveur, la réponse revient par le DC, et le DC l’oublie ensuite entièrement. Le client suivant pose la même question et tout recommence.
Regardez la table plus haut dans ce billet et notez ce que c’est : un transitaire sans le cache du transitaire. Il a les coûts du rôle — un saut de plus, une dépendance, une chose qui peut tomber — et aucun de ses bénéfices.
Donc un DC avec SAMBA_INTERNAL qui sert le parc n’est pas un serveur DNS au sens où les gens l’entendent. C’est un proxy sans cache pour un vrai résolveur, et vous l’avez placé sur la machine qui détient votre annuaire.
Pourquoi c’est un risque et pas juste une inefficacité
L’inefficacité est facile à voir : chaque recherche externe du bâtiment devient un aller-retour par le DC AD, en permanence, sans cache pour en émousser l’arête. Sur un domaine tranquille personne ne le remarque. C’est exactement pourquoi ça survit.
L’argument de sécurité est celui qui vaut la peine d’être fait, et il a trois parties.
L’écouteur est dans le mauvais processus. Le DNS interne est une tâche de service du DC AD lui-même, tournant avec les privilèges de l’annuaire — pas un démon séparé sous son propre compte comme l’est named. Donc la chose qui analyse de l’UDP non authentifié venant de tout ce qui peut atteindre le port 53 tourne à l’intérieur du processus qui sert LDAP et Kerberos et possède sam.ldb. BIND a trente ans d’attention hostile, un utilisateur dédié, et l’habitude d’être exécuté en prison, justement parce qu’un écouteur DNS est un quartier difficile. Le serveur interne de Samba est une commodité qui se trouve vivre dans les joyaux de la couronne.
Servir les clients veut dire être joignable par les clients. Pour être le serveur DNS du parc, il doit accepter des requêtes de chaque poste, chaque imprimante, chaque portable de prestataire sur le VLAN invité que quelqu’un a ponté par accident. C’est une grande surface d’attaque, ouverte en permanence, non authentifiée, sur l’hôte le plus précieux que vous possédiez, et vous la faites tourner pour économiser le coût d’un résolveur qu’un Raspberry Pi pourrait héberger.
Et un transitaire ouvert au monde est l’arme de quelqu’un d’autre. Un DC qui transite pour tout ce qui demande est un transitaire ouvert. Une fois joignable hors de votre réseau, il devient un participant à la réflexion et à l’amplification, ce qui veut dire que le trafic et les rapports d’abus arrivent tous deux à votre contrôleur de domaine. Il n’y a pas de limitation de débit vers laquelle se tourner, parce que le serveur interne n’en a pas.
Rien de tout ça ne demande une vulnérabilité de Samba pour être une mauvaise idée. C’est une mauvaise idée sur la forme seule : ça met un service non authentifié, exposé-à-l’internet-par-accident, lourd en analyse, dans le même processus que votre annuaire, pour faire un travail dont il est documenté qu’il ne peut pas le faire correctement.
Il tombera plus tôt, et emportera plus avec lui
Il vaut la peine d’être clair sur ce que cet argument n’est pas. Ce n’est pas une affirmation que le code DNS de Samba a plus de bugs que celui de BIND. BIND a une longue liste de CVE, surtout parce que c’est l’implémentation DNS la plus examinée qui existe, et compter les avis serait une piètre façon de choisir entre eux.
La comparaison qui compte est structurelle, et elle se ramène à trois questions avec trois réponses inconfortables.
Qui peut lui envoyer un paquet malformé ? Avec SAMBA_INTERNAL qui sert le parc : chaque poste, chaque téléphone sur le sans-fil, tout ce qui peut router jusqu’au port 53 de cette machine. Avec la conception de ce billet : le signeur. Un hôte, une clé TSIG, allow-query limité à lui. Ce n’est pas une petite différence de degré. C’est la différence entre un service exposé et un effectivement injoignable, et elle éclipse toute différence de qualité de code entre les deux implémentations.
Qu’est-ce qui tombe quand il tombe ? C’est celle qui décide de la gravité. named est un démon séparé sous son propre compte ; quand il meurt, le DNS s’arrête et le contrôleur de domaine continue d’authentifier. Le DNS interne de Samba est une tâche de service dans le DC AD, donc tout ce qui le coince, l’épuise ou le fait planter se passe à l’intérieur du processus qui sert LDAP et Kerberos. Un problème de DNS devient une panne d’annuaire. Et systemctl restart named coûte une seconde, alors que redémarrer un DC est un autre genre de matinée.
Que pouvez-vous y faire pendant que ça arrive ? BIND a la limitation de débit des réponses, allow-query, allow-recursion, blackhole, la politique par vue, et l’option de ne pas répondre aux clients du tout. Le serveur interne a dns forwarder et un fichier de journal. Quand quelque chose se met à le marteler, il n’y a pas de molette à tourner.
Ajoutez ensuite le cache manquant. Chaque requête client est un aller-retour sortant neuf, donc un déluge de requêtes coûte au DC une recherche amont par paquet plutôt qu’un accès cache — et ça lui coûte dans le même processus qui essaie d’émettre des tickets Kerberos. Vous n’avez pas besoin d’un exploit pour ça ; vous avez besoin d’une matinée chargée, d’une application qui se conduit mal, ou de quelqu’un qui pointe un scanner sur le mauvais VLAN. Soutenu, ça se présente comme une authentification lente et personne ne pense à regarder le DNS.
Alors oui — même avec DLZ dans le tableau, BIND est l’endroit le plus sûr pour ça. Le module DLZ donne bien à named accès aux données de Samba, et c’est une vraie considération dont ce billet a déjà tenu à faire un point. Mais un plantage de named est une panne de DNS plutôt qu’une panne d’annuaire, et dans cette conception ce named ne prend pas de requêtes du parc au départ. Les bugs sont un fait de toute base de code. Le périmètre d’impact et la joignabilité sont des choses que vous choisissez.
Et il ne peut pas bâtir la conception de ce billet
Il y a une raison plus simple et plus définitive pour laquelle ce n’est pas le backend ici.
Pas de transferts de zone. La pipeline de la section suivante — primaire caché, signeur, serveurs autoritatifs autonomes — commence par un AXFR sortant du DC. SAMBA_INTERNAL n’a rien pour transférer. Pas de TSIG non plus, donc même l’authentification dont ce transfert aurait besoin est absente. Et pas de signature, et pas de validation de quoi que ce soit qu’il transite.
Donc le résumé honnête de SAMBA_INTERNAL : c’est le backend qui vous laisse monter un domaine AD dans un labo un dimanche après-midi sans configurer BIND, et il est très bon à ça. Samba dit « installations DNS simples » et le pense. Ce n’est pas un résolveur, il n’a jamais été bâti pour être le service DNS d’un parc, et à la seconde où vous voulez de la signature, des transferts, des vues, des ACL, du cache ou de la limitation de débit, la réponse n’est pas de le régler. Il n’a pas ces molettes. La réponse est BIND.
Si vous le faites tourner aujourd’hui avec chaque client pointé vers le DC, le correctif n’est pas urgent mais il n’est pas facultatif non plus : donnez aux clients un vrai résolveur validant, et posez dns forwarder sur le DC pour qu’il pointe vers lui, si bien que le DC répond pour ses propres zones et rien d’autre.
Et voici la partie sur laquelle je veux être clair, parce que « n’utilisez pas DLZ » est répété comme si c’était une règle de durcissement : DLZ n’est pas l’exposition. C’est le mécanisme d’extraction. Ce qui compte n’est pas quel module est chargé dans BIND — c’est qui a le droit de parler à ce BIND, et ce qu’il advient de la zone ensuite. Un BIND adossé à DLZ qui ne répond qu’à une demande de transfert de votre signeur n’est pas une surface d’attaque en un sens intéressant. Un DC SAMBA_INTERNAL qui traite chaque recherche de nom de quatre cents portables l’est très certainement. Une seule de ces deux choses apparaît sur les listes de durcissement, et ce n’est pas celle qui compte.
Deux choses à propos de DLZ sont vraies et méritent qu’on les planifie plutôt qu’on les craigne :
- Le module est couplé à la version de BIND. Samba livre un
.soséparé par version de BIND, etnamed.confen nomme un précisément. Une montée de version majeure de BIND veut dire que le module correspondant doit être en place, sinonnamedne démarre pas. C’est une dépendance d’empaquetage à tester d’avance, pas une propriété de sécurité. nameda besoin d’accès aux données de Samba, ce qui est pourquoi Samba garde un répertoire dédié pour les bits dont BIND a besoin plutôt que de lui accorder tout le répertoire privé. L’octroi est censé être étroit — à vérifier qu’il l’est encore sur vos DC, puisque c’est le seul endroit où DLZ élargit ce qu’une compromission denamedatteindrait.
La raison pour laquelle DLZ est le bon choix ici est ce qu’il permet : l’interface DLZ de BIND supporte l’énumération d’une zone entière, ce qui est ce qui rend possible, tout court, un transfert de zone sortant d’une zone adossée à DLZ. Ce transfert est le premier saut de la pipeline, et c’est BIND qui le fait, ce qui veut dire que le reste de la pipeline est de la configuration BIND ordinaire plutôt que quoi que ce soit d’exotique.
Il y a une contrainte qui façonne tout ce qui est en aval, et il vaut la peine de l’énoncer clairement parce qu’il est facile de supposer le contraire. Une zone DLZ ne peut pas être signée elle-même. L’ISC est explicite là-dessus dans le BIND ARM : DLZ « is unable to handle DNSSEC-signed data due to its limited API » — est incapable de gérer des données signées par DNSSEC à cause de son API limitée. Vous ne pouvez pas accrocher une dnssec-policy à l’instruction dlz et en avoir fini.
Ce que vous pouvez faire — et ce que l’ISC suggère pour DLZ dans la même respiration — est de le faire tourner comme un primaire caché, avec la signature faite par une zone BIND normale qui transfère les données en entrée. C’est la section suivante, et la contrainte est la raison de la forme qu’elle a.
Il vaut la peine de savoir que c’est une contrainte de Samba plutôt qu’une loi d’Active Directory. Le serveur DNS de Microsoft fait de la signature en ligne de zones dynamiques intégrées à AD depuis Windows Server 2012. La zone est signée en place, les clés privées se répliquent vers les Key Masters par la réplication AD elle-même, et les mises à jour dynamiques continuent de marcher. Sur Windows, « signer les partitions AD » est une vraie option et la réponse à l’objection du churn est intégrée. (Sur Server 2008 R2 elle ne l’était pas : vous pouviez signer une zone intégrée à AD, mais pas une acceptant des mises à jour dynamiques, et chaque changement voulait dire re-signer à la main — d’où vient le folklore selon lequel les zones AD ne seraient pas signables.)
Samba n’a pas d’équivalent. Aucun backend ne signe : le serveur interne n’a aucun DNSSEC, et DLZ ne peut pas porter de données signées. Donc sur Samba la pipeline transfert-et-signature n’est pas une conception parmi plusieurs. C’est la voie.
La pipeline de publication
Maintenant sa forme. Quatre rôles, et le DC est au fond où rien ne peut l’atteindre.
named sur le DC ou un hôte séparé. Les serveurs autoritatifs autonomes sont la seule chose que les clients voient jamais, et ce sont des secondaires de la zone signée.1. Le contrôleur de domaine — primaire caché. BIND avec dlz_bind9, autoritatif pour les zones AD depuis l’annuaire. Récursion coupée. Aucun service face aux clients. allow-transfer restreint au seul signeur, avec TSIG. Du point de vue du réseau, le DC ne sert pas de DNS du tout, et la seule chose qui l’interroge jamais est la boîte suivante.
2. L’instance de signature — une zone BIND normale qui transfère les données en entrée. C’est là que vivent inline-signing et la dnssec-policy, sur une zone du même nom qui détient la copie transférée. BIND garde la copie non signée qu’il a reçue et la copie signée qu’il publie comme des choses distinctes, et re-signe à mesure que de nouveaux transferts arrivent. Parce que c’est un transfert plutôt qu’un fichier partagé, cette instance peut siéger sur le DC lui-même — un second named sur sa propre adresse — ou sur un hôte séparé, et la configuration est presque identique dans les deux cas.
Le compromis est celui qu’il paraît : sur le DC c’est une machine de moins à faire tourner, tandis qu’un hôte séparé garde les clés privées hors de la boîte qui détient l’annuaire. Les deux sont défendables, et le choix ne change rien d’autre dans la pipeline. Ce qui compte est que la signature ait lieu une fois, à un point défini, sous une politique de clés — la différence entre du DNSSEC que vous exploitez et du DNSSEC qui expire à trois heures du matin.
3. Les serveurs autoritatifs — la seule chose que les clients voient. De simples secondaires de la zone signée. Ils ne détiennent aucune clé, ne font aucune signature, et n’ont aucun chemin vers l’annuaire. Si l’un est compromis, l’attaquant a une copie d’une zone et aucune capacité de forger un nouvel enregistrement qui validera.
4. Les résolveurs. Des résolveurs récursifs validants pour le parc, qui transitent conditionnellement les zones internes vers ces serveurs autoritatifs et parcourent l’arbre public pour tout le reste. C’est vers eux que pointe le resolv.conf des clients.
Deux propriétés découlent de cet arrangement et méritent d’être énoncées à part, parce qu’elles sont tout le propos :
- La machine qui détient l’annuaire n’est pas joignable par les machines qui l’utilisent. Un contrôleur de domaine est l’hôte de plus grande valeur du parc. Lui donner un service réseau face aux clients — un qui répond à de l’UDP non authentifié de n’importe quel poste — est un mauvais échange pour un service que d’autres machines peuvent rendre.
- La signature a lieu une fois, à un point défini. L’objection habituelle à signer une zone AD est le churn — que le contenu change trop souvent pour que les signatures suivent. Cette objection est en réalité une objection à la disposition par défaut, pas à la signature. Avec l’enregistrement des clients sorti, comme la section suivante soutient qu’il doit l’être, la zone AD change quand un contrôleur de domaine est promu ou rétrogradé et à peu près jamais autrement. Une zone écrite seulement par les DC est une zone stable, et une zone stable est une chose banale à signer. Garder les clients dehors n’est pas seulement un contrôle de sécurité ; c’est ce qui rend la zone assez tranquille pour être signée proprement.
Comment la signature est réellement câblée
La forme ci-dessus est la partie importante, mais « une zone BIND normale qui transfère les données en entrée » mérite d’être montrée plutôt que décrite, parce que la première tentative échoue d’habitude à vouloir signer le DLZ directement.
Sur le DC, le côté DLZ reste délibérément ennuyeux. Il sert l’annuaire, il remet la zone à exactement un pair, et il ne fait rien d’autre :
key "transfer-to-signer" {
    algorithm hmac-sha256;
    secret "...";
};

options {
    recursion no;
    allow-query { key transfer-to-signer; localhost; };
    allow-transfer { key transfer-to-signer; };
    notify no;
};

dlz "AD DNS Zone" {
    database "dlopen /usr/lib64/samba/bind9/dlz_bind9_18.so";
};
Notez que le .so porte la version majeure de BIND dans son nom. C’est le couplage de version de la section précédente rendu concret — une montée de version de BIND a besoin du module Samba correspondant en place avant que named ne démarre.
Côté signature, la zone est un secondaire ordinaire avec les options de signature attachées. C’est la partie qui ne peut pas vivre sur le DLZ :
dnssec-policy "ad-internal" {
    keys {
        ksk lifetime P365D algorithm ecdsa256;
        zsk lifetime P90D  algorithm ecdsa256;
    };
};

zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 key transfer-to-signer; };
    file "ad.example.com.axfr";
    inline-signing yes;
    dnssec-policy "ad-internal";
    allow-transfer { key transfer-to-public; };
    also-notify { 192.0.2.20; 192.0.2.21; };
};
Que ça marche sur un secondaire est le détail porteur, et l’ARM l’énonce directement :
If
yes, BIND 9 maintains a separate signed version of the zone. An unsigned zone is transferred in or loaded from disk and the signed version of the zone is served with, possibly, a different serial number.
Donc BIND garde deux copies — la non signée qu’il a reçue, écrite dans file, et la signée qu’il sert, écrite à côté avec une extension .signed. Un transfert arrive, la version signée est régénérée, et les serveurs en aval reçoivent un notify, parce qu’à ce stade c’est une zone entièrement ordinaire. inline-signing yes est en fait la valeur par défaut une fois qu’une dnssec-policy est attachée ; il est écrit ci-dessus parce qu’une config qui dit ce qu’elle fait vaut la ligne.
Le renouvellement des clés vient avec la politique plutôt qu’avec une tâche cron. Les rotations de ZSK ne demandent aucune intervention ; les rotations de KSK demandent que le nouveau DS arrive au parent, ce qui est l’automatisation CDS/CDNSKEY de plus loin dans ce billet. rndc dnssec -status ad.example.com vous dit où en est chaque clé dans sa durée de vie.
Que ce bloc tourne sur le DC ou sur son propre hôte est une question de quelle adresse primaries pointe. Sur le DC c’est une seconde instance named sur une seconde adresse, transférant depuis la première par le bouclage ou une interface d’administration. C’est ce que « BIND avec DLZ peut être le signeur » veut dire en pratique : même logiciel, même boîte si vous voulez, mais la signature a lieu sur la copie transférée plutôt que sur la zone DLZ.
Le seul accroc opérationnel est le notify — et il est du côté DLZ. Le manuel de l’ISC est franc : DLZ « has no built-in support for DNS notify » — n’a aucun support intégré du notify DNS, donc les serveurs secondaires ne sont pas automatiquement informés des changements des zones de la base. Samba peut changer un enregistrement dans l’annuaire et l’instance DLZ n’a aucune idée qu’elle devrait le dire à quiconque.
Donc le premier saut est un sondage, pas une poussée. Le signeur se rafraîchit sur le minuteur SOA de la zone qu’il transfère, ce qui veut dire :
- La propagation d’un changement du DC vers un enregistrement signé et publié est bornée par cet intervalle de rafraîchissement, pas par des secondes. Promouvez un DC et ses nouveaux enregistrements
_msdcsapparaissent en aval jusqu’à un rafraîchissement plus tard. - Cet intervalle est la molette à tourner si le délai compte. C’est un compromis avec la fréquence à laquelle vous voulez que le DLZ soit interrogé, ce qui amène l’autre chose que l’ISC dit de DLZ : il fait des recherches en base en temps réel sans cache et est « not recommended for use on high-volume servers » — non recommandé sur des serveurs à fort volume.
- Ces deux points sont des arguments pour cette topologie plutôt que contre. Le seul client que l’instance DLZ a jamais est le signeur, qui demande une fois par rafraîchissement. La charge de requêtes réelle du parc atterrit sur les serveurs autoritatifs autonomes, qui servent un fichier de zone signé ordinaire à pleine vitesse.
Tout en aval du signeur est conventionnel : les serveurs autoritatifs sont des secondaires de la zone signée, ils reçoivent un notify en règle, et ils ne touchent jamais à l’annuaire ni à une clé.
Les clients ne doivent pas écrire la zone qui porte les locators
C’est la plus importante, et c’est une règle de conception plutôt qu’un réglage.
Active Directory enregistre les enregistrements dynamiquement. Une machine se joint, et elle s’enregistre elle-même ; un DC démarre, et il enregistre les SRV qui annoncent ses services. « Sécurisée », la mise à jour dynamique veut dire que ces mises à jour sont authentifiées — la machine prouve qui elle prétend être avec ses propres identifiants, et il y a une ACL par enregistrement pour qu’une machine ne puisse généralement modifier qu’un enregistrement qu’elle a créé.
Lisez ça attentivement, parce que la garantie est plus étroite qu’il n’y paraît d’abord. La mise à jour dynamique sécurisée authentifie qui écrit. Elle n’évalue pas ce que l’enregistrement veut dire. Et l’ensemble des comptes habilités à écrire est bien plus large qu’on ne le suppose : dans une zone intégrée à AD par défaut, le groupe Utilisateurs authentifiés détient Créer tous les objets enfants sur le conteneur de zone dans l’annuaire, parce que l’ADIDNS stocke chaque enregistrement comme un objet AD sous CN=MicrosoftDNS,DC=DomainDnsZones. Pas seulement les comptes machine — n’importe quel compte authentifié du domaine, y compris celui de qui a ouvert la pièce jointe de la facture ce matin.
Ce qui produit deux modes de défaillance dans une zone qui détient à la fois les enregistrements des clients et les locators de service :
Les noms qui n’existent pas encore n’appartiennent à personne. Les ACL par enregistrement protègent un enregistrement qui a déjà un propriétaire. Un nom qui n’a jamais été enregistré n’a aucun objet sur lequel faire respecter une ACL, donc le premier compte à le créer l’obtient. C’est le mécanisme derrière toute la famille des attaques ADIDNS, la plus tranchante étant un joker : créez * et chaque nom de la zone que personne n’a explicitement revendiqué — fautes de frappe, hôtes déclassés, wpad — résout vers l’attaquant. Les enregistrements existants ne sont pas touchés, ce qui est justement pourquoi ça passe inaperçu.
Le périmètre d’impact inclut les locators. Les enregistrements sous _msdcs sont la façon dont chaque client du domaine trouve un contrôleur de domaine et un KDC. Ce sont les enregistrements les plus critiques pour la sécurité que vous possédiez, et dans un déploiement par défaut ils siègent dans la même zone que quatre cents portables écrivent chaque fois qu’ils obtiennent un bail DHCP.
Donc la règle : la zone qui porte les locators est écrite par les contrôleurs de domaine, et par rien d’autre. L’enregistrement dynamique des clients va ailleurs.
Ailleurs peut être l’une de deux choses, et les deux vont bien :
- Une sous-zone déléguée servie ailleurs. La zone AD détient une délégation
NSpour, disons,dyn.ad.example.com, et les enregistrements atterrissent sur un serveur séparé qui accepte les mises à jour. Les partitions de Samba ne prennent jamais aucune écriture de client. - Une zone séparée dans Samba avec sa propre ACL de mise à jour. Toujours dans l’annuaire, mais sa propre zone, si bien qu’une écriture de client n’a aucun chemin vers
_msdcsni vers les enregistrements propres d’un DC.
Le premier donne la séparation la plus dure ; le second est moins à faire tourner. Ce qui échoue à la règle n’est ni l’un ni l’autre. C’est le défaut, où les deux vivent ensemble. Ce qui est la façon dont la plupart des domaines tournent encore, parce que personne ne l’a choisie et personne n’est revenu regarder.
Et il y a un second dividende, celui qui rattache ça à la pipeline. Une zone que seuls les contrôleurs de domaine écrivent est une zone qui ne change presque jamais : une promotion de DC, une rétrogradation de DC, et sinon le silence. Tout le churn d’une zone AD par défaut est de l’enregistrement de client. Retirez-le et l’objection à signer les partitions AD s’en va avec — il n’y a pas de flux de mises à jour à poursuivre pour les signatures, donc la signer est routinier plutôt qu’un combat. La discipline d’écriture et la signature sont la même décision vue deux fois.
À côté de l’une ou l’autre, il y a une permission à aller regarder — et sur un DC Microsoft c’est le correctif direct. Parce que les enregistrements ADIDNS sont des objets d’annuaire, l’habilitation vient d’une ACL AD plutôt que de quoi que ce soit dans le protocole DNS : Utilisateurs authentifiés détenant Créer tous les objets enfants sur le conteneur de zone. Resserrer ça est l’atténuation la plus propre pour le problème du nom non revendiqué et du joker, et dans bien des parcs la permission peut être retirée purement et simplement une fois que vous savez ce qui a réellement besoin de s’auto-enregistrer. Le DNS AD de Samba stocke ses enregistrements dans l’annuaire de la même façon, donc la même question s’applique — allez voir ce que votre conteneur de zone accorde réellement.
Mais attendez — les clients devraient-ils même s’enregistrer en 2026 ?
Tout ce qui précède suppose que la mise à jour dynamique des clients est une chose dont vous avez besoin et que vous essayez de rendre sûre. Avant d’accepter ça, il vaut la peine de poser la question que personne ne pose, parce que la réponse a changé depuis que ce comportement a été conçu.
L’enregistrement DNS dynamique a été bâti pour un poste de bureau. Une boîte sous un bureau, un câble réseau, une adresse qu’elle gardait des années. Dans ce monde-là, une machine qui enregistrait son propre nom était propre et globalement vraie.
Regardez maintenant ce qu’est un client en 2026. Il se réveille sur le wifi de la maison. Il arrive au bureau et rejoint le sans-fil de l’entreprise. Il entre dans une station d’accueil et prend une adresse filaire en plus. Quelqu’un démarre le VPN et un adaptateur de tunnel apparaît avec une troisième adresse. Il va au café, se connecte par un téléphone, et le VPN revient sur une quatrième. C’est une machine, un nom, et une demi-douzaine d’adresses dans une journée de travail — et par défaut elle va essayer d’en enregistrer un bon nombre.
Donc la zone se remplit de revendications qui étaient vraies une fois.
- Windows enregistre chaque adaptateur qu’il a, à moins que quelqu’un ne soit passé décocher Enregistrer les adresses de cette connexion dans DNS par interface. Un portable en station d’accueil sur le VPN est une machine avec trois adaptateurs actifs et un avis sur tous.
- Plusieurs enregistrements A pour un nom n’est pas un état d’erreur, c’est le résultat normal. Une recherche les renvoie tous, les clients les essaient dans l’ordre qui leur chante, et les connexions à ce nom échouent en proportion du nombre d’adresses mortes. C’est le mécanisme derrière « le support à distance voit la machine une minute et plus la suivante ».
- Les adresses VPN sont les pires, parce qu’une adresse de tunnel est valide une heure et que l’enregistrement survit à l’adresse. Le tunnel tombe, l’adresse du pool va à quelqu’un d’autre, et le nom pointe maintenant vers un collègue.
- Les stations d’accueil brouillent l’identité elle-même. Sauf si le passthrough d’adresse MAC est configuré, le bail appartient à la station plutôt qu’au portable, si bien qu’un parc en bureaux partagés a des noms, des baux et des machines qui dérivent les uns des autres chaque jour.
- Et la propriété rend ça permanent. Un enregistrement ne peut être mis à jour que par le compte qui l’a créé. Quand un enregistrement a été fait par DHCP sous un identifiant et que la machine essaie plus tard de le mettre à jour sous le sien, la mise à jour échoue, en silence, et l’adresse périmée reste exactement où elle est.
L’histoire du nettoyage n’est pas non plus le sauvetage qu’elle semble. Samba a le nettoyage depuis la 4.9, mais il est coupé par défaut (dns zone scavenging = yes, avec samba-tool dns zoneoptions --aging=1), et Samba lui-même dit qu’il « should only be enabled on new zones or new installations » — ne devrait être activé que sur des zones neuves ou des installations neuves, parce que les versions plus anciennes marquaient les enregistrements dynamiques comme statiques et les statiques comme dynamiques. Sur les parcs les plus susceptibles d’être pleins de déchets — ceux qui tournent depuis des années — l’outil pour les nettoyer est celui qu’on vous conseille de ne pas activer. Il a aussi eu sa propre CVE.
Alors posez la question directement : qu’est-ce qui consomme réellement l’enregistrement A d’un portable ?
Dans la plupart des maisons, très peu. Les utilisateurs se connectent à des serveurs ; les serveurs ne se connectent pas à des portables. Les vrais consommateurs sont les outils de support à distance, le RDP vers un poste nommé, et l’inventaire ou la supervision — et presque tout cet outillage maintient son propre inventaire et travaille à partir d’un agent qui se signale, parce qu’il n’a jamais pu compter sur le DNS pour des clients mobiles au départ.
Ce qui suggère d’inverser le défaut :
- Les serveurs et l’infrastructure obtiennent leurs enregistrements du provisionnement. Avec NetBox et Ansible déjà dans le tableau, l’enregistrement est créé par la même chose qui a créé la machine, il est correct par construction, et il est retiré quand la machine l’est.
- Le parc filaire stable peut prendre des enregistrements de DHCP si quelque chose en a réellement besoin, avec un seul identifiant qui les possède pour que les mises à jour n’échouent pas.
- Les clients mobiles n’enregistrent rien du tout. Ils sont consommateurs de DNS, pas éditeurs. Si quelque chose a besoin d’atteindre un portable, il lui faut un agent, pas un enregistrement A.
Vous finissez au même endroit que l’argument de sécurité vous a mis, depuis une direction complètement différente. Moins de rédacteurs veut dire une surface ADIDNS plus petite, une zone qui n’est pas pleine de revendications expirées, et — retour à la pipeline — une zone assez tranquille pour être signée sans y penser.
L’argument de sécurité dit que les clients ne doivent pas écrire la zone qui porte les locators. L’argument opérationnel demande pourquoi ils écrivent du DNS tout court. En 2026, pour une flotte qui change d’adresse cinq fois par jour, « ils ne le font pas » est une réponse parfaitement bonne, et considérablement moins de travail que de rendre leur bazar sûr.
Vues séparées, et d’où vient la confiance
La dernière pièce noue les deux moitiés du billet ensemble.
Il y a deux vues de l’espace de noms. Une zone publique, publiée sur l’internet, détenant la poignée de noms dont le monde a besoin. Et une vue interne — le contenu dérivé d’AD, chaque hôte joint, chaque locator de service, la topologie des sites — que le monde n’a aucune raison de voir. Ce contenu est une carte du parc, et il devrait être injoignable et intransférable depuis l’extérieur.
Mais la confiance pour la vue interne vient du côté public, et c’est ce qui rend cette conception meilleure que l’île de DNS interne habituelle :
example.comest public et signé, avec sonDSdans le parent et une chaîne jusqu’à la racine.ad.example.comen est délégué. Le parent public publie la délégation et unDSpour la clé de la zone interne.- Les serveurs autoritatifs internes servent le
ad.example.comsigné. Les résolveurs internes le valident — racine →com→example.com→ad.example.com— en n’utilisant rien d’autre que le point d’ancrage de confiance de la racine qu’ils avaient déjà.
Pas de point d’ancrage de confiance local. Pas d’île. Pas de clé distribuée à la main. Les données ne quittent jamais le bâtiment, et le chemin de validation est le chemin public ordinaire. Quand vous ajoutez un résolveur, il valide les noms internes correctement sans aucune configuration DNSSEC.
Soyons droits sur le compromis, parce qu’il y en a un. Publier une délégation et un DS dans la zone publique veut dire que l’existence de ad.example.com, et les noms de ses serveurs de noms, sont publics. Le contenu ne l’est pas, et ne l’est jamais — mais vous avez dit au monde que la zone existe. En échange, chaque résolveur que vous possédez valide les noms internes contre la vraie racine. C’est un bon échange pour la plupart des parcs, et il devrait être délibéré plutôt qu’une surprise.
Deux choses à bien faire à côté :
- Gardez la vue interne inénumérable et intransférable.
allow-transfersur les serveurs autoritatifs internes est pour le signeur et vos propres secondaires, rien d’autre. Et gardez à l’esprit que le déni authentifiéNSEClaisse quiconque peut interroger la zone la parcourir de bout en bout ;NSEC3en relève le coût, mais le vrai contrôle est que les gens de l’extérieur ne peuvent pas atteindre les serveurs du tout. - Automatisez le
DS. UnDSdans le parent qui cesse de correspondre à la clé de l’enfant emmène tout le domaine interne enSERVFAIL.CDS/CDNSKEYexistent pour que l’enfant puisse signaler un changement de clé et que le parent puisse le reprendre sans qu’un humain édite un enregistrement pendant une rotation. Si la zone parente est chez un registraire ou un fournisseur qui le supporte, utilisez-le ; sinon, la procédure de rotation a besoin d’être écrite avant la première rotation, pas pendant.
Faire valider réellement Windows et Linux
Tout jusqu’ici a porté sur la publication d’une zone qui peut être vérifiée. Rien de tout ça ne fait quoi que ce soit tant que quelque chose côté client n’insiste pas pour la vérifier. Une zone parfaitement signée et un client qui ne vérifie jamais une signature produisent exactement la même expérience qu’une zone non signée, jusqu’au jour où non.
Il n’y a que deux endroits où la validation peut avoir lieu, et la différence entre eux est la différence entre un contrôle de sécurité et une suggestion polie.
Valider au résolveur, et faire confiance au bit AD. Le client demande à un résolveur, le résolveur fait la cryptographie, et il rapporte le résultat en posant un bit — AD, données authentifiées — dans la réponse. Le client croit le bit. C’est le modèle qu’utilise Windows, et il n’est aussi fort que le chemin entre le client et le résolveur, parce que tout ce qui peut répondre comme le résolveur peut poser ce bit.
Valider sur le client lui-même. La machine fait tourner son propre résolveur validant, si bien que le « chemin vers le résolveur » est un socket de bouclage à l’intérieur de la machine et qu’il n’y a plus rien à usurper. C’est plus fort, et sur Linux c’est entièrement réalisable.
Le défaut, c’est rien
Avant de configurer quoi que ce soit, il vaut la peine de voir ce qu’un poste Linux courant fait à la sortie de la boîte. Voici une machine Fedora 44, systemd 259, intacte :
$ resolvectl status | head -3
Global
         Protocols: LLMNR=resolve -mDNS -DNSOverTLS DNSSEC=no/unsupported
  resolv.conf mode: stub

$ grep options /etc/resolv.conf
options edns0 trust-ad

$ dig +dnssec cloudflare.com A | grep flags
;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
Lisez ces trois ensemble, parce qu’ils racontent une petite histoire.
Le stub est configuré avec trust-ad — on lui a dit de croire le bit AD. systemd-resolved rapporte DNSSEC=no/unsupported, donc il ne valide rien lui-même. Et la réponse pour une zone signée revient avec les drapeaux qr rd ra et pas de ad — rien nulle part dans ce chemin n’a prétendu avoir validé.
Ce n’est pas une mauvaise configuration. C’est le défaut. On peut dire à un client de faire confiance à une assertion que rien dans la chaîne ne fait. Rien ne la vérifie. À méditer une minute avant de configurer quoi que ce soit d’autre.
Linux
Trois options, par ordre croissant du peu que vous avez à faire confiance au réseau.
1. systemd-resolved, validant localement. Un drop-in plutôt que d’éditer le fichier livré :
# /etc/systemd/resolved.conf.d/dnssec.conf
[Resolve]
DNSSEC=yes
DNSOverTLS=opportunistic
Puis systemctl restart systemd-resolved et confirmez avec resolvectl status que la ligne lit maintenant DNSSEC=yes.
Le réglage sur lequel être prudent est celui du milieu. DNSSEC=allow-downgrade a l’air d’un compromis sensé et n’est pas un contrôle de sécurité — resolved.conf(5) le dit lui-même :
Note that this mode makes DNSSEC validation vulnerable to “downgrade” attacks, where an attacker might be able to trigger a downgrade to non-DNSSEC mode by synthesizing a DNS response that suggests DNSSEC was not supported.
Un attaquant qui peut forger des réponses est exactement l’attaquant que DNSSEC existe pour arrêter, donc un mode qu’il peut couper en forgeant une réponse ne vous achète rien contre lui. C’est yes ou c’est de la décoration.
2. Un vrai résolveur validant sur l’hôte. Le validateur de systemd-resolved est commode plutôt que rigoureux. Là où ça compte, faites tourner Unbound ou BIND sur le bouclage et pointez le stub vers lui :
# unbound: validate against the root anchor, refuse to be stripped
server:
    module-config: "validator iterator"
    auto-trust-anchor-file: "/var/lib/unbound/root.key"
    harden-dnssec-stripped: yes
    val-permissive-mode: no

# the internal zone is reached like any other name — no local anchor needed
forward-zone:
    name: "ad.example.com."
    forward-addr: 192.0.2.53
L’équivalent BIND est une ligne — dnssec-validation auto; — qui utilise sa copie intégrée du point d’ancrage de la racine et gère la rotation pour vous.
3. À l’échelle du parc, sur les résolveurs que vous faites déjà tourner. Ce sont l’étape quatre de la pipeline plus haut dans ce billet. La validation a lieu là, les clients font confiance au bit AD, et le saut entre eux est la chose que vous devez protéger — avec DoT, ou avec un réseau au sujet duquel vous êtes prêt à faire cette hypothèse.
Et notez ce qui n’est pas dans aucune de ces configurations : un point d’ancrage de confiance pour la zone interne. Parce que ad.example.com est une délégation à l’intérieur d’une zone publiquement signée, chacune de celles-ci valide les noms internes par la chaîne ordinaire depuis la racine. C’est la conception de la section précédente qui se rembourse. L’alternative est de pousser un point d’ancrage local vers chaque client et résolveur du parc, et de le re-pousser à chaque rotation.
Windows
L’important d’abord, parce que c’est régulièrement mal compris : le client DNS de Windows ne valide pas DNSSEC. Il ne fait aucune cryptographie, ne vérifie aucune signature, et ne détient aucun point d’ancrage de confiance. C’est un résolveur stub, et il l’a toujours été.
Ce que vous pouvez faire est le forcer à refuser les réponses qui n’ont pas été validées par le serveur en son nom. C’est la Name Resolution Policy Table, et elle est par espace de noms plutôt que globale :
# Require validated answers for the internal zone
Add-DnsClientNrptRule -Namespace ".ad.example.com" `
    -DnsSecEnable -DnsSecValidationRequired

# What is actually in force on this machine, including from Group Policy
Get-DnsClientNrptPolicy -Effective
Get-DnsClientNrptRule
Pour le parc, la même chose vit dans la stratégie de groupe sous Configuration ordinateur → Stratégies → Paramètres Windows → Stratégie de résolution de noms : créez une règle pour l’espace de noms, cochez l’option DNSSEC, et cochez l’exigence que le client vérifie que les données ont été validées par le serveur DNS.
Deux choses en découlent, et les deux comptent.
Quelque chose en amont doit encore faire la validation. La règle NRPT fait que le client exige le bit AD ; elle n’en crée pas. Le résolveur vers lequel ces clients pointent doit être un résolveur validant, sinon chaque nom de cet espace de noms échoue.
Et c’est pourquoi la règle NRPT a des options IPsec à côté d’elle. Microsoft les a mises là pour la raison exposée en haut de cette section : exiger un bit que n’importe quel attaquant sur le chemin peut poser n’est pas une bien grande exigence. Si vous vous reposez sur le modèle résolveur-valide sur un réseau non fiable, le dernier saut a besoin d’être protégé — IPsec entre client et résolveur, ou DoT là où le résolveur le supporte.
Ça échoue fermé, alors déployez-le dans cet ordre
Forcer la validation convertit une classe de compromission silencieuse en une classe de panne bruyante. C’est le bon compromis, et c’est quand même une panne : un RRSIG expiré, un DS dans le parent qui ne correspond plus après une rotation, ou un résolveur qui ne peut pas atteindre la zone parente produisent tous un SERVFAIL, et un SERVFAIL pour _ldap._tcp.dc._msdcs veut dire que le domaine est en panne plutôt que dégradé.
Alors faites-le dans cet ordre :
- Activez la validation sur les résolveurs d’abord, et laissez les clients tranquilles. Guettez les
SERVFAILdans les journaux des résolveurs pendant quelques semaines — c’est là que vous trouvez la zone qui est cassée en silence depuis un an. - Automatisez le
DSavant de forcer quoi que ce soit, comme dans la section précédente. La plupart des pannes DNSSEC auto-infligées sont une rotation où le parent n’a jamais été mis à jour. - Puis forcez les clients, un espace de noms à la fois, en commençant par votre propre poste et une OU de test plutôt que tout le parc.
La défaillance contre laquelle vous vous protégez est un client à qui on remet un contrôleur de domaine forgé. La défaillance que vous risquez est un client à qui on ne remet rien du tout. La seconde est récupérable et évidente ; la première n’est ni l’une ni l’autre. Vous entendrez parler de la panne en une minute. Vous n’auriez jamais entendu parler de l’autre du tout.
Chiffrer le dernier saut : DoT et DoH sur les résolveurs internes
La section validation a laissé une chose en suspens. Dans le modèle résolveur-valide — celui que Windows vous donne — le client fait confiance à un seul bit posé par le résolveur, et ce bit ne vaut que le chemin qu’il a parcouru. Quelque chose doit protéger ce chemin.
BIND supporte bien les deux transports chiffrés nativement, donc c’est un travail de configuration plutôt que d’achat :
- DNS over TLS — un bloc
tlsréférencé depuislisten-on, conventionnellement sur le port 853. - DNS over HTTPS — le même bloc
tlsplus un blochttp, sur le 443. - DoT sortant, parce que
forwardersprend un transport TLS par adresse ou pour toute la liste. - Transferts de zone sur TLS, parce que l’instruction
primariesd’une zonetype secondaryen prend un aussi — ce qui est directement utile à la pipeline plus haut dans ce billet.
D’abord, soyez clair sur ce que ça achète, parce que DoT et DNSSEC sont confondus sans cesse et ne sont pas des alternatives. DNSSEC authentifie les données, jusqu’à la zone qui les a publiées. DoT protège la conversation avec le résolveur. L’un survit à un résolveur hostile et à un réseau hostile entre résolveurs ; l’autre empêche la machine sur votre wifi de lire et de réécrire ce que votre portable a demandé. Vous voulez les deux, et aucun ne remplace l’autre. Chiffrer le saut vers un résolveur qui ne valide pas est une conversation privée avec quelque chose à qui on peut encore mentir.
Le servir
tls internal-resolver {
    key-file "/etc/pki/dns/resolver.key";
    cert-file "/etc/pki/dns/resolver.pem";
    protocols { TLSv1.3; };
};

http internal-doh {
    endpoints { "/dns-query"; };
};

options {
    dnssec-validation auto;

    listen-on          port  53                          { 192.0.2.53; };
    listen-on          port 853 tls internal-resolver    { 192.0.2.53; };
    listen-on          port 443 tls internal-resolver
                                 http internal-doh       { 192.0.2.53; };
    listen-on-v6       port 853 tls internal-resolver    { 2001:db8::53; };
};
Le certificat est le vrai travail, et c’est la partie qu’on saute. Un client qui vérifie — ce qui est tout le propos — a besoin d’un certificat valide pour le nom avec lequel il a été configuré, émis par quelque chose auquel il fait déjà confiance. Ça veut dire votre CA interne et votre automatisation de certificats existante, pas le mot-clé ephemeral. ephemeral génère un certificat auto-signé jetable ; il est là pour que vous puissiez prouver que l’écouteur marche, et il est sans valeur pour tout client qui vérifie vraiment.
Le transiter par-dessus
Si ces résolveurs transitent quelque part plutôt que de parcourir l’arbre eux-mêmes, le saut amont peut être chiffré lui aussi — et il y a ici une distinction à bien faire :
tls upstream {
    ca-file "/etc/pki/tls/certs/ca-bundle.crt";
    remote-hostname "dns.example.net";
};

options {
    forwarders port 853 tls upstream { 192.0.2.1; };
};
Sans remote-hostname, vous obtenez du chiffrement sans authentification : le trafic est illisible pour un observateur passif, et un attaquant actif qui peut intercepter la connexion présente simplement son propre certificat. Avec remote-hostname et ca-file, BIND vérifie à qui il parle. Le premier vaut quelque chose. Seul le second vaut d’être appelé un contrôle.
La moitié client n’est pas symétrique
C’est là qu’un parc mixte devient délicat, et c’est la raison de configurer les deux transports plutôt que d’en choisir un.
Linux fait le DoT correctement. systemd-resolved prend DNSOverTLS=yes pour le mode strict, et on peut donner au serveur le nom à vérifier :
[Resolve]
DNS=192.0.2.53#resolver.ad.example.com
DNSOverTLS=yes
DNSSEC=yes
Comme pour DNSSEC=, le réglage du milieu est le piège : DNSOverTLS=opportunistic se rabat sur le clair quand le TLS est indisponible, ce qu’un attaquant capable d’interférer avec la connexion peut arranger.
Windows fait le DoH, et pas le DoT. Le support client DoH est arrivé dans Windows 11 et Server 2022, configuré par serveur avec un modèle :
$doh = "https://resolver.ad.example.com/dns-query"
netsh dnsclient add encryption server=192.0.2.53 dohtemplate=$doh
Le DoT, au moment où j’écris, n’est apparu que dans des builds Insider. Donc sur un Windows publié l’option chiffrée est le DoH ou rien, ce qui est justement pourquoi la section NRPT plus haut s’est tournée vers IPsec.
D’où le service des deux depuis la même instance BIND. DoT pour la flotte Linux et tout ce qui le parle, DoH pour Windows, un résolveur, un certificat.
Lequel, où
Pour un résolveur interne, le DoT est le meilleur transport et le DoH est la réponse de compatibilité.
Le DoT est sur son propre port. Vous pouvez le voir, l’autoriser, le refuser, et alerter sur tout ce qui fait du DNS sans le faire ainsi. L’avantage du DoH — indiscernable du trafic web ordinaire sur le 443 — est un vrai bénéfice sur un réseau hostile et une nuisance sur le vôtre, où pouvoir dire ce qui est du DNS est une fonction que vous avez payée. Sur le parc que vous contrôlez, préférez le transport que vous pouvez observer, et faites tourner le DoH parce que Windows ne vous laisse pas le choix plutôt que parce qu’il est meilleur.
Tant que vous y êtes : chiffrez les transferts
La pipeline plus haut dans ce billet déplace la zone AD par AXFR, et la section vues séparées a fait le point que son contenu est une carte du parc. TSIG authentifie ces transferts ; il ne les cache pas. Puisque l’instruction primaries d’un secondaire accepte une configuration TLS, le transfert peut tourner sur TLS lui aussi — RFC 9103 si vous voulez la norme :
zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 port 853 tls xfr-tls key transfer-to-signer; };
    ...
};
Authentifié par la clé, chiffré par le transport. Si un saut de cette pipeline traverse un lien de site, un hyperviseur que vous partagez, ou quoi que ce soit sur quoi vous ne poseriez pas volontiers un hub, ça vaut les vingt minutes.
Ce que ça ne corrige pas
- Ce n’est pas de la validation. Couvert plus haut, et à répéter parce que les éditeurs vendent du « DNS sécurisé » en voulant dire le chiffrement seul.
- Ça ne cache rien au résolveur. Le résolveur voit chaque requête en entier. Le chiffrement protège le chemin, pas la confidentialité de la recherche vis-à-vis de l’exploitant — ce qui va bien quand l’exploitant, c’est vous.
- Ça ne fait rien pour un client qui ne vérifie pas le certificat, et les modes opportunistes sont rétrogradables par exactement l’attaquant qui vous inquiète.
- Et ce n’est pas une raison de poser un écouteur sur le contrôleur de domaine. Du DNS chiffré sur le DC résoudrait le mauvais problème magnifiquement. Le DC ne répond toujours à personne.
Comment vérifier ce que vous avez
Des commandes à lancer contre votre propre parc. Les sorties sont la partie intéressante, et une ou deux tendent à être une lecture inconfortable la première fois.
# Walk the tree yourself, one delegation at a time
dig +trace dc01.ad.example.com

# Validate, and show the chain being built
delv +rtrace +vtrace ad.example.com SOA

# Is the resolver you are pointed at actually validating?
# A deliberately broken test name must come back SERVFAIL, not an address
dig @<resolver> dnssec-failed.org A

# What does the estate advertise as a domain controller?
dig SRV _ldap._tcp.dc._msdcs.<domain>
dig SRV _kerberos._udp.<domain>

# Is a DC answering for names it has no business answering?
# Ask it for something it is not authoritative for. "recursion requested
# but not available" is the answer you want. An actual address means it is
# serving the estate — recursing if it is BIND, relaying to the forwarder
# if it is SAMBA_INTERNAL. Either way it should not be doing that.
dig @<dc> www.example.org A

# Is the DC configured as the estate's DNS relay?
grep -E 'dns forwarder|server services' /etc/samba/smb.conf

# Will a DC hand its zone to anybody who asks?
dig @<dc> AXFR ad.example.com

# Which backend is this DC running, and does named have the module?
grep -r dlz /etc/named.conf /var/lib/samba/bind-dns/ 2>/dev/null
samba-tool dns query <dc> <domain> @ ALL

# Is the internal zone chained to the public parent?
dig DS ad.example.com @<public-authoritative-for-example.com>

# What does the local stub actually do with the AD bit, and is the
# hop to the resolver encrypted?
resolvectl status                    # DNSSEC= and DNSOverTLS= per link
grep options /etc/resolv.conf        # trust-ad, trusting whom exactly?

# Did anything in the path claim to have validated? Look for "ad" in the flags
dig +dnssec ad.example.com SOA | grep flags

# Validate independently of whatever the local resolver believes
delv ad.example.com SOA              # "fully validated" is the line you want

# Is the resolver actually listening for DoT, and does its certificate
# match the name clients are configured with?
kdig +tls @192.0.2.53 ad.example.com SOA
openssl s_client -connect 192.0.2.53:853 \
    -servername resolver.ad.example.com </dev/null 2>/dev/null \
    | openssl x509 -noout -subject -dates
Et sur un client Windows, pour voir s’il exige quoi que ce soit :
Get-DnsClientNrptPolicy -Effective    # the rules actually in force
Resolve-DnsName ad.example.com -DnssecOk
Get-DnsClientDohServerAddress         # is the hop to the resolver encrypted?
Les deux qui produisent le plus souvent une surprise sont la vérification de récursion et la tentative d’AXFR. Si un DC répond à l’une ou l’autre pour un client arbitraire, la pipeline de ce billet n’est pas en place, quoi que dise le diagramme sur le wiki.
La troisième est resolvectl status sur une machine que personne n’a touchée. DNSSEC=no/unsupported à côté de trust-ad dans resolv.conf est l’état normal d’un poste Linux, et ça veut dire que le travail de signature décrit ci-dessus est actuellement vérifié par personne.
La version courte
Un résolveur naît en connaissant les serveurs racine et une clé, et apprend tout le reste en se faisant dire. Les noms sont trouvés en descendant des délégations, et les services sont trouvés en demandant un enregistrement SRV — donc au moment où un client se met à faire du Kerberos avec un contrôleur de domaine, l’identité de ce contrôleur de domaine est venue d’une réponse DNS. La découverte par DNS est correcte et va bien. L’autorisation par DNS ne l’est pas, et une quantité surprenante d’infrastructure le fait discrètement quand même.
DNSSEC est ce qui rend ces réponses vérifiables : des signatures sur chaque ensemble, un DS dans chaque parent, une chaîne jusqu’à un seul point d’ancrage de confiance à la racine, et un déni authentifié pour qu’un nom ne puisse pas être fait disparaître. Il achète l’authentification d’origine et l’intégrité — pas la confidentialité, et pas la justesse. Il signe tout ce que la zone dit, ce qui est pourquoi il ne peut pas sauver une zone que des machines non fiables ont le droit d’écrire. Et il a besoin d’un parent : une TLD interne inventée n’a nulle part où mettre un DS, donc .local, .lan, .internal et home.arpa vous laissent tous soit non signés soit à faire tourner une île privée de clés distribuées à la main.
Pour un domaine Active Directory, ça produit une conception plutôt qu’une liste de réglages. Utilisez une délégation à l’intérieur d’une zone publique que vous possédez, pour que la confiance descende par la chaîne ordinaire depuis la racine pendant que les données ne quittent jamais le bâtiment. Servez les partitions AD avec BIND et dlz_bind9 — DLZ n’est pas le risque, c’est ainsi que vous sortez la zone de l’annuaire — et laissez le DC être un primaire caché qui transfère vers l’extérieur et ne répond à personne d’autre. Une zone DLZ ne peut pas être signée elle-même, donc la signature est une zone secondaire normale qui détient la copie transférée, avec inline-signing et une dnssec-policy dessus : un second named sur le DC si vous voulez moins de machines, un hôte séparé si vous voulez les clés privées hors de l’annuaire. Dans les deux cas elle est signée une fois, à un point défini, sous une politique de clés — et le premier saut est un sondage plutôt qu’une poussée, parce que DLZ ne peut pas envoyer de notify. Publiez depuis des serveurs autoritatifs autonomes qui ne détiennent aucune clé et n’ont aucune route vers l’annuaire.
Et gardez les clients hors de la zone qui compte. La mise à jour dynamique sécurisée authentifie le rédacteur, pas le sens, et dans une zone intégrée à AD par défaut les rédacteurs sont les Utilisateurs authentifiés — chaque compte, pas seulement chaque machine — donc une zone qui détient à la fois les enregistrements des portables et les locators _msdcs est à un utilisateur hameçonné d’un client à qui on dit, avec une signature parfaitement valide, que le contrôleur de domaine est ailleurs. Les enregistrements des clients appartiennent à une sous-zone, déléguée vers l’extérieur ou séparée dans Samba, où le pire qu’un compte compromis puisse faire est de mentir sur lui-même.
Bien que la meilleure question soit de savoir si les clients devraient s’enregistrer tout court. Un portable de 2026 a une adresse sur le wifi de la maison, une autre sur le sans-fil du bureau, une autre par la station d’accueil et une autre sur le VPN, et il publiera joyeusement la plupart d’entre elles. Ce qui consomme l’enregistrement A d’un portable n’est presque rien — les outils qui ont besoin d’atteindre un poste gardent leur propre inventaire, parce que le DNS n’a de toute façon jamais été fiable pour les clients mobiles. Les enregistrements des serveurs devraient venir du provisionnement, et la flotte ne devrait rien enregistrer.
Puis faites en sorte que quelque chose vérifie les signatures, parce que rien de ce qui précède ne vaut quoi que ce soit tant qu’un client ne refuse pas une réponse. Sur Linux ça veut dire DNSSEC=yes dans systemd-resolved, ou un vrai résolveur validant sur le bouclage — jamais allow-downgrade, qu’un attaquant capable de forger des réponses peut simplement couper en forgeant une réponse. Sur Windows ça veut dire accepter que le client DNS ne valide jamais rien lui-même, et utiliser une règle NRPT pour le faire exiger une réponse que le résolveur a validée, avec le dernier saut protégé parce que cette exigence est un seul bit. Activez-le sur les résolveurs d’abord et guettez les SERVFAIL, automatisez le DS, puis forcez les clients. Ça échoue fermé, ce qui est le bon sens et quand même une panne.
Rien de tout ça n’est exotique. C’est de la délégation, du transfert et de la signature — les trois choses que le DNS a toujours faites — arrangées pour que la machine qui détient votre annuaire ne soit pas la machine qui prend les questions du parking, et pour que quand quelque chose ment bien à un client, le client le remarque.