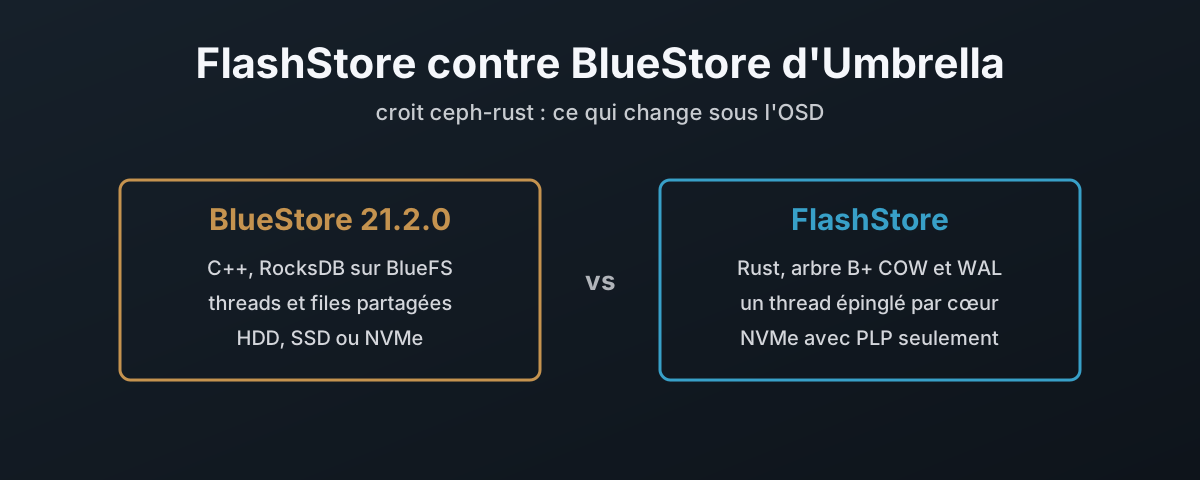
Je le dis d’emblée : je travaille pour croit, qui a écrit ceci. Tout ce qui suit est lu dans le code source et la documentation publiés des deux projets, liés en bas de page, et là où la documentation de croit contredit le code de croit, je le dis.
L’OSD de Ceph, réécrit de zéro
croit a publié ceph-rust, un OSD Ceph écrit à partir de rien en Rust, avec un magasin d’objets à lui, FlashStore, à la place de BlueStore1.
Il est passé en préversion publique le 9 novembre 2026, et la disponibilité générale est prévue pour le premier trimestre 20271.
Ce n’est pas un fork.
La règle du projet, c’est que le C++ de Ceph est lu comme référence, rédigé sous forme de spécification dans les propres mots de croit, puis implémenté à partir de la spécification2.
La promesse qui compte pour quiconque exploite Ceph, c’est celle du remplacement à chaud.
Vos moniteurs, vos gestionnaires, la CLI ceph et vos clients restent tels quels.
Un OSD FlashStore rejoint les mêmes pools et les mêmes placement groups que les OSD classiques déjà présents, et vous changez un disque à la fois1.
La question, pour un exploitant, est donc pratique. Si vous remplacez un OSD BlueStore par un OSD FlashStore, qu’est-ce qui change en dessous ? Pas dans l’abstrait, et pas face à un BlueStore vu dans une conférence il y a des années. Face au BlueStore que vous faites réellement tourner aujourd’hui si vous êtes sur Umbrella, Ceph 21.2.0, la version contre laquelle FlashStore est compilé et testé1.
C’est donc la comparaison menée ici, et rien d’autre. Le BlueStore d’Umbrella tel que le décrivent son code et sa documentation, face à FlashStore tel que le décrivent son code et ses registres de décisions.
Elle concerne tous ceux qui ont des clusters Ceph en NVMe, et tous ceux qui ont regardé ce qu’un OSD leur coûte en cœurs. Elle ne concerne pas du tout les clusters sur HDD, et la raison viendra plus bas.
Ce que contient le dépôt
Le dépôt est un instantané en lecture seule de l’arbre de développement privé de croit. Pas de suivi de tickets, pas de pull requests ; les mises à jour arrivent sous forme de nouveaux commits d’instantané1. C’est la phase de préversion, qui sert à recueillir les retours de la communauté pendant que croit fait passer en interne ses scénarios de test de production avant de le déclarer sûr pour l’usage. Le développement s’ouvre après la première version de production, comme pour la plupart des projets open source soutenus par une entreprise. Celui-ci est daté du 10 novembre 2026 et contient environ 700 000 lignes de Rust et plus de 450 architecture decision records, les ADR, ces courts documents qui consignent pourquoi chaque choix de conception a été fait.
Les ADR sont la partie utile pour une comparaison comme celle-ci. Ils sont francs, ils contiennent des mesures, et ils consignent ce qui a été essayé puis jeté autant que ce qui est resté.
| Composant | Ce qu’il remplace | Préversion | GA (prévue) |
|---|---|---|---|
| OSD FlashStore | ceph-osd + BlueStore | nov. 2026 | T1 2027 |
| librustyrados | librados | nov. 2026 | T1 2027 |
| librustyrbd | librbd | nov. 2026 | T1 2027 |
| Transport RDMA (RoCEv2) | rien dans Umbrella | nov. 2026 | T1 2027 |
| CephFS2, RGW en Rust | MDS, RGW | T1 2027 | T2 2027 |
| ceph-mon, ceph-mgr | non remplacés | s.o. | s.o. |
Les licences valent d’être connues avant de bâtir quoi que ce soit dessus. Le démon et les outils sont en LGPL-3.0-only, les bibliothèques clientes en MPL-2.0, et la documentation en CC-BY-SA-4.03. Les bibliothèques clientes sont passées en MPL pour qu’un programme Rust puisse les lier statiquement sans les obligations de réédition de liens qu’apporte la LGPL, ce qui est un choix raisonné et consigné comme tel3.
Préversion veut dire ce que cela veut dire. Le README de croit lui-même dit qu’il sert aux tests et à l’évaluation et qu’il est « not yet recommended for production data »1. Je n’y mettrais pas non plus de données client pour l’instant, et rien dans le reste de cet article ne change cela.
Deux magasins, côte à côte
Un OSD a deux moitiés. La moitié haute parle le protocole Ceph, possède les placement groups, fait le peering, la récupération et le scrub. La moitié basse, le magasin d’objets, transforme « écris ces octets dans cet objet » en blocs sur un disque et promet qu’ils survivront à une coupure de courant.
BlueStore est la moitié basse d’Umbrella. Sa documentation dit qu’il « reads and writes to the devices directly in a ‘raw’ fashion »4, et qu’il consomme des « raw block devices or partitions »5. Les données des objets vont droit au périphérique bloc. Tout le reste, les métadonnées des objets, l’OMAP et sa propre comptabilité, va dans une base clé/valeur RocksDB embarquée, et RocksDB repose sur BlueFS, un petit système de fichiers que BlueStore transporte pour elle56.
FlashStore laisse tomber tout cela. Un arbre B+ en copie sur écriture par shard de magasin contient l’ensemble : collections, métadonnées des objets, attributs étendus, cartes d’extents, OMAP, le journal des PG, les compteurs de références et même le bitmap de l’allocateur lui-même7. À côté se trouvent un anneau de journal d’écriture anticipée de type redo et la zone de données. Il n’y a pas de RocksDB, pas de BlueFS, et pas de seconde base de données à régler.
L’autre grande séparation, c’est le disque lui-même. BlueStore passe par la couche bloc du noyau vers tout ce que vous lui donnez. FlashStore parle au NVMe soit avec SPDK, un pilote en espace utilisateur qui retire le périphérique au noyau via vfio, soit à travers le noyau avec io_uring89. SPDK est le backend par défaut. Le tier io_uring est celui qui fonctionne là où vfio ne fonctionne pas, et c’est à ce titre celui sur lequel j’ai fini dans le montage Proxmox.
Où vivent les métadonnées
Commencez ici. Presque tout le reste en découle.
| BlueStore d’Umbrella | FlashStore | |
|---|---|---|
| Métadonnées des objets | clés RocksDB | arbre B+ COW par shard |
| OMAP | clés RocksDB | le même arbre B+ par défaut ; LSM ou RocksDB en option au prepare |
| Journal des PG | clés RocksDB | le même arbre B+ |
| État de l’allocateur | allocateur hybride, freelist dans RocksDB | bitmap par shard, dans l’arbre |
| Périphérique de métadonnées | block.db et block.wal en option | aucun, même NVMe |
| Sommes de contrôle des données | crc32c par 4 Kio par défaut | crc32c par 4 Kio, dans la carte d’extents |
| Nombre de magasins par OSD | un | un par cœur |
Les valeurs par défaut côté BlueStore viennent directement du fichier d’options d’Umbrella : RocksDB comme backend clé/valeur, l’allocateur hybride, des sommes de contrôle crc32c61011. Le contrôle des métadonnées de BlueStore « is handled by RocksDB and uses the crc32c algorithm », et les données lui coûtent « a checksum value (usually 4 bytes) for every 4 KB block of data »4. Sur les sommes de contrôle, les deux magasins sont d’accord. FlashStore garde un crc32c par bloc de 4 Kio dans la carte d’extents et le vérifie à la lecture7.
C’est sur la structure qu’ils se séparent. Le RocksDB de BlueStore est un arbre LSM, log-structured merge : il écrit, puis compacte en arrière-plan, en réécrivant des données qu’il avait déjà écrites. L’arbre de FlashStore est mis à jour par copie sur écriture et replié sur disque aux checkpoints : toutes les cinq secondes tant que quelque chose n’est pas persisté, ou quand l’anneau du WAL atteint la moitié de sa capacité7.
Autre conséquence : FlashStore n’a pas de périphérique rapide pour les métadonnées, parce qu’il n’en a pas besoin.
Sur Umbrella, vous pouvez mettre block.db sur un disque plus rapide, et BlueStore y placera « as much metadata as it can on the DB device »4.
FlashStore suppose que chaque disque est déjà un NVMe rapide, et garde ses métadonnées à côté des données.
C’est une hypothèse juste pour le matériel qu’il vise. C’est aussi exactement pour cela qu’il n’y a rien pour les HDD.
L’OMAP est le seul endroit où FlashStore se couvre. L’arbre est le choix par défaut, mais un magasin peut être préparé avec un moteur LSM maison de croit, ou avec RocksDB, derrière la même interface12. Le moteur OMAP se choisit à la création du magasin. Vous ne le changez pas sur un OSD en marche.
Une écriture de 4 Kio, deux façons
Voici la différence que vous sentiriez, si vous en sentez une.
Prenez une écriture de 4 Kio dans un objet sur Umbrella, réglages par défaut, sur flash.
bluestore_min_alloc_size_ssd vaut 4 Kio et bluestore_prefer_deferred_size_ssd vaut 0, donc une écriture complète de 4 Kio va dans 4 Kio fraîchement alloués1314.
BlueStore soumet cette écriture de données, et la transaction reste dans STATE_AIO_WAIT jusqu’à ce que le disque dise qu’elle est faite15.
Ce n’est qu’alors que les métadonnées sont mises en file pour RocksDB, et le thread de synchronisation de RocksDB vide le périphérique bloc avant de valider16.
Ensuite, le client reçoit son acquittement.
Deux allers-retours vers le périphérique, en série.
FlashStore envoie les deux d’un coup. Les données vont dans un extent neuf de 4 Kio et l’unité de WAL va dans l’anneau du journal en parallèle. L’enregistrement du WAL porte le crc32c de chaque nouveau bloc de données, si bien que le rejeu après un plantage peut dire si les données sont arrivées7. L’acquittement part, dans l’ordre du journal, quand les données, l’unité de WAL et toutes les transactions antérieures sont durables7. La justification que donne l’ADR lui-même est « parallel commit gives one device latency per ack »7.
Deux choses gardent cela honnête. Sur un OSD chargé, les deux magasins regroupent les validations, donc l’écart sous charge est inférieur à une latence de périphérique par écriture. Et un aller-retour vers un NVMe, c’est quelques dizaines de microsecondes. Que vous le remarquiez dépend de ce que font vos clients : attendre la latence à faible profondeur de file, ce que font souvent les bases de données sur RBD, ou pousser du débit, où cela disparaît.
croit a essayé d’aller plus loin, jusqu’à une seule écriture sur le périphérique par transaction, à la manière de ZFS. Ils l’ont construit, mesuré, et jeté : le gain n’apparaissait qu’en profondeur de file 1 et la complexité n’en valait pas la peine17. J’accorde plus de valeur à cela qu’à n’importe quel graphique de benchmark. C’est un registre de décision qui dit « nous l’avons construit et cela n’en valait pas la peine », en public.
L’écriture de moins de 4 Kio
C’est sur la petite écriture que les deux divergent vraiment.
Disons qu’un client réécrit 512 octets au milieu d’un bloc qui contient déjà des données.
Umbrella fait encore tourner son chemin d’écriture d’origine par défaut ; bluestore_write_v2, la refonte, est livrée désactivée18.
Sur ce chemin, une écriture plus petite que min_alloc_size dans un bloc déjà alloué devient une écriture différée19.
Les données voyagent dans la transaction RocksDB sous forme de clé avec le préfixe L, et ne rejoignent leur vraie place qu’une fois que le client a été informé qu’elles sont en sécurité2021.
Les données atteignent donc le disque deux fois. La documentation d’Umbrella ne le cache pas : « writes smaller than min_alloc_size must first pass through the BlueStore WAL »4.
FlashStore ne réécrit jamais en place des données vivantes, point7. Les objets jusqu’à 2 Kio vont plus loin et vivent entièrement dans l’arbre, si bien qu’une seule écriture dans le WAL constitue toute la validation7.
Cela veut aussi dire que FlashStore n’a pas de file d’écritures différées à vider, pas de rejeu différé au montage, et pas de clés L à nettoyer.
Il paie ailleurs : les blocs libérés sont retenus jusqu’au checkpoint suivant, donc l’espace libéré a jusqu’à un intervalle de checkpoint de retard7.
Des threads contre des cœurs
La moitié haute de l’OSD diffère tout autant.
Le ceph-osd d’Umbrella est un serveur multithread classique, et chaque nombre de la moitié gauche du diagramme ci-dessous est l’une de ses valeurs par défaut sur flash22.
Une opération traverse plusieurs de ces pools en chemin. Ils partagent un état derrière des verrous.
FlashStore garde tout le trajet sur un seul cœur épinglé qui fait du polling, de la carte réseau au disque et retour23. Chaque placement group appartient à exactement un cœur, et tout ce que le PG touche aussi : « no locks, no atomics, no shared mutable state »24. Le trafic entre cœurs passe par des anneaux à producteur unique, et la propriété du message passe avec lui.
Le magasin suit le même découpage.
flashstore_store_shards vaut par défaut un shard par cœur, chacun avec son propre anneau de WAL, son arbre et son allocateur, et un PG vit dans exactement un shard257.
BlueStore, c’est un magasin par OSD avec un seul RocksDB.
Il y a un prix, et l’ADR le dit : « idle cores burn CPU (accepted; optional adaptive sleep later) »23.
Des travaux ultérieurs ont ajouté une inactivité adaptative et des attentes calées sur le périphérique pour qu’un cœur ne tourne pas à vide pendant toute la latence du périphérique à faible profondeur de file8, mais le principe tient, et flashstore_cores vaut 8 par défaut si vous n’épinglez pas de plage25.
Vous donnez à FlashStore des cœurs entiers.
Sur un nœud de stockage dédié, ça va. Sur une machine hyperconvergée où ces cœurs font aussi tourner des VM, c’est le premier calcul à faire.
Le disque doit tenir sa promesse
BlueStore est écrit pour s’accommoder d’un disque qui ment sur le moment où les données sont en sécurité. FlashStore refuse purement et simplement d’avoir affaire à ce disque.
| BlueStore d’Umbrella | FlashStore | |
|---|---|---|
| Ce qui rend une écriture durable | vidage du périphérique bloc avant la validation RocksDB | l’écriture qui se termine sur un disque PLP |
| Vidage sur le chemin critique | oui | non |
| Disque avec cache d’écriture volatil | utilisé, et vidé | mkfs le refuse ; contrôle de l’hôte en FAIL |
| Contournement | inutile | labo seulement : bit FUA sur chaque écriture durable |
Côté BlueStore, c’est le thread de synchronisation kv déjà cité16. Côté FlashStore, c’est l’ADR sur la durabilité et le contrôle de l’hôte : PLP signifie que le disque ne déclare aucun cache d’écriture volatil, donc une complétion veut dire que les données sont sur un support stable2426.
C’est le bon choix pour la cible, mais soyez clair sur ce qu’il exclut, parce que presque tous les NVMe grand public ont un cache volatil et pas de PLP, et c’est aussi le cas d’une bonne partie du matériel « datacenter » vendu sur le prix. Pas de PLP, pas de FlashStore. Quoi que vous en pensiez par ailleurs.
Ce sur quoi FlashStore ne tourne pas
Mettez les exigences côte à côte et le marché visé saute aux yeux.
| BlueStore d’Umbrella | FlashStore | |
|---|---|---|
| Support | HDD, SSD, NVMe | NVMe seulement |
| Protection contre les coupures de courant | non requise | requise, mkfs refuse sans |
| Format de secteur | 512 o ou 4 Kio | 4 Kio attendu, avertissement sinon |
| Disposition | partitions, LVM via ceph-volume | namespaces entiers, pas de partitions |
| Périphérique DB/WAL séparé | pris en charge | cela n’existe pas |
| Chiffrement au repos | --dmcrypt via ceph-volume | hors périmètre |
| Clients msgr1 | écoutés par défaut | refusés, msgr2 seulement |
| Cache tiering | déprécié, toujours présent | refusé, le pool passe en passif |
| Exigences noyau | toute version prise en charge | io_uring : Linux 5.19+, ou le 5.14 de RHEL 9 avec rétroportages ; hugepages pour SPDK |
La colonne BlueStore est celle d’Umbrella lui-même : ceph-volume chiffre les volumes logiques « using dmcrypt by specifying the --dmcrypt flag »27, et ms_bind_msgr1 vaut toujours true par défaut28.
La colonne FlashStore vient de sa référence matérielle et de sa décision de périmètre2629.
Deux de ces lignes méritent plus qu’une ligne de tableau.
Le chiffrement au repos est exclu, avec une raison : SPDK contourne dm-crypt, et aucun chiffrement dans le magasin n’est prévu. La réponse de l’ADR, ce sont des disques NVMe à chiffrement intégré, ou un chiffrement au-dessus du magasin, au niveau du client ou de RGW29. Si vous avez une exigence de conformité qui nomme dm-crypt sur l’OSD, c’est bloquant aujourd’hui.
msgr1 est exclu en tant que risque accepté. Les clients noyau antérieurs à 5.11 et les librados d’avant Nautilus ne peuvent pas du tout parler à un OSD FlashStore29. La plupart des parcs ont dépassé ce stade depuis longtemps. Certains non, et c’est la vieille machine oubliée dans un coin qui s’en aperçoit.
Il dit au moniteur qu’il est BlueStore
C’est celle-ci qui va piéger du monde.
Par défaut, un OSD FlashStore démarre et annonce aux moniteurs osd_objectstore=bluestore30.
Il ne se cache pas. Il ajoute ses propres clés flashstore_version et flashstore_build à côté30.
La raison, c’est la compatibilité : un moniteur Umbrella n’autorise des fonctionnalités comme les EC overwrites sur un pool que si chaque OSD du pool déclare BlueStore, et des modules du gestionnaire comme Prometheus et telemetry se branchent sur la même valeur30.
L’ADR dit explicitement que bluestore est ici « is a compat value for mon/mgr feature gates, not a product name »30.
Il existe un commutateur, flashstore_report_objectstore=flashstore, qui renomme tout : les métadonnées, les clés bluestore_bdev_*, le perf logger, les commandes tell et les codes de santé BLUESTORE_*. Il faut des moniteurs patchés, et la valeur par défaut reste bluestore2530.
Les builds Ceph de croit intègrent ces correctifs, donc FlashStore s’y déclare flashstore et rien de ce qui suit ne s’applique.
Le nom bluestore est là pour les moniteurs et managers standard que l’on fait tourner en production aujourd’hui.
Je comprends pourquoi.
Un verrou du moniteur fondé sur une chaîne de caractères, c’est la conception de Ceph, pas celle de croit, et refuser de dire bluestore désactiverait des fonctionnalités sur un cluster non patché.
C’est là le piège sur un cluster standard.
Chaque tableau de bord, chaque script d’inventaire et chaque ceph osd count-metadata osd_objectstore que vous lancez comptera les OSD FlashStore comme BlueStore.
Pendant une migration, quand vous avez le plus besoin de savoir quel OSD est quoi, le champ évident ne vous dit rien du tout.
Vérifiez donc flashstore_version dans ceph osd metadata, pas osd_objectstore.
Mettez-le dans votre runbook avant que le premier OSD FlashStore n’entre.
Mêmes réglages, autre comportement
FlashStore lit beaucoup des options existantes de Ceph, et c’est surtout une bonne nouvelle. Toutes les options ne veulent pas dire ce qu’elles voulaient dire sur Umbrella, et celles qui diffèrent sont celles où un cluster réglé aux petits oignons se fait surprendre.
| Option | BlueStore d’Umbrella | FlashStore |
|---|---|---|
compression_mode, par pool | none, passive, aggressive, force | les quatre mêmes, même sens |
compression_algorithm | snappy par défaut | snappy, zlib, zstd, lz4 ; niveau zstd fixé à 1 |
bluestore_compression_max_blob_size_ssd | 64 Kio | blocs de 64 Kio |
osd_memory_target | 4 Gio, caches réglés automatiquement en continu | lu une fois au démarrage, dimensionne les caches du magasin, pas d’autotune |
osd_op_queue | mclock_scheduler | accepté et ignoré |
osd_mclock_* | actif | accepté et ignoré |
csum_type | crc32c par défaut, variantes xxhash disponibles | crc32c fixe ; toute autre valeur journalise un avertissement31 |
La compression correspond.
Le mode par défaut de BlueStore est none et son algorithme par défaut snappy3233 ; FlashStore implémente les quatre mêmes modes, les mêmes options de pool et le même découpage en 64 Kio, et l’ADR note qu’un bloc de 64 Kio compressible à 50 % occupe la même place sur les deux34.
Elle n’a pas toujours été prévue. Le fichier de l’ADR s’appelle encore no-store-compression, d’après la décision d’origine, renversée quand croit s’est donné pour mandat la parité fonctionnelle complète avec le Ceph classique34.
La mémoire, ce n’est pas la parité.
Umbrella règle automatiquement les caches de BlueStore par rapport à osd_memory_target pendant qu’il tourne3536.
FlashStore lit la cible une fois au démarrage, la répartit sur ses shards, et un changement fait avec ceph config set prend effet au redémarrage suivant37.
Il ne tient pas non plus le processus à la cible : les hugepages, les tampons réseau et l’état des PG sont en dehors37.
Donc osd_memory_target dimensionne les caches de FlashStore. Il ne plafonne pas la mémoire de l’OSD comme vous en avez peut-être l’habitude.
Et mClock est tout bonnement ignoré37.
Pas réduit. Ignoré.
Il n’y a pas d’ordonnanceur d’opérations à configurer, parce que chaque cœur possède ses PG.
La récupération et le backfill sont freinés par osd_max_backfills, osd_recovery_max_active et les options de sleep à la place37.
Si vous avez réglé des profils mClock pour une reconstruction sur Umbrella, ces réglages ne font rien sur un OSD FlashStore, et rien ne vous avertira.
Aucune conversion, dans un sens comme dans l’autre
Vous ne pouvez pas convertir un OSD BlueStore en OSD FlashStore. Le guide de migration de croit le dit sans détour : « There is no in-place conversion of a BlueStore device »38. Il propose deux ordres à la place, et les deux passent par le backfill38 :
| Ajouter, puis retirer | Libérer, puis ajouter | |
|---|---|---|
| Il faut | un emplacement NVMe libre | rien de libre |
| Étape 1 | préparer FlashStore sur le nouveau disque | ceph osd out, attendre l’état clean |
| Étape 2 | attendre active+clean | arrêter et purger l’OSD classique |
| Étape 3 | retirer l’OSD classique | préparer FlashStore sur le disque libéré |
| Risque pendant l’opération | aucun au-delà d’un backfill normal | une copie de moins jusqu’à la fin du backfill |
Et cela ne devient pas plus simple ensuite. Le format sur disque de FlashStore a des bits de fonctionnalités, et un montage refuse un bit inconnu : « Every format change means mkfs; unknown bits refuse mount (no downgrade) »7. Un changement de format dans une version ultérieure de FlashStore, c’est donc le même vidage-remplissage que la première migration.
Il y a une chose sur laquelle la documentation se trompe.
La liste de contrôle du guide de migration dit de s’assurer que « the pools do not use erasure coding on croit-flashstore-osd OSDs »38.
Le guide sur l’erasure coding du même instantané dit que FlashStore sert par défaut les pools EC hérités, et la valeur par défaut du code pour l’EC optimisé est all3940.
L’un des deux est périmé, et d’après le code, c’est le guide de migration.
Je lirais quand même le guide EC en entier avant de mélanger des pools EC sur les deux types d’OSD, parce que la panne qu’il décrit, c’est un PG qui se dégrade et un backfill qui cale39.
Un magasin fait pour les disques que l’on achète vraiment
BlueStore a été construit pour tourner sur tout. Disques rotatifs, SSD bon marché, NVMe, partitions, LVM, volumes chiffrés, un périphérique DB rapide devant un périphérique de données lent. C’est cette largeur qui en a fait le choix par défaut, et c’est pour elle qu’il transporte un chemin d’écriture différée, un vidage avant chaque validation, une base clé/valeur sur un système de fichiers à lui, et un pool de threads pour faire tourner tout cela. Chacun de ces éléments existe parce qu’un disque quelque part en avait besoin.
FlashStore part de l’autre bout. Il suppose que le disque est un NVMe, qu’il a une protection contre les coupures de courant, et qu’il est assez rapide pour que le logiciel soit désormais le goulot d’étranglement. Puis il jette tout ce qui n’existait que pour les autres disques.
Est-ce le bon pari ? Pour de nouveaux clusters 100 % flash, bâtis sur du vrai NVMe d’entreprise, oui. C’est là que vont les clusters Ceph, et un OSD qui dépense ses cœurs en verrous, en passages de relais et en une base de données qui compacte derrière lui paie, chaque seconde de chaque jour, pour une souplesse dont un tel cluster ne se servira jamais.
Mais le pari a un coût, et je préfère que vous le voyiez avant d’y adhérer. Vous renoncez aux HDD, à dm-crypt, à msgr1, au réglage mémoire à chaud et à mClock. Sur un cluster standard, vous obtenez un OSD qui dit à vos moniteurs qu’il est BlueStore, parce que les moniteurs et managers actuels ne lui laissent pas d’autre moyen. Les builds de croit n’en auront pas besoin. Vous obtenez un format vers lequel vous ne pouvez pas convertir, et entre les versions duquel vous ne pouvez pas convertir non plus. Et vous l’obtenez en préversion, d’un fournisseur unique, qui se trouve être mon employeur.
Prenez donc le code source comme preuve, pas cet article et pas le rapport de benchmark de croit. Les registres de décisions sont publics et ils disent ce qui a été mesuré et ce qui a été jeté. Lisez-les, montez un cluster de test sur le matériel que vous déploieriez réellement, et mesurez votre propre charge de travail. S’il fait sur vos disques ce que disent les ADR, vous le saurez. S’il ne le fait pas, vous le saurez aussi, et vous l’aurez découvert sur un cluster de test.
croit ceph-rust, README at snapshot 48f9014 — composants, statut et feuille de route, « not yet recommended for production data », compatible sur le fil avec v21.2.0 et v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, green-field, no Crimson fork — « No fork, no linking of Ceph code » ; le code source de Ceph lu comme référence, spécifications dans ses propres mots. ↩︎
ADR 0164, licences — démon et outils en LGPL-3.0-only, bibliothèques clientes en MPL-2.0, documentation en CC-BY-SA-4.0, et la raison du choix de la MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — accès direct au périphérique, périphérique DB, « writes smaller than min_alloc_size must first pass through the BlueStore WAL », sommes de contrôle. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore « consumes raw block devices or partitions » ; RocksDB embarqué pour les métadonnées internes. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— par défautrocksdb. ↩︎ ↩︎ADR 0021, storage engine — arbre B+ COW par shard, anneau de WAL, validation parallèle, checkpoints, données en ligne, libérations retenues, « Every format change means mkfs ». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, storage I/O — SPDK sur vfio, amendé en deux tiers avec io_uring, inactivité calée sur le périphérique. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkest le backend par défaut,kerneletkernel-cmdlaissent le NVMe au pilote du noyau. ↩︎Ceph v21.2.0,
bluestore_allocator— par défauthybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— par défautcrc32c. ↩︎ceph-rust, croit-flashstore-tool usage — « fresh prepare/mkfs –omap-engine btree|lsm|rocksdb ». ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— par défaut 4 Kio. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— par défaut 0. ↩︎Ceph v21.2.0,
BlueStore.cc, transaction state machine — des aio en attente font passer la transaction enSTATE_AIO_WAITavant sa mise en file pour la validation clé/valeur. ↩︎Ceph v21.2.0,
BlueStore.cc, kv sync thread — « flush/barrier on block device » avant la soumission à RocksDB. ↩︎ ↩︎ADR 0027, single-IO atomic commit, rejected — « gain only at QD1 », construit puis retiré. ↩︎
Ceph v21.2.0,
bluestore_write_v2— « Use faster write path », par défaut false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— lecture de la tête et de la queue, puis « chunk-aligned deferred overwrite ». ↩︎Ceph v21.2.0,
BlueStore.cc, “journal deferred items” — la transaction différée est posée comme clé dans la même transaction RocksDB. ↩︎Ceph v21.2.0,
BlueStore.cc, key prefixes —PREFIX_DEFERRED = "L". ↩︎Valeurs par défaut des threads de Ceph v21.2.0 —
osd_op_num_shards_ssd8 ;osd_op_num_threads_per_shard_ssd2 ;osd_op_queuemclock_scheduler;ms_async_op_threads3 ;BlueStore.ccthread creation,bstore_kv_syncetbstore_kv_final. ↩︎ADR 0006, thread-per-core runtime — un thread épinglé en busy-polling par cœur, PG possédés par un seul cœur, « idle cores burn CPU (accepted …) ». ↩︎ ↩︎
ADR 0008, concurrency and durability — « no locks, no atomics, no shared mutable state » ; PLP requise,
mkfsrefuse les disques sans PLP, contournement FUA pour le labo. ↩︎ ↩︎ceph-rust docs, configuration reference —
flashstore_corespar défaut 8,flashstore_store_shardsauto,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, hardware and host requirements — cache d’écriture volatil en FAIL, LBA de 4 Kio, pas de partitions, exigences noyau et io_uring. ↩︎ ↩︎
Ceph Umbrella, ceph-volume encryption — « Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag ». ↩︎Ceph v21.2.0,
ms_bind_msgr1— par défaut true. ↩︎ADR 0168, encryption at rest, msgr1, cache tiering out of scope — « SPDK bypasses dm-crypt » ; les clients v1 uniquement « cannot reach croit-flashstore-osd ». ↩︎ ↩︎ ↩︎
ADR 0019, report
osd_objectstore=bluestore— les verrous de fonctionnalités du moniteur, les clésflashstore_*supplémentaires, et l’option de déclarationflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— « csum_type {v} unsupported; using fixed crc32c per 4096-byte block ». ↩︎Ceph v21.2.0,
bluestore_compression_mode— par défautnone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— par défautsnappy. ↩︎ADR 0059, per-pool store compression — mêmes modes et options que BlueStore, niveau zstd 1 fixe, espace à 50 % compressible « identical to BlueStore ». ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— par défaut 4 Gio. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— par défaut true. ↩︎ADR 0062, memory target and mClock — cible lue une fois, pas d’autotune, RSS non imposé ; options mClock « ACCEPTED and IGNORED ». ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migrate from classic — « There is no in-place conversion of a BlueStore device » ; les deux ordres ; la ligne de la liste de contrôle sur l’EC. ↩︎ ↩︎ ↩︎
ceph-rust docs, erasure-coded pools —
ec_enable_poolspar défautall,ec_enable_optimizedpar défautall, et à quoi ressemble un pool refusé. ↩︎ ↩︎ceph-rust, OSD config defaults —
("ec_enable_optimized", "all"). ↩︎