L’hôte existe cette fois. Il est juste sur le mauvais hyperviseur
La dernière fois, le problème était que la machine nommée dans l’inventaire n’existait pas encore — pas d’IP, pas de SSH, pas de Python, rien à quoi se connecter. Chaque tâche devait être déléguée loin d’elle.
Une migration VMware inverse cela et ne change rien. La machine existe, elle tourne, des gens s’en servent. Vous ne vous y connectez toujours jamais. C’est un nom et un sac de variables décrivant quelque chose à reconstruire ailleurs. Chaque tâche tourne toujours sur le nœud de contrôle, et il y a maintenant deux API à l’autre bout au lieu d’une.
Une note sur ce que c’est. Ce billet est la conception et le playbook, pas un récit de guerre. Je ne l’ai pas encore lancé de bout en bout contre un parc de production. Tout ce que je dis sur le comportement des modules ci-dessous a été lu dans le code livré et vérifié, et j’ai dit clairement là où une affirmation vient de la source plutôt que d’une exécution. Quand j’aurai fait une vraie migration avec, les chiffres et les surprises auront leur propre billet.
Versions contre lesquelles ceci a été vérifié :
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Les fragments ci-dessous sont découpés d’un seul playbook — migrate.yml, un inventaire dynamique vSphere dans inventory/vmware.vms.yml, et un group_vars/all.yml. J’ai rendu génériques les noms de datacenter, de nœud et de stockage pour la lisibilité.
La forme du travail
Cinq étapes, et seule la dernière coûte quelque chose.
L’ordre est toute la conception. La découverte ne change rien. Bâtir le réseau ne change que Proxmox. Bâtir les coquilles ne change que Proxmox, et une coquille sans disque est bon marché à supprimer. Déplacer les disques est lent mais en vie. Seul le dernier play éteint quoi que ce soit.
Partez à mi-chemin et chaque invité tourne encore sur VMware, intact.
Deux collections, et l’une d’elles est en retrait
Il vous faut les deux, et pas pour la raison que vous devineriez.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware est l’ancienne collection large et elle est en cours de démontage. Son MANIFEST.json déclare {"vmware.vmware": ">=2.5.0"} comme dépendance dure, donc installer la première tire la seconde que vous l’ayez demandée ou non. Les modules migrent un à un, et ceux que vous choisissez dans une migration sont à différentes étapes de ce déplacement :
vmware_dvs_portgroup_info— encore seulement danscommunity.vmware, et c’est lui qui lit vos VLAN.vmware_vmotion— encore seulement danscommunity.vmware.vmware_guest_powerstate— obsolète, retiré danscommunity.vmware7.0.0. Utilisezvmware.vmware.vm_powerstate.vmware_vm_inventory— obsolète, retiré en 7.0.0. Utilisezvmware.vmware.vms.
Ansible vous prévient des obsolescences de modules à la première exécution, ce qui est correct de sa part :
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Il ne vous prévient pas au sujet du plugin d’inventaire, parce que les plugins d’inventaire sont analysés avant que cette machinerie ne tourne. Vous devez aller lire le plugin.
Il y a un troisième piège dans la scission. vmware.vmware.vm_portgroup_info a l’air d’être exactement ce qu’une migration réseau veut — par VM, par NIC, vous donne le portgroup et le VLAN. Mais il est bâti sur ModuleRestBase et importe com.vmware.vapi, ce qui veut dire qu’il a besoin du SDK d’automatisation vSphere sur le nœud de contrôle, pas seulement de pyVmomi. Son retour documenté est aussi périmé : le bloc RETURN promet name et vlan_id, alors que le code bâtit en fait portgroup_name et un dict vlan_info pour le cas distribué. J’ai pris une autre voie, ci-dessous, et n’ai eu besoin d’aucun des deux.
L’inventaire est la découverte
Il n’y a pas de play « va trouver les VM » dans ce playbook, parce qu’au moment où la première tâche tourne, l’inventaire l’a déjà fait — en une requête du collecteur de propriétés plutôt qu’en une boucle par VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
Le nom du fichier compte. Le verify_file du plugin ne réclame que les fichiers finissant par vms.yml, vms.yaml, vmware_vms.yml ou vmware_vms.yaml. Appelez-le vcenter.yml et ce n’est silencieusement pas votre inventaire.
search_paths filtre avant la requête, pas après. Sur un grand parc, c’est la différence entre des secondes et des minutes — contrairement à filter_expressions, dont la doc est explicite : il tourne après la collecte et « does not affect the speed of the inventory plugin » — n’affecte pas la vitesse du plugin d’inventaire.
filter_expressions écarte un hôte quand l’expression est vraie. config.template retire donc les modèles, ce qui se lit à l’envers la première fois.
Et la ligne importante est config.hardware.device, qui n’est dans aucune liste de propriétés par défaut nulle part. C’est tout l’inventaire matériel de la VM, et il porte trois choses sans lesquelles cette migration ne peut avancer : la MAC de chaque NIC, la clé de dvportgroup à laquelle chaque NIC est attachée, et le chemin de datastore de chaque disque. Sans lui, vous revenez à une boucle vmware_guest_info, un aller-retour par VM.
Les périphériques reviennent en JSON avec leur type vSphere préservé dans _vimtype. C’est bon à savoir parce que c’est ainsi qu’on distingue une NIC d’un disque. J’ai vérifié l’encodeur plutôt que de deviner :
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Un bloc compose peut donc tirer les chemins pénibles vers des hostvars plates :
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Cette asymétrie est réelle et elle attrape les gens. Il n’y a pas de type VirtualEthernetCard à faire correspondre. C’est la classe de base abstraite, et ce que vCenter vous remet en fait est VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 ou VirtualSriovEthernetCard. Il n’y a pas de sous-chaîne commune à tous. Avoir une MAC, en revanche, est une chose que seule une NIC fait.
Chaque module d’info cache le champ dont vous avez besoin
C’est le fil conducteur de tout le travail, et une fois que vous l’avez vu trois fois, vous vous mettez à vérifier chaque défaut avant d’écrire la tâche.
vmware_dvs_portgroup_info a six options show_*. Cinq valent true par défaut. La sixième est show_vlan_info, et elle vaut false par défaut.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Laissez-la tranquille et vous obtenez la politique d’apprentissage MAC, la politique de teaming, l’ordre des uplinks et la politique de port pour chaque portgroup du parc. Tout sauf l’étiquette de VLAN, qui est le seul champ qu’une migration réseau demande réellement. La tâche est donc à l’envers de ce que vous écririez d’instinct : activez la seule chose, désactivez les cinq autres.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Ce n’est pas un cas isolé. vmware.vmware.vms a gather_compute_objects, qui remplit cluster et esxi_host — false par défaut. community.vmware.vmware_vm_info a show_allocated, qui est le bloc tenant le CPU et la mémoire — false par défaut. Dans les trois cas, le champ coûteux à collecter est celui dont la migration a besoin, et le défaut protège un cas d’usage de rapport en lecture seule qui n’est pas celui où vous êtes.
vlan_id est trois types différents
Puis vous obtenez les étiquettes de VLAN et vous trouvez qu’elles ne sont pas d’une seule forme. Tout droit de get_vlan_info :
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Un portgroup d’accès vous donne la chaîne "100". Un PVLAN vous donne une chaîne. Un trunk vous donne une liste de chaînes, chacune soit "20" soit "20-30". Et chaque commutateur distribué a au moins un trunk dessus que vous en ayez fait un ou non, parce que le portgroup d’uplink est un trunk portant "0-4094".
| int ne vous est donc pas disponible tant que vous n’avez pas jeté les deux autres formes :
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Trois rejets, dans cet ordre. Les trunks partent, les PVLAN partent, puis les portgroups non étiquetés partent, ce qui écarte aussi les groupes d’uplink et tout ce qui est sur le VLAN 0.
Je ne traduis pas les trunks ni les PVLAN automatiquement et je repousserais quiconque le ferait. Un trunk VMware atterrissant sur Proxmox a besoin soit d’une zone Q-in-Q, soit d’un VNet conscient du VLAN, et lequel est juste dépend de ce que l’invité s’attend à voir. C’est une décision, pas un mappage. Le playbook les imprime et passe :
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Refléter les VLAN dans le SDN
Une zone VLAN liée à un pont, puis un VNet par VLAN avec l’étiquette dessus.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
Les noms de VNet sont courts et contraints, et les noms de portgroup VMware ne le sont pas. Production-Web-Tier-VLAN100 est un nom de portgroup parfaitement ordinaire et un nom de VNet impossible. Le nom est donc généré — v100, à partir de l’étiquette — et l’original lisible par l’humain va dans alias, où il reste visible dans l’interface et dans la sortie de pvesh. Dériver le nom du VLAN plutôt que du portgroup veut aussi dire que le mappage est réversible à l’inspection six mois plus tard.
Deux portgroups sur le même VLAN s’effondrent en un seul VNet. C’est correct — ils étaient le même domaine de diffusion dans VMware aussi — mais vous devriez le voir se passer, ce qui est ce que fait unique(attribute='vlan_info.vlan_id'). Deux portgroups appelés prod-web et prod-web-b, tous deux sur le VLAN 100, produisent un seul v100.
throttle: 1 n’est pas de la prudence, c’est le module. Chaque écriture SDN dans community.proxmox prend un verrou de cluster global, applique la configuration en attente et le relâche — get_global_sdn_lock(), puis apply_sdn_changes_and_release_lock(). Lancez-les en parallèle et elles font la queue sur le verrou de toute façon ; le throttle vous empêche juste de prétendre le contraire. Bon à savoir aussi que le rollback en cas d’échec dépend de la version — le module vérifie is_lock_and_rollback_supported et, sur un PVE plus ancien, vous dit qu’il n’a pas pu défaire plutôt que de le faire.
Une chose cosmétique qui vous fera douter. En 1.6.0, proxmox_vnet émet tout son dict de params comme un avertissement Ansible à chaque création :
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
C’est une ligne de débogage que quelqu’un a laissée. C’est du bruit, pas un défaut.
Bâtir les coquilles, sans disques
Maintenant les VM, et c’est là que la conception se paie. Chaque VM est bâtie dans Proxmox avec le bon nombre de CPU, la bonne mémoire, le bon micrologiciel et les bonnes NIC sur les bons VLAN. Aucun disque du tout.
Une coquille sans disque est rapide à créer, gratuite à supprimer, et démarre sur une invite PXE si quelqu’un la lance par accident. Vous pouvez en bâtir quatre cents en un après-midi, regarder le résultat, décider qu’il est faux, tout supprimer et recommencer. Rien n’a été copié, rien n’a été éteint, et personne n’a remarqué.
Les valeurs dérivées sont des déclarations, pas des tâches. Ansible les évalue paresseusement contre l’hôte en cours, donc chaque VM obtient la sienne sans un seul set_fact :
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
Le VMID vient du MoID de vCenter. vm-42 devient 20042. Cela compte plus qu’il n’y paraît : le play de bascule doit trouver la VM que le play de construction a créée, et une nouvelle exécution doit atterrir sur la même plutôt que de bâtir silencieusement une seconde. Laisser l’API allouer le prochain ID libre — ce qui arrive si vous omettez vmid, et dont j’ai parlé la dernière fois — rend cela impossible.
La mémoire n’a besoin d’aucune conversion. VMware rapporte config.hardware.memoryMB et Proxmox veut des Mo. Les sockets si : VMware vous donne le total de vCPU et de cœurs par socket, Proxmox veut des sockets et des cœurs.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false exprès. Rien ne devrait démarrer de soi-même au milieu d’une migration, surtout pas une machine dont les disques sont encore écrits par un autre hyperviseur.
Bien régler le micrologiciel n’est pas optionnel. Un invité UEFI importé sur une VM SeaBIOS s’importera parfaitement puis refusera de démarrer, et vous y passerez une heure. config.firmware est efi ou bios et se mappe droit sur ovmf et seabios. Un invité UEFI a aussi besoin d’un disque de variables EFI, qui doit être créé avec la VM — voir plus bas pourquoi.
proxmox_kvm ne corrigera pas une NIC, et ne vous le dira pas
La dernière fois, j’ai écrit que proxmox_kvm refuse de converger plutôt que de mettre à jour. Voici la version plus aiguë de cela, qui m’a mordu en écrivant ceci et vaut d’être précise.
update vaut false par défaut, donc relancer contre une VM qui existe déjà ne fait rien. Bien, et documenté. Mais mettez update: true et le module refuse encore de toucher à certains paramètres :
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Il les supprime de la requête et continue. Vous corrigez donc une NIC dans votre mappage d’inventaire, relancez avec update: true, regardez Ansible rapporter changed, et la NIC est exactement aussi fausse qu’elle l’était. Le changed est vrai — autre chose dans la charge utile a été mise à jour — mais pas la chose que vous corrigiez.
update_unsafe: true lève la restriction, et le nom est honnête. La même garde couvre les disques, donc sur une VM qui a des disques, une mise à jour non sûre est une bonne façon d’acquérir une seconde copie de l’un d’eux. Ce n’est pas un interrupteur à choisir pendant une migration.
La sortie est de ne pas utiliser net du tout. Les NIC vont avec proxmox_nic, un module dont tout le travail est une seule interface et qui converge correctement :
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
C’est la même scission où j’ai fini la dernière fois : proxmox_kvm pour définir la machine, proxmox_disk et proxmox_nic pour les choses qui changent ensuite. Le paramètre est mac, pas mac_addr.
efidisk0 ne peut pas être sorti de la même façon — proxmox_disk n’a ni efitype ni pre_enrolled_keys — donc il doit être posé à la création et être juste du premier coup.
Reportez la MAC. VMware distribue des MAC depuis 00:50:56:... et Proxmox les prendra sans se plaindre. Les garder veut dire que les réservations DHCP correspondent encore, que les licences verrouillées sur MAC valident encore, et que toute règle de pare-feu écrite contre une MAC se déclenche encore. Les changer veut dire une journée de petits mystères. proxmox_nic accepte aussi model: vmxnet3 si vous avez besoin que l’invité voie la même NIC qu’avant, mais sur KVM, virtio est la meilleure carte, et un invité Windows voudra de nouveaux pilotes de toute façon.
Refuser plutôt que deviner
Une NIC sur un portgroup standard n’a pas de backing.port du tout. Son backing est un NetworkBackingInfo avec un deviceName. Elle ne sera pas dans la carte, et la bonne chose à faire est de s’arrêter :
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Deux conditions plutôt qu’une, parce que la première doit tourner avant la seconde : map(attribute=...) sur une NIC sans port exploserait sur la recherche indéfinie. Rejetez d’abord les informes, puis vérifiez le reste contre la carte.
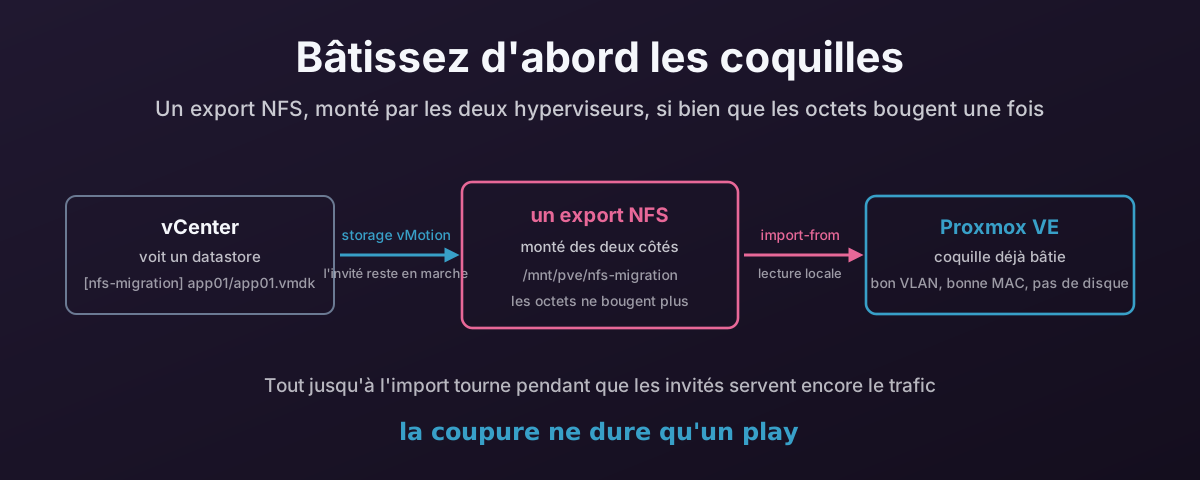
Un export, monté deux fois
Voici la partie qui rend le tout bon marché.
Mettez un export NFS là où les deux hyperviseurs peuvent le monter. vCenter voit un datastore appelé nfs-migration ; les nœuds Proxmox montent le même export et voient /mnt/pve/nfs-migration. Maintenant, storage-vMotion les VMDK dessus.
Le Storage vMotion est en vie. L’invité continue de servir le trafic tout du long. Rien n’est basculé, aucune fenêtre n’est nécessaire, et cela peut être abandonné à mi-chemin sans conséquence au-delà d’E/S gaspillées. C’est l’étape la plus lente de loin et elle ne coûte rien.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout vaut 3600 par défaut — une heure. Un VMDK de 2 To n’y arrivera pas, et le mode d’échec est vilain d’une façon discrète : la tâche Ansible échoue tandis que le vMotion continue de tourner dans vCenter. Vous avez maintenant un playbook qui dit qu’il a échoué et un parc qui est encore occupé. Réglez-le à quelque chose qui reflète votre stockage réel.
throttle: 2, parce que le goulot d’étranglement n’est pas le nœud de contrôle. Le Storage vMotion est borné par la baie et le réseau. Six à la fois ne vous donne pas six fois le débit ; il vous donne six migrations lentes et une équipe de stockage fâchée.
Le module est idempotent de la façon que vous voulez — il met storage_vmotion_needed = False si la VM est déjà sur le datastore cible — donc relancer pour ramasser les retardataires est sûr.
Le temps que ceci finisse, les octets siègent sur un stockage que Proxmox monte déjà. À ce titre, rien d’autre n’a besoin de les copier. Jamais.
La bascule
C’est le seul play qui coûte du temps d’arrêt, et l’ordre à l’intérieur n’est pas négociable.
D’abord, un problème facile à rater : l’inventaire est maintenant périmé. Il a été recueilli avant le vMotion, donc vm_disks tient encore les anciens chemins de datastore. Importez à partir de ceux-là et vous pointez Proxmox vers un chemin qu’il ne peut pas voir.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Ce qui est aussi pourquoi le cache est coupé dans la configuration de l’inventaire. Un cache chaud rendrait à refresh_inventory exactement les données périmées qu’il a été appelé à remplacer. C’est un vrai compromis — vCenter n’est pas rapide — mais un mauvais chemin ici est une bascule échouée dans une fenêtre, et l’aller-retour est bon marché en comparaison.
Puis éteignez. Importer un VMDK qu’un hôte ESXi tient encore ouvert vous donne une copie cohérente au mieux au crash :
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest est un arrêt gracieux par les VMware Tools ; force: true arrête durement tout ce qui ne part pas dans le délai. Sur le nouveau module, le paramètre est timeout, pas state_change_timeout comme sur l’obsolète.
Puis l’import, qui est le pivot :
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
Le regex_replace fait la traduction entre les deux mondes. vCenter nomme un disque [nfs-migration] app01/app01.vmdk ; Proxmox atteint le même fichier à /mnt/pve/nfs-migration/app01/app01.vmdk. Même export, mêmes octets, pas de seconde copie. Vous gardez le descripteur .vmdk et ignorez le -flat.vmdk à côté — qemu-img lit le descripteur et le suit jusqu’à l’extent.
Trois choses au sujet d’import_from qui sont toutes dans le module et toutes bonnes à savoir avant l’ouverture de la fenêtre.
Il ne se déclenche qu’à la création. Dans la branche de mise à jour :
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Si scsi0 existe déjà sur cette VM, le paramètre est abandonné et vous obtenez une mise à jour ordinaire. Donc une nouvelle exécution après un mauvais import ne réimporte pas. Elle ne fait silencieusement rien du tout et rapporte un succès. Si un import se passe mal, supprimez le disque avant de réessayer.
timeout vaut 600 secondes par défaut. Dix minutes, pour importer et convertir le disque d’une machine virtuelle. La propre documentation du module dit de le relever ; suivez le conseil.
Et un chemin absolu a besoin de root. La documentation est directe là-dessus :
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Ce qui atterrit maladroitement contre le conseil que j’ai donné la dernière fois, et que je maintiens toujours : utilisez un jeton d’API cadré, pas root. Ce conseil tient pour chaque autre étape ici : la découverte, le SDN, la construction des coquilles, le réglage de l’ordre de démarrage marchent tous bien avec un jeton. Cette seule tâche non, et aucune quantité de privilège sur le rôle ne le changera, parce que la restriction porte sur le fait que l’utilisateur soit root plutôt que sur une permission.
Il y a trois sorties honnêtes, et pas de quatrième astucieuse :
- PVE 9.x : utilisez
<storage>:import/<file>et restez sur le jeton. - PVE 8.x : faites cette seule tâche en
root@pam, et cette seule. - PVE 8.x, pas de root sur l’API : lancez
qm importdiskpar SSH à la place.
Le playbook prend les deux premières via un drapeau, parce que prétendre le contraire ne ferait que déplacer le problème vers qui le lance.
Enfin l’ordre de démarrage, qui est une mise à jour ordinaire et donc intacte à la restriction update_unsafe :
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Rien ne démarre l’invité. C’est délibéré. Démarrez-le à la main, regardez-le monter, et seulement alors pensez à supprimer quoi que ce soit dans VMware.
Le lancer
Le tout est un seul playbook, étiqueté par étape, parce que ce ne sont pas des étapes que vous voulez lancer ensemble :
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit est votre ami tout du long. Faites une VM d’abord. Faites un cluster. Le playbook n’a pas d’opinion sur combien vous mordez, et l’inventaire vous donne des groupes gratuitement — power_poweredOn, cluster_<name>, plus vmware_windows et vmware_linux du bloc groups.
Vérifiez ce que vous visez avant de le viser :
ansible-inventory --graph
ansible-inventory --host some-vm
Ce que je surveillerais encore
Des choses que je m’attends à trouver quand ceci rencontrera un vrai parc, écrites maintenant pour ne pas pouvoir prétendre après coup que je les ai vues venir :
- Les invités Windows ne démarreront pas proprement sur un contrôleur VirtIO SCSI sans que le pilote soit présent d’abord.
virtio-scsi-singleest le bon contrôleur et le mauvais à remettre à une VM Windows qui ne l’a jamais vu. C’est tout un problème à part et il n’est résolu par rien de ce qui précède. - Les VMware Tools devraient être retirés avant le déplacement, pas après.
- Les instantanés. Une VM avec une chaîne d’instantanés a plus d’un
.vmdkpar disque et importer la base vous donne l’état d’avant l’instantané. Consolidez d’abord. - L’ordre de
config.hardware.deviceest ce qui décide quel disque devientscsi0. Il a correspondu à l’ordre propre de l’invité partout où j’ai regardé, mais je le vérifierais sur un serveur de base de données multi-disque avant de m’y fier dans une fenêtre. - Les disques indépendants et RDM ne feront pas de storage-vMotion comme les ordinaires.
Rien de cela ne change la forme. Bâtissez les coquilles d’abord, déplacez les disques pendant que tout tourne encore, et gardez la coupure au seul play qui en a besoin.