Skip to content
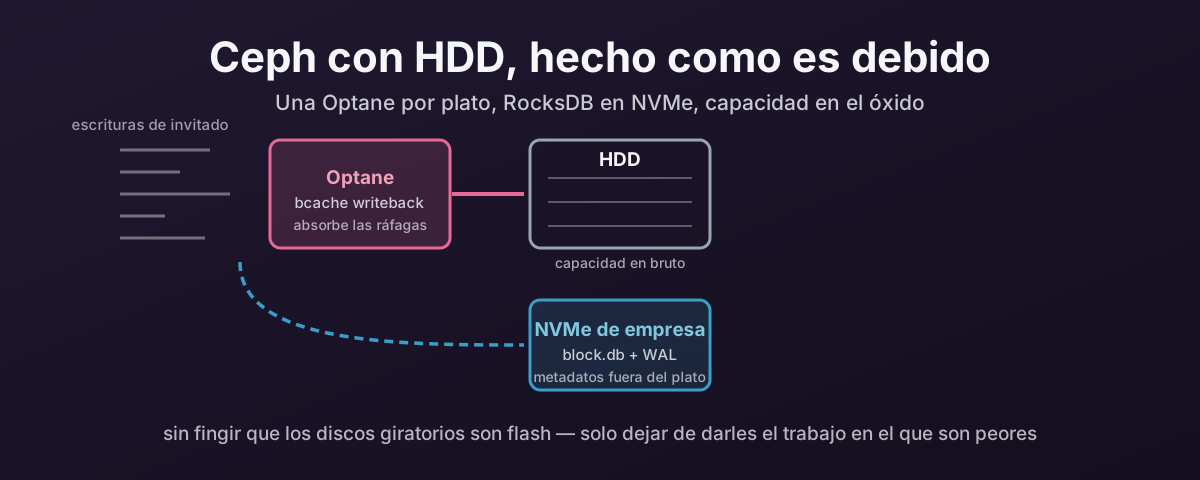
Tres capas de almacenamiento: Optane absorbiendo escrituras, NVMe guardando los metadatos de Ceph, y HDD aportando capacidad en bruto

Hacer rápidos los clústeres Ceph de Proxmox con HDD — metadatos en NVMe, una Optane por plato, y qué te cuesta

El precio del flash ha hecho difícil justificar el todo-NVMe, y los HDD de empresa merecen otra mirada. Sacarles latencia aceptable en Ceph hiperconvergido de Proxmox significa sacar RocksDB del plato, emparejar cada disco con su propia Optane a través de bcache — Optane en concreto, porque la resistencia de la NAND es la equivocada para ese trabajo — y ser honesto con los modos de fallo que te compra.
7 de agosto de 2026 · 41 min · 8547 palabras · Damien Dye
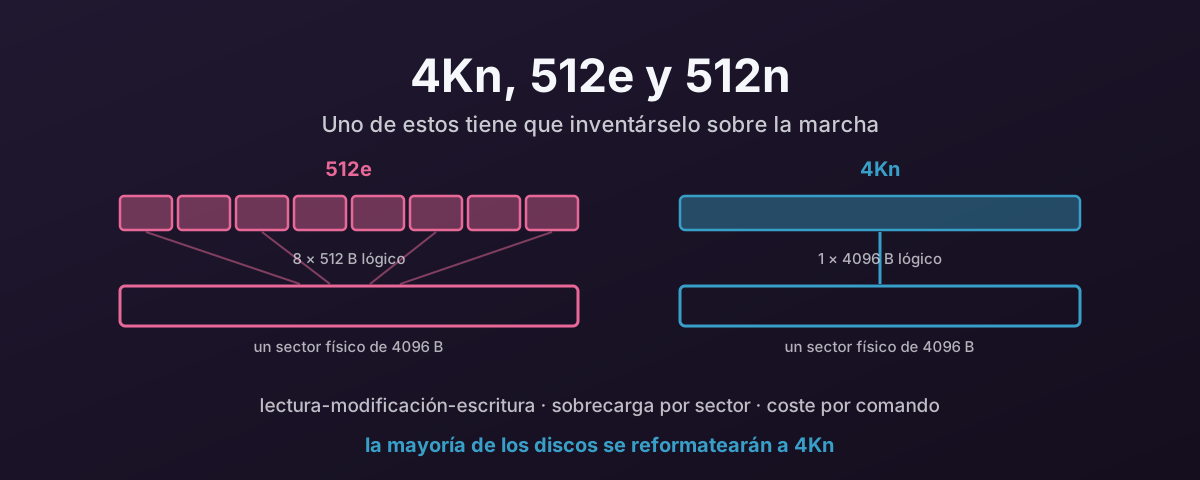
Ocho bloques lógicos de 512 bytes mapeados sobre un sector físico de 4K, junto a un mapeo 4K uno a uno

4Kn, 512e y 512n — por qué el 4K nativo gana, y qué cuesta la emulación

Los discos 512e presentan sectores de 512 bytes que no tienen, y el firmware inventa la diferencia en cada escritura desalineada. Qué cuesta eso en el medio, en el host y en amplificación de escritura — por qué las escrituras directas síncronas son el peor caso — y cómo convertir un parque a 4Kn.

7 de agosto de 2026 · 30 min · 6200 palabras · Damien Dye
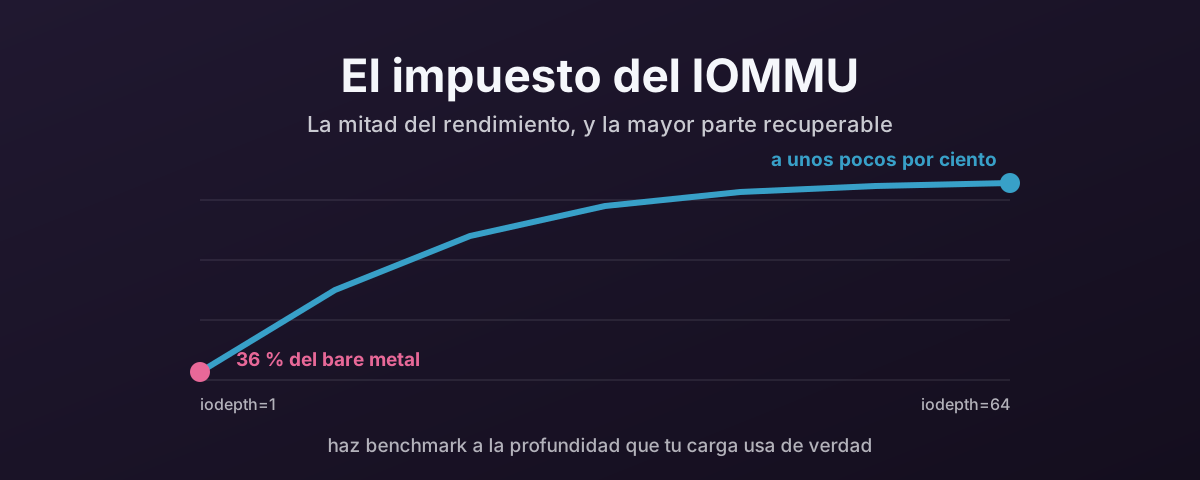
Una curva que sube del 36 por ciento del bare metal a profundidad de cola 1 hasta unos pocos por ciento de él a profundidad de cola 32

Rendimiento del passthrough PCIe en Proxmox VE — el impuesto del IOMMU y cómo minimizarlo

Por qué los dispositivos PCIe pierden rendimiento cuando se pasan a una VM vía VFIO, y los pasos prácticos de ajuste que recuperan la mayor parte.

7 de agosto de 2026 · 22 min · 4628 palabras · Damien Dye
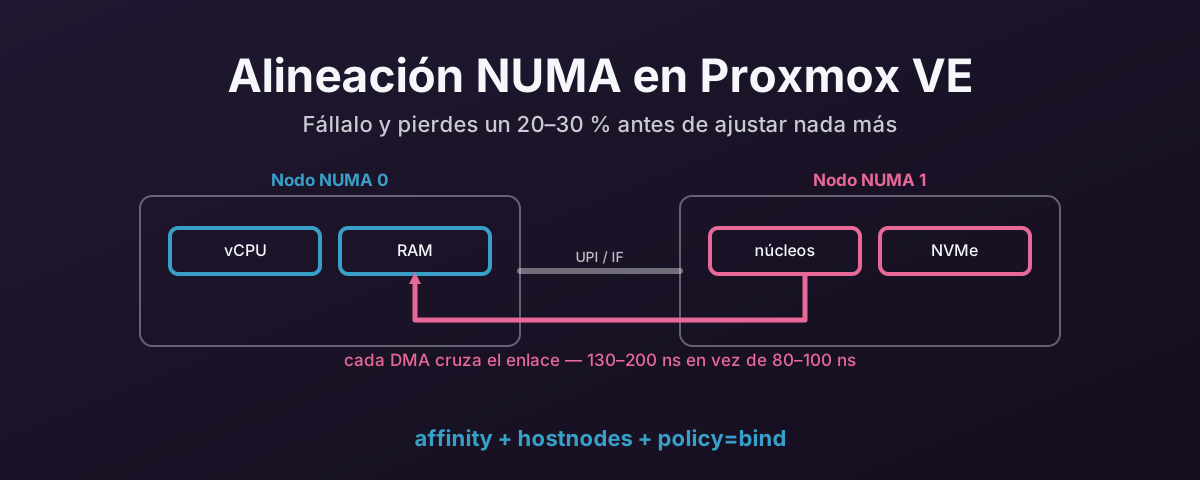
Dos zócalos de CPU con un camino DMA que cruza el enlace entre zócalos

Alineación NUMA en Proxmox VE — por qué importa y cómo hacerla bien

En sistemas multizócalo, una VM con sus vCPU en un nodo NUMA y su dispositivo pasado por passthrough en otro pierde un 20–30 % de rendimiento antes de haber mirado nada más.

7 de agosto de 2026 · 10 min · 1963 palabras · Damien Dye
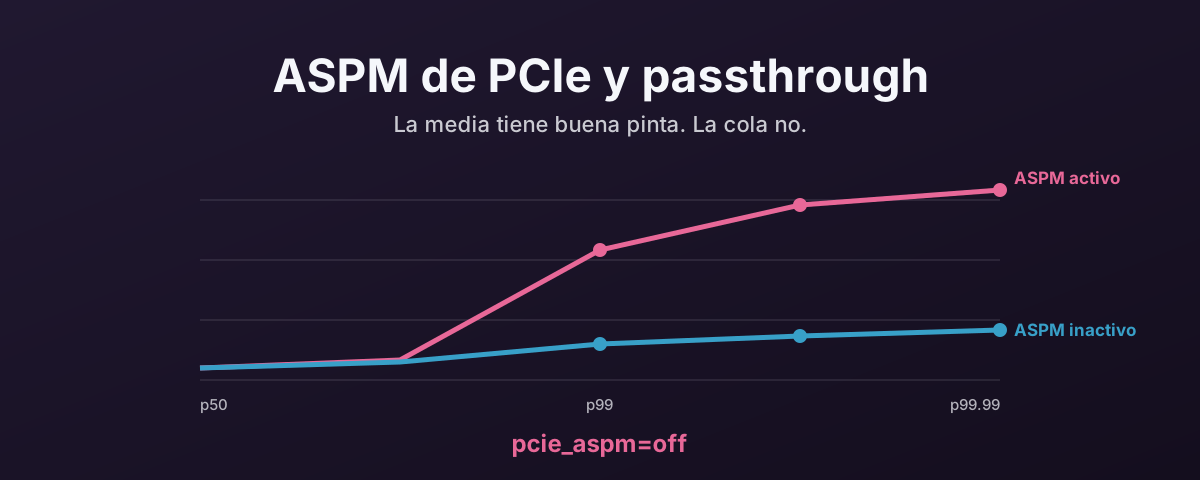
Una curva de percentiles de latencia que se mantiene plana hasta el p90 y luego sube con fuerza, junto a otra que se mantiene plana

ASPM de PCIe y por qué deberías desactivarlo para el passthrough

La gestión de energía en estado activo (ASPM) ahorra unos vatios en enlaces PCIe ociosos. Bajo passthrough VFIO añade fluctuación de latencia difícil de diagnosticar y fácil de arreglar.

7 de agosto de 2026 · 9 min · 1874 palabras · Damien Dye
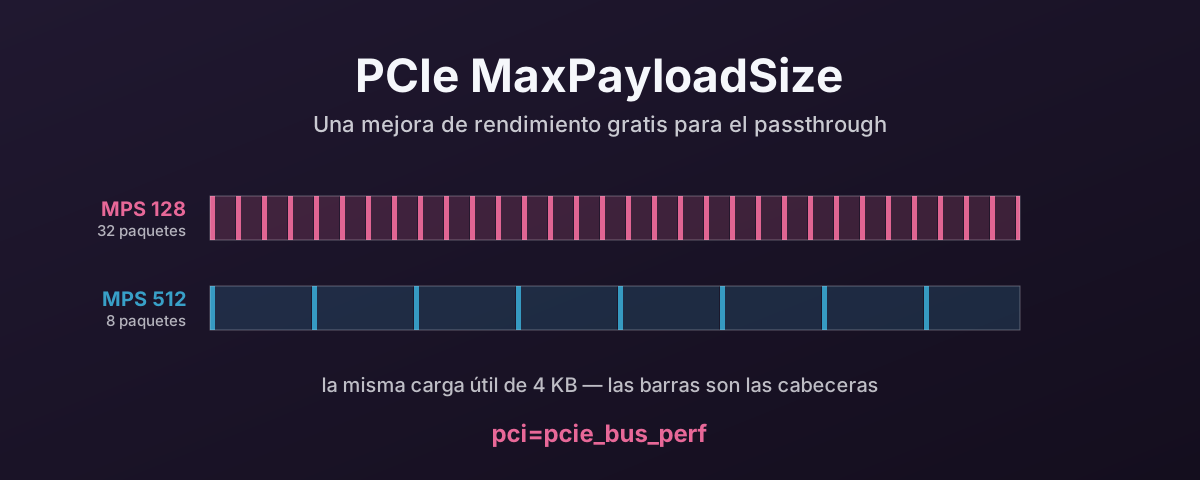
El mismo payload de 4 KB dibujado como 32 paquetes con MPS 128 y 8 paquetes con MPS 512

PCIe MaxPayloadSize — una mejora de rendimiento gratis para el passthrough

El complejo raíz virtual de QEMU usa por defecto payloads TLP de 128 bytes. La mayoría de dispositivos admiten 256 o 512. Un parámetro del kernel lo arregla.

7 de agosto de 2026 · 8 min · 1564 palabras · Damien Dye