Skip to content
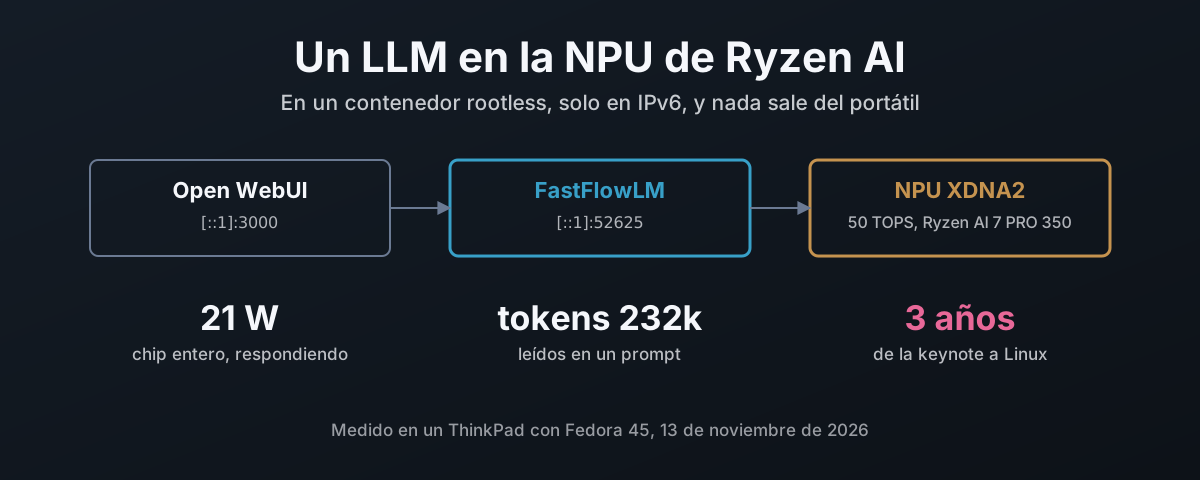
Open WebUI hacia FastFlowLM hacia la NPU XDNA2 sobre loopback IPv6: 21 W respondiendo, 232 000 tokens en un solo prompt, tres años desde la keynote de AMD hasta Linux

Un LLM en la NPU de Ryzen AI, dentro de un contenedor

La NPU de un portátil Ryzen AI son 50 TOPS que se quedan parados en la mayoría de instalaciones Linux. Aquí se recorre cómo compilar el driver amdxdna de AMD y dejar en el host solo el módulo del kernel, cómo meter FastFlowLM con el runtime XRT de AMD en un contenedor podman rootless emparejado con ese driver, cómo atarlo todo al loopback IPv6 y arrancarlo con el sistema mediante Quadlet. Luego lo que hace: nueve modelos medidos, una prueba de contexto de 232 000 tokens, voz a texto con Whisper a diez veces el tiempo real, Open WebUI y los 7 000 tokens ocultos que añadía a cada mensaje, y la velocidad y la energía de la NPU medidas frente a llama.cpp en la iGPU Radeon 860M. Por último, la cronología: tres años desde que AMD anunció Ryzen AI hasta un modelo de lenguaje en su NPU bajo Linux, entregado por un proyecto que AMD no empezó, mientras el esfuerzo se iba a Copilot+ en el Fisher-Price OS (Windows) en lugar de al centro de datos y a las herramientas Linux que de verdad usan los profesionales de la IA.
13 de noviembre de 2026 · 27 min · 6438 palabras · Damien Dye

Arreglar el TSC cuando tu firmware está roto

Durante cuatro meses, en cada arranque, mi ThinkPad E595 entregó a Linux un núcleo de CPU tres segundos por detrás de los otros siete, y el kernel dejó el TSC por el HPET. Qué significa el aviso, por qué una máquina AMD Zen no tiene forma de repararlo desde dentro de Linux, qué dicen del firmware 40 arranques de journal, por qué tsc=reliable es la respuesta equivocada, y cómo tscsync mide y mueve los contadores en UEFI antes de que el kernel llegue a verlos, incluido el núcleo que marcó como BAD y que Linux aceptó igualmente. Actualizado para la BIOS 1.30: no arregla el desfase, y el watchdog de clocksource del kernel tiró el TSC en dos arranques incluso después de que tscsync sincronizara los núcleos. Con tsc=nowatchdog aguantó, y una comprobación de cinco minutos contra el reloj de tiempo real, código incluido, no encontró ningún warp ni deriva. Por último, qué hace esa caída en cualquier hipervisor KVM, sea Proxmox o no: el reloj maestro desaparece, los invitados pierden su lectura rápida del reloj, y en este portátil una lectura del reloj en un invitado salió siete veces más lenta.

11 de octubre de 2026 · 26 min · 5779 palabras · Damien Dye
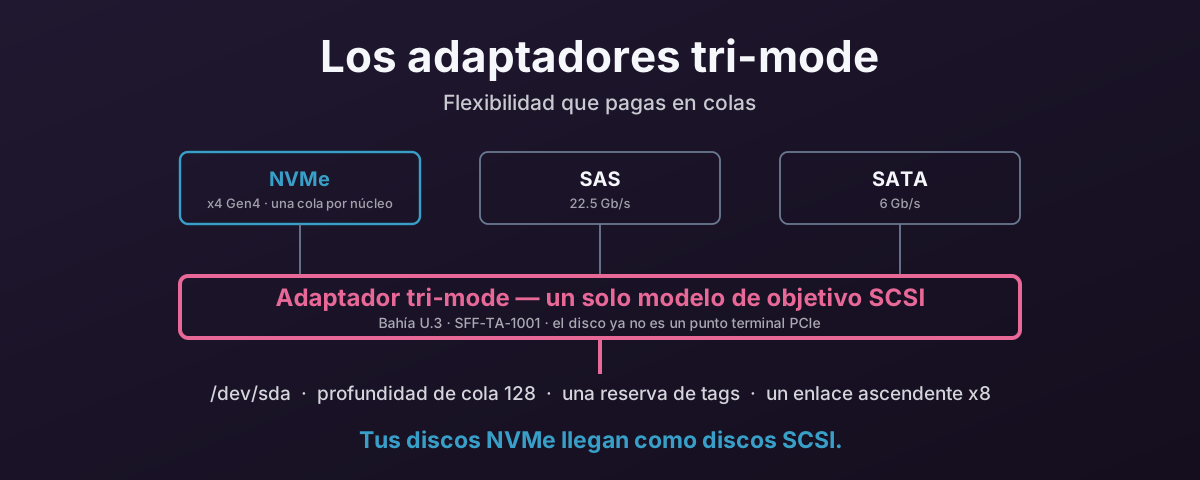
Un disco NVMe entrando en un adaptador tri-mode y saliendo como un disco SCSI con una profundidad de cola de 128

Los adaptadores tri-mode compran flexibilidad a costa de tus colas NVMe

Un adaptador tri-mode deja que cualquier bahía acepte SAS, SATA o NVMe — flexibilidad real, y la razón de que existan los backplanes U.3. Lo que no anuncia es que tus discos NVMe dejan de ser discos NVMe: llegan a Linux como discos SCSI sobre mpt3sas, profundidad de cola 128, compartiendo una reserva de tags y un enlace ascendente x8. Dos discos Gen4 saturan la tarjeta. Un solo disco Gen5 ya la pasa. Si ese trato sigue teniendo sentido en 2026, y por qué las bahías universales pertenecen al backplane en vez de a la controladora.

13 de agosto de 2026 · 28 min · 5755 palabras · Damien Dye
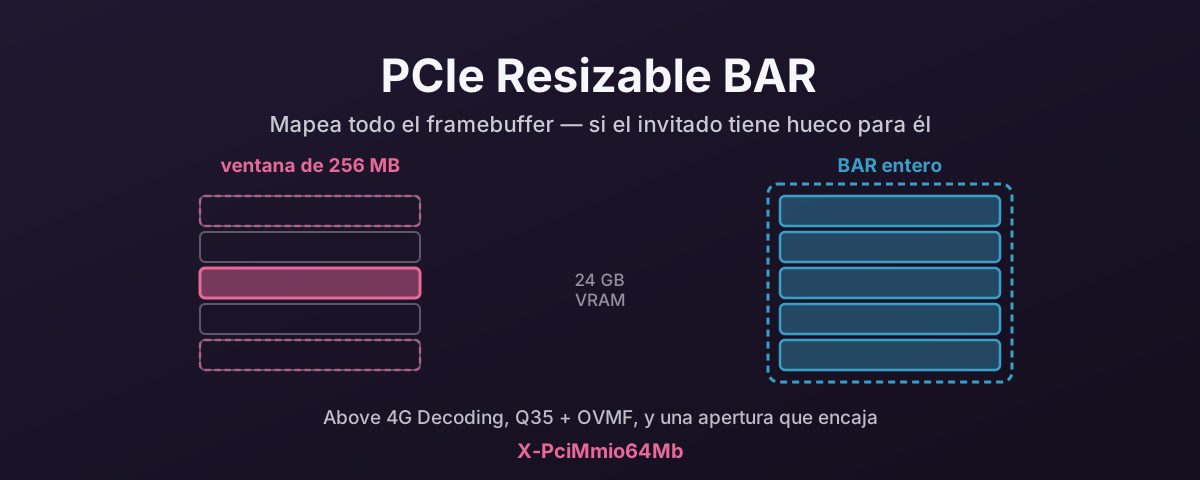
Una pequeña apertura deslizándose sobre un framebuffer grande, junto al framebuffer entero mapeado de una vez

PCIe Resizable BAR y las GPU modernas — Intel Arc, NVIDIA y AMD

El Resizable BAR deja a la CPU mapear todo el framebuffer de una GPU en vez de atisbarlo por una ventana de 256MB. Intel lo llama obligatorio para Arc, NVIDIA lo activa por juego, AMD lo vende como Smart Access Memory — y para el trabajo de IA cambia la transferencia, no las cuentas.

7 de agosto de 2026 · 13 min · 2674 palabras · Damien Dye