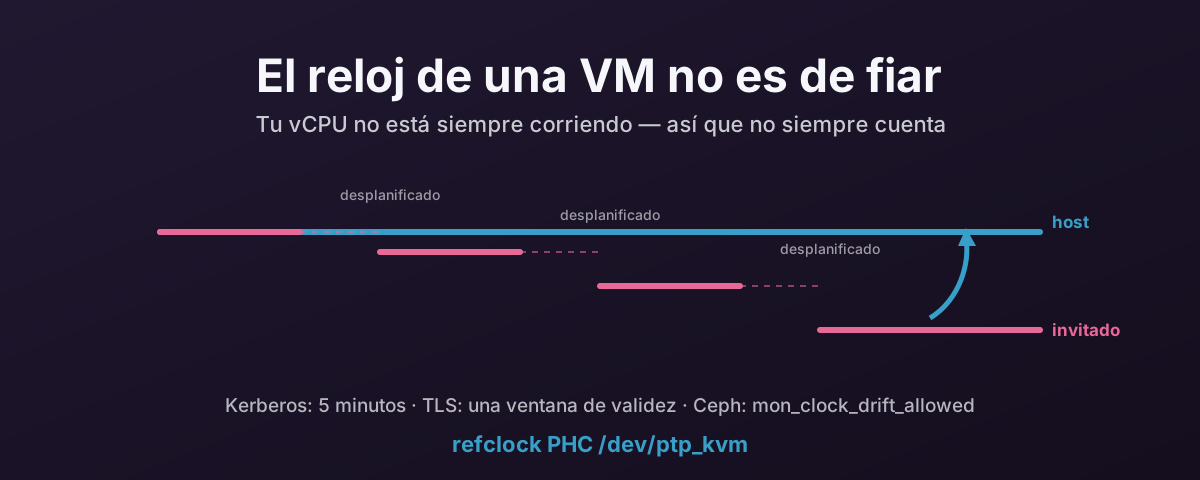
La suposición que hace todo reloj
El reloj de un ordenador funciona contando algo regular y confiando en que ese algo sigue contando. Un cristal oscila, un contador se incrementa, y el software calcula cuánto tiempo ha pasado.
La virtualización rompe la parte de confiar.
La documentación KVM del kernel sobre la medida del tiempo resume el problema en una frase: «the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption» — el sistema operativo virtual no corre usando el 100 % de la CPU, aunque bien puede suponer que sí. Todo lo que sigue se deriva de ahí.
Tu vCPU no está siempre corriendo
Una vCPU es un hilo en el host. Corre cuando el planificador del host lo dice.
Cuando no corre, el invitado no está simplemente ocioso — está ausente. No puede contar, no puede atender una interrupción de temporizador, y no tiene forma de saber cuánto tiempo estuvo fuera. El host lo contabiliza como steal time, que es el nombre honesto para «tiempo que te ocurrió a ti en vez de servirte».
Las interrupciones de temporizador son donde esto duele más. Un invitado que pide un tick periódico le está pidiendo al host que entregue interrupciones a cadencia fija, y el host no siempre puede obedecer. De nuevo la documentación del kernel: «the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind» — el motor de virtualización del host puede no ser capaz de entregar el número correcto de interrupciones por segundo, así que la hora del invitado se queda atrás.
Cuanto más alta la cadencia de tick, peor, y un host sobresuscrito lo empeora todavía más. Por eso también un host cargado degrada la hora de invitados tranquilos. Todos hacen cola para los mismos núcleos físicos.
Los contadores tampoco son tuyos
Si los ticks periódicos no son fiables, la respuesta evidente es leer un contador en su lugar. Eso tiene sus propios problemas.
El TSC es el rápido, y la documentación del kernel es franca al respecto: «The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times» — el TSC es un reloj local a la CPU en la mayoría de implementaciones, y los TSC de CPU distintas pueden arrancar en momentos distintos. Su cadencia puede variar con los estados de energía del procesador, y en piezas antiguas se detiene por completo cuando el núcleo se pone en reposo. Una vCPU que migra entre núcleos físicos puede por tanto leer un contador que no coincide con el que leyó un microsegundo antes.
Las alternativas son malas de otra forma. El HPET, el PIT y el temporizador ACPI PM son todos dispositivos emulados, así que cada lectura es una trampa hacia el hipervisor. Correcto, y lo bastante caro como para que un invitado que lea el reloj en un bucle apretado lo note.
Por eso existen los relojes paravirtuales. En KVM, kvm-clock deja que el host publique su propia medida del tiempo en una estructura compartida que el invitado lee directamente: sin trampa, sin conteo, sin suponer que el invitado estaba despierto.
También por eso deberías dejar en paz la clocksource del invitado en vez de forzar tsc o hpet porque un mensaje de foro dijera que era más rápido.
Migración, instantáneas y suspensión
La migración en vivo, la restauración de instantánea y la suspensión/reanudación le hacen todas lo mismo al reloj de un invitado: lo paran, y luego lo arrancan de nuevo en otro sitio.
Lo que el invitado ve no es deriva, es un salto. El reloj valía una cosa, y ahora vale otra, sin nada en medio. Migrar a un host cuyo TSC corre a otra frecuencia lo agrava.
Los saltos importan porque el software que corrige relojes está hecho para corregir deriva, no teletransporte.
Esto no es un problema de KVM
Es tentador leer todo lo anterior como un defecto de KVM. No lo es.
Todos los hipervisores llevan un reloj paravirtual, porque todos los hipervisores tienen el mismo problema estructural: KVM tiene kvm-clock, Hyper-V tiene su página TSC de referencia, VMware tiene un contador de rendimiento ficticio más una sincronización por las Tools, Xen tiene su pvclock. Son cuatro implementaciones independientes de un mismo apaño.
La conclusión de la propia documentación del kernel es que aquí no hay solución perfecta. Solo compromisos entre precisión, rendimiento y complejidad.
Si lo prefieres de labios de un fabricante en vez de desarrolladores del kernel, la frontera de soporte de Microsoft para la hora de alta precisión es notablemente franca. Para reclamar una precisión de 50 ms en un sistema Windows virtualizado, uno de los requisitos declarados es que «the one-day average CPU utilization of the host must not exceed 90%» — la utilización media de CPU del host en un día no debe superar el 90 %. Para 1 ms, el host debe mantenerse por debajo del 80 %.
Léelo otra vez: la precisión del reloj del invitado está documentada como condicionada por lo cargado que esté el host. Eso no es una rareza de Windows, es la misma física que describe la documentación del kernel, puesta por escrito como una frontera de soporte.
Por qué NTP dentro del invitado es la herramienta equivocada
NTP es bueno en aquello para lo que se diseñó: una máquina con un oscilador real que va un poco rápido o lento, corregida midiendo el ida y vuelta hacia un servidor remoto y ajustando suavemente el reloj local.
Cada una de esas suposiciones es frágil en una VM.
El oscilador local no está ligeramente mal, está intermitentemente ausente. La medida del ida y vuelta la toma un proceso que puede ser desplanificado entre leer el reloj y enviar el paquete, lo que corrompe la propia medida. Y las correcciones necesarias tras una migración son saltos, que un algoritmo de ajuste gradual maneja mal o rechaza de plano.
chrony se las apaña mucho mejor que ntpd aquí. Ajusta más rápido, tolera saltos, y es honesto sobre su propia incertidumbre. Pero sigue resolviendo el problema equivocado: tirar de la hora a través de una red desde un servidor de estrato 2 a 20 ms de distancia, cuando la hora correcta está posada en el hipervisor, al otro lado de una simple frontera de memoria.
Lo que obtienes en la práctica es un invitado casi siempre correcto, de vez en cuando desviado decenas o cientos de milisegundos, y nunca del todo capaz de decirte cuál.
Qué rompe de verdad el desfase
A nadie le importan los relojes por sí mismos. Le importan cuando algo deja de funcionar.
Kerberos y Active Directory
Kerberos depende del tiempo por diseño, porque la validez de un ticket se expresa como una ventana temporal.
La documentación del krb5.conf del MIT define clockskew como «the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid» — el desfase máximo en segundos que la biblioteca tolerará antes de dar por inválido un mensaje Kerberos, y el valor por defecto son 300 segundos, cinco minutos.
Cruza eso y la autenticación no se degrada, falla.
Como la autenticación de Active Directory es Kerberos, eso significa los inicios de sesión del dominio, net use, las conexiones a SQL Server, Exchange, los recursos compartidos de archivos — todo el lote.
Cinco minutos parecen generosos hasta que un invitado retrocede tras una restauración de instantánea.
TLS
Un certificado lleva una ventana de validez: notBefore y notAfter.
Un invitado cuyo reloj va atrasado rechazará un certificado emitido esta mañana porque, por lo que él sabe, el certificado aún no es válido.
Un invitado cuyo reloj va adelantado rechazará uno que en realidad no ha caducado.
La misma aritmética gobierna la frescura de OCSP y CRL, las reclamaciones nbf/exp de los JWT, y los códigos TOTP de la autenticación multifactor, que viven en ventanas de 30 segundos.
Un reloj desfasado 45 segundos es una caída de autenticación con un mensaje de error muy confuso.
Ceph
Los monitores de Ceph se preocupan por esto más que por casi nada más en la pila, porque su consenso depende de ello.
El chequeo de salud MON_CLOCK_SKEW salta cuando «the clocks on hosts running Ceph Monitor daemons are not well-synchronized» — los relojes de los hosts que ejecutan demonios Ceph Monitor no están bien sincronizados. En concreto, cuando el desfase supera mon_clock_drift_allowed.
El consejo de la documentación es sincronizar con ntpd o chrony contra varias fuentes, y señala que la sincronización entre monitores importa de forma particular.
Puedes subir mon_clock_drift_allowed, pero la documentación es clara: tiene que quedar «significantly below the mon_lease interval» — muy por debajo del intervalo mon_lease. Como tal, es un presupuesto pequeño, y gastarlo para tapar un problema de medida del tiempo del hipervisor no es un buen trato.
Todo lo demás
Los registros de varios hosts dejan de correlacionar, lo que convierte la cronología de un incidente en adivinanza. La replicación de bases de datos y el consenso distribuido — etcd, Galera, cualquier cosa que haga arrendamientos de líder — se ponen de mal humor. Las ventanas de copia de seguridad y de supervisión se desalinean de aquello que debían observar.
Los invitados Windows se desfasan de otra forma
Windows merece su propia nota, porque su servicio de tiempo se construyó con otros objetivos y se nota.
Microsoft dice sin rodeos que las versiones anteriores a Windows 10 1607 / Server 2016 «can’t guarantee highly accurate time» — no pueden garantizar una hora de alta precisión. Lo que el servicio de tiempo de Windows ofrecía en esas versiones era «the necessary time accuracy to satisfy Kerberos version 5 authentication requirements» — la precisión de hora necesaria para satisfacer los requisitos de autenticación de Kerberos versión 5, y una hora «loosely accurate», vagamente precisa, para las máquinas de un mismo bosque AD. Más ajustado que eso quedaba «outside of the design specification… and weren’t supported» — fuera de la especificación de diseño, y sin soporte.
Dicho de otro modo, el Windows antiguo aspira a quedarse dentro de la ventana Kerberos de cinco minutos, no a ser exacto. Lo cual va muy bien hasta que algo en tu parque necesita más. Una máquina Windows virtualizada desfasada 90 segundos se autenticará sin rechistar mientras escribe registros que no se pueden correlacionar con nada.
Windows 10 y Server 2016 en adelante saben hacer 1 s, 50 ms o incluso 1 ms — pero solo bajo las condiciones citadas antes, incluidos los límites de utilización de CPU del host. Microsoft también señala que «anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy» — cualquier cosa que introduzca asimetría de red, como un enlace por satélite unidireccional o una carga de CPU alta en el sistema de destino, perjudicará la precisión. Una vCPU en disputa es una carga de CPU alta en el sistema de destino con otro nombre.
No hay ptp_kvm para Windows. Lo que tienes en su lugar:
- Los enlightenments de reloj de Hyper-V. Proxmox ya se los expone a los invitados Windows.
PVE::QemuServer::CPUConfigponehv_timejunto ahv_vapic,hv_spinlocks,hv_relaxedyhv_synic.hv_timees el reloj paravirtual, y es el equivalente del lado Windows dekvm-clock. Está activo por defecto para las VM tipadas como Windows; no hay nada que habilitar. - El agente invitado de QEMU. Con el agente instalado, el host puede empujar su hora dentro del invitado tras una reanudación o una restauración de instantánea, lo que cubre el caso del salto, el que NTP maneja peor.
- Elige una sola autoridad. El fallo clásico de Windows en una VM son dos fuentes de tiempo peleándose: la sincronización host-a-invitado y la sincronización por la jerarquía del dominio, ambas corrigiendo el mismo reloj en sentidos contrarios. Para un invitado unido al dominio, deja que gane la jerarquía del dominio y detén al host de empujarle la hora. Para un invitado autónomo, la sincronización por el host va bien. Nunca las dos.
Si quieres saber exactamente qué le cuenta tu hipervisor a una VM dada sobre el tiempo, pregúntaselo en vez de adivinar:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
El arreglo en QEMU/KVM: ptp_kvm
Para los invitados Linux en KVM hay una respuesta como es debido, y no es «más servidores NTP».
ptp_kvm deja que el invitado le pregunte al host qué hora es, directamente, a través de un hypercall — KVM_HC_CLOCK_PAIRING en x86, y una llamada de firmware equivalente en arm64.
El kernel lo presenta como un dispositivo de reloj hardware PTP, así que desde el espacio de usuario parece cualquier otra fuente de reloj de precisión, y chrony puede usarlo como reloj de referencia.
Las propiedades que importan:
- Sin red. Sin jitter, sin asimetría, sin estrato, sin paquetes. El camino es una frontera de memoria.
- Por debajo del microsegundo. La precisión la acota el hypercall, no un ida y vuelta a través de un centro de datos.
- Sortea la parte rota. El invitado no cuenta nada ni estima ningún ida y vuelta. Lee un valor que el host calculó con un reloj que sí estuvo corriendo todo el rato.
Implementación
Aplica esto a toda VM Linux que tenga el controlador. El hipervisor host necesita un NTP o un PTP que funcione, por su parte. ptp_kvm le entrega al invitado la hora del host, así que hereda el error del host.
1. Cargar el módulo del kernel al arrancar.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Darle un nombre estable y dejar que chrony lo lea.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
El enlace simbólico importa porque la numeración de dispositivos PTP no es estable. /dev/ptp0 puede ser el reloj de una NIC en un arranque y el reloj KVM en el siguiente. Filtrar por clock_name atrapa el correcto cada vez.
3. Apuntar chrony hacia él, y quitar los pools.
Edita /etc/chrony/chrony.conf en Debian y Ubuntu, o /etc/chrony.conf en la familia RHEL. Borra las líneas pool y usa:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Quitar los pools no es una limpieza opcional. Dejarlos le pide a chrony que reconcilie una referencia local por debajo del microsegundo contra servidores de internet a decenas de milisegundos, y las fuentes de internet solo pueden empeorar la respuesta.
4. Reiniciar y comprobar.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Verificación
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
En chronyc sources, la refclock PHC aparece como #* PHC0 una vez seleccionada. El # marca una referencia hardware local en vez de un par de red, y el * marca la que está en uso.
Si la ves listada pero no seleccionada, chrony no la ha aceptado: comprueba los permisos del dispositivo y que el grupo chrony de la regla udev coincide con el usuario bajo el que chrony corre realmente en tu distribución.
Salvedades
- El host tiene que estar bien. Esto pone al invitado de acuerdo con el host, lo cual solo sirve si el host está de acuerdo con la realidad. Dales a los hipervisores NTP o PTP de verdad.
- Todos los invitados lo necesitan. Un parque donde la mitad de las VM usan
ptp_kvmy la otra mitad pools de internet es un parque con dos autoridades de tiempo. - La migración en vivo va bien, y es el objetivo. Tras migrar, el invitado lee el reloj de su nuevo host. Siempre que los hosts estén de acuerdo entre sí, el invitado nunca ve un salto.
- Solo KVM. Es un hypercall de KVM. Los hipervisores anidados o ajenos no presentarán el dispositivo, y la regla udev simplemente no se disparará. Eso es un fallo limpio en vez de una respuesta silenciosamente equivocada.
Qué no hacer
- No fuerces la clocksource. Deja
kvm-clocken paz. Forzartscohpeten la línea de comandos del kernel del invitado cambia un reloj paravirtual diseñado para esta situación por un contador que nunca fue tuyo. - No lances
ntpdatenihwclockdesde cron. Eso es un salto de reloj a hora fija, exactamente lo que odian las bases de datos y Kerberos. - No mantengas los pools «como respaldo». Con una refclock que funciona no son un respaldo, son una segunda opinión de una fuente peor.
- No subas
mon_clock_drift_allowedy lo des por arreglado. Has gastado parte de un presupuesto que existe para la realidad de la red, con tal de tolerar un problema cuya solución es conocida.
Ese último merece decirse claro: ensanchar el umbral no arregla el reloj. Mueve la alarma para que deje de sonar.
Referencias
- Linux kernel — KVM timekeeping — por qué la hora del invitado se queda atrás, el problema de reloj local del TSC, y la conclusión de que solo existen compromisos
- Linux kernel — PTP_KVM — la interfaz de hypercall tras el dispositivo de reloj PTP
- Linux kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, el lado x86 de la cosa - chrony — chrony.conf — la directiva
refclocky las opciones del controlador PHC - MIT Kerberos — krb5.conf —
clockskewy su valor por defecto de 300 segundos - Microsoft — support boundary for high accuracy time — los objetivos de precisión, y las condiciones de utilización de CPU del host para sistemas virtualizados
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowedy su relación conmon_lease