Menos bytes llegan a la unidad
VDO es la capa de deduplicación y compresión del kernel de Linux. Se coloca bajo un grupo de volúmenes y trabaja en bloques de 4 KiB. Cada bloque que ya ha visto antes lo guarda una sola vez.
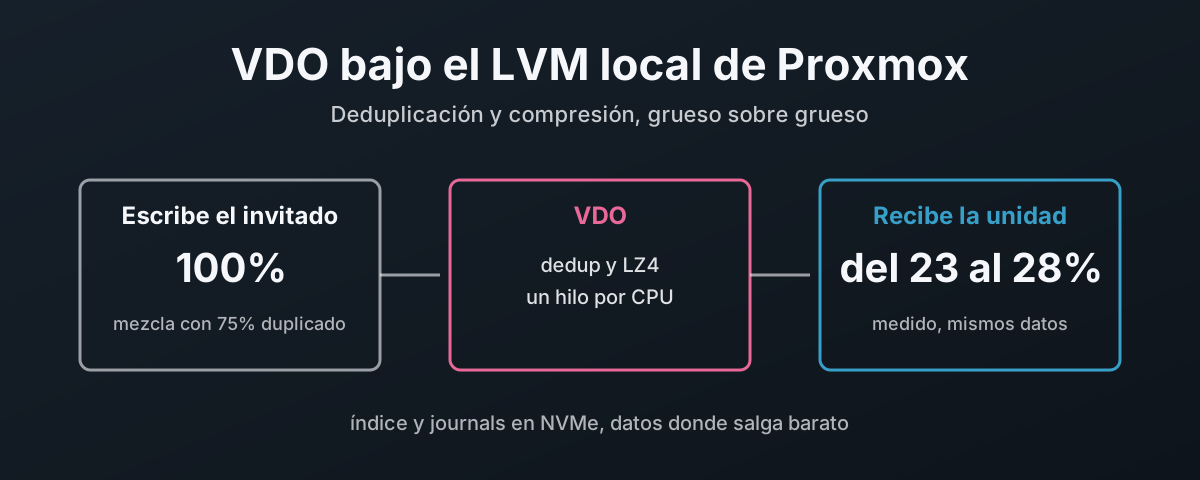
Lo que eso significa para el hardware es sencillo. A la unidad llegan menos bytes. Escribí a través de VDO una mezcla con un 75% de duplicados y un 50% comprimible, 30 segundos cada vez, y los contadores de la propia unidad dijeron que recibió del 23 al 28% de lo que escribió el invitado. Seis clones completos de un disco de plantilla añadieron 8 bloques de datos entre todos. Treinta y dos kilobytes.
Menos bytes es menos desgaste, y menos trabajo para cualquier caché de la unidad o de la controladora que tenga delante. Para llegar ahí cuesta CPU y latencia, y en una unidad rápida ese coste se mide más abajo frente a la misma Optane sin VDO. En discos mecánicos lentos ese mismo coste desaparece dentro de los tiempos de búsqueda, y ahí es donde esto se pone interesante.
Dos reglas dan forma a todo lo que sigue. La pila es grueso sobre grueso (thick on thick): nada por encima de VDO, ni el propio VDO, puede prometer más espacio del que tiene la unidad. Y los metadatos propios de VDO, su índice y sus journals, pueden vivir en NVMe mientras los datos viven en algo más lento.
Cada número de aquí sale de un único host Proxmox VE 9.2, un Ryzen 7 5700G con 16 CPUs, kernel 7.0.14-25-pve, LVM 2.03.31 y las herramientas vdo 8.3.1.1 de Debian, sobre dos unidades Intel Optane que se borraron después.
Qué es VDO y dónde se coloca
El kernel describe dm-vdo como un target de device-mapper que «provides block-level deduplication, compression, and thin provisioning»1. Cada bloque de 4 KiB que entra se pasa por un hash. Si ya hay guardado un bloque idéntico, VDO apunta una referencia en lugar de una copia. Los bloques que no son duplicados pasan por LZ4 y se empaquetan varios en un bloque físico, y los bloques que son todo ceros no se guardan en absoluto2.
LVM lo maneja todo.
lvcreate --type vdo crea un VDO pool, que guarda los bloques reales, y encima un VDO LV con el tamaño virtual que le pidas2.
Sobre el VDO LV va un grupo de volúmenes grueso, y Proxmox lo usa como almacenamiento lvm normal.
| Capa | Nombre en el laboratorio | Qué hace |
|---|---|---|
| Discos de VM | vm-9901-disk-0 y demás | LVs gruesos, creados por Proxmox |
| Grupo de volúmenes | vdovg, 35 GiB | LVM normal, lo que lee el almacenamiento lvm de Proxmox |
| VDO LV | vdolab/vdolv, 35 GiB virtuales | dedup, LZ4, bloques a cero descartados |
| VDO pool | vdolab/vdopool, 40 GiB | los bloques reales, los metadatos y el índice de VDO |
| Físico | nvme8n1 | VG vdolab |
Grueso sobre grueso, o nada
VDO es un aprovisionador fino por derecho propio: al VDO LV se le puede dar cualquier tamaño virtual. Hazlo más grande de lo que cabe en el pool y el grupo de volúmenes de encima es grueso sobre una promesa, que es fino sobre fino bajado una capa. Eso mismo hice en el primer montaje, un VDO LV de 120 GiB sobre un pool de 40 GiB, y Proxmox mostraba un tercio del almacenamiento libre mientras VDO estaba lleno.
Así que dimensiona el VDO LV a lo que el pool puede direccionar de verdad, ni un byte más.
lvcreate imprime esa cifra, «can address 36.00 GB» en este pool de 40 GiB, y el block map de VDO para el espacio lógico sale del mismo sitio, así que le di 35 GiB.
Luego lo demostré por las malas. Un disco de VM que se quedó con todos los extents que Proxmox quiso darle, 34 GiB, lleno de punta a punta con datos aleatorios con los que VDO no puede hacer nada:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
El disco se acabó en su propio final, como debe hacer un disco grueso. A VDO todavía le quedaban 1.9 GiB libres, más que el 1 GiB que a Proxmox le quedaba por asignar. La cifra de Proxmox es el límite real, y VDO no puede quedarse sin espacio antes.
Lo que pierdes es el sobrecompromiso: el espacio que ahorra la deduplicación aparece como unidad que nunca se escribe, no como discos de más para Proxmox. Es el intercambio correcto para este post, que va del hardware. Y tampoco pongas encima un pool lvmthin. Dos capas finas son dos libros de cuentas3.
Lo que cuesta antes de guardar un solo byte
VDO mantiene un índice de deduplicación, el índice UDS, en el propio pool.
Un pool vacío de 40 GiB marcaba 4.0 GiB usados y 36.0 GiB disponibles.
vdolistmetadata, del mismo paquete vdo, lista cada bloque de metadatos del dispositivo y da cuenta de casi todo:
| Región | Bloques de 4 KiB | Tamaño |
|---|---|---|
| Índice UDS | 679 127 | 2.59 GiB |
| Recovery journal | 32 768 | 128 MiB |
| Contadores de referencias y journals, 18 slabs | 6 372 | 25 MiB |
| Espacio demasiado pequeño para un decimonoveno slab | 336 555 | 1.28 GiB |
| Total | unos 4.0 GiB |
Vale la pena conocer la línea del sobrante: los slabs son de 2 GiB, así que dimensiona el pool en slabs enteros más la sobrecarga o el resto simplemente no se usa.
La RAM es la otra factura. Se paga tanto si el pool está ocupado como si está parado:
| Coste | Regla de lvmvdo(7) | Este pool de 40 GiB |
|---|---|---|
| Fijo | 38 MiB | 38 MiB |
| Caché del block map | 1.15 MiB por MiB de caché, mínimo 150 MiB | 150 MiB (128 MiB por defecto) |
| Espacio físico | 268 MiB por TiB | 11 MiB |
| Índice UDS (denso) | mínimo 250 MiB, el valor por defecto | 256 MiB |
| Total | unos 455 MiB |
El índice denso por defecto cubre una ventana de deduplicación de unos 256 GiB, ya que un índice denso con 1 GiB de RAM «maintains a 1 TiB deduplication window»2. La caché del block map de 128 MiB está dimensionada para «efficient access to 100 GB of logical space at a time», y la documentación del kernel la señala como el valor más importante que ajustar a medida que crece el conjunto de trabajo1.
Montar la pila
Que LVM vea un PV sobre un LV
El grupo de volúmenes está sobre un LV, y por defecto LVM ignora los LVs como volúmenes físicos.
devices/scan_lvs lo activa, y la referencia de LVM trae la advertencia que va con ello: «Caution is required to avoid using PVs that belong to guest images stored on LVs»4.
De otro modo, a un invitado que use LVM dentro de su propio disco le aparecerían sus grupos de volúmenes en el host.
Así que el filtro también cambia. En la misma edición. El filtro de serie de este host solo rechazaba los zvols de ZFS y los dispositivos RBD. Añadí un rechazo para cada disco de VM de Proxmox:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
La misma referencia dice que scan_lvs «does not enable autoactivation of layered VGs»4.
Proxmox no lo necesita. Su plugin de LVM activa cada disco con lvchange -aey cuando arranca la VM5.
Lo probé tal como deja las cosas un arranque, todo desactivado y luego las mismas ejecuciones de pvscan desde udev: el VG bajo VDO subió, y qm start activó él solo el disco de la VM.
La trampa está debajo. Con el VG bajo VDO incompleto, el mismo qm start falló con «Volume group “vdovg” not found».
El VDO pool, grueso, con sus ajustes en la línea de creación
El formateador está en el paquete vdo de Debian6:
# apt install vdo
Después el pool.
-L es el espacio real, -V el tamaño virtual, dentro de lo que el pool puede direccionar.
La disposición de hilos y el tamaño de discard van en la misma línea, porque ninguno de los dos se puede cambiar después sin parar todas las VMs del pool:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
La disposición de hilos es la que se mide más abajo para un host de 16 CPUs; max_discard=4096 tiene su propia sección.
El grupo de volúmenes y el almacenamiento de Proxmox
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 importa, y se trata más abajo.
Lo que ahorró la deduplicación
Escribí cosas que un host Proxmox guarda de verdad y leí los contadores de bloques de VDO después de cada una.
logical blocks used es lo que escribieron las capas de encima; data blocks used es lo que guardó VDO. Los dos en bloques de 4 KiB.
| Lo que se escribió | Bloques lógicos añadidos | Bloques de datos añadidos | Ahorro |
|---|---|---|---|
| Rootfs de Rocky Linux 10, ext4 en un disco de 4 GiB | 114 505 | 60 537 | 47% |
Seis clones completos (qm clone --full, unos 4 s cada uno) | 6 291 456 | 8 | 99.9999% |
| ISO de Proxmox Datacenter Manager 1.1, 1.36 GiB | 356 172 | 351 965 | 1.2% |
Su reconstrucción -auto, prácticamente los mismos bytes | 356 399 | 40 | 99.99% |
| 4 GiB de ceros | 1 048 575 | 0 | 100% |
| 1 GiB de datos aleatorios | 262 143 | 262 144 | 0% |
Cada clon escribió los 4 GiB enteros, ceros incluidos, porque un clon completo sobre un LV grueso copia todos los bloques. VDO guardó los ceros como nada y el resto como referencias.
VDO es muy bueno con los datos que ya ha visto. Y con la nada. No sirve para nada con datos que ya están comprimidos o cifrados, y por eso la primera ISO, casi toda squashfs, ahorró un 1.2%.
Con la plantilla y sus seis clones en su sitio, Proxmox mostraba el almacenamiento al 80.01% de uso, 28 GiB de discos gruesos de 35. La unidad guardaba 4.3 GiB, y casi todo era el índice. En almacenamiento grueso esa es la gracia: Proxmox cuenta lo que se ha asignado, y la unidad carga con lo que es realmente distinto.
Lo que recibe de verdad la unidad
El ahorro en disco es una foto fija. Al hardware le importa el flujo.
Así que medí los bytes que llegaban a la unidad mientras se escribía: fio durante 30 segundos, el contador de escritura de la unidad en /sys/block antes y después, la misma Optane con VDO y sin él, dos veces cada una.
El contador es honrado. En toda la prueba sumó 794 GB, y el propio «Data Units Written» de SMART de la unidad se movió también 794 GB.
| Carga, 30 s | Sin VDO | Con VDO, 16 hilos | Bytes que llegan a la unidad |
|---|---|---|---|
| Escritura aleatoria 4k, QD32, 4 jobs, 75% dup, 50% compresión | 582 013 IOPS, p99 244 µs | 460 887 IOPS, p99 1.05 ms | 28% |
| Escritura 128k, QD8, 75% dup, 50% compresión | 2 345 MiB/s, p99 490 µs | 2 179 MiB/s, p99 1.02 ms | 23% |
| Escritura aleatoria 4k, QD32, 4 jobs, datos aleatorios | 571 721 IOPS | de 272 366 a 381 005 IOPS | del 59 al 100% |
| Escritura 128k, QD8, datos aleatorios | 2 346 MiB/s | de 1 051 a 1 854 MiB/s | 100% |
Con una mezcla realista, VDO conservó entre el 79 y el 93% del rendimiento de la unidad desnuda y le mandó una cuarta parte de los bytes. Con datos completamente aleatorios no ahorra nada y cuesta mucho, y las dos pasadas discreparon tanto que solo doy el rango.
La latencia de cola es el procesamiento propio de VDO, no la unidad. Un p99 de alrededor de un milisegundo, frente a un cuarto de milisegundo sin nada.
La Optane no tiene caché que aliviar
Estas unidades lo dicen ellas mismas: vwc 0 en nvme id-ctrl, write through en /sys/block.
Una Optane escribe in situ sin DRAM ni SLC de paso, así que en este hardware lo que se gana son los bytes y el desgaste, no una caché de unidad que tarda más en llenarse.
Una SSD NAND con caché SLC, o una controladora RAID con caché write-back, es donde menos bytes compra también capacidad de respuesta. Esa es la sección de RAID6 de más abajo.
Ajustar los hilos de VDO a las CPUs
De serie, LVM le da a VDO diez hilos: uno lógico, uno físico, una zona de hash, dos de CPU, cuatro de envío bio, uno de acuse. En un host de 16 CPUs eso deja ociosa la mayor parte de la máquina mientras el trabajo del block map de VDO hace cola detrás de un solo hilo lógico.
La documentación del kernel explica los mandos1. Cada hilo lógico es dueño de «a disjoint section of the block map», cada hilo físico de «a disjoint section of the data blocks», y ambos «can increase throughput», mientras que los hilos de más «can waste resources and increase contention». Los hilos lógicos llegan hasta 60, los físicos hasta 16, y el pool necesita al menos un slab por hilo físico. Con 18 slabs este tiene margen.
| Disposición | logical | physical | hash | cpu | bio | ack | Total |
|---|---|---|---|---|---|---|---|
| Valores por defecto de LVM | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Ajustada a 16 CPUs | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| El doble | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Cada disposición pasó las mismas tareas de fio dos veces, intercaladas, con datos aleatorios, más los siete discos clon leídos a la vez, como cuando arrancan siete VMs juntas:
| Prueba, media de dos pasadas | Por defecto | Ajustada a 16 CPUs | El doble |
|---|---|---|---|
| Escritura aleatoria 4k, QD32, 4 jobs | 292 466 IOPS | 365 314 IOPS | 302 461 IOPS |
| p99 de escritura aleatoria 4k, 4 jobs | de 2.1 a 3.7 ms | de 1.5 a 1.6 ms | de 2.1 a 2.2 ms |
| Escritura secuencial 1M | 1 153 MiB/s | 1 729 MiB/s | 1 507 MiB/s |
| Lectura aleatoria 4k, QD32, 4 jobs | 507 450 IOPS | 503 827 IOPS | 485 263 IOPS |
| Siete discos clon leídos a la vez | 7.5 s | 3.1 s | 3.4 s |
Ajustada al número de CPUs gana en casi todo: una cuarta parte más de escrituras en paralelo, la mitad más en escrituras secuenciales, siete discos leídos 2.4 veces más rápido y una cola más ajustada. Volver a doblarla es peor en todo. Esa es la contención contra la que avisa la documentación. Los valores por defecto fueron además los menos estables, con la lectura de siete discos oscilando entre 6.1 y 8.8 s de una pasada a otra.
Así que la regla es un hilo de VDO por CPU, repartidos entre los tipos como arriba, con los hilos físicos limitados por el número de slabs.
Lo que cuesta VDO en hardware rápido
La misma Optane sin VDO, frente a VDO con los hilos ajustados, datos aleatorios, media de dos pasadas:
| Prueba | Optane, sin VDO | VDO, 16 hilos |
|---|---|---|
| Escritura aleatoria 4k, QD1 | 42 294 IOPS, 19.4 µs | 55 806 IOPS, 12.1 µs |
| Escritura aleatoria 4k, QD32 | 142 416 IOPS | 144 292 IOPS |
| Escritura aleatoria 4k, QD32, 4 jobs | 572 293 IOPS | 365 314 IOPS |
| Lectura aleatoria 4k, QD1 | 55 276 IOPS, 14.4 µs | 27 988 IOPS, 31.4 µs |
| Lectura aleatoria 4k, QD32, 4 jobs | 586 463 IOPS | 503 827 IOPS |
| Escritura secuencial 1M, QD8 | 2 348 MiB/s | 1 729 MiB/s |
| Siete discos de plantilla leídos a la vez | 11.1 s | 3.1 s |
Léelo sin rodeos. Una sola lectura aleatoria tarda más del doble a través de VDO. Las escrituras aleatorias en paralelo pierden más de un tercio, las secuenciales una cuarta parte. En una unidad así de rápida, los 17 µs de trabajo extra de VDO por lectura son la mayor parte de la lectura.
Que la escritura QD1 sea más rápida a través de VDO no sale gratis. Ni de lejos. VDO confirma una escritura antes de que esté en la unidad, y la documentación del kernel es clara en que «unflushed writes may or may not persist after a crash»1. Ese número mide un acuse. Un invitado que hace flush, como hacen todos los sistemas de ficheros, obtiene la durabilidad que pide.
La línea de los siete discos es la que VDO gana sin discusión, y conviene tener claro por qué. Siete copias normales tienen que leer 28 GiB de bytes reales, ceros incluidos. VDO lee un único juego de bloques compartidos y se salta los ceros.
Así que en flash rápida, VDO cambia latencia por bytes. Pero cada uno de esos microsegundos es un coste fijo, y no crece cuando la unidad de debajo se vuelve más lenta.
Poner los metadatos de VDO en NVMe
VDO no tiene un dispositivo de metadatos aparte. Todo vive en el único LV del pool. Pero el código fuente de dm-vdo muestra que la disposición es fija, y un LV se puede montar con trozos en unidades distintas.
El código de formateo coloca las raíces del block map desde el principio de la región de datos, después el slab summary y el recovery journal desde el final, y rellena el centro con slabs7.
El índice UDS va antes que todo, justo después del bloque de geometría.
vdolistmetadata lo confirmó en el pool del laboratorio:
| Bloques | Qué | Dónde está |
|---|---|---|
| 0 a 679 188 | geometría, índice UDS, super block, raíces del block map | los primeros 2.59 GiB |
| dentro de cada slab de 2 GiB | datos, hojas del block map, 130 bloques de referencias y un slab journal de 224 bloques | repartidos por el pool |
| 10 452 928 a 10 485 695 | recovery journal | los últimos 128 MiB, casi |
| 10 485 696 a 10 485 759 | slab summary | los últimos 256 KiB del todo |
Así que monta el LV del pool en tres trozos: la cabeza en NVMe, el centro en la unidad lenta, la cola en NVMe.
Después conviértelo en un VDO pool, cosa que lvmvdo(7) documenta para un LV existente2.
Aquí nvme6n1 hace de NVMe y nvme8n1 de unidad lenta:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Después comprueba que VDO puso sus metadatos donde están los extents:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Un extent son 1 024 bloques. La cabeza en NVMe son los extents 0 a 767, bloques 0 a 786 431, que cubren el índice y las raíces, con unos 420 MiB de datos del primer slab de propina. La cola en NVMe son los extents 10 176 a 10 239, bloques 10 420 224 en adelante, que cubren el recovery journal y el slab summary.
Cuánto del trabajo de VDO se va con ellos, por pasada de 30 segundos, contado por dispositivo:
| Carga | E/S de escritura en NVMe | E/S de escritura en la unidad de datos | Parte de NVMe |
|---|---|---|---|
| Escritura aleatoria 4k, 75% dup, 50% compresión | de 388 430 a 538 223 | de 3.42 a 3.63 millones | del 10 al 13% |
| Escritura 128k, 75% dup, 50% compresión | de 458 214 a 634 167 | de 3.30 a 3.53 millones | del 12 al 15% |
| Escritura aleatoria 4k, datos aleatorios | de 181 457 a 384 507 | de 3.25 a 8.49 millones | del 4 al 5% |
| Lectura aleatoria 4k | 0 escrituras, 2% de las lecturas | 0 |
Más o menos una décima parte de las operaciones de escritura: el recovery journal, las actualizaciones del índice y esa porción del slab 0 en la cabeza en NVMe. Son escrituras de metadatos pequeñas y dispersas, justo las que peor lleva un disco mecánico. En NVMe no son nada.
Dos límites.
Los metadatos de cada slab, contadores de referencias, slab journals y hojas del block map, viven dentro de los slabs y se quedan con los datos.
Y no probé a hacer crecer un pool dividido. El journal se coloca desde el final, así que después de cualquier lvextend vuelve a ejecutar vdolistmetadata y mira adónde ha ido antes de fiarte.
VDO sobre bcache: una NVMe, dos trabajos
bcache es la otra forma de poner flash delante de discos lentos. Es lo que ya uso bajo Ceph en discos mecánicos, con cada ajuste explicado en el post de bcache. Así que la pregunta es qué le hace VDO a una caché bcache cuando se pone encima de ella.
Una sola NVMe hace los dos trabajos de flash, dividida en dos particiones:
| Dispositivo | Tamaño | Trabajo |
|---|---|---|
nvme8n1p1 | 32 GiB | caché de bcache, writeback |
nvme8n1p2 | 8 GiB | cabeza y cola de VDO: índice, raíces, recovery journal, slab summary |
nvme6n1 | 349 GiB | dispositivo de respaldo de bcache, donde viven los datos |
/dev/bcache0 | 349 GiB | el centro del VDO pool, los slabs |
Las dos unidades vuelven a ser Optane, así que nvme6n1 hace las veces de disco mecánico.
Tenlo presente en cada cifra de abajo. Aquí el dispositivo de respaldo es rápido, así que esto mide lo que llega a la caché, no cuánto tarda un disco mecánico en vaciarla.
Las particiones y el cache set, con los ajustes de ese post:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Esas líneas echo duran hasta el siguiente reinicio. La regla de udev del post de bcache es como se quedan fijas.
Después el pool, dividido igual que arriba, con nvme8n1p2 para los dos extremos y bcache0 para el centro:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata imprimió los mismos rangos de bloques que el montaje dividido, así que el índice y los dos journals están en nvme8n1p2.
vdovg y el almacenamiento de Proxmox van encima exactamente igual que antes.
Lo que llega a la caché
La comparación es un LV de 8 GiB directamente sobre bcache0 frente a un LV de 8 GiB en vdovg, las mismas tareas de fio durante 30 segundos, dos veces, con la caché vaciada y limpia entre cada pasada.
Los contadores de dispositivo de /sys/class/block dicen adónde fueron los bytes.
| 75% dup, 50% compresión, 30 s | Solo bcache | VDO sobre bcache |
|---|---|---|
| Escritura aleatoria 4k, QD32, 4 jobs | 212 222 y 205 585 IOPS | 390 206 y 304 757 IOPS |
| p99 | 1.89 y 2.04 ms | 1.45 y 2.54 ms |
| Escrito por el invitado | 24.29 y 23.53 GiB | 44.67 y 34.88 GiB |
| Escrito en la caché de bcache | 25.00 y 24.26 GiB | 11.48 y 10.44 GiB |
| Escrito en la partición de metadatos de VDO | 1.18 y 0.59 GiB | |
| Escrituras en caché por byte del invitado | 103% | 26 y 30% |
| Sucio en la caché al final | 6.0 y 6.5 GiB | 5.5 y 5.2 GiB |
| Escritura 128k, QD8 | 2 001 y 1 985 MiB/s | 1 878 y 1 416 MiB/s |
| Escrituras en caché por byte del invitado, 128k | 101% | 24 y 27% |
bcache por su cuenta tocó techo en unas 210 000 escrituras pequeñas por segundo, y escribió cada byte en la caché más un 3% suyo. Pon VDO delante y la caché recibió una cuarta parte de los bytes. En la primera pasada esa misma caché aguantó entonces 390 206 escrituras por segundo, casi el doble, y aun así terminó con menos datos sucios esperando a la unidad lenta. El límite era la caché. VDO lo movió.
La segunda pasada es la honrada para un pool que ya ha estado en uso. fio siembra sus generadores igual en cada pasada por defecto8, así que la segunda pasada escribió datos que el índice ya había visto, apuntando a bloques que entretanto se habían descartado. VDO trata el índice como pistas y lee cada bloque candidato para comprobar que es de verdad un duplicado antes de compartirlo9. Durante una prueba solo de escritura, esa segunda pasada leyó 7.11 GiB de vuelta de la caché y 1.20 GiB de la unidad de datos. La primera leyó 0.12 GiB. Un consejo caducado no sale gratis, y en un pool donde las VMs van y vienen siempre habrá algo.
Los datos aleatorios son la otra cara:
| Datos aleatorios, 30 s | Solo bcache | VDO sobre bcache |
|---|---|---|
| Escritura aleatoria 4k, QD32, 4 jobs | 205 984 y 203 066 IOPS | 203 186 y 85 882 IOPS |
| p99 | 2.04 y 2.15 ms | 5.7 y 17.7 ms |
| Escritura 128k, QD8 | 2 038 y 2 017 MiB/s | 878 y 357 MiB/s |
| Lectura aleatoria 4k, QD1 | 36 609 y 36 639 IOPS, 21.6 µs | 26 345 y 26 202 IOPS, 33.6 y 33.7 µs |
| Lectura aleatoria 4k, QD32, 4 jobs | 471 585 y 471 730 IOPS | 335 461 y 336 941 IOPS |
No hay nada que ahorrar, así que VDO es sobrecarga pura, y en la pasada con el índice caducado dejó las escrituras pequeñas en menos de la mitad. Todas las lecturas de las dos columnas salieron de la caché. Los 12 µs de VDO encima son el mismo coste fijo que añade sobre la Optane desnuda.
Así que donde los datos se repiten, los dos se apilan bien. La caché recibe una cuarta parte de los bytes, aguanta una ráfaga más tiempo y tiene menos que volcar a los discos mecánicos. Donde no se repiten, bcache está mejor solo.
Sobre RAID6 hardware de HDD: razonado, no medido
No tengo ningún host con RAID6 de HDD en el que probar, así que esta sección es razonamiento apoyado en las mediciones de arriba. Mide tu propio array antes de fiarte de ella.
| Sobre RAID6 de HDD | Lo que cambia VDO |
|---|---|
| Escrituras que llegan al array | más o menos una cuarta parte, con una mezcla como la medida |
| Caché write-back de la controladora | se llena a una cuarta parte del ritmo, así que aguanta una ráfaga unas cuatro veces más |
| Coste de CPU de VDO | 17 µs por lectura, perdidos dentro de un seek de 5 a 10 ms |
| Escrituras del recovery journal | más o menos una décima parte de la E/S de escritura, pequeñas y con flush: ponlas en NVMe |
| Búsquedas en el índice | vigila dedupe advice timeouts en vdostats; en almacenamiento lento VDO puede dejar de buscar y escribir el duplicado igualmente |
| Leer un clon de principio a fin | más lento: sus bloques apuntan a los de la plantilla, desperdigados por el array |
Las dos primeras líneas son la respuesta del hardware. Mientras la caché con batería o con flash de la controladora tiene sitio, el invitado ve la latencia de la caché. Cuando se llena, el invitado ve los discos. Mándale una cuarta parte de los bytes y la misma caché da unas cuatro veces más margen, y tiene una cuarta parte de lo que vaciar. La sección de bcache de arriba es eso mismo medido, con una caché por software en lugar de la de la controladora.
La tercera es por qué VDO pinta más en discos lentos que en rápidos. En la Optane, VDO dobló la latencia de lectura. En unidades de 7 200 rpm ese mismo coste fijo desaparece dentro de un solo seek.
Las tres últimas son los costes. Una tormenta de arranques de clones idénticos va más rápida, pero un clon leído de punta a punta va más lento, porque la deduplicación lo desperdiga. Y las propias escrituras pequeñas de VDO también acaban en el array, que es el argumento para la disposición dividida de arriba: índice y journal en NVMe, slabs en el RAID6.
Borrar un disco: haz que Proxmox lo descarte
Eliminar un LV libera sus extents en LVM. No le dice a VDO que los bloques ya no se usan, así que VDO se los queda. La documentación del kernel explica por qué importa: «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»1. En almacenamiento grueso no puede quedarse sin espacio, pero los bloques sin descartar siguen siendo espacio de unidad reservado para datos que no son de nadie.
La opción on-volume-remove discard=1 del almacenamiento es el arreglo. Proxmox la describe como emitir «discard (TRIM) requests before removal»5:
| Borrado | Bloques de VDO liberados |
|---|---|
almacenamiento lvm normal, un disco con 1 GiB | 0 |
con on-volume-remove discard=1, lo mismo | 262 140, el 1 GiB entero |
Eso sí, en un disco grande es lento.
Borrar el disco de 34 GiB de la prueba de llenado le llevó a Proxmox 262.6 s, mientras que blkdiscard con el mismo tipo de datos despachó 15 GiB en 2.25 s.
Así que para cualquier cosa grande, haz blkdiscard del disco primero y bórralo después.
El tamaño de discard también importa. El max_discard por defecto de VDO es un bloque de 4 KiB por petición1:
| Discard de 15 GiB de datos aleatorios | Tiempo | CPU (sys) |
|---|---|---|
max_discard=1, el valor por defecto | 8.06 s | 8.06 s |
max_discard=4096, 16 MiB | 2.25 s | 0.00 s |
Dentro de los invitados, activa la opción Discard de la unidad para que su TRIM llegue al almacenamiento10, y ejecuta fstrim de forma programada.
Dónde se gana su sitio
| Encaja | No encaja |
|---|---|
| muchas VMs de las mismas pocas plantillas | bases de datos y trabajo atado a la latencia con mucha profundidad |
| RAID6 de HDD detrás de una caché write-back de controladora | un host todo NVMe que necesita cada microsegundo |
| datos en discos mecánicos con una NVMe para los metadatos de VDO | datos ya comprimidos: multimedia, copias de seguridad, ISOs |
| bcache delante de datos en discos mecánicos, donde los datos se repiten | bcache delante de datos que no se repiten |
| unidades donde la resistencia a escritura es el límite | discos de invitado cifrados, que nunca se deduplican |
| un host con medio gigabyte de RAM libre por pool | un pool pequeño, donde el índice se come una décima parte |
| Ajuste | Por defecto | Ponlo en | Cambiarlo después |
|---|---|---|---|
Tamaño virtual de VDO -V | lo que pidas | no más de lo que el pool puede direccionar | solo crecer, nunca encoger |
| Hilos de VDO | 10, uno lógico | uno por CPU, repartidos como arriba | solo con las VMs del pool paradas |
max_discard | 1, que son 4 KiB | 4096, que son 16 MiB | solo con las VMs del pool paradas |
on-volume-remove en el almacenamiento | sin poner | discard=1 | sí, pvesm set |
| Discard en cada disco virtual | desactivado | activado | sí, por disco |
scan_lvs y el filtro | 0, sin rechazo de discos de VM | 1, discos de VM rechazados | sí, en lvm.conf |
Nada de eso es difícil. Nada de eso viene por defecto.
La escritura más barata es la que nunca mandas
Lo que me llama la atención de VDO es lo mal que se vende. Aparece como una forma de meter en un disco más de lo que cabe, y eso es lo menos útil que hace. Yo lo hice sin querer en el primer montaje, y Proxmox mostraba un tercio del almacenamiento libre mientras VDO estaba lleno. Sobrecomprometer es un préstamo, y la unidad te lo reclama a velocidad de escritura completa.
El valor de verdad está en la línea que casi nadie mide. Una cuarta parte de los bytes llegando a la unidad es una cuarta parte del desgaste y una caché de controladora que dura cuatro veces más. Eso no es capacidad. Es el hardware haciendo menos trabajo para el mismo resultado, que es el único tipo de ahorro que no vuelve a morderte.
Cuesta CPU, y en flash rápida cuesta latencia, y los dos costes son fijos. Ese es el trato, dicho claro: tiempo de procesador gastado para que la parte lenta y cara de la máquina trabaje menos. En discos mecánicos detrás de una controladora RAID o de un bcache, con el índice y el journal en una NVMe, la cuenta sale bien. En un host todo Optane, casi nunca.
Y no se cuida solo. Cada valor por defecto que importa está mal para este trabajo: diez hilos en dieciséis CPUs, un tamaño de discard que quema un núcleo, un tamaño virtual que puedes poner en lo que quieras, y nada en la configuración del almacenamiento que le diga a Proxmox que devuelva el espacio. Nada de eso está escondido. Está todo en la documentación.
Así que móntalo grueso, una vez, como es debido, con los ajustes en la línea de creación y los metadatos donde tienen que estar. Haz eso y la unidad hace una cuarta parte del trabajo. Sáltatelo y habrás comprado otra capa que promete más de lo que tiene.
Linux kernel documentation — dm-vdo — el target «provides block-level deduplication, compression, and thin provisioning»; «If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space»; «unflushed writes may or may not persist after a crash»; la caché del block map de 128 MB permite «efficient access to 100 GB of logical space at a time»; los parámetros de hilos, sus límites y la guía de ajuste; maxDiscard «in 4096-byte blocks». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — VDO pool y VDO LV, la conversión de un LV existente con
lvconvert --type vdo-pool, el uso de memoria, el índice denso y su ventana de 1 TiB por GiB de RAM, y «You cannot reduce the size of a VDOPoolLV». ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()desactiva el paso de discard cuando el dispositivo de datos no admite un chunk fino entero, que es lo que hace el valor por defecto de VDO bajo un thin pool. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: «Caution is required to avoid using PVs that belong to guest images stored on LVs» y «This option does not enable autoactivation of layered VGs». ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — la propiedad
on-volume-remove, «Use ‘discard=1’ to issue discard (TRIM) requests before removal»; los volúmenes se activan uno a uno conlvchange -aeyen lugar de convgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — «Management tools for Virtual Data Optimizer», versión 8.3.1.1-1, que proporciona
vdoformat,vdostatsyvdolistmetadata. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()crea la partición del block map al principio, las particiones del slab summary y del recovery journal al final, y el slab depot con lo que queda. ↩︎fio documentation — randrepeat — «Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.» ↩︎
Linux kernel documentation — Design of dm-vdo — «vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.» ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — «For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.» ↩︎