El switch que no compras
Un clúster Proxmox de tres nodos con Ceph quiere una red rápida entre los nodos. La respuesta habitual es un switch de 100 Gbit, y la objeción habitual es lo que cuesta.
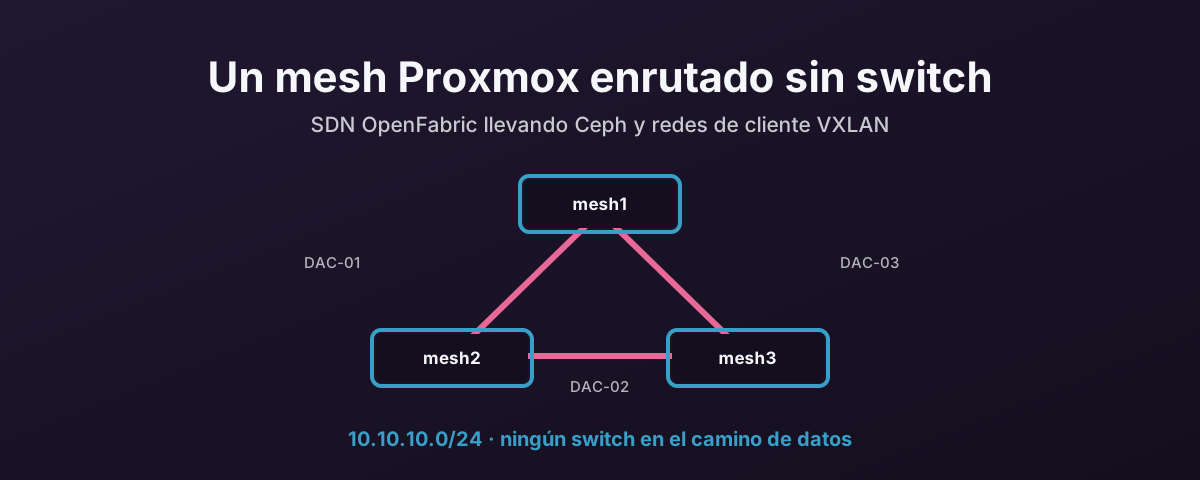
Hay otra respuesta para tres nodos: cablearlos derecho unos a otros en triángulo y enrutar a través de él. Ningún switch en el camino de almacenamiento.
El componente más barato de cualquier diseño es el que no compras, y es el único que no falla nunca.
Eso te compra cuatro cosas.
El coste del switch desaparece. Necesitas tarjetas de red y tres cables, no un switch de 100 o 200 Gbit con el número de puertos que le acompaña.
El camino de datos no tiene punto único de fallo. Un switch que falla o se reinicia se lleva con él todo el tráfico este-oeste del clúster. Los nodos cableados directamente entre sí no se preocupan por lo que le pase a un switch en otra parte del edificio.
El tráfico pesado va por sus propios cables. La migración en vivo y la replicación de Ceph se quedan en el mesh en vez de competir con el tráfico de oficina y de administración.
Agrandarlo es un trabajo de cableado, no de presupuesto de puertos. No hay caja central que haga de techo de ancho de banda o de número de puertos, así que el fabric crece mientras cada servidor tenga una ranura PCIe libre. OpenFabric enruta sobre los enlaces nuevos por sí solo.
Y un límite honesto, porque importa más que las cuatro ventajas. Un mesh completo necesita un cable entre cada par de nodos. Tres nodos son tres cables. Cuatro, seis. Cinco, diez. El cableado crece más rápido que el número de nodos, y este diseño no sobrevive más allá de un clúster pequeño sin pasar a algo conmutado, como leaf-spine.
Tres nodos es exactamente donde un mesh completo tiene sentido. Más allá, con dos puertos de mesh por nodo, lo que aún puedes construir es un anillo — y eso necesita una cosa que este montaje por lo demás evita, tratada más abajo.
Qué se construye
Tres hosts Proxmox VE, cada uno con dos interfaces de 100 Gbit dedicadas, cableados en triángulo de modo que cada nodo tenga dos vecinos directos.
El SDN de Proxmox hace el enrutamiento. OpenFabric es el protocolo: calcula el mejor camino a través del mesh, y cuando se tira de un cable o cae un enlace reenruta por el camino restante. Nadie inicia sesión.
El fabric vive en 10.10.10.0/24, reservado para el mesh y nada más — ni administración, ni invitados, ni direccionamiento de almacenamiento, ni nada externo.
| Nodo | Dirección de mesh | Interfaces de mesh |
|---|---|---|
| mesh1 | 10.10.10.1/32 | nic1, nic2 |
| mesh2 | 10.10.10.2/32 | nic1, nic2 |
| mesh3 | 10.10.10.3/32 | nic1, nic2 |
Cada nodo recibe un /32, no una porción de la subred.
Ese es el sentido de un mesh enrutado en vez de puenteado. La dirección identifica el nodo, OpenFabric la anuncia, y los dos enlaces físicos son solo caminos para alcanzarlo.
Proxmox crea una interfaz loopback ficticia para sostenerla.
El cableado
Cables DAC de fibra activa, en triángulo, con jumbo frames habilitados en ambas interfaces de mesh en cada nodo.
| Cable | De | A |
|---|---|---|
| DAC-01 | mesh1 nic1 | mesh2 nic1 |
| DAC-02 | mesh2 nic2 | mesh3 nic1 |
| DAC-03 | mesh3 nic2 | mesh1 nic2 |
Fibra activa en vez de DAC de cobre, por dos razones que van del rack más que de la red:
- Gestión del cableado. Los DAC de fibra activa son más finos y mucho más flexibles que el cobre, así que se tienden limpiamente y no se amontonan detrás de los servidores.
- Flujo de aire. Menos volumen de cable detrás del chasis significa menos estorbo al flujo de aire de delante hacia atrás, lo que importa cuando varios enlaces de alta velocidad aterrizan en las mismas pocas unidades de rack.
Dos redes, no una
El mesh no es la única red, y no debe convertirse en ella.
Cada nodo tiene nic0 en un switch de 2,5 Gbit, presentado a Proxmox como el puente vmbr0.
Eso lleva la interfaz web, el acceso de administración y el tráfico de cliente. Es también el camino que usas mientras construyes el fabric, y por eso tiene que ser independiente de él.
nic0 se deja fuera del fabric a propósito. Solo nic1 y nic2 se seleccionan cuando se crean los nodos del fabric.
El mesh lleva tres cosas:
- Ceph. Replicación, recuperación y backfill de nodo a nodo para el almacenamiento hiperconvergido.
- Red virtual de cliente. Las VNets respaldadas por VXLAN estiran las redes de los invitados por los tres nodos, usando el mesh enrutado como underlay.
- Corosync, como segundo camino. El tráfico de pertenencia al clúster corre por la red de administración y por el mesh, así que el quórum no depende de que sobreviva ninguno de los dos por su cuenta.
La regla que merece escribirse en el ticket de cambio: la administración y el acceso de cliente permanecen disponibles a través del switch de 2,5 Gbit en todo momento, sea cual sea el estado de las interfaces de 100 Gbit.
Todo por la interfaz web
Este montaje se hace enteramente en la interfaz web de Proxmox. Es una elección deliberada, no un límite de la herramienta.
No usado, a propósito:
- Editar
/etc/network/interfacesa mano. - Editar los archivos de configuración de FRR a mano.
vtyshcomo método de construcción.
Proxmox genera la configuración de red y enrutamiento subyacente a partir de los objetos SDN que defines. Si algo de verdad no se puede fijar en la interfaz, eso merece señalarse como prerrequisito en vez de arreglarse a escondidas en la línea de comandos. La siguiente persona que abra la interfaz web no sabrá que lo hiciste.
La salida de línea de comandos aparece abajo solo como prueba, nunca como paso de construcción.
La construcción
1. Abre la interfaz web de Proxmox y ve a Datacenter → SDN → Fabrics.
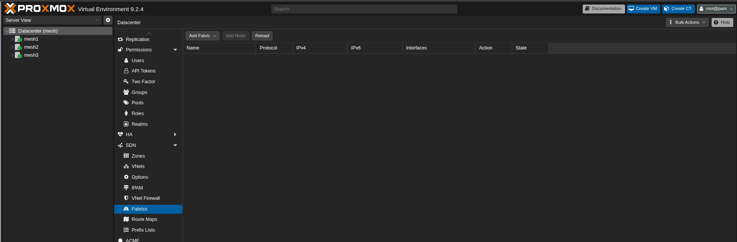
2. Añade el fabric. Nómbralo, dale el prefijo del mesh, y fija los temporizadores.
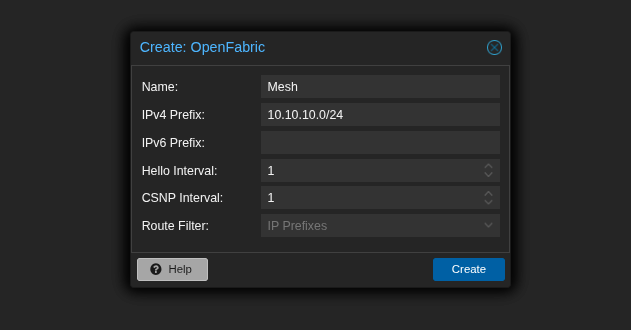
Intervalos Hello y CSNP de 1 actualizan el estado lo más rápido posible cuando algo cambia, que es lo que quieres en un fabric tan pequeño.
El coste es más charla del plano de control. Irrelevante en tres nodos con dos enlaces cada uno, digno de una segunda reflexión si el fabric llega a crecer.
3. Añade cada nodo con Add node. Dale una dirección del rango del mesh y marca las interfaces que participan.
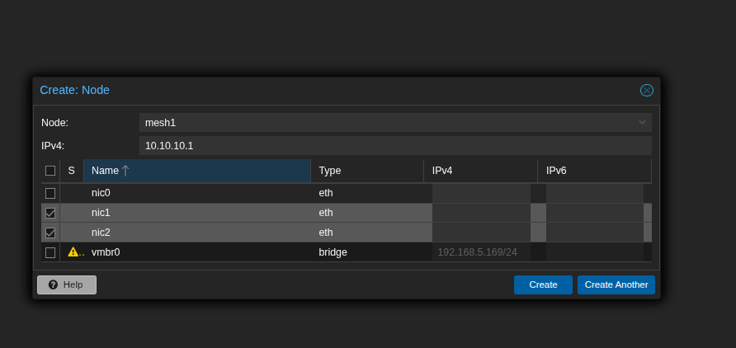
Fíjate en lo que no está marcado: nic0 se queda fuera, y vmbr0 conserva la dirección de administración.
Usa Create another para los dos primeros nodos y Create en el último.
4. Comprueba el resultado antes de aplicarlo.
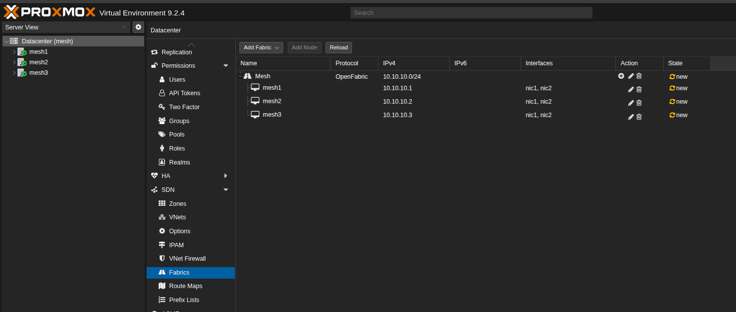
Tres nodos, tres direcciones, nic1, nic2 en cada uno, todos marcados new — todavía no se ha escrito nada.
5. Aplica la configuración SDN.
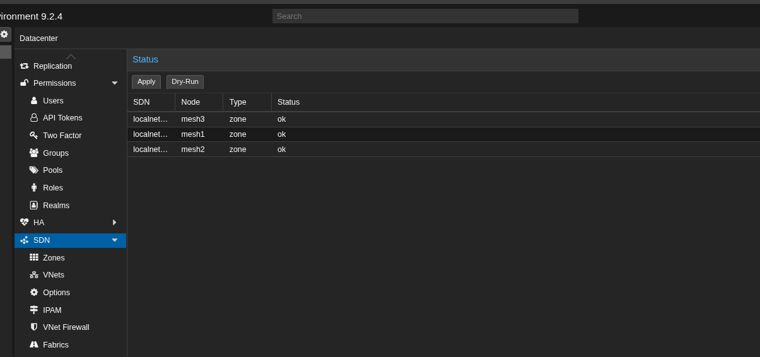
Hay un Dry-Run junto a Apply si prefieres ver primero lo que pretende hacer.
Saber que funcionó
La vista de estado debería mostrar las entradas de zona y de fabric ok en los tres nodos, y ningún cambio pendiente por aplicar.
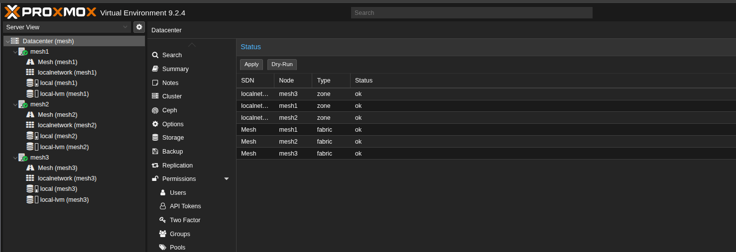
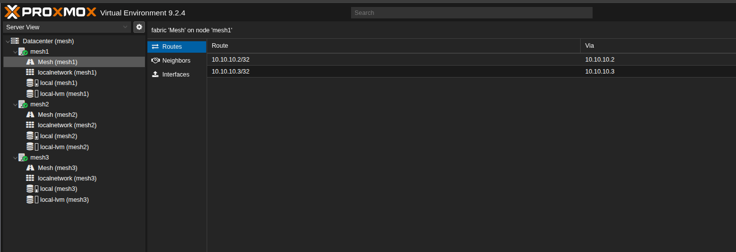
Luego comprueba el fabric desde el propio punto de vista de un nodo.
Las rutas primero — cada nodo debería tener un /32 hacia cada uno de los otros, y la columna Via te dice qué vecino está usando.
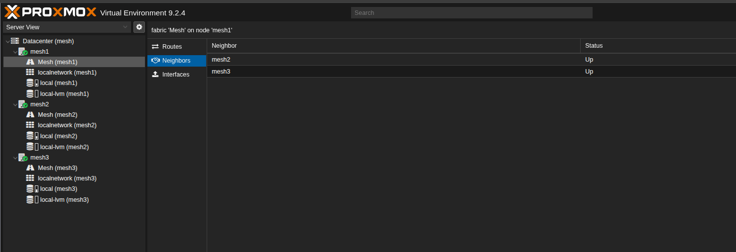
Los vecinos después. Dos, ambos Up, en un triángulo de tres nodos.
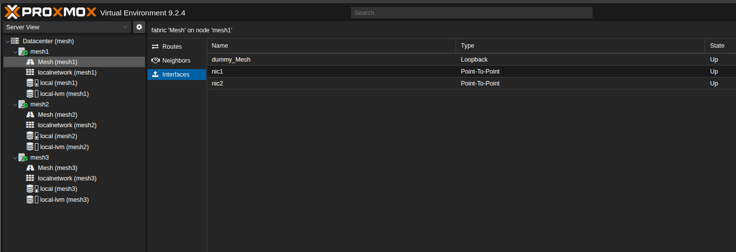
Luego las interfaces, que es donde se ve la forma de la cosa: dummy_Mesh como el loopback que sostiene la dirección del router, y nic1 y nic2 como Point-To-Point en vez de segmentos de difusión.
Por último, demuéstralo de punta a punta.
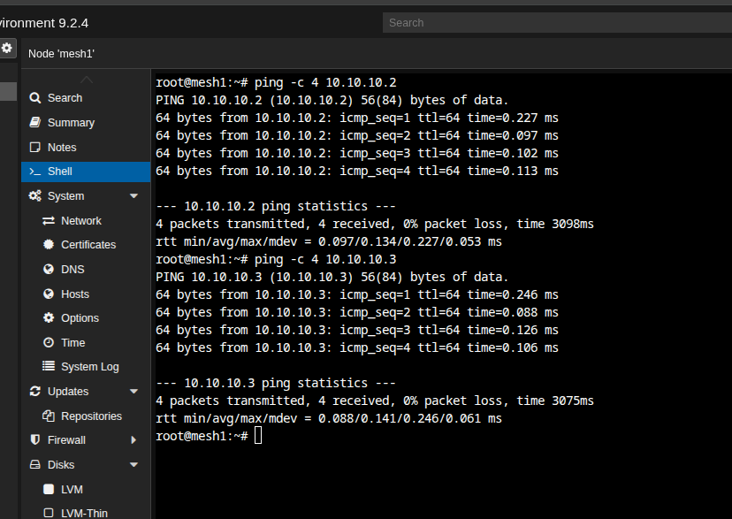
Sin pérdida, y medias de 0,134 ms y 0,141 ms. Ambos vecinos están a un salto directo de distancia, que es lo que da un triángulo.
La comprobación que merece hacerse y que ninguna captura puede mostrar: tira de un cable y confirma que todo sigue siendo alcanzable. Esa es la razón entera de elegir un mesh enrutado en vez de un par de enlaces punto a punto. Como tal, es la única prueba que importa.
Más allá de tres nodos: el anillo
Un triángulo es un mesh completo. Cada nodo tiene un cable directo hacia cada otro nodo, cada salto es un salto único, y ningún nodo lleva nunca tráfico que no sea el suyo.
Esa propiedad es lo que dos puertos de mesh por nodo te compran con tres nodos, y es exactamente lo que pierdes con cuatro. No una parte. Toda. Un mesh completo de cuatro nodos necesita tres puertos cada uno. Con dos, lo máximo que puedes cablear es un anillo.
Un anillo cambia el modelo de tráfico. Los nodos adyacentes siguen teniendo un cable directo, pero los nodos en lados opuestos del anillo no — su tráfico tiene que cruzar un nodo intermedio. Y ese nodo tiene que estar dispuesto a reenviar paquetes entre sus dos interfaces de mesh, cosa que Linux no hace por defecto. El kernel documenta ip_forward como «Forward Packets between interfaces» con «Default: 0 (disabled)» — reenviar paquetes entre interfaces, por defecto 0, desactivado.
Actívalo para las interfaces de mesh, y solo para esas:
# /etc/sysctl.d/99-mesh-forwarding.conf
net.ipv4.conf.nic1.forwarding = 1
net.ipv4.conf.nic2.forwarding = 1
sysctl --system
Léelos de vuelta en vez de suponer:
sysctl net.ipv4.conf.nic1.forwarding net.ipv4.conf.nic2.forwarding
El ajuste por interfaz es el alcance correcto aquí, y funciona por sí solo. El net.ipv4.ip_forward global no es un prerrequisito. La decisión de reenvío del kernel lee el valor propio de la interfaz de recepción:
#define IN_DEV_FORWARD(in_dev) IN_DEV_CONF_GET((in_dev), FORWARDING)
IN_DEV_CONF_GET devuelve el ajuste de ese dispositivo, no un Y lógico con el global. Así que nic1 y nic2 reenvían el tráfico de tránsito del fabric mientras nic0 y vmbr0 se quedan exactamente como deben estar: interfaces de host que no enrutan. Activar el interruptor global convertiría cada interfaz de la máquina en un router, incluida la que mira a tu red de oficina. Eso es algo que este diseño no necesita para nada.
Una cosa que saber sobre el interruptor IPv4 global aunque no lo pongas: net.ipv4.ip_forward es un ajustador en bloque, y por eso la documentación del kernel advierte que cambiarlo «resets all configuration parameters to their default state» — restablece todos los parámetros de configuración a su estado por defecto. Si cualquier otra cosa del host lo escribe alguna vez, sobrescribe estos valores por interfaz. Bueno saberlo antes de pasar una tarde buscando por qué el tránsito dejó de funcionar.
IPv6 es la excepción, y es el único sitio donde el interruptor global tiene su lugar. La documentación del kernel lo dice directamente bajo conf/all/forwarding:
Enable global IPv6 forwarding between all interfaces. IPv4 and IPv6 work differently here; the
force_forwardingflag must be used to control which interfaces may forward packets.
Así que no hay equivalente IPv6 del pulcro enfoque por interfaz de arriba. Si el fabric lleva IPv6 habilitas el reenvío globalmente y luego lo acotas con force_forwarding, documentado como «Enable forwarding on this interface only — regardless of the setting on conf/all/forwarding» — habilita el reenvío solo en esta interfaz, sea cual sea el ajuste de conf/all/forwarding. Fíjate en que el mismo sobrescrito aplica al revés: poner conf.all.forwarding a 0 restablece force_forwarding en todas las interfaces.
El montaje de arriba deja vacío el prefijo IPv6 del fabric, así que nada de eso aplica aquí — solo importa si añades uno.
Fíjate en lo que el reenvío no cambia: OpenFabric ya anunciaba el /32 de cada nodo y ya calculaba el camino a través del anillo. El reenvío es el permiso que faltaba, no la inteligencia que faltaba. La tabla de enrutamiento estuvo bien desde el principio. El kernel simplemente se negaba a hacer de router.
Lo que cuesta el anillo, comparado con el triángulo:
- Tráfico de tránsito. En un anillo de cuatro nodos, los dos pares diagonales cruzan un nodo intermedio, así que su tráfico consume el ancho de banda del enlace de ese nodo además del suyo. Ceph lo nota primero, porque la replicación es de todos a todos en vez de de vecino a vecino.
- Un salto de latencia extra en esos caminos, encima de las cifras habituales por debajo del milisegundo del diseño sin switch.
- Menos margen ante fallos. Un enlace roto convierte un anillo en una cadena: sigue del todo conectado, pero con caminos más largos y más tránsito. Una segunda rotura parte el clúster. Un triángulo tolera una rotura sin tránsito alguno.
Y empeora de una forma más fácil de dibujar que de describir. Añade un quinto nodo y la mitad de cada par de nodos del clúster depende de que otro reenvíe:
Ese es el techo real de este diseño, y no es el protocolo de enrutamiento. OpenFabric se las apaña bien. Es que los puertos por nodo son fijos, así que pasados los tres nodos cada máquina nueva convierte más de tu tráfico en tránsito de otro.
Y la nota honesta, porque importa para un montaje que ha sido solo de interfaz web hasta aquí: un sysctl no es una acción de interfaz web. Por la regla puesta antes, eso lo convierte en un prerrequisito que señalar en vez de algo que arreglar a escondidas en la línea de comandos — escríbelo en el runbook, porque la siguiente persona que abra el panel SDN verá un fabric sano y ninguna pista de que un anillo depende de un archivo en /etc/sysctl.d.
Deshacerlo
La retirada es la construcción al revés, en la misma interfaz: borra los objetos SDN creados para el mesh, aplica la configuración, y confirma que el acceso de administración queda intacto.
Ese último paso es la razón de que nic0 y el switch de 2,5 Gbit existan. Si deshacer el mesh pudiera costarte la interfaz web, el diseño estaba mal antes de empezar.
Antes de empezar
- El acceso de administración es de verdad independiente del mesh. Compruébalo, no lo supongas.
- Los tres nodos están sanos antes de cualquier cambio SDN.
- Los nombres de nodo, los nombres de interfaz y el cableado están anotados, porque que
nic1en un host seanic2en otro es una mala tarde. - Los jumbo frames están puestos en ambas interfaces de mesh, y el MTU tiene en cuenta la sobrecarga de VXLAN en el underlay.
- El rango del mesh está reservado y no se usa en ninguna otra parte.
Referencias
- Proxmox VE — Software-Defined Network — la documentación de SDN Fabrics. Los fabrics «provide automated routing between nodes in a cluster», OpenFabric está «based on IS-IS and optimized for the spine-leaf topology common in data centers», cada nodo necesita un Router-ID único, y «a dummy ’loopback’ interface with the router-id is automatically created»
- Proxmox VE — Cluster Manager — la red de Corosync y los enlaces redundantes, tras el diseño de pertenencia por dos caminos
- Proxmox VE — Deploy Hyper-Converged Ceph Cluster — las expectativas de red de un clúster hiperconvergido
- Linux kernel — IP sysctl documentation —
ip_forwardy su valor por defecto de 0, el controlforwardingpor interfaz, y la advertencia de que cambiar el interruptor global restablece la configuración por interfaz