El problema
Esto surgió durante un trabajo con un cliente en el que diseñábamos un despliegue de Proxmox VE con passthrough de NVMe para una carga sensible a la latencia.
El cliente había hecho su propio benchmarking antes de la llamada.
En el host, fio contra el disco NVMe informaba de 700K IOPS de lectura aleatoria con latencia de finalización por debajo de 10µs.
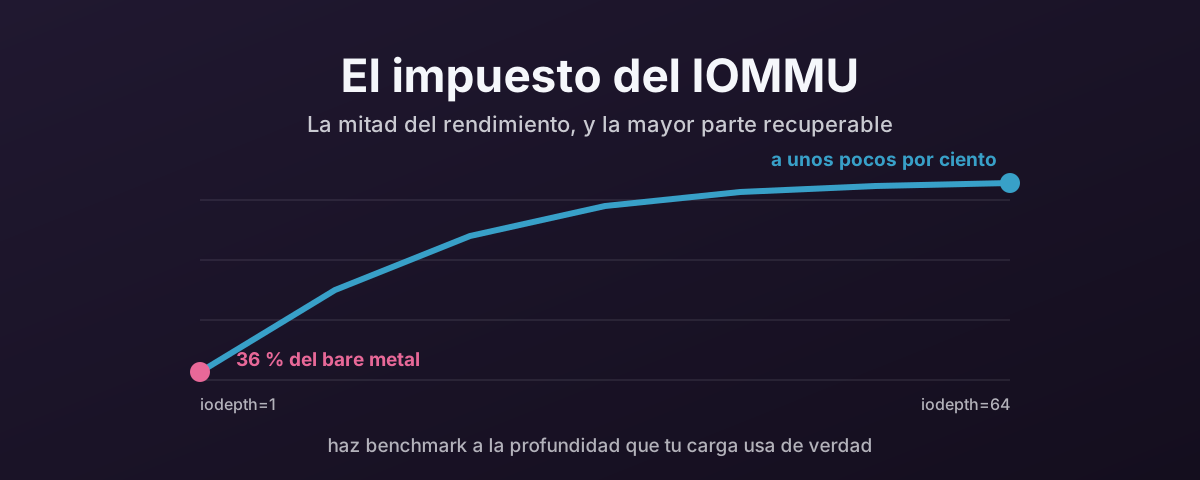
Dentro de la VM, usando el mismo disco con la misma prueba, obtenían aproximadamente la mitad.
Ya habían comprobado lo obvio. El disco no había cambiado. El firmware no había cambiado. La ranura PCIe no se había movido. Empezaban a preguntarse si el passthrough era el enfoque equivocado por completo.
No lo era. Lo que veían es el impuesto del IOMMU. Pilla desprevenida a la gente porque nadie te habla de él antes de que te hayas comprometido con el diseño de passthrough. La buena noticia es que la mayor parte de la sobrecarga es recuperable una vez que entiendes de dónde viene.
En profundidad
Los problemas que había que resolver
Dar a una VM acceso directo a un dispositivo PCIe físico suena sencillo. En la práctica, es uno de los problemas más difíciles de la virtualización de sistemas. Unas cuantas cosas que funcionan automáticamente en bare metal se vuelven peligrosas cuando un dispositivo se comparte entre un host y un invitado.
Aislamiento de DMA
Este es el problema fundamental.
Los dispositivos PCIe no pasan por la CPU para leer y escribir memoria. Usan Acceso Directo a Memoria. Escriben directo a direcciones físicas de RAM. En bare metal, eso está bien. El dispositivo y el SO se fían el uno del otro.
Bajo virtualización, la VM invitada tiene su propia visión de la memoria física. Las direcciones que el driver del invitado le da a la controladora NVMe son direcciones físicas del invitado. No se corresponden con las mismas ubicaciones en la RAM del host. Si el dispositivo las usa directamente, lee y escribe la memoria equivocada. Eso corrompe el host, otras VM, o ambos.
Peor aún, un driver de invitado malicioso o con errores podría programar deliberadamente el dispositivo para hacer DMA en cualquier parte de la memoria del host. Eso es efectivamente acceso root a toda la máquina sin explotar jamás un fallo del hipervisor.
La solución es el IOMMU — una unidad de traducción por hardware (Intel VT-d, AMD-Vi) que se sitúa entre cada dispositivo PCIe y la memoria principal. Mantiene sus propias tablas de páginas, separadas de las de la CPU. Cada petición de DMA del dispositivo pasa por el IOMMU, que traduce las direcciones físicas del invitado a direcciones físicas del host y bloquea cualquier acceso fuera de las regiones de memoria asignadas al invitado.
Sin el IOMMU, el passthrough seguro es imposible. Con él, el dispositivo queda contenido.
Agrupación de dispositivos
El IOMMU no aísla dispositivos individuales. Aísla grupos.
La especificación PCIe define los Access Control Services (ACS) que gobiernan si los dispositivos del mismo bus pueden hablarse directamente — DMA de igual a igual — sin pasar por el complejo raíz donde está el IOMMU. Si dos dispositivos comparten un switch PCIe que no impone ACS, un dispositivo puede hacer DMA en el espacio de memoria del otro, saltándose el IOMMU por completo.
El núcleo agrupa los dispositivos que potencialmente pueden alcanzarse sin la imposición del IOMMU en un único grupo de IOMMU. Si tu controladora NVMe comparte un grupo con otro dispositivo, pasar solo la NVMe rompe el modelo de aislamiento. El otro dispositivo del grupo todavía se podría usar como un canal lateral alrededor del IOMMU.
El hardware de grado servidor con soporte ACS adecuado en cada puente y switch normalmente da a cada dispositivo su propio grupo. Las placas de consumo y de estación de trabajo a menudo juntan varios dispositivos porque el complejo raíz PCIe no implementa ACS en cada puerto.
Proxmox lleva un parche del núcleo — pcie_acs_override — que le dice al núcleo que trate cada dispositivo como aislado sin importar el soporte ACS del hardware.
Funciona en la práctica, pero le está mintiendo al núcleo sobre la topología del hardware.
En un sistema de producción, los grupos limpios respaldados por ACS real del hardware son siempre preferibles.
Entrega de interrupciones
En bare metal, cuando una controladora NVMe completa una operación de IO, dispara una interrupción MSI-X directamente a la CPU. La CPU la maneja en unos pocos cientos de nanosegundos.
Bajo virtualización, esa interrupción tiene que llegar al invitado, no al host. El enfoque ingenuo es atrapar cada interrupción en el hipervisor, disparar una salida de VM, inyectar la interrupción en el invitado, y reanudar. Eso funciona, pero cada salida de VM cuesta 5-20µs. A IOPS altas — cientos de miles de interrupciones por segundo — la sobrecarga es sustancial.
La solución de hardware son las interrupciones publicadas. La APICv de Intel y la AVIC de AMD permiten al IOMMU escribir la interrupción directamente en la página APIC virtual del invitado sin causar ninguna salida de VM. El invitado ve la interrupción como si viniera de hardware bare-metal. La sobrecarga baja a unos pocos cientos de nanosegundos.
No todas las plataformas soportan interrupciones publicadas. Las CPU más antiguas, algunos chipsets de estación de trabajo, y algunas versiones de BIOS no exponen la capacidad. Cuando están ausentes, cada interrupción va por el camino lento, y no hay solución por software.
Reinicio de dispositivo
Cuando una VM se apaga o se cae, el dispositivo pasado necesita volver a un estado limpio y conocido. Si no, no se puede reasignar a otra VM ni reclamar por el host.
En bare metal, el SO hace un apagado ordenado del driver del dispositivo. Bajo passthrough, el invitado podría caerse, el usuario podría forzar la parada de la VM, o el hipervisor podría matar el proceso. El dispositivo podría estar a mitad de transferencia con operaciones de DMA en curso.
PCIe define el Function Level Reset (FLR) para esto — una forma de reiniciar una única función de dispositivo sin afectar al resto del bus. Las controladoras NVMe generalmente soportan FLR y lo manejan bien. Las GPU son notoriamente malas en ello, pero eso es otro artículo.
Si FLR no se soporta, el recurso es un reinicio de bus secundario, que reinicia todo lo que hay detrás de ese puente PCIe. Si el puente tiene otros dispositivos, todos se reinician también. En el peor caso, un reinicio completo del host es la única forma de reclamar el dispositivo.
Sobrecarga de traducción de direcciones
El IOMMU resuelve el problema de seguridad. Por eso, no es opcional. Pero introduce uno de rendimiento.
Cada operación de DMA pasa ahora por un nivel extra de traducción de direcciones. El IOMMU tiene su propio TLB — el IOTLB — y cuando acierta, la sobrecarga es pequeña. Cuando falla, el IOMMU tiene que recorrer sus tablas de páginas, y eso añade latencia real a cada operación de IO afectada.
Este es el impuesto del IOMMU. El resto de este artículo va de entender de dónde viene y cómo minimizarlo.
Mapeo de BAR y espacio de direcciones
Cada dispositivo PCIe expone uno o más Base Address Registers (BAR) que mapean los registros y la memoria internos del dispositivo en el espacio de direcciones MMIO del host. La CPU del host accede al dispositivo a través de estos mapeos. Para que el passthrough funcione, el hipervisor tiene que presentar estos mapeos correctamente al invitado.
Tradicionalmente, los tamaños de los BAR se fijaban al arrancar por la BIOS y cabían dentro de la ventana MMIO heredada de 32 bits por debajo de los 4GB. Eso funcionaba cuando los BAR eran pequeños. Las GPU modernas han cambiado el panorama. Un framebuffer de 24GB necesita un BAR de 24GB, que no cabe en un espacio de direcciones de 32 bits.
El Resizable BAR (ReBAR) — también comercializado como AMD Smart Access Memory (SAM) — es una capacidad de PCIe que permite renegociar el tamaño del BAR después de arrancar. Para las GPU, esto es una función importante. En vez de acceder al framebuffer a través de una ventana de 256MB y paginar por ella a trozos, el host mapea toda la VRAM de una vez.
Para NVMe, el impacto directo es menor. Los BAR de las controladoras NVMe son normalmente de 16KB a 64KB para el conjunto de registros de la controladora (BAR0). La especificación NVMe define un Controller Memory Buffer (CMB) que puede exponer un BAR mayor para las colas de envío residentes en el host, pero la mayoría de los discos no lo implementan. ReBAR no cambia el rendimiento de NVMe como lo hace para las GPU.
La razón por la que importa en un contexto de passthrough de NVMe es el entorno PCIe compartido. Si estás pasando un disco NVMe junto a una GPU en el mismo host, el BAR redimensionado de la GPU necesita espacio de direcciones por encima de la frontera de los 4GB. La BIOS, el IOMMU, y la topología PCIe virtual tienen que acomodar todos eso. Equivocarse con la asignación del espacio de direcciones significa que los dispositivos no inicializan, y el passthrough de NVMe falla junto a todo lo demás.
Exposición a la pérdida de energía
En un disco virtual, el hipervisor y la capa de almacenamiento manejan el orden de escritura y la consistencia ante caídas. Con passthrough, el invitado habla directamente con la flash. Si el host pierde energía a mitad de escritura, lo que el firmware de la controladora NVMe haga — o no haga — con su caché de escritura determina si pierdes datos.
Los discos NVMe empresariales llevan condensadores de protección ante pérdida de energía (PLP) que vacían la caché de escritura de forma segura durante un fallo de energía. Los discos de consumo sin PLP puede que no. Con passthrough, no hay red de seguridad del hipervisor entre el invitado y el hardware.
Para una carga de producción, un disco empresarial con PLP no es opcional.
Compromisos operativos
El passthrough también quita capacidades que los discos virtuales proveen.
Un dispositivo pasado está físicamente atornillado a un host concreto. La VM no se puede migrar en vivo mientras el dispositivo está conectado. En un clúster Proxmox con HA, un fallo de nodo significa que la VM se cae y arranca en frío en otro nodo. No hay failover sin costuras.
El disco también es invisible para vzdump y Proxmox Backup Server.
No se incluirá en las instantáneas de VM ni en las copias programadas.
Una estrategia de copia aparte — a nivel de invitado, de sistema de ficheros, o de aplicación — necesita estar en su sitio antes de que la carga entre en producción.
Cómo funciona en realidad el passthrough VFIO
Cuando pasas un dispositivo PCIe a una VM, el hipervisor le da al invitado el control directo de los registros MMIO del dispositivo. El driver del invitado habla con la controladora NVMe como si corriera en bare metal. Esa parte es casi nativa. El acceso a los registros MMIO pasa por las Extended Page Tables (EPT en Intel, NPT en AMD) y normalmente se completa sin una salida de VM.
El camino de DMA es donde aparece el coste. Cada operación de DMA pasa por el IOMMU para la traducción de direcciones, y como se describió arriba, esa traducción tiene un precio. Especialmente en los fallos de IOTLB.
Por qué los benchmarks parecen peor que la realidad
Aquí es donde la mayoría de la gente se equivoca con sus pruebas.
Un hilo del foro de Proxmox que motivó este artículo tenía usuarios corriendo fio con iodepth=1.
A esa profundidad de cola, fio envía una IO, espera a que se complete, y luego envía la siguiente.
La prueba solo mide la latencia por IO.
Cada microsegundo de sobrecarga del IOMMU aparece al completo.
Los números de ese hilo cuentan la historia con claridad.
La latencia de finalización en bare metal promediaba en torno a 10µs.
Dentro de la VM, promediaba en torno a 28µs.
Esos ~18µs extra por IO son la sobrecarga de traducción del IOMMU.
A iodepth=1, reduce directamente a la mitad el rendimiento porque el rendimiento es igual a 1 / latencia cuando solo hay una IO en curso.
Sube la profundidad de cola a 32 o 64 — que es como los discos NVMe están diseñados para operar — y el panorama cambia. Con varias IO en curso, la sobrecarga del IOMMU se amortiza entre todas. La controladora procesa finalizaciones mientras suceden nuevas traducciones. El rendimiento se recupera hasta unos pocos por ciento del bare metal.
La conclusión práctica es esta. Si tu carga corre a profundidades de cola por encima de 4, la penalización de rendimiento del IOMMU es probablemente insignificante. Eso cubre la mayoría de las cargas de base de datos, virtualización y almacenamiento. Si tu carga es sensible a la latencia a profundidades de cola bajas — ciertas aplicaciones en tiempo real, operaciones síncronas de metadatos — la notarás.
Corre tus benchmarks a profundidades de cola realistas antes de concluir que el passthrough es demasiado lento:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Compara los percentiles de clat (latencia de finalización) y las cifras de IOPS.
A iodepth=32 con cuatro trabajos, el hueco debería ser de puntos porcentuales de un solo dígito, no del 50 %.
Alineación NUMA
Esto tiene su propio artículo. Ver Alineación NUMA en Proxmox VE — por qué importa y cómo hacerla bien.
La versión corta: en sistemas multi-socket, cada dispositivo PCIe está cableado a un socket concreto. Si el disco NVMe está en el nodo NUMA 1 y las vCPU de la VM están fijadas al nodo 0, cada finalización de DMA cruza el enlace entre sockets. Eso añade 50-100ns por operación. A IOPS altas, la diferencia de rendimiento entre NUMA alineado y desalineado es del 20-30 %.
Comprueba con cat /sys/bus/pci/devices/0000:XX:00.0/numa_node, luego fija las vCPU de la VM a núcleos del mismo nodo con el parámetro affinity en la configuración de la VM.
En sistemas de un solo socket, esto no es una preocupación.
PCIe Active State Power Management (ASPM)
Esto tiene su propio artículo. Ver ASPM de PCIe y por qué deberías desactivarlo para el passthrough.
La versión corta: ASPM permite a los enlaces PCIe entrar en estados de bajo consumo cuando están inactivos.
Bajo passthrough, el host todavía controla el enlace físico pero el invitado posee el dispositivo.
Cuando el invitado envía IO y el enlace está dormido, el tiempo de despertar añade latencia.
El síntoma es una amplia dispersión en tus percentiles de clat. El p99 podría ser 5-10 veces más alto que la media mientras que el promedio parece bien.
Desactívalo en el host con pcie_aspm=off en la línea de comandos del núcleo.
Añade también disable_idle_d3=1 a las opciones del módulo vfio-pci si tu controladora NVMe tiene problemas de recuperación de estado de energía. La Samsung 990 EVO Plus es una infractora conocida.
MaxPayloadSize (MPS)
Esto tiene su propio artículo. Ver PCIe MaxPayloadSize — una mejora de rendimiento gratis para el passthrough.
La versión corta: los dispositivos PCIe transfieren datos en Transaction Layer Packets.
El complejo raíz virtual de QEMU usa por defecto una carga máxima de 128 bytes.
La mayoría de los dispositivos soportan 256 o 512 bytes.
Añadir pci=pcie_bus_perf a la línea de comandos del núcleo del host pone el MPS al máximo que permite el bus padre de cada dispositivo.
Es una pequeña mejora de rendimiento — un porcentaje bajo de un solo dígito — pero es gratis y sin inconvenientes.
Resizable BAR y apertura MMIO
El problema de mapeo de BAR descrito antes tiene pasos prácticos tanto en el lado de la BIOS como en el de la VM.
Primero, activa Above 4G Decoding en la BIOS. Esto permite mapear los BAR en el espacio de direcciones por encima de la frontera de los 4GB, que es necesario para cualquier dispositivo con BAR grandes. Actívalo incluso para passthrough solo de NVMe. No tiene inconvenientes y evita problemas si añades una GPU u otro dispositivo de BAR grande más adelante.
Si ReBAR está disponible en la BIOS, actívalo también. No afectará al rendimiento de NVMe directamente, pero permite a las GPU del mismo host usar su mapeo de framebuffer completo.
En el lado de la VM, el complejo raíz Q35 virtual de QEMU necesita una ventana MMIO de 64 bits lo bastante grande para que el invitado vea los BAR redimensionados. Por defecto, OVMF asigna una ventana relativamente pequeña. Para passthrough solo de NVMe esto está bien. Los BAR de NVMe caben cómodamente. Pero si la VM tiene pasados tanto una NVMe como una GPU, aumenta la apertura MMIO:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Esto le dice a OVMF que asigne 64GB de espacio MMIO de 64 bits, suficiente para la mayoría de los framebuffers de GPU junto al pequeño BAR de la controladora NVMe.
El soporte de ReBAR de QEMU ha ido mejorando pero todavía no es sin costuras. Algunas GPU de AMD (Vega y más nuevas) disparan errores de driver (Code 43 en Windows) con ReBAR activado bajo QEMU. Si te topas con eso, desactiva ReBAR en la BIOS como primer paso. El passthrough de NVMe no se verá afectado de ninguna manera.
Para lo que hace el Resizable BAR en el lado de la GPU de la valla, y por qué Intel lo trata como obligatorio en Arc mientras NVIDIA lo activa por juego, ver PCIe Resizable BAR y las GPU modernas.
Manejo de interrupciones
El problema de entrega de interrupciones descrito antes tiene un paso práctico de ajuste. Las interrupciones publicadas (APICv en Intel, AVIC en AMD) puede que no estén activadas por defecto.
Comprueba si están activas:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
En sistemas AMD EPYC, activa AVIC en el módulo KVM si no está activado por defecto:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
En sistemas Intel, APICv con interrupciones publicadas normalmente se activa automáticamente cuando VT-d está activo.
Si tu plataforma no soporta interrupciones publicadas, no hay solución por software. Es una capacidad de hardware. Pero vale la pena verificar que de verdad está activada antes de suponer que el camino lento es inevitable.
Afinidad de interrupciones y alineación de colas
Las controladoras NVMe usan varios pares de colas de envío y finalización. Normalmente uno por núcleo de CPU. Cuando las vCPU de la VM no se alinean con los núcleos físicos que manejan las interrupciones de NVMe, las finalizaciones tienen que cruzar núcleos vía interrupciones interprocesador. Eso añade latencia.
Dentro del invitado, comprueba cuántas colas de IO ha creado el driver NVMe y cómo están mapeadas:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idealmente, la interrupción de cada cola de IO de NVMe debería afinizarse a la vCPU que envía a esa cola. La mayoría de los drivers NVMe modernos manejan esto automáticamente. Pero vale la pena verificarlo, especialmente si has fijado vCPU a mano o reducido el número de vCPU por debajo del número de colas de la controladora.
Usa siempre Q35, no i440fx
Esto merece su propio artículo. Ver Usa siempre Q35, no i440fx.
La versión corta: i440fx presenta un bus PCI heredado plano. Q35 presenta un complejo raíz PCIe adecuado. Los dispositivos de passthrough en i440fx aparecen como PCI heredado, lo que rompe la entrega de interrupciones multi-cola MSI-X. Las controladoras NVMe necesitan MSI-X para su arquitectura de una-cola-por-núcleo. Sin él, todas las finalizaciones de IO se embudan por una única interrupción y obtienes un cuello de botella a IOPS altas que ninguna cantidad de ajuste del núcleo arreglará.
En Proxmox 8.x y más nuevo, Q35 es el valor por defecto para las VM nuevas. Si estás haciendo passthrough en una VM antigua que todavía es i440fx, cámbiala. RHEL 10 ha declarado formalmente obsoleto i440fx, y el ecosistema KVM más amplio va detrás.
Juntándolo todo
Aquí tienes un resumen de los pasos de ajuste en orden de impacto.
Alineación NUMA — asegúrate de que el disco NVMe y las vCPU de la VM están en el mismo nodo NUMA. Esto solo puede explicar una diferencia de rendimiento del 20-30 % en sistemas multi-socket.
ASPM apagado — añade pcie_aspm=off a la línea de comandos del núcleo del host.
Elimina el jitter de latencia de las transiciones de estado de energía del enlace PCIe.
Profundidades de cola realistas — prueba a iodepth=32 o más, no a iodepth=1.
La sobrecarga del IOMMU que domina a profundidades de cola bajas se amortiza a profundidades realistas.
Interrupciones publicadas — verifica que APICv (Intel) o AVIC (AMD) está activo. Reduce la sobrecarga por interrupción de microsegundos a nanosegundos.
Optimización de MPS — añade pci=pcie_bus_perf a la línea de comandos del núcleo del host.
Pone MaxPayloadSize al máximo que soporta la topología.
Gestión de energía de vfio-pci — añade disable_idle_d3=1 si tu controladora NVMe tiene problemas de estado de energía bajo passthrough.
Una línea de comandos del núcleo del host combinada para un nodo Proxmox haciendo passthrough de NVMe en un sistema AMD EPYC quedaría algo así:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Para Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Cuándo el passthrough no vale la pena
Antes de meterte por este camino, vale la pena preguntar si de verdad necesitas passthrough de NVMe en absoluto.
VirtIO-SCSI y VirtIO-BLK con un disco virtual respaldado por NVMe ya son muy eficientes. La sobrecarga comparada con el passthrough es normalmente del 5-10 % en latencia. La diferencia de rendimiento es insignificante para la mayoría de las cargas.
El passthrough tiene sentido cuando necesitas que el SO invitado gestione el dispositivo directamente. Eso incluye la monitorización SMART, las actualizaciones de firmware, el control de TRIM/discard, y funciones específicas de NVMe como las reservas. También tiene sentido para cargas sensibles a la latencia donde incluso unos pocos microsegundos importan. Ciertos motores de base de datos y la ingesta de datos en tiempo real caen en esa categoría.
Para todo lo demás, los compromisos operativos cubiertos antes — pérdida de migración en vivo, pérdida de instantáneas e integración de copias — normalmente pesan más que la pequeña ganancia de rendimiento.
No hay nada listo en elegir el camino más difícil cuando el más fácil hace el trabajo.
Verificar tus cambios
Después de aplicar los pasos de ajuste, verifica que todo funciona como se espera:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Compara los resultados de la VM con tu baseline de bare metal de antes.
A iodepth=32, deberías ver un rendimiento dentro del 5 % del bare metal.
Los promedios de latencia de finalización deberían estar dentro de 10-15µs de las cifras del host.
Si el hueco sigue siendo grande, comprueba la alineación NUMA primero.
Es el factor que más comúnmente se pasa por alto.
También no cuesta nada más que un cambio de configuración, lo que lo hace la mejor clase de problema con el que quedarse.
Referencias
- Documentación PCI del núcleo Linux — opciones de ajuste de MPS y MRRS — la fuente autoritativa para
pcie_bus_perf,pcie_bus_safe, y parámetros relacionados - Guía de administración de Proxmox VE — passthrough PCI(e) — documentación oficial de Proxmox sobre la configuración del passthrough de dispositivos VFIO
- Foro de Proxmox — rendimiento del passthrough de NVMe — la discusión de la comunidad que motivó este artículo